


第一部分:论文开篇与基础构建 (Prompts 1-5)
这部分旨在帮助你明确研究方向,构建论文的“四梁八柱”。
Prompt 1: 研究问题与核心概念界定 (Problem Formulation & Core Concept Definition)
Prompt:
我正在撰写一篇关于 [你的研究领域,例如:基于深度学习的蛋白质结构预测] 的博士学位论文。我的核心研究问题是 [明确阐述你的核心研究问题,例如:如何通过融合多模态数据(如序列、共进化信息和三维几何约束)来提升对膜蛋白这类特殊蛋白质结构的预测精度?]。请基于此问题,为我完成以下任务:
-
核心概念界定 (Conceptual Definition): 定义并阐述与此研究问题直接相关的3-5个核心学术概念,例如:
深度学习 (Deep Learning)、蛋白质结构预测 (Protein Structure Prediction)、多模态数据融合 (Multimodal Data Fusion)、膜蛋白 (Membrane Protein)。要求每个定义都具备学术权威性,并指出其在该研究领域内的特定内涵。 -
研究问题解构 (Problem Decomposition): 将上述核心研究问题分解为3-4个可执行、可验证的子问题 (Sub-questions)。每个子问题都应更具体,并共同指向对核心问题的解答。
-
创新性声明 (Novelty Statement): 基于你对该领域的理解,草拟一段150-200字的创新性声明,清晰地论述我的研究相较于现有技术(例如:AlphaFold 2)可能存在的理论、方法或应用层面的贡献。
Prompt 2: 论文摘要的结构化生成 (Structured Abstract Generation)
Prompt:
请你扮演一位经验丰富的博士生导师,为我撰写一篇博士论文的结构化摘要 (Structured Abstract),大约400-500字。我的论文主题是 [你的论文主题],采用了 [你的研究方法],主要发现是 [你的核心发现]。请严格按照以下结构进行撰写:
-
背景 (Background): 简要介绍研究领域的重要性及现有研究的空白 (Research Gap)。
-
目的 (Objective): 清晰陈述本研究旨在解决的核心问题或达成的目标。
-
方法 (Methods): 高度概括研究设计、数据来源、使用的关键模型或算法。
-
结果 (Results): 定量或定性地呈现最核心、最关键的研究发现。使用具体数据支撑(如果适用)。
-
结论 (Conclusion): 总结本研究的理论意义、实践价值,并简要提及未来展望。
请确保各部分逻辑衔接紧密,语言专业、精炼。
Prompt 3: 论文引言的“GAP分析”与写作框架 (Introduction Chapter Framework with GAP Analysis)
Prompt:
我需要为我的博士论文撰写引言章节 (Introduction)。我的研究课题是 [你的研究课题]。请为我设计一个详细的引言写作框架,该框架必须以“研究缺口”(Research Gap)为中心展开,并遵循经典的“背景 -> 问题 -> 缺口 -> 解决方案”的逻辑流。请提供以下内容:
-
章节结构大纲 (Chapter Outline): 列出引言章节的详细二级和三级标题。
-
核心逻辑流 (Logical Flow): 详细描述每个标题下应阐述的核心内容,特别是如何从宏观背景 (Big Picture) 逐步聚焦到具体的、尚未被充分解决的学术问题 (The Gap)。
-
“缺口”论证策略 (Gap Justification Strategy): 提出3种可以用来有力论证“研究缺口”存在的策略,例如:
理论冲突 (Theoretical Conflict)、方法论局限 (Methodological Limitation)、应用空白 (Empirical Void),并为每种策略提供一小段示例性的论述。
Prompt 4: 文献综述的批判性视角构建 (Critical Literature Review Framework)
Prompt:
我正在撰写博士论文的文献综述 (Literature Review) 章节,主题是 [你的研究主题]。为了避免仅仅是简单地“堆砌”文献,我需要构建一个具有批判性视角 (Critical Perspective) 的综述框架。请为我执行以下任务:
-
主题分类 (Thematic Categorization): 基于我的研究主题,建议3-4个逻辑清晰的文献分类维度。例如,可以按
理论流派、技术演进路径、研究方法的差异或应用场景等进行划分。 -
批判性分析框架 (Critical Analysis Framework): 针对每一个文献分类,设计一个包含以下要素的分析框架:
-
主要贡献 (Key Contributions): 该类别文献的核心学术贡献是什么?
-
方法论优势与局限 (Methodological Strengths & Limitations): 它们所采用的研究方法有何优点和不可避免的缺点?
-
核心假设与争议 (Core Assumptions & Debates): 这些研究建立在哪些核心假设之上?学术界对这些假设或结论存在哪些争议?
-
与我研究的关联 (Connection to My Research): 这些文献如何共同指向了我的研究缺口?我的研究将如何回应 (Respond to)、挑战 (Challenge) 或拓展 (Extend) 这些已有工作?
-
-
撰写示例: 请为其中一个分类,草拟一段约200字的批判性综述示例。
Prompt 5: 研究假设的逻辑推演与表述 (Hypothesis Formulation and Justification)
Prompt:
基于我的研究问题:[你的研究问题],我计划提出以下核心研究假设 (Hypothesis)。请你作为一名逻辑学家和科研方法论专家,帮我完善它。
-
我的初步假设 (My Draft Hypothesis):[写下你初步构思的研究假设]
请完成以下工作:
-
逻辑评估 (Logical Evaluation): 评估该假设是否满足“可证伪性”(Falsifiability)、“清晰性”(Clarity)和“可检验性”(Testability)三大科学原则。如果不满足,请指出具体问题。
-
学术化重述 (Academic Refinement): 将我的初步假设改写为1-3个更加规范、严谨的学术假设 (H1, H2, ...)。请使用精确的变量关系描述,例如
正向影响 (positively affects)、调节 (moderates)、中介 (mediates)等。 -
理论基础与逻辑推演 (Theoretical Grounding & Justification): 为每个重述后的假设,提供一个简短的立论依据 (Justification)。这个依据应源自于 [你可以指定一个或几个经典理论,例如:技术接受模型(TAM)或认知负荷理论] 或普遍接受的学术逻辑,清晰地展示从理论到假设的推演过程。
第二部分:研究方法与设计 (Prompts 6-9)
这部分聚焦于研究的“心脏”——方法论,确保其科学性和可复现性。
Prompt 6: 研究设计与方法论的系统性阐述 (Methodology Chapter Outline)
Prompt:
我需要撰写博士论文的第三章“研究方法与设计”(Research Methodology)。我的研究属于 [选择:定量研究 / 定性研究 / 混合方法研究],具体方法是 [例如:基于深度卷积网络的图像识别 / 扎根理论的案例分析 / 准实验设计]。请为我设计一个逻辑严密、内容全面的章节大纲,至少应包含以下模块,并为每个模块提供简要的内容说明:
-
研究范式 (Research Paradigm): 明确阐述本研究遵循的哲学基础(如实证主义、解释主义等)及其对方法选择的影响。
-
研究设计 (Research Design): 详细说明总体研究方案,解释为何该设计最适合回答我的研究问题。
-
数据收集 (Data Collection):
-
数据来源/样本: 描述数据来源、样本选择标准 (Inclusion/Exclusion Criteria)、样本量及其确定的依据。
-
工具/仪器: 描述所用的数据收集工具(如问卷、访谈提纲、实验设备、数据集),并说明其信度 (Reliability) 和效度 (Validity)。
-
程序: 详细描述数据收集的具体步骤,确保他人可以复现。
-
-
数据分析 (Data Analysis):
-
分析策略: 阐明将使用何种具体的统计方法、算法模型或质性分析技术。
-
软件工具: 列出将使用的所有分析软件(如SPSS, R, Python, NVivo等)及其版本号。
-
-
伦理考量 (Ethical Considerations): 说明研究中涉及的伦理问题及相应的处理措施。
Prompt 7: 算法或模型的技术细节阐述 (Technical Elaboration of an Algorithm/Model)
Prompt:
在我的博士论文中,我提出/使用了一个名为 [你的算法/模型名称,例如:Attn-BiLSTM-CRF] 的模型来解决 [具体问题]。请你帮我撰写该模型的技术细节部分,要求兼具专业性和清晰度。请包含以下内容:
-
总体架构图 (Overall Architecture): 用文字描述该模型的总体架构,说明其由哪些核心组件构成,以及数据是如何在这些组件之间流动的。
-
核心组件详述 (Detailed Component Description): 逐一详细解释每个核心组件的数学原理和功能。例如,对于
Attn-BiLSTM-CRF:-
Embedding Layer: 它的作用和实现方式。
-
Bidirectional LSTM (BiLSTM) Layer: 解释其如何捕捉序列的双向依赖关系,并提供关键的数学公式(如状态更新方程)。
-
Attention Mechanism: 阐述其工作原理,为何在此模型中是必要的,并提供注意力权重的计算公式。
-
Conditional Random Field (CRF) Layer: 解释为何在序列标注任务的输出层使用CRF优于Softmax,并提供其损失函数的数学表达式。
-
-
伪代码 (Pseudocode): 为整个模型的训练或推理过程提供一段清晰的伪代码。
Prompt 8: 实验设计的严谨性论证 (Justification of Experimental Design)
Prompt:
我设计了一个实验来验证我的研究假设。实验设计如下:[详细描述你的实验设计,包括自变量、因变量、控制变量、实验分组、实验流程等]。请你扮演一个学术评审人,从以下几个方面对我的实验设计进行审视,并帮助我撰写一段文字,以增强其在论文中的说服力和严谨性:
-
内部效度 (Internal Validity): 分析我的设计在多大程度上控制了潜在的混淆变量 (Confounding Variables)?提出可能存在的威胁内部效度的因素(如选择性偏差、成熟效应等),并建议如何通过设计或统计方法来弥补。
-
外部效度 (External Validity): 我的实验结果在多大程度上可以推广 (Generalize) 到其他情境或人群?论证我选择的样本/实验环境的代表性。
-
构念效度 (Construct Validity): 我的自变量和因变量的操作化定义 (Operationalization) 是否准确地反映了其背后的理论构念 (Theoretical Construct)?
-
撰写论证段落: 基于以上分析,为我撰写一段约300字的段落,系统地论证我选择该实验设计的合理性,并主动说明其潜在局限性及应对策略。
Prompt 9: 定性研究的信度与效度保障 (Ensuring Rigor in Qualitative Research)
Prompt:
我的博士论文采用定性研究方法,具体为 [例如:多案例研究 (Multiple Case Study) / 扎根理论 (Grounded Theory)]。为了提升研究的严谨性,我需要专门撰写一节来论述如何保障本研究的“可信度”(Credibility)、“可转移性”(Transferability)、“可靠性”(Dependability)和“可确认性”(Confirmability)(Guba & Lincoln, 1985)。请为我针对这四个准则,分别提供3-4种具体可操作的策略,并为每种策略提供简要说明。
-
可信度 (Credibility):
-
可转移性 (Transferability):
-
可靠性 (Dependability):
-
可确认性 (Confirmability):
第三部分:结果呈现与分析 (Prompts 10-13)
这部分帮助你清晰、客观地展示你的研究成果。
Prompt 10: 结果章节的叙事结构设计 (Structuring the Results Chapter Narrative)
Prompt:
我已经获得了所有的实验/分析结果,现在需要撰写结果章节 (Results)。为了让读者能清晰地理解我的发现,我需要一个强有力的叙事结构。我的研究旨在回答以下几个子问题:[列出你的研究子问题]。请为我设计一个结果章节的写作大纲,该大纲应:
-
以研究问题为导向: 章节的组织结构应直接对应并逐一回答之前提出的研究子问题或假设。
-
逻辑递进: 结果的呈现顺序应有逻辑性,例如:从描述性统计开始,到主要假设的检验,再到探索性分析。
-
图表整合: 在大纲中明确指出在何处应插入关键的图 (Figure) 或表 (Table),并说明该图/表旨在传达的核心信息。
-
“不解释,只报告”原则: 在每个小节的内容描述中,请提醒我应遵循“只客观报告结果,不做过多解释或讨论”的原则。
Prompt 11: 为关键图表撰写专业的图注和表头 (Writing Professional Figure Captions and Table Titles)
Prompt:
我有一张图表,需要为其撰写专业的图注/表头。请遵循学术规范(如APA, MLA, Chicago等,请指定一种)为我生成。
-
图表类型:[例如:折线图 / 散点图 / 混淆矩阵 / 表格]
-
图表内容:[详细描述图表展示了什么,包括X/Y轴是什么,不同的线/点/颜色代表什么,表格的行和列是什么,关键数据点是什么]
-
核心信息: 这张图表最想传达的核心结论是 [一句话总结]。
请为我生成:
-
一个简洁但信息完整的标题 (Title)。
-
一段详细的图注/脚注 (Caption/Note)。 图注应独立成文,即读者不看正文也能完全理解该图表。它需要解释所有的缩写、符号、误差线 (error bars) 的含义,并简要说明统计检验方法(如p-value的显著性水平)。
Prompt 12: 对统计结果的学术化描述 (Describing Statistical Results Academically)
Prompt:
我进行了一项 [你的统计分析名称,例如:多元线性回归 / 独立样本t检验 / 重复测量方差分析]。以下是我的主要结果:[粘贴或描述你的关键统计输出,例如:回归系数、p值、F统计量、t值、自由度、R方等]。
请将这些统计结果转化为一段符合学术写作规范的、流畅的描述性文字。要求:
-
报告所有关键统计量: 确保在文本中正确报告所有必要的统计数据。
-
解释统计量的意义: 用通俗易懂的语言解释这些统计结果在研究背景下的实际意义。例如,回归系数
β=0.5意味着什么。 -
明确假设检验结果: 清晰地说明结果是否在统计上显著,以及这是否支持或拒绝了我的研究假设。
-
遵循特定格式: 请使用 [指定一种格式,如APA] 格式来报告统计量,例如
(F(1, 98) = 5.23, p = .024, η² = .05)。
Prompt 13: 定性数据分析结果的可视化与呈现 (Presenting Qualitative Data Findings)
Prompt:
我通过 [你的定性分析方法,例如:主题分析 (Thematic Analysis)] 对我的访谈数据进行了编码和分析,最终提炼出了 [数量] 个核心主题 (Themes)。现在我需要在结果章节中呈现这些发现。请为我提供一个结构化的呈现方案,包含:
-
主题呈现结构: 为每个主题设计一个标准的呈现结构,例如:
-
主题命名与定义: 清晰地命名并定义该主题。
-
主题描述: 详细阐述该主题的内涵和外延。
-
引用证据 (Illustrative Quotes): 提供1-2个最具代表性的原始访谈引文来支撑该主题。引文前应有引导性描述。
-
初步分析: 对引文进行简要分析,说明它如何体现了该主题。
-
-
可视化建议: 建议1-2种可以用来可视化这些主题及其相互关系的方法,例如:
主题网络图 (Thematic Network)或概念层次图 (Hierarchical Concept Map),并描述这种图的优势。 -
撰写示例: 请选择一个假设性主题(例如:“对AI助手的依赖与焦虑并存”),并按照你设计的结构撰写一个完整的呈现示例。
第四部分:讨论与深化 (Prompts 14-17)
这是论文的灵魂,需要将你的发现与现有知识对话,并展示其深层价值。
Prompt 14: 讨论章节的“IMRaD对话”框架 (Structuring the Discussion Chapter with IMRaD Dialogue)
Prompt:
我需要撰写博士论文的讨论 (Discussion) 章节。为了确保深度和逻辑性,我希望采用一种将我的研究结果 (My Results) 与引言 (Introduction) 和文献综述 (Literature Review) 进行系统性对话的结构。请为我设计一个讨论章节的写作框架,该框架应至少包含以下几个核心部分,并为每个部分提供详细的写作指引:
-
核心发现重申 (Restatement of Key Findings): 如何在不重复结果章节的情况下,高度概括我的核心贡献?
-
与文献对话 (Dialogue with Existing Literature):
-
结果支持 (Findings in Support): 我的哪些发现验证或支持了前人的研究?如何与他们的研究进行比较,并强调我研究的增量贡献?
-
结果冲突 (Findings in Conflict): 我的哪些发现与前人的研究不一致甚至相悖?为这些差异提供几种可能的、有说服力的解释(例如:样本差异、方法论不同、理论边界条件等)。
-
-
理论贡献 (Theoretical Implications): 我的研究在多大程度上修正、扩展或挑战了现有的理论框架?是否提出了新的概念或关系?
-
实践启示 (Practical/Managerial Implications): 我的研究发现对行业、政策制定者或特定实践领域有哪些具体的、可操作的建议?
-
局限性与未来研究方向 (Limitations and Future Research):
-
坦诚局限: 如何以一种建设性的方式承认本研究的局限性(理论、方法、数据等方面)?
-
指明未来: 基于这些局限性和新的发现,为后续研究者提出3-5个具体、有启发性的未来研究方向。
-
Prompt 15: 深入阐述研究的理论贡献 (Elaborating on Theoretical Contributions)
Prompt:
我的研究发现 [简要描述你的核心发现]。我认为它对 [某个特定理论,例如:计划行为理论 (Theory of Planned Behavior)] 有重要的理论贡献。请你帮我深入挖掘并清晰地阐述这些理论贡献。请从以下三个层次展开:
-
证实与丰富 (Confirmation and Enrichment): 我的研究是否在一个新的情境下验证了该理论?我的发现是否为该理论的现有构念 (Constructs) 增加了新的经验证据或更丰富的内涵?
-
扩展 (Extension): 我的研究是否引入了一个新的变量(如调节变量或中介变量),从而扩展了该理论的解释边界?我的研究是否揭示了该理论在之前未被注意到的作用机制?
-
挑战 (Challenge): 我的研究结果是否在某种程度上挑战了该理论的核心假设或预测?如果是,这是否意味着该理论需要进行修正或重新审视其适用范围?
请为每个层次草拟一段论述,帮助我清晰地定位我研究的理论价值。
Prompt 16: 从研究发现到实践启示的桥梁构建 (Bridging Findings to Practical Implications)
Prompt:
我的博士论文核心发现是 [用非技术语言概括你的发现,例如:我们发现,在远程办公环境下,使用A类沟通工具的团队比使用B类工具的团队,其创新效率高出15%,且员工幸福感显著更高]。我需要将这个发现转化为对 [你的目标受众,例如:企业管理者] 有价值的实践启示 (Practical Implications)。
请帮我完成以下任务:
-
目标受众导向: 确定1-2个最直接相关的利益相关者群体。
-
“So What?”测试: 对我的核心发现反复追问“So what?”(所以呢?),直到得出一个具体的、可操作的建议。
-
启示的结构化表述: 为我生成2-3条结构清晰的实践启示。每条启示都应遵循以下结构:
-
发现概述 (Summary of Finding): 简要重述相关的研究发现。
-
具体建议 (Actionable Recommendation): 提出一个明确的、可执行的建议。
-
预期效果 (Expected Outcome): 阐明采纳该建议可能带来的正面效果。
-
实施前提/注意事项 (Caveats): 提醒实施该建议时需要注意的潜在风险或边界条件。
-
Prompt 17: 系统性地思考并陈述研究局限性 (Systematic Articulation of Research Limitations)
Prompt:
我需要撰写研究局限性 (Limitations) 部分。请你扮演一个严苛但富有建设性的评审专家,帮助我从以下几个维度全面地审视我的研究,并为每个维度找出一到两个潜在的局限性。我的研究是 [简要描述你的研究设计和方法]。
-
理论视角局限 (Theoretical Limitations): 我是否只依赖单一理论视角,而忽略了其他可能有解释力的理论?
-
方法论局限 (Methodological Limitations):
-
抽样: 我的样本(数量、代表性)是否存在局限?
-
测量: 我的变量测量工具(问卷、量表)是否存在效度或信度问题?
-
设计: 我的研究设计(如横断面研究)是否限制了因果推断的能力?
-
-
数据局限 (Data Limitations): 我使用的数据集是否存在偏差、缺失值或时间跨度不足的问题?
-
普适性局限 (Generalizability Limitations): 我的研究结论是否只适用于特定的文化、行业或人群?
请为每个识别出的局限性,提供一种积极、专业的表述方式,并建议一个可以弥补该局限性的未来研究方向。
第五部分:结论与收尾 (Prompts 18-20)
最后一步,完美收官,提升论文的整体高度。
Prompt 18: 结论章节的升华与总结 (Crafting a Powerful Conclusion Chapter)
Prompt:
我需要撰写博士论文的最后一章:结论 (Conclusion)。这一章需要简洁有力,并提升整篇论文的高度。请为我设计一个结论章节的写作框架,避免与摘要或讨论章节内容过度重复。该框架应包含:
-
研究核心贡献的高度凝练 (Synthesis of Core Contributions): 如何用全新的语言,从更高层面(例如,对该领域认知范式的推动)总结我的研究回答了什么核心问题,以及最重要的贡献是什么?
-
对“大图景”的贡献 (Contribution to the "Big Picture"): 我的研究对于 [一个更宏大的社会、科学或技术议题,例如:人工智能伦理、可持续发展、公共卫生] 有何长远意义?
-
“闭环”与反思 (Closing the Loop & Reflection): 回顾引言中提出的问题,明确声明本研究是如何完成这一学术旅程的。可以包含一段对整个研究过程的简短反思。
-
最终展望 (Final Visionary Note): 抛开具体的未来研究建议,用一段富有启发性和前瞻性的话语来结束全文,描绘该领域未来激动人心的可能性。
Prompt 19: 全文逻辑一致性与流畅性审查 (Review for Logical Consistency and Flow)
Prompt:
我已经完成了博士论文的初稿。现在我需要对全文的逻辑一致性和学术“叙事流” (Narrative Flow) 进行一次彻底的审查。请你生成一个详细的“自查清单”(Self-Checklist),帮助我检查以下关键节点之间是否存在逻辑断层或矛盾:
-
研究问题 vs. 文献综述: 文献综述是否最终聚焦到了研究问题所指的“缺口”?
-
研究问题 vs. 研究方法: 所选的研究方法是否是回答研究问题的最恰当、最有力的方式?
-
研究方法 vs. 结果呈现: 结果的呈现方式是否与研究设计和数据分析方法完全对应?
-
结果 vs. 讨论: 讨论章节是否对结果章节中每一个重要发现都进行了解释和深化?是否存在讨论了结果中未报告的内容?
-
研究问题 vs. 结论: 结论是否清晰地回应了引言中提出的每一个研究问题?
-
全文术语一致性: 核心概念的定义和使用在全文中是否保持了严格一致?
请将这个清单以表格形式呈现,包含“检查点”、“检查内容”和“自查结果”三列。
Prompt 20: 学术语言的“降噪”与精炼 (Academic Language Polishing and Refinement)
Prompt:
以下是我博士论文中的一段话,请你扮演一个顶级的学术编辑,对其进行精炼和润色。
[粘贴你的一段原文,大约150-250字]
润色的目标是:
-
提升精确性 (Precision): 替换模糊、口语化的词语(如
thing,a lot of,get better)为更专业的学术术语。 -
增强客观性 (Objectivity): 移除带有过多主观色彩或情感的表达(如
I think,fortunately),使用更中立的陈述。 -
改善句式结构 (Sentence Structure): 将简单句合并为更复杂的复合句,使用从句和连接词来增强逻辑关系。避免重复的句式。
-
遵循学术惯例 (Academic Conventions): 采用更主动的语态(除非必要),并确保符合学术写作的正式风格。
请提供“润色后版本”,并用一个简短的列表指出你主要做了哪些类型的修改及其理由。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
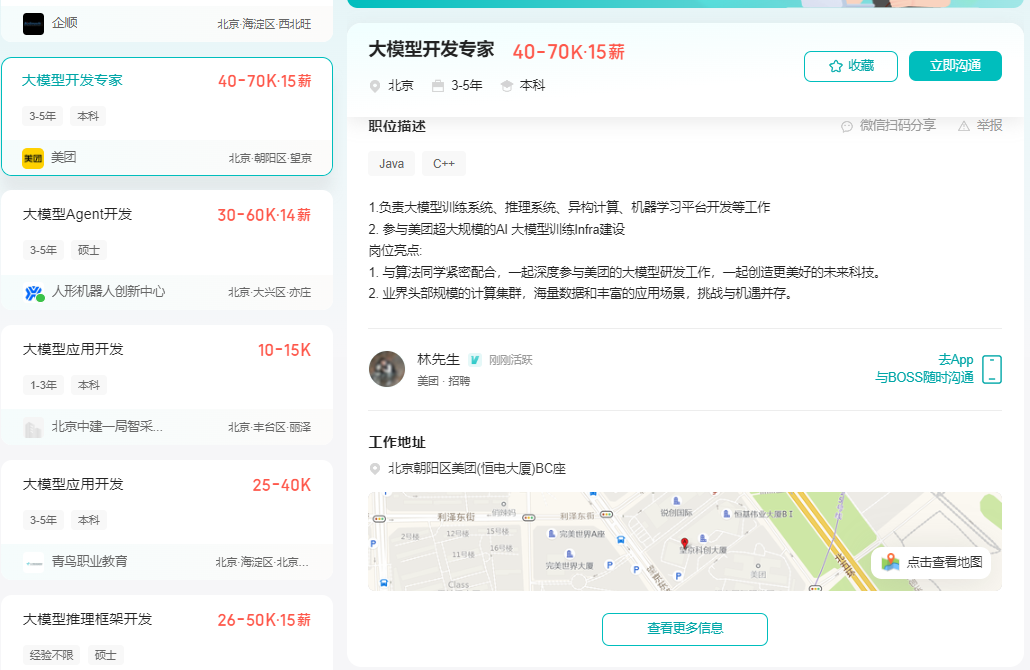
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
02.如何学习大模型 AI ?
🔥AI取代的不是人类,而是不会用AI的人!麦肯锡最新报告显示:掌握AI工具的从业者生产效率提升47%,薪资溢价达34%!🚀
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
 2029


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


