金仓数据库平滑演进:真实业务全链路流量仿真实践

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数 下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。 阅读详情

在这里插入图片描述

2247万条可执行请求、2817个Session。同一份真实负载、同一目标数据库、同一硬件环境下:回放时间从132分18秒缩短至49分47秒,平均吞吐从2801 req/s提升至7523 req/s。这是Kreplay并行回放模式的一组实测结果。但这次升级解决的,不只是“回放更快”。更重要的是:让大规模真实负载的回放方式,也更接近真实业务本来的运行方式。

在数据库国产化替代与版本升级的浪潮中,如何验证新环境能否平稳承接生产负载,始终是运维与DBA团队最头疼的问题之一。直接切换风险太高,全量回归又耗时耗力。Kreplay给出的答案是:把生产环境真实发生的SQL请求完整捕获下来,在目标数据库上原样重放,用最接近实战的方式提前暴露兼容性、性能与稳定性隐患。而并行回放模式的引入,则让这一验证过程从“能跑”迈向了“跑得快、跑得真”。

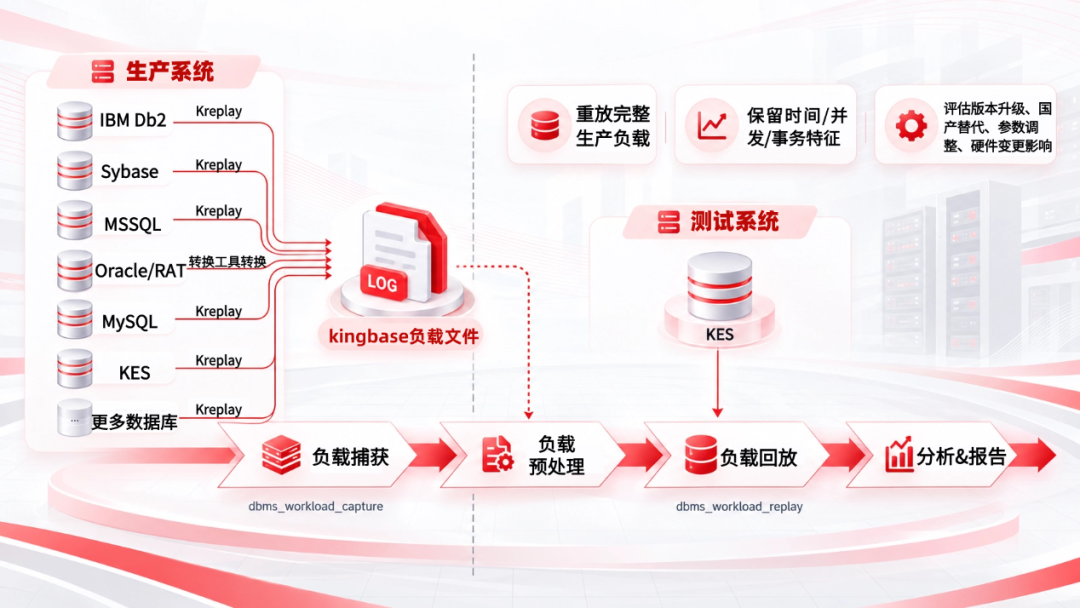
Kreplay作为电科金仓自主研发的一款数据库回放工具,用于在正式适配之前,通过捕获生产系统上的真实工作负载,并在测试系统中进行生产工作负载的完整重放,以评估系统更改(如版本升级、国产替代、参数调整、硬件变更等)的总体影响。它解决的是一道经典难题:如何在不动生产环境的前提下,尽可能真实地预演未来。
Kreplay作为电科金仓自主研发的一款数据库回放工具,用于在正式适配之前,通过捕获生产系统上的真实工作负载,并在测试系统中进行生产工作负载的完整重放,以评估系统更改(如版本升级、国产替代、参数调整、硬件变更等)的总体影响。
真实业务是并发的,回放也不该只有一条队伍

过去,为保证执行顺序,回放通常采用全局时间戳排序:将不同Session产生的SQL统一排序,再依次执行。这种方式足够稳妥,但随着回放规模进入千万级,一个问题开始变得突出:生产环境中原本互不依赖、可以同时执行的多个Session,在回放时也被排进了同一条队伍。一条慢SQL,可能让后面大量无关请求一起等待。

不仅回放时间被拉长,原生产环境中的并发关系也被削弱。而真实数据库上线后面对的,恰恰不是一条整齐的SQL队列,而是大量Session同时运行,由此产生的锁竞争、事务冲突和资源争用。所以,Kreplay并行回放要解决的问题很明确:既不能为了并发打乱原有执行关系,也不能让彼此无关的请求继续相互等待。
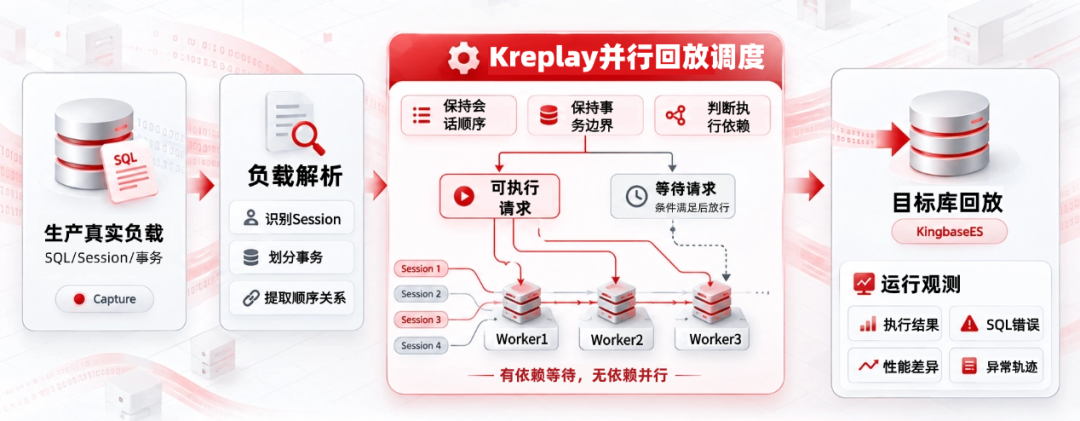
该串行的继续串行,可以并行的不再排队

Kreplay并行回放不是简单地“多开几个线程”。它会保留同一Session内必要的执行顺序、事务边界以及相关执行约束,同时让已经满足执行条件、彼此独立的Session并行推进。过去是所有SQL围绕一条全局队列推进;现在,则把等待控制在真正需要等待的范围内。这样既保留了真实负载中的必要执行关系,也释放了原本就存在的并发空间。

2247万条请求,从132分钟降到49分钟

在本次测试中,共包含:2817个Session,22472516条可执行请求。两种模式使用同一份捕获到的真实负载(Capture)、同一目标数据库版本及相同硬件环境。
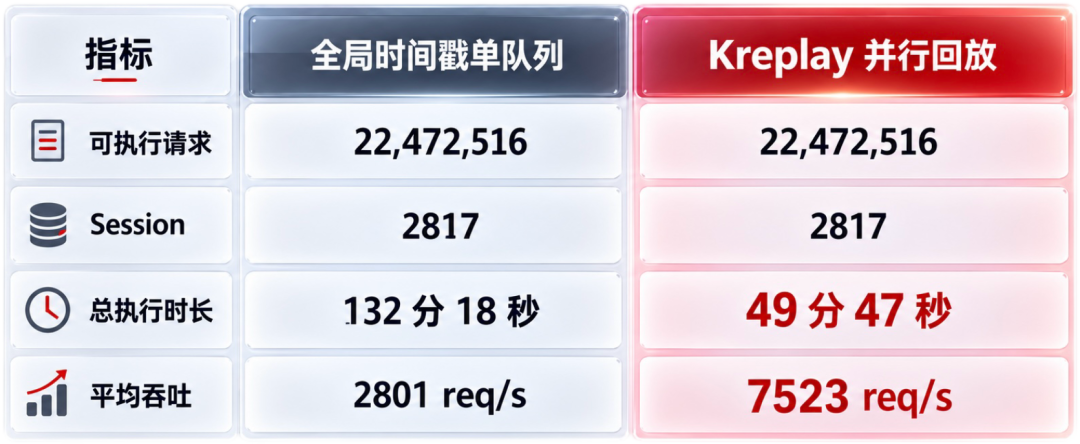
在本次测试环境下:平均吞吐提升168.57%、回放时长缩短62.37%。这意味着,当真实业务负载进入千万级规模后,回放机制本身不必再因为全局串行成为验证效率的瓶颈。

快了,更要真实了

如果只看49分钟,很容易把这次升级理解为一次单纯的性能优化。但对KReplay来说,真正重要的变化是:以前解决的是,生产环境发生过的SQL,能不能在目标数据库重新跑一遍。现在进一步解决的是,这些SQL能不能以更接近生产环境的并发方式重新跑一遍。这意味着,在数据库正式迁移上线之前,目标环境可以更充分地面对真实业务中的多Session并发、资源竞争和事务压力。同时,KReplay仍会记录回放过程中的执行进度、SQL错误、事务异常等信息,为后续兼容性分析、性能定位和迁移决策提供依据。从真实SQL,到真实负载,再到更接近真实业务的并发运行方式。

存储&AI行业每日要闻(2026-10-25 影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题; 阅读详情

相关推荐

第33章 YOLO+OpenCV:视频流网络传输

本案例演示用视觉处理库连接网络视频流并逐帧显示画面。程序先打开流地址,再循环取帧、显示、等待按键退出,并用重试计数应对连接失败与读取中断。验证时关注窗口能否稳定出画、是否长时间卡顿黑屏、退出后终端有无报错。🌈

小哥谈 493

「大车小标」自动稽核怎么落地:识别车型与计费车型如何自动比对、争议如何排除

在高速公路货车逃费里,"大车小标"是最高频、也最难缠的一类:实际是更大车型、更多轴数的货车,却按更小车型交费,跑同样的路交更少的钱。单次差额可能不大,但放到长距离、高频次、规模化运营的路网里,累积的通行费流失相当可观。自动稽核"大车小标",核心不是"识别出这是什么车"这么简单,而是要把多个来源的车型判断和最终计费车型自动比对,并在大量正常交易里把真正可疑的少数挑出来,同时把设备误差、遮挡污染造成的误判排除掉。本文拆解这条链路的工程落地思路,全文定性,不涉及具体识别率与金额。

weixin_53898122的博客 350

RAG项目简历包装指南:从“流水线工人”到“问题解决者”的跃迁(附代码与思路)

本文代码已在Python 3.11 + CUDA 12.3环境测试,部分功能需LangChain 0.2+支持。

Conan_0728的博客 1877

【技术拆解】配音工具选型评估方法论:用 6 个维度给 AI 配音软件打打分

✅ 测试方案:准备一段包含括号注释、数字、中英文混排的文案导入试听,校验读音、停顿是否合理。案例参考:逗哥配音配套了文案提取、自动对轴、人声分离、声音转换等附加工具,支持 wav /mp3 /mp4 格式导出,可附带字幕与 SRT 文件,在字幕对齐、文件导出这条链路具备对应的能力,适合批量生产场景的创作者在这个维度进行自测打分。同一款配音引擎,有人评价 “自然接近真人”,也有人反馈 “AI 感很重”,核心差异往往来自使用场景:30 字以内的短口播,和 3000 字小说章节朗读,对引擎能力要求完全不一样。

zhizhizhuzhuxia的博客 142

C#与YOLOv8工业缺陷检测实战:从算法到PLC集成的工程化落地

目标检测作为计算机视觉的核心任务,其原理是通过深度学习模型在图像中定位并识别物体。这项技术的关键价值在于将AI的感知能力转化为实际生产力,尤其在工业自动化领域,它能实现高效、精准的视觉检测。在工业缺陷检测这一典型应用场景中,稳定性和实时性是核心挑战。本文聚焦于如何将YOLOv8这一先进的目标检测模型,与C#上位机开发及工业相机硬件深度集成,构建一个能够7x24小时稳定运行的智能检测系统。文章深入探讨了从模型训练、ONNX部署,到与PLC通信联调的完整工程化路径,并针对工业环境中常见的稳定性、性能及调试问题提

weixin_33508411的博客 233

【飞控】PX4 Autopilots与MATLAB/Simulink联合仿真环境搭建全攻略

本文详细介绍了在Windows系统上搭建PX4 Autopilots与MATLAB/Simulink联合仿真环境的完整流程。通过WSL2安装Ubuntu,配置UAV Toolbox支持包,并重点解决了PX4源码克隆、子模块更新等网络难题,最终实现软件在环(SITL)仿真。文章还涵盖了硬件在环(HITL)配置及常见问题排查,为无人机飞控算法开发与测试提供了高效、可靠的解决方案。

weixin_29201933的博客 541

外贸独立站 AI 爬虫日志分析:UA 清单、状态码分布与「爬取不等于引用」

日志可反映爬虫访问路径、状态码与UA,但无法证明内容是否被AI引用。需按UA、状态码、路径三层分析,识别可达性问题,避免误判“抓取=引用”。应结合实测验证引用效果,警惕日志误导。关键结论:抓取≠收录≠引用,技术优化仅解决可抓取性,不保证被引用。

mqhgeo的博客 336

Tushare Pro的安装使用——“抱歉,您没有访问该接口的权限,权限的具体详情访问:https://tushare.pro/document/1?doc_id=108”问题

最近做毕设关于量化交易的, 因此一直使用tushare作数据源,但是过程中到一些问题,因此这里写篇文章,供大家一起交流下。 Tushare简介 Tushare是一个免费、开源的python财经数据接口包。拥有如股票、基金、期货等行情数据,公司财务、基金经理等基本面数据,以及债券、外汇、行业、大数据、区块链。Tushare返回的绝大部分的数据格式都是pandas DataFrame类型,因此非常方便...

sinat_40875078的博客 1万+

把GeoReady九维当工程项做:储能管理官网的AI就绪度改造笔记

GeoReady把1900多个网站的审计数据摊开,做成实时基准(State of GEO):AI搜索就绪度平均56.7/100,中位数59,一半以上卡在地基档。这篇用工程视角拆解这份基准:九维权重分别对应哪些工程项(robots.txt放行AI爬虫、llms.txt部署、Schema JSON-LD注入、Meta标签规范化、品牌实体清晰),哪些是「白给的分」,以及怎么把就绪度检查纳入CI流水线。先说结论——56.7分测的是机器可读性,是卫生指标不是排名;工程上先补最便宜的两块(llms.txt+JSON-L

RoseMarketing的博客 246

医疗领域BGE-M3模型微调全流程:从数据准备到效果评估

本文详细介绍了医疗领域BGE-M3模型的微调全流程,从数据准备到效果评估。通过医疗数据微调,BGE-M3模型在临床问答、病历检索等场景中表现显著提升,能够准确理解医学术语之间的细微差别。文章还提供了实战练习代码和效果评估指标,帮助开发者快速掌握医疗文本嵌入模型的应用技巧。

weixin_29098367的博客 278

26版SPSS操作教程(高级教程第十章)

#大道之行,在于坚持 #本期内容:二分类Logistic回归模型 #由于导师最近布置了学习SPSS这款软件的任务,因此想来平台和大家一起交流下学习经验,这期推送内容接上一次高级教程第九章的学习笔记,希望能得到一些指正和帮助~

你好! 1591

什么是AI、模型和token、vibecoding介绍、ClaudeCode环境搭建

AI是用计算机模拟人类思维与行为的技术,不具意识,仅作为能力放大器。模型是其核心,参数量决定智能水平,大模型历经文本、多模态到全模态演进。大模型按任务表现排名,如千问、DeepSeek等。收费以token为单位,按使用量或套餐计费。Vibecoding通过自然语言生成代码,工具包括ClaudeCode、Cursor等。安装可选CLI或GUI版本,需配置Python、Git、Node及大模型账号,提升开发效率。

2501_91966873的博客 256

QEMU源码全解析7 —— QEMU主函数

QEMU源码全解析7 —— QEMU主函数

phmatthaus的专栏 1286

LDR6100 智能遥控器精品软文:Type-C 充电口与低功耗量产维护

当 USB-C 接口从单纯的结构升级,变成整机供电稳定性、待机续航、量产一致性的核心瓶颈,智能遥控器、语音遥控器、手持控制器这类小型手持设备的硬件开发,早已不再是 “换一个 Type-C 座子” 那么简单。大量项目在试产阶段反复踩坑:不同品牌适配器识别失败、热插拔瞬间掉电死机、整机休眠待机电流超标导致电池续航缩水、产线测试时端口状态无法捕捉、兼容性参差不齐。乐得瑞 LDR6100 作为单路 USB-C/PD 专用控制芯片,专为小体积手持设备的 Type-C 供电入口量身打造。

LDR006的博客 404

ViT 实战 万字全攻略:从图像分类到医学影像,Transformer 重塑视觉 AI

摘要:本文深度解析 ViT(Vision Transformer)算法在视觉任务中的原理与实践,涵盖图像分类、目标检测、语义分割及医学影像分析四大领域。从理论出发,详细拆解图像分块、位置编码、Transformer 编码器等核心机制;通过 PyTorch 与 Timm 库实现模型构建、训练与优化,提供 CIFAR-10、Pascal VOC、Cityscapes 及医学数据集的完整代码示例。针对工业级部署,重点介绍模型量化、TensorRT 加速、Flask API 开发及 Docker 容器化方案。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 1930

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Python 浏览器自动化:Selenium vs Playwright 底层原理、实现细节 + Codex 大模型为什么能自主操控浏览器登录填表

Selenium。缺点维护成本高,不适合对接 AI。Playwright,CDP+AX 语义树是核心优势。用自然语言代替硬编码选择器,让 AI 看懂网页语义,自主完成多步网页任务。传统自动化是 “人告诉程序每一步点击哪里”;AI 浏览器 Agent 是 “人告诉程序目标,AI 自己观察页面,决定点哪里,自主完成任务”。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 318

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

【论文解读】DMH-Net:用深度曼哈顿霍夫变换从全景立方图估计3D房间布局

想象一个空房间,把所有面都去掉,只剩下棱┌─────────────┐ ← 墙与天花板的交界线/│ /│/ │ / │ ← 墙与墙的交界线(竖直)│ │ │ ││ / │ /└─┘───────────┘ ← 墙与地板的交界线论文的房间线框只有三类线线类型是什么在 3D 空间中的方向墙-天花板交界线​墙顶那条边水平,在天花板平面上墙-地板交界线​墙脚那条边水平,在地板平面上墙-墙交界线​两面墙相交的竖棱竖直​为什么用线框?​ 论文给的动机很有说服力:人类感知 3D 世界时,靠的是。

拜小白的成长之路,告别小白 351

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

8G 显存本地部署 AI 漫剧流水线:分镜提示词版本管理、批量归档与角色提示词隔离实战教程

本文针对8G显存本地部署的AI漫剧生产中提示词混乱、版本丢失、角色画风漂移等痛点,设计并实现一套轻量化本地提示词管理系统。系统基于纯JSON文件存储,支持角色提示词隔离、分镜模板复用、项目版本快照、批量校验与导入导出,与ComfyUI流水线无缝对接,实现画风一致性与高效复现。所有功能均无需数据库,可常驻后台运行,显著提升红果短剧系列化生产的稳定性与可维护性。

2603_96706877的博客 144

纳米 AI 搜索实战应用场景指南

在数字化运营的日常工作中,我们常常面临这样的困境:海量信息扑面而来,但真正能转化为决策依据的却寥寥无几。无论是电商团队需要精准锁定潜力爆款,还是市场部门急需捕捉转瞬即逝的热点,亦或是研究人员需要在浩如烟海的文献中梳理脉络,传统的人工检索与整理方式不仅效率低下,还极易遗漏关键细节。很多时候,我们花费了数小时甚至数天去收集数据,最后却发现信息滞后、来源单一,甚至存在事实偏差,导致后续的strategy制定建立在沙滩之上。这种“信息过载”与“价值稀缺”的矛盾,正在成为制约个人与企业成长的核心瓶颈。

llhllq2015的博客 209

32 分钟不是完成科研:多智能体读脑图谱,突破在哪里?

如果数千个 AI 智能体只用 32 分钟,就能梳理一份庞大的脑科学数据,我们应该惊讶什么?是模型终于能“独立做科研”,还是科研流程中的某个环节开始出现新的组织方式?10 月 21 日,OpenAI 公布了与 PerturbAI、Scripps Research 合作的研究:利用基于 GPT-Rosalind 的多智能体系统,解释一份已经存在的小鼠脑基因扰动数据,整理潜在研究线索。

weixin_44369324的博客 247

图像审核‑图片内容风控‑违规图像检测‑图片鉴黄鉴暴‑广告二维码识别‑图像风险筛查 API 接口介绍

名称类型必须说明imgBase64String否图像base64字符串imgFilefile否图像文件imgUrlString否图像url链接imgTypeString否图片类型 0: 静态图片(PNG、JPG、JPEG、BMP、GIF(仅对首帧进行审核)、Webp、TIFF)1: GIF动态图片 默认 0注意imgFile, imgBase64, imgUrl至少传入一个,优先级:imgBase64 > imgFile > imgUrl。

聚美智数 234

AI辅助逆向的完整链路——反汇编→特征提取→大模型重写

编译后的程序(PE/ELF/Mach-O)丢失了源代码几乎所有高层语义:变量名、注释、类型、函数命名、循环分支结构,只剩下CPU能识别的机器码。传统逆向链路:机器码 → 反汇编(汇编指令)→ 人工阅读 + 静态分析工具生成伪C → 人工梳理逻辑。优化编译、混淆、花指令会把控制流打碎,伪代码可读性极差;无符号剥离(stripped binary)下所有函数都是FUN_xxxx,变量全是v1、v2;单函数上下文有限,跨函数调用、数据依赖靠人脑记忆,效率极低;

weixin_43156294的博客 193

零信任架构实战:基于海宇全国车辆配置查验构建自动化智慧高速公路称重检测与ETC货车车型分类比对网关

破解高速公路货车车型分类与治超比对痛点:从人工目测验票到车管权威配置数据即时直连 在全国深化收费公路制度改革、全面取消省界收费站以及大力推行“入口称重检测、按车型分类计费(JT/T 489-2019《收费公路车辆通行费车型分类》)、ETC不停车电子收费”的智慧交通体系中,高速公路ETC自由流门架系统与入口动态称重治超检测中台承担着高速通行效率与道路交通安全治

haiyuzhicha的博客 181

我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内容,你们AI导出鸭可以吗?

很多人第一次听到“导出对话”,脑子里浮现的是打开某一条聊天记录,右上角点一下导出,保存成一份文件。这不是为了设门槛,而是因为批量导出背后的枚举、并发、格式渲染成本,和单条导出完全不是一个量级。AI导出鸭 不做格式绑架,这是它作为导出工具的基本修养。回到标题那个问题:我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内,你们AI导出鸭可以吗?批量导出和选择性导出并不冲突,工具的设计逻辑是先枚举、再选择、后导出。我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内容,你们AI导出鸭可以吗?

laoyunsi的博客 113

《FDE前沿部署工程师实战教程》46 - Enterprise AI Value Engineering:构建企业 AI 的价值度量、投资回报与持续优化体系

本文探讨了人工智能在现代教育领域的应用及其对教学模式的深远影响。文章指出,AI技术通过个性化学习路径推荐、智能作业批改和实时学习反馈,显著提升了教学效率与学生参与度。同时,文中分析了教师角色的转变,强调其从知识传授者向学习引导者和情感支持者的过渡。研究还提及了数据隐私、算法偏见及技术依赖等潜在挑战,并提出应建立完善的伦理框架与监管机制以确保AI教育应用的公平性与透明度。最后,文章呼吁教育机构、政策制定者和技术开发者协同合作,推动人工智能与教育深度融合,实现更加包容、高效的学习生态。

IT古董 347

AI 越快,越要慢下来想清楚

AI 把"做出来"变便宜了,值钱的东西整体往后移——从执行到判断、从生产到分发、从产出到问责。层面普通人程序员生产与回报不学"变现课",学自己已验证的链路先验证"有人付钱",再让 AI 加速开发劳动与入口可编码的交出去,省下的时间投到判断/协调/关系从"实现者"迁到"定义者 + 验收者"能力与判断学"什么算做好",保留判断权合入底线:看懂 or 完备用例通过信任与账单学"什么不该用 AI 做",放大独有的AI 可以帮你写,不能帮你懂。

runafterhit的博客 275
上一篇: 国庆重保红蓝演练(一):模拟外部黑客视角发起受限探测
下一篇: 要持续维护AI生成的前端Java后端什么时候该系统学框架
硅徒
博客等级 码龄3年 9773粉丝 828原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值