混合专家模型 (MoE) 简述

一步一步理解大模型:混合专家模型(MoE)简介 混合专家模型,英文叫Mixture of Experts (MoE) 是一种模型设计策略,它通过将多个模型(称为"专家")的预测结果结合在一起,以获得更好的预测性能。 阅读详情

引言

本文主要想梳理一下 MoE 模型相关的概念,并阅读整理部分开源 MoE 模型的论文,简要地描述整体架构等。

概念

关于MoE 模型详解的部分主要参考了这篇文章 混合专家模型 (MoE) 详解。

Transformer 和 MoE

先回顾一下 Transformer 架构

  • Transformer 完整结构由若干个 Block 组成
  • 每个 Block 中包含了编码器 Encoder 和解码器 Decoder
  • Encoder 和 Decoder 都包含4个部分:注意力层 Attention、位置感知前馈层 FNN、残差连接 Add 和层归一化 Norm
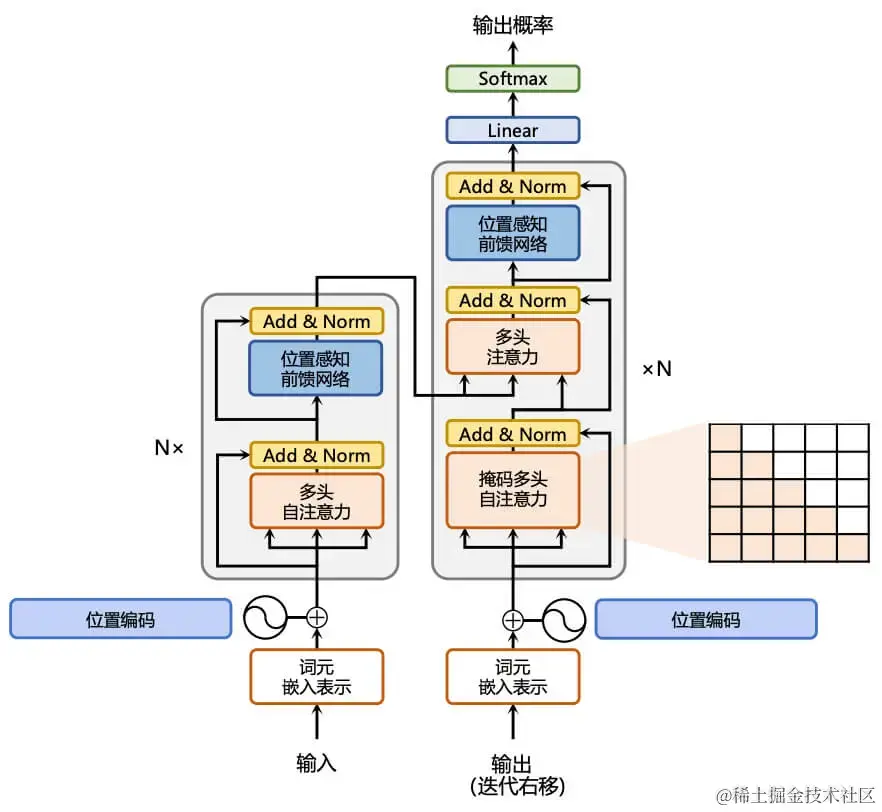
Transformer 架构.png 混合专家模型 (MoE) 是一种基于 Transformer 架构的模型,主要是由两个关键部分组成:

  • 稀疏 MoE 层:代替了 Transformer 架构中的前馈层 FNN。MoE 层包含了多个专家,每个专家可以是一个独立的神经网络,通常是前馈网络 FNN,但也可以是更复杂的网络结构,甚至可以是 MoE 层本身。
  • 门控网络或路由:这部分决定 token 被发送到哪个专家。一个令牌可以被发送到多个专家,路由器由学习的参数组成,并与网络的其他部分一起进行预训练。
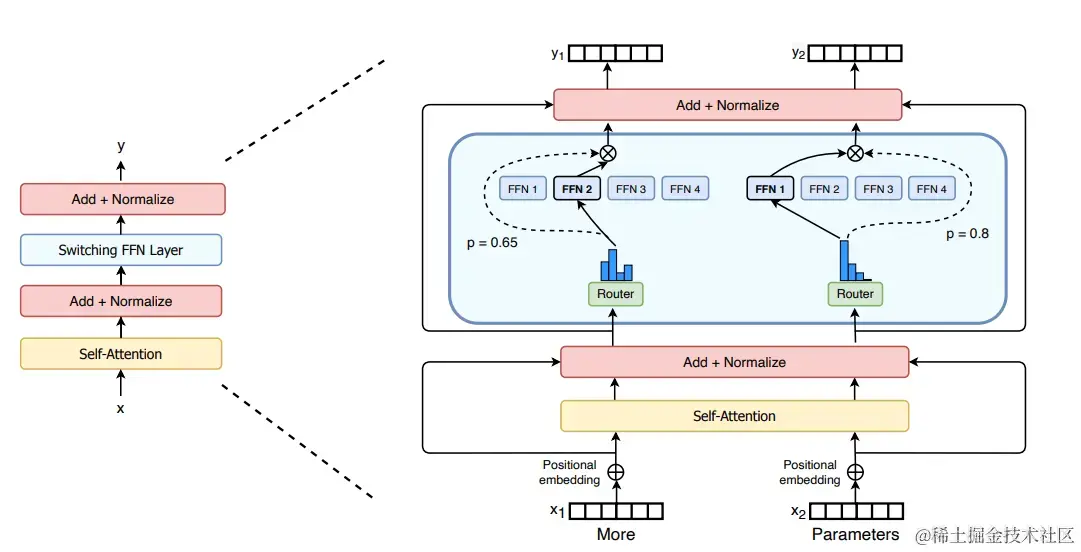
Switch Transfomer.png

稀疏性

在传统的 Transformer 稠密模型中,所有参数都会对所有输入数据进行处理;相比而言,MoE 稀疏模型支持仅对整个系统的某些特定部分执行计算,即可以根据输入的特定特征或需求,只运行和调用部分参数,这被称为条件计算。

22年的一篇论文,指出了 Transformer 模型中 FFNs 也存在稀疏性激活问题。换句话说,对于单个输出,只有 FFNs 中一小部分神经元被激活(引用自 MoEfication: Transformer Feed-forward Layers are Mixtures of Experts )。为了验证这个结论,作者将 Transformer 中的 FNNs 层分割成多个专家,称作 MoEfication,比较重要的主要是两点:

  • 专家分割:将 FFNs 分割成多个功能区作为专家,这里主要提供了两种方法

    • 参数聚类分割:使用平衡 K-Means (Balanced K-Means) 算法对神经元向量做聚类
    • 共激活图分割:构建共激活图 (Co-activation Graph)
  • 专家选择:这部分主要决定如何选择专家,这里没有使用典型的 MoE 门控网络,只是浅谈一下

    • Groundtruth Selection:用贪婪算法计算每个专家的得分,然后选得分最高的专家
    • Similarity Selection:用余弦距离做近似计算,选出最近似的
    • MLP Selection (推荐):训练多层感知器 (MLP),预测每个专家中激活神经元的总和并将其作为得分
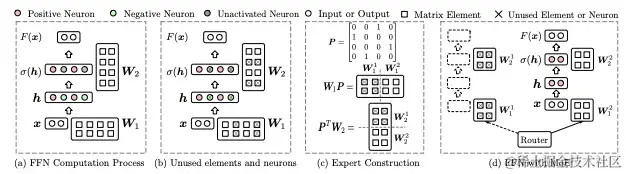
MoEfication.png

门控网络

但这里还需要注意一点的是,需要对专家进行负载均衡,以防止不均匀分配和资源利用效率不高的问题。这可以通过一个可学习的门控网络 (G) 来决定要发送给哪些专家 (E):

y=∑i=1nG(x)iEi(x)y=\sum^n_{i=1}G(x)_iE_i(x)y=∑i=1n​G(x)i​Ei​(x)

典型的可学习的门控网络 (G) 通常是带有 softmaxsoftmaxsoftmax 函数的网络(返回每个输出分类的结果和概率),但默认的 softmaxsoftmaxsoftmax 函数是返回所有结果,即返回所有专家和概率。在这种情况下可以再引入一些可调整的噪声,然后保留k个值,公式如下。 (引用自 Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer )

H(x)i=(xWg)∗i+StandardNormal()∗SoftPlus((xW∗noise)i)H(x)_i =(xW_g)*i + StandardNormal()SoftPlus((xW{noise})_i)H(x)i​=(xWg​)∗i+StandardNormal()∗SoftPlus((xW∗noise)i​)

G(x)=Softmax(KeepTopK(H(x),k))G(x)=Softmax(KeepTopK(H(x), k))G(x)=Softmax(KeepTopK(H(x),k))

最后还需要注意的是,在训练 MoE 模型的过程中,因为受欢迎的专家训练的更快,所以门控网络往往更倾向于主要激活相同的几个专家,使得这种情况自我加强。为了缓解这个问题,就需要引入一个辅助损失,从而确保所有专家接收大致相等数量的训练样本。在 transformers 库中,可以通过 aux_loss 参数来控制辅助损失。

💡 稀疏混合专家模型 (MoE) 更适用于有多台机器且要求高吞吐量的场景;相反,显存较少且吞吐量低的场景更适合用稠密Transfomer模型

GShard:Top-2 门控

谷歌使用 MoE 架构将模型的参数量扩展到了 6000亿。 (引用自 GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding )

GShard 将编码器和解码器中的每个前馈网络层(FNN)替换为一个 Top-2 门控网络的 MoE 层。简而言之,token 进入 MoE 层之后,通过门控网络选出 Top-2 的专家进行处理,每个专家都是 Transformer 架构的稠密模型。
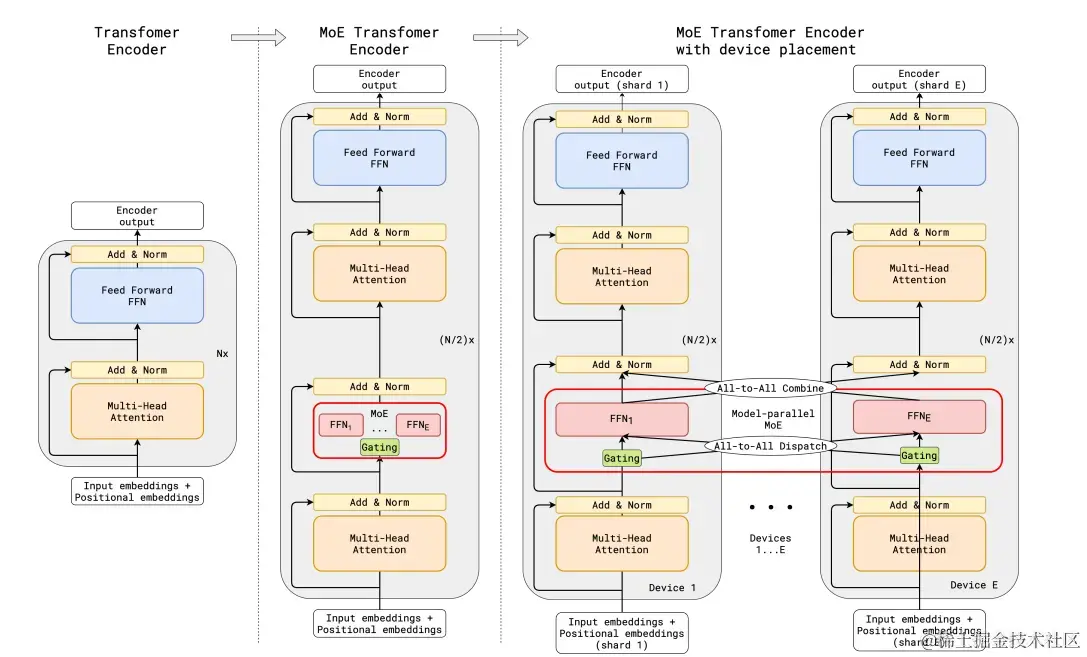
GShard.png

GShard 还引入了一下关键变化:

  • 随机路由:Top-2选择中,第一个专家是排名最高的,第二个专家是根据其权重比例随机选择的
  • 专家容量:设定阈值来定义专家能处理多少个 token。如果两个专家的容量都达到上限,令牌就会溢出,并通过残差链接传递到下一层,或在某些情况下被完全丢弃。所以 MoE 模型的专家容量决定了能处理的token长度。

Switch Transformers:单专家和专家容量

HuggingFace 上开源的 Switch Transformer 是模型是一个基于 google/flan-t5-large 模型改造的 MoE ,拥有2048个专家、1.6万亿参数的 MoE,专家容量64。Switch Transformer 中的每个专家是一个标准的 FFN,所以总的参数量是标准 Transformer 模型的 2048 倍。

(引用自 Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, 模型 google/switch-c-2048)
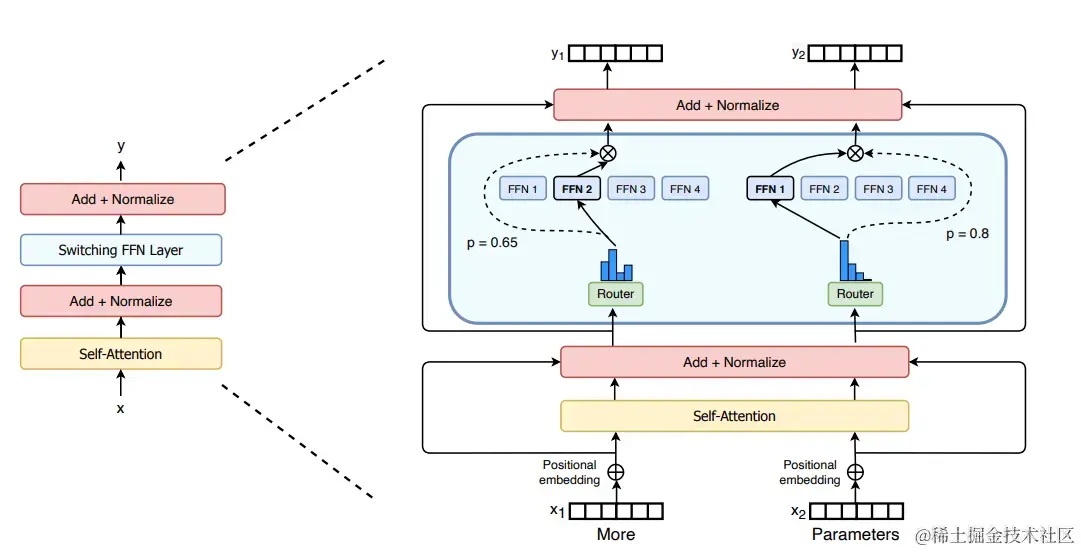
Switch Transfomer.png

与 GShard 想法不同,Switch Transformers 对经典的 topK 门控进行了简化,采用了单专家策略,即一个token令牌只由一个专家执行,这种方法可以 ① 减少门控网络的计算负担 ② 每个专家的批量大小至少可以减半 ③ 降低通信成本 ④ 保持模型质量。

Switch Transformers也对专家容量进行了研究,建议容量将批次中的令牌数量均匀分配到各个专家,具体公式如下(注:Switch Transformers 在低容量因子 (例如 1 至 1.25) 下表现出色)

Expert Capacity=(tokens per batchnumber of experts)×capacity factorExpert\space{} Capacity = (\frac{tokens \space{}per\space{}batch}{number \space{}of\space{}experts})\times capacity\space{}factorExpert Capacity=(number of expertstokens per batch​)×capacity factor

以开源模型为例,专家容量是64,专家数量是2048,假设容量因子是1,那么每个批次中的令牌数量是 131072。

DeepSeek-MoE:共享专家

这部分主要看一下国产开源的 MoE 模型,在 huggingface 上开源的模型包含164亿参数,共 64个路由专家、2个共享专家,每个令牌会匹配6个专家。(引用自 DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models, 模型 deepseek-ai/deepseek-moe-16b-base , 微调代码 github.com/deepseek-ai…)
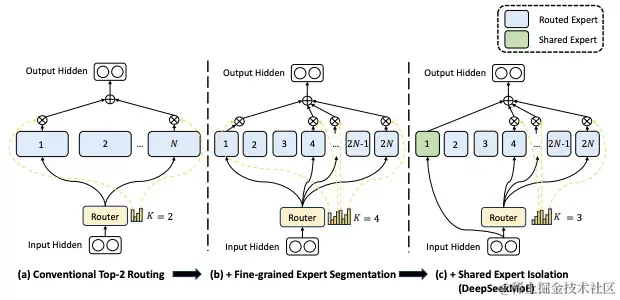
DeepSeek-MoE.png

DeepSeek-MoE 引入了“细粒度/垂类专家”和“共享专家”的概念。

“细粒度/垂类专家” 是通过细粒度专家切分 (Fine-Grained Expert Segmentation) 将一个 FFN 切分成 mmm 份。尽管每个专家的参数量小了,但是能够提高专家的专业水平。

“共享专家”是掌握更加泛化或公共知识的专家,从而减少每个细粒度专家中的知识冗余,共享专家的数量是固定的且总是处于被激活的状态。

LLaMA-MoE:轻量化和可配化

LLaMA-MoE-v1 是基于 LLaMA2 的一个 MoE 模型。类似 MoEfication,LLaMA-MoE-v1 将 LLaMA2 模型中的前馈网络层 FFNs 分割为包含多个专家的 MoE,这导致LLaMA-MoE-v1中一个专家的参数比其他 MoE 模型要更小些。(引用 LLaMA-MoE: Building Mixture-of-Experts from LLaMA with Continual Pre-training, 模型 llama-moe, 代码库 github.com/pjlab-sys4n…)

对于分割方法,这里提供了随机(Random)、聚类(Clustering)、共激活图(Co-activation Graph)和梯度(Gradient)等等。

对于专家路由即门控网络部分, LLaMA-MoE-v1 实现了经典的 TopK 噪声门控,也实现了 Switch Transformer 中提出的单专家门控。
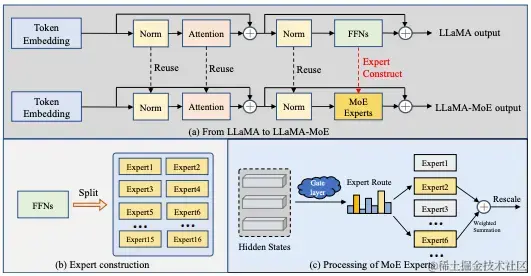
LLaMA-MoE.png

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓

在这里插入图片描述

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

😝有需要的小伙伴,可以Vx扫描下方二维码免费领取==🆓

在这里插入图片描述

【人工智能】MOE架构的详细解析 MOE(Mixture of Experts,混合专家)架构是一种用于提高深度学习模型性能和效率的神经网络架构设计。以下是对MOE架构的详细解析: 阅读详情

相关推荐

大模型-moe混合专家模型

九、专家的数量对预训练有何影响?六、为什么门控网络要引入噪声呢。十二、MoE和稠密模型的对比。十一、MoE模型的主要特点。四、介绍稀疏 MoE 层。七、如何均衡专家间的负载。五、介绍门控网络或路由。十、什么是topK门控。十五、微调MoE的方法。十六、MoE的并行计算。二、MoE出现的背景。三、有哪些MoE模型。

weixin_44885180的博客 1085

【有啥问啥】大模型中的MoE是什么?

MoE通过将任务分配给多个专家模型并引入门控机制,有效地减少了计算复杂度,提高了模型的效率和性能。不同类型的MoE模型可以根据具体的应用场景进行选择和调整。通过合理设计和使用MoE,能够显著提升深度学习模型的训练和推理效率。

Chauvin的博客 5893

MoE(混合专家模型)

与稠密模型相比,预训练速度更快;与具有相同参数数量的模型相比,具有更快的推理速度;模型规模是提升模型性能的关键因素之一。在有限的计算资源预算下,用更少的训练步数训练一个更大的模型,往往比用更多的步数训练一个较小的模型效果更佳。混合专家模型 (MoE) 的一个显著优势是它们能够在远少于稠密模型所需的计算资源下进行有效的预训练。这意味着在相同的计算预算条件下,您可以显著扩大模型或数据集的规模。特别是在预训练阶段,与稠密模型相比,混合专家模型通常能够更快地达到相同的质量水平。稀疏 MoE 层。

技术引领业务创新 881

万字长文!小白也能懂的混合专家模型(MoE)深度解析

混合专家模型(Mixture of Experts,MoE)是一种先进的神经网络架构,旨在通过整合多个模型或“专家”的预测来提升整体模型性能。MoE模型的核心思想是将输入数据分配给不同的专家子模型,然后将所有子模型的输出进行合并,以生成最终结果。这种分配可以根据输入数据的特征进行动态调整,确保每个专家处理其最擅长的数据类型或任务方面,从而实现更高效、准确的预测。专家(Experts):模型中的每个专家都是一个独立的神经网络,专门处理输入数据的特定子集或特定任务。

2401_85375298的博客 3139

混合专家模型MoE及拓展

摘要:混合专家模型(MoE)通过引入多个子模型(专家)提升大型语言模型性能,其核心由专家网络和路由器组成。稀疏MoE仅激活部分专家以降低计算成本,而稠密MoE则使用所有专家。路由器通过门控网络分配token给最适合的专家,并通过负载均衡和辅助损失确保专家利用率均衡。SwitchTransformer采用Top-1路由策略简化架构,引入专家容量因子和辅助损失优化训练稳定性。MoE在减少推理计算量的同时需要更大显存加载所有专家参数。

皮皮blog 6041

大模型建模基础:混合专家模型MoE体系结构

大模型建模基础:混合专家模型MoE体系结构

天涯雨的博客 1646

GLM5-W4A8架构揭秘:MoE混合专家模型的W4A8量化实现原理

GLM5-W4A8作为Ascend-SACT项目的重要组成部分,是一款采用MoE(混合专家)架构并结合W4A8量化技术的高效能AI模型。本文将深入剖析其核心架构设计与量化实现原理,为初学者揭开模型高性能运行的神秘面纱。 ## 一、MoE混合专家架构:模型性能的倍增器 🚀 MoE(Mixture of Experts)混合专家架构是GLM5-W4A8的核心设计理念。该架构通过将模型参数分散到多

gitblog_00969的博客 340

混合专家模型(MoE)/KV-cache

主要介绍(MoE)、KV cache并且结合代码进行解释。

个人Blog 1174

混合专家模型MoE的全面详解

混合专家模型MoE是一种能让大型语言模型(LLM)质量变好的技术。专家——现在每个前馈神经网络(FFNN)层都有好多个“专家”,每次可以用其中一部分。“专家”一般也是前馈神经网络。门控网络——它能决定把哪些tokens送到哪些专家那儿。在带混合专家模型MoE的大型语言模型的每一层,都能看到这些有点专门作用的专家:要知道,这里的‘专家’可不是像‘心理学’‘生物学’这种特定领域的专家哦。最多就是学学词语层面的语法信息:说得更细点儿,它们擅长处理特定情境下的特定词。

qq_32907491的博客 5223

混合专家(MoE)模型

当数据流通过MoE层时,每个输入令牌会动态地路由到一部分专家进行计算,这样可以实现更加高效的计算,并且随着每个专家在特定任务上的专业化,可以获得更好的结果。在MoE模型中,每个专家模型可以专注于解决特定的子问题,而整体模型则能够在复杂的任务中获得更好的性能。门控网络(gating network)在混合专家模型中起到了决策的作用,它负责学习在特定输入条件下如何调配不同专家的权重,以便有效整合这些专家的知识来作出最终的预测或决策。随着硬件技术的不断进步和人工智能领域的发展,混合专家方法有望迎来更广泛的应用。

数字人生 2933

QST QMC5883L —— 经典磁传感器的生存指南与替代预案

本文聚焦于QST旗下经典三轴磁力计 QMC5883L,解析其技术渊源、核心特性及当前面临的停产风险。结合真实应用场景提供续命方案与选型建议,为依赖该芯片的开发团队争取过渡时间窗口期。文章包含实测数据对比、生命周期管理策略及潜在替代方案拆解。存续价值判断✔️ 现有产品设计无需大幅改动即可延续生命;❌ 新项目采用将面临更高的维护成本;⚠️ 建议在6个月内完成技术路线切换。#磁传感器 #嵌入式开发 #供应链管理 #QST #QMC5883L。

2501_93066786的博客 993

使用PyTorch实现混合专家(MoE)模型

我们测试的输出结果显示了混合专家模型的强大功能。该模型通过门控网络将各个专家模型的优势结合起来,取得了比单个专家模型更高的精度。门控网络有效地学习了如何根据输入数据权衡每个专家的贡献,以产生更准确的预测。混合专家利用了各个模型的不同专业知识,在测试数据集上提供了更好的性能。同时也说明我们可以在现有的任务上尝试使用MOE来进行测试,也可以得到更好的结果。作者:Shahriar Hossain。

deephub 9957

实测对比:DECIMER、Img2Mol、MolScribe,哪个化学结构识别工具更靠谱?

化学结构识别(CSR)工具的核心任务是将分子结构图像转换为SMILES(Simplified Molecular Input Line Entry System)表示。这一过程需要克服图像质量差异、绘制风格变化以及特殊基团识别等挑战。三款工具采用不同的技术路线:DECIMER:基于EfficientNetV2+Transformer架构,优势在于处理标准期刊文献中的分子图示Img2Mol。

weixin_32576389的博客 331

混合专家模型 (MoE)

随着 Mixtral 8x7B (announcement, model card) 的推出,一种称为混合专家模型 (Mixed Expert Models,简称 MoEs) 的 Transformer 模型在开源人工智能社区引起了广泛关注。在本篇博文中,我们将深入探讨 MoEs 的核心组件、训练方法,以及在推理过程中需要考量的各种因素。混合专家模型 (MoEs):为了实现大模型的高效训练和推理,有的是从模型底层下手,比如直接改变底层模型架构,将原来的Transformer架构改成近期新出的基于状态空间模型

qq_32907491的博客 2578

阿里云搭建vps服务器的过程

最近突发奇想想要搭建一个阿里云的的vps服务器,下面是搭建的过程: 首先,登录阿里云网站: 搜索,esc控制台: 点击创建实例: 选择地区: 选择实例规格: 选择镜像: 将存储规格改成100G(40G可能不够用) 点击下一步: 这里面不需要更改,点击下一步 设置连接密码即可 创建成功后点击启动 点击远程连接,然后立即登录,在弹出的框里面输入之前设置的密码即可 登录成功:

zhanchulan的博客 3356

Kaamel白皮书:IoT设备安全隐私评估实践

明确评估的目的和预期结果。

kaamelai的博客 1309

MoE(混合专家)模型

MoE模型的本质,是一种分布式的模型架构设计思想,核心是将传统“单一大模型”拆解为两个核心部分:多个“专家模型”(Expert)和一个“门控网络”(Gating Network),通过“分工协作”实现高效计算。与传统稠密模型的核心区别:传统稠密模型在处理输入时,所有参数会被“全量激活”——无论输入是简单的句子生成,还是复杂的逻辑推理,模型的每一层、每一个神经元都会参与计算,导致算力浪费。

weixin_43156294的博客 3085

[Python从零到壹] 十四.机器学习之分类算法五万字总结全网首发(决策树、KNN、SVM、分类对比实验)

分类(Classification)属于有监督学习(Supervised Learning)中的一类,它是数据挖掘、机器学习和数据科学中一个重要的研究领域。分类模型类似于人类学习的方式,通过对历史数据或训练集的学习得到一个目标函数,再用该目标函数预测新数据集的未知属性。本章主要讲述分类算法基础概念,并结合决策树、KNN、SVM分类算法案例分析各类数据集,从而让读者学会使用Python分类算法分析自己的数据集,研究自己领域的知识,从而创造价值。 19.1 分类 19.1.1 分类模型 与前面讲述的聚类模型类似

杨秀璋的专栏 2万+

一文看懂混合专家模型 (MoE) 到底是什么?

混合专家(Mixture of Experts,简称 MoE)模型,是一种利用多个不同的子模型(或“专家”)来提升大语言模型(LLM)质量的技术。MoE 架构主要由两个核心组件构成:1.专家模块:每个前馈神经网络(FFNN)层包含一组“专家”,每次可从中选择一个子集。这些“专家”本身通常是 FFNN。2.路由或者网关网络,决定将哪些标记(token)分配给哪些专家。在采用 MoE 架构的大语言模型的每一层中,我们会发现这些专家模块往往具有这样的特点:

weixin_72959097的博客 7241

rk3576 点亮 LCD(eDP)

RK3576 处理器集成了对 **eDP (Embedded DisplayPort)** 接口的支持,主要用于驱动嵌入式或笔记本电脑的内置屏幕。支持 **eDP 1.3 版本协议**, 最大可支持 ****4K@120Hz**。

weixin_35723192的博客 341

基于Python实现身份证信息识别

身份证是一种重要的证件,包含了个人的基本信息,如姓名、性别、出生日期、住址等。在实际应用中,有时需要对身份证进行自动化的识别,以提高工作效率和准确性。本文将介绍如何使用Python实现身份证信息的识别,通过图像预处理、OCR技术和解析算法,实现对身份证号码和其他信息的提取和解析。

商务合作 / 项目定制 / 学习交流。个人vx:lovely_wml 1万+

混合专家模型(MoE)详解

混合专家模型(MoE)详解

诸神缄默不语的博客 3281

《网络安全自学教程》- SQL注入之报错注入原理+步骤+实战操作

这篇文章为大家解析报错注入的实现原理,结合实战案例讲解报错注入的使用步骤。

wangyuxiang946的博客 1万+

混合专家模型(MoE)的前世今生

​ 在文章《聊聊最近很火的混合专家模型(MoE)》中,我们简单介绍了MoE模型的定义和设计,并且比较了MoE和Dense模型的区别,今天我们继续来回顾一下MoE模型发展的历史和最新的发展现状。

产品老A,8年互联网大厂AIPM,专注探索新型人机交互 4301

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

混合专家模型 (MoE) 到底是什么?看完这篇,你也能讲明白!

如果你还不知道什么是 MoE ,那就码住今天的文章吧!我们将图解 MoE,用 50 张图细致地探索这一重要组件——混合专家模型(MoE)。

2301_81940605的博客 3128

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

混合专家模型(MoE)入门

模型规模是提升LLM大语言模型性能的关键因素,但也会增加计算成本。Mixture of Experts (MoE) 架构通过分布式专家层和动态门控机制,有效降低了计算资源,使模型能够在扩展参数规模的同时保持高效的运行。

weixin_44858814的博客 5499

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

上一篇: LLM 大模型框架 LangChain 可观测性最佳实践
下一篇: 自定义 open3d可视化
大语言模型
博客等级 码龄3年 1万+粉丝 1971原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值