Java最全【114期】ElasticSearch 搜索引擎常见面试题总结,mysql索引面试题

ElasticSearch常见面试题汇总 Elasticsearch 是基于 Lucene 的 Restful 的分布式实时全文搜索引擎,每个字段都被索引并可被搜索,可以快速存储、搜索、分析海量的数据。全文检索是指对每一个词建立一个索引,指明该词在文章中出现的次数和位置。当查询时,根据事先建立的索引进行查找,并将查找的结果反馈给用户的检索方式。这个过程类似于通过字典中的检索字表查字的过程。**(1)index 索引:**索引类似于mysql 中的数据库,Elasticesearch 中的索引是存在数据的地方,包含了一堆有相似结构的文档数据。**(2 阅读详情

最后

金三银四马上就到了,希望大家能好好学习一下这些技术点

学习视频:
大厂面试真题:
本文已被CODING开源项目:【一线大厂Java面试题解析+核心总结学习笔记+最新讲解视频+实战项目源码】收录

需要这份系统化的资料的朋友,可以点击这里获取

  • 倒排索引中的词项 根据字典顺序升序排列

4、DocValues的作用:

倒排索引也是有缺陷的,假如我们需要对数据做一些聚合操作,比如排序/分组时,lucene内部会遍历提取所有出现在文档集合的排序字段,然后再次构建一个最终的排好序的文档集合list,这个步骤的过程全部维持在内存中操作,而且如果排序数据量巨大的话,非常容易就造成solr内存溢出和性能缓慢。

DocValues 就是 es 在构建倒排索引的同时,构建了正排索引,保存了docId到各个字段值的映射,可以看作是以文档为维度,从而实现根据指定字段进行排序和聚合的功能。

另外doc Values 保存在操作系统的磁盘中,当docValues大于节点的可用内存,ES可以从操作系统页缓存中加载或弹出,从而避免发生内存溢出的异常,docValues远小于节点的可用内存,操作系统自然将所有Doc Values存于内存中(堆外内存),有助于快速访问。

5、text 和 keyword类型的区别:

两个的区别主要分词的区别:keyword 类型是不会分词的,直接根据字符串内容建立倒排索引,keyword类型的字段只能通过精确值搜索到;Text 类型在存入 Elasticsearch 的时候,会先分词,然后根据分词后的内容建立倒排索引

6、什么是停顿词过滤:

停顿词可以看成是没有意义的词,比如“的”、“而”,这类词没有必要建立索引

7、query 和 filter 的区别?

(1)query: 查询操作不仅仅会进行查询,还会计算分值,用于确定相关度;

(2)filter: 查询操作仅判断是否满足查询条件,不会计算任何分值,也不会关心返回的排序问题,同时,filter 查询的结果可以被缓存,提高性能。更多关于ES面试题,公众号Java精选,回复Java面试,获取最新最全的ES面试题,支持在线随时随地刷题。

二、ES的写入流程:

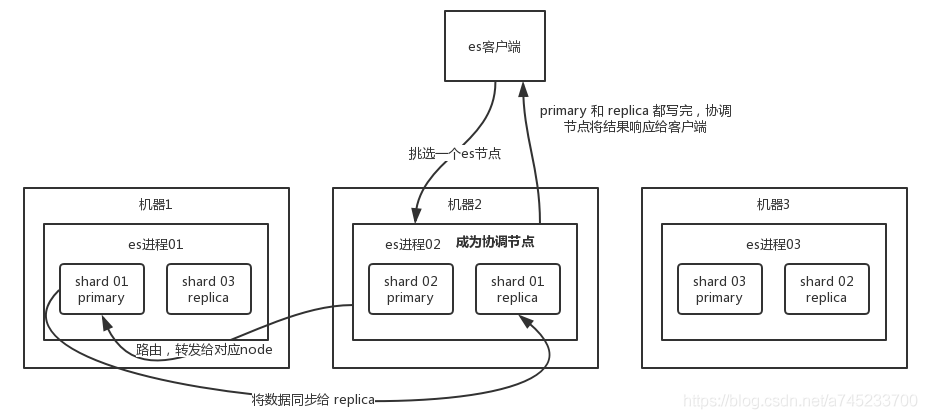
1、es 写数据的过程:
c307f3d28834da47c8ec1363f43ab76a.png

图片

(1)客户端选择一个 node 发送请求过去,这个 node 就是 coordinating node (协调节点)

(2)coordinating node 对 document 进行路由,将请求转发给对应的 node(有 primary shard)

(3)实际的 node 上的 primary shard 处理请求,然后将数据同步到 replica node

(4)coordinating node 等到 primary node 和所有 replica node 都执行成功之后,就返回响应结果给客户端。

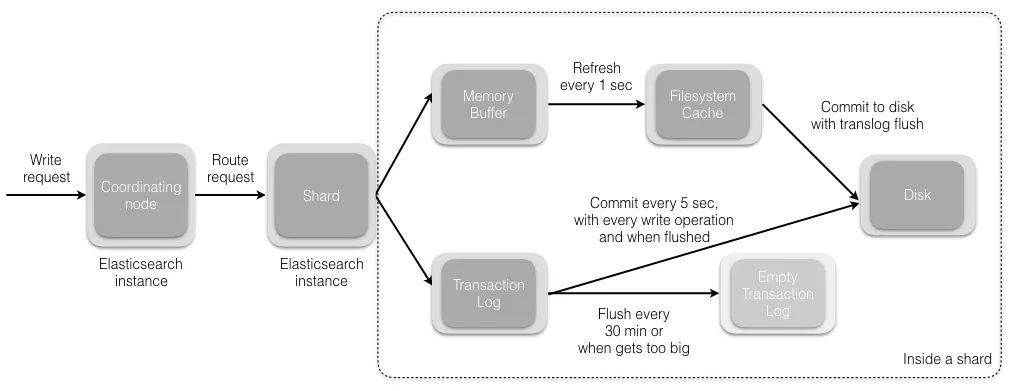
2、写数据的底层原理:
12a6ed69c4548b35e2de7577fb5991e5.png

图片

(1)数据先写入 memory buffer,然后定时(默认每隔1s)将 memory buffer 中的数据写入一个新的 segment 文件中,并进入 Filesystem cache(同时清空 memory buffer),这个过程就叫做 refresh;

ES 的近实时性:数据存在 memory buffer 时是搜索不到的,只有数据被 refresh 到  Filesystem cache 之后才能被搜索到,而 refresh 是每秒一次, 所以称 es 是近实时的,可以通过手动调用 es 的 api 触发一次 refresh 操作,让数据马上可以被搜索到;

(2)由于 memory Buffer 和 Filesystem Cache 都是基于内存,假设服务器宕机,那么数据就会丢失,所以 ES 通过 translog 日志文件来保证数据的可靠性,在数据写入 memory buffer 的同时,将数据写入 translog 日志文件中,在机器宕机重启时,es 会自动读取 translog 日志文件中的数据,恢复到 memory buffer 和 Filesystem cache 中去。

ES 数据丢失的问题:translog 也是先写入 Filesystem cache,然后默认每隔 5 秒刷一次到磁盘中,所以默认情况下,可能有 5 秒的数据会仅仅停留在 memory buffer 或者 translog 文件的 Filesystem cache中,而不在磁盘上,如果此时机器宕机,会丢失 5 秒钟的数据。也可以将 translog 设置成每次写操作必须是直接 fsync 到磁盘,但是性能会差很多。

(3)flush 操作:不断重复上面的步骤,translog 会变得越来越大,当 translog 文件默认每30分钟或者 阈值超过 512M 时,就会触发 commit 操作,即 flush操作。

  • 将 buffer 中的数据 refresh 到 Filesystem Cache 中去,清空 buffer;

  • 创建一个新的 commit point(提交点),同时强行将 Filesystem Cache 中目前所有的数据都 fsync 到磁盘文件中;

  • 删除旧的 translog 日志文件并创建一个新的 translog 日志文件,此时 commit 操作完成。更多关于ES面试题,公众号Java精选,回复Java面试,获取最新最全的ES面试题,支持在线随时随地刷题。

三、ES的更新和删除流程:

删除和更新都是写操作,但是由于 Elasticsearch 中的文档是不可变的,因此不能被删除或者改动以展示其变更;所以 ES 利用 .del 文件 标记文档是否被删除,磁盘上的每个段都有一个相应的.del 文件

(1)如果是删除操作,文档其实并没有真的被删除,而是在 .del 文件中被标记为 deleted 状态。该文档依然能匹配查询,但是会在结果中被过滤掉。

(2)如果是更新操作,就是将旧的 doc 标识为 deleted 状态,然后创建一个新的 doc。

memory buffer 每 refresh 一次,就会产生一个 segment 文件 ,所以默认情况下是 1s 生成一个 segment 文件,这样下来 segment 文件会越来越多,此时会定期执行 merge。

每次 merge 的时候,会将多个 segment 文件合并成一个,同时这里会将标识为 deleted 的 doc 给物理删除掉,不写入到新的 segment 中,然后将新的 segment 文件写入磁盘,这里会写一个 commit point ,标识所有新的 segment 文件,然后打开 segment 文件供搜索使用,同时删除旧的 segment 文件

四、ES的搜索流程:

搜索被执行成一个两阶段过程,即 Query Then Fetch:

1、Query阶段:

客户端发送请求到 coordinate node,协调节点将搜索请求广播到所有的 primary shard 或 replica shard。每个分片在本地执行搜索并构建一个匹配文档的大小为 from + size 的优先队列。每个分片返回各自优先队列中 所有文档的 ID 和排序值 给协调节点,由协调节点及逆行数据的合并、排序、分页等操作,产出最终结果。

2、Fetch阶段:

协调节点根据 doc id 去各个节点上查询实际的 document 数据,由协调节点返回结果给客户端。

  • coordinate node 对 doc id 进行哈希路由,将请求转发到对应的 node,此时会使用 round-robin 随机轮询算法,在 primary shard 以及其所有 replica 中随机选择一个,让读请求负载均衡。

  • 接收请求的 node 返回 document 给 coordinate node 。

  • coordinate node 返回 document 给客户端。

Query Then Fetch 的搜索类型在文档相关性打分的时候参考的是本分片的数据,这样在文档数量较少的时候可能不够准确,DFS Query Then Fetch 增加了一个预查询的处理,询问 Term 和 Document frequency,这个评分更准确,但是性能会变差。

五、ES在高并发下如何保证读写一致性?

(1)对于更新操作:可以通过版本号使用乐观并发控制,以确保新版本不会被旧版本覆盖

每个文档都有一个_version 版本号,这个版本号在文档被改变时加一。Elasticsearch使用这个 _version 保证所有修改都被正确排序。当一个旧版本出现在新版本之后,它会被简单的忽略。

利用_version的这一优点确保数据不会因为修改冲突而丢失。比如指定文档的version来做更改。如果那个版本号不是现在的,我们的请求就失败了。

(2)对于写操作,一致性级别支持 quorum/one/all,默认为 quorum,即只有当大多数分片可用时才允许写操作。但即使大多数可用,也可能存在因为网络等原因导致写入副本失败,这样该副本被认为故障,分片将会在一个不同的节点上重建。

  • one: 要求我们这个写操作,只要有一个primary shard是active活跃可用的,就可以执行

  • all: 要求我们这个写操作,必须所有的primary shard和replica shard都是活跃的,才可以执行这个写操作

  • quorum: 默认的值,要求所有的shard中,必须是大部分的shard都是活跃的,可用的,才可以执行这个写操作

(3)对于读操作,可以设置 replication 为 sync(默认),这使得操作在主分片和副本分片都完成后才会返回;如果设置replication 为 async 时,也可以通过设置搜索请求参数_preference 为 primary 来查询主分片,确保文档是最新版本。

六、ES如何选举Master节点:

1、Elasticsearch 的分布式原理:

Elasticsearch 会对存储的数据进行切分,将数据划分到不同的分片上,同时每一个分片会保存多个副本,主要是为了保证分布式环境的高可用。在 Elasticsearch 中,节点是对等的,节点间会选取集群的 Master,由 Master 会负责集群状态信息的改变,并同步给其他节点。

Elasticsearch 的性能会不会很低:只有建立索引和类型需要经过 Master,数据的写入有一个简单的 Routing 规则,可以路由到集群中的任意节点,所以数据写入压力是分散在整个集群的。更多关于ES面试题,公众号Java精选,回复Java面试,获取最新最全的ES面试题,支持在线随时随地刷题。

2、Elasticsearch 如何 选举 Master:

Elasticsearch 的选主是 ZenDiscovery 模块负责的,主要包含Ping(节点之间通过这个RPC来发现彼此)和 Unicast(单播模块包含一个主机列表以控制哪些节点需要ping通)这两部分;

  • 确认候选主节点的最少投票通过数量,elasticsearch.yml 设置的值 discovery.zen.minimum_master_nodes;

  • 对所有候选 master 的节点(node.master: true)根据 nodeId 字典排序,每次选举每个节点都把自己所知道节点排一次序,然后选出第一个(第0位)节点,暂且认为它是master节点。

  • 如果对某个节点的投票数达到阈值,并且该节点自己也选举自己,那这个节点就是master。否则重新选举一直到满足上述条件。

补充:master节点的职责主要包括集群、节点和索引的管理,不负责文档级别的管理;data节点可以关闭http功能。

3、Elasticsearch是如何避免脑裂现象:

最后

我还为大家准备了一套体系化的架构师学习资料包以及BAT面试资料,供大家参考及学习

已经将知识体系整理好(源码,笔记,PPT,学习视频)
在这里插入图片描述

在这里插入图片描述

在这里插入图片描述

本文已被CODING开源项目:【一线大厂Java面试题解析+核心总结学习笔记+最新讲解视频+实战项目源码】收录

需要这份系统化的资料的朋友,可以点击这里获取

]

[外链图片转存中…(img-sTUtZPOo-1715329211333)]

[外链图片转存中…(img-RZhSjWBK-1715329211334)]

本文已被CODING开源项目:【一线大厂Java面试题解析+核心总结学习笔记+最新讲解视频+实战项目源码】收录

需要这份系统化的资料的朋友,可以点击这里获取

Elasticsearch+Fluentd+Kibana:数据流操作系统实战指南 Elasticsearch、Fluentd、Kibana(EFK)常被误认为仅用于日志分析,实则构成一套可编程的数据流操作系统——以Fluentd为神经中枢实现协议适配与可靠传输,Elasticsearch为记忆体与处理器支撑毫秒级结构化/半结构化数据检索,Kibana作为交互界面与低代码编译器赋能可视化与运行时计算。其核心价值在于统一处理带时间戳、可结构化、需关联分析的实时数据流,广泛适用于IoT时序监控、金融风控流水、电商用户行为分析等场景。本文深入解析缓冲区模型、倒排索引设计、Dev Tools诊断链 阅读详情

相关推荐

2023最新整理的 Elasticsearch 21道面试题

系统中的数据, 随着业务的发展, 时间的推移, 将会非常多,而业务中往往采用模糊查询进行数据的 搜索,而模糊查询会导致查询引擎放弃索引, 导致系统查询数据时都是全表扫描,在百万级别的数据库中, 查询效率是非常低下的,而我们使用 ES 做一个全文索引, 将经常查询的系统功能的某些字段,比如说电 商系统的商品表中商品名,描述、价格还有 id 这些字段我们放入 ES 索引库里,可以提高查询速度。它的优点是:利用字符串的公共前缀来减少查询时间,最大限度地减少无谓的字符串比较,查询效率比哈希树高。

Java全能学习+面试指南 1万+

ElasticSearch搜索引擎常见面试题总结

一、ElasticSearch基础: 1、什么是ElasticsearchElasticsearch 是基于 Lucene 的 Restful 的分布式实时全文搜索引擎,每个字段都被索引并可被搜索,可以快速存储、搜索、分析海量的数据。 全文检索是指对每一个词建立一个索引,指明该词在文章中出现的次数和位置。当查询时,根据事先建立的索引进行查找,并将查找的结果反馈给用户的检索方式。这个过程类似于通过字典中的检索字表查字的过程。 2、Elasticsearch 的基本概念: (1)index 索

张维鹏的博客 5万+

精选7道Elastic Search面试题

全局映射的方式默认映射继承_default_的配置、动态模板映射: dynamic_templates,使用动。状态监控,包括 jvm 的情况, linux 的情况, elasticsearch 的情况。虽然 lucene 是性能最先进的、功能完善的搜索引擎,但是它只能有一个库,而且使用它需。Es 映射是用于确定字段类型,将新增的每个字段数据类型映射后确定的字段类型,常见的。最佳的数据量不是一个确定的数值,它取决于你的硬件,你的文档大小以及复杂性,你的索。在修改数据的时候指定版本号,操作一次版本号加 1。

s13596191285的博客 2696

ElasticSearch面试

Welcome to Elastic Docs | ElasticES的整体结构? 1)正排就是我记得我电脑有个文档,讲了 ES 的常见问题总结。那么我就找到文档,从上往下翻 页,找到 ES 的部分。通过文档找文档内容。 2)倒排:一个 txt 文件 ES 的常见问题 -> D:/分布式问题总结.doc。 所以倒排就是文档内容找文档。当然内容不是全部的,否则也不需要找文档了,内容就是几个分词 而已。这里的 txt 就是搜索引擎。 通俗解释: 传统的我们的检索是通过文章,逐个遍历找到对应关键词的位置。 而倒

1578

114ElasticSearch 搜索引擎常见面试题总结

点击上方“Java精选”,选择“设为星标”别问别人为什么,多问自己凭什么!下方留言必回,有问必答!每天08:00更新文章,每天进步一点点...一、ElasticSearch基础:1、什...

Java精选 338

采集mysql数据到es_上亿数据怎么玩深度分页?兼容MySQL + ES + MongoDB

推荐学习阿里P8MySQL,基础/索引/锁/日志/调优都不误,一锅深扒端给你“吃”完这本Java性能调优实战,MySQL+JVM+Tomcat等问题一键全消面试题 & 真实经历面试题:在数据量很大的情况下,怎么实现深度分页?大家在面试时,或者准备面试中可能会遇到上述的问题,大多的回答基本上是分库分表建索引,这是一种很标准的正确回答,但现实总是很骨感,所以面试官一般会追问你一句,现在工不足...

weixin_36080939的博客 592

sql只显示前20条数据_上亿数据怎么玩深度分页?兼容MySQL + ES + MongoDB

推荐学习阿里P8MySQL,基础/索引/锁/日志/调优都不误,一锅深扒端给你“吃”完这本Java性能调优实战,MySQL+JVM+Tomcat等问题一键全消面试题 & 真实经历面试题:在数据量很大的情况下,怎么实现深度分页?大家在面试时,或者准备面试中可能会遇到上述的问题,大多的回答基本上是分库分表建索引,这是一种很标准的正确回答,但现实总是很骨感,所以面试官一般会追问你一句,现在工不足...

weixin_39756696的博客 371

千道流!!!整理 Java 面试题资料超 1000 道面试题资料,源码和答案

Java面试前需要做足各方面的准备工作,大家肯定都会浏览大量的面试题过往的面试经验,本人也不例外,通过浏览面试题和以往的面试经历,总结了初级、中级、高级的面试题以及面试技巧和面试经验,供大家学习讨论。 面试题-141-150 【141】JDK8 Stream 操作 collectingAndThen:根据对象的属性去重 【142】List 中 remove() 方法的“陷阱”,被坑惨了! 【143面试官问:说一说 Spring 和 Spring Boot 核心的 3 大区别? 【144

Java精选 837

JAVA各类基础高级面试题和中间件面试题资料,面试考点安排多久出来

互联网大厂比较喜欢的人才特点:对技术有热情,强硬的技术基础实力;主动,善于团队协作,善于总结思考。无论是哪家公司,都很重视高并发高可用技术,重视基础,所以千万别小看任何知识。面试是一个双向选择的过程,不要抱着畏惧的心态去面试,不利于自己的发挥。同时看中的应该不止薪资,还要看你是不是真的喜欢这家公司,是不是能真的得到锻炼。其实我写了这么多,只是我自己的总结,并不一定适用于所有人,相信经过一些面试,大家都会有这些感触。下面有部分截图希望能对大家有所帮助。

2401_84023579的博客 1058

JAVA各类基础高级面试题和中间件面试题资料,2024年最新java关于线程的面试题

ava中级篇—35 个 Java 代码优化的小技巧,你知道几个?]( )

2401_84446882的博客 583

Java面试题mysql数据库查询优化、索引相关

先来看看索引的作用:(摘自:http://blog.csdn.net/qq_33556185/article/details/52192551) (一)索引的作用 索引通俗来讲就相当于书的目录,当我们根据条件查询的时候,没有索引,便需要全表扫描,数据量少还可以,一旦数据量超过百万甚至千万,一条查询sql执行往往需要几十秒甚至更多,5秒以上就已经让人难以忍受了。 提升查询速

zjkC050818的博客 1307

最全、最通俗易懂的Java面试题积累【二】

文章目录101.分布式事务你知道哪些解决方案?102.什么是2pc,基于什么协议,有什么缺点?103.Seata相比传统2PC有什么区别,以及优点?104.Seata的TC,TM,RM的含义,以及作用?105.你知道TCC吗,它的缺点是什么?106.解释一下Seata的工作原理?107.你能简单描述一下你在项目中是如何集成Seata的吗?108.哪些因素可能会造成数据库性能问题?109.Mysql的执行流程是怎么样的?110.优化SQL你采用什么样的优化流程?111.如何去定位慢SQL?112.定位到慢SQ

WLK0423的博客 735

精选Java基础【114~130企业真题】附答案

摘要: 本文涵盖多个技术知识点:(1) Java编程方面,包括Filter接口实现、MVC设计模式(Model 2优于Model 1)、构造函数特点、多线程同步操作等;(2) Linux系统命令,如mount挂载文件系统、ls/cat/mv/rm等基础命令;(3) Oracle数据库操作,涉及游标更新(FOR UPDATE子句)和同义词创建;(4) 异常处理机制中throw与throws的区别;(5) JDBC数据库连接示例代码;(6) 抽象类与接口的应用场景对比。最后列举了Linux常见系统日志如/var

2501_93507003的博客 633

java初级程序员面试题_初级Java程序员面试题(146道企业真题)_Java技术面试题-java面试题 -动力节点...

初级Java程序员面试题(114~130企业真题)114、编写一个Filter,需要(B)A. 继承 Filter 类B. 实现 Filter 接口C. 继承 HttpFilter 类D. 实现 HttpFilter 接口115、有关MVC设计模式(B)描述不正确A. 使用 Servlet 作为控制器B. MVC 设计模式增大了维护难度C. MVC 设计模式属于 Model 2D. 模型对象向客户...

weixin_36076907的博客 307

java面试题

各大互联网公司java开发面试常问问题  本人是做java开发的,这是我参加58,搜狐,搜狗,新浪微博,百度,腾讯文学,网易以及其他一些小的创业型公司的面试常被问的问题,当然有重复,弄清楚这些,相信面试会轻松许多。 1. junit用法,before,beforeClass,after, afterClass的执行顺序 2. 分布式锁 3. nginx的请求转

qq_35124535的博客 615

Java工具书

系列文章目录 文章目录系列文章目录前言一丶基础(一)语法基础1.编程基础语法(通用)2.面向对象(1)方法(2)重载(3)封装(4)继承(5)多态3.抽象类4.接口5. 枚举6.注解7.异常处理8.多线程9.IO流10.反射(二)集合1.Collection(1)Collection2.List(1)Lista.概述和特点b.常用api介绍c.遍历(常用)(2)ArrayList(3)Linklist3.Set(1) Seta.概述和特点b.常用api介绍c.遍历(常用)(2)TreeSet(3)HashS

s_0111的博客 3497

MySQL问答200

本文涵盖MySQL全栈面试核心内容,包括:基础概念(关系型数据库特性、体系结构);存储引擎对比(InnoDB/MyISAM);索引原B+树、聚簇索引)与优化策略;事务ACID与隔离级别实现;锁机制(行锁、间隙锁)与MVCC原理;日志系统(redo/undo/binlog);SQL优化与执行计划分析;高可用方案(主从复制、分库分表);InnoDB底层机制(Buffer Pool、Checkpoint);以及MySQL 8.0新特性。

weixin_72753562的博客 806
上一篇: Java最全【097期】面试必问系列:50 道经典 Spring 面试题!,2024Java常见面试题
下一篇: Java最全【158期】Spring Boot + Redis 分布式锁:模拟 10万人的秒杀抢单,Java进阶学习资料
2301_82257317
博客等级 码龄3年 4074粉丝 411原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值