从Prompt到Context Engineering:揭秘大模型稳定输出的底层逻辑!

Context Engineering:让AI稳定可控的上下文工程实战指南 上下文工程(Context Engineering)是大模型落地中保障响应稳定性与业务合规性的核心方法论,它超越传统Prompt Engineering,通过空间、角色、时间三维约束,将模糊指令转化为结构化、可验证、有时效的执行边界。其技术价值在于显著降低幻觉率、提升领域任务准确率,并支撑客服、合规、医疗等高风险场景的可信AI应用。本文结合Schema设计、动态注入、多级校验与生命周期管理四大构件,提供从知识库问答切入的可运行工作流,覆盖金融、电商、医疗等真实业务中的上下文约束实践,助力产品、运营、法务等非 阅读详情

你写了一个很棒的 Prompt,测试时效果不错,上线后问题一大堆。输出忽好忽坏,用户的上下文记不住,遇到稍微复杂点的任务就开始一本正经地胡说八道。

你开始怀疑是 Prompt 没写好,反复调整措辞,但越改越没底气。

其实问题可能根本不出在 Prompt 上。

过去两年,围绕大模型的开发方式发生了一次悄无声息的迁移。表面上看,大家还在讨论"怎么写好提示词",但实际上,AI 应用开发的核心关注点已经从 Prompt Engineering(提示词工程)转向了一个更底层的问题:Context Engineering(上下文工程)。

这不是换个名词炫技,而是真正理解了问题的边界在哪里。这篇文章,我们从头说清楚这件事。


一、Prompt Engineering 解决了什么,又解决不了什么

先说清楚 Prompt Engineering 确实很有价值。在早期,能把提示词写好的人,产品效果就是比别人好一截。

Prompt Engineering 的核心技巧大概就那几件事:清晰表达任务、设定角色、约束输出格式、提供 Few-shot 示例。说白了,就是"怎么把问题问清楚"。

但它有一个隐藏的前提假设,而这个假设在真实产品里几乎从不成立:

  • 任务足够简单,一条消息就能说完
  • 上下文是固定的,不需要动态变化
  • 只有一轮交互,不需要记住任何东西

现实是什么?用户在对话,有历史;任务在推进,有状态;数据在变化,需要实时获取;工具在调用,结果要整合回来。

这时候,再漂亮的提示词也没用,因为问题已经不是"怎么问",而是**“给模型看什么”**。

Prompt Engineering 不是错的,只是它解决的问题,不是你以为的那个问题。


二、Context Engineering:从"问对问题"到"喂对信息"

理解 Context Engineering,要先理解一个基本事实:大语言模型本质上是一个函数。你输入什么,它就基于那些输入来生成输出。它的"智能",在某种意义上是对输入信息的高度压缩和重组。

这意味着,模型能力的上限,取决于它在推理时刻能看到什么。再强的模型,看到的信息残缺不全,输出也会一塌糊涂。

Context Engineering 就是在解决这件事:精准管理模型在每个时刻的上下文窗口里装了什么。

一个模型的 Context Window 里,可能包含这些东西:系统规则和角色设定、用户的历史对话、实时查询到的业务数据、调用工具后返回的结果、从知识库里检索出来的相关片段、对过往记忆的摘要……

怎么组织这些信息、放什么不放什么、放多少、按什么顺序放——这就是 Context Engineering 要干的事。

如果说 Prompt Engineering 是在教你"怎么开口说话",那 Context Engineering 是在解决"让模型拿着什么去干活"。维度完全不同。


三、Token 的残酷现实:上下文不是越多越好

很多人刚接触 Context Engineering 时,第一反应是:“那我把所有信息都塞进去不就完了?”

这是个非常合理的直觉,也是个非常危险的想法。

首先,Token 是钱。每一个字符、每一段文本被送入模型,都要消耗计算资源,直接对应 API 费用。上下文越长,成本越高,响应越慢。

其次,更致命的问题是:模型的注意力是有限的。研究早就发现,当上下文特别长时,模型对中间部分的信息会出现"注意力稀释"。你把一千条历史对话全塞进去,模型不仅不会更聪明,反而可能被无关信息带偏。

Context Engineering 真正的挑战,是在有限的窗口里,装最有价值的信息。这需要:

  • 相关性排序:最相关的信息优先放入
  • 主动压缩:把长文本摘要后再送入
  • 动态召回:不是一次性加载,而是按需取用
  • 信息剔除:过时的、无关的,主动从上下文里移除

做好这件事,比写一条好 Prompt 难多了,也有价值多了。


四、System Prompt 与 Prompt Template:把经验固化成工程

说到具体工程实践,有两个概念值得展开:System Prompt 和 Prompt Template。

很多团队在早期阶段,Prompt 写在哪儿、谁在改、改完有没有测,完全是一团浆糊。某个工程师调好了一个效果不错的提示词,就硬编码在代码里,换人之后就成了黑盒。

System Prompt 解决的是"规则层"的问题。把产品的角色定义、行为边界、输出规范、安全约束,沉淀到 System Prompt 里,这就是 AI 应用的"出厂设置"。它不随用户输入变化,是稳定的产品基线。

Prompt Template 解决的是"任务层"的问题。高频任务的结构模板化,把动态变量用占位符替代,每次调用时填入实际数据。这让输出稳定可复现,也让团队协作成为可能。

这两者的本质,是把原本藏在"个人脑子里的技巧"变成"团队可以维护的资产"。这才叫工程,而不叫玄学。


五、Memory:从每次都是第一次,到真正认识你

如果你用过一些 AI 产品,肯定遇到过这种体验:你昨天告诉它你是一名产品经理,今天再来,它又开始用"假设你是一名技术专家"的方式跟你说话。

这不是模型变蠢了。这是因为它没有记忆。每一次对话,对它来说都是全新的开始。

解决这个问题,就是 Memory 层要做的事。从 Context Engineering 的角度看,Memory 本质上是在解决"跨会话的上下文持久化"——把需要长期保留的信息,存储在上下文窗口之外,在需要时动态注入。

Memory 大致分三个层次:

  • 用户偏好:沟通风格、专业背景、常用格式偏好
  • 历史任务:上次做了什么、做到哪一步、有哪些遗留问题
  • 企业知识:产品文档、内部规范、行业特定知识库

这三者结合,才能从"每次都是陌生人"变成"越用越懂你"。这才是真正个性化体验的底层逻辑,也是很多 To B 的 AI 应用里最有壁垒的部分之一。

没有记忆的 AI,再聪明也只是个失忆症患者。Memory,是 AI 应用从工具变成伙伴的关键一步。


六、Tool 与 Function Calling:给模型装上"手"

模型有个先天的局限:它只知道训练截止日期之前的事情,它不知道你们公司今天的销售数据,它也没办法帮你真的发出一封邮件。

Tool 调用就是为了突破这个边界。让模型能查询实时数据、读写数据库、执行代码、调用第三方 API。

而 Function Calling,是目前主流大模型实现工具调用的标准机制。你告诉模型"你有这些工具,每个工具的参数是这样的",模型在需要时会输出一个结构化的调用请求,你的程序捕获这个请求、执行工具、把结果返回给模型,模型再基于结果继续生成。

从 Context Engineering 的角度理解,工具的调用结果,是一种特殊的上下文注入。模型自己无法直接感知外部世界,但工具执行的结果可以通过上下文窗口传递给它。这是"信息管理"延伸到"能力扩展"的关键一步。


七、Agent 与 Workflow:让上下文驱动真实世界的行动

说到这里,我们来聊最复杂也最有想象力的部分。

把上面这些东西组合起来——System Prompt、Memory、Tool Calling、动态上下文管理——你就有了构建 Agent 的基础。

但实际落地时,你会发现有两种截然不同的设计哲学:

Workflow(工作流):确定性的。流程提前定义好,每一步做什么都是明确的,适合标准化、高频、对准确性要求极高的任务。可审计、可回滚、出了问题知道查哪里。

Agent(智能体):动态的。没有预设的固定流程,模型根据上下文和工具反馈自主决策下一步。适合开放性强、需要灵活处理意外情况的任务。

实际上,生产环境里的 AI 应用几乎从来不会是纯粹的某一种。最好用的方案,往往是 Workflow 托底 + Agent 在关键节点决策。确定性流程保证稳定性,动态决策处理例外情况。

Context 在这个架构里是"中枢神经"。它既是 Agent 感知当前状态的来源,也记录着每一步行动的结果。Agent 的每次决策,本质上是对当前上下文的一次推理。


八、MCP:当 Context Engineering 开始标准化

最后说一个正在发生的趋势:MCP(Model Context Protocol)。

当你开始做上面这些事情,接入工具、管理记忆、动态注入数据,你会遇到一个让人头大的问题:每一个工具、每一个数据源的接入方式都不一样。接 Slack 是一套 API,接数据库是另一套,接文件系统又是另一套。每接一个新工具,都要重新写一堆胶水代码。

MCP 试图解决的,就是这个碎片化问题。它是由 Anthropic 提出的一个开放协议,目标是为 AI 应用和外部工具、资源之间的交互,建立一套统一的标准接口。

你可以把它理解为:MCP 之于 AI 应用生态,就像 HTTP 之于 Web。不是要替代具体的工具或服务,而是提供一个所有人都能遵循的通信标准,让整个生态的互操作性变得更好。

对开发者来说,这意味着:标准化的工具插件、可复用的上下文供给模块、更低的集成复杂度。对整个行业来说,这是 Context Engineering 从"各自摸索"走向"基础设施化"的重要信号。


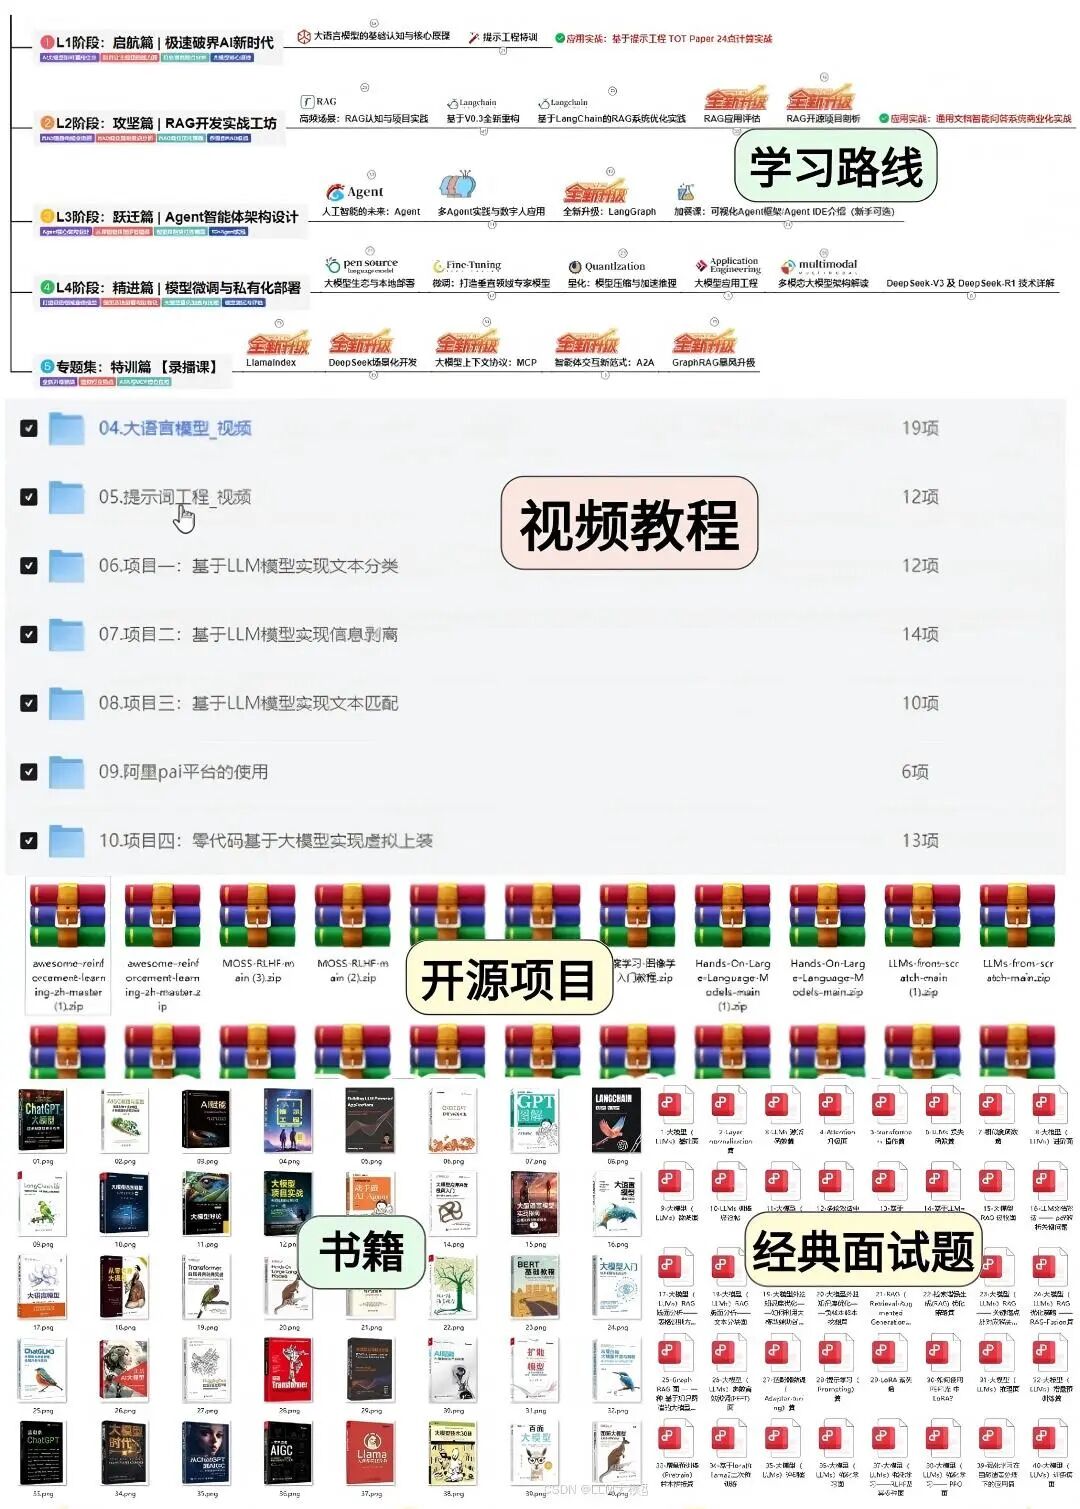
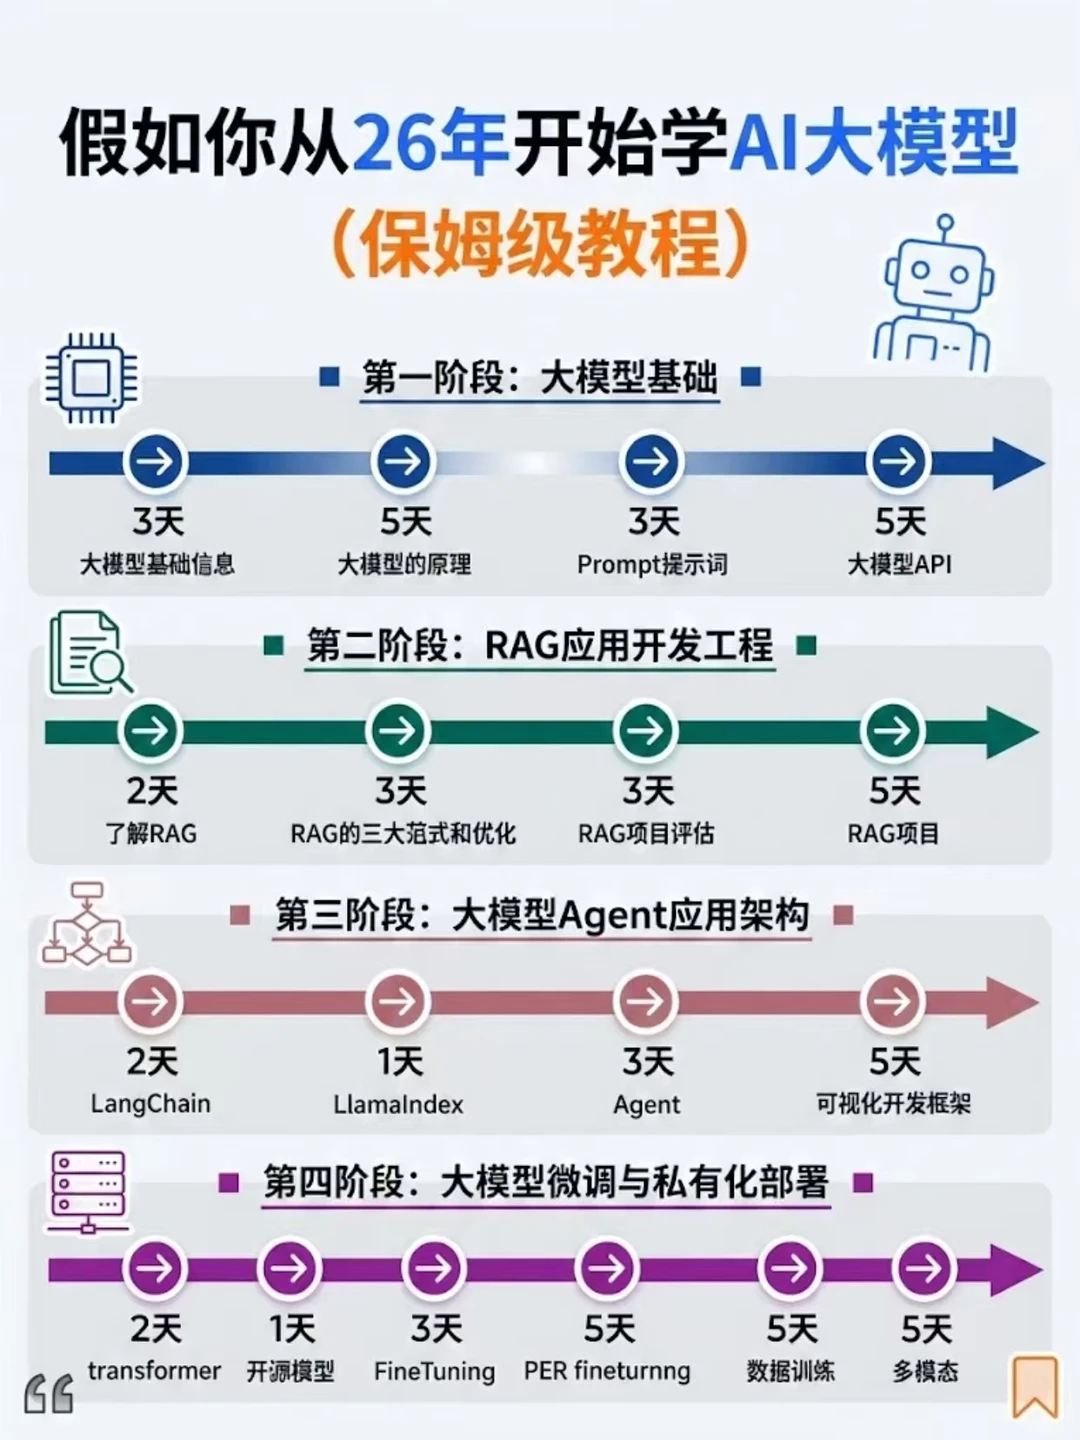
假如你从2026年开始学大模型,按这个步骤走准能稳步进阶。

接下来告诉你一条最快的邪修路线,

3个月即可成为模型大师,薪资直接起飞。
img

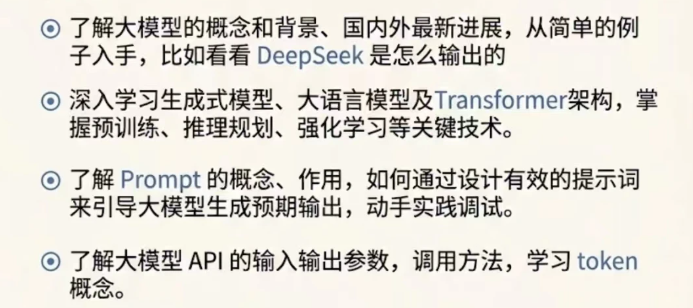
阶段1:大模型基础

img

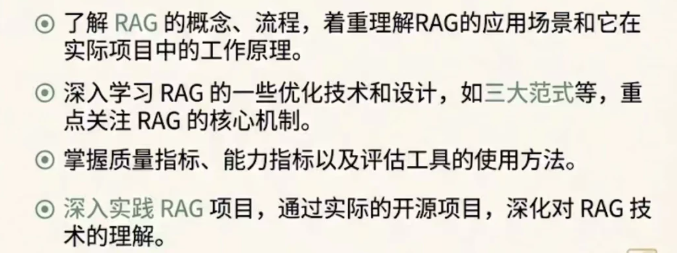
阶段2:RAG应用开发工程

img

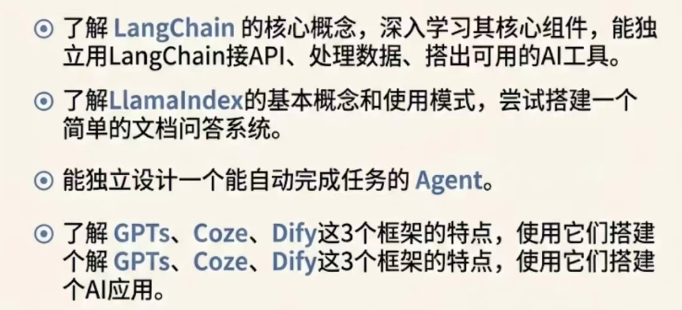
阶段3:大模型Agent应用架构

img

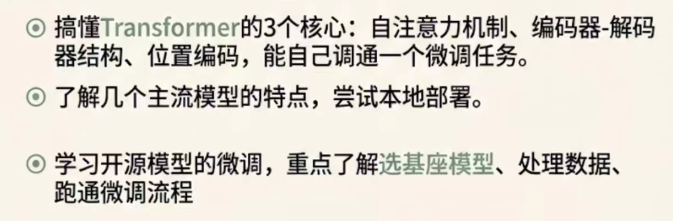
阶段4:大模型微调与私有化部署

img

配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇
在这里插入图片描述
img

img

img

img
img

配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇
在这里插入图片描述

Prompt Engineering与Context Engineering:AI后端开发核心概念解析与实战 在构建基于大语言模型的AI应用时,提示工程(Prompt Engineering)与上下文工程(Context Engineering)是两项至关重要的核心技术。提示工程聚焦于如何设计单次输入的文本指令,以精确引导模型生成预期输出,其本质是与AI高效沟通的“编程语言”。上下文工程则关注如何管理与组织多轮交互中的全部信息环境,包括对话历史、外部知识检索与整合,以支撑模型进行持续、连贯的复杂推理。这两项技术共同构成了现代AI后端系统的核心价值,是实现高效、稳定、可控的智能应用(如智能客服、知识问答系统)的基石。 阅读详情

相关推荐

Python开发者必看:5分钟搞定Gemini API的3种调用方式(含代码示例)

本文为Python开发者详细介绍了三种高效调用Gemini API的核心方式:基础同步调用、流式调用和聊天模式,并涵盖多模态应用等高级特性。通过清晰的代码示例和实战场景分析,帮助开发者快速掌握Gemini API的集成与优化,提升AI应用开发效率。

g8f9d0s1a2的博客 1113

【必收藏】大模型开发新范式:从Prompt Engineering到Context Engineering的全面指南

一方面,专注于构建可扩展系统的前沿实践者们(如 Andrej Karpathy 等),积极倡导用 “Context Engineering” 来描述工作,认为 “Prompt Engineering” 这个词不足以涵盖复杂性,认为它只是 “Coming up with a laughably pretentious name for typing in the chat box(给在聊天框里打字起的一个可笑的自命不凡的名字)”。指的是 LLM 动态地指导自己的流程和工具使用,自主控制如何完成任务的系统。

xxx2422971714的博客 2079

高效数据迁移:ICCAP到ADS的数据导入与导出实战指南

本文提供了从ICCAP到ADS进行高效、准确数据迁移的实战指南。针对射频与微波电路设计中的关键挑战,详细阐述了迁移前的战略规划、ICCAP数据的精细化导出(包括脚本化批处理)、ADS数据的多种导入方法(如Data Items、DML模型库及编程化API),并强调了数据完整性与准确性验证的重要性,确保模型参数和仿真结果在平台间可靠传递。

weixin_29291185的博客 126

Context Engineering实战:如何通过Prompt Engineering提升开发效率

Context Engineering不是替代Prompt Engineering,而是它的进化。它将我们从编写孤立的“魔法咒语”中解放出来,转向构建可维护、可扩展、可协作的“对话系统”。通过结构化上下文、动态组装Prompt,我们能够更可靠地驾驭大模型的能力,真正提升AI应用的开发效率和稳定性。在你当前或未来的项目中,哪个环节最像是一个“上下文管理”的痛点?是用户个性化推荐时需要融合多种行为数据,还是自动化客服需要查询多份异构文档?

2600_94960234的博客 836

Vue 10分钟入门VR全景显示 基于photo-sphere-viewer

文章目录前言一、引入photo-sphere-viewer?二、使用步骤1.引入库2.声明容器3.内容加载4.全部代码总结 前言 由于工作的需求,要实现全景图片的展示与预览,本来以为会是一个很难的内容,没想到使用现成的组件photo-sphere-viewer就可以轻松实现,上手只需要10分钟! 一、引入photo-sphere-viewer? 可以直接通过npm进行引入 npm install photo-sphere-viewer 二、使用步骤 1.引入库 photo-sphere-viewer

YIGE_MO的博客 5860

FPGA时序约束--实战篇(读懂Vivado时序报告)

本文将详细介绍如何读懂Vivado时序报告,包括报告的基本结构和如何分析报告。

mengzaishenqiu的博客 1万+

一文讲透:Prompt Engineering、Context Engineering、Harness Engineering、Loop Engineering 到底有什么区别?

AI工程实践的演进并非线性替代,而是构建在Prompt、Context、Harness、Loop四层架构之上,每层对应不同的控制权让渡程度。Prompt Engineering通过角色设定、少样本学习等技巧精确表达意图,但面临边际效益递减和模型依赖的局限。Context Engineering引入动态信息管理,Harness建立自动化验证,Loop则设计系统级决策循环。关键在于识别何时停止优化当前层(如Prompt超过2000字符可能负收益),转而向上层寻求突破。这四层共同构成AI开发的基础设施

以为在机器学习领域与人工智能领域深耕多年的老牛 952

MT25QL256完整操作指南:从ID读取到4KB扇区擦除(附华大SPI例程)

本文提供了MT25QL256 NOR FLASH在华大MCU上的完整驱动开发指南。内容涵盖从SPI初始化、器件ID读取、状态寄存器查询,到核心的页编程和4KB扇区擦除操作,并分享了构建健壮驱动框架、处理跨页写入及常见调试问题的实战经验。

tt34567的博客 878

【干货收藏】从Prompt Engineering到Context Engineering:大模型应用开发的范式转变!

本文探讨了从Prompt Engineering到Context Engineering的关键转变,强调Context Engineering是构建高效AI Agent的核心学科。文章详细介绍了RAG作为基础架构,包括高级分块策略、重排序技术及"Lost in the Middle"问题解决方案,并探讨了智能体系统的上下文管理框架和工作流编排技术。Context Engineering作为连接LLM与实际应用的关键桥梁,代表了AI应用开发的重要演进方向,为构建可靠、可扩展的AI系统提供了系统化方法论。

libaiup的博客 752

UWB 多传感器通信的纳秒无线位置和时钟同步方法

利用UWB高精度的特点,实现多节点下的无线时钟同步和定位。通过优化硬件架构,减少不确定延迟的影响,系统可以提供纳秒级时钟同步消息

DT程序员的博客 1315

MIKE水动力笔记18_如何将dfsu流场模拟结果的数据导出成txt文件

MIKE的模拟结果dfsu文件的数据是可以导出的,导出格式为xyz,我们也可以将其改后缀改为txt文本格式,其中包含了某一时刻下所有网格坐标点的数据。

晏长街的博客 4400

为什么Context Engineering比Prompt Engineering更重要?大模型开发者的必学技能!

Anthropic提出Context Engineering比Prompt Engineering更重要,因AI工作记忆有限且存在上下文腐化问题。有效上下文管理需遵循三个原则:系统提示恰到好处、工具设计高效、例子典型精炼。针对长任务,可采用压缩、结构化笔记或多Agent架构技术。未来AI应用开发将向动态管理、按需加载和分布式协作方向发展,即使模型能力提升,将上下文视为稀缺资源的原则不变。

lyy2017175913的博客 777

YOLOv12涨点改进 | CVPR 2026 |独家创新首发、特征融合改进篇 | 引入Local Attender 局部注意力算子融合模块,高效捕捉小目标和密集目标的局部上下文特征,助力高效涨点

🚀本文提出LocalAttender模块改进YOLOv12模型,通过局部注意力机制解决传统上采样方法的语义漂移问题。该模块采用固定偏移邻域加权聚合方式,在保持线性计算复杂度的同时有效捕捉小目标和密集目标的局部特征。实验表明,LocalAttender能显著提升检测精度而不增加过多计算负担,且与YOLOv12兼容性强。文章详细介绍了模块原理、实现方法和配置步骤,并提供了两种改进方案的具体yaml配置文件。这一创新为提升目标检测性能提供了高效解决方案。

Ai缝合怪、助力小伙伴高效发论文 115

【AI编程通识】Prompt,Context,Harness,and Loop Engineering

本文系统梳理了AI辅助编程的演化阶段与核心范式。

📷 图像处理践行者 | 传统算法 · 深度学习 · 多模态 | 分享实战经验与技术洞见,探索从像素到智能的无限可能。 979

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

Prompt Engineering

概述:内容、种类、CoT、提示词漂移、提示词洗牌、优化; 拓展:PDL、POML、PromptWizard、RTSCEN、CRISPE、grok-prompt、PrompterHub、PromptLayer、PromptPilot。

lonelymanontheway的博客 1548

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Context (上下文) vs Prompt(提示) Engineering,该如何理解?

今天我们来聊一下人工智能应用场景 - 构建大模型应用架构演进技术:Context Engineering vs Prompt Engineering。在大型语言模型(LLM)兴起的早期,构建 AI 应用更像是一场“炼金术”实验。开发者们围绕一个核心 API 端点,通过反复调试和优化输入文本——即所谓的“提示工程”(Prompt Engineering),试图从模型这个神秘的“黑箱”中召唤出理想的结果。这种方式直接、灵活,也确实催生了无数令人惊艳的创意原型。

欢迎来到我的博客 867

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

什么是Context Engineering?Anthropic说这比Prompt更重要

Anthropic提出Context Engineering比Prompt Engineering更重要,因AI工作记忆有限且存在上下文腐化问题。有效上下文管理需遵循三个原则:系统提示恰到好处、工具设计高效、例子典型精炼。针对长任务,可采用压缩、结构化笔记或多Agent架构技术。未来AI应用开发将向动态管理、按需加载和分布式协作方向发展,即使模型能力提升,将上下文视为稀缺资源的原则不变。

WANGJUNAIJIAO的博客 1545

从 Prompt Engineering 到 Loop Engineering

Prompt工程:人约束模型输出口径;上下文工程:人为模型补充业务数据;编排管控工程:人定义流程,系统指挥模型执行;闭环工程:模型自主决策、自主执行、自主纠错,全链路无人值守。

qzhqbb的博客 590

从Prompt到Context Engineering,构建强大AI Agent系统

文章探讨了Prompt Engineering与Context Engineering的区别与联系,指出Context Engineering是更高阶的系统设计学科,关注动态构建和管理上下文。RAG作为Context Engineering的基础架构,通过检索外部数据增强模型能力。文章详细分析了Context Stack、向量数据库选型、上下文管理策略及多智能体系统中的数据流编排,展示了如何从战术性指令构建转向战略性架构设计,以构建可靠、可扩展的AI Agent系统。

youmaob的博客 1500

Harness Engineering、Agent Engineering、Prompt Engineering、Context Engineering:概念辨析与层次关系

本文系统梳理了AI Agent工程化过程中的四个关键概念:Prompt Engineering(提示词优化)、Context Engineering(上下文管理)、Agent Engineering(智能体构建)和Harness Engineering(基础设施)。通过层次化分析揭示了它们的递进关系:从最基础的提示词设计,到跨轮次的上下文管理,再到整合工具调用和决策循环的智能体构建,最后是确保生产可靠性的基础设施层。文章指出,2026年的AI工程实践正从单纯关注提示词转向更重视上下文管理和基础设施构建,这四

技术引领业务创新 848

Prompt Engineering与Context Engineering:AI后端架构中的核心差异与协同实践

在构建基于大模型的智能应用时,提示工程(Prompt Engineering)与上下文工程(Context Engineering)是两大关键技术。提示工程聚焦于优化单次交互的输入指令,通过结构化设计引导模型生成高质量、格式规范的输出,其本质是对话的艺术与精准指令设计。而上下文工程则属于系统工程范畴,它负责管理跨越多次交互的信息流,涉及向量检索、信息压缩、Token预算管理等核心技术,直接决定了系统的长期记忆能力、响应延迟与成本控制。从工程实践角度看,提示工程将非结构化需求转化为结构化数据,而上下文工程则像

weixin_34034670的博客 302

Context Engineering:重构大模型信息注入的工程范式

Context Engineering 是面向大语言模型应用落地的核心工程方法,它超越传统 Prompt Engineering 的语言优化范畴,聚焦于信息如何高保真、低衰减、有时序与空间锚点地注入模型上下文。其本质是解决模型‘看不见关键信息’这一根本瓶颈,通过结构化编码、动态调度与语义加固,提升事实召回率与逻辑一致性。在 RAG、Agentic 系统、Geo-AI 等高频场景中,它已成为保障 context window 有效利用率的关键技术路径,尤其适用于交通预测、政策问答、多源异构文档理解等强时空约束

weixin_34280237的博客 386

Context Engineering 详解(建议收藏):不止Prompt,解锁大模型落地能力的核心技术

Context Engineer 核心价值,下达清晰正确的指令,收集丰富准确的信息,选择正确的工具,让LLM拿到的上下文“准、全、省(省内存)、清(隔离清晰)”。最终让模型推理更准、效率更高,不管是单智能体完成复杂任务,还是多智能体协作,都能靠优质上下文,才能激发出大语言模型的能力,做出真正落地到实际应用。当然,有个残酷的现实就是如果大模型没有那个能力,你再怎么激发也没有用。

m0_48891301的博客 676

掌握大模型核心技术:从Prompt Engineering到Context Engineering,收藏这份进阶指南!

本部分旨在建立 Prompt Engineering 与 Context Engineering 的基础概念,清晰地界定二者之间的区别与联系。从前者到后者的转变,代表了人工智能应用开发领域一次关键的演进——从业界最初关注的战术性指令构建,转向由可扩展、高可靠性系统需求驱动的战略性架构设计。本节详细介绍用于主动管理上下文的技术,确保最有价值的信息被优先呈现。上下文压缩的目标缩短检索到的文档列表和/或精简单个文档的内容,只将最相关的信息传递给LLM。

大模型研究中心 803

【干货收藏】从Prompt Engineering到Context Engineering:Dify平台AI Agent开发实战教程!大模型学习

Context Engineering通过整合七大核心要素,构建动态上下文系统,突破传统Prompt Engineering局限。Dify作为CE技术理想载体,凭借可视化Prompt IDE、企业级RAG引擎和灵活工作流编排,实现企业知识库问答、智能客服等场景。文章详解环境配置、系统提示词设计、工作流串联等实施步骤,解决知识检索、长上下文处理等技术难点,助力开发者构建更智能可靠的AI Agent。

2401_84495872的博客 1617

Agent 架构综述:从 Prompt 到 Context

Prompt Engineering 是与大型语言模型(LLM)交互的基础,其核心在于精心设计输入内容,以引导模型生成期望的输出。这一实践为理解 Context Engineering 的必要性提供了基准。

volcenginetod的博客 945
上一篇: 一篇文章讲清楚:预训练、SFT、RLHF
下一篇: AI Agent大比拼:WorkBuddy、QoderWork、TraeWork三巨头谁更胜一筹?
大模型入门学习
博客等级 码龄3年 1万+粉丝 2834原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值