




💖💖作者:计算机毕业设计小明哥
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
大数据实战项目
网站实战项目
安卓/小程序实战项目
深度学习实战项目
💕💕文末获取源码
文章目录
运动员训练大数据可视化-系统功能
本系统是一套面向运动员训练场景的大数据可视化分析系统,基于 Hadoop、Spark 大数据组件完成数据集处理与计算,使用 Pandas 开展原始数据集预处理,将一万条运动员训练原始数据集完成缺失值填补、类别字段中文映射、数值精度统一处理后存入 MySQL。系统共实现 18 项业务分析任务,覆盖训练效果统计、训练负荷计算、项目表现对比、训练风险等级统计、生理恢复指标评估、睡眠影响分析、训练负荷效率计算、运动员能力综合评分、增益分层统计,同时借助 PySpark MLlib 完成 FPGrowth 频繁项集挖掘、K‑Means 运动员画像聚类、IQR 与 Z‑Score 多维训练异常识别。Django 后端对外提供分析结果接口,Vue 结合 Echarts 完成各类统计图表渲染,为教练群体提供多维度训练数据可视化结果,辅助开展运动员训练评估。
运动员训练大数据可视化-技术选型
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
运动员训练大数据可视化-背景意义
竞技体育训练过程中会持续积累大量运动员训练记录、生理指标、运动表现数据,单份纵向运动员数据集可累积上万条训练会话记录。传统处理方式只依靠人工翻阅训练台账,很难快速挖掘训练负荷、生理恢复、运动增益之间的潜在关联。教练员很难快速区分高风险训练会话、识别运动员疲劳异常,大量结构化训练数据没有发挥数据价值。随着大数据技术落地体育行业,Hadoop 与 Spark 可以高效完成大样本训练数据集统计挖掘,把分散的训练会话数据转化为可直观查看的分析结论。搭建运动员训练大数据分析可视化系统,能够把海量训练数据转化为可视化图表,解决传统人工统计效率低下、多维指标难以综合评估的现实痛点。
本课题实现运动员训练数据集的大数据处理与可视化输出,能够对上万条训练会话数据完成自动化统计分析,减少人工整理统计的工作量。从训练业务层面,可以对不同体育项目、不同训练类型的训练负荷、风险等级、运动增益开展量化评估,帮助教练员快速识别高风险训练,观察睡眠、生理恢复状态对运动表现带来的影响。通过聚类算法划分不同画像运动员群体,异常检测识别过劳、异常恢复等训练会话,挖掘训练项目与训练类型之间的频繁组合模式。课题将大数据技术应用于体育训练数据分析场景,完成完整的数据预处理、算法分析、结果可视化流程,也为本专业本科大数据方向毕业设计提供可落地的项目实践案例。
运动员训练大数据可视化-演示视频
Hadoop+Spark的运动员运动表现和训练数据可视化毕设
运动员训练大数据可视化-演示图片
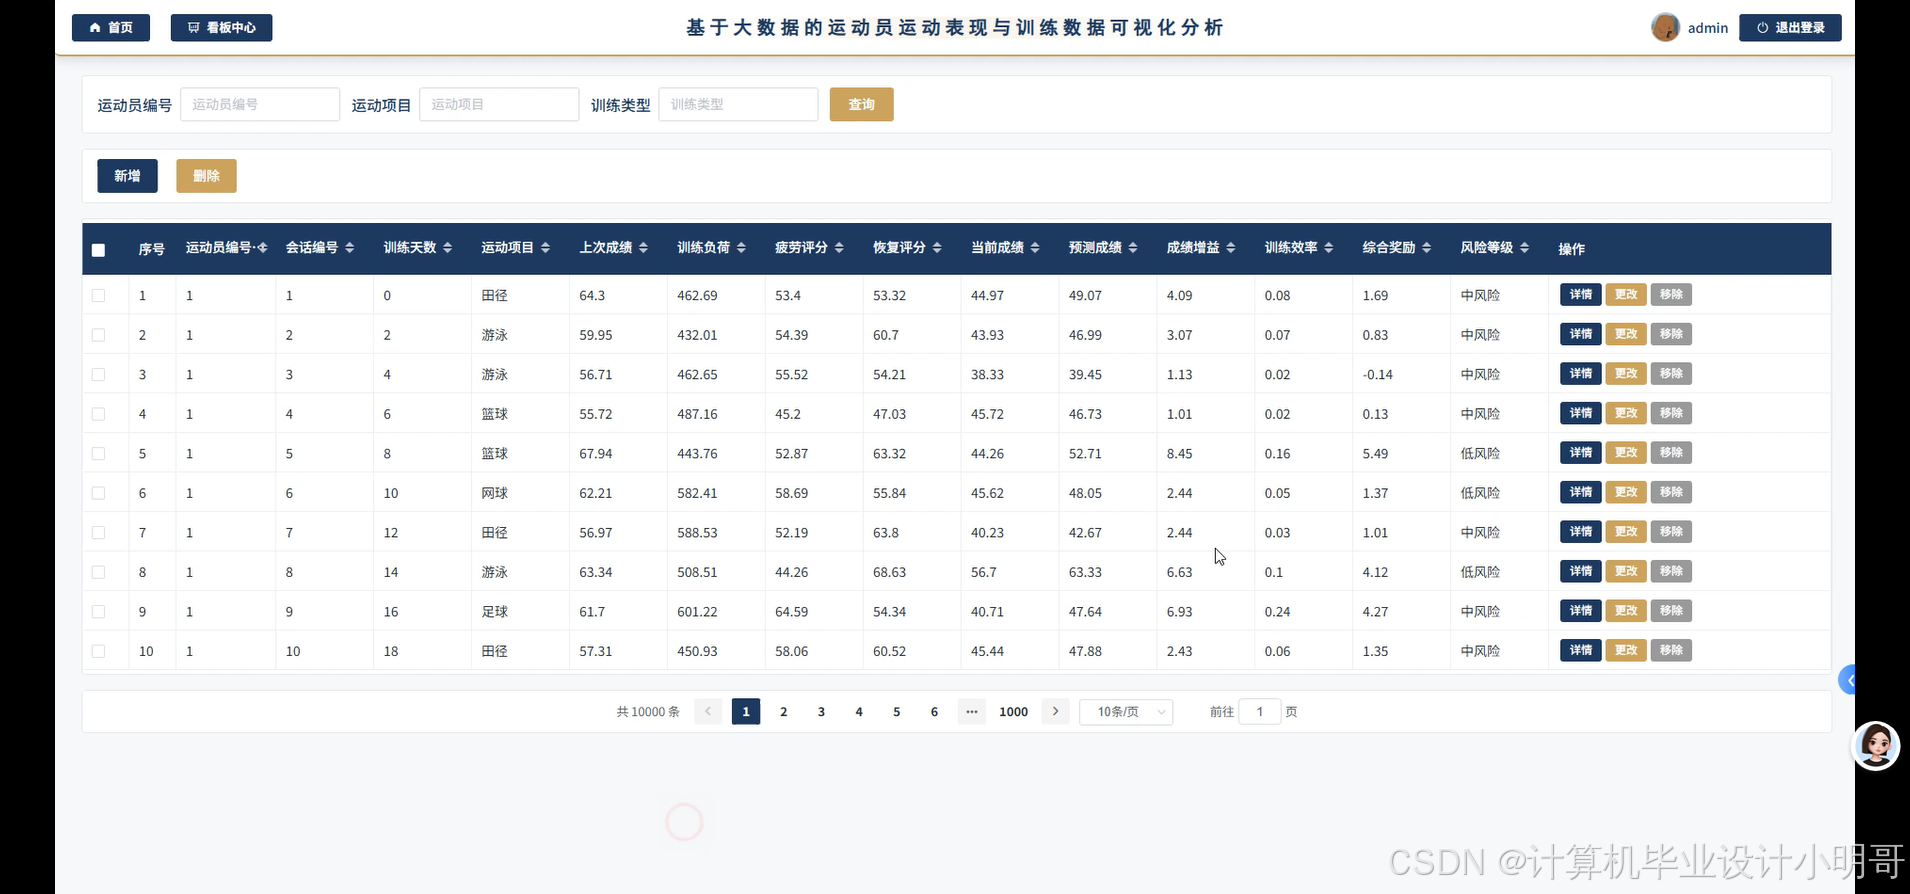
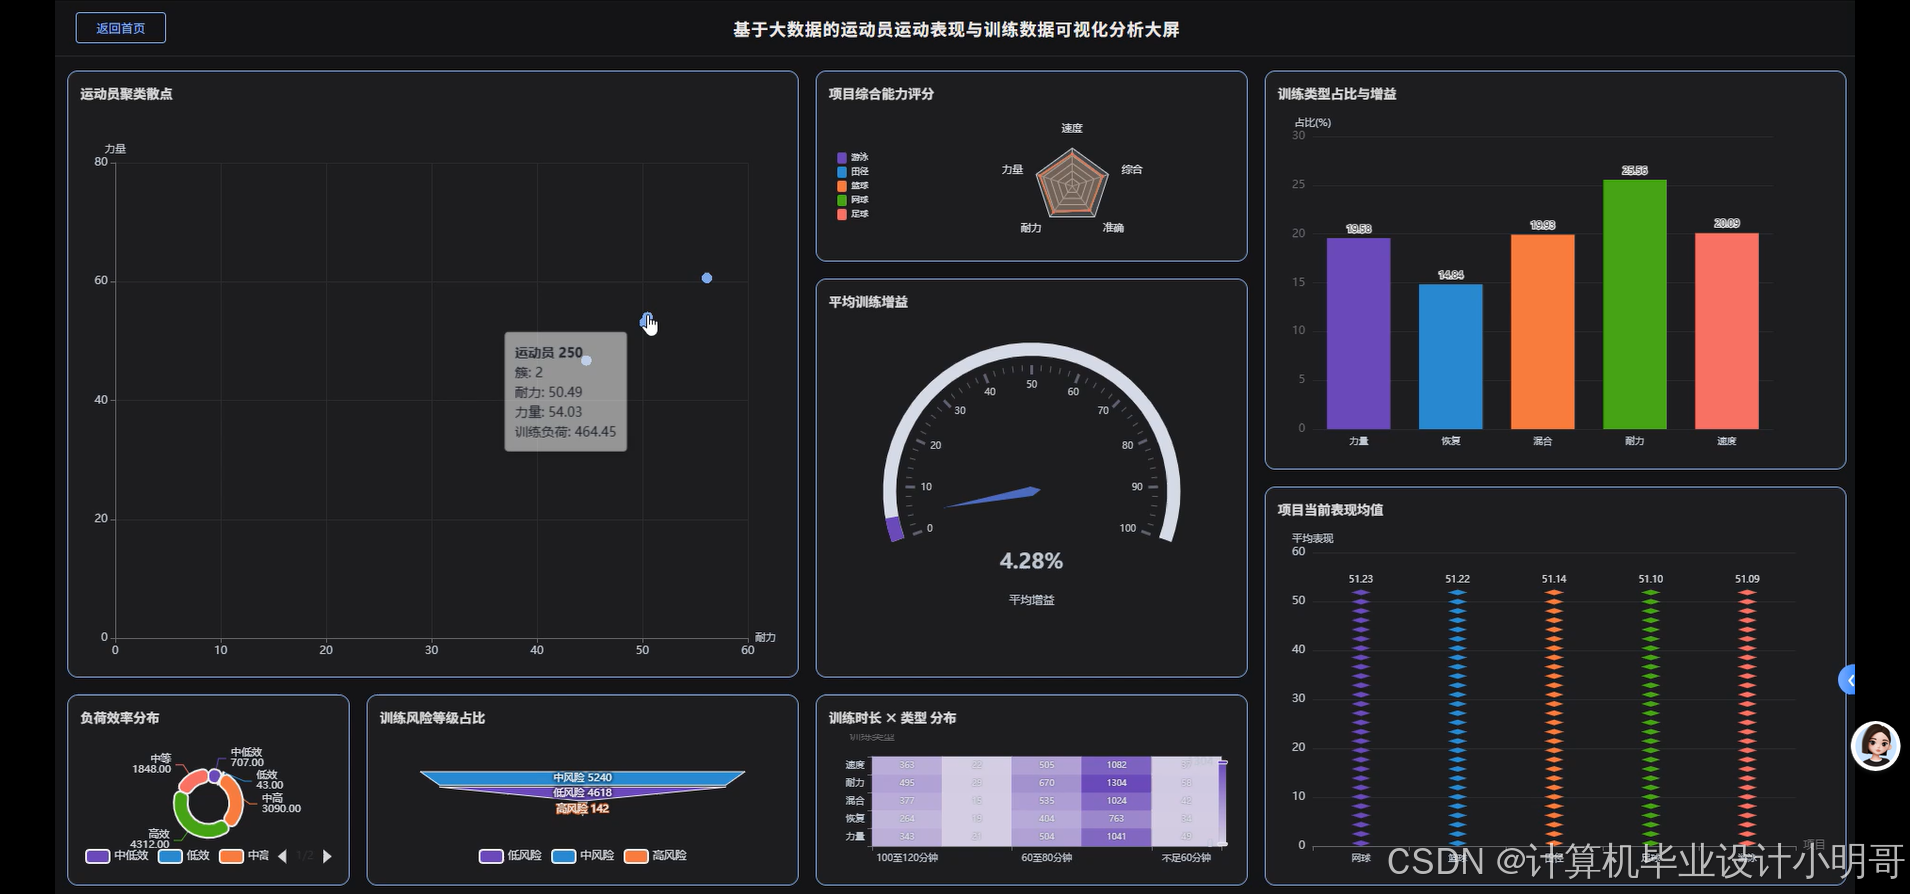
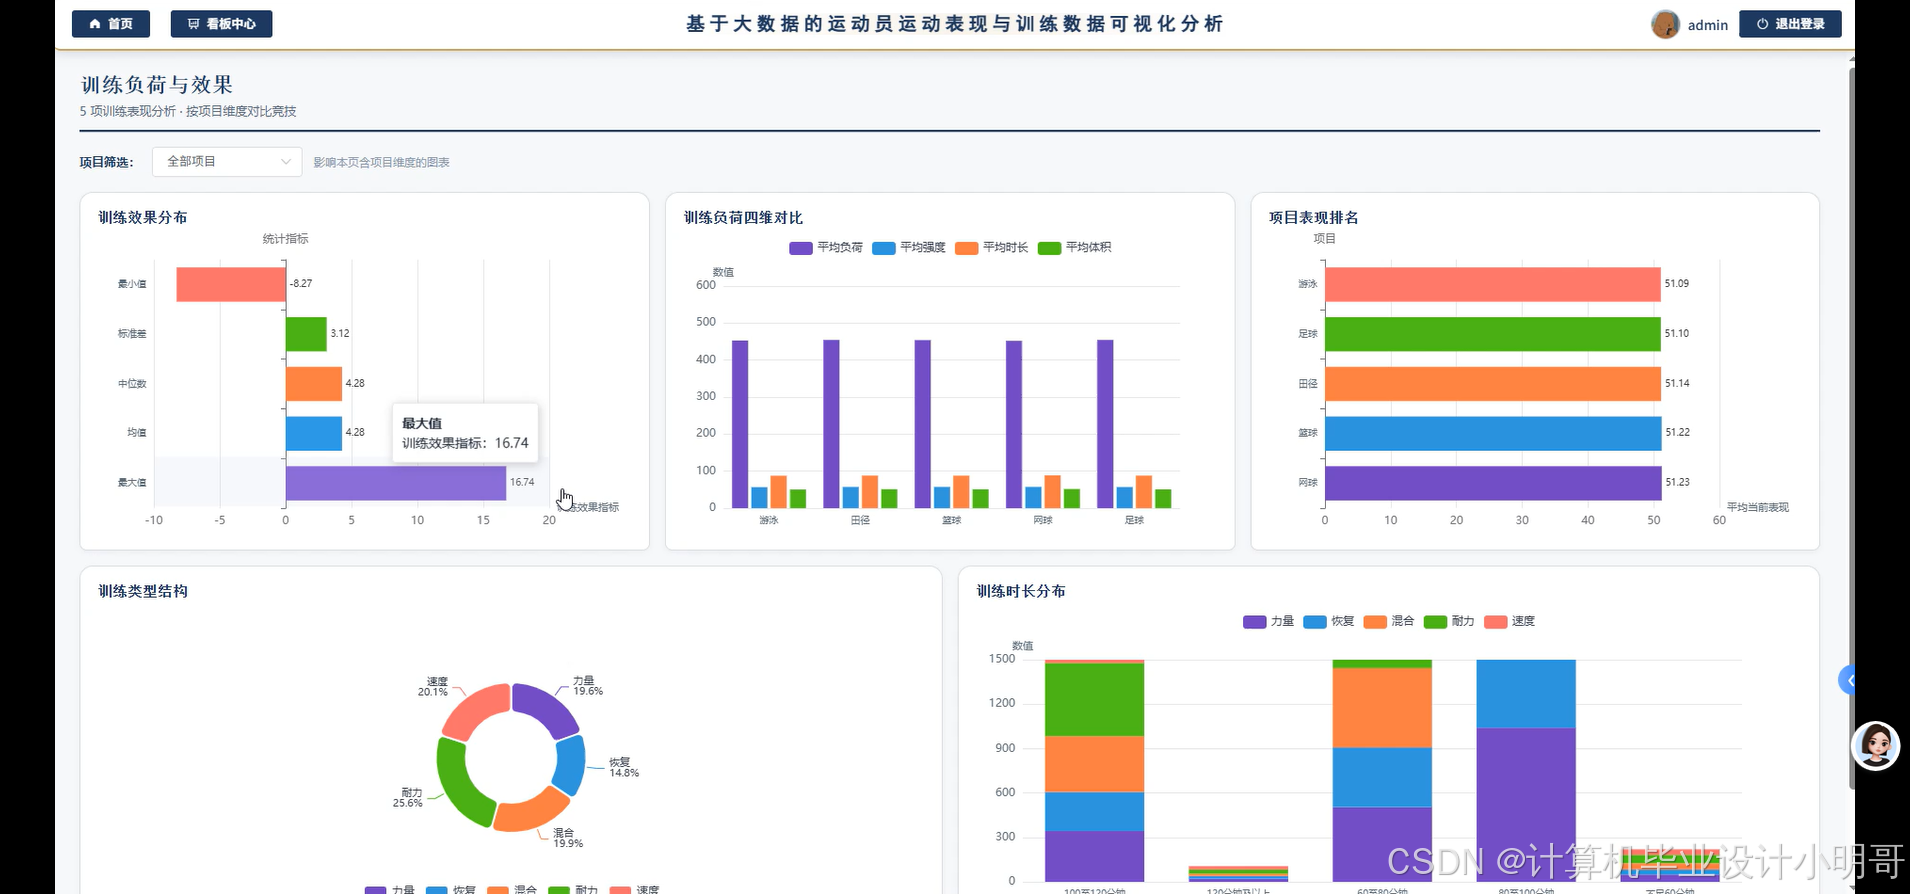
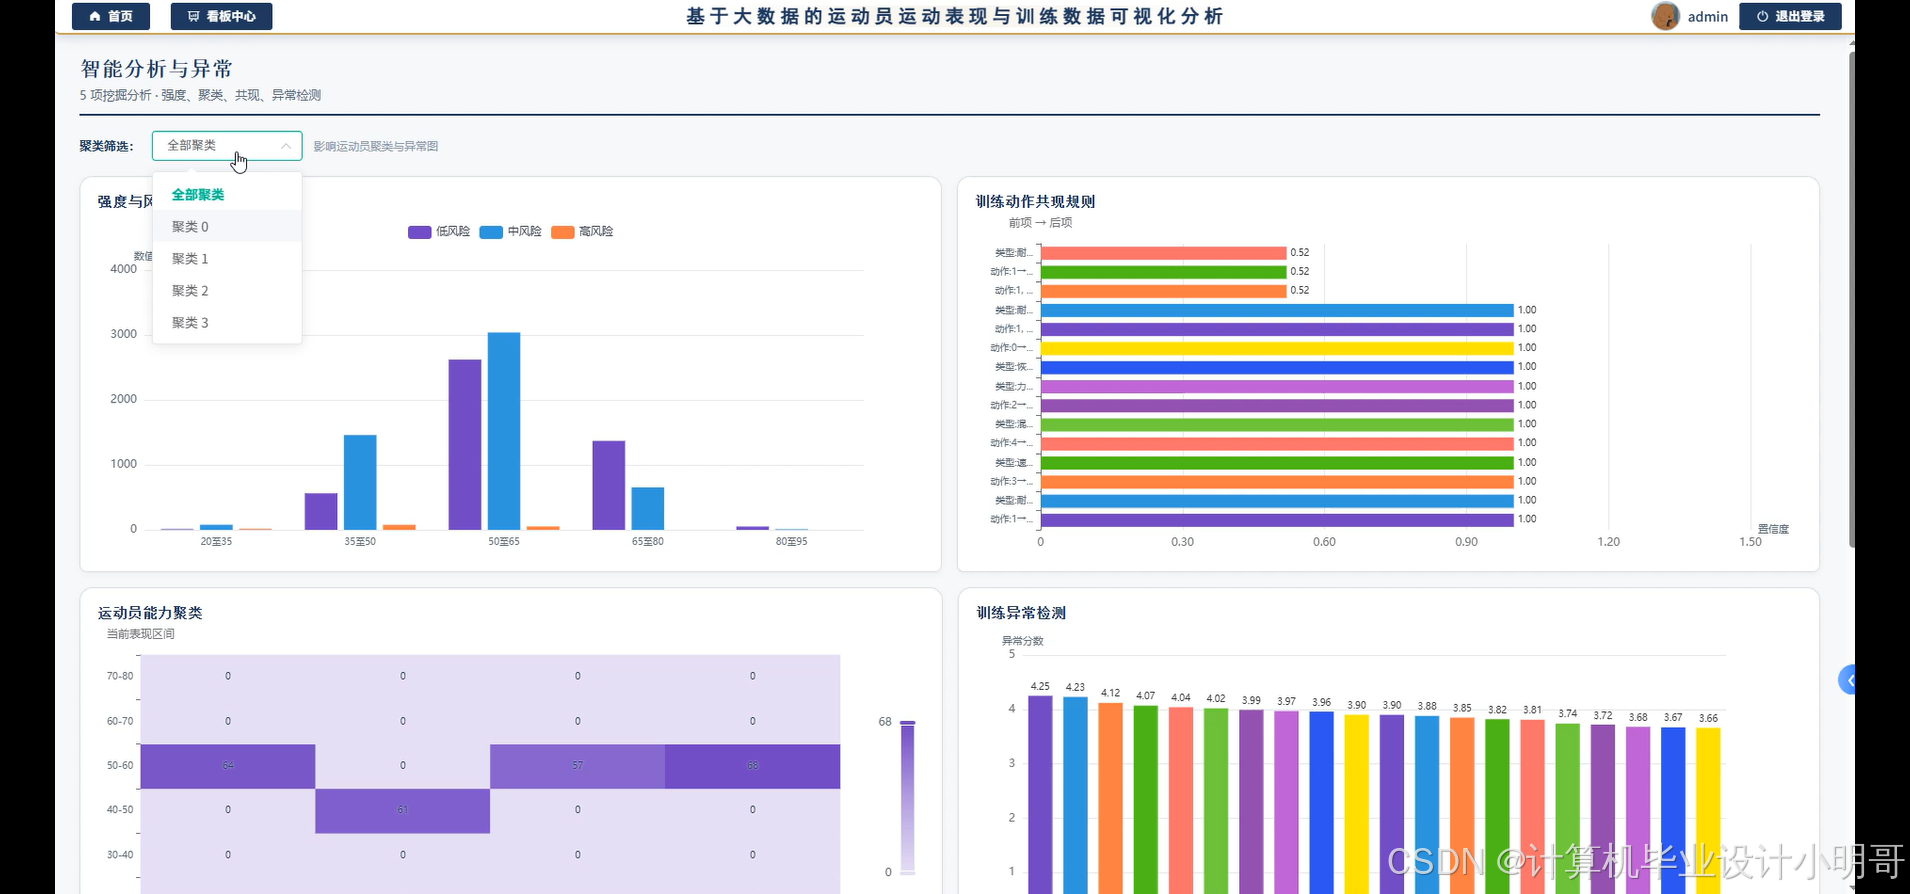
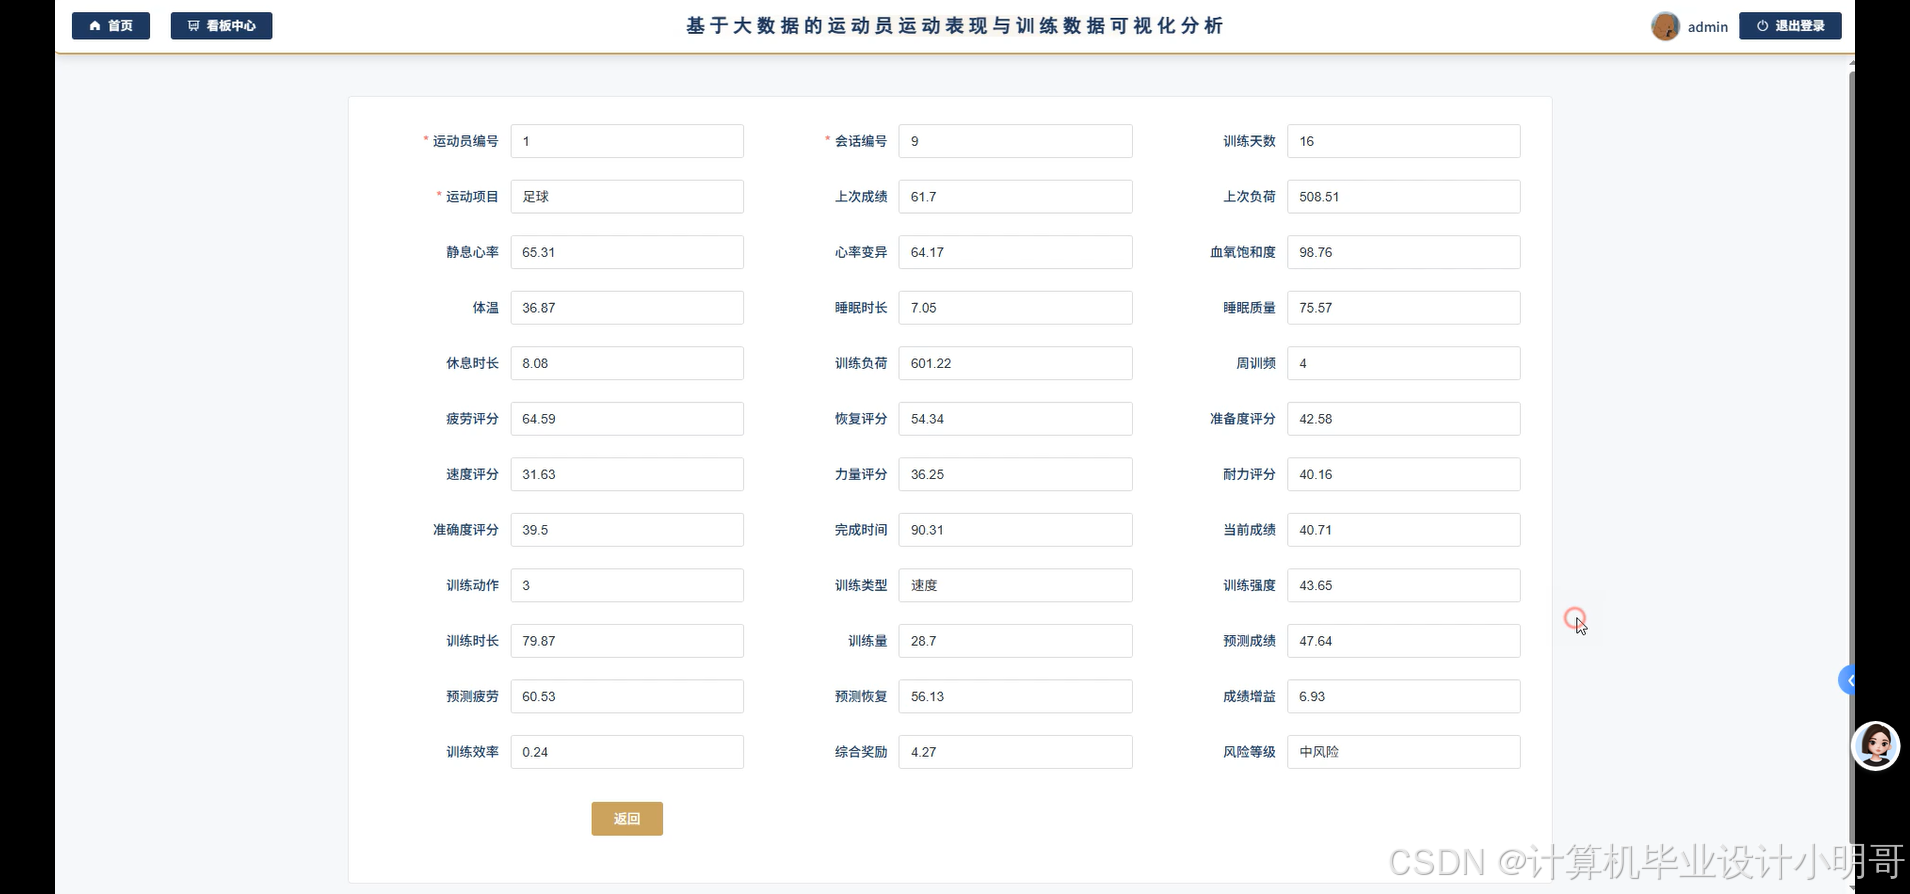
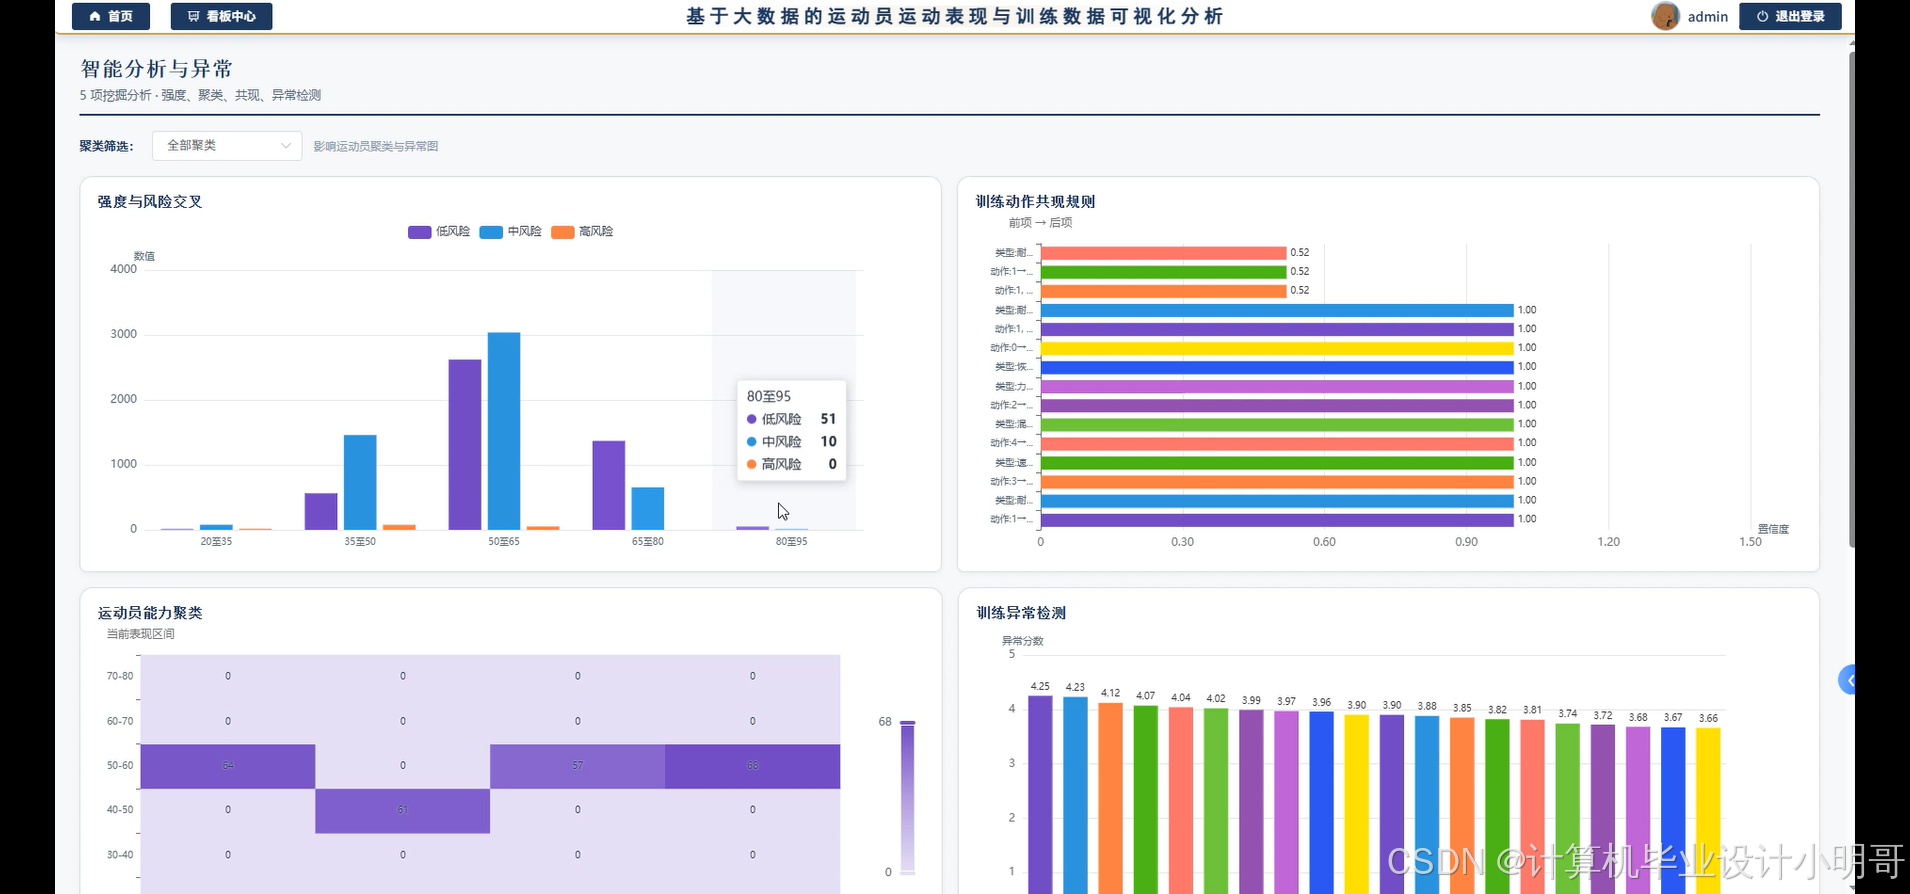
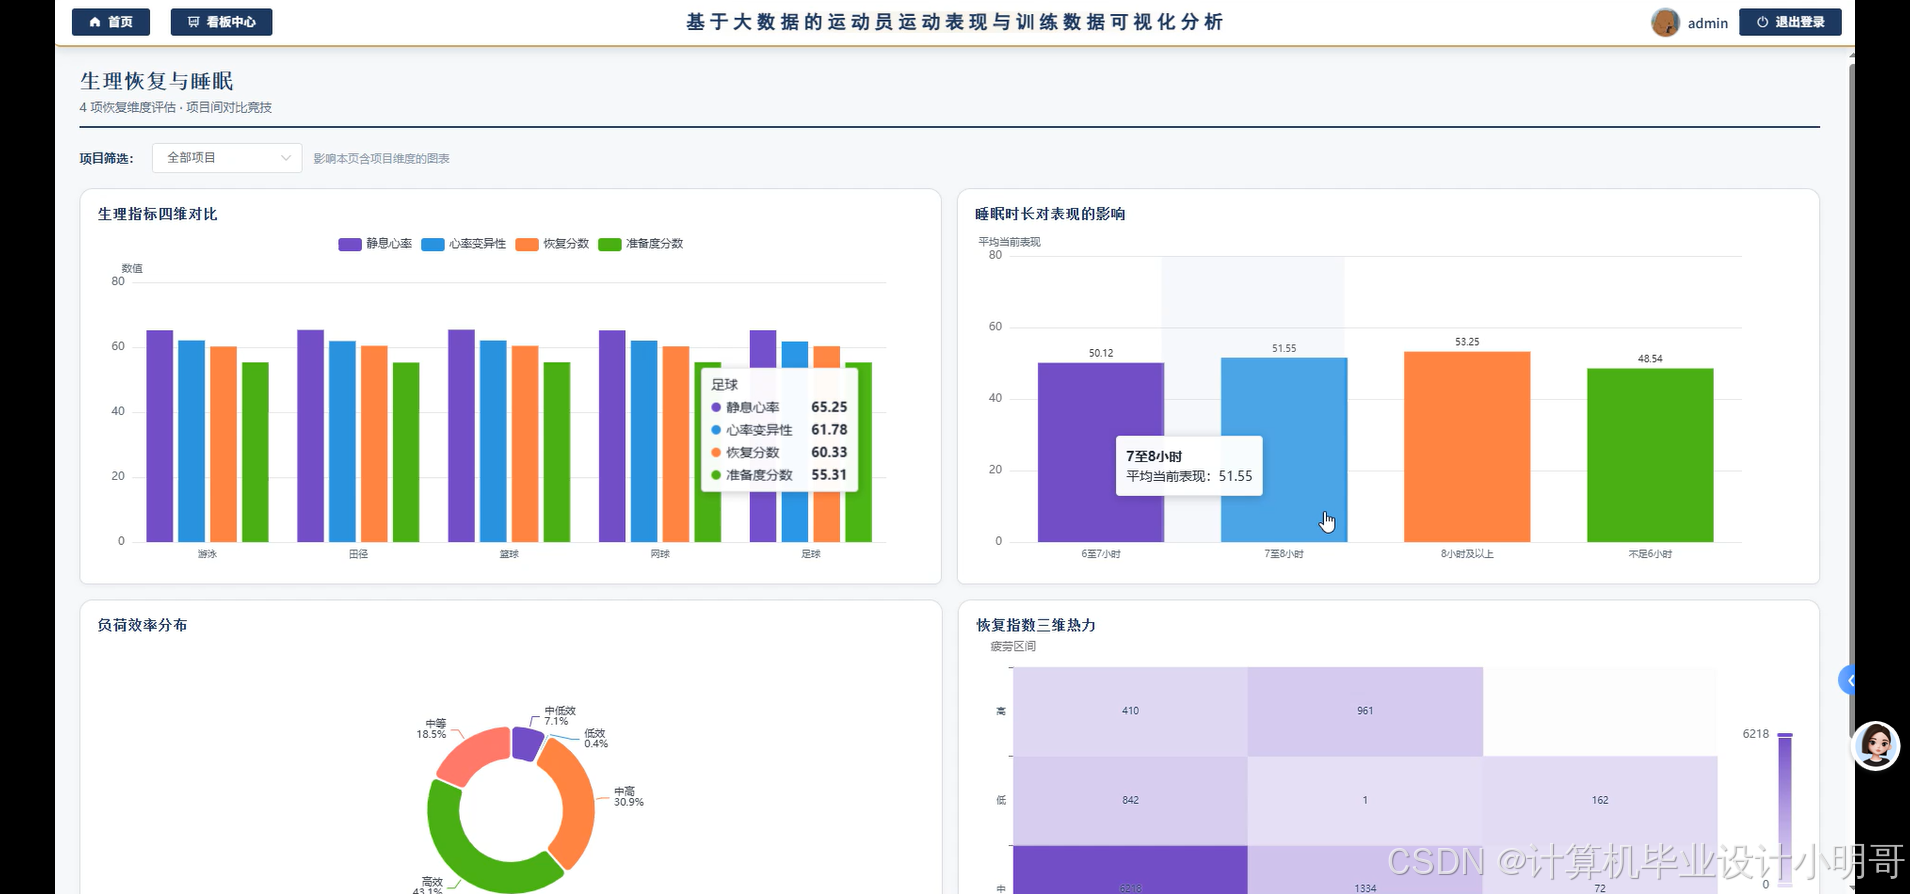
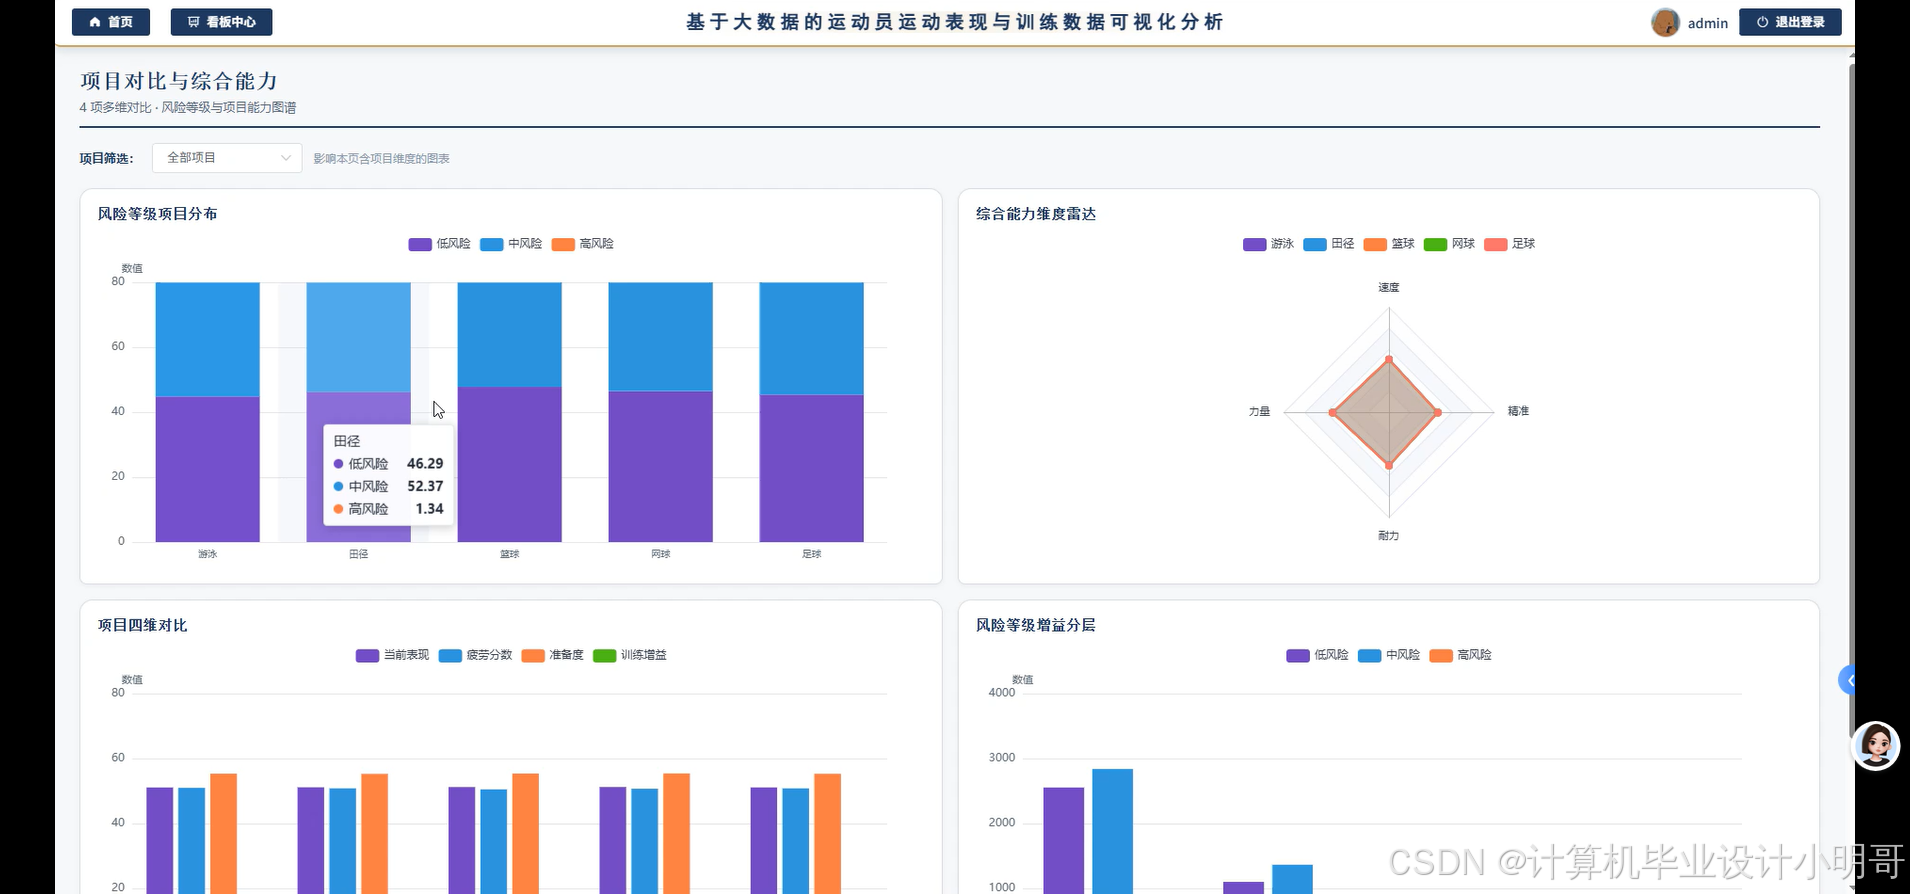
运动员训练大数据可视化-代码展示
# A01 训练效果统计 Performance_Gain描述统计
def training_effect_analysis(df):
    gain_col = df["Performance_Gain"]
    count_val = len(gain_col)
    mean_val = round(gain_col.mean(),2)
    median_val = round(gain_col.median(),2)
    std_val = round(gain_col.std(),2)
    min_val = round(gain_col.min(),2)
    max_val = round(gain_col.max(),2)
    result_row = {
        "count":count_val,"mean":mean_val,"median":median_val,
        "std":std_val,"min":min_val,"max":max_val
    }
    import pandas as pd
    res_df = pd.DataFrame([result_row])
    res_df.to_csv("output/SportPerformanceData_analysis/training_effect.csv",index=False,encoding="utf-8-sig")
    return result_row

# A16 运动聚类 K-Means运动员聚类分析 PySpark
from pyspark.ml.clustering import KMeans
from pyspark.ml.feature import VectorAssembler
def athlete_cluster_analysis(spark_df):
    feature_cols = ["Current_Performance","Fatigue_Score","Recovery_Score","Speed_Score",
                    "Strength_Score","Endurance_Score","Training_Load","Readiness_Score"]
    assembler = VectorAssembler(inputCols=feature_cols,outputCol="features")
    vec_df = assembler.transform(spark_df)
    kmeans = KMeans(k=4,seed=2026,featuresCol="features",predictionCol="cluster_id")
    kmeans_model = kmeans.fit(vec_df)
    predict_df = kmeans_model.transform(vec_df)
    output_df = predict_df.select("Athlete_ID","cluster_id","distanceToCenter").withColumnRenamed("distanceToCenter","centroid_dist")
    pandas_res = output_df.toPandas()
    pandas_res["centroid_dist"] = pandas_res["centroid_dist"].round(2)
    pandas_res.to_csv("output/SportPerformanceData_analysis/athlete_cluster.csv",index=False,encoding="utf-8-sig")
    return pandas_res

# A17 异常识别 Z‑Score + IQR多维训练会话异常检测
from pyspark.sql.functions import col,stddev,mean,abs
def anomaly_detect_analysis(spark_df):
    detect_cols = ["Fatigue_Score","Recovery_Score","Readiness_Score","Heart_Rate_Variability_ms",
                   "Oxygen_Saturation_pct","Resting_Heart_Rate_bpm","Performance_Gain"]
    stats_df = spark_df.select(*[mean(c).alias(f"mean_{c}") for c in detect_cols],
                               *[stddev(c).alias(f"std_{c}") for c in detect_cols]).collect()[0]
    for one_col in detect_cols:
        col_mean = stats_df[f"mean_{one_col}"]
        col_std = stats_df[f"std_{one_col}"]
        spark_df = spark_df.withColumn(f"z_{one_col}",abs((col(one_col)-col_mean)/col_std))
    z_col_list = [f"z_{c}" for c in detect_cols]
    sum_expr = "+".join(z_col_list)
    spark_df = spark_df.withColumn("anomaly_score",eval(f"col('{sum_expr}')/len(detect_cols)"))
    spark_df = spark_df.withColumn("out_flag",col("anomaly_score")>2.0)
    result_df = spark_df.select("Athlete_ID","Session_ID","anomaly_score","out_flag")
    pd_result = result_df.toPandas()
    pd_result["anomaly_score"] = pd_result["anomaly_score"].round(2)
    pd_result.to_csv("output/SportPerformanceData_analysis/anomaly_detect.csv",index=False,encoding="utf-8-sig")
    return pd_result
运动员训练大数据可视化-结语
💕💕
大数据实战项目
网站实战项目
安卓/小程序实战项目
深度学习实战项目
💟💟如果大家有任何疑虑,欢迎在下方位置详细交流,也可以在主页联系我。


 扫一扫


 36

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


