


GraphRAG通过将文本语料转换为图结构,有效解决了传统RAG难以捕捉信息关联的问题,在复杂推理和抽象概括任务中表现突出。

在大语言模型(LLMs)主导AI应用的当下,"幻觉"问题始终是制约其落地的关键瓶颈——即便强大如GPT-4、Llama 3.1,面对领域知识、实时信息或专有数据时,仍可能生成错误输出。检索增强生成(RAG)技术的出现为解决这一问题提供了有效路径,而基于图的RAG(Graph-based RAG)凭借其对实体关系和语义关联的精准捕捉,逐渐成为研究热点。
港中文深圳与华为云团队发表于VLDB 2025的这项研究,正是针对当前GraphRAG领域缺乏统一评估标准、方法对比不系统的痛点,提出了涵盖所有现有方法的统一框架,并通过大规模实验揭示了各类方法的优劣与适用场景。

01、为什么需要GraphRAG?从传统RAG的局限说起
传统的Vanilla RAG直接从文本块中检索相关信息,虽然简单高效,但存在明显短板:它难以捕捉文本间的隐性关联,面对多跳推理、抽象概括等复杂任务时力不从心。比如要回答"人工智能如何影响医疗行业的诊断流程"这类问题,需要串联技术应用、医疗流程、数据安全等多个维度的信息,传统RAG的文本块检索模式很难实现这种跨领域关联。
而GraphRAG的核心优势正在于此:它将文本语料转换为包含节点(实体)和边(关系)的图结构,既能保留原始文本细节,又能显性化呈现信息间的关联。这种结构天然适合处理需要推理和整合的复杂任务,同时还能提升答案的可解释性——你可以清晰追溯答案来自哪些实体关系的推导。
不过在此研究之前,GraphRAG领域可谓"群雄割据":RAPTOR用树结构组织信息,HippoRAG依赖知识图,GGraphRAG引入社区概念……不同方法基于不同的图结构和检索逻辑,缺乏统一的对比标准,开发者很难判断哪种方法适合自己的场景。这正是该研究要解决的核心问题。

02、统一框架:拆解GraphRAG的四大核心阶段
研究的最大贡献之一,是提出了一个包含四大阶段的统一框架,让所有GraphRAG方法都能被清晰拆解和对比。这个框架就像一个"乐高积木套装",不同方法只是选择了不同的积木组合。


图构建:为语料库搭建关联骨架
这是GraphRAG的基础步骤,核心是将文本块转换为结构化图。研究总结了五种主流图类型,各自适用于不同场景:
- 段落图(PG):每个文本块作为节点,共享实体超过阈值则连边,构建成本最低,适合简单关联检索
- 树结构:叶节点是原始文本块,上层节点是LLM生成的摘要,适合层级化检索,RAPTOR就用这种结构
- 知识图(KG):提取实体和关系作为节点与边,结构最简洁,是很多基础GraphRAG的选择
- 文本知识图(TKG):在KG基础上为实体和关系添加文本描述,增强语义丰富度
- 丰富知识图(RKG):进一步增加关系关键字等信息,适合需要深度语义理解的场景
实际应用中,图类型的选择直接影响后续性能。比如处理简单事实查询时,树结构或段落图足够高效;而复杂领域的多跳推理,可能需要TKG或RKG提供更丰富的语义支撑。

索引构建:为高效检索铺路
图构建完成后,需要建立索引来加速在线查询。论文总结提出三种核心索引类型:
- 节点索引:将节点嵌入存储到向量数据库,支持快速相似度匹配,大部分方法都依赖这种索引
- 关系索引:专门为关系构建索引,适合需要精准捕捉实体关联的场景
- 社区索引:通过聚类算法生成社区并由LLM生成报告,GGraphRAG和LGraphRAG用这种方式提升抽象任务性能
值得注意的是,社区索引虽然能提升抽象任务表现,但成本较高——在HotpotQA这样的大型数据集上,仅生成社区报告就需要消耗大量tokens,这也是后续优化的重要方向。
操作算子配置:检索逻辑的"积木组合"
这是GraphRAG的核心创新点之一。研究将所有检索逻辑拆解为19种基本算子,按检索粒度分为五大类:节点型、关系型、文本块型、子图型、社区型。
比如节点型算子中的VDB(向量数据库检索)是RAPTOR的核心,而社区型算子中的Entity(按实体筛选社区)则是LGraphRAG的关键。不同方法本质上是选择不同算子并组合使用,这种模块化设计让研究者可以灵活创造新方法——就像搭积木一样,替换一个算子就能形成新的检索策略。

检索与生成:从图中找答案,给LLM喂素材
最后阶段是将用户问题转换为检索指令,从图中提取相关信息,再结合问题生成提示给LLM。问题转换的方式各不相同:有的提取实体,有的提取关键词,有的直接生成问题向量。生成方式也分两种:直接让LLM生成答案,或用Map-Reduce先分社区回答再汇总(GGraphRAG用这种方式提升抽象任务性能)。
03、实验揭秘:哪些GraphRAG方法真的好用?

研究在11个真实数据集上对12种方法进行了全面测试,涵盖具体问题(简单/复杂)和抽象问题,结论极具实践价值。

特定QA任务评估:聚焦事实准确性与推理效率
1. 整体性能:GraphRAG的优势与局限并存
将12种GraphRAG方法与Zeroshot(无外部知识)、VanillaRAG(传统文本块检索)在6个特定QA数据集上对比,核心结果如表5所示。从数据中可提炼出三个关键结论:

首先,RAG技术对LLM性能的提升并非绝对。整体来看,GraphRAG方法(如RAPTOR、HippoRAG)的准确率普遍高于VanillaRAG;但当检索信息与问题无关时,RAG反而会“拖后腿”——G-retriever在Quality数据集上因仅返回子图结构(缺乏文本细节),准确率比Zeroshot低,这说明“检索相关性”是RAG生效的前提。
其次,原始文本块是特定QA的“刚需”。仅依赖图结构的方法(G-retriever、ToG、DALK)在多数数据集上表现不佳。因为特定QA的问题与答案均源自文本语料,脱离原始文本的图结构(如实体关系、子图)无法提供完整的事实细节,而融合文本块的方法(RAPTOR、HippoRAG)更能平衡“结构关联”与“细节完整性”。
最后,RAPTOR在多数场景下表现最优,尤其在简单事实查询任务中。例如在PopQA数据集上,RAPTOR的准确率达到62.54%,即便在复杂的MultihopQA数据集(多跳推理),RAPTOR仍以56.06%的准确率领先。其优势源于树结构的“层级检索”——既能通过高层摘要快速定位相关主题,又能通过叶节点获取原始文本细节。值得注意的是,当数据集规模过大时(如HotpotQA),将RAPTOR的聚类方法从高斯混合模型替换为K-means(即RAPTOR-K),性能几乎无差异(如表6所示),这说明GraphRAG的核心性能瓶颈不在聚类算法,而在检索策略。

2. 图与索引构建成本:结构复杂度决定资源消耗
GraphRAG的离线构建阶段(图构建+索引构建)直接影响落地可行性,通过对不同图类型的token成本与索引构建开销重点分析,结果如图4、图5所示。
在图构建环节,成本差异主要源于图结构的信息密度:树结构的token成本最低(如MultihopQA数据集上仅10⁶量级),而文本知识图(TKG)与丰富知识图(RKG)成本最高(部分数据集达10⁸量级),知识图(KG)介于两者之间。这一趋势与图的属性复杂度完全匹配——树仅需层级摘要,KG仅含实体关系,而TKG/RKG需额外添加文本描述与关键字,自然消耗更多token。更关键的是,无论哪种图类型,提示token成本均高于完成token成本(如图4(g)(h)所示),这意味着优化图构建的核心是“精简提示设计”,而非压缩模型输出。
在索引构建环节,仅有LGraphRAG与GGraphRAG需要额外消耗token(生成社区报告),其成本与TKG构建相当(如图5所示)。以HotpotQA数据集为例,两者的索引构建token成本达10⁶量级,原因是该数据集包含57,384个社区,每个社区需LLM生成独立报告——这提表面,社区索引虽能提升抽象任务性能,但在特定QA场景中“性价比不高”,除非有明确的层级化检索需求,否则优先选择节点/关系索引。


3. 生成成本:效率与性能的平衡艺术
生成阶段的时间与token成本直接决定GraphRAG的在线可用性,对各方法在特定QA任务中的平均成本进行统计,结果如表7所示。
从数据中可清晰划分出“成本梯队”:
- 极致高效型:Zeroshot(平均1.17-3.23秒/查询)与VanillaRAG(1.04-2.35秒/查询),无需复杂图检索,token消耗也最低(Zeroshot仅82.2-270.3 token/查询);
- 均衡实用型:RAPTOR与HippoRAG,时间成本与VanillaRAG接近(RAPTOR平均1.36-3.18秒/查询),token消耗仅略高(RAPTOR 757.6-4140.7 token/查询),这是因为它们的检索逻辑与VanillaRAG相似,仅增加了高层摘要或实体关系的筛选;
- 高成本型:KGP与ToG,时间成本达34.94-105.09秒/查询,token消耗超6738 token/查询,核心原因是它们依赖LLM作为“代理”——KGP需LLM推理下一步检索需求,ToG需LLM筛选实体关系,额外的LLM调用大幅推高成本;
- 渐进成本型:LLightRAG、GLightRAG、HLightRAG,成本随“关键词提取粒度”增加而上升(HLightRAG成本最高),适合对上下文丰富度要求高的场景,但整体性价比低于RAPTOR。
这一结果表面:在特定QA场景中,GraphRAG的成本优化重点是“减少不必要的LLM调用”,优先选择基于向量检索的方法(如RAPTOR),而非依赖LLM代理的策略(如KGP、ToG)。

4. 方法细节分析:RAPTOR与LGraphRAG的性能差异根源
为进一步理解GraphRAG的核心优化点,对表现突出的RAPTOR与潜力较大的LGraphRAG展开深度拆解,从检索策略、元素选择两个维度寻找性能差异的根源。
- RAPTOR:多层次检索为何有效?
RAPTOR的核心是“树结构+跨层检索”,统计了其在不同数据集上检索到的“非叶节点比例”(即高层摘要信息),结果如表8所示。数据揭示了一个关键规律:多跳推理数据集(MultihopQA、MusiqueQA)的非叶节点检索比例显著更高——MultihopQA的非叶节点占比达40.7%(1层27.5%+超1层13.2%),而简单数据集(如ALCE)仅9.4%。这说明高层摘要信息能帮助LLM快速串联多文本块的隐性关联,例如在回答“某药物如何通过抑制某蛋白治疗疾病”时,RAPTOR的高层节点能直接提供“药物-蛋白-疾病”的关联摘要,避免LLM在海量原始文本中逐一查找。
反观VanillaRAG,由于仅检索原始文本块,无法捕捉这种跨块关联,因此在多跳推理任务中性能落后。这也解释了为何RAPTOR能在复杂特定QA任务中保持优势——它的检索策略与任务需求高度匹配。

- LGraphRAG:如何通过优化检索策略提升性能?
LGraphRAG的原始版本采用“实体频率筛选社区”的策略,但在部分数据集上表现不稳定。通过修改其检索元素与策略,构建了三个变体(GraphRAG-ER、GraphRAG-CC、VGraphRAG-CC),对比结果如表10所示。
实验得出三个关键发现:
这一分析为GraphRAG的优化提供了清晰方向:融合“结构化信息(实体关系)+高层摘要(社区报告)+向量检索”,是平衡性能与效率的关键。

a.社区报告是优质高层信息源:VGraphRAG-CC(仅检索社区与文本块,用向量筛选)的性能与RAPTOR相当,在ALCE数据集上的STRREC达37.82%,比GraphRAG-ER(仅检索实体关系)高11.05%,证明社区报告能提供更全面的上下文;
b.向量检索优于规则检索:VGraphRAG-CC始终优于GraphRAG-CC(同元素,规则筛选),例如在MultihopQA上准确率高3.09%,原因是向量检索能捕捉语义相似性,而规则筛选(如实体频率)易遗漏“语义相关但实体不重叠”的信息;
c.结构化信息对多跳推理至关重要:LGraphRAG(实体+关系+社区+文本块)在MultihopQA上的准确率达55.36%,比VGraphRAG-CC高0.16%,说明实体关系能帮助LLM构建推理路径,尤其适合“需明确关联的多跳任务”。
5. 新SOTA方法VGraphRAG:融合优势的性能突破
基于上述分析,提出新方法VGraphRAG,核心逻辑是“取各家之长”:
- 先检索前k个实体与关系(沿用LGraphRAG的结构化信息优势);
- 用向量检索筛选最相关的社区与文本块(沿用VGraphRAG-CC的语义匹配优势);
- 将四类信息(实体、关系、社区、文本块)整合为提示,输入LLM生成答案。
实验结果显示,VGraphRAG在所有复杂特定QA数据集上均实现SOTA:在MultihopQA上准确率达59.66%,比RAPTOR高3.6%;在ALCE上STRREC达41.02%,比VGraphRAG-CC高3.2%。更重要的是,其生成成本仅比RAPTOR高15%,远低于GGraphRAG等方法,真正实现了“性能与效率的双重优化”。

抽象QA任务评估:聚焦主题概括与成本优化
抽象QA任务的核心是“提炼主题、整合观点”,无需精准事实,而需对语料库的高层语义有全局理解(如“总结某领域的技术趋势”)。围绕“性能优势、成本瓶颈、优化方向”展开实验,最终提出低成本高性能的新方法。
1. 整体性能:高层结构化信息是核心竞争力
选择5种代表性方法(VanillaRAG、RAPTOR、GGraphRAG、HLightRAG、FastGraphRAG),在5个抽象QA数据集上采用“头对头胜率”评估(用GPT-4o从全面性、多样性、启发性、整体表现四个维度打分),结果如图6-10所示。
核心结论集中在三点:
- GraphRAG普遍优于VanillaRAG:在Mix数据集的“全面性”维度,GGraphRAG对VanillaRAG的胜率达70%,RAPTOR达61%,原因是GraphRAG能捕捉文本块间的关联,避免VanillaRAG“只见树木不见森林”的局限;
- GGraphRAG性能最优:在几乎所有数据集的所有维度中,GGraphRAG均领先——例如在Agriculture数据集的“启发性”维度,其胜率比RAPTOR高25%,比HLightRAG高44%。这源于其“社区报告+Map-Reduce”策略:社区报告捕捉主题分布,Map-Reduce筛选无关信息,两者结合能生成更全面、更有深度的抽象答案;
- RAPTOR的补充价值:在部分数据集(如CS)的“多样性”维度,RAPTOR对GGraphRAG的胜率达55%,原因是RAPTOR保留了更多原始文本块细节,能提供社区报告未覆盖的小众观点,而GGraphRAG因过度依赖社区摘要,可能丢失部分多样性。
这一结果表明,抽象QA任务的核心需求是“高层结构化信息”,社区报告比简单的文本块检索或实体关系更能满足这一需求。


2. 构建与生成成本:GGraphRAG的“性能-成本”困境
尽管GGraphRAG性能最优,但其成本问题极为突出。在图与索引构建环节(如图11所示),GGraphRAG的社区索引成本与TKG相当,在Agriculture数据集上达10⁷ token量级;而在生成环节(如表11所示),其成本更是“碾压级”——在MultihopSum数据集上,每个查询需521秒(约9分钟),消耗353,889 token,分别是VanillaRAG的57倍与210倍。
深入分析发现,GGraphRAG的成本源于两个“过度设计”:
- 检索所有社区(而非相关社区):即便90%的社区与问题无关,仍需逐一处理;
- 完整社区报告(而非关键信息):社区报告包含大量冗余描述,未针对抽象QA任务精简。
这种“为性能牺牲成本”的设计,使其在实际应用中难以落地——即便在高性能硬件上,也无法满足实时响应需求(如客服、实时分析场景)。


3. 新方法CheapRAG:低成本下的性能保持
为解决GGraphRAG的成本问题,提出CheapRAG,核心优化思路是“精准筛选+信息精简”:
- 向量检索筛选社区:用向量搜索从所有社区中筛选Top-10相关社区,而非处理全部;
- 社区报告+文本块关键句:提取社区报告的核心观点(约300 token/社区),结合原始文本块的关键句,而非完整内容;
- 保留Map-Reduce策略:确保筛选后的信息能有效整合,不丢失全面性。
实验结果显示,CheapRAG实现了“成本大幅降低,性能接近GGraphRAG”:在MultihopSum数据集上,token消耗从353,889降至3,784(降低100倍),时间从521秒降至54秒(降低9.6倍);而在“全面性”与“启发性”维度,其胜率仅比GGraphRAG低3%-5%,完全满足实际应用需求。更重要的是,CheapRAG在“多样性”维度表现更优——因融入原始文本块关键句,避免了GGraphRAG的观点单一问题。

跨场景补充分析:影响GraphRAG性能的共性因素
除上述场景化实验外,还针对“文本块质量”“基础LLM模型”“图结构特性”三个跨场景因素展开补充实验,结果进一步验证了GraphRAG落地的关键注意事项。
1. 文本块质量:比方法选型更基础的影响因素
对比“专家分块”(按语义完整性分割)与“规则分块”(按1200 token分割)的数据集性能,结果如图15所示。所有方法在规则分块数据集上的性能均下降,其中依赖TKG/RKG的方法(如LGraphRAG)下降最明显——在ALCE数据集上,STRREC从28.448%降至21.408%,原因是规则分块可能拆分完整语义单元,导致实体关系提取错误,进而影响图结构质量。这表明:在落地GraphRAG前,优先优化数据预处理,专家分块或LLM辅助分块(校验语义完整性)的投入,远胜于后续更换复杂方法。

2. 基础LLM模型:性能的“放大器”而非“救世主”
将基础模型从Llama 3-8B更换为Llama 3-70B后,所有方法的性能均提升8%-15%(如表12所示),但方法间的相对优劣不变——VGraphRAG仍为SOTA,G-retriever仍表现不佳。例如在MultihopQA上,VGraphRAG的准确率从59.664%提升至67.567%,RAPTOR从56.064%提升至63.028%。这说明更强的LLM能更好地整合GraphRAG提供的结构化信息,但无法弥补方法本身的设计缺陷。因此,资源有限时,优先匹配“方法与场景”,再考虑升级LLM。

3. 图结构特性:稀疏性是常态,质量比规模更重要
对不同数据集的图结构规模统计,如表13所示,发现两个规律:
- 图结构普遍稀疏:KG、TKG、RKG的边数与节点数比例通常低于1.5,远低于段落图(PG)的340(如HotpotQA数据集),原因是LLM提取实体关系时易遗漏潜在关联;
- 图规模与性能无强关联:PopQA数据集的KG节点数(260,202)是MultihopQA(35,953)的7倍,但性能反而更低,说明“图的质量(实体关系准确性)比规模更重要”。这为图构建优化提供了方向:未来需研究“轻量级图质量评估指标”,提前筛选优质图结构,避免无效规模扩张。

04、实践指南:不同场景该选哪种GraphRAG?
结合实验结论,整理了一份实用选型指南:
|
应用场景 |
推荐方法 |
核心优势 |
注意事项 |
|
简单事实查询(如"XX事件的时间") |
RAPTOR |
检索高效,成本低 |
适合专家分块的数据集 |
|
复杂多跳推理(如"XX技术如何影响XX行业的XX环节") |
VGraphRAG |
结合实体关系与社区信息,推理能力强 |
需平衡tokens消耗 |
|
抽象概括任务(如"总结AI在教育领域的应用趋势") |
CheapRAG |
性能接近GGraphRAG,成本可控 |
适合需要快速响应的场景 |
|
轻量级部署(资源有限) |
HLightRAG |
仅依赖实体关系和文本块,成本低 |
抽象任务性能一般 |
|
未经过专家分块的数据集 |
Vanilla RAG |
保留原始文本块,减少噪声影响 |
复杂问题性能不足 |
另外还有两个实践小贴士:
- 优先使用BGE-M3等先进的文本编码器,实验证明它能显著提升索引的检索准确性;
- 对于大型数据集,可采用RAPTOR-K(K-means聚类替代高斯混合模型),在保证性能的同时降低训练时间。
05、未来方向:GraphRAG还有哪些潜力可挖?
研究还指出了几个极具价值的研究方向,也为开发者提供了创新思路:
- 动态知识源适配:当前方法假设语料库静态,但实际中维基百科、行业报告等都在实时更新,如何设计增量式图更新机制是重要课题;
- 图质量评估与优化:目前没有好的方法提前评估图的质量,很多图存在冗余实体或缺失关系,需要低成本的图质量评估指标;
- 隐私保护GraphRAG:金融、医疗等领域的语料库敏感,如何在保护隐私的同时保留图结构的语义信息,是落地的关键;
- 异构知识源支持:现有方法局限于文本,未来可扩展到PDF、表格、HTML等多源数据,构建跨模态图结构。
06、总结
GraphRAG通过将文本语料转换为图结构,有效解决了传统RAG难以捕捉信息关联的问题,在复杂推理和抽象概括任务中表现突出。港中文深圳与华为云团队的这项研究,不仅提供了统一的评估框架,更通过大规模实验为实践提供了明确指导——按问题类型和数据特点选择合适的图结构、算子组合和生成策略,是GraphRAG成功落地的关键。
随着CheapRAG等高效方法的出现,GraphRAG的落地成本大幅降低,相信在不久的将来,GraphRAG会成为LLM应用中解决"幻觉"问题、提升答案可信度的可落地技术。
如果你想更深入地学习大模型,以下是一些非常有价值的学习资源,这些资源将帮助你从不同角度学习大模型,提升你的实践能力。
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
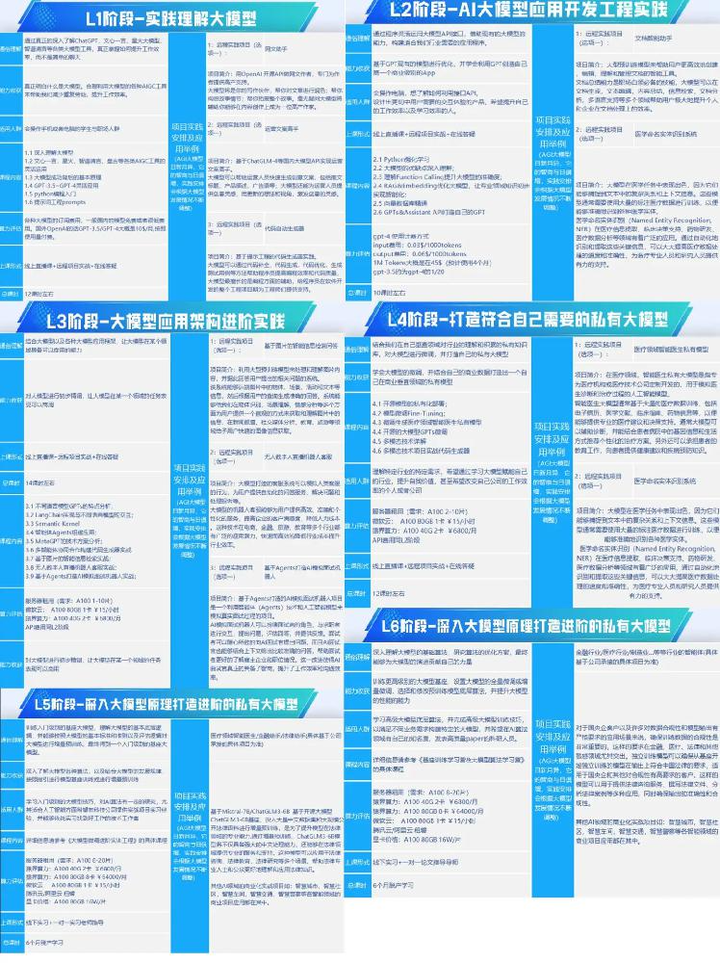
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
四、AI大模型商业化落地方案
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1577


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


