



一. 冒泡排序:每一趟确定一个最大值
1. 单趟冒泡在做什么?
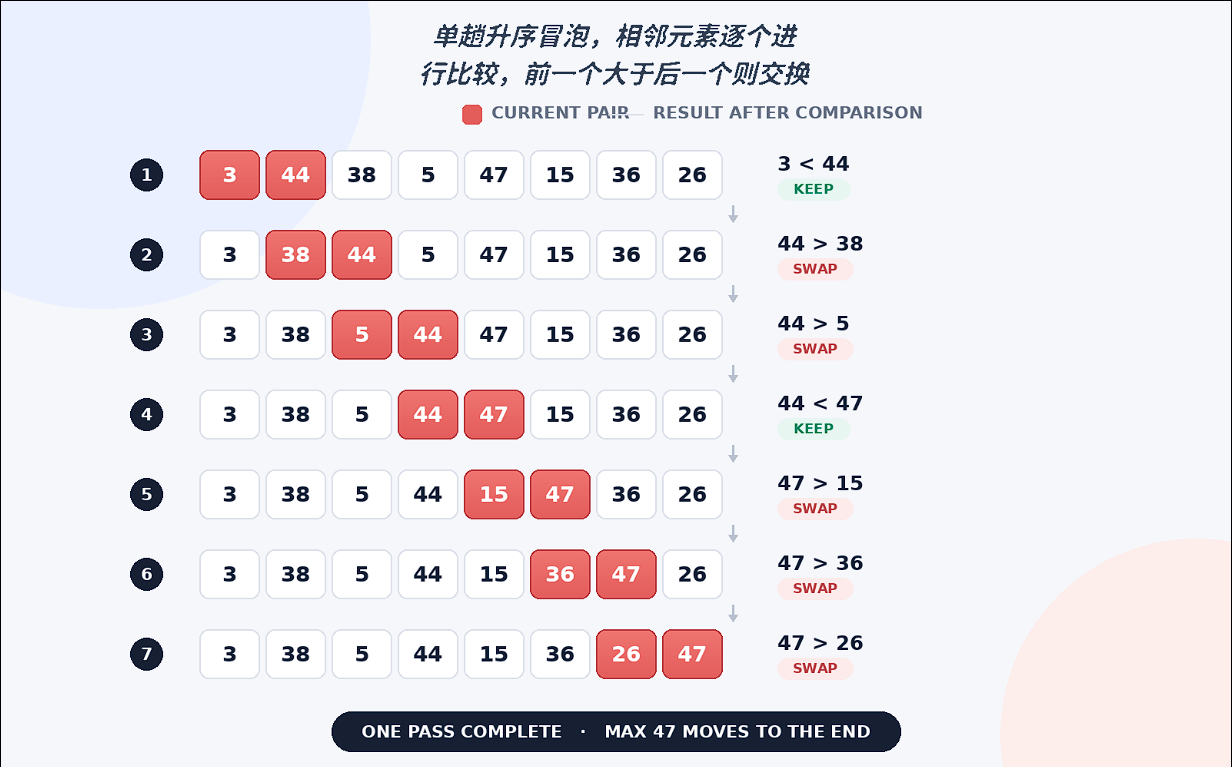
从左向右比较每一对相邻元素。如果前一个元素大于后一个元素,说明这两个元素构成逆序对,就
交换它们:若 a[i - 1] > a[i],交换 a[i - 1] 与 a[i]。
一趟扫描结束后,当前未排序区间中的最大元素会移动到最右端,就像气泡上浮到水面。下一趟可以忽略这个已经就位的元素。
单趟冒泡:假设排升序,冒泡的过程是从前往后(或从后往前)两两比较相邻元素的值,如果逆序(即A[i-1] > A[i])则交换,直到序列中相邻元素比较交换完成,称为⼀趟冒泡。
如图所示:
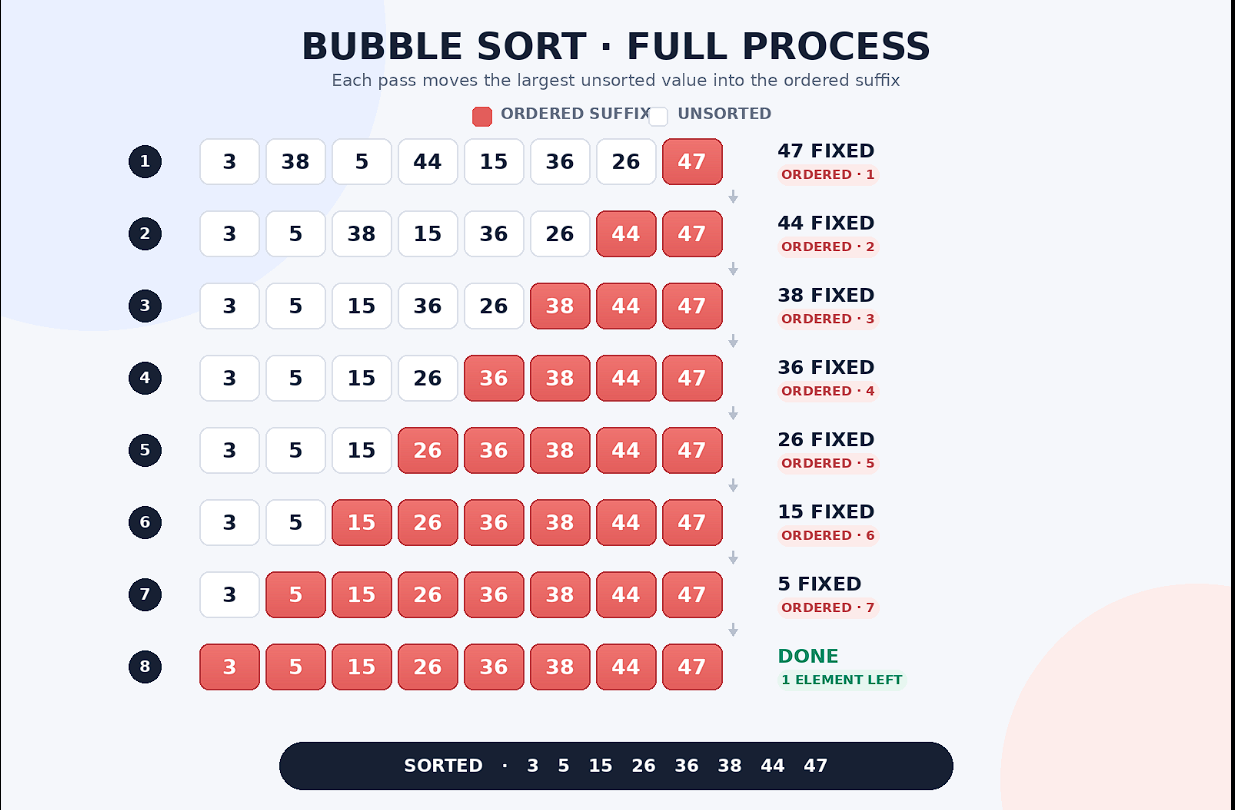
整体冒泡:假设排升序,⼀趟冒泡结束后,会将最⼤元素放在区间最后,即最大元素已经排列好。 下⼀趟冒泡可以对除最大元素外的子序列从前往后继续冒泡,结束后次大元素就可以排列好。以此 类推,共趟冒泡后序列就排好了。注意最后⼀趟区间中只有⼀个元素,本趟冒泡可以不需要,因此是n-1趟冒泡过程。
如图:
代码块:
void BubbleSort(int* a, int n)
{
    for (int j = 0; j < n - 1; ++j)
    {
        // 每一趟开始前,默认本趟没有发生交换
        int flag = 0;

        // 单趟冒泡:
        // 将当前未排序区间中的最大元素移动到末尾
        // 后面的 j 个元素已经有序,不需要再次比较
        for (int i = 1; i < n - j; ++i)
        {
            if (a[i - 1] > a[i])
            {
                int tmp = a[i - 1];
                a[i - 1] = a[i];
                a[i] = tmp;

                // 本趟发生过交换
                flag = 1;
            }
        }

        // 如果某一趟没有发生任何交换,
        // 说明不存在相邻逆序对,整个序列已经有序,
        // 后续的冒泡没有必要继续进行,可以立即结束
        if (flag == 0)
        {
            break;
        }
    }
}

void TestQuickSort()
{
    int a[] = { 23,44,38,5,47,15,36,26,27,2 };

    PrintArray(a, sizeof(a) / sizeof(int));
    BubbleSort(a, sizeof(a) / sizeof(int));
    PrintArray(a, sizeof(a) / sizeof(int));
}
flag 是冒泡排序的提前结束标记:
- 每一趟开始时设置为
0,表示暂时没有交换。 - 只要发生一次交换,就将其设置为
1。 - 一趟结束后,如果仍然是
0,说明这一趟比较的所有相邻元素都满足前者不大于后者,数组已经完全有序,可以直接退出。
2. 复杂度与稳定性
最好情况:数组已经有序,只扫描一趟,时间复杂度 O(n)。
平均情况:O(n²)。
最坏情况:数组完全逆序,时间复杂度 O(n²)。
额外空间复杂度:O(1)。
稳定性:稳定。
稳定性的关键是只在 a[i - 1] > a[i] 时交换。相等时不交换,相同关键字的记录不会越过彼此。
冒泡排序的主要价值是教学、极小规模数据,以及判断一段数据是否已经有序。实际大规模排序通
常不会把它作为主算法。
二. 快速排序的核心:划分与分治
1. 挖坑法:保存基准值,交替填坑
1.1. 前言
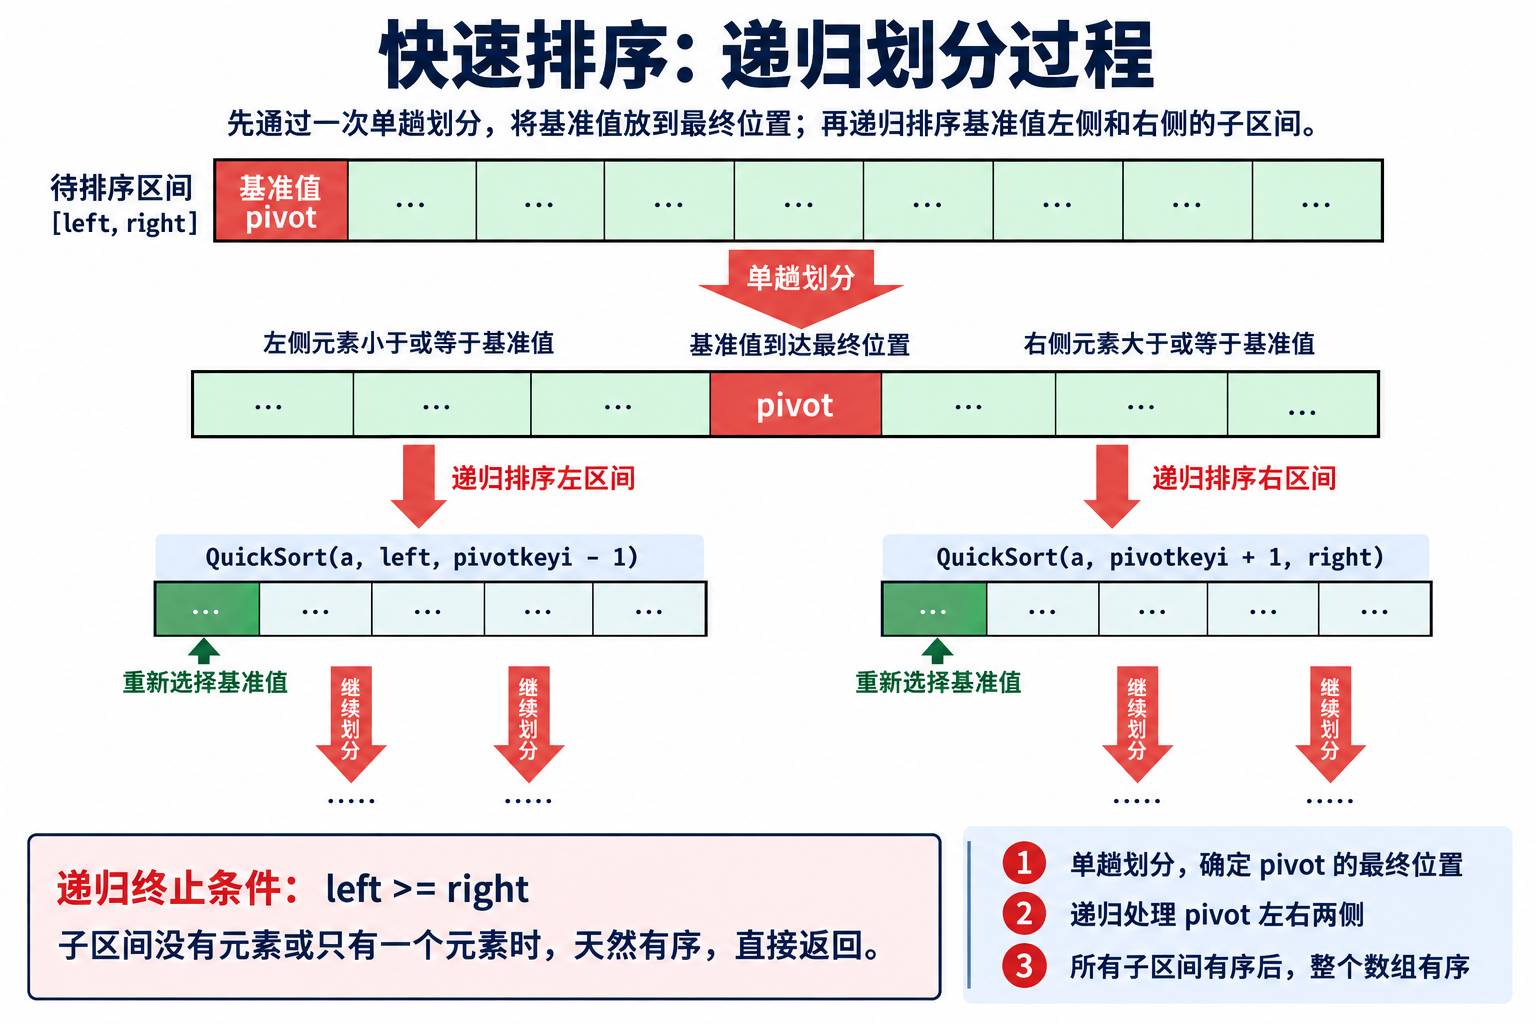
快速排序由 C. A. R. Hoare 于 1960 年提出。它的基本过程是:
1. 从待排序区间选择一个基准值 pivot;
2. 执行一次划分,使较小元素位于一侧、较大元素位于另一侧;
3. 递归排序基准值两侧的子区间;
4. 子区间有序后,整个区间自然有序。
如图:
伪代码可以写成:
void QuickSort(int* a, int left, int right)
{
    // 递归出口:
    // 当区间中没有元素或只有一个元素时,
    // 该区间已经有序,不需要继续划分
    if (left >= right)
    {
        return;
    }

    // 使用挖坑法进行单趟划分
    // 划分完成后,基准值位于 pivotkeyi 位置
    int pivotkeyi = PartitionDigHole(a, left, right);

    // 此时数组被划分为:
    // [left, pivotkeyi - 1]  pivotkeyi  [pivotkeyi + 1, right]
    //       左区间             基准值             右区间

    // 递归排序基准值左侧区间
    QuickSort(a, left, pivotkeyi - 1);

    // 递归排序基准值右侧区间
    QuickSort(a, pivotkeyi + 1, right);
}
如图:
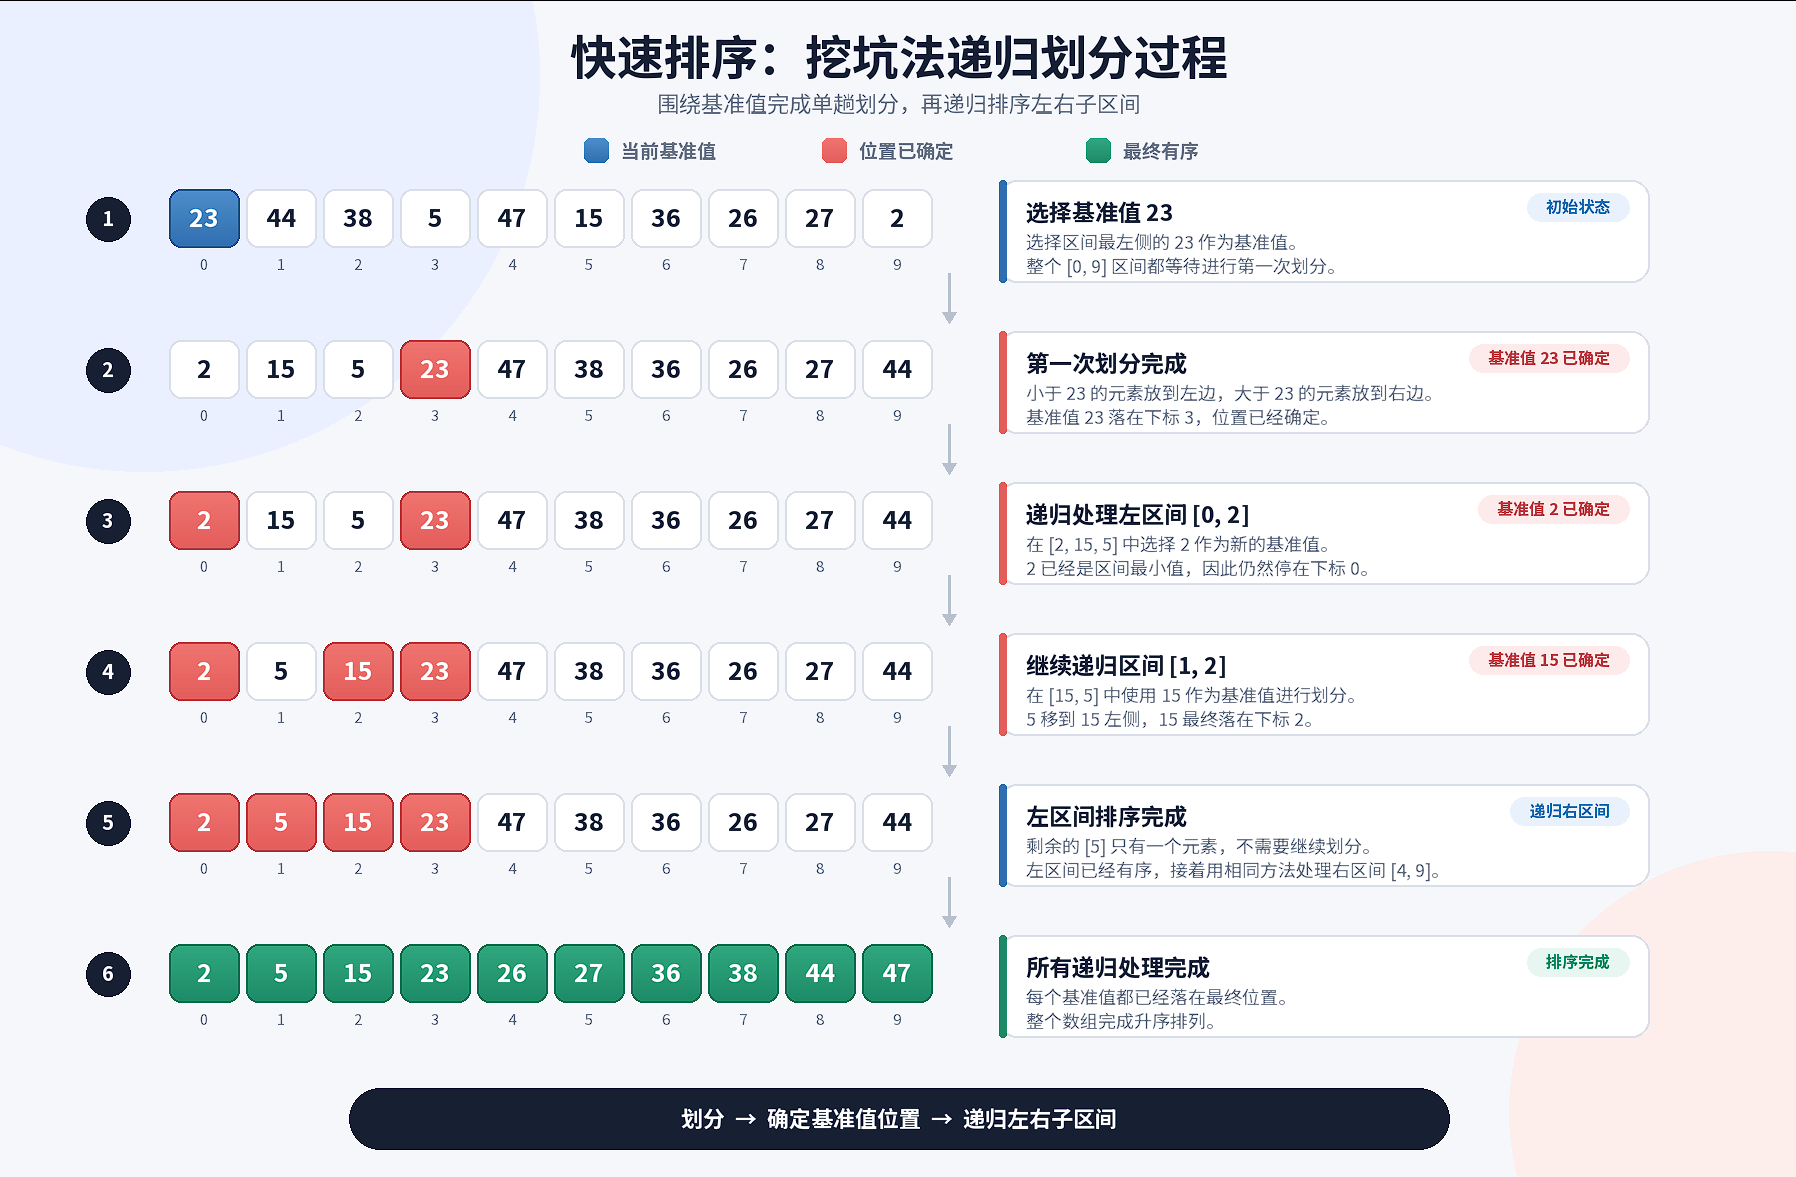
如图:
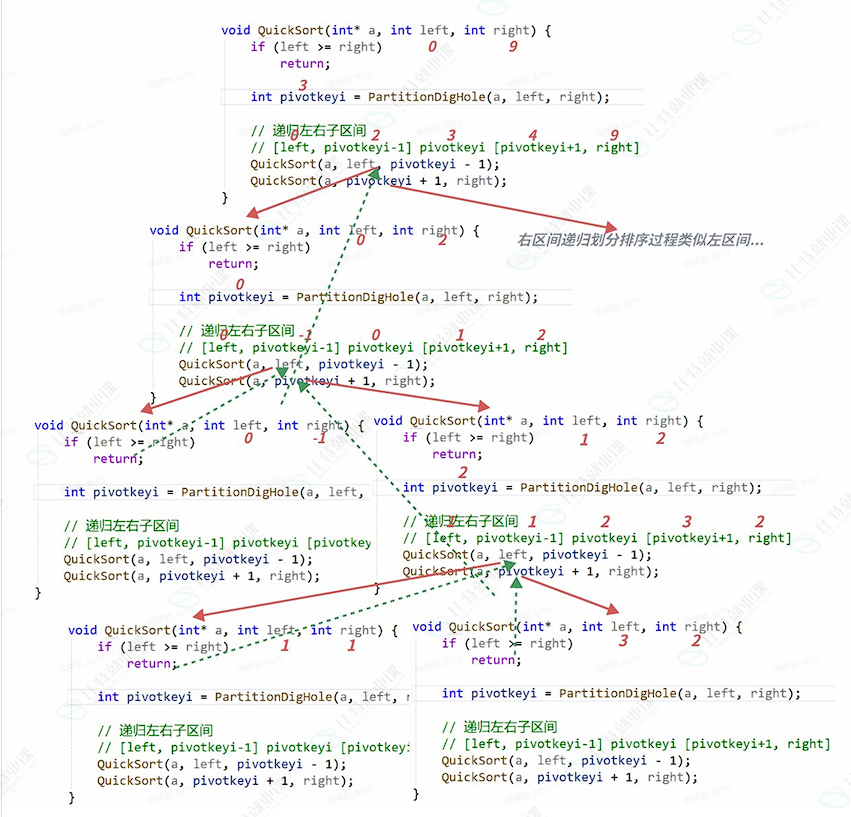
快速排序真正困难的地方不是递归,而是“划分函数返回什么”。不同划分方法的返回语义不同,递归区间也必须配套使用。把挖坑法、Lomuto 和 Hoare 的递归边界混在一起,是最常见的快排错误之一。
1.2. 思想与不变量
思想:
先保存最左端元素作为 pivot,于是最左端形成一个“坑”。
从右向左找第一个小于 pivot 的元素,把它填入左侧坑,右侧位置成为新坑;
再从左向右找第一个大于 pivot 的元素,把它填入右侧坑,左侧位置成为新坑;
左右指针相遇时,把保存的 pivot 填入最后的坑。
结束后,pivot 位于最终位置;左侧元素不大于它,右侧元素不小于它。
单趟实例流程图:
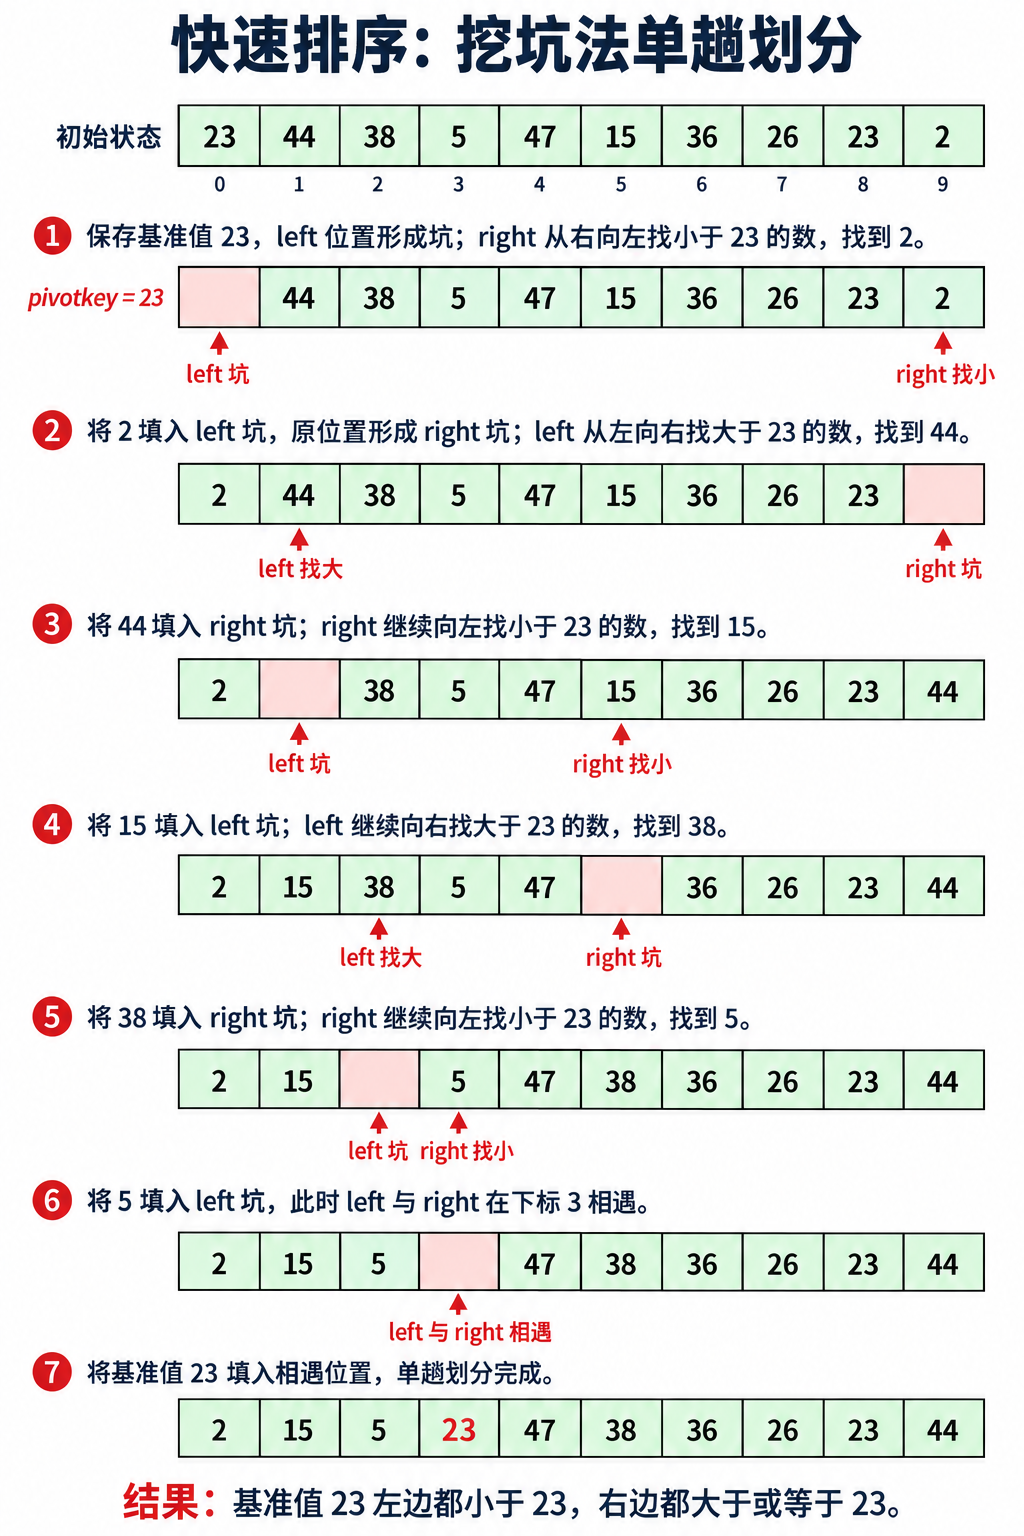
然后我们再递归处理基准值的左区间和右区间,即可完成排序。
代码块:
// 挖坑法
int PartitionDigHole(int* a, int left, int right)
{
    // 保存基准值,left 位置形成第一个坑
    int pivotkey = a[left];
    // left 与 right 相遇时结束
    // 相遇的位置一定是一个坑
    while (left < right)
    {
        // 右边找小:从右向左寻找小于基准值的元素
        while (left < right && a[right] >= pivotkey)
        {
            --right;
        }

        // 将右边较小的元素放入左边的坑
        // 此时 right 位置形成新的坑
        a[left] = a[right];

        // 左边找大:从左向右寻找大于基准值的元素
        while (left < right && a[left] <= pivotkey)
        {
            ++left;
        }

        // 将左边较大的元素放入右边的坑
        // 此时 left 位置形成新的坑
        a[right] = a[left];
    }

    // left 与 right 相遇,将基准值填入最后的坑
    a[left] = pivotkey;

    // 返回基准值最终所在的下标
    return left;
}

void QuickSort(int* a, int left, int right)
{
    // 区间中没有元素或只有一个元素,不需要排序
    if (left >= right)
    {
        return;
    }

    // 使用挖坑法进行一次划分
    int pivotkeyi = PartitionDigHole(a, left, right);

    // 如果想使用 Lomuto 法,则改为:
    // int pivotkeyi = PartitionLomuto(a, left, right);

    // 递归排序基准值左侧区间:
    // [left, pivotkeyi - 1]
    QuickSort(a, left, pivotkeyi - 1);

    // 递归排序基准值右侧区间:
    // [pivotkeyi + 1, right]
    QuickSort(a, pivotkeyi + 1, right);
}
测试代码:
void TestQuickSort()
{
    int a[] = {23, 44, 38, 5, 47, 15, 36, 26, 27, 2};
    int size = sizeof(a) / sizeof(int);

    // 排序前
    PrintArray(a, size);

    // 快速排序
    QuickSort(a, 0, size - 1);

    // 排序后
    PrintArray(a, size);
}
注意事项:
<1>.两个内层循环都必须带 left < right,否则指针可能越过边界。比较符号中的等号也不能随意删掉否则在大量重复值场景下可能停滞。
<2>.挖坑法返回的是“基准值最终位置”,因此递归时应排除 `pivotIndex`。
2. Lomuto 划分:一个扫描指针,一个边界指针
Lomuto 通常选择最右端元素作为基准值。
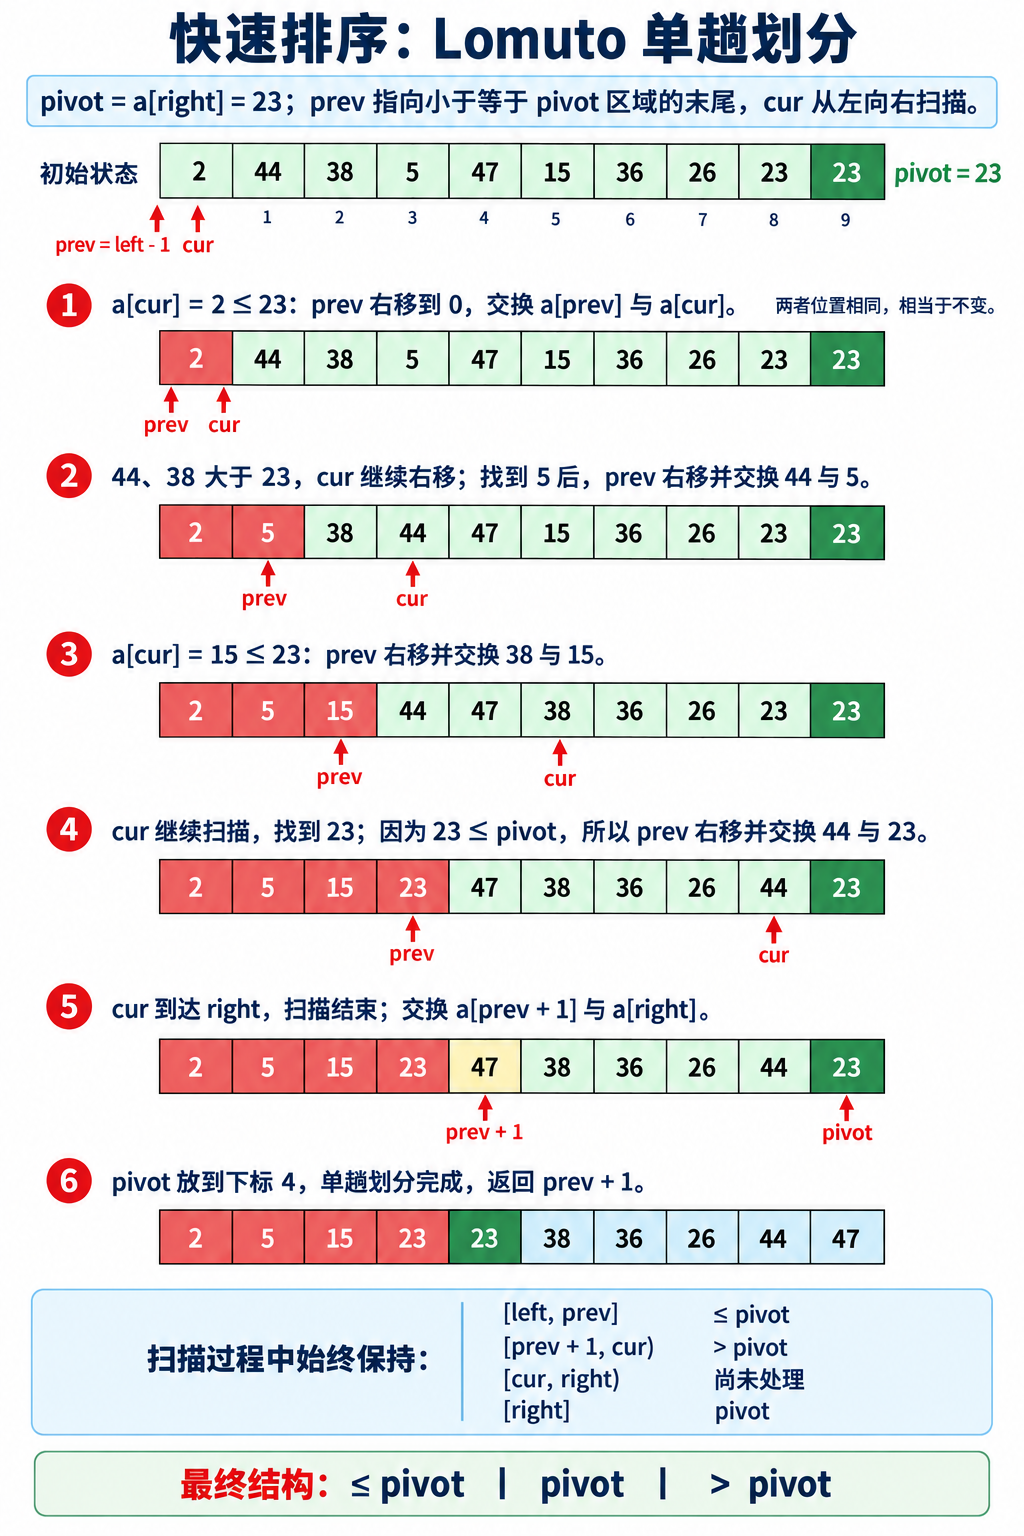
可以把 cur 和 prev 理解成:
cur:探路指针,负责从左向右检查元素。prev:边界指针,指向“<= pivot区域”的最后一个元素。
假设选择最右边的元素作为基准值:
int pivot = a[right];
初始状态:
int prev = left - 1;
此时还没有发现小于等于 pivot 的元素,所以左侧区域为空。
扫描过程:
cur 从 left 一直扫描到 right - 1:
for (int cur = left; cur < right; ++cur)
扫描过程中,数组始终被划分成四个区域:
[left, prev]       <= pivot
[prev + 1, cur)    >  pivot
[cur, right)       尚未处理
[right]            pivot
核心就是判断 a[cur] 属于哪个区域。
<1>.情况一:a[cur] > pivot
这个元素本来就应该放在较大区域,所以不需要交换,只让 cur 继续向右走:
cur++;
区域变化:
大于 pivot 的区域扩大一个位置
<2>.情况二:a[cur] <= pivot
说明当前元素应该放到左侧的小元素区域。
执行:
++prev;
swap(a[prev], a[cur]);
含义是:
++prev:将小于等于区域扩大一个位置。- 交换:把当前找到的小元素放进这个新位置。
如果 prev == cur,相当于元素本来就在正确区域,自己和自己交换,不影响结果。
流程图:
代码块:
void Swap(int* x, int* y)
{
    int tmp = *x;
    *x = *y;
    *y = tmp;
}
int PartitionLomuto(int* a, int left, int right)
{
    int pivot = a[right];
    int prev = left - 1;

    for (int cur = left; cur < right; ++cur)
    {
        if (a[cur] <= pivot)
        {
            ++prev;
            if (prev != cur)
                Swap(&a[prev], &a[cur]);
        }
    }

    Swap(&a[prev + 1], &a[right]);
    return prev + 1;
}

void QuickSortLomuto(int* a, int left, int right)
{
    if (left >= right)    return;

    int pivotIndex = PartitionLomuto(a, left, right);
    QuickSortLomuto(a, left, pivotIndex - 1);
    QuickSortLomuto(a, pivotIndex + 1, right);
}
测试代码:
void TestQuickSort()
{
    int a[] = { 2,44,38,5,47,15,36,26,23,23 };

    PrintArray(a, sizeof(a) / sizeof(int));
    //PartitionLomuto(a, 0, sizeof(a) / sizeof(int) - 1);
    QuickSort(a, 0, sizeof(a) / sizeof(int) - 1);
    PrintArray(a, sizeof(a) / sizeof(int));
}
Lomuto 的优点是逻辑清晰、容易证明;缺点是交换次数可能较多,对大量重复元素的处理通常不如 Hoare 或三路划分。
与挖坑法一样,它返回的是基准值最终位置,所以递归区间排除该位置。
3. Hoare 划分:左右指针向中间逼近
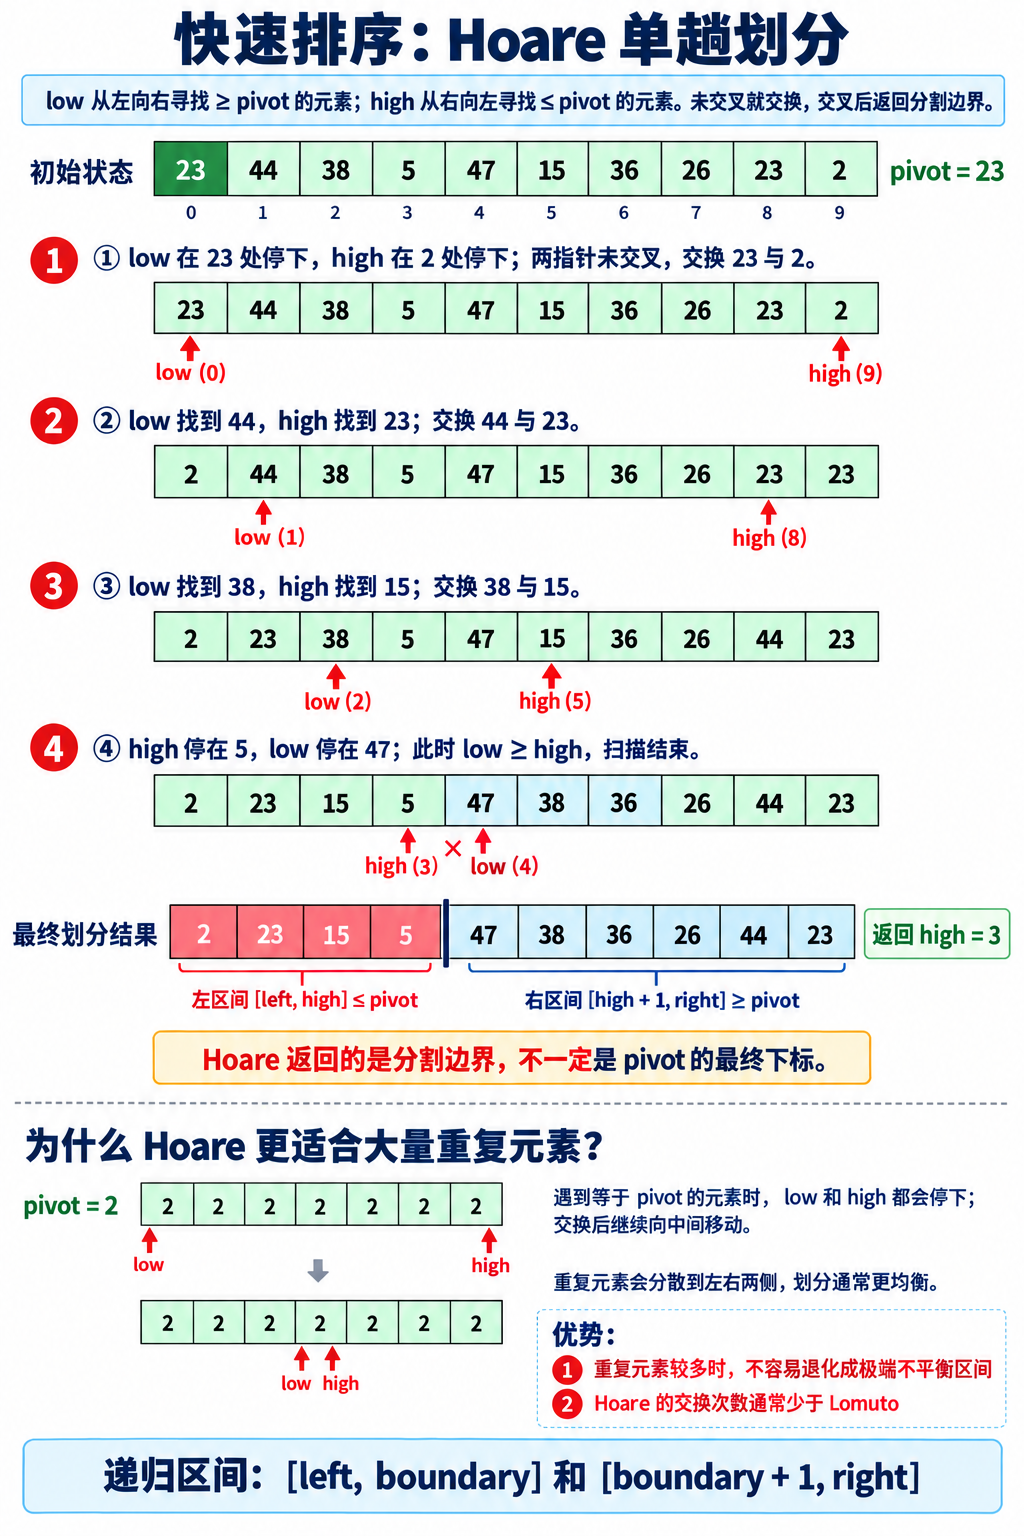
Hoare 划分从两端向中间扫描:
左右各派一个指针,把放错区域的两个元素找出来并交换,直到两个指针相遇或交叉。
假设选择中间位置的元素作为基准值:
int pivot = a[left + (right - left) / 2];
两个指针的任务
i:从左向右找 >= pivot 的元素
j:从右向左找 <= pivot 的元素
为什么找这两种元素?
- 左边最终应该主要放
<= pivot的元素,所以>= pivot的元素可能放错了。 - 右边最终应该主要放
>= pivot的元素,所以<= pivot的元素可能放错了。 - 找到两个放错位置的元素后,交换它们。
扫描过程
初始化:
int i = left - 1;
int j = right + 1;
每轮执行:
do
{
    ++i;
} while (a[i] < pivot);  // 左边寻找 >= pivot

do
{
    --j;
} while (a[j] > pivot);  // 右边寻找 <= pivot
注意这里的停止条件:
i 停下来时:a[i] >= pivot
j 停下来时:a[j] <= pivot
然后判断指针是否交叉:
if (i >= j)
{
    return j;
}
如果还没有交叉,就交换:
swap(a[i], a[j]);
流程图:
代码块:
// Hoare 划分:左右指针从两端向中间移动
int PartitionHoare(int* a, int left, int right)
{
    // 选择区间的第一个元素作为基准值
    int pivotkey = a[left];

    // low 从区间左侧向右寻找
    // high 从区间右侧向左寻找
    int low = left - 1;
    int high = right + 1;

    while (true)
    {
        // 从左向右寻找第一个大于等于 pivotkey 的元素
        do
        {
            ++low;
        } while (a[low] < pivotkey);

        // 从右向左寻找第一个小于等于 pivotkey 的元素
        do
        {
            --high;
        } while (a[high] > pivotkey);

        // 两个指针相遇或交叉,划分结束
        // high 是左右两个区间的分界位置
        if (low >= high)
            return high;

        // 此时:
        // a[low]  >= pivotkey,应该放到右边
        // a[high] <= pivotkey,应该放到左边
        Swap(&a[low], &a[high]);
    }
}

void QuickSortHoare(int* a, int left, int right)
{
    // 区间没有元素或者只有一个元素时,已经有序
    if (left >= right)
        return;
    // 对当前区间进行一次 Hoare 划分
    int pivoti = PartitionHoare(a, left, right);
    QuickSortHoare(a, left, pivoti);
    QuickSortHoare(a, pivoti + 1, right);
}
测试代码:
void TestQuickSort()
{
    int a[] = {23, 44, 38, 5, 47, 15, 36, 26, 23, 2};
    int n = sizeof(a) / sizeof(int);

    PrintArray(a, n);

    QuickSortHoare(a, 0, n - 1);

    PrintArray(a, n);
}
Hoare 划分通常交换更少,对重复元素也比较友好。但它的返回语义更容易被误解。若错误地写成 [left, boundary - 1]和 [boundary + 1, right],可能漏掉元素;若把返回值当成已就位的基准下标,也会造成逻辑错误。
4. 复杂度与稳定性
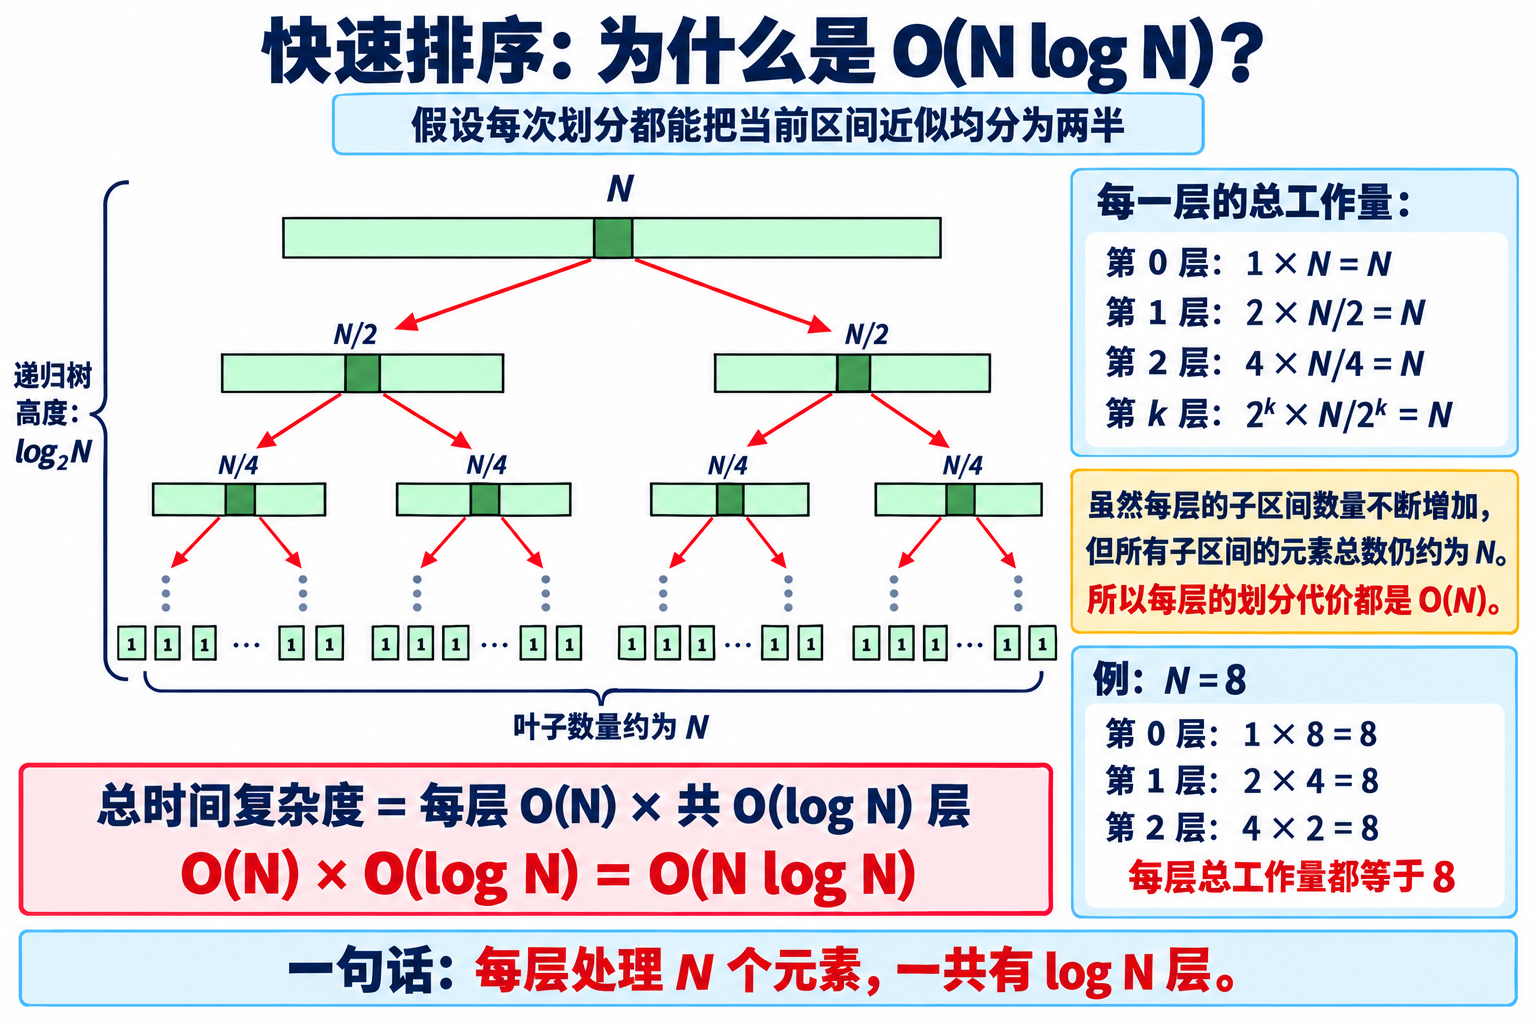
快速排序效率取决于基准值的选取,如果每次选择的基准值恰巧都能将区间中元素分割成左右⼏乎 相等的两部分,快排的效率会达到最优,整个递归过程展开近似⼀颗平衡⼆叉树。整体而言对每⼀ 层序列进行划分为O(N),递归的深度为logn,因此最好情况时间复杂度为O(nlogn),空间复杂度 O(logn)。
如图:
快速排序效率取决于基准值的选取,如果每次选择的基准值恰巧是区间的最小值或最大值(有序时就 会),快排的效率会达到最坏,n个数据的区间被划分为n-1个和0个的子区间,整体划分是⼀个1到n 的等差数列,因此最坏情况时间复杂度为O(n^2 ),空间复杂度 O(n )。
快速排序无法保持稳定性。如: {2,2,2,2,2} 单趟划分以后相对顺序就乱了。
5.基准值选择:避免“逢有序必退化”
1. 随机选择基准值
在 [left, right] 内随机选一个位置,与预定基准位置交换,再执行原划分。随机化无法改变理论最坏复杂度,但能让固定输入难以稳定触发最坏情况。
int pivotIndex = left + rand() % (right - left + 1);
实际工程中应使用质量合适的随机源,并避免在每次递归中重复播种。测试代码可在最外层调用一次 srand。
2. 三数取中
取区间左端、中间和右端三个元素的中位数作为基准。对于已经升序或降序的数据,它能避免总选到极值。
int MedianOfThreeIndex(const int* a, int left, int right)
{
    int mid = left + (right - left) / 2;

    if (a[left] < a[mid]) {
        if (a[mid] < a[right])
            return mid;
        return a[left] < a[right] ? right : left;
    }

    if (a[left] < a[right])
        return left;
    return a[mid] < a[right] ? right : mid;
}
三数取中不是“保证每次都均分”,但成本很低,能处理不少常见坏输入。
6. 大量重复元素:三路划分
三路划分会在一次扫描中,把区间分成三个部分:
< pivot | == pivot | > pivot
这样,等于 pivot 的所有元素会一次性移动到中间。这个中间区间已经有序,不需要继续递归。
<1>.扫描过程
使用三个指针:
less:小于 pivot 区域的下一个位置
cur:当前正在检查的位置
greater:大于 pivot 区域的前一个位置
扫描过程中维持:
[left, less)        < pivot
[less, cur)         == pivot
[cur, greater]      尚未处理
(greater, right]    > pivot
对于当前元素 a[cur],存在三种情况。
<2>.a[cur] < pivot
把它放入左侧的小元素区域:
swap(a[less], a[cur]);
++less;
++cur;
<3>.a[cur] == pivot
当前位置本来就属于中间区域,只需要让 cur 继续向右移动:
++cur;
<4>.a[cur] > pivot
把它交换到右侧的大元素区域:
swap(a[cur], a[greater]);
--greater;
这里不能立即执行 ++cur,因为从右侧交换过来的元素还没有检查,需要下一轮继续判断。
划分完成
当:
cur > greater
说明所有元素都已经处理完毕,此时数组形成:
[left, less - 1]       < pivot
[less, greater]        == pivot
[greater + 1, right]   > pivot
递归时只需要处理:
左区间:[left, less - 1]
右区间:[greater + 1, right]
中间等于 pivot 的区间:
[less, greater]
不需要继续递归。
代码块:
void QuickSortThreeWay(int* a, int left, int right)
{
    if (left >= right)
        return;
    int pivot = a[left];
    int less = left;       // 小于 pivot 区域的右边界
    int cur = left + 1;    // 当前检查的位置
    int greater = right;   // 大于 pivot 区域的左边界

    while (cur <= greater)
    {
        if (a[cur] < pivot)
        {
            Swap(&a[less], &a[cur]);
            ++less;
            ++cur;
        }
        else if (a[cur] > pivot)
        {
            Swap(&a[cur], &a[greater]);
            --greater;
        }
        else
        {
            ++cur;
        }
    }
    // [left, less - 1]       < pivot
    // [less, greater]        == pivot
    // [greater + 1, right]   > pivot
    QuickSortThreeWay(a, left, less - 1);
    QuickSortThreeWay(a, greater + 1, right);
}
当所有元素都相等时,一次扫描即可把整个区间归入 == pivot,后续无需递归;这比不断生成极不平衡二路分区高效得多。
7. 内省排序:发现快排不妙就及时换算法
即使随机选基准,理论上仍可能出现持续不平衡的划分。内省排序(introspective sort,简称 introsort)采用“自我检测”的混合策略:
1. 默认使用快速排序,获得优秀的平均性能;
2. 监控递归深度;
3. 当深度超过约 2 * floor(log₂n) 时,认为快排可能正在退化,切换到堆排序;
4. 当子区间很小时,切换到直接插入排序,减少递归和划分常数开销。
这样可以同时获得:
快速排序良好的平均性能;
堆排序 `O(n log n)` 的最坏时间保证;
插入排序处理小区间的低开销。
C++ 标准库中的 std::sort 通常采用以 introsort 为核心的实现思路,但具体细节由标准库实现决定。
内省排序体现了一个重要工程思想:不存在必须从头用到尾的“唯一算法”。可以根据运行状态在算法之间切换,让不同算法各自在最擅长的阶段工作。
结语:
交换排序的学习重点不只是会写两段代码。冒泡排序让我们看到,局部相邻交换可以逐步消除逆序;快速排序则进一步说明,只要一次划分能建立正确的不变量,分治就能把全局问题拆成独立子问题。
掌握快速排序时,应牢记四件事:
1. 划分函数的返回语义决定递归边界;
2. 基准值质量决定递归树是否均衡;
3. 大量重复值应优先考虑三路划分;
4. 工程实现要同时考虑时间退化和栈深度风险。
从最朴素的冒泡到内省排序,真正进步的不是代码越来越长,而是算法开始主动识别输入特征,并在合适时机选择更合适的策略。


 扫一扫


 1313


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


