

淘天一面已过,二面面经:QS200留学生的AI Agent岗通关复盘
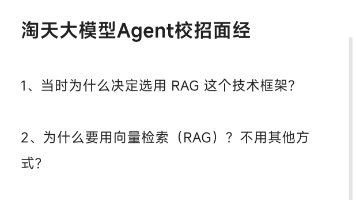
我重点讲了我们是如何分层设计的。数据清洗层(PDF解析、OCR、表格结构化)、Embedding层(采用了BGE-large-v1.5结合Query改写)、检索层(ES向量检索+重排模型BGE-Reranker)、生成层(基于Qwen-7B的接入)。核心思路是为了解决高精度问答场景,我们不仅做了Naive RAG,还引入了Self-RAG机制,让模型在生成过程中自我评估检索结果的有效性,以降低幻觉。面试结束的那一刻,我长舒一口气。