


OLTP的三个范式
-1-第一范式 1NF 数据原子性(不可分割性)
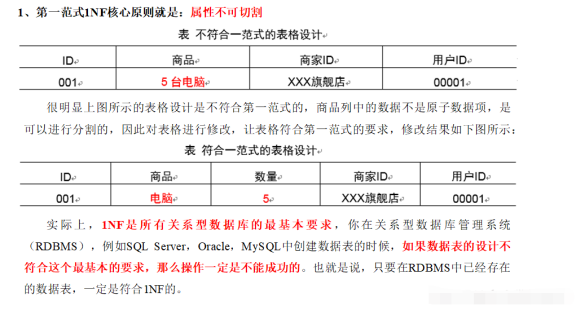
-2-第二范式(2NF) “消除部分函数依赖”
它要求在第一范式(1NF,即数据原子性)的基础上,确保表中的所有非主属性(字段)必须完全依赖于整个主键(所有的主键),而不能只依赖于主键的一部分。
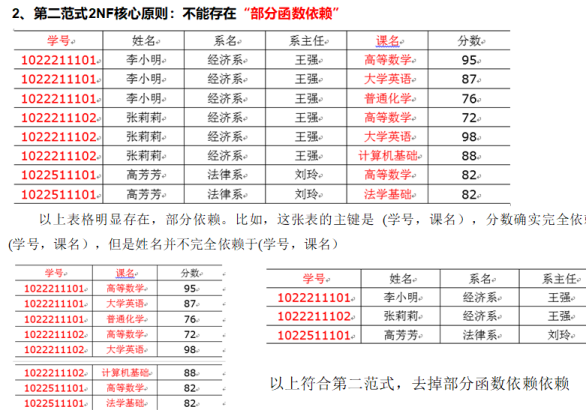
姓名以及 姓名、系名、系主任这个组合只依赖于学号这个主键,与课程名无关。毕竟,学生姓名不会因为选了什么课就跟着变吧?
因此把上面这一个表拆成两个表
-3-第三范式 不能存在传递函数依赖
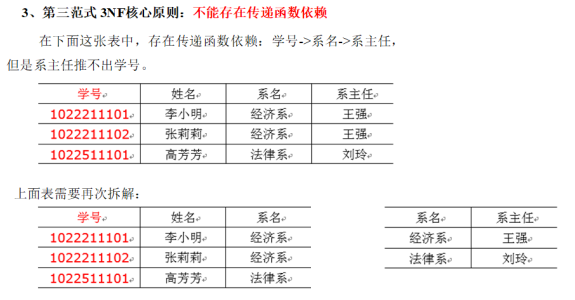
这里第一个table系名依赖于学号,但是系主任是直接依赖于系名,而不是依赖于学号的。存在学号->系名->系主任的传递性依赖,也就是说所以的非主键列,只能依赖于主键 学号,不能依赖于 主键 学号 之外的其他非主键列 如系名
官方定义
一个关系模式满足2NF,且所有非主属性都不传递依赖于任何候选键。
人话解释
-
表中的每一列都要直接依赖于主键,不能依赖于其他非主键列
比如在这里系主任这一列,依赖于系名这个非主键列。因为这样一种情况:学生学号不同,但是系主任的名字相同。这是因为系主任是谁,取决于系名是什么,而不是学号一变系主任就变了。 -
消除字段间的传递依赖关系
-
目标是:一个字段只描述一个实体的一种属性
第三范式广泛使用于OLTP事务型数据库,是因为以下几个理由
-
无数据冗余
——系主任这一列不需要在多个表上显示,只在系名-系主任这个table上显示。避免了系主任这一列重复记录在多个表上,减少了数据存储的浪费。 -
更新只需修改一处
——因为每个表内部的非主键都不存在依赖关系。比如系主任换了,只需要修改 系名-系主任 这一张表。 -
适合频繁增删改的OLTP系统
——增删改这些对数据进行 增 减 修改只动一个表,而不是多个表,速度更快。
缺点:
-
查询需要多表连接,性能差
——所以在OLAP数据库,为了减少多表连接,直接将常用的列拼在一起,组成一个大宽表
-
不适合分析型查询
OLTP的设计要点
减少每个表上的数据冗余,让每个表格上的列尽可能的少(第二范式,所有数据必须完全依赖于所有的主键,不依赖于所有主键的列全部移除;不依赖于主键的列 找到他们的主键,单独建表 ;第三范式:有传递性依赖的拿出去单独建表)
让增删改操作涉及的表尽可能的少,甚至只涉及一张表。从而提升增删改查的性能。
三、银行数仓:故意违反3NF!
在数仓中,我们反其道而行之,使用维度建模,故意引入“冗余”:
银行数仓的典型设计(星型模型)
-- 事实表:交易事实(存储业务过程度量值)
CREATE TABLE fact_transactions (
    tx_id          BIGINT,
    tx_date_key    INT,         -- 日期维度代理键
    tx_time_key    INT,         -- 时间维度代理键
    account_key    INT,         -- 账户维度代理键
    branch_key     INT,         -- 支行维度代理键
    customer_key   INT,         -- 客户维度代理键
    product_key    INT,         -- 产品维度代理键
    channel_key    INT,         -- 渠道维度代理键
    -- 度量值(数值型)
    amount         DECIMAL(15,2),
    fee            DECIMAL(10,2),
    balance_after  DECIMAL(15,2),
    -- 退化维度(为了减少连接)
    tx_type        VARCHAR(10),  -- 直接冗余,避免连接维度表
    tx_status      VARCHAR(10)
) PARTITIONED BY (dt STRING);

-- 维度表:客户维度(违反3NF!包含大量冗余信息)
CREATE TABLE dim_customer (
    customer_key   INT PRIMARY KEY,
    -- 自然键
    cust_id        VARCHAR(20),
    -- 客户基本信息(层次关系,违反3NF)
    cust_name      VARCHAR(100),
    cust_type      VARCHAR(20),     -- 个人/企业
    -- 人口统计信息(可单独成表,但冗余在此)
    age            INT,
    gender         CHAR(1),
    education      VARCHAR(50),
    occupation     VARCHAR(50),
    income_level   VARCHAR(20),
    -- 联系信息(可单独成表,但冗余在此)
    mobile         VARCHAR(11),
    email          VARCHAR(100),
    address        VARCHAR(200),
    city           VARCHAR(50),
    province       VARCHAR(50),
    zip_code       VARCHAR(10),
    -- 风险信息
    risk_level     CHAR(1),
    credit_score   INT,
    -- 时间信息
    create_date    DATE,
    update_date    DATE,
    is_current     BOOLEAN,         -- SCD Type 2标记
    start_date     DATE,
    end_date       DATE
);
s
-- 维度表:支行维度(包含地理层级信息)
CREATE TABLE dim_branch (
    branch_key     INT PRIMARY KEY,
    branch_code    VARCHAR(10),
    branch_name    VARCHAR(100),
    -- 地理层级(违反3NF!本应分开存储)
    branch_level   VARCHAR(20),      -- 总行/分行/支行/网点
    parent_branch  VARCHAR(10),      -- 上级机构代码
    region         VARCHAR(50),      -- 大区
    province       VARCHAR(50),
    city           VARCHAR(50),
    address        VARCHAR(200),
    manager        VARCHAR(50),
    -- 业绩属性
    branch_type    VARCHAR(20),      -- 对公/对私/综合
    employee_count INT,
    aum_total      DECIMAL(18,2)     -- 管理资产总额
);
四、为什么银行数仓要违反3NF?
核心原因:更新性能 vs 查询性能
| 考虑维度 | OLTP核心系统(3NF) | 数仓(反范式化) |
|---|---|---|
| 主要操作 | 大量INSERT/UPDATE/DELETE | 大量SELECT查询 |
| 性能关键 | 写性能、数据一致性 | 读性能、查询速度 |
| 数据规模 | GB~TB级,当前数据 | TB~PB级,历史数据 |
| 典型查询 | 按主键查询单条记录 | 多维度聚合、复杂连接 |
| 用户数量 | 数千银行柜员 | 数百分析师/决策者 |
-- 场景:分析各支行2024年1月的交易情况

-- 3NF方式(需要5表连接)
SELECT
    b.branch_name,
    c.province,
    EXTRACT(MONTH FROM t.tx_date) as month,
    SUM(t.amount) as total_amount,
    COUNT(*) as tx_count
FROM transactions t
JOIN accounts a ON t.account_no = a.account_no
JOIN branches b ON a.branch_code = b.branch_



 扫一扫


 6150

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


