【干货收藏】告别AI“失忆“!LangChain与Manus联合揭秘上下文工程的满分解决方案

一文解读Manus AI核心功能与技术原理 Manus是由中国团队Monica.im于2025年3月5日发布的全球首款通用型AI Agent(智能体)产品,在权威的GAIA基准测试中性能超越OpenAI同类产品。产品定位Manus定位于"手脑并用"(拉丁语Mens et Manus),采用多代理架 构模拟人类工作流(Plan-Do-Check-Act),成本仅为同类产品的十分之一。 用户只需输入简单指令,即可获得接近实用状态的报告或文档。 本文重点介绍Manus AI的核心功能和技术原理! 阅读详情

前言

一句话总结:
当AI智能体越用越慢、开始“失忆”,不是模型不行,而是它的“记忆”乱了。
本文揭秘LangChain与Manus两位顶尖团队如何用五大策略,驯服失控的上下文,让智能体始终保持清醒、高效、精准。

一、警报拉响:你的AI正在“失忆”

你有没有遇到这种情况?

  • 智能体一开始思路清晰,但跑着跑着就开始重复、啰嗦、胡言乱语;
  • 调用几次工具后,它突然忘了自己要干什么;
  • 明明给了正确信息,它却视而不见。

这不是模型“变笨”了,而是它被自己的“记忆”压垮了——这就是当前AI智能体面临的最大隐患:上下文腐烂(Context Rot)。

🚨 什么是上下文腐烂?

简单说:智能体记得太多,反而不会思考了。

每次调用工具、生成思考、接收反馈,这些内容都会不断追加到它的“聊天记录”里。一个任务跑几十上百步,上下文动辄几十万Token,模型的注意力被稀释,关键信息被淹没,最终导致性能断崖式下降。

Anthropic的研究显示,当上下文超过200k Token时,模型就开始出现明显退化。
而Manus的实际数据显示,一个典型任务平均需要50次工具调用——这还只是中等复杂度任务。

这就形成了一个死循环:

智能体越聪明,做的事越多 → 上下文越长 → 模型越卡 → 行为越蠢

怎么破?答案就是:上下文工程(Context Engineering)。


二、上下文工程:给AI做“记忆力管理”

如果说“提示工程”是教AI怎么说话,那“上下文工程”就是教它怎么记住重要的事,忘记无关的噪音。

它不是单一技术,而是一套系统方法论。
LangChain和Manus总结出了五大核心策略,堪称当前最实用的“满分作业”。


✅ 策略1:卸载 —— 把记忆存进“外接硬盘”

不是所有信息都得留在脑子里。
该存文件就存文件,别塞在上下文里。

比如:

  • 网页搜索结果太长?存成search_result.html,只留一句“已保存搜索结果至文件”。
  • 读取大文件?保留路径/data/report.txt,内容不放上下文。

需要时再通过路径读取,既节省Token,又保证信息不丢。

🔍 实战建议:把文件系统当成你的“外接硬盘”,随时存取,轻装上阵。


✅ 策略2:缩减 —— 压缩 vs 总结,别搞混了!

很多人一上来就“总结”,结果丢了关键细节。
Manus的做法更聪明:先压缩,再总结。

🔹 压缩(可逆):删掉能重建的信息
  • 文件写入后,删掉内容,只留路径;
  • 工具调用成功,删掉冗余日志,只留状态。

这些信息随时可以“恢复”,相当于无损压缩。

🔹 总结(不可逆):最后手段,慎用!

只有当上下文快撑爆时才用。
而且Manus有个狠招:先完整存档,再总结,确保万不得已还能翻旧账。

💡 关键洞察:
“你永远不知道哪一步操作会在十步后突然变得重要。”
所以,能不丢就不丢,能可逆就不不可逆。


✅ 策略3:检索 —— 需要时才“唤醒”记忆

与其让AI背下所有历史,不如让它“按需查询”。

Manus的做法很务实:

  • 不搞复杂的向量数据库;
  • 直接用grep、glob在沙盒文件系统里搜;
  • 用户明确说“记住这个”,才存入长期记忆。

简单、高效、可控。

📌 类比:就像你不需要记住所有微信聊天记录,但可以用关键词搜出来。


✅ 策略4:隔离 —— 多智能体,各管一摊

复杂任务怎么办?拆!
用多个子Agent分工协作,每个只负责一块,上下文互不干扰。

Manus借鉴Go语言哲学:

“不要通过共享内存来通信,而要通过通信来共享内存。”

具体分两种模式:

模式适用场景特点
通信模式任务简单,只关心结果主Agent发指令,子Agent轻装上阵
共享模式任务复杂,依赖中间过程子Agent能看到完整上下文,但成本高

⚠️ 提醒:共享上下文会预加载大量数据,浪费Token,非必要不用。


✅ 策略5:缓存 —— 别让AI重复“烧脑”

有些计算很耗资源,比如解析大文件、执行复杂脚本。
如果结果没变,就别每次都重来。

Manus会缓存高频操作的结果,下次直接调用,省时省力。

🧠 类比:你查过一次“北京到上海多少公里”,下次还会再算一遍吗?


三、Manus的杀手锏:分层动作空间

除了上下文管理,Manus还有一个颠覆性设计:分层动作空间。

传统做法是把所有工具都注册成“函数调用”,结果越堆越多,模型容易混淆。

Manus把它分成三层,清晰有序:

🏗️ 第一层:原子操作(函数调用)

  • 读写文件、执行命令、获取时间等基础操作。
  • 数量少,边界清,模型不容易搞混。

🧪 第二层:沙箱工具(命令行)

  • 在独立沙盒中运行CLI工具,比如:
  • ffmpeg 转视频格式
  • sox 处理音频
  • 自定义MCP工具
  • 输出可以直接写文件,不塞上下文。

📦 第三层:代码包与API

  • 写Python脚本调用外部库或API;
  • 适合大数据分析、金融计算等重任务;
  • 数据处理在沙盒内完成,只返回结果。

🔑 核心思想:
从模型角度看,所有操作最终都是“函数调用”。
比如“运行shell命令”是一个函数,“读文件”也是一个函数。
这样既保持接口简洁,又避免上下文爆炸。


四、最重要的经验:别过度工程,相信模型

最后,Peak分享了一个反直觉但极其重要的观点:

我们最大的进步,不是加了什么牛逼功能,而是删了很多东西。

回顾Manus的发展,每一次简化架构,系统反而变得更快、更稳、更聪明。

他们发现:

  • 很多中间层、抽象层其实没必要;
  • 模型本身的能力在快速进化;
  • 越复杂的工程,越容易出问题。

✅ 正确姿势:
少做加法,多做减法;少折腾,多信任。

上下文工程的目标,不是让模型适应复杂的系统,而是让系统适应模型的天然能力。


五、给开发者的实战建议

  1. 别急着微调:先用通用大模型 + 上下文工程,性价比更高。
  2. 优先压缩,慎用总结:能可逆就不不可逆。
  3. 善用文件系统:它是你最好的“外挂存储”。
  4. 结构化输出:让AI填表单,比自由发挥更可靠。
  5. 定期重构:每隔一两个月回头看,能不能更简单?
  6. 评估阈值:实测你的模型在多少Token开始“腐烂”,作为触发机制。

结语:让AI记住该记的,忘记该忘的

真正的智能,不在于记住一切,而在于知道什么值得记住。

上下文工程的本质,是帮AI建立一种“健康的记忆习惯”——
该存的存,该删的删,该查的查,该分的分。

不必追求完美架构,也不必迷信最新技术。
从简单的卸载和压缩开始,逐步迭代,信任模型,回归本质。

这才是通往强大AI智能体的真正捷径。

🌈 项目亮点

  • ✅ 集成 MCP 多智能体架构
  • ✅ 支持 Dify / LangChain / LlamaIndex / Ollama / vLLM / Neo4j
  • ✅ 前端采用 Vue3 + TypeScript + Vite5,现代化交互体验
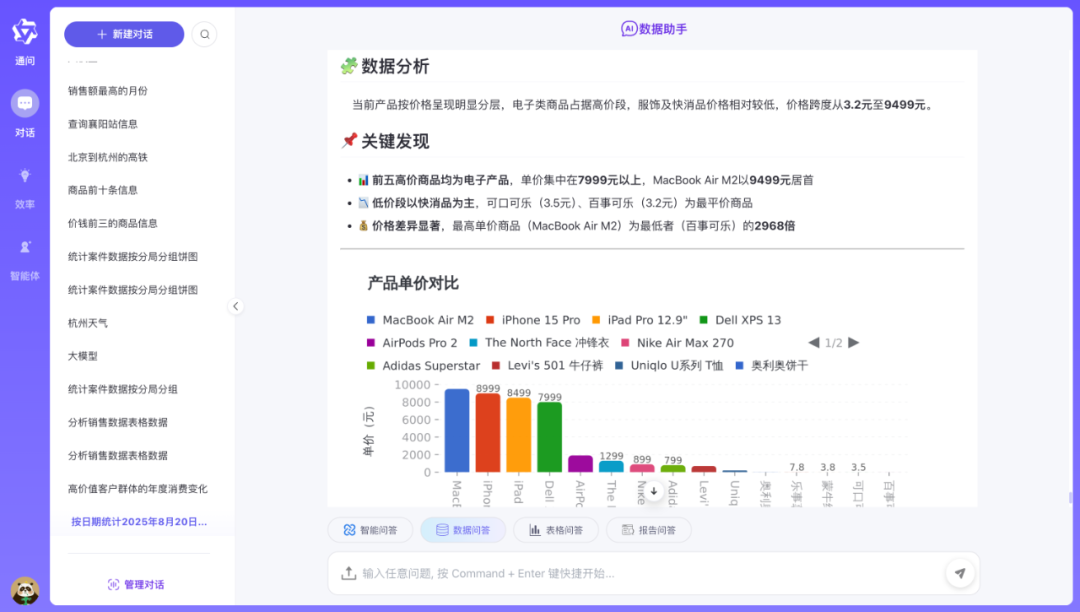
  • ✅ 内置 ECharts / AntV 图表问答 + CSV 表格问答
  • ✅ 支持对接主流 RAG 系统 与 Text2SQL 引擎
  • ✅ 轻量级 Sanic 后端,适合快速部署与二次开发

AntV

运行效果:
最后

为什么要学AI大模型

当下,⼈⼯智能市场迎来了爆发期,并逐渐进⼊以⼈⼯通⽤智能(AGI)为主导的新时代。企业纷纷官宣“ AI+ ”战略,为新兴技术⼈才创造丰富的就业机会,⼈才缺⼝将达 400 万!

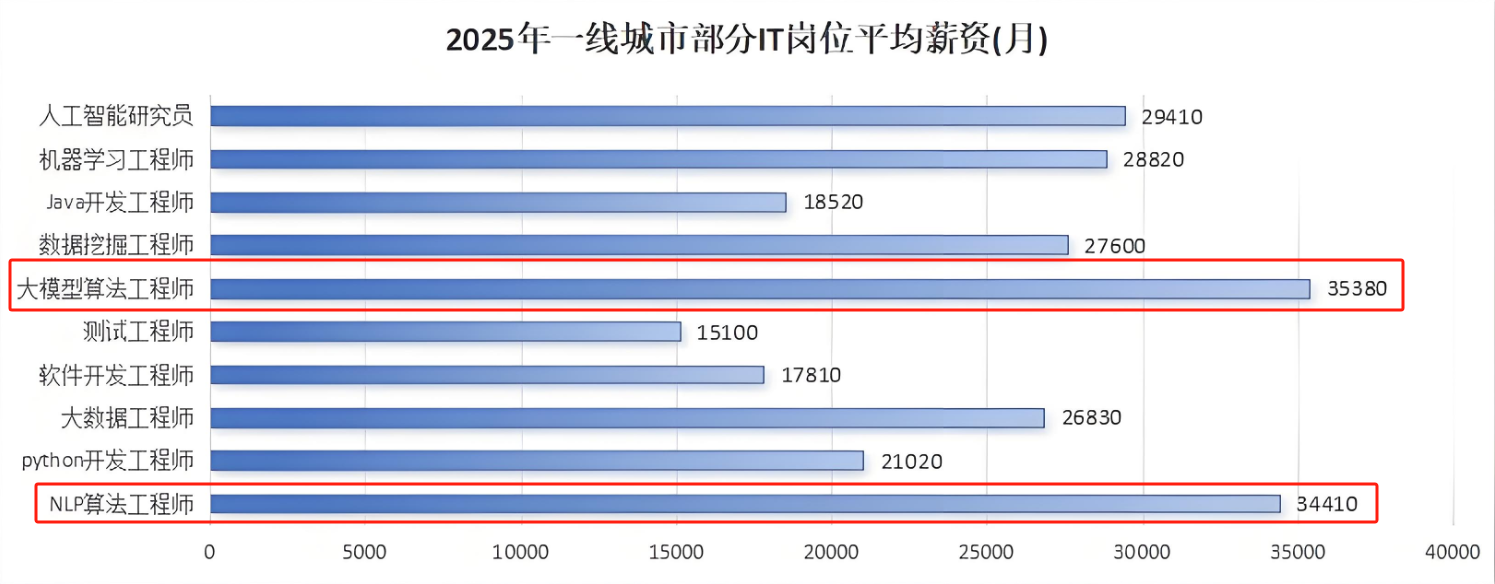
DeepSeek问世以来,生成式AI和大模型技术爆发式增长,让很多岗位重新成了炙手可热的新星,岗位薪资远超很多后端岗位,在程序员中稳居前列。
在这里插入图片描述

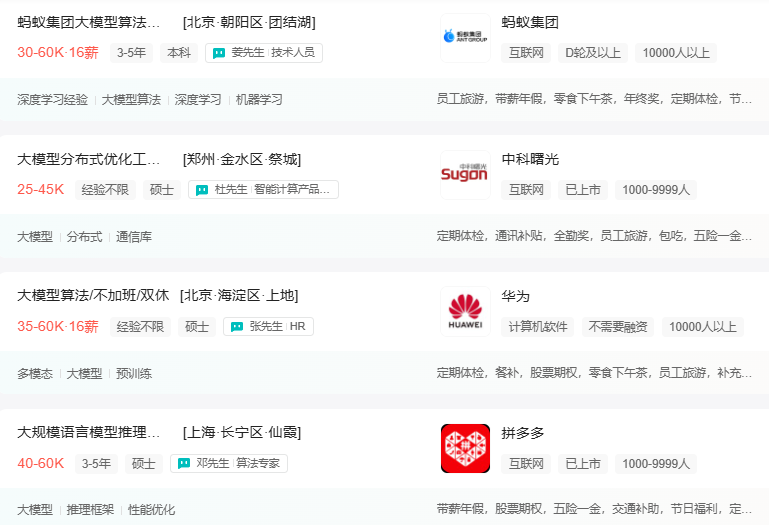
与此同时AI与各行各业深度融合,飞速发展,成为炙手可热的新风口,企业非常需要了解AI、懂AI、会用AI的员工,纷纷开出高薪招聘AI大模型相关岗位。
在这里插入图片描述
最近很多程序员朋友都已经学习或者准备学习 AI 大模型,后台也经常会有小伙伴咨询学习路线和学习资料,我特别拜托北京清华大学学士和美国加州理工学院博士学位的鲁为民老师给大家这里给大家准备了一份涵盖了AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频 全系列的学习资料,这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
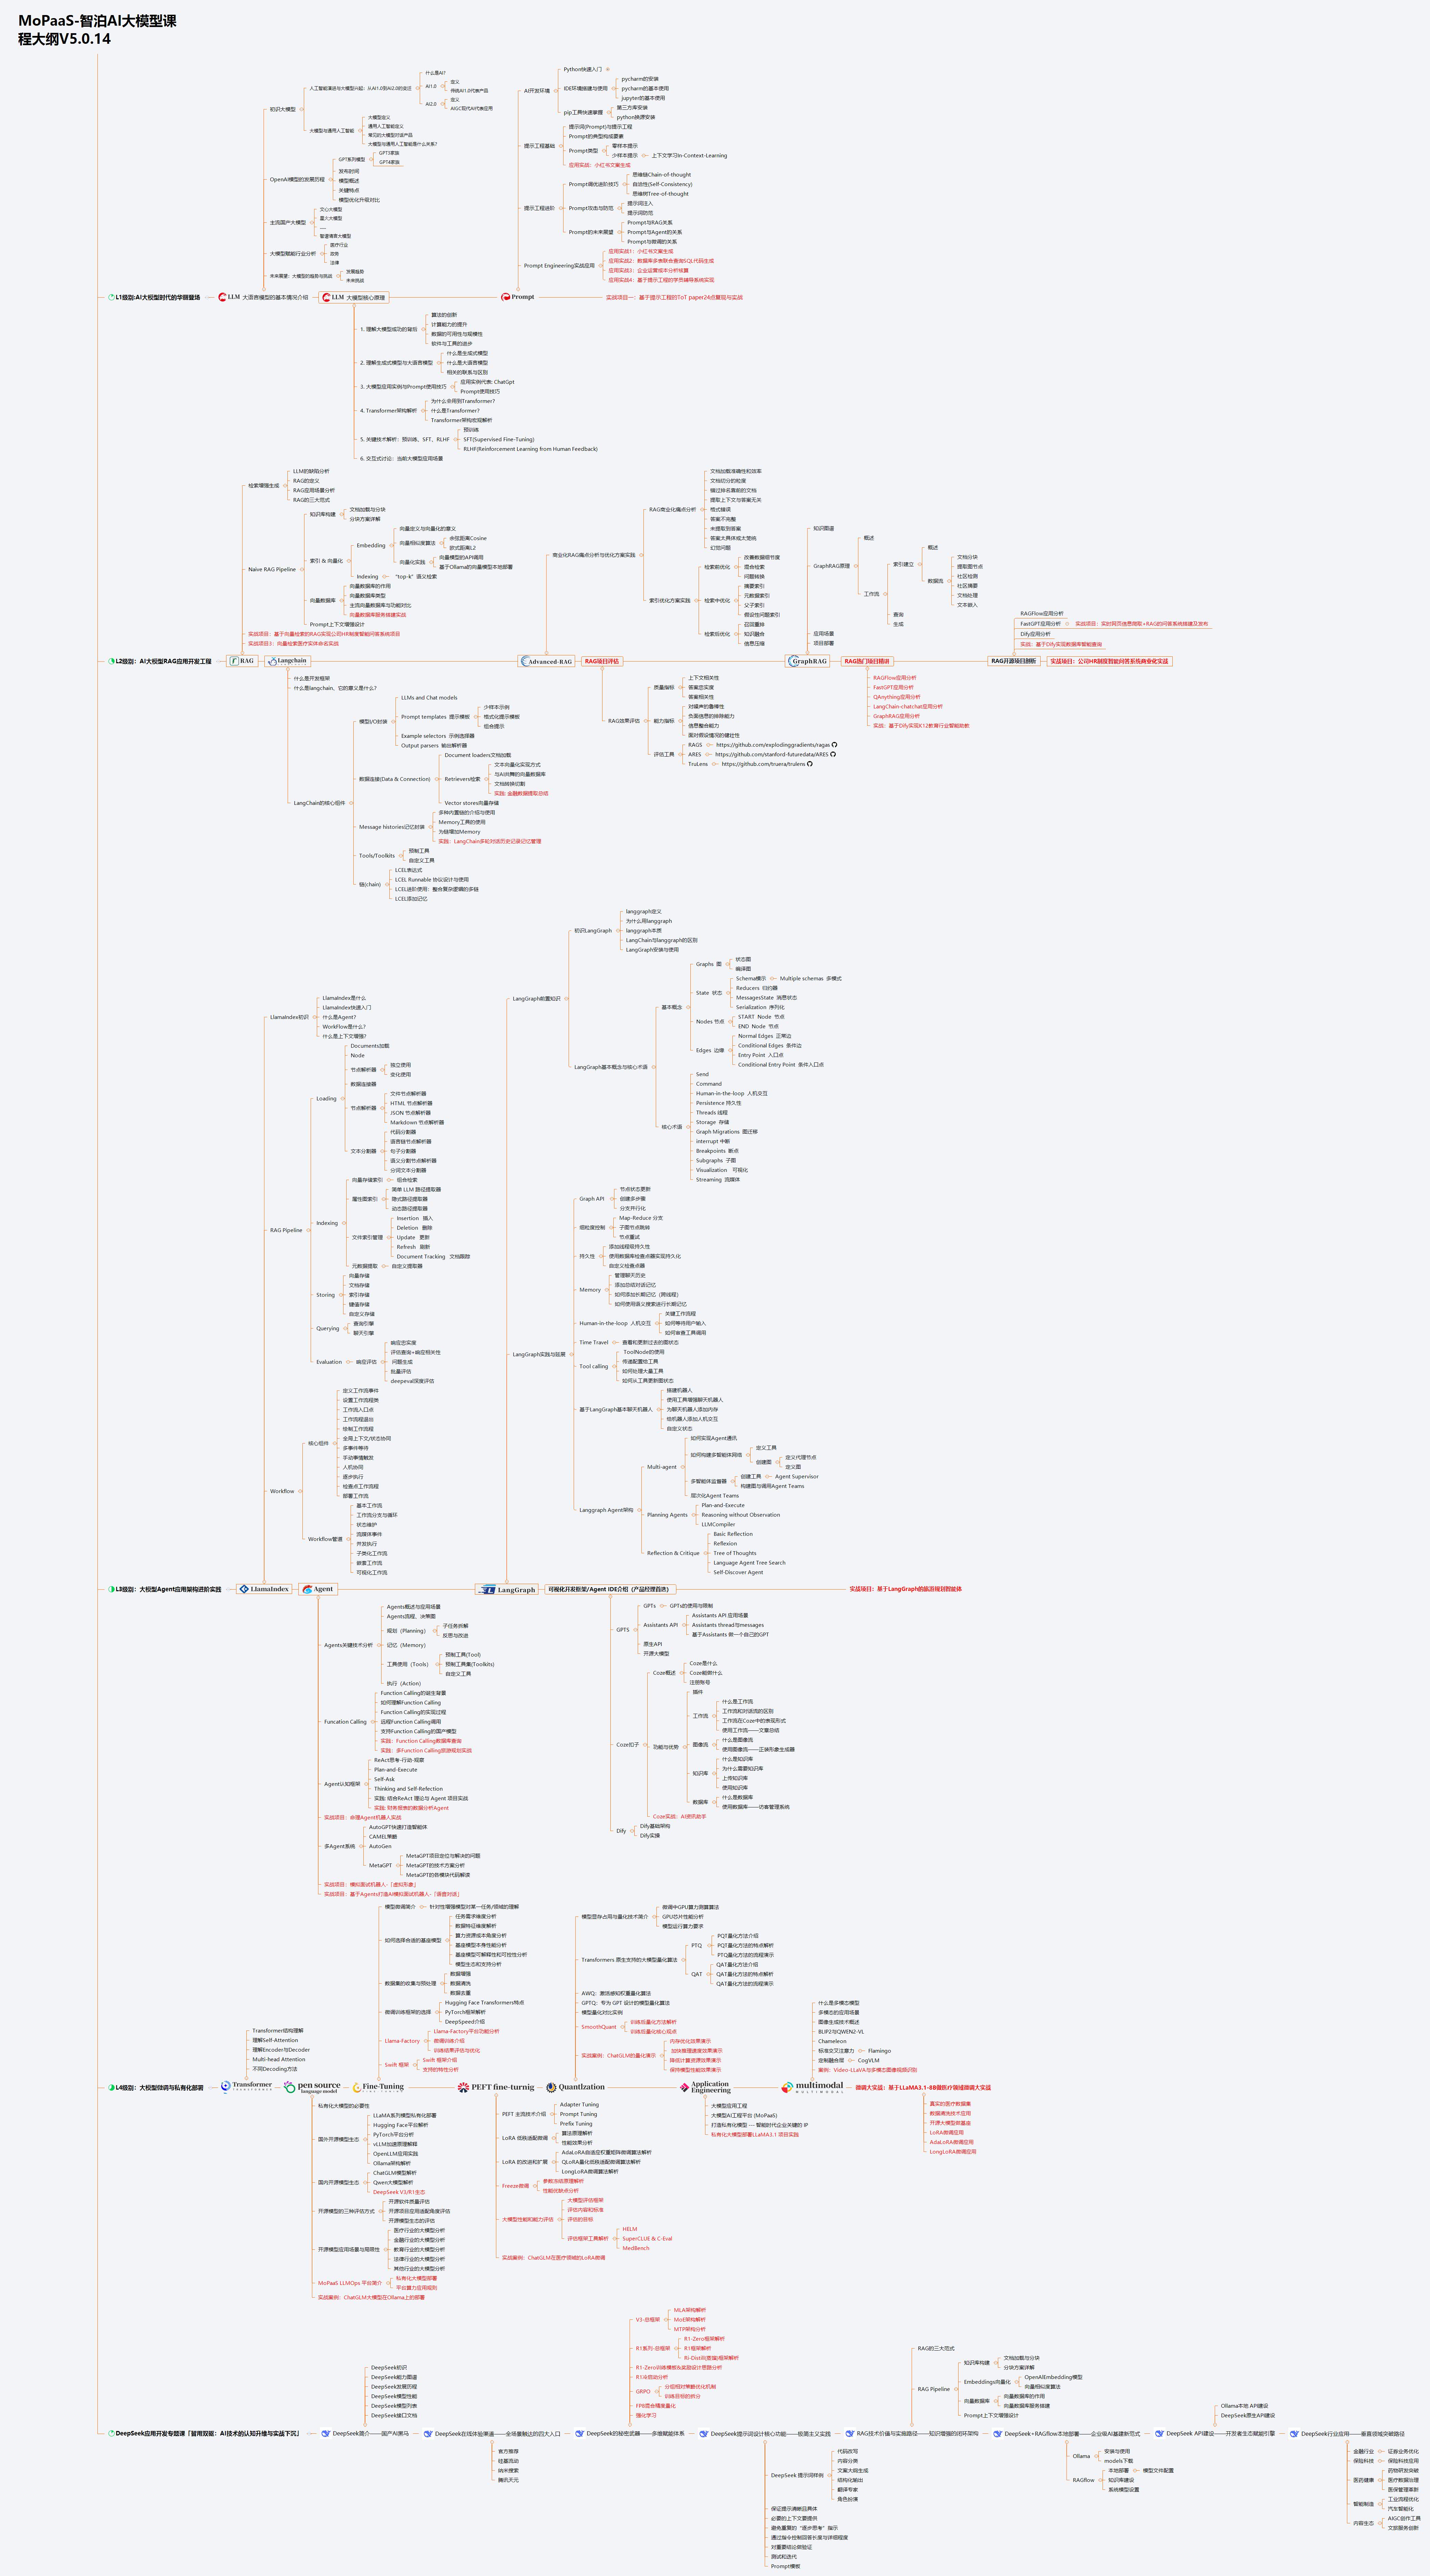
AI大模型系统学习路线

在面对AI大模型开发领域的复杂与深入,精准学习显得尤为重要。一份系统的技术路线图,不仅能够帮助开发者清晰地了解从入门到精通所需掌握的知识点,还能提供一条高效、有序的学习路径。
img

但知道是一回事,做又是另一回事,初学者最常遇到的问题主要是理论知识缺乏、资源和工具的限制、模型理解和调试的复杂性,在这基础上,找到高质量的学习资源,不浪费时间、不走弯路,又是重中之重。

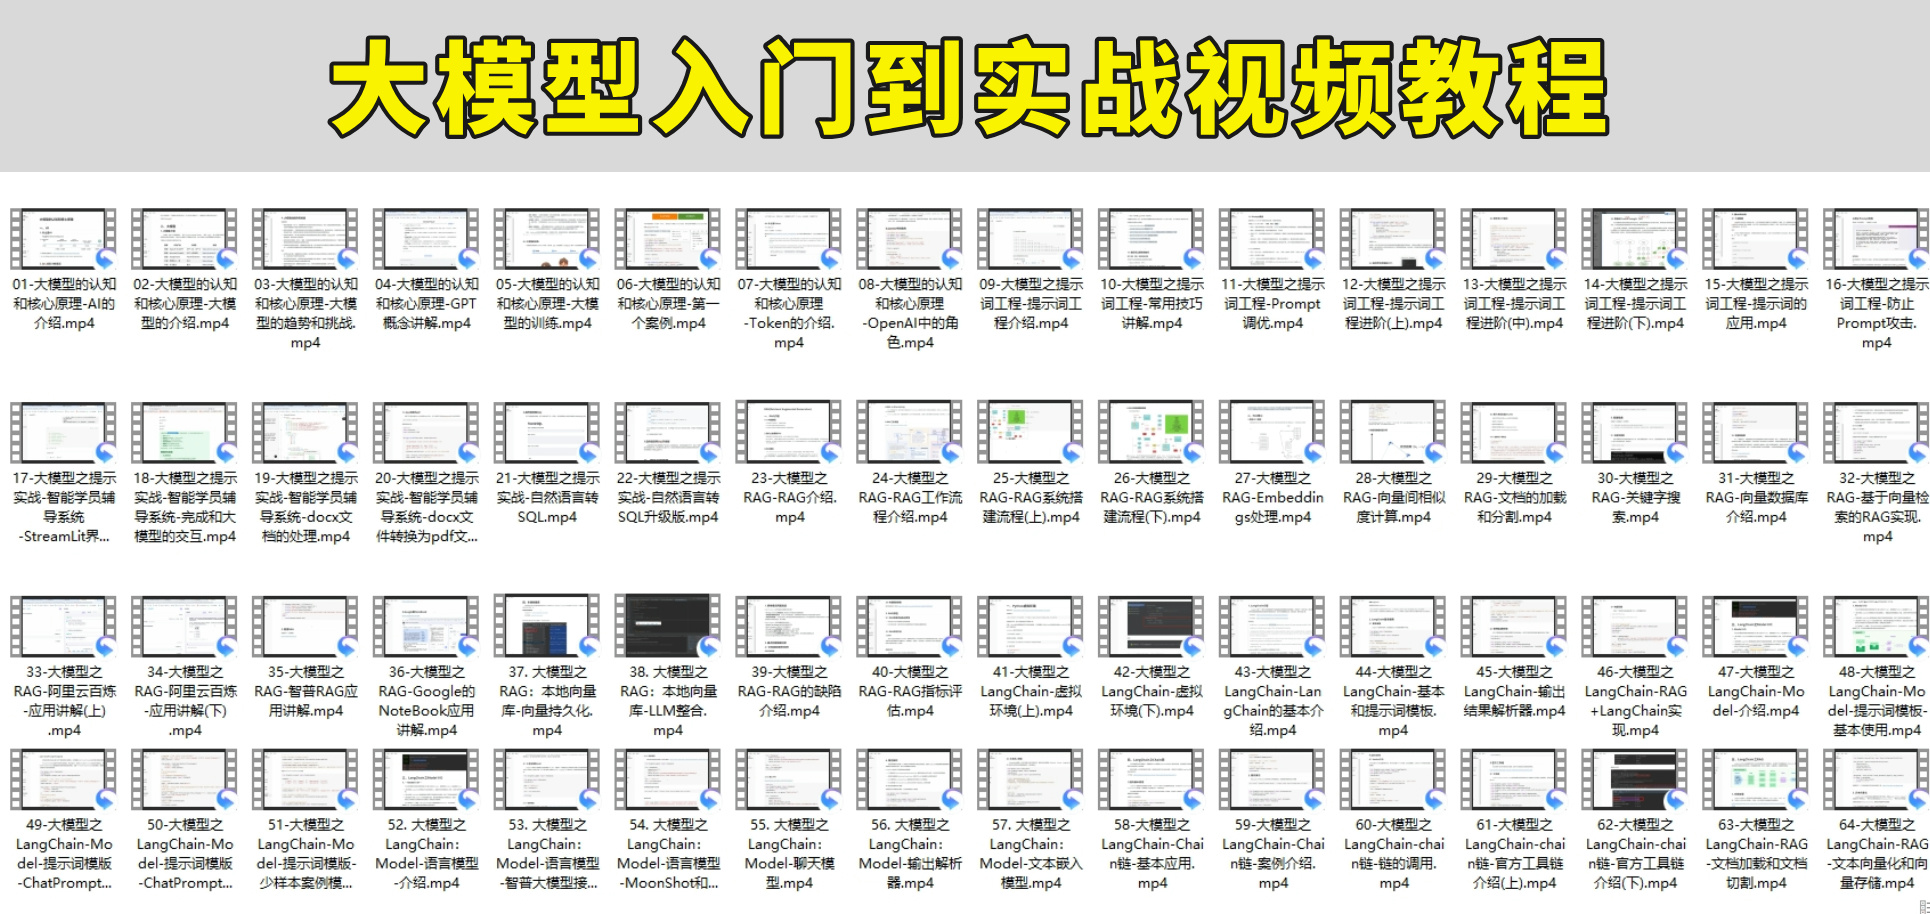
AI大模型入门到实战的视频教程+项目包

看视频学习是一种高效、直观、灵活且富有吸引力的学习方式,可以更直观地展示过程,能有效提升学习兴趣和理解力,是现在获取知识的重要途径
在这里插入图片描述
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
在这里插入图片描述

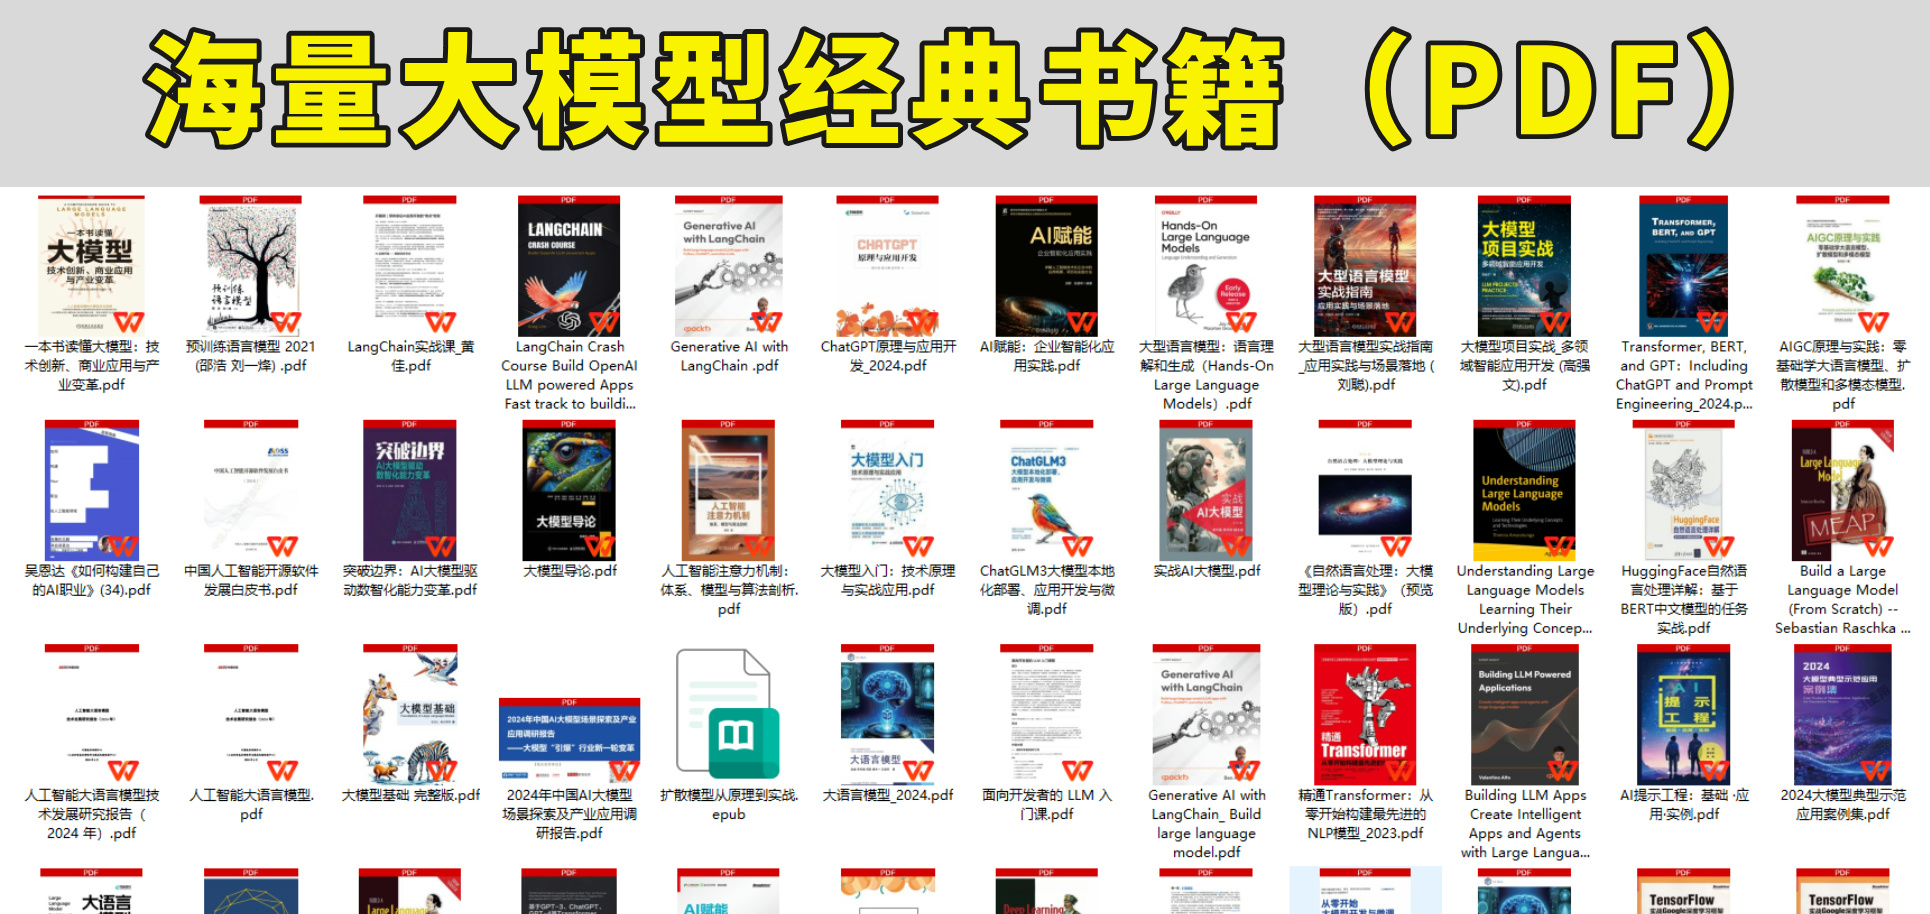
海量AI大模型必读的经典书籍(PDF)

阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。
在这里插入图片描述

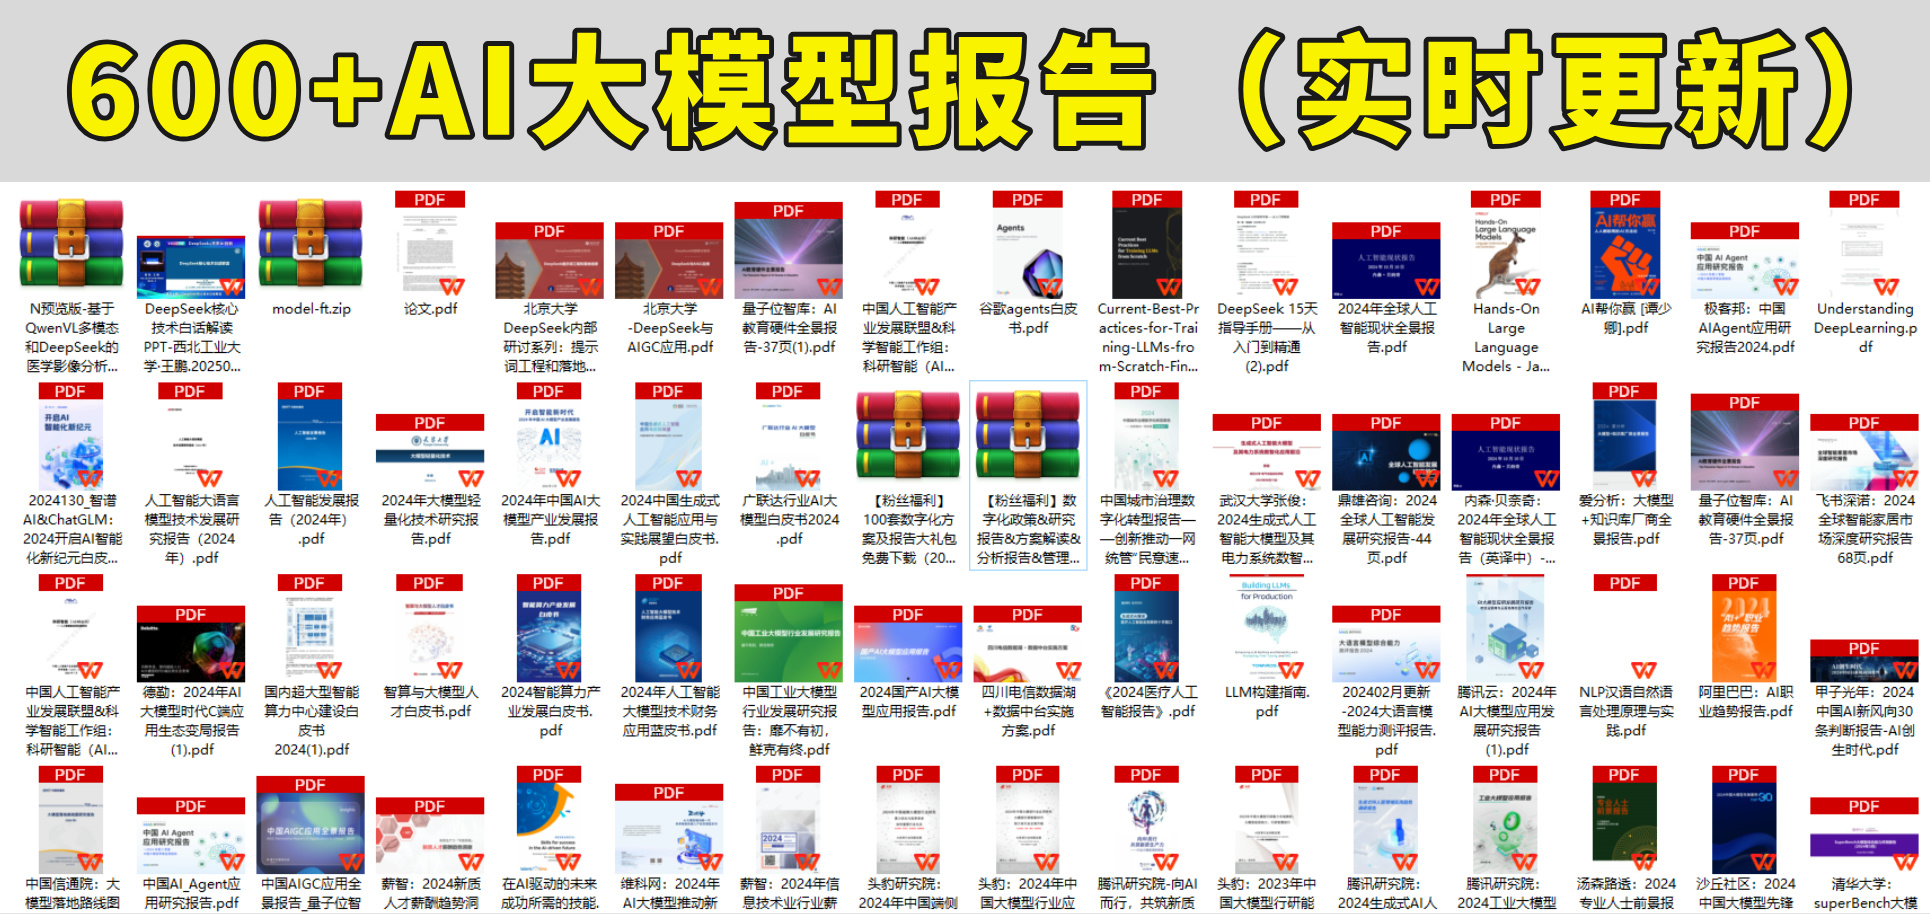
600+AI大模型报告(实时更新)

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
在这里插入图片描述

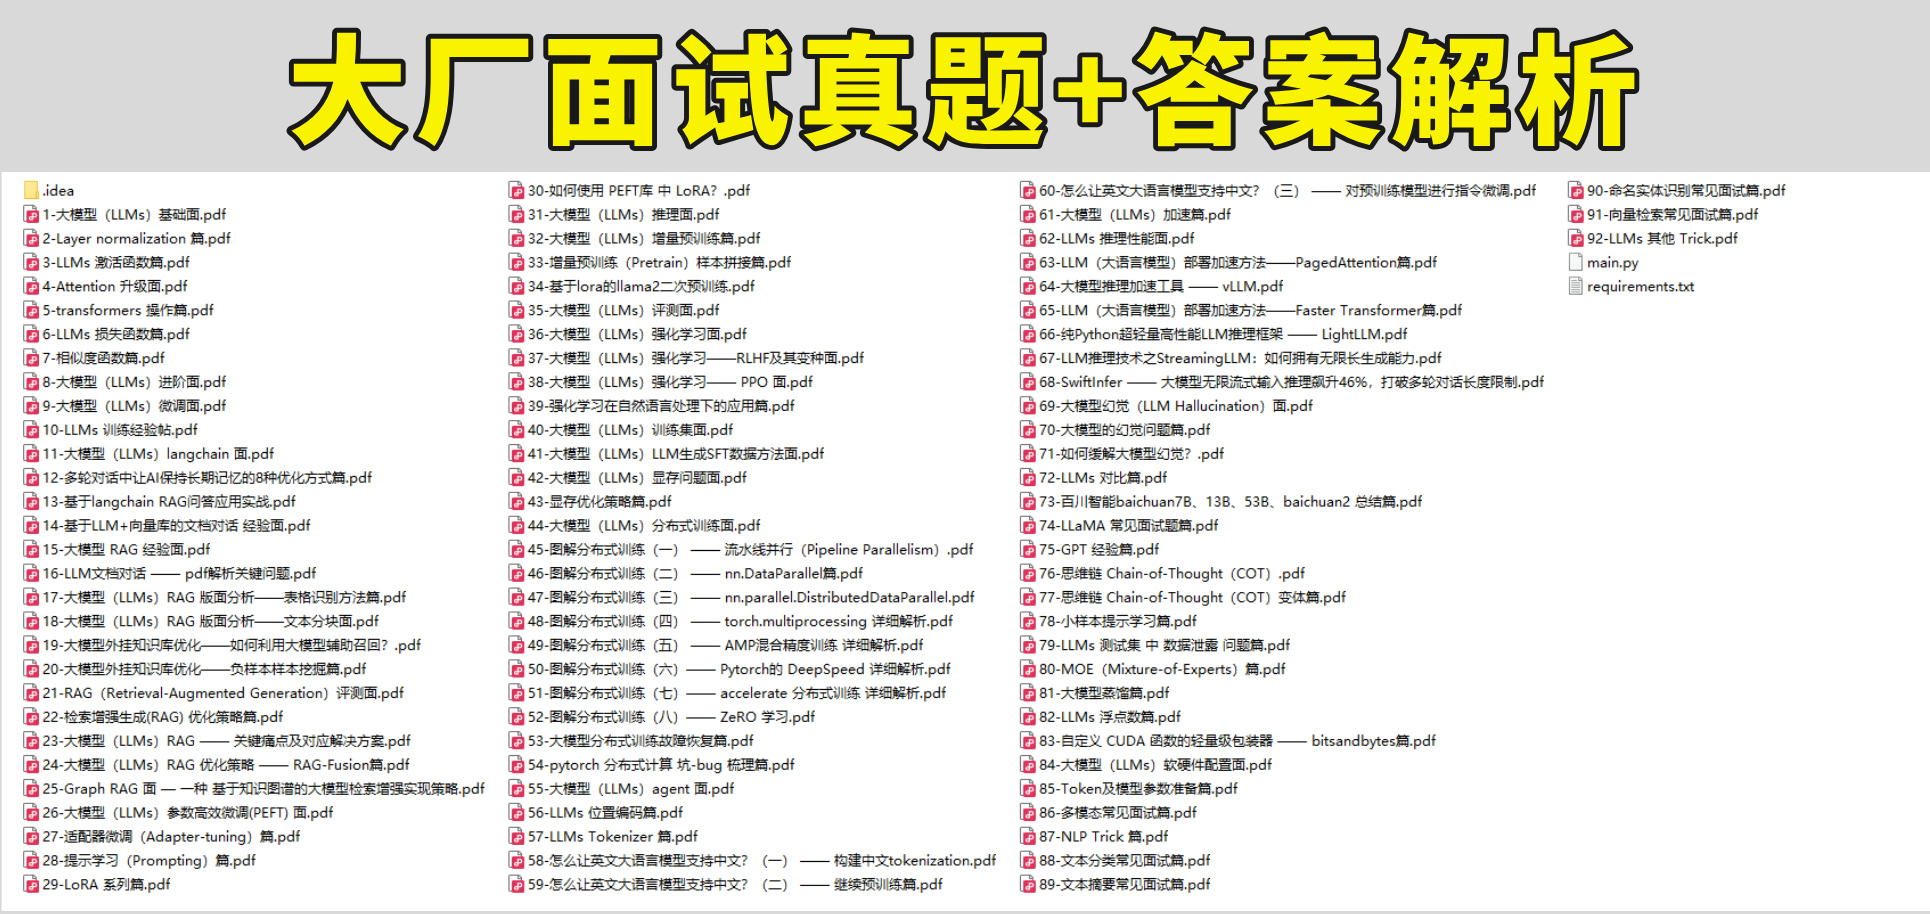
AI大模型面试真题+答案解析

我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数 下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。 阅读详情

相关推荐

存储&AI行业每日要闻(2026-10-25

影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题;

惠惠软件 164

LangChain与Manus揭秘:大模型记忆力管理秘诀,让AI更高效精准!

文章揭示了AI智能体面临的"上下文腐烂"问题,即随着任务进行,上下文信息不断增加导致模型性能下降。LangChain与Manus团队提出五大解决方案:卸载(存外部文件)、缩减(压缩优先)、检索(按需唤醒)、隔离(多智能体分工)和缓存(避免重复计算)。强调应简化架构,信任模型能力,通过文件系统等工具实现"健康记忆管理",让AI记住关键信息,忽略噪音,从而保持高效精准的运行状态。

2401_85379281的博客 776

从抽象到落地:线性代数中“秩”与“最大无关组”的降维打击

线性代数中的“向量组的秩”与“最大线性无关组”并非抽象理论,而是数据科学与工程应用的核心工具。通过矩阵秩揭示系统真实自由度,实现特征降维(如PCA)、图像压缩(低秩近似)与故障诊断。结合Python的NumPy和SciPy,可高效求解秩、提取核心特征,将教材中的行变换转化为实际代码。从海量数据中剥离冗余、提炼本质,正是数学赋予我们驾驭复杂世界的底层能力。

数字人生 143

LLM之Agent(二十七)| Manus 上下文管理经验揭秘

上下文缩减与上下文卸载类似,但它的做法则是对信息进行摘要或压缩。一个直观的方法是摘要工具调用的输出,Open Deep Research 项目中已经采用了该方法。另一个方法是精简 (pruning) 工具调用或工具消息。有趣的是,Claude 3.5 Sonnet 实际上已经内置了这个功能。如果你去看他们最近的发布,会发现它现在原生支持这个特性。所以,精简掉旧的工具调用和输出,已经成为 Claude 在其 SDK 中内置的功能。对完整的消息历史进行摘要或压缩。

wshzd的博客 1279

Kinect V1结构光激光散斑原理及样式

   对 intel realsense F200 和 Kinect V1的coding pattern原理进行调研,知二者都使用light coding的方式,该方法与传统的coded structure light不同:传统编码结构光(空间编码,时间编码)最终使用的是三角测量的原理计算深度信息;light coding通过投射具有高度伪随机性的激光散斑,会随着不同距离变换不同

松间明月 1万+

【2021工业图像异常检测文献】DRÆM: 基于判别性训练的重建嵌入表面异常检测方法

DRÆM – A discriminatively trained reconstruction embedding for surface anomaly detection

qq_1532145264的博客 1475

Java怎么开发AI Agent?——从模型调用到业务编排,框架级底座要备齐什么

Java怎么开发AI Agent?调大模型API只是第一行代码,真正的工作量都在模型之外:多步骤的编排、工具的接入协议、模型和资源的调度、权限和审计,还有让Agent读懂业务对象——这几块自己拼,Demo三天、上生产三个月。向量空间JBoltAI框架把这些做成了框架级底座,当前V5.3.0是第24个版本,100%源码按git仓库交付,AI能力长在框架层,不是外挂拼装。

AIGS001的博客 154

Carsim与AVL CRUISE联合仿真:从零搭建整车模型的实战指南

本文详细介绍了如何从零开始搭建Carsim与AVL CRUISE联合仿真整车模型,涵盖软件环境配置、接口设置、模型连接及调试技巧。通过联合仿真,可充分发挥Carsim在车辆动力学和AVL CRUISE在动力系统仿真方面的优势,为电动车和混合动力汽车的研发提供精准的整车模型分析。

weixin_29067143的博客 935

【技术拆解】配音工具选型评估方法论:用 6 个维度给 AI 配音软件打打分

✅ 测试方案:准备一段包含括号注释、数字、中英文混排的文案导入试听,校验读音、停顿是否合理。案例参考:逗哥配音配套了文案提取、自动对轴、人声分离、声音转换等附加工具,支持 wav /mp3 /mp4 格式导出,可附带字幕与 SRT 文件,在字幕对齐、文件导出这条链路具备对应的能力,适合批量生产场景的创作者在这个维度进行自测打分。同一款配音引擎,有人评价 “自然接近真人”,也有人反馈 “AI 感很重”,核心差异往往来自使用场景:30 字以内的短口播,和 3000 字小说章节朗读,对引擎能力要求完全不一样。

zhizhizhuzhuxia的博客 162

Conda换源全攻略:从清华源到默认源的保姆级切换教程(附常见问题解决)

本文提供Conda换源的完整教程,详细讲解如何从清华源切换到默认源,包括配置步骤、常见问题解决方案及高级技巧。针对国内开发者遇到的下载速度慢问题,清华源提供了高速稳定的解决方案,同时文章也介绍了恢复默认源的方法和多种镜像源选择。

weixin_28837817的博客 933

JeecgBoot漏洞利用工具解析:一键getshell原理与安全加固实践

在应用安全领域,远程代码执行(RCE)和文件上传漏洞是Web系统面临的高危威胁,其核心原理在于对用户输入的控制不足或安全校验缺失。攻击者通过构造恶意请求,可绕过系统边界,在服务器上执行任意命令或上传恶意文件,从而获取系统控制权。这类漏洞的技术价值在于揭示了应用层安全防护的薄弱环节,其利用方式自动化、集成化趋势明显,极大地提升了攻击效率。在低代码开发平台等快速构建的业务系统中,此类风险尤为突出。应用场景广泛覆盖安全测试、渗透评估与应急响应。本文聚焦于JeecgBoot平台的历史高危漏洞,深入解析其SQL注入、

weixin_30787531的博客 547

容器能启动却调用不了GPU?CUDA驱动兼容性验收实战

AI算力平台容器虽可进入Shell,但GPU任务仍可能因驱动、运行时、框架版本或设备映射不匹配而失败。验收需逐层验证:宿主机驱动、Docker GPU支持、框架版本、动态库加载、基础CUDA计算及自定义扩展。通过固定镜像Digest、执行最小计算与业务请求,确保真实算力可用,避免将兼容性问题误判为模型错误。

iFisher666的博客 454

HFSS实战项目——基片集成波导(SIW)带通滤波器

设计了一款直接耦合的SIW带通滤波器, 采用直接耦合的形式, 工作频率覆盖19~21 GHz, 通带内插入损耗小于1.5 dB, 回波损耗小于-20 dB, 带外抑制特性良好.

2401_87464239的博客 4891

一文读懂 RSI:大模型递归自进化五大技术路线全景解析

在人工智能领域,递归自进化(RSI) 是指一个 AI 系统不仅能够自主提升自身的任务表现,还能够改进 ⌈产生这种改进的机制本身⌋,从而形成持续迭代的正向飞轮。为了通俗理解 RSI,可以将 LLM 系统下的 RSI 划分为三个递进层级(参考 https://github.com/lobehub/awesome-rsi 、 https://arxiv.org/abs/2607.07663、https://arxiv.org/abs/2607.07663):演进层级通俗比喻核心特征改了什么是否持久化。

分享AI前沿进展、底层原理和行业应用 244

系统架构设计(以飞控系统、航电系统、机电管理系统、电子电气架构为例)

系统架构涉及对系统的结构和行为进行高层次的描述。它包括系统的组成部分、这些部分之间的关系、与外部环境的交互方式,以及满足特定功能和非功能性需求的方法。系统架构定义了系统的总体设计蓝图,指导系统的开发、集成、部署和维护。系统架构设计的目的是通过合理的结构和设计原则,确保系统能够高效、稳定、安全地运行,满足当前和未来的需求,同时具备良好的维护性、扩展性和可持续性。良好的系统架构不仅能够提高系统的开发效率和运行性能,还能降低长期的维护和运营成本,支持系统的持续演进和技术更新。

qq_41854911的博客 3051

导航系统 | 全球四大卫星导航系统(2025)核心能力对比分析

北斗系统通过GEO卫星(80°E、110.5°E、140°E)实现区域增强,其IGSO卫星在亚太地区形成"8"字形轨迹,使该区域可见卫星数量比GPS多4-6颗,显著提升复杂环境下的定位可用性[13]。北斗短报文功能在2025年云南地震救援中发挥关键作用,被困人员通过北斗终端发送120字求救信息,实现"位置+状态"一体化上报,救援响应时间缩短40%[15]。北斗通过三频信号(B1C/B2a/B3)消除电离层延迟误差,在城市峡谷环境下定位连续性达99.98%,优于GPS的99.95%[5]。

尘世冰封的专栏 2602

外贸独立站 AI 爬虫日志分析:UA 清单、状态码分布与「爬取不等于引用」

日志可反映爬虫访问路径、状态码与UA,但无法证明内容是否被AI引用。需按UA、状态码、路径三层分析,识别可达性问题,避免误判“抓取=引用”。应结合实测验证引用效果,警惕日志误导。关键结论:抓取≠收录≠引用,技术优化仅解决可抓取性,不保证被引用。

mqhgeo的博客 361

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

电子厂用易特AI助理做BOM变更影响分析,改一处知道影响哪些单

电子厂BOM改了不知道影响哪些在制订单,容易用旧BOM做错返工。易特电子行业ERP加易特AI助理,改BOM后自动分析影响哪些工单哪些采购哪些物料,出报告通知车间采购。小厂要BOM变更建版本、工单绑定版本、AI报告老板决策、变更通知到人。上线后因变更没通知到位导致的返工降到零,BOM变了大家都知道怎么处理。

2602_96212498的博客 219

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

32 分钟不是完成科研:多智能体读脑图谱,突破在哪里?

如果数千个 AI 智能体只用 32 分钟,就能梳理一份庞大的脑科学数据,我们应该惊讶什么?是模型终于能“独立做科研”,还是科研流程中的某个环节开始出现新的组织方式?10 月 21 日,OpenAI 公布了与 PerturbAI、Scripps Research 合作的研究:利用基于 GPT-Rosalind 的多智能体系统,解释一份已经存在的小鼠脑基因扰动数据,整理潜在研究线索。

weixin_44369324的博客 268

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

AI辅助逆向的完整链路——反汇编→特征提取→大模型重写

编译后的程序(PE/ELF/Mach-O)丢失了源代码几乎所有高层语义:变量名、注释、类型、函数命名、循环分支结构,只剩下CPU能识别的机器码。传统逆向链路:机器码 → 反汇编(汇编指令)→ 人工阅读 + 静态分析工具生成伪C → 人工梳理逻辑。优化编译、混淆、花指令会把控制流打碎,伪代码可读性极差;无符号剥离(stripped binary)下所有函数都是FUN_xxxx,变量全是v1、v2;单函数上下文有限,跨函数调用、数据依赖靠人脑记忆,效率极低;

weixin_43156294的博客 213

零信任架构实战:基于海宇全国车辆配置查验构建自动化智慧高速公路称重检测与ETC货车车型分类比对网关

破解高速公路货车车型分类与治超比对痛点:从人工目测验票到车管权威配置数据即时直连 在全国深化收费公路制度改革、全面取消省界收费站以及大力推行“入口称重检测、按车型分类计费(JT/T 489-2019《收费公路车辆通行费车型分类》)、ETC不停车电子收费”的智慧交通体系中,高速公路ETC自由流门架系统与入口动态称重治超检测中台承担着高速通行效率与道路交通安全治

haiyuzhicha的博客 197

主机 Agent:用 AI 操作本地与远程主机

本章适合这样的任务:你已经在 aiopsterm 中保存并连接了一台主机,希望让 AI 帮你完成诊断、命令生成或多步运维,同时保留明确的目标主机和审批边界。

woai110120130的专栏 163

AI 越快,越要慢下来想清楚

AI 把"做出来"变便宜了,值钱的东西整体往后移——从执行到判断、从生产到分发、从产出到问责。层面普通人程序员生产与回报不学"变现课",学自己已验证的链路先验证"有人付钱",再让 AI 加速开发劳动与入口可编码的交出去,省下的时间投到判断/协调/关系从"实现者"迁到"定义者 + 验收者"能力与判断学"什么算做好",保留判断权合入底线:看懂 or 完备用例通过信任与账单学"什么不该用 AI 做",放大独有的AI 可以帮你写,不能帮你懂。

runafterhit的博客 297

【工业AI实战】工业智能体如何打通RAG、工具调用与MOM?架构设计与落地避坑

麦肯锡与Anthropic研究揭示,AI虽提升个人效率,但企业级高绩效应用仍受限。工业智能体正从生成答案转向任务规划、工具调用与连续执行,推动制造业AI向系统化演进。其核心在于构建融合任务理解、知识检索、工具调用、权限控制与验证反馈的技术架构,并与MOM系统协同,实现自然语言交互与业务流程闭环。技术选型应基于场景需求,优先结合RAG与结构化查询,逐步引入知识图谱与微调。工业智能体落地关键在于真实环境中的可靠性、安全性和可验证价值,而非单一模型表现。

qq_40453532的博客 362

【零基础学AI】第 16 章课后练习与答案

全部数值为虚构教学设定。先在纸上算,再运行代码核对。

m0_73879806的博客 223

科技云报到:AI没有杀死软件,只是重写了它的“收银台“

而所谓"智能体商业"已不是概念——多智能体在后台互相沟通、直接完成下单的交易流程已经跑通,亚马逊云科技已推出目前处于预览阶段的Amazon Bedrock AgentCore payments,与Stripe、Visa两家合作方进行整合,探索智能体自主完成交易的闭环。平台自身的增长,是这个故事最直观的注脚:全球已有6000多家卖家,上架超过3万个产品;对ISV而言,真正的分水岭不是"用不用AI",而是"AI是外挂,还是产品的内核"——正如他所说,“不应该只做一个AI外挂,简单地加一个聊天窗口”。

科技云报道 166
上一篇: 2025年最大风口:Agent智能体到底是什么?看完这一篇你就知道了!!
下一篇: 收藏!从DeepSeek-V3到MiniMax-M2:现代大模型架构设计全面解析,程序员必看
Agent学习路线
博客等级 码龄6年 1万+粉丝 1902原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值