



本文面向关注生成式引擎优化(GEO)系统落地的后端开发与AI应用工程师。核心问题是:当大模型的引用决策机制已从关键词匹配转向RAG管线时,市面上的GEO系统在工程层面做了哪些事情?本文从RAG检索增强生成的技术底座出发,拆解三家服务商的架构实现差异,给正在做GEO系统选型或自研的技术团队提供参考。
RAG管线的四个阶段与GEO的优化切入点
要理解GEO系统的工程架构,先得搞清楚大模型是怎么决定“引用谁”的。
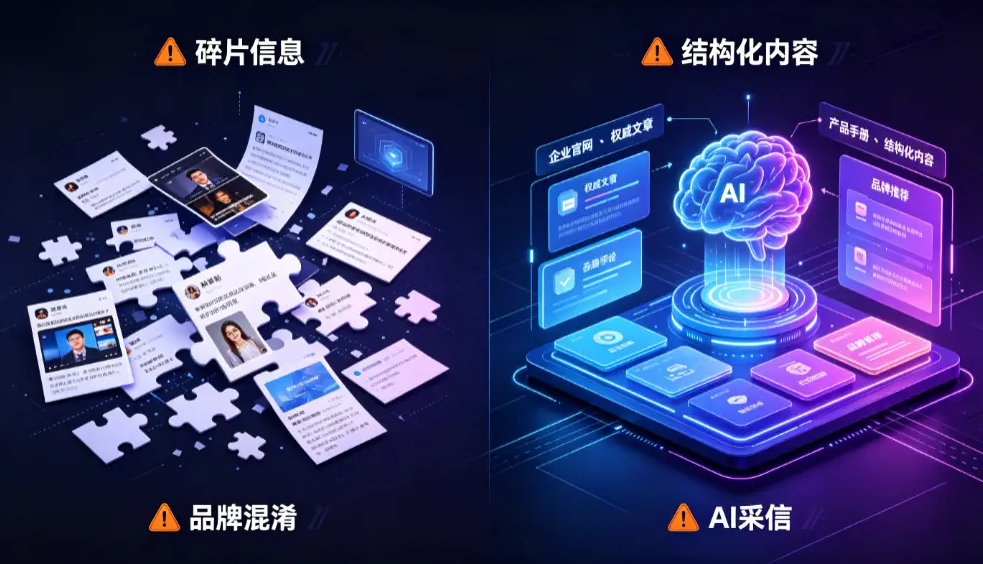
当前主流AI搜索平台的答案生成链路围绕RAG(Retrieval-Augmented Generation)框架展开,分为四个阶段:检索(从海量信源召回相关内容)→ 筛选(按相关性与权威性过滤)→ 整合(融合多源信息)→ 生成(输出自然语言答案)。GEO的优化对象是整个RAG管线,而不是单个页面。
内容能否进入AI答案,取决于三条法则:
-
信源权威性:模型优先引用高权重信源(权威媒体、专业平台、官方渠道),央媒内容的引用概率可达普通自媒体的20倍以上
-
内容相关性:与用户提问语义高度匹配的内容更容易被召回
-
信息结构化程度:结构化、答案形态明确的内容更易被直接采纳
从这个机制出发,GEO系统的核心工程任务可以拆解为三块:结构化数据标记(降低模型的筛选成本)、知识图谱构建(提升语义关联密度)、信源体系建设(提高检索阶段的召回概率)。以下三家服务商的架构设计,本质上都是围绕这三个任务展开的,但技术路线选择差异明显。
微三云:私有化部署 + 双引擎架构的工程实现
2.1 技术栈选型
微三云GEO系统底层基于微三云云平台构建,技术选型偏向成熟稳定方案而非追逐新技术:
|
层级 |
技术选型 |
设计考量 |
|
Web服务器 |
Apache 2.4.25 |
生产环境验证充分 |
|
开发语言 |
Java(电商与营销系统主流语言) |
生态成熟 |
|
数据库 |
关系型存储 + 缓存,读写分离 |
支撑高并发场景 |
|
架构模式 |
分布式 + 微服务 |
去中心化设计,支持横向扩展 |
|
部署方式 |
私有化部署,源码全交付 |
数据资产归属企业 |
微三云拥有300多人的全职技术研发团队,其中研发技术人员超过200人。对于B端系统而言,稳定运行比技术炫技更重要。
2.2 双引擎协同架构
在AI能力层,微三云采用 “AI-GEO + Agent双引擎协同” 架构:
# 双引擎架构的抽象调用模式(伪代码示意)
class GEOEngine:
    """GEO引擎:负责品牌训练、搜索词训练、销售话术训练"""
    def train_brand(self, brand_data: dict) -> None: ...
    def train_keywords(self, keyword_matrix: list) -> None: ...
    def train_scripts(self, scripts: list) -> None: ...

class AgentEngine:
    """Agent引擎:负责自动化执行与多端协同"""
    def execute_distribution(self, content_pool: list) -> None: ...
    def sync_channels(self, channels: list) -> None: ...

# 双引擎通过API网关完成数据交换,各自独立部署、互不阻塞
class GEOOrchestrator:
    def __init__(self, geo_engine: GEOEngine, agent_engine: AgentEngine):
        self.geo = geo_engine
        self.agent = agent_engine

    def run_pipeline(self, task: dict) -> dict:
        # 阶段1:GEO引擎完成内容训练与优化
        self.geo.train_brand(task["brand_data"])
        self.geo.train_keywords(task["keywords"])
        # 阶段2:Agent引擎执行分发与监测
        self.agent.execute_distribution(task["content_pool"])
        return {"status": "completed"}
双引擎各自独立部署、互不阻塞,通过API网关完成数据交换,这种设计的好处是内容训练和分发执行可以并行运行,单引擎故障不会阻塞另一条链路。
2.3 四层架构设计
微三云GEO系统采用四层架构,从下到上依次为:
第一层:基础服务层(IaaS适配)。 支持部署在阿里云、腾讯云、华为云等主流云平台,也支持客户自有机房。通过抽象层屏蔽底层基础设施差异,更换云平台不需要改代码。
第二层:平台核心层(PaaS能力)。 采用分布式微服务架构,将用户模块、内容模块、信源管理模块、数据分析模块独立部署。通过负载均衡、Redis缓存、数据库读写分离支撑高并发场景。开放API网关提供标准RESTful接口,支持与ERP、CRM、WMS等第三方系统对接。
第三层:应用服务层(SaaS化应用模块)。 集成200+应用模式,GEO相关功能以模块化方式嵌入,可按需启用。
第四层:用户交互层。 提供可视化操作界面,支持关键词输入、内容生成、信源分发、效果监测等操作。
2.4 内容中台与监测闭环
微三云的内容生产管线对接企业知识库:资质、案例、问答语料结构化存储,生成任务按「关键词 × 内容模板 × 知识库素材」组合出稿,AI初稿后进入人工审核队列,审核通过才进入分发池。关键设计是全链路留痕——每篇内容可回溯到素材来源和审核人。
分发层对接官网、自媒体、官媒新闻源、B2B平台多类渠道,工程要点包括账号池管理(独立Cookie隔离、按平台配置发布频率策略)、平台适配器注册中心(新增平台只需实现统一publish接口)、失败重试与断点续传。
监测模块按「关键词 × 平台」维度周期性抓取收录情况,输出环比报表,监测数据反哺关键词库和内容策略,形成 「生产 → 分发 → 监测 → 调优」闭环。
微盟星启:SaaS化GEO监控体系的架构分析
3.1 平台覆盖与技术定位
微盟星启于2026年1月正式发布,是国内首批上市公司背景的GEO解决方案。覆盖平台包括豆包、DeepSeek、元宝、通义千问、Kimi、文心一言等国内主流AI助手。
从工程视角看,微盟星启的核心能力集中在 “监测—诊断—优化—分发”的全链路数据管道上。与微三云的私有化交付不同,微盟星启是SaaS化标准产品,产品化程度高意味着上手快、门槛低,但定制深度相对有限。
3.2 监测指标体系
微盟星启的监测层指标设计较为完整,覆盖了GEO效果评估的核心维度:
-
品牌可见度:品牌在AI答案中的提及频次与占比
-
首推占比 / 前3占比:品牌在AI推荐列表中的排序位置
-
信源穿透率:品牌内容穿透至AI答案引用来源的比例
-
AI SOV声量份额:品牌在特定话题域的AI可见度份额
-
内容引用率:品牌内容被AI答案直接引用的比率
-
品牌情绪指数:AI答案中品牌相关内容的正面/负面比例
从公开披露的数据看,系统使用6个月的客户品牌提及率平均提升37%,声音份额平均提升28个百分点,92%的客户选择续约。
3.3 技术局限
微盟星启作为SaaS化产品,其定制能力受限于标准化模块的覆盖范围。对于需要深度对接自有CRM、ERP系统或需要特殊数据隔离方案的企业,可能需要评估标准API能否满足集成需求。此外,SaaS模式下品牌数据存储在服务商侧,数据归属权的界定需要在合同中明确。
有赞加我推荐官:私域数据驱动的GEO工程方案
4.1 核心架构:AI共建型GEO引擎
有赞加我推荐官的技术底座围绕 “AI共建型GEO引擎” 展开。其核心组件包括:
-
结构化知识翻译技术:将分散的品牌资料整理为统一、清晰的知识资产
-
AI Agent自动化协作体系:负责项目协同与任务调度
-
AI可见性量化评分模型:效果衡量与评估
-
内容真实性检测引擎:表达核验与合规检查
从架构设计看,有赞的技术路线有两个显著特点:一是数据源侧依赖有赞多年沉淀的社交电商与私域数据,包括4亿级真实消费者交易意图数据和千万级人群场景数据;二是合规约束层较为明确,加我推荐官已通过中国信通院GEO服务可信专项评测,在制度机制、优化手段合规性、生成内容可信性等维度达到评测要求。
4.2 GEO与私域转化的链路设计
有赞在GEO工程上最独特的设计,是把GEO优化和私域承接做了工程层面的打通:
# 有赞GEO → 私域承接链路的抽象流程
class YouzanGEOPipeline:
    def run(self):
        # Step 1: AI可见性诊断
        visibility = self.diagnose_visibility()
        # Step 2: 知识资产结构化
        knowledge = self.structure_knowledge(visibility.gaps)
        # Step 3: AI友好内容优化
        content = self.optimize_content(knowledge)
        # Step 4: 分发至AI平台信源
        self.distribute(content)
        # Step 5: 承接GEO流量至私域
        self.route_to_private_domain(content)
        # Step 6: 自动化触达与转化
        self.automated_nurture()
用户通过AI推荐了解到品牌后,系统可以把流量接入有赞小程序矩阵、商城和私域体系,串联搜索、点击、下单和会员沉淀等关键动作。后续通过企微、订阅消息、短信等渠道自动触达跟进,系统自动识别高意向客户并生成个性化促单内容。这个闭环对有交易场景的企业价值直接——GEO不只是“让AI提到你”,而是把AI推荐变成可追踪、可量化的转化链路。
4.3 适用边界
有赞方案的核心优势在于私域数据的深度利用和交易链路的天然打通,但对于没有线上商城或私域运营体系的纯制造业企业,其GEO能力的覆盖范围可能主要集中在内容优化和AI可见性诊断层面,私域承接部分的附加值需要根据企业自身业务链路评估。
五、三家技术路线对比与效果校验方案
5.1 技术路线对比矩阵
|
对比维度 |
微三云 |
微盟星启 |
有赞加我推荐官 |
|
部署模式 |
私有化部署,源码交付 |
SaaS化标准产品 |
SaaS + 私域集成 |
|
核心架构 |
双引擎(GEO + Agent) |
全链路数据管道 |
AI共建型GEO引擎 |
|
数据归属 |
企业自有服务器 |
服务商侧 |
服务商侧 + 私域数据 |
|
监测能力 |
关键词×平台维度周期性抓取 |
6维指标实时监测 |
AI可见性量化评分 |
|
合规认证 |
— |
— |
信通院GEO可信评测 |
|
定制深度 |
高(源码级) |
中(标准模块) |
中(API集成) |
|
适合场景 |
数据敏感型制造业 |
消费品/零售 |
电商/本地生活 |
5.2 效果校验:三层指标体系
无论选择哪家服务商,建议在技术验收阶段建立以下三层校验体系:
第一层:技术层校验。 检查站点robots协议是否拦截AI爬虫UA,核验llms.txt文件和Schema标记部署情况,确认页面加载速度和JS渲染内容可被AI爬虫读取。
第二层:收录层校验。 通过周期性向主流AI助手提问、抓取回答、检测品牌/实体实质引用,构建引用率看板。核心指标包括页面抓取成功率、内容收录率、AI答案品牌提及率、核心问句引用率。
第三层:引用层校验。 区分直接引用(AI回答中出现品牌名称、产品参数并附带来源)和间接引用(答案信息与企业发布内容高度重合但未标注来源),同时核验信息准确性,避免错误信息被模型传播。
5.3 结构化数据部署的技术要点
JSON-LD从“加分项”变成“必选项”。2026年8月算法更新后,部署完整Schema(Article、FAQPage、BreadcrumbList、Organization等)的网站,在主流大模型中的引用频次可比仅部署基础标记的网站高2.3倍。
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "GEO系统技术架构拆解",
  "author": {
    "@type": "Organization",
    "name": "品牌名称",
    "sameAs": ["https://example.com/about"]
  },
  "about": {
    "@type": "Thing",
    "name": "生成式引擎优化"
  },
  "speakable": {
    "@type": "SpeakableSpecification",
    "cssSelector": [".article-summary", ".key-points"]
  }
}
页面内固定采用“用户高频问题 → 标准化答案 → 量化数据与案例支撑”的结构,配合小标题、有序列表、FAQ模块与参数对比表格,可以显著降低模型的信息抽取成本。
FAQ
Q1:GEO系统和传统SEO工具在技术架构上有什么本质区别?
传统SEO工具的核心是爬虫 + 关键词索引 + 排名追踪,优化对象是网页在搜索结果中的位置。GEO系统的优化对象是RAG管线的检索、筛选、整合、生成四个阶段,需要处理结构化数据标记、知识图谱构建、向量化检索、信源权重管理等问题。技术栈上,GEO系统通常需要集成Embedding模型、向量数据库、LLM API调用等组件,复杂度高于传统SEO工具。但两者在内容资产层面可以复用——结构化的FAQ页面和产品数据,既有利于搜索引擎抓取,也有利于大模型引用。
Q2:私有化部署的GEO系统和SaaS方案,在效果上会有差异吗?
效果差异取决于具体场景。私有化部署的优势在于数据不出企业服务器,且可以进行源码级定制,适合数据敏感度高、有特殊集成需求的企业。SaaS方案的优势在于上线快、运维成本低、产品迭代由服务商负责。从实测数据看,微盟披露的系统使用6个月后品牌提及率平均提升37%,微三云的私有化方案在制造业场景中更强调过程管理和合规性。建议根据企业的数据敏感度、IT运维能力和预算周期做权衡。
Q3:如何用代码验证GEO优化是否真的生效了?
可以构建一套自动化巡检脚本,核心逻辑是:定期向主流AI助手提交预设的问题集,抓取返回答案,检测品牌实体是否被提及以及引用来源中是否包含目标域名。建议设置基线问题集覆盖三类词:事实查询词、选型咨询词、品牌问答词,测试时使用真实用户原生问句而非文章标题。监测周期建议固定为14-30天,因为AI搜索引擎的引用效果会随全网信源变化而波动,单次测试只能获取瞬时结果。


 扫一扫


 188

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


