


2026年以来,“Agent”正在加速从学术概念走向产业落地,而诸葛鸣晨已在这条赛道上深耕数年。
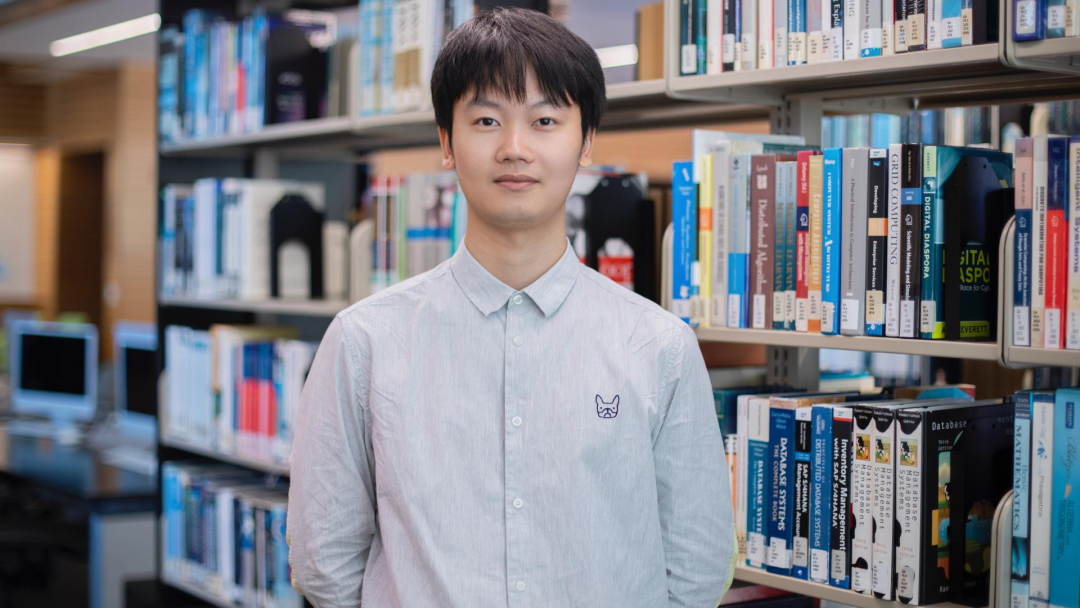 图注:诸葛鸣晨
他的博士生涯始于论文 Mindstorm,该工作系统描绘了智能体社会的整体图景及其潜在经济形态。此后,他又以共同第一作者身份主导完成了 MetaGPT,使其迅速成为近年来智能体编程领域最具代表性、也最具影响力的现象级工作之一;与此同时,他也是 OpenHands(原 OpenDevin)的早期核心贡献者。
围绕 Agent 系统方法论,他进一步发展出 GPTSwarm,将多智能体建模为可优化的图(graph),为 Agent 的系统化构造与演化开辟了新路径;他提出的 Agent-as-a-Judge,则切中了长时程任务自动评估这一关键瓶颈,为持续迭代优化提供了核心机制。尤其值得一提的是,早在 2023 年,他便已在 MetaGPT 附录中明确指出,“recursive self-improvement” 与 “learning from experience” 将构成 Agents 下一阶段发展的核心方向,显示出极强的前瞻判断力。
这位师从 Jürgen Schmidhuber 的 KAUST 博士生,早在 2021 年就将博士研究锚定为多模态 Agent。回看他的路径,核心是一件事:更早判断方向,并把判断落成研究。
Agent 的未来究竟是怎样的图景?长时程任务中智能体该如何实现自我评估?被调侃为“老顽童”的导师又给他带来了怎样的科研启迪?在这篇深度专访中,他将围绕 Agent 技术演进的关键路径展开分享,深入讨论智能体社会、智能体经济、自动化评估与递归自我改进(RSI,Recursive Self-Improvement)以及神经计算机(NC,Neural Computer)。
采访&编辑:梦佳 迪阳
要点速览
研究起点与选择:2021年末将博士课题锁定为多模态智能体(Multimodal Agents);并始终认为Coding Agent是最易落地、最具商业价值的方向。
Agent进化的核心引擎:他判断下一阶段突破将集中在 recursive self-improvement,Agent-as-a-Judge 则为长时程任务提供自动评估信号。
开源实践:深度参与 MetaGPT,用角色分工与 SOP 规范化破解大模型幻觉与上下文瓶颈;提出 GPTSwarm,将 Agent 创新性地抽象为图结构,让智能体的构建与优化等价于对节点(Node)与边(Edge)的系统性求解。
“现代AI之父”的言传身教:导师 Jürgen Schmidhuber 不仅在学术写作上严谨严格,更在合作项目中亲自撰写“Economy of Mind”章节,为其注入了“Agent 社会将由经济规律驱动”的超前洞察。
未来方向:(1)即将推出 “Neural Computer”。(2)Agent 将从代码编写全面渗透至日常全场景,始终坚信:人类具备强的适应力与创造性,越早拥抱AI的收益会越大。
智源专访栏目意在展现行业顶尖技术研究者和创业者的研究经历和故事,记录技术世界的嬗变,激发当代AI从业者的创新思维,启迪认知、关注突破性进展,为行业注入灵感光芒。本次专访为总第36期。
简介:诸葛鸣晨是沙特阿卜杜拉国王科技大学(KAUST)的计算机科学博士生,青源会成员,师从被誉为“LSTM之父”的Jürgen Schmidhuber教授。他的研究领域集中于大语言模型和多模态智能体。他曾在Meta AI实习,博士就读前,曾在微软、阿联酋起源人工智能研究院和阿里巴巴等知名机构任职。他以第一作者身份在ICML、ICLR、CVPR、TPAMI等顶级会议和期刊上发表了多篇论文,荣获NeurIPS研讨会最佳论文奖,EMNLP杰出论文候选,CVPR杰出审稿人等奖项,论文累计被引用近5500次。最近2年,他积极参与的开源项目共取得约130K Stars。此外,他近几年智能体的研究工作在顶级ML会议共获得6次口头报告(Oral Presentation)。他发起并组织了ICLR 2026递归自我改进(RSI)研讨会,同时担任COLM 2026与CAIS 2026的领域主席(Area Chair)。
01
于浪潮未至时落子:研究课题和个人选择
"我不太在乎agent最终的呈现形式,但我非常喜欢这个课题,未来大家都会从multimodal agent中受益。"
Q1:博士就读前你曾在微软、阿联酋起源人工智能研究院等机构,围绕多模态预训练和大语言模型开展研究,是什么契机让您在2021年末申请博士时,将研究方向锁定在多模态智能体领域?
诸葛鸣晨:那是2020年,确实我在读博之前做的是多模态预训练 (VLP),是受到VLBERT、ViLBERT等工作的启发,但当时国内做这块比较多的主要是微软和阿里。在阿里碰到了对前沿课题非常感兴趣的manager。尽管多模态在那个时间点是作为区别于NLP和CV的独立课题存在的,但我认为未来任何子topics都会围绕“多模态”展开的。在阿里的时期,我在CVPR2021发表了名为 Kaleido-BERT的工作。尽管当时整个CVPR 2021多模态预训练的工作似乎就5篇左右,我觉得这个 topic 未来会很火热。
但当时,大多数相关工作都是基于BERT等工作,参数量远远不够,所以大多停留在基础的多模态Understanding,具体任务基本是图片描述、图文相互检索、以及分类,应用,主要以拿到好的embeddings来服务搜推广,距离具备推理和规划能力的 Agent 还很远。所以离 reasoning(推理)及真正能够做 planning(规划)还差得很远。所以我申请博士时,研究提案就叫“多模态智能体”(Multimodal Agent),希望现有的模型能够跟真实环境进行交互。
我对agent的最初想象,不完全来自论文,也来自几部科幻电影,比如:a. 《生化危机》里以全息影像现身的"红皇后",背后是一个真正在决策、在控制整个设施的AI;b. 《机械姬》让我开始认真思考智能体的主体性和具身化;c. 《头号玩家》则让我想象,agent在数字世界里会以什么方式存在和演化。
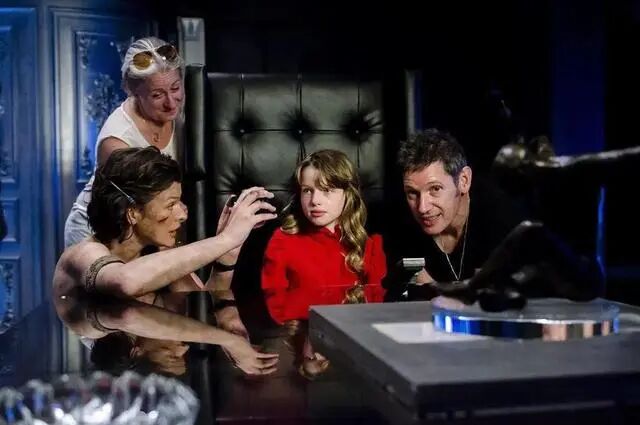
图注:电影《生化危机》
所以我当时写 proposal 的时候就说,其实有一个很明确的想法:我并不太在意 Agent 最终会以什么形式出现,但会考虑哪个方向更能直接产生影响力。我非常喜欢这个课题,并且觉得未来它一定能够得到广泛的应用,大家都会从 multimodal agent 中受益。
Q2:在众多AI细分领域中,Agent领域兼具学术深度与工程落地潜力,您认为这个领域最吸引您的核心特质是什么?有没有某个具体的研究场景或问题,让您当时就判断一定值得投入研究?
诸葛鸣晨:说实话, 对于PhD而言,真正可用的窗口并不宽裕,所以更需要选择那些长期绕不开的问题。Agent的本质,就是让日常或非日常任务自动化。如果坚信这一点,那么未来可能很多研究方向,最终都会绕不开 agents。
最开始ChatGPT 只能写20到100行代码,而且你可能还得自己去编译、去修改。并且一开始基础模型的context window只有2k到4k,也就是远远不够用来理解一个repo级别的代码的。但那时候我就觉得 Agent 在这个领域能够产生非常大的价值。作为研究课题,当时也有足够多低垂果实。比如ICLR 2024的Oral Papers,关于Coding Agents的唯二工作,一篇是MetaGPT,另一篇是SWE-Bench,在后面的影响力都挺大的。
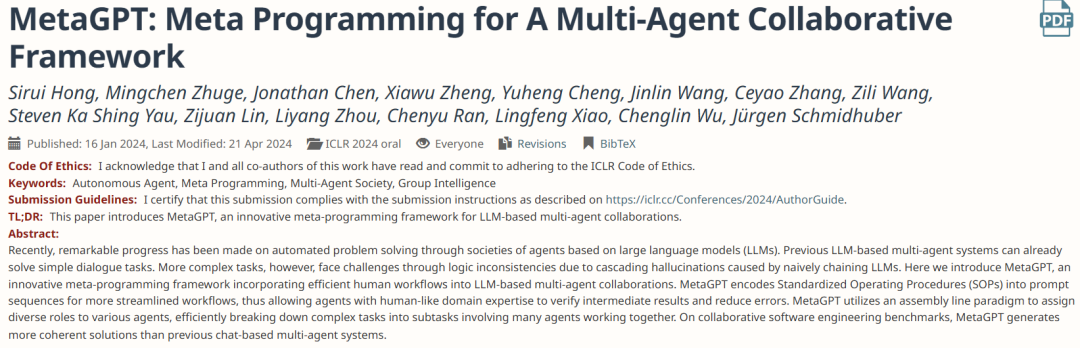
图注:ICLR 2024的Oral Papers
Q3:2021年放弃大厂的offer,gap之后申请博士,您认为这个选择背后,除了对科研的热爱,还有哪些关键考量?
诸葛鸣晨:和我同期去阿里实习的人,我认识的其他10人都加入了阿里或者其他大厂,我反而成了少数派。因为那个时候,阿里是世界市值第6的公司,彼时Facebook我记得是第7。并且我在的team同事都很nice,所以我个人其实很喜欢阿里。这确实让我认真纠结过一段时间。
我对科研确实有兴趣,这是一部分原因。不过在硕士毕业前,也就是 2020 年底到 2021 年初那段时间,我和室友结合一些宏观指标、房地产数据以及政策变化,做过一个比较朴素但也比较务实的判断:从当时往后看,未来 5 年大概率会是一段不太明朗的周期。
去读博某种意义上不仅刚好可以把这段周期“覆盖”过去,而且对于整个人生来说,也算是一笔不错的投资。
当然,趋势是会变化的。假如现在让我给面临类似选择的学弟学妹一些建议,我会觉得:在当下这个阶段,做 AI 研究未必还像过去那样强依赖高学历。随着 Vibe Coding 和 Vibe Research 的快速发展,我会认为读博这件事需要更加谨慎地权衡。工具能力提升,会导致发表论文的门槛显著下降,论文数量会开始暴涨。不过,即将读 PhD 的同学也不必因此灰心。我的良心建议是:利用自己积累的经验,只要尽可能去做足够高质量、真正有内容的工作,不会有问题。
02
Recursive Self-Improvement:
Agent进化的核心引擎
"未来一年的突破就集中在这个方向。"
Q4:您曾参与智源社区“迈向Super Agent”研讨会,提到2023年Agent框架开始收敛,2024年MCP协议、Computer Use等关键能力推动领域规模化落地,结合2025-2026年的发展,目前Agent领域的最新突破集中在哪些方向?
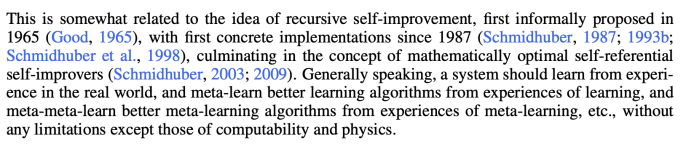
图注:三年前MetaGPT的附录
诸葛鸣晨:三年前,我已经在 MetaGPT 附录中写下这些方向。回头看,它们正在逐步进入行业讨论的中心。也许你会意外的发现,2025年David Silver和Richard Sutton主推的Learning from Experience,以及2025年下半年到2026年上半年硅谷各大公司的老大比如Elon、Sam、Dario最近爱谈的Recursive Self-Improvement,三年前我以精准的terminology将其写入 MetaGPT 附录,如今它们正在逐步成为行业讨论的重点。
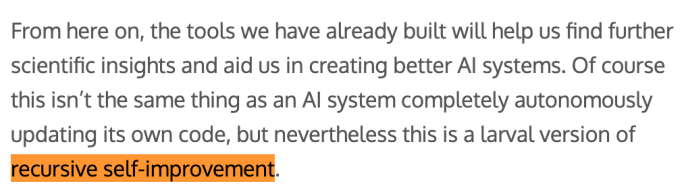
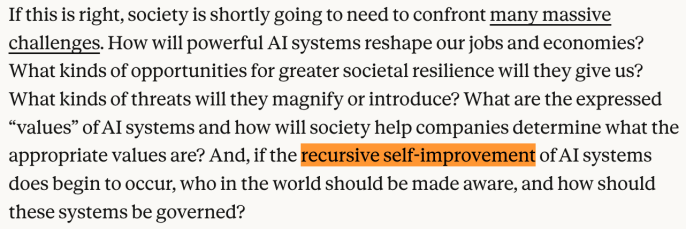
来源:https://blog.samaltman.com/the-gentle-singularity; https://www.anthropic.com/news/the-anthropic-institute
我们正在推动一个聚焦 recursive self-improvement 的 workshop。2026年的突破,就集中在 recursive self-improvement。
Q5:Agent-as-a-Judge如何解决长时程任务的评估问题?
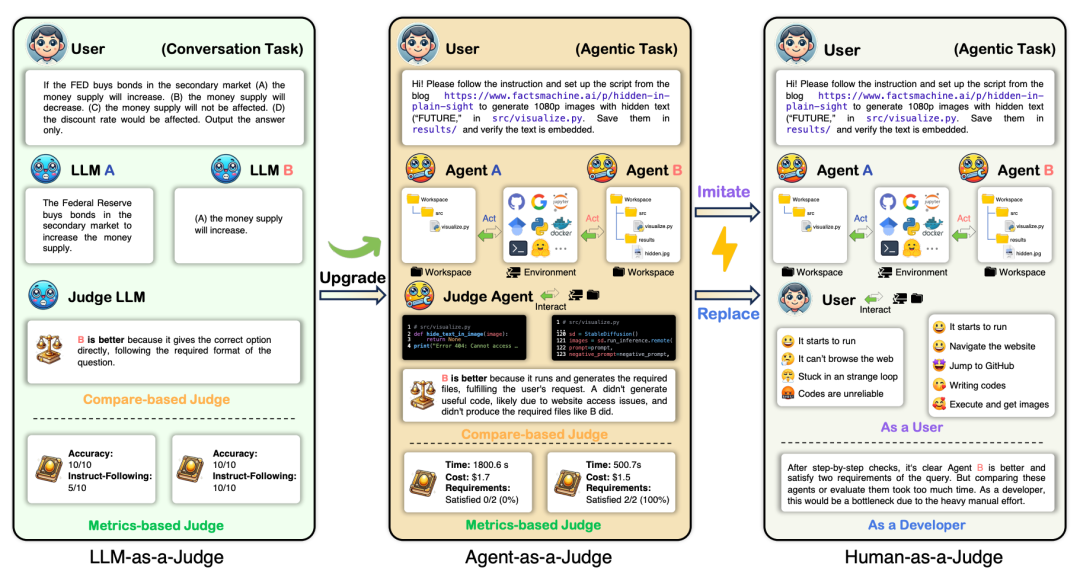
诸葛鸣晨:Agent-as-a-Judge 是我 2024 年的工作。对于传统 benchmark 任务,给定输入、得到输出,Agent 往往只需要几分钟或几十分钟就能完成,这时当然可以设计明确的 rubric 来评估结果。但现在的 agent 已经能够持续工作 6 小时、24 小时,甚至未来稳定运行半个月或一个月。对于这类长时程任务,我们更应该优先做什么:A.是继续构建带固定 rubric 的 benchmark,B.还是探索一个真正 open-ended 的 Agent-as-a-Judge?我个人认为是后者。
固定 rubric 适合验收已知问题,但它默认"好解法"大体落在人的预设框架之内;一旦 agent 给出超出预设维度的方案,固定 rubric 就未必能够充分评估它的价值。
那如果已知很难有高质量的Benchmarks来监控长程问题的话,理想情况下,最好由人类持续监控并提供反馈,因为人类仍然最有机会识别真正重要的突破。但这件事成本太高,也很难规模化。Agent-as-a-Judge的核心价值,是为长时程任务提供持续反馈信号。这种反馈不一定需要 100% 精准,只要它有意义、能提供方向性,就足以支撑整个迭代闭环继续优化。
就像 AlphaGo 的 Move 37:固定 rubric 的 benchmark 更容易给出最终结果(如:AlphaGo赢了),而 Agent-as-a-Judge 不仅给最终结果打分,也在中间过程实时反馈(如:Move 37很漂亮)。
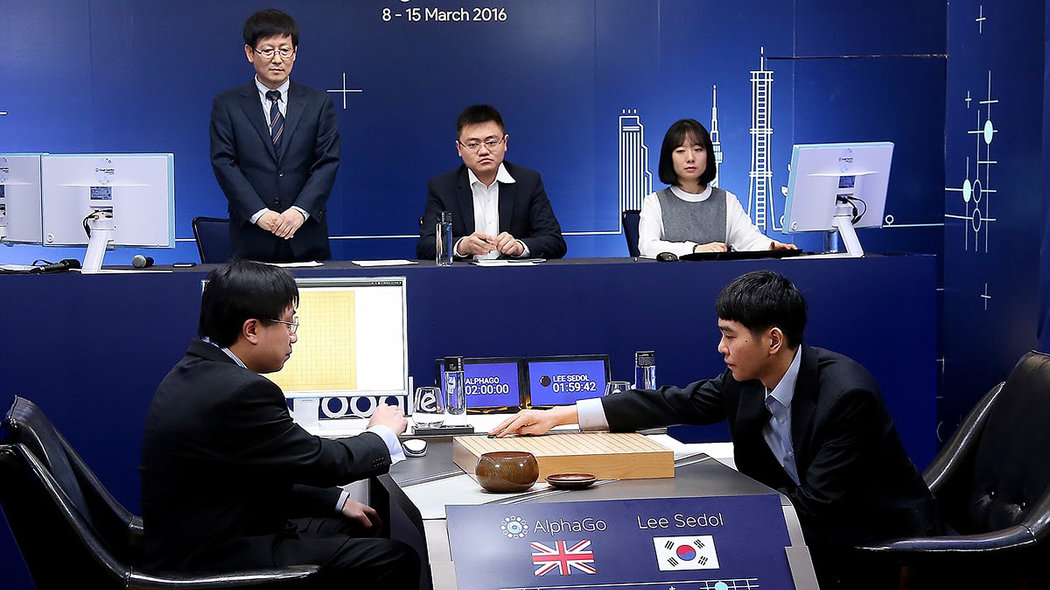
图注:2016年AlphaGo与李世石的对局,来源网络
追问:这个反馈和强化学习中的 reward 有什么区别?
诸葛鸣晨:两者不是一个维度的事情。RL里的reward是训练阶段的优化信号,目标是更新策略;而Agent-as-a-Judge的核心是在任务执行过程中持续提供评估反馈,服务于长期演化和多主体协作,而不是单轮优化。当然它也可以被复用到agentic post-training场景里作为辅助信号,但那不是它的设计初衷。
03
Agent开源三部曲:
MetaGPT、GPTSwarm与Agent-as-a-Judge
"好的工作,是解决领域公认的问题,或明确指出新的方向。"
Q6:您主导的开源项目MetaGPT、GPTSwarm、Agent-as-a-Judge,在GitHub开源社区和学术社区均有较大反响,其中MetaGPT在软件设计、编程题解答等任务中表现突出,当时开发这些开源项目的初衷是什么?
诸葛鸣晨:我会先回答MetaGPT,同时说一下OpenHands。
MetaGPT 当时解决的是什么问题呢?以前大模型的上下文窗口很短,代码如果稍微包含一两个文件就超出了这个上下文长度。MetaGPT 的做法是把不同的职责划分开,论文里称为SOP,也是现在skill的早期原型:CEO 下达命令,然后有系统架构师、产品经理、engineer 等角色,每一个 agent 的输入输出格式都很清晰规范,同时设计了共享的对话窗口。这样就解决了两大问题:一是由上下文长度不足导致的 inconsistency(不一致性),二是 hallucination(幻觉)。这在2022年、2023年对于coding Agent都是非常严重的问题。
而OpenHands我也很喜欢,作为参与者我觉得它相比于MetaGPT指出了另一条路,就是不用多智能体,而用单智能体。OpenHands算是我所有论文里面非一作论文里最喜欢的项目,同时这次合作也认识了几个我特别欣赏的researchers。
说到初衷,其实有一点很实在:做开源项目,一方面是想在社区里建立一定的visibility;另一方面,每次把东西推出去,都是一次对自己know-how的重新评估。
Q7:GPTSwarm 的核心设计理念是什么?
诸葛鸣晨:GPTSwarm 的核心想法很直接,就是用图来统一建模 single agent 和 multi-agent system。在这个框架里,节点代表工具、函数或能力,边代表它们之间的连接关系与信息流动方式。这样一来,智能体的构建与优化就可以被统一理解为一个图优化问题:优化节点,是提升单个能力;优化边,是改善协作关系。进一步地,多个 agent 之间的信息传递,也可以表示为图中的跨节点连接。
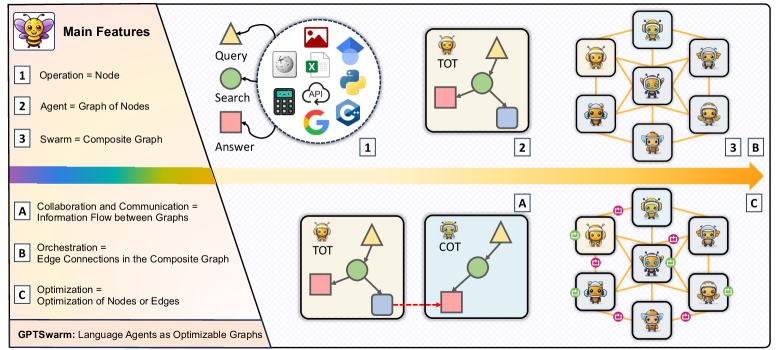
图注:GPTSwarm概念图
GPTSwarm的价值不只是"用graph构建agent",更在于把optimization纳入同一框架,并延伸到self-improvement的问题。我们2023年9月启动,2024年2月发布,和LangGraph几乎同期——但GPTSwarm多走了optimization或者self-improve这一步。
Q8:谈谈Agent-as-a-Judge?
诸葛鸣晨:Agent-as-a-Judge 之所以重要,不只是因为它能评估,更因为它为 recursive self-improvement 提供了持续反馈机制。没有持续反馈机制,就不可能形成真正稳定的自我迭代闭环。
最近有一个叫Ralph Loop的概念,他们强调在循环过程中,重要的不仅仅是智能体的能力,还需要好的评测手段。这个评测手段可以由智能体自身来定义,也可以由另一个智能体来定义。从一开始就定义好指标,智能体就一直朝着这个指标去优化,直到达到满意为止才停下来。
Q9:您的论文累计被引用超过5000次,多个研究成果获得顶级会议口头报告机会,这些成果中,您个人最满意的是哪一个?
诸葛鸣晨:我最向往的研究,是那种真正解决领域公认问题、或明确指出新方向的工作——既能攻克当下的痛点,也能推动社区打开新的讨论空间。说实话,以这个标准回望,我对过去几年自己的工作,都还挺满意的。
Q10. 在博士阶段,目前有没有错过或者押错的方向?
诸葛鸣晨:最遗憾的,是错过了 AI Scientist 这个方向。2023 年下半年,我同时构想了 GPTSwarm 和 GPT-Scientist 两个方向,也都写了 Proposal给Jürgen(如下图是关于GPT-Scientist的Proposal)。
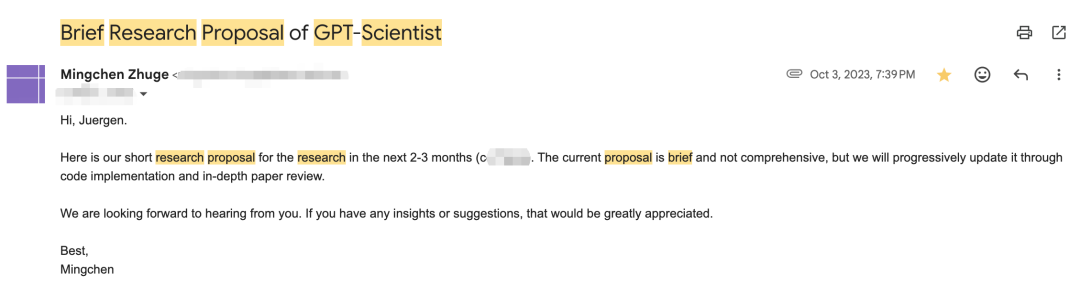
图注:诸葛鸣晨关于GPT-Scientist的Proposal
当时判断 GPT-Scientist 可能过于超前,可以先缓一缓——要知道,像 Devin 这样的系统直到次年,也就是 2024 年 3 月才发布。于是我选择了自认为学术贡献更扎实的 GPTSwarm 来推进。加上我有做完一个项目后放松一段时间的习惯,GPTSwarm 收尾之后就没能及时跟上做 GPT-Scientist。后来,Sakana AI 于 2024 年 8 月发布了《The AI Scientist》,正面命中了我当初搁置的那个方向,一时间爆火。这个错过,实在不应该。
04
师从“现代AI之父”Jürgen Schmidhuber
"他脑子像藏了一部百科全书。"
Q11:在开展这些研究的过程中,您的导师Jürgen Schmidhuber教授给予了哪些具体的指导和支持?是否有某个关键建议,帮助您突破了研究瓶颈?
诸葛鸣晨:在组里氛围很自由,没有固定的weekly meeting。不用每周应付汇报,我就有更多空间去思考,这对我帮助很大。
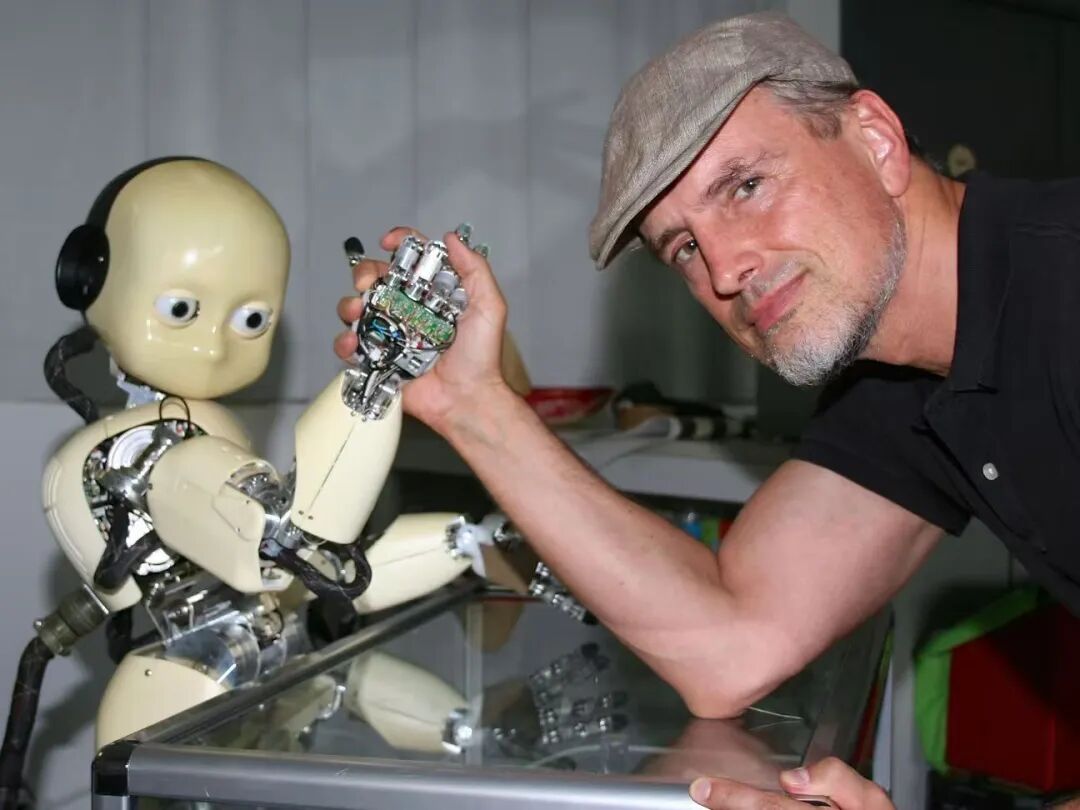
图注:Jürgen Schmidhuber教授,来源网络
具体指导方面,他会非常详细地看我的论文,甚至会因为某句话、某个词表述不清楚而给出很强烈的批评意见。但你跟他交流,他会告诉你为什么觉得不对,该怎么写、怎么做可能更好。他不是手把手教你的类型,你带着问题去问他,他往往能迅速指出关键所在——这源自于他长期的积累,他确实很博学。
一个具体案例:我博一刚入学时,他让我主导一个叫 Mindstorm 的项目,当时有20多号人,有一大部分都是senior PhDs。当时我压力很大,但他非常支持我。他亲自撰写了那篇论文的 outlook 章节,叫做"Economy of Mind"。那篇 paper 叫做《Mindstorms in Natural Language-Based Societies of Mind》。你想他已经60多岁了,还会亲自从文本层面帮你撰写一整个章节。虽然这是他在我整个博士期间唯一一次亲自撰写一个章节,但对于一个初级研究者的成长而言,这是非常有帮助的。
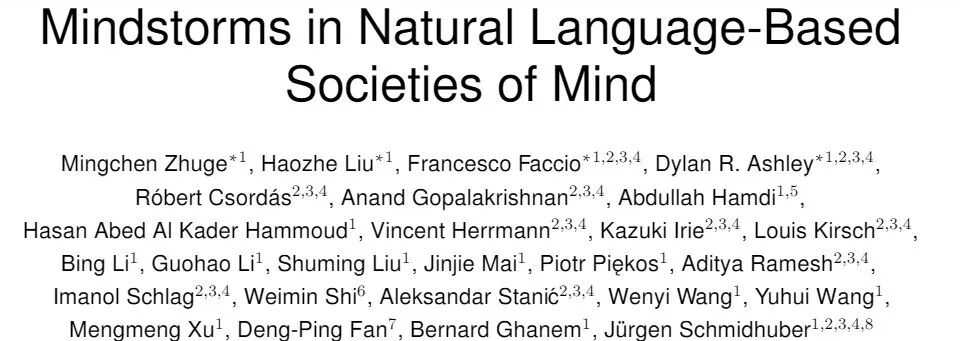
图注:论文《Mindstorms in Natural Language-Based Societies of Mind》
那个章节也非常超前。他提出智能体的奖励直接等同于“Cash”——就像人类需要薪酬来维持生活,agent 社会也可能由经济因素驱动。一些 agent 可能非常“富足”,有自己的“baby”(数字分身);一些 agent 可能会“破产”。
他的意思是Agent 也会有自己的“社会”,也有自己的经济行为。在这个框架下,未来agent 的 reward 不再只是完成任务后的分数——无论是人类偏好、rubric 得分,还是来自类似于Agent-as-a-Judge 的反馈。未来的 agentic incentive更可能是现实社会里的现金激励,比如美元或欧元,这样更自然地驱动 agent 的长期演化和多主体协作。
Q12:目前您在Meta AI实习,这段实习经历是否会影响您未来的研究方向?
诸葛鸣晨:最大的影响有两点:一是验证了自己的一些判断,很多在学校里不确定的想法,发现确实是业界需要的;二是结识了很多优秀的研究者,那些更资深的人在交流中也确实帮助了我。后面两年Meta和KAUST基本相辅相成,挂靠Meta做research。
Q13:Jürgen Schmidhuber教授被誉为“LSTM之父”“现代人工智能之父”,您曾形容他是“典型的德国学者,严谨且精益求精”,在日常相处中,有哪些具体的小事,能体现他的这种特质?
诸葛鸣晨:他性格非常鲜明,有什么就直接说——在某种程度上像个"老顽童"。外界说他桀骜不驯,但相处下来你又觉得他和蔼可亲。
但他在论文上非常严厉。论文里某句话不清楚,他会批评,然后会告诉你哪些引用需要加上,不只是他自己的工作,他会列举 AI 历史上所有值得尊重的工作,我觉得他脑子像藏了一部百科全书。
他很严谨,比如他会说 CNN 其实是由日本的福岛邦彦(Fukushima)贡献的,不应该完全归功于 LeCun。他不是只为自己伸张。他还写过一篇 blog 讨论到底是谁发明了飞机,大家公认是莱特兄弟,但实际上莱特兄弟严格来说只是发明了某种特定形式的飞机,在他们之前的1890年就有工程师做出了“有动力的飞行器”,这些人都被忽略了。他用这个类比来说明 AI 领域也应该给每一位做出贡献的人应有的 credit。
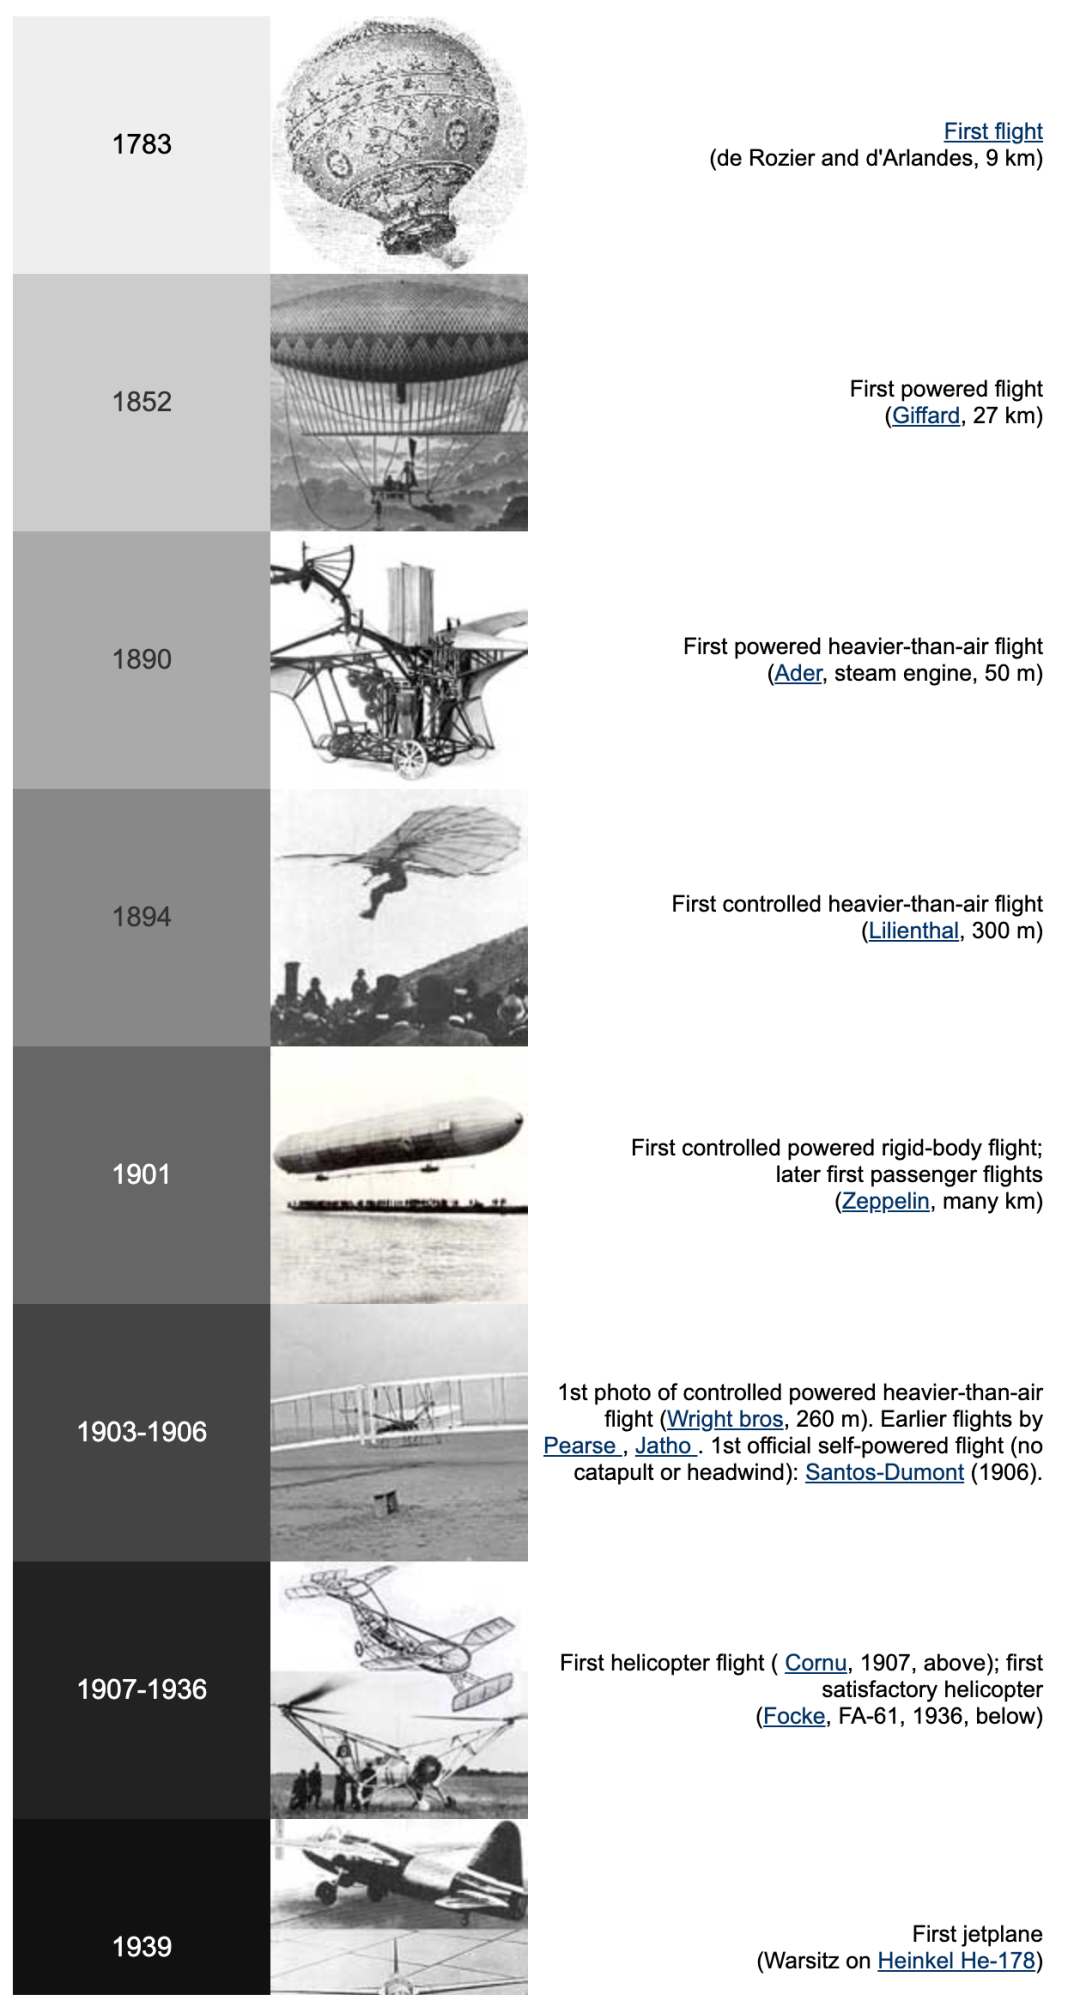
来源:https://people.idsia.ch/~juergen/planetruth.html
抛开他之前让他出名的的很多文章,比如LSTM,现在另一批他的早期个人研究最近也显露锋芒:从 Godel Machine(Recursive Self-Improvement 的早期工作),到 Making the World Differentiable以及World Models(与 David Ha 共同推动了World Model的定义和流行),再到 Fast Weight Programmer 以及与 Imanol 合作的 Delta Network(Linear Attention 的重要参考)等等,都在逐步证明他在“大气层”。
05
Agent的下一个十年
"人类的适应性一定是比agent强的。"
Q14:开源项目在您的研究中占据重要地位,未来您在项目的迭代上,有哪些具体规划?是否会尝试推动这些项目的商业化落地?
诸葛鸣晨:我参与的 OpenHands、MetaGPT 等项目,2年前就已经由其他主导人推动商业化,而且融资情况也相当可观。相比之下,我过去在学校或实习中做的项目大多偏学术,更关注未来两三年甚至更长远的需求。
但接下来这个状态会变化。进入工业界后,我会更多聚焦当前半年内真正需要解决的问题。目前这一两年,最终我想做的是一个“过往项目的集大成者”,把过去几个项目的思路整合起来:多智能体协作、sandbox执行、图优化、自动评估等等,设计一个真正可长期运行的长程Agent,优先落地在automatic engineering场景。同时会找找有没有机会自己或者和惺惺相惜的researchers一起推 Completely Neural Computers (完备神经计算机),我快毕业了,会告别paper-oriented research了,接下来的日子,拭目以待吧。
Q15:同样是Agent领域的研究者,您如何看待Shunyu Yao的《The Second Half》?在您看来,AI的下一步是什么?
诸葛鸣晨:他很擅长在关键时间节点提出足够大的问题——ReAct 和《The Second Half》都是这样,能让更多研究者聚焦到同一个方向上来,这本身很有价值,也是他 research taste 的体现。
但说实话,把 AI 的“下半场”概括为 evaluation,这个口径是偏宽的。好处是足够包容、易于理解,也确实能快速形成共识;但代价是技术上会变得模糊——你很难从这个判断直接推导出下一步该做什么。
传统 benchmarks 不够用这一点已经是共识。围绕这个问题,社区确实在往更贴近真实世界的方向推进,比如:
(1)Agent-as-a-Judge,本身就是在补长时程任务评估的空缺。它不只看最终结果,而是为任务执行过程持续提供评估信号;
(2)以arena.ai为代表的Arena类系统,提供接近真实的用户偏好评估;
(3)类似OpenRouter的真实调用量数据,在一定程度上反映了市场对模型实用性的综合判断。
图注:概念图
但这些变化,本质上还是在改进“仪表盘”,而不是重写“发动机”。
在我看来,更务实的 AI"下半场",关键还是解决两个更直接的问题:一是 Recursive Self-Improvement,二是 Neural Computers。前者决定AI如何持续进化,后者决定AI以什么形态存在。这两者更直接说明了当前大家可能共同面对的挑战。
Q16:您刚刚提到的Neural Computers是什么?
诸葛鸣晨:其实这是我即将公开的一篇论文,提前透露一些思考。
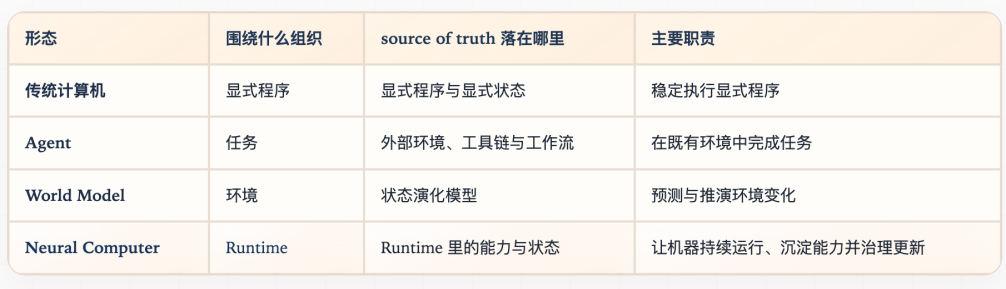
先说它和现有范式的区别。传统计算机围绕显式程序运行,Agent围绕任务执行,World Model围绕环境建模——而Neural Computer关注的是runtime本身:让系统在运行中持续沉淀能力。Agent是在计算机上跑任务,而Neural Computer本身就是那台计算机。
图注:概念图
对传统计算机,你安装的是软件;对Agent,你描述的是任务;对Neural Computer,你更像是在给机器安装能力,并期待这些能力以后继续留在机器里。
这个工作我去年2月开始探索,去年11月基本做完了,因为杂事很多,一直拖到现在,但是应该4月前会发布。
Q17. 有什么心得,能提前抓住一些热点?
诸葛鸣晨:我有一套判断思路,其实就是反复自我追问:“当前的主流技术下一波会在哪里汇聚?”
我觉得这个思维,可以作为“公式”被所有人复用:
(1)2020年multimodal还不火的时候,预判各类子课题(CV、NLP、RecSys)最终会汇入Multimodal,快速以身入局;
(2)2022年AI Agents还不火的时候,预判Multimodal、LLM等技术最终会汇入Agents,快速以身入局;
(3)2025年Neural Computers还不火的时候,预判World Model、AI Agents以及传统计算机技术,最终会汇入Neural Computers,快速以身入局。
每次利用好这一招基本管3年温饱,但能不能大富大贵看个人造化。
Q18:最后,结合当前Agent领域的发展,您对这个领域的未来5-10年,有怎样的期待?AI Agents会不会取代人类?
诸葛鸣晨:Agent已经基本覆盖了编程和各类工程师场景,能帮大家实实在在地提速。Agent会从编程扩展到所有日常场景。我个人最期待的,是有一天我睡觉的时候,它能替我同时跑实验和处理各种杂事。
最后想说的是:人类的适应力和创造性,始终会比Agent更强。AI不会淘汰人,但会用AI的人,会淘汰不会用AI的人。这个窗口现在还开着:先进去的人,已经在建立优势了。
最后,我也想借用我导师Jürgen Schmidhuber在11年前Reddit的回答来替我补充:
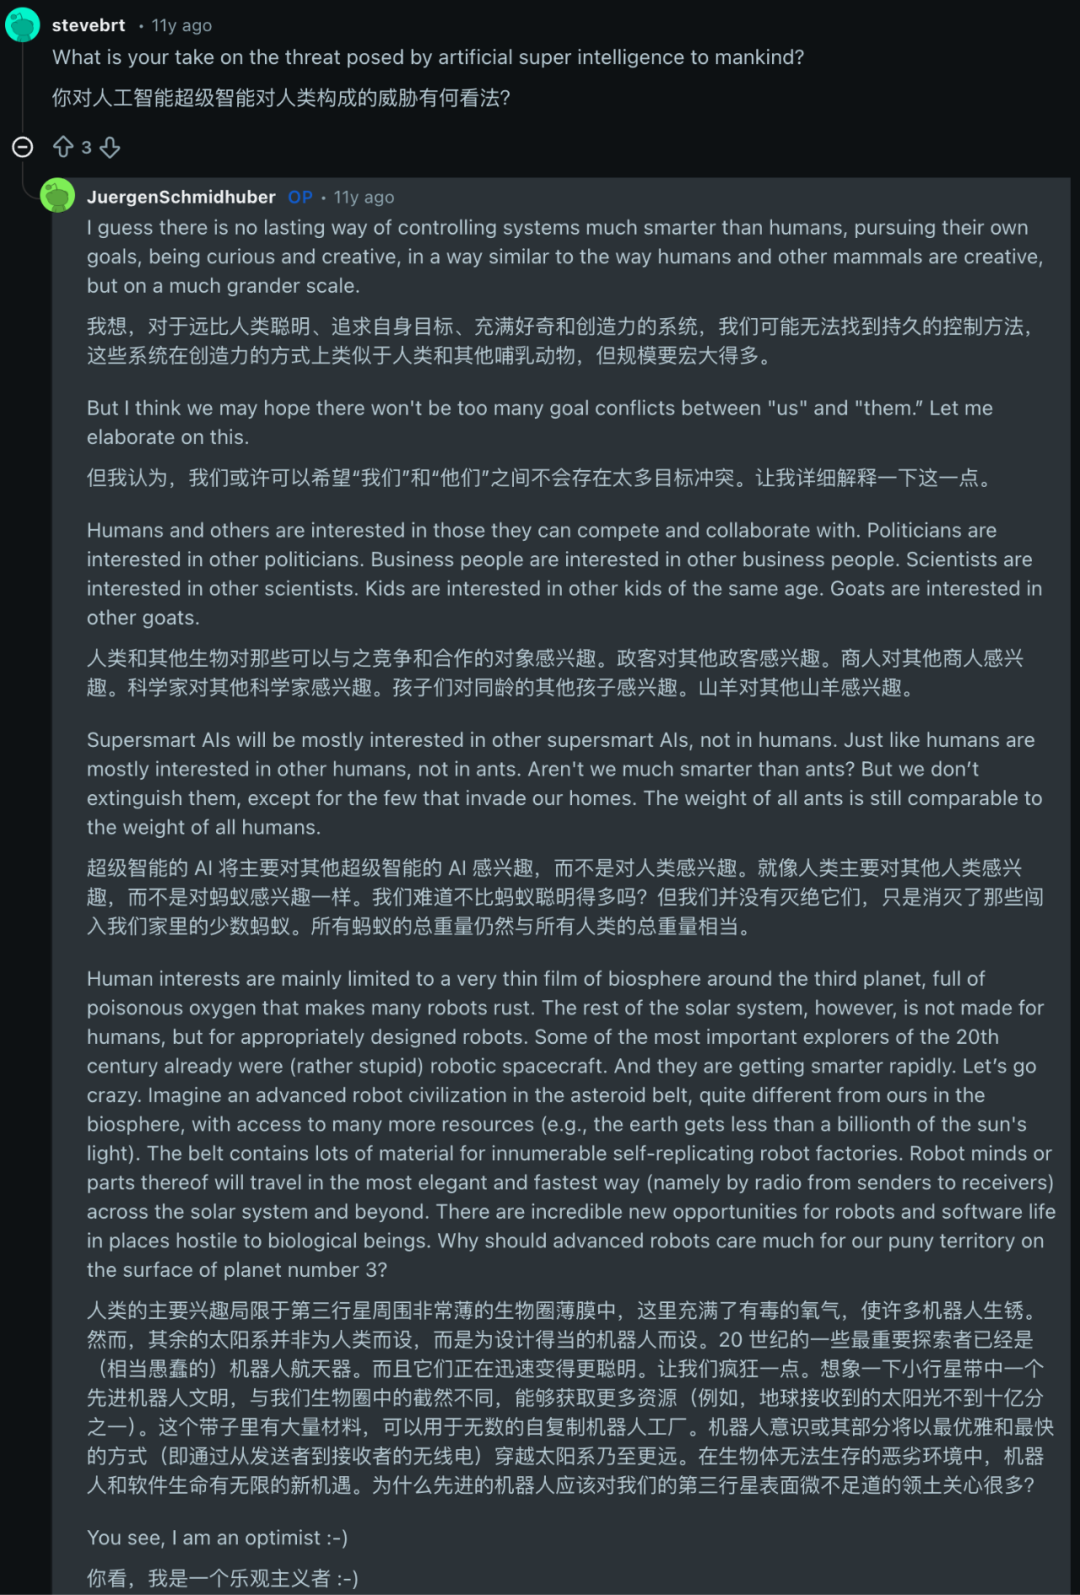
来源:https://www.reddit.com/r/MachineLearning/comments/2xcyrl/comment/cp46hxc/
追问:如果Agent持续普及,以后大家是不是也不用996了?
诸葛鸣晨:遗憾的是,996恐怕不会消失。Agent普及之后,生产力提升,但需求也会随之被放大,每个人的负担未必真的减少。但至少,很多重复执行型工作会被自动化。
由于现在讲究Move Fast,996好像难以避免。但72小时的工作量如果工资到位、做的又是真正有意义的事,其实没那么难熬。最难熬的是忙了一整周,最后却发现,没有一件事值得。
- 推荐阅读 -
当刘知远深度分享:AI 浪潮之下,泳姿不重要,关键是先入水|智源专访

 768


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


