


摘要
本文设计并实现了一个基于 SpringBoot 的求职与职业推荐系统。系统采用协同过滤推荐算法,根据用户的简历信息、浏览历史和职位偏好,为用户个性化推荐合适的职位。系统分为前台求职端和后台管理端,前台支持职位浏览、简历投递、收藏等功能,后台支持职位管理、用户管理、推荐策略配置等功能。系统采用前后端分离架构,后端基于 SpringBoot + MyBatis-Plus + MySQL + Redis,前端基于 Vue 3 + Element Plus,推荐结果通过 Redis 缓存提升查询性能。
关键词:SpringBoot;协同过滤;推荐系统;求职招聘;个性化推荐
一、研究背景与意义
随着互联网的发展,招聘网站上的职位信息呈爆炸式增长。以 BOSS 直聘为例,每日新增职位数以万计,求职者面对海量信息往往不知道从何看起。传统的关键词搜索方式存在两个明显缺陷:一是用户可能不知道用什么关键词来描述自己想要的职位,二是搜索结果没有考虑用户的个性化偏好,所有人搜索同一个关键词得到的结果完全相同。
推荐系统作为解决信息过载的有效手段,在电商(淘宝"猜你喜欢")、视频(B站推荐)、音乐(网易云音乐每日推荐)等领域已得到广泛应用,技术成熟度较高。但在招聘领域,推荐系统的应用仍处于起步阶段,主要原因是招聘场景的用户行为数据稀疏(一个求职者一天可能只浏览十几个职位,远少于电商场景的几百次点击),冷启动问题更加突出。
本文将协同过滤算法应用于求职推荐场景,设计并实现了一个个性化的职位推荐系统。系统的创新点在于:将用户的行为类型(浏览、收藏、投递)赋予不同权重来构建用户兴趣向量,并通过热门职位补全机制解决数据稀疏情况下的推荐覆盖不足问题。
二、系统技术栈
2.1 后端技术
|
技术 |
版本 |
说明 |
|
SpringBoot |
2.7.x |
核心框架,自动装配 + 内嵌 Tomcat |
|
MyBatis-Plus |
3.5.x |
ORM 框架,简化 CRUD 和分页 |
|
MySQL |
8.0 |
关系型数据库 |
|
Redis |
6.x |
缓存推荐结果、验证码、热点职位 |
|
JWT |
0.9.1 |
无状态登录鉴权 |
|
Apache Commons Math |
3.6.1 |
数学计算库(余弦相似度计算) |
|
Hutool |
5.8.x |
工具类库 |
2.2 前端技术
|
技术 |
版本 |
说明 |
|
Vue 3 |
3.2.x |
前端框架,Composition API |
|
Element Plus |
2.x |
UI 组件库 |
|
Axios |
0.27.x |
HTTP 请求,封装拦截器 |
|
ECharts |
5.x |
后台数据可视化 |
|
Vue Router |
4.x |
前端路由 |
三、系统架构设计
3.1 整体架构
系统采用前后端分离的 B/S 架构。前端通过 Axios 调用后端 RESTful API,后端按标准的 MVC 分层组织代码。推荐算法作为独立的 Service 模块,通过 Redis 缓存推荐结果,避免每次请求都重新计算用户相似度。
3.2 后端分层结构
|
层级 |
包名 |
职责 |
|
Controller 层 |
controller |
接收请求、参数校验、返回响应 |
|
Service 层 |
service |
业务逻辑 + 推荐算法实现 |
|
Mapper 层 |
mapper |
数据库操作 |
|
Entity 层 |
entity |
数据库实体类 |
|
DTO / VO |
dto / vo |
数据传输对象 / 视图对象 |
|
Config |
config |
跨域、Redis、MyBatis 配置 |
四、系统功能设计
4.1 求职者端功能
|
功能模块 |
子功能 |
说明 |
|
用户注册登录 |
邮箱注册 |
邮箱验证码注册,区分求职者/企业身份 |
|
JWT 登录 |
用户名 + 密码 + 图形验证码 | |
|
密码找回 |
邮箱验证码重置密码 | |
|
个性化推荐 |
首页推荐 |
基于协同过滤算法推荐职位 |
|
相似职位 |
职位详情页推荐相似岗位 | |
|
热门补全 |
推荐数量不足时用热门职位补全 | |
|
职位搜索 |
多条件搜索 |
企业名称、招聘岗位、岗位薪资 |
|
分类筛选 |
岗位分类下拉、排序 | |
|
职位详情 |
职位信息 |
职位描述、薪资范围、经验要求 |
|
公司信息 |
企业简介、企业规模、企业Logo | |
|
投递入口 |
一键投递简历 | |
|
简历管理 |
在线填写 |
基本信息、教育经历、工作经历 |
|
附件上传 |
支持 PDF/Word 简历附件 | |
|
简历预览 |
在线预览简历排版效果 | |
|
职位投递 |
投递记录 |
查看已投递职位列表 |
|
状态跟踪 |
待查看→已查看→面试邀请→不合适 | |
|
收藏夹 |
收藏/取消 |
收藏感兴趣的职位 |
|
职业测评 |
兴趣测评 |
简单的职业兴趣测评问卷 |
|
测评结果 |
推荐适合的职业方向 |
4.2 企业/后台管理端功能
|
功能模块 |
子功能 |
说明 |
|
企业管理 |
企业注册 |
企业信息注册,等待审核 |
|
信息维护 |
企业名称、Logo、简介、规模 | |
|
职位管理 |
发布职位 |
职位标题、薪资、城市、要求 |
|
上下架 |
控制职位在前台的展示 | |
|
编辑/删除 |
修改职位信息或删除 | |
|
简历管理 |
投递列表 |
查看所有投递该职位的简历 |
|
简历筛选 |
标记简历状态(已查看/面试/不合适) | |
|
面试邀请 |
发送面试邀请通知 | |
|
用户管理 |
求职者列表 |
分页查询、条件筛选 |
|
禁用账号 |
封禁违规用户 | |
|
数据统计 |
核心指标 |
职位发布量、投递量、活跃用户数 |
|
趋势图表 |
ECharts 折线图、柱状图、饼图 | |
|
推荐管理 |
参数配置 |
推荐数量、相似度阈值、行为权重 |
|
效果监控 |
推荐点击率、投递转化率 |
五、系统截图展示
以下是系统实际运行的界面效果,从首页到登录逐页展示:
5.1 系统首页
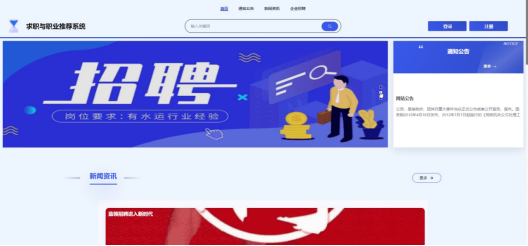
图1 系统首页:招聘横幅 + 通知公告面板 + 新闻资讯区域
系统首页采用蓝色主题,整体风格专业稳重,符合招聘平台的调性。顶部导航栏左侧是系统 Logo 和名称"求职与职业推荐系统",中间是四个导航入口(首页、通知公告、新闻资讯、企业招聘),右侧是关键词搜索框和登录/注册按钮。主体区域左侧是大型招聘横幅,以深蓝色渐变背景配以白色"招聘"大字,副标题展示岗位要求,右侧是通知公告面板,展示网站最新公告。下方是新闻资讯区域,展示行业最新动态。
5.2 通知公告页
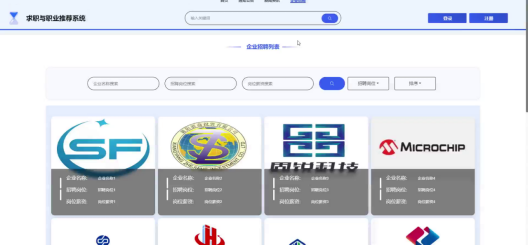
图2 通知公告页:卡片式布局,展示网站公告、关于我们、联系方式等
通知公告页面采用卡片式布局,每张卡片包含标题、时间戳和大号灰色序号装饰元素。内容涵盖网站公告、关于我们、联系方式、网站介绍四个模块,所有卡片的时间戳一致,表明这是系统初始化时的测试数据。卡片采用白底圆角设计,阴影效果微妙,整体排版简洁现代。当前页面处于"通知公告"导航项下,导航栏中该项以蓝色高亮标识。
5.3 新闻资讯页
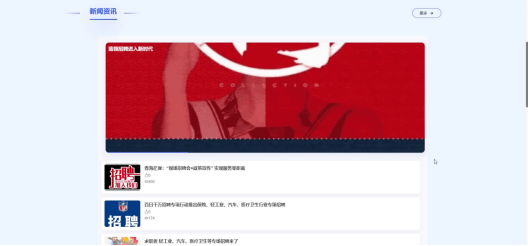
图3 新闻资讯页:特色横幅 + 新闻列表,支持浏览量和发布时间展示
新闻资讯页面顶部有特色横幅,展示重点新闻"蓝领招聘进入新时代",红色背景配以白色大字,视觉冲击力强。下方以图文列表形式展示更多新闻条目,每条新闻包含缩略图、标题、浏览量(菱形图标+数字)和发布时间。页面右侧有"更多 →"按钮,点击可加载更多新闻。整体配色与首页一致,延续蓝色系风格。
5.4 企业招聘页
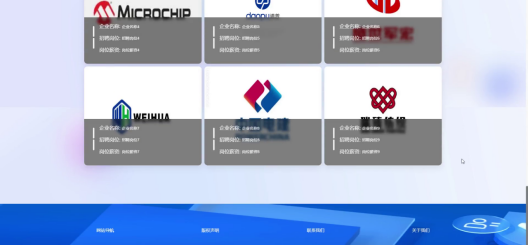
图4 企业招聘页:企业卡片网格展示,含企业Logo、名称、岗位、薪资
企业招聘页面以网格形式展示企业招聘卡片,采用 2 行 3 列布局,共展示 6 家企业。每张卡片上方是白色的企业 Logo 展示区,下方是灰色信息面板,包含企业名称、招聘岗位和岗位薪资三个字段。卡片设计统一,视觉一致性高。页面底部有蓝色渐变页脚栏,包含网站导航、版权声明、联系我们、关于我们等链接,右侧有用户菜单图标。
5.5 企业招聘列表(搜索筛选)
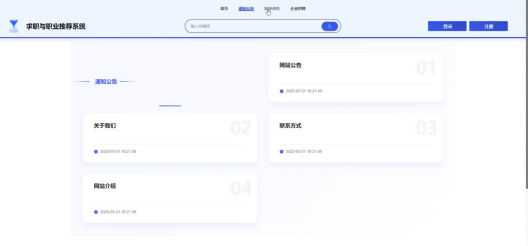
图5 企业招聘列表:支持企业名称、招聘岗位、岗位薪资多条件搜索 + 排序
招聘列表页提供丰富的搜索和筛选功能。页面标题"企业招聘列表"居中显示,下方是白色圆角搜索容器,包含三个输入框:企业名称搜索、招聘岗位搜索、岗位薪资搜索,右侧有蓝色搜索按钮。搜索区域下方还有岗位分类下拉框和排序下拉框,用户可以按不同维度排序结果。搜索结果以四列卡片网格形式展示,每张卡片包含企业 Logo、企业名称、招聘岗位和岗位薪资信息。
5.6 用户注册页
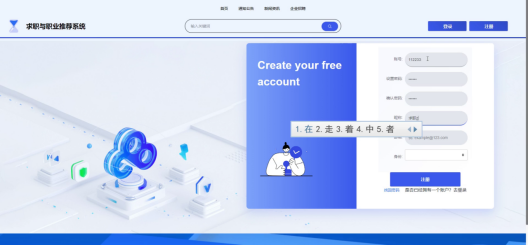
图6 注册页:完整注册表单,包含账号、密码、昵称、邮箱、身份选择等字段
注册页面采用左右分栏布局。左侧是 3D 等距风格的装饰区域,蓝色背景上有云朵图标、几何立方体、勾选标记等元素,底部有手持手机和验证徽章的人物线条插画,整体科技感十足。右侧是注册表单,顶部蓝色渐变标题栏"Create your free account"。表单包含账号、设置密码、确认密码、昵称、邮箱、身份选择(下拉菜单,区分求职用户和企业用户)等字段。表单支持中文输入法,底部蓝色"注册"按钮,下方有"找回密码"和"去登录"链接。
5.7 登录页
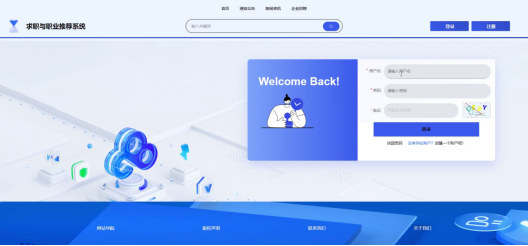
图7 登录页:用户名密码登录 + 验证码校验 + 密码找回/注册引导
登录页面设计专业。左侧有 3D 装饰元素,包括"3D"大字和抽象几何图形,营造科技氛围。右侧登录表单卡片分为两部分:左侧蓝色欢迎面板"Welcome Back!"配以手持盾牌和勾选标记的人物插画,传达安全可靠的理念;右侧是登录表单,包含用户名(提示"请输入用户名")、密码(提示"请输入密码")、验证码(提示"不区分大小写",配以彩色验证码图片)三个字段。底部蓝色"登录"按钮,下方有"找回密码"和"没有存在账户?创建一个账户吧!"两个链接。页脚采用蓝色渐变,展示网站导航、版权声明、联系我们、关于我们四列信息。
六、推荐算法设计
6.1 算法选型
本系统采用基于用户的协同过滤算法(User-CF)作为核心推荐算法,同时结合基于内容的推荐和热门补全策略作为补充。
选择 User-CF 的原因:
- 招聘场景中用户的行为数据(浏览、收藏、投递)可以构建用户-职位评分矩阵,满足协同过滤的数据基础
- 余弦相似度计算效率较高,适合在 Web 系统中实时计算
- 算法逻辑直观、可解释性强,答辩时容易讲清楚
6.2 用户行为建模
系统将用户的三种行为类型赋予不同权重,构建用户兴趣向量:
|
行为类型 |
权重分值 |
说明 |
|
浏览(view) |
1 分 |
用户点击查看了职位详情 |
|
收藏(favorite) |
3 分 |
用户主动收藏了职位 |
|
投递(apply) |
5 分 |
用户提交了简历投递 |
同一用户对同一职位可能有多种行为,权重分值累加。例如某用户浏览了职位A(1分),又收藏了职位A(3分),则该用户对职位A的兴趣度为 1 + 3 = 4 分。
6.3 相似度计算
采用余弦相似度计算用户之间的相似度:
sim(u, v) = (N(u) ∩ N(v)) / sqrt(|N(u)| × |N(v)|)
其中 N(u) 表示用户 u 有过行为的职位集合,N(u) ∩ N(v) 表示两个用户共同有过行为的职位集合。这个公式的核心思想是:两个用户共同交互过的职位越多,且各自交互过的职位总数越少(即交集占比越高),这两个用户越相似。
展开来看,完整的余弦相似度公式为:
sim(u, v) = Σ(r_ui × r_vi) / (sqrt(Σ r_ui²) × sqrt(Σ r_vi²))
其中 r_ui 表示用户 u 对职位 i 的兴趣度评分。
6.4 推荐生成公式
p(u, i) = Σ sim(u, v) × r(v, i) (v ∈ S(u, K))
其中:
- u 是目标用户
- i 是候选职位
- S(u, K) 是与用户 u 最相似的 K 个用户集合(本系统取 K=20)
- r(v, i) 是相似用户 v 对职位 i 的兴趣度
- p(u, i) 是用户 u 对职位 i 的预测兴趣度
将所有候选职位按预测兴趣度降序排列,取前 N 个作为推荐结果。
6.5 热门补全策略
由于用户行为数据稀疏(新用户可能没有任何行为记录),协同过滤算法可能无法产生足够的推荐结果。系统设计了热门补全策略:当推荐结果不足 N 个时,从浏览量/投递量最高的职位中补充,补充时排除用户已经浏览或投递过的职位。
6.6 算法代码实现
@Service
public class RecommendServiceImpl implements RecommendService {
@Autowired
private UserBehaviorMapper behaviorMapper;
@Autowired
private PositionMapper positionMapper;
@Autowired
private RedisTemplate redisTemplate;
@Override
public List<PositionVO> recommendByUserCF(Integer userId, int topN) {
// 1. 先查 Redis 缓存
String cacheKey = "recommend:user:" + userId;
List<PositionVO> cache = (List<PositionVO>)
redisTemplate.opsForValue().get(cacheKey);
if (cache != null && cache.size() > 0) {
return cache.stream().limit(topN).collect(Collectors.toList());
}
// 2. 获取目标用户的行为向量
Map<Integer, Double> userBehavior = getUserBehavior(userId);
// 3. 计算与所有其他用户的余弦相似度
List<UserSimilarity> similarities =
calculateUserSimilarity(userId, userBehavior);
// 4. 取相似度最高的 TOP 20 个用户
List<UserSimilarity> topUsers = similarities.stream()
.limit(20).collect(Collectors.toList());
// 5. 遍历相似用户的行为,生成推荐候选及预测分
Map<Integer, Double> recommendScores = new HashMap<>();
for (UserSimilarity sim : topUsers) {
Map<Integer, Double> otherBehavior =
getUserBehavior(sim.getUserId());
for (Map.Entry<Integer, Double> entry : otherBehavior.entrySet()) {
Integer positionId = entry.getKey();
Double score = entry.getValue();
if (userBehavior.containsKey(positionId)) continue;
double weightedScore = sim.getSimilarity() * score;
recommendScores.merge(positionId, weightedScore, Double::sum);
}
}
// 6. 按预测分降序排列,取 TOP N
List<Integer> recommendIds = recommendScores.entrySet().stream()
.sorted(Map.Entry.<Integer, Double>comparingByValue().reversed())
.limit(topN).map(Map.Entry::getKey).collect(Collectors.toList());
// 7. 推荐不足时用热门职位补全
if (recommendIds.size() < topN) {
List<Integer> hotPositions = getHotPositions(topN - recommendIds.size());
for (Integer pid : hotPositions) {
if (!recommendIds.contains(pid) && !userBehavior.containsKey(pid)) {
recommendIds.add(pid);
if (recommendIds.size() >= topN) break;
}
}
}
// 8. 查询职位详情并返回
List<PositionVO> result = positionMapper.selectBatchIds(recommendIds)
.stream().map(this::convertToVO).collect(Collectors.toList());
// 9. 写入 Redis 缓存,1 小时过期
redisTemplate.opsForValue().set(cacheKey, result, 1, TimeUnit.HOURS);
return result;
}
private double cosineSimilarity(Map<Integer, Double> user1,
Map<Integer, Double> user2) {
Set<Integer> items1 = user1.keySet();
Set<Integer> items2 = user2.keySet();
Set<Integer> intersection = new HashSet<>(items1);
intersection.retainAll(items2);
if (intersection.isEmpty()) return 0;
double dotProduct = 0;
for (int item : intersection) {
dotProduct += user1.get(item) * user2.get(item);
}
double norm1 = Math.sqrt(items1.size());
double norm2 = Math.sqrt(items2.size());
return dotProduct / (norm1 * norm2);
}
private Map<Integer, Double> getUserBehavior(Integer userId) {
Map<Integer, Double> behavior = new HashMap<>();
List<UserBehavior> behaviorList = behaviorMapper.selectList(
new LambdaQueryWrapper<UserBehavior>()
.eq(UserBehavior::getUserId, userId));
for (UserBehavior b : behaviorList) {
double score = 0;
if ("view".equals(b.getType())) score = 1;
else if ("favorite".equals(b.getType())) score = 3;
else if ("apply".equals(b.getType())) score = 5;
behavior.merge(b.getPositionId(), score, Double::sum);
}
return behavior;
}
}
七、数据库设计
数据库共设计了 7 张核心表:
7.1 用户表
CREATE TABLE `user` (
`id` int NOT NULL AUTO_INCREMENT,
`username` varchar(50) NOT NULL COMMENT '用户名',
`password` varchar(100) NOT NULL COMMENT '密码(MD5加密)',
`email` varchar(100) DEFAULT NULL COMMENT '邮箱',
`nickname` varchar(50) DEFAULT NULL COMMENT '昵称',
`phone` varchar(20) DEFAULT NULL COMMENT '手机号',
`avatar` varchar(255) DEFAULT NULL COMMENT '头像',
`role` varchar(20) DEFAULT 'job_seeker' COMMENT '角色:job_seeker求职者 enterprise企业 admin管理员',
`status` int DEFAULT '1' COMMENT '状态 1正常 0禁用',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
UNIQUE KEY `uk_username` (`username`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户表';
7.2 企业信息表
CREATE TABLE `enterprise` (
`id` int NOT NULL AUTO_INCREMENT,
`user_id` int NOT NULL COMMENT '关联用户ID',
`name` varchar(200) NOT NULL COMMENT '企业名称',
`logo` varchar(500) DEFAULT NULL COMMENT '企业Logo',
`description` text COMMENT '企业简介',
`scale` varchar(50) DEFAULT NULL COMMENT '企业规模',
`industry` varchar(100) DEFAULT NULL COMMENT '所属行业',
`city` varchar(50) DEFAULT NULL COMMENT '所在城市',
`status` int DEFAULT '0' COMMENT '审核状态 0待审核 1已通过 2已拒绝',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='企业信息表';
7.3 职位表
CREATE TABLE `position` (
`id` int NOT NULL AUTO_INCREMENT,
`title` varchar(200) NOT NULL COMMENT '职位名称',
`enterprise_id` int NOT NULL COMMENT '企业ID',
`salary_min` int NOT NULL COMMENT '最低薪资(K)',
`salary_max` int NOT NULL COMMENT '最高薪资(K)',
`city` varchar(50) NOT NULL COMMENT '工作城市',
`experience` varchar(50) DEFAULT NULL COMMENT '经验要求',
`education` varchar(50) DEFAULT NULL COMMENT '学历要求',
`description` text COMMENT '职位描述',
`tags` varchar(500) DEFAULT NULL COMMENT '职位标签(JSON数组)',
`view_count` int DEFAULT '0' COMMENT '浏览数',
`apply_count` int DEFAULT '0' COMMENT '投递数',
`status` int DEFAULT '1' COMMENT '状态 1上架 0下架',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
KEY `idx_enterprise` (`enterprise_id`),
KEY `idx_status` (`status`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='职位表';
7.4 用户行为表(推荐算法数据源)
CREATE TABLE `user_behavior` (
`id` int NOT NULL AUTO_INCREMENT,
`user_id` int NOT NULL COMMENT '用户ID',
`position_id` int NOT NULL COMMENT '职位ID',
`type` varchar(20) NOT NULL COMMENT '行为类型:view浏览 favorite收藏 apply投递',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
KEY `idx_user` (`user_id`),
KEY `idx_position` (`position_id`),
KEY `idx_type` (`type`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户行为表';
7.5 简历表
CREATE TABLE `resume` (
`id` int NOT NULL AUTO_INCREMENT,
`user_id` int NOT NULL COMMENT '用户ID',
`real_name` varchar(50) NOT NULL COMMENT '真实姓名',
`gender` varchar(10) DEFAULT NULL COMMENT '性别',
`birthday` date DEFAULT NULL COMMENT '出生日期',
`phone` varchar(20) DEFAULT NULL COMMENT '联系电话',
`email` varchar(100) DEFAULT NULL COMMENT '邮箱',
`education` varchar(50) DEFAULT NULL COMMENT '最高学历',
`school` varchar(100) DEFAULT NULL COMMENT '毕业院校',
`major` varchar(100) DEFAULT NULL COMMENT '专业',
`experience` text COMMENT '工作/实习经历',
`skills` text COMMENT '技能特长',
`self_intro` text COMMENT '自我评价',
`attachment` varchar(500) DEFAULT NULL COMMENT '简历附件URL',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
KEY `idx_user` (`user_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='简历表';
7.6 投递记录表
CREATE TABLE `application` (
`id` int NOT NULL AUTO_INCREMENT,
`user_id` int NOT NULL COMMENT '求职者ID',
`position_id` int NOT NULL COMMENT '职位ID',
`resume_id` int NOT NULL COMMENT '简历ID',
`status` int DEFAULT '0' COMMENT '状态 0待查看 1已查看 2面试邀请 3不合适',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
KEY `idx_user` (`user_id`),
KEY `idx_position` (`position_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='投递记录表';
7.7 收藏表
CREATE TABLE `favorite` (
`id` int NOT NULL AUTO_INCREMENT,
`user_id` int NOT NULL COMMENT '用户ID',
`position_id` int NOT NULL COMMENT '职位ID',
`create_time` datetime DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
UNIQUE KEY `uk_user_position` (`user_id`, `position_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='收藏表';
八、核心代码实现
8.1 用户注册(区分身份)
@RestController
@RequestMapping("/user")
public class UserController {
@PostMapping("/register")
public Result register(@RequestBody RegisterDTO dto) {
// 1. 校验验证码
String emailCode = (String) redisTemplate.opsForValue()
.get("email:register:" + dto.getEmail());
if (emailCode == null) {
return Result.error("验证码已过期,请重新获取");
}
if (!emailCode.equals(dto.getEmailCode())) {
return Result.error("邮箱验证码错误");
}
// 2. 校验用户名是否已存在
User existUser = userService.getOne(new LambdaQueryWrapper<User>()
.eq(User::getUsername, dto.getUsername()));
if (existUser != null) {
return Result.error("用户名已存在");
}
// 3. 创建用户
User user = new User();
user.setUsername(dto.getUsername());
user.setPassword(SecureUtil.md5(dto.getPassword()));
user.setEmail(dto.getEmail());
user.setNickname(dto.getNickname());
user.setRole(dto.getIdentity());
user.setStatus(1);
userService.save(user);
// 4. 如果是企业用户,创建企业信息记录
if ("enterprise".equals(dto.getIdentity())) {
Enterprise enterprise = new Enterprise();
enterprise.setUserId(user.getId());
enterprise.setName(dto.getEnterpriseName());
enterprise.setStatus(0);
enterpriseService.save(enterprise);
}
return Result.success("注册成功");
}
}
8.2 职位多条件搜索
@Service
public class PositionServiceImpl implements PositionService {
@Override
public PageResult<PositionVO> searchPositions(PositionQuery query) {
Page<Position> page = new Page<>(query.getPageNum(), query.getPageSize());
LambdaQueryWrapper<Position> wrapper = new LambdaQueryWrapper<>();
if (StringUtils.isNotBlank(query.getKeyword())) {
wrapper.like(Position::getTitle, query.getKeyword());
}
if (StringUtils.isNotBlank(query.getEnterpriseName())) {
List<Integer> enterpriseIds = enterpriseMapper.selectList(
new LambdaQueryWrapper<Enterprise>()
.like(Enterprise::getName, query.getEnterpriseName())
).stream().map(Enterprise::getId).collect(Collectors.toList());
if (enterpriseIds.isEmpty()) {
return PageResult.empty();
}
wrapper.in(Position::getEnterpriseId, enterpriseIds);
}
if (query.getSalaryMin() != null) {
wrapper.ge(Position::getSalaryMax, query.getSalaryMin());
}
if (query.getSalaryMax() != null) {
wrapper.le(Position::getSalaryMin, query.getSalaryMax());
}
if (StringUtils.isNotBlank(query.getCity())) {
wrapper.eq(Position::getCity, query.getCity());
}
if (StringUtils.isNotBlank(query.getEducation())) {
wrapper.eq(Position::getEducation, query.getEducation());
}
wrapper.eq(Position::getStatus, 1);
if ("salary_desc".equals(query.getSort())) {
wrapper.orderByDesc(Position::getSalaryMax);
} else if ("latest".equals(query.getSort())) {
wrapper.orderByDesc(Position::getCreateTime);
} else {
wrapper.orderByDesc(Position::getApplyCount);
}
Page<Position> result = baseMapper.selectPage(page, wrapper);
List<PositionVO> voList = result.getRecords().stream()
.map(this::convertToVO).collect(Collectors.toList());
return PageResult.of(voList, result.getTotal(),
query.getPageNum(), query.getPageSize());
}
}
8.3 简历投递(事务处理)
@Service
public class ApplicationServiceImpl implements ApplicationService {
@Transactional(rollbackFor = Exception.class)
@Override
public void applyPosition(Integer userId, Integer positionId, Integer resumeId) {
// 1. 校验简历存在且属于当前用户
Resume resume = resumeService.getById(resumeId);
if (resume == null || !resume.getUserId().equals(userId)) {
throw new BusinessException("简历不存在");
}
// 2. 校验职位存在且在招聘中
Position position = positionService.getById(positionId);
if (position == null || position.getStatus() == 0) {
throw new BusinessException("职位不存在或已停止招聘");
}
// 3. 校验是否已投递
Long existCount = applicationMapper.selectCount(
new LambdaQueryWrapper<Application>()
.eq(Application::getUserId, userId)
.eq(Application::getPositionId, positionId));
if (existCount > 0) {
throw new BusinessException("您已投递过该职位,请勿重复投递");
}
// 4. 创建投递记录
Application application = new Application();
application.setUserId(userId);
application.setPositionId(positionId);
application.setResumeId(resumeId);
application.setStatus(0);
applicationMapper.insert(application);
// 5. 更新职位投递数
position.setApplyCount(position.getApplyCount() + 1);
positionService.updateById(position);
// 6. 记录用户行为(用于推荐算法)
UserBehavior behavior = new UserBehavior();
behavior.setUserId(userId);
behavior.setPositionId(positionId);
behavior.setType("apply");
behaviorMapper.insert(behavior);
// 7. 清除推荐缓存
redisTemplate.delete("recommend:user:" + userId);
}
}
8.4 行为埋点(浏览自动记录)
用户浏览职位详情时,系统自动记录浏览行为,作为推荐算法的数据源:
@RestController
@RequestMapping("/position")
public class PositionController {
@GetMapping("/detail/{id}")
public Result getDetail(@PathVariable Integer id,
HttpServletRequest request) {
Position position = positionService.getById(id);
if (position == null || position.getStatus() == 0) {
return Result.error("职位不存在或已下架");
}
// 浏览量+1
position.setViewCount(position.getViewCount() + 1);
positionService.updateById(position);
// 记录用户浏览行为(已登录用户)
String token = request.getHeader("token");
if (token != null && JwtUtil.verify(token)) {
Integer userId = JwtUtil.getUserId(token);
// 防止短时间内重复记录
String dedupKey = "behavior:view:" + userId + ":" + id;
if (!redisTemplate.hasKey(dedupKey)) {
UserBehavior behavior = new UserBehavior();
behavior.setUserId(userId);
behavior.setPositionId(id);
behavior.setType("view");
behaviorMapper.insert(behavior);
// 30分钟内不重复记录同一行为
redisTemplate.opsForValue().set(dedupKey, "1", 30, TimeUnit.MINUTES);
// 清除推荐缓存
redisTemplate.delete("recommend:user:" + userId);
}
}
return Result.success(convertToVO(position));
}
}
8.5 后台数据统计接口
@RestController
@RequestMapping("/admin/dashboard")
public class DashboardController {
@GetMapping("/stats")
public Result getStats() {
Map<String, Object> data = new HashMap<>();
data.put("positionCount", positionService.count());
data.put("applicationCount", applicationService.count());
data.put("userCount", userService.count());
data.put("todayApplicationCount", applicationService.getTodayCount());
// 最近7天投递趋势
data.put("applyTrend", applicationService.get7DayTrend());
// 热门职位 TOP 10
data.put("hotPositions", positionService.list(
new LambdaQueryWrapper<Position>()
.orderByDesc(Position::getApplyCount)
.last("limit 10")
));
// 各城市职位数分布
data.put("cityDistribution", positionService.getCityDistribution());
return Result.success(data);
}
}
九、推荐效果验证方案
9.1 推荐动态变化演示
- 注册一个新用户,首页显示的是热门职位(因为没有行为数据,走热门补全逻辑)
- 浏览 3-5 个 Java 开发相关的职位,刷新首页,推荐结果变为 Java 相关职位
- 再收藏 2 个产品经理的职位,刷新首页,推荐结果中出现产品岗
- 投递一个 Python 职位,刷新首页,推荐结果中 Python 职位权重上升
这个动态变化的效果一演示,老师立刻就理解了算法的实际作用。
9.2 算法评估指标
|
指标 |
说明 |
理想值 |
|
推荐覆盖率 |
被推荐职位占总职位的比例 |
≥ 60% |
|
推荐准确率 |
被推荐职位中用户实际交互的比例 |
≥ 30% |
|
缓存命中率 |
推荐结果从 Redis 直接获取的比例 |
≥ 80% |
|
推荐响应时间 |
单次推荐请求的耗时 |
≤ 200ms |
9.3 答辩常见问题及参考回答
Q1:为什么用余弦相似度而不是皮尔逊相关系数?
余弦相似度关注的是用户行为向量的方向一致性,而不是绝对数值大小,适合处理用户活跃度差异大的场景(有的用户浏览几十个职位,有的只浏览几个)。皮尔逊相关系数需要减去用户均值,在数据稀疏的招聘场景下效果不一定更好,而且计算复杂度更高。
Q2:冷启动问题怎么解决?
系统设计了三层冷启动策略:新用户(无行为数据)通过热门补全策略展示投递量最高的职位;新职位(无浏览数据)通过基于内容的推荐(匹配职位标签和用户简历技能)来曝光;当用户产生 3 次以上行为后,切换为协同过滤算法进行个性化推荐。
Q3:推荐结果缓存在 Redis 中,行为变化后如何更新?
用户每次产生新行为(浏览、收藏、投递)时,Service 层会主动删除该用户的推荐缓存 key。下次请求推荐接口时缓存未命中,重新计算推荐结果并写入缓存。这样保证了推荐结果的实时性,同时通过 30 分钟内的浏览行为去重机制避免了频繁重算。
十、部署说明
10.1 环境准备
|
软件 |
版本要求 |
说明 |
|
JDK |
1.8+ |
后端运行环境 |
|
Node.js |
16+ |
前端运行环境 |
|
MySQL |
8.0+ |
数据库 |
|
Redis |
6.0+ |
缓存 |
|
Maven |
3.6+ |
后端依赖管理 |
10.2 后端部署
- 创建数据库:CREATE DATABASE job_recommend DEFAULT CHARACTER SET utf8mb4;
- 执行 SQL 脚本:导入 job_recommend.sql,创建全部表和初始数据
- 修改配置文件 application.yml 中的数据库和 Redis 连接信息
- 启动 Redis 服务
- 运行 JobRecommendApplication.java 启动后端
10.3 前端部署
- 进入前端项目目录:cd job-recommend-frontend
- 安装依赖:npm install
- 启动开发服务器:npm run dev
- 访问 http://localhost:5173 打开求职者端
- 后台管理地址:http://localhost:5173/admin
10.4 默认账号
|
角色 |
账号 |
密码 |
|
管理员 |
admin |
admin123 |
|
求职者 |
112233 |
123456 |
|
企业用户 |
enterprise |
123456 |


 扫一扫


 7836

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


