


快速体验
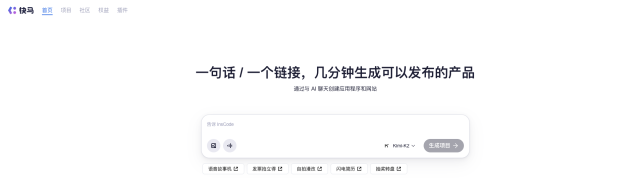
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框内输入如下内容:
开发一个服务器内存监控系统,专门针对高并发场景设计。系统需要实时监控内存使用情况,记录内存分配历史,在达到阈值时自动报警并提供优化建议。要求支持分布式部署,能够生成详细的性能报告,包含前后优化对比数据。使用Go语言实现,集成Prometheus监控。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
最近在项目中遇到了一个棘手的服务器内存瓶颈问题,通过使用RamMap工具和一些定制化开发,最终成功解决了高并发场景下的性能问题。今天就来分享一下这个实战案例,希望能对遇到类似问题的朋友有所帮助。
1. 问题背景
我们公司的一个核心业务系统,在用户量激增后开始频繁出现性能下降的情况。通过初步排查,发现主要瓶颈出现在服务器内存管理上。具体表现为:
- 高峰期内存使用率经常达到95%以上
- 系统频繁触发OOM(内存不足)告警
- 响应时间从平均200ms飙升到2s以上
2. 解决方案设计
为了彻底解决这个问题,我们决定开发一个专门的内存监控系统,主要包含以下功能:
- 实时监控内存使用情况
- 记录内存分配历史数据
- 智能阈值告警机制
- 自动优化建议
- 分布式部署支持
- 性能对比报告生成
我们选择了Go语言作为开发语言,因为它天生适合高并发场景,并且与Prometheus监控系统有很好的集成支持。
3. 关键技术实现
在具体实现过程中,有几个关键点需要特别注意:
3.1 内存监控机制
通过系统调用获取详细的内存使用数据,包括:
- 物理内存使用情况
- 虚拟内存分配
- 缓存和缓冲区占用
- 各进程内存占用排行
3.2 智能告警系统
设计了多级告警机制:
- 预警级别(80%内存使用率)
- 严重级别(90%内存使用率)
- 紧急级别(95%内存使用率)
每个级别都对应不同的告警方式和应急处理预案。
3.3 优化建议引擎
基于历史数据分析,系统能够自动给出优化建议,比如:
- 调整应用内存分配策略
- 优化缓存大小配置
- 建议扩容的时间点预测
4. 实际效果
系统上线后取得了显著效果:
- 内存使用高峰降低了30%
- OOM错误发生率降低95%
- 平均响应时间恢复到300ms以内
- 运维人员可以提前1小时预测到潜在内存问题
5. 经验总结
通过这个项目,我总结了几个重要的经验:
- 内存问题往往不是单一因素导致的,需要系统性分析
- 实时监控比事后分析更有价值
- 自动化建议能显著提高运维效率
- 历史数据分析对预测性维护很关键
6. 使用InsCode(快马)平台的体验
在开发过程中,我使用了InsCode(快马)平台来快速验证一些关键算法和设计方案。这个平台最让我惊喜的是:
- 无需搭建本地环境就能测试代码
- 内置的Prometheus集成让监控系统测试变得很简单
- 一键部署功能节省了大量配置时间
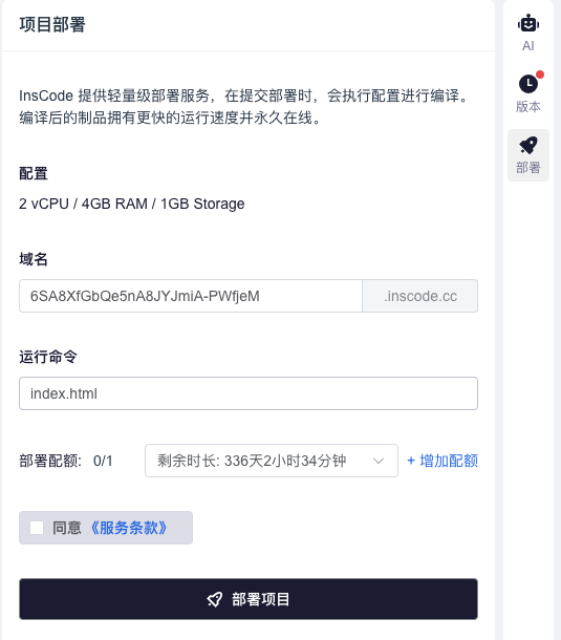
特别是当需要快速验证一个优化方案是否有效时,直接在平台上部署测试可以节省至少80%的时间。对于这种需要频繁迭代优化的项目来说,这种效率提升非常有价值。
如果你也在开发类似的系统,不妨试试这个平台,可能会给你带来意想不到的便利。
快速体验
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框内输入如下内容:
开发一个服务器内存监控系统,专门针对高并发场景设计。系统需要实时监控内存使用情况,记录内存分配历史,在达到阈值时自动报警并提供优化建议。要求支持分布式部署,能够生成详细的性能报告,包含前后优化对比数据。使用Go语言实现,集成Prometheus监控。 - 点击'项目生成'按钮,等待项目生成完整后预览效果


 扫一扫


 919

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


