扩散模型 Diffusion Models - 原理篇

扩散模型的一些公式证明 扩散模型的前向扩散过程: q(x1:T∣x0)=∏t=1Tq(xt∣xt−1),q(xt∣xt−1):=N(1−βt)xt−1,βtI)(1)q(x_{1:T}|x_0) = \prod_{t=1}^Tq(x_t|x_{t-1}),q(x_t|x_{t-1}):=\mathcal{N}(\sqrt{1-\beta_t})x_{t-1},\beta_tI)\quad(1)q(x1:T​∣x0​)=t=1∏T​q(xt​∣xt−1​),q(xt​∣xt−1​):=N(1−βt​​)xt−1​,βt​I)(1) 阅读详情

扩散模型 Diffusion Models - 原理篇

参考博客及视频链接:

What are Diffusion Models?

Diffusion Model扩散模型理论与完整PyTorch代码详细解读

论文:

2015 年 Deep Unsupervised Learning using Nonequilibrium Thermodynamics

2020 年 Generative Modeling by Estimating Gradients of the Data Distribution

2020 年 Denoising Diffusion Probabilistic Models

数学公式基础

  1. 联合条件概率
    P ( A , B , C ) = P ( C ∣ A , B )   P ( A , B ) = P ( C ∣ A , B )   P ( B ∣ A )   P ( A ) P ( B , C ∣ A ) = P ( A , B , C )   /   P ( A ) = P ( C ∣ A , B )   P ( B ∣ A ) P(A,B,C)= P(C|A,B)~P(A,B)=P(C|A,B)~P(B|A)~P(A) \\ P(B,C|A)= P(A,B,C)~/~P(A)= P(C|A,B)~P(B|A) P(A,B,C)=P(C∣A,B) P(A,B)=P(C∣A,B) P(B∣A) P(A)P(B,C∣A)=P(A,B,C) / P(A)=P(C∣A,B) P(B∣A)

  2. 基于马尔可夫假说的联合条件概率,如果满足 A->B->C,则
    P ( A , B , C ) = P ( C ∣ A , B )   P ( A , B ) = P ( C ∣ B )   P ( B ∣ A )   P ( A ) P ( B , C ∣ A ) = P ( A , B , C )   /   P ( A ) = P ( C ∣ B )   P ( B ∣ A ) P(A,B,C)= P(C|A,B)~P(A,B)=P(C|B)~P(B|A)~P(A) \\ P(B,C|A)= P(A,B,C)~/~P(A)= P(C|B)~P(B|A) P(A,B,C)=P(C∣A,B) P(A,B)=P(C∣B) P(B∣A) P(A)P(B,C∣A)=P(A,B,C) / P(A)=P(C∣B) P(B∣A)

  3. 高斯分布的 KL 散度公式

    对于两个单一变量的高斯分布 p 和 q 而言:
    K L ( p , q ) = l o g σ 2 σ 1 + σ 1 2 + ( μ 1 − μ 2 ) 2 2 σ 2 2 − 1 2 KL(p,q)=log\frac{\sigma_2}{\sigma_1}+\frac{\sigma_1^2+(\mu_1-\mu_2)^2}{2\sigma_2^2}-\frac{1}{2} KL(p,q)=logσ1​σ2​​+2σ22​σ12​+(μ1​−μ2​)2​−21​

  4. 参数重采样

    为了网络可训练,从高斯分布 N ( μ , σ ) \mathcal{N}(\mu,\sigma) N(μ,σ) 中采样,等价于先从标准分布 N ( 0 , I ) \mathcal{N}(0,I) N(0,I) 采样出 z z z ,再得到 σ ∗ z + μ \sigma*z+\mu σ∗z+μ 。

原理

扩散模型的灵感来自于非平衡热力学。定义了一个扩散步骤的马尔可夫链(当前状态只与上一时刻的状态有关),慢慢地向真实数据中添加随机噪声(前向过程),然后学习反向扩散过程(逆扩散过程),从噪声中构建所需的数据样本。
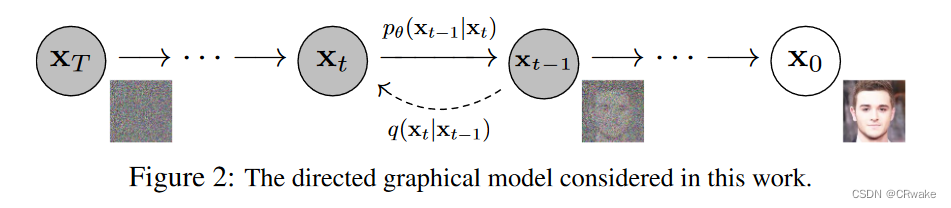
在这里插入图片描述

前向过程

前向过程是不含可学习参数的,随着 t t t 不断增大,最终分布变成各向独立的高斯分布。定义真实数据分布 x 0 ∼ q ( x ) x_0 \sim q(x) x0​∼q(x) ,我们在前向过程中逐步加入一个小的高斯噪声,一共加入 T T T 步,从而产生了一系列加噪的样本 x 1 , x 2 , … , x T x_1,x_2,\dots,x_T x1​,x2​,…,xT​ ,加入噪声的均值和方差由 β t \beta_t βt​ 决定,其在 ( 0 , 1 ) (0,1) (0,1) 之间,且 β 1 < β 2 < ⋯ < β T \beta_1 < \beta_2 < \dots < \beta_T β1​<β2​<⋯<βT​ ,这意味着所加的噪声是越来越大的。
q ( x t ∣ x t − 1 ) = N ( x t ; 1 − β t   x t − 1 , β t I ) q(x_t|x_{t-1}) = \mathcal{N}(x_t;\sqrt{1-\beta_t}~x_{t-1},\beta_tI) q(xt​∣xt−1​)=N(xt​;1−βt​ ​ xt−1​,βt​I)
由于定义为马尔可夫链,所以给定 x 0 x_0 x0​ 的 x 1 : T x_{1:T} x1:T​ 的联合概率分布为
q ( x 1 : T ∣ x 0 ) = Π t = 1 T   q ( x t ∣ x t − 1 ) q(x_{1:T}|x_0)=\Pi_{t=1}^{T}~q(x_t|x_{t-1}) q(x1:T​∣x0​)=Πt=1T​ q(xt​∣xt−1​)
上述式子计算 q ( x t ∣ x 0 ) q(x_t|x_0) q(xt​∣x0​) 需要不断迭代,我们希望给定 x 0 , β t x_0,\beta_t x0​,βt​ 就可以计算出来。给定 α t = 1 − β t   ,   α ˉ t = Π i = 1 t α i \alpha_t = 1-\beta_t~,~\bar{\alpha}_t=\Pi_{i=1}^{t} \alpha_i αt​=1−βt​ , αˉt​=Πi=1t​αi​
x t = α t   x t − 1 + 1 − α t   z t − 1               # 参数重整化和替换 = α t   ( α t − 1 x t − 2 + 1 − α t − 1 z t − 2 ) + 1 − α t   z t − 1 = α t α t − 1   x t − 2 + α t − α t α t − 1 z t − 2 + 1 − α t   z t − 1 # 由于两个正态分布 X ∼ N ( μ 1 , σ 1 ) , Y ∼ N ( μ 2 , σ 2 ) 叠加后的分布 a X + b Y 的均值是 a μ 1 + b μ 2 , 方差是 a 2 σ 1 2 + b 2 σ 2 2 # 所以 α t − α t α t − 1 z t − 2 + 1 − α t   z t − 1 均值为 0 ,方差为 1 − α t α t − 1 再利用参数重整化 = α t α t − 1   x t − 2 + 1 − α t α t − 1 z ˉ t − 2               # 此 z ˉ t − 2 不同于 z t − 2 = … = α ˉ t x 0 + 1 − α ˉ t z               # 参数逆重整化 q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I )               # 此时无需迭代即可算出任意时刻 q ( x t ∣ x 0 ) \begin{align} x_t &= \sqrt{\alpha_t}~x_{t-1}+\sqrt{1-\alpha_t}~z_{t-1} ~~~~~~~~~~~~~\#参数重整化和替换\\ &= \sqrt{\alpha_t}~(\sqrt{\alpha_{t-1}}x_{t-2}+\sqrt{1-\alpha_{t-1}}z_{t-2})+\sqrt{1-\alpha_t}~z_{t-1} \\ &= \sqrt{\alpha_t\alpha_{t-1}}~x_{t-2}+\sqrt{\alpha_t-\alpha_t\alpha_{t-1}}z_{t-2}+\sqrt{1-\alpha_t}~z_{t-1} \\ \\ & \#由于两个正态分布X\sim\mathcal{N}(\mu_1,\sigma_1),Y\sim\mathcal{N}(\mu_2,\sigma_2)叠加后的分布aX+bY的均值是a\mu_1+b\mu_2,方差是a^2\sigma_1^2+b^2\sigma_2^2 \\ & \#所以\sqrt{\alpha_t-\alpha_t\alpha_{t-1}}z_{t-2}+\sqrt{1-\alpha_t}~z_{t-1} 均值为 0,方差为 1-\alpha_t\alpha_{t-1}再利用参数重整化\\ \\ &= \sqrt{\alpha_t\alpha_{t-1}}~x_{t-2}+\sqrt{1-\alpha_t\alpha_{t-1}}\bar{z}_{t-2}~~~~~~~~~~~~~\#此\bar{z}_{t-2}不同于z_{t-2} \\ &= \dots \\ &= \sqrt{\bar{\alpha}_t} x_0 +\sqrt{1-\bar{\alpha}_t}z ~~~~~~~~~~~~~\#参数逆重整化\\ \\ & q(x_t|x_0) = \mathcal{N}(x_t;\sqrt{\bar{\alpha}_t} x_0,(1-\bar{\alpha}_t)I)~~~~~~~~~~~~~\#此时无需迭代即可算出任意时刻q(x_t|x_0) \end{align} xt​​=αt​ ​ xt−1​+1−αt​ ​ zt−1​             #参数重整化和替换=αt​ ​ (αt−1​ ​xt−2​+1−αt−1​ ​zt−2​)+1−αt​ ​ zt−1​=αt​αt−1​ ​ xt−2​+αt​−αt​αt−1​ ​zt−2​+1−αt​ ​ zt−1​#由于两个正态分布X∼N(μ1​,σ1​),Y∼N(μ2​,σ2​)叠加后的分布aX+bY的均值是aμ1​+bμ2​,方差是a2σ12​+b2σ22​#所以αt​−αt​αt−1​ ​zt−2​+1−αt​ ​ zt−1​均值为0,方差为1−αt​αt−1​再利用参数重整化=αt​αt−1​ ​ xt−2​+1−αt​αt−1​ ​zˉt−2​             #此zˉt−2​不同于zt−2​=…=αˉt​ ​x0​+1−αˉt​ ​z             #参数逆重整化q(xt​∣x0​)=N(xt​;αˉt​ ​x0​,(1−αˉt​)I)             #此时无需迭代即可算出任意时刻q(xt​∣x0​)​​

逆扩散过程

逆过程是从高斯噪声中恢复原始数据,由于正向过程中我们每次加的噪声很小,所以我们假设 p ( x t − 1 ∣ x t ) p(x_{t-1}|x_t) p(xt−1​∣xt​) 也是一个高斯分布,我们可以使用神经网络进行拟合。逆过程也是一个马尔科夫链过程。
p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , Σ θ ( x t , t ) ) p_\theta(x_{t-1}|x_t) = \mathcal{N}(x_{t-1};\mu_\theta(x_t,t),\Sigma_\theta(x_t,t)) pθ​(xt−1​∣xt​)=N(xt−1​;μθ​(xt​,t),Σθ​(xt​,t))

p θ ( x 0 : T ) = p ( x T ) Π t = 1 T p θ ( x t − 1 ∣ x t ) p_{\theta}(x_{0:T})=p(x_T)\Pi_{t=1}^{T}p_\theta(x_{t-1}|x_t) pθ​(x0:T​)=p(xT​)Πt=1T​

扩散模型diffusion model的原理浅谈 扩散模型的原理主要基于两个核心过程:前向扩散过程(Forward Diffusion Process)和反向扩散过程(Reverse Diffusion Process)。这两个过程相互对应,前向过程用于逐渐给数据添加噪声,而反向过程则用于从噪声中恢复原始数据。 阅读详情

相关推荐

DDPM扩散模型公式推理----扩散和逆扩散过程

本文章旨在梳理DDPM这篇论文中的各个公式含义及推导,很多内容从其他博客处摘录,在文后列举。打个比方,就像是给你一块木头,让你把它雕刻成一个佛像,需要栩栩如生。Diffusion model在推理阶段就是在执行逆扩散过程,也就是雕刻佛像的过程。用数学语言进行描述,生成式模型本质上是从一组概率分布中得到另一组概率分布。如下图所示,左边是一个训练数据集,里面所有的数据都是从某个数据pdata p_{\text {data }}pdata ​中独立同分布取出的随机样本。右边就是其生成式模型(概率分布),在这种概率

weixin_45453121的博客 5845

扩散模型(Diffusion Models)

扩散模型是一种基于随机过程的生成模型,灵感来源于物理学中的扩散过程,即有序结构逐渐转化为无序状态。在机器学习中,扩散模型用于生成高质量的数据(如图像、音频等)。其核心思想是通过一个可逆的随机过程,将数据从有序状态(如清晰图像)转化为无序状态(噪声),然后逆向该过程生成新数据。

weixin_42136827的博客 2508

为什么Diffusion Models扩散模型可以称为Score-based Models?

前言: Diffusion Model扩散模型与深度学习(附Python示例)_沉迷单车的追风少年-CSDN博客、击败GANs的新生成式模型:score-based model(diffusion model)原理、网络结构、应用、代码、实验、展望_沉迷单车的追风少年-CSDN博客 前面这两篇文章中详细讨论了diffusion models和score-based models原理、方法和代码实现。新的生成式模型从出生开始就被寄予打败GANs、VAE等前辈的重望。虽然这两种模型在本质上来讲是一样的,但.

沉迷单车的追风少年 9277

【AI理论学习】深入理解扩散模型:Diffusion Models(DDPM)(理论篇)

继OpenAI在2021提出的文本转图像模型之后,越来越多的大公司卷入这个方向,例如谷歌相继推出了和。一些主流的文本转图像模型,例如,和采用了扩散模型()作为图像生成模型,这也引发了对扩散模型的研究热潮。与GAN相比,扩散模型训练更稳定,而且能够生成更多样的样本,OpenAI的论文也证明了

小哲的博客 5199

Diffusion models代码实战:从零搭建自己的扩散模型

这个系列曾经写过三篇文章专门讲代码,分别从数据集、超参数、loss设计、参数计算、Unet结构、正向过程、逆向过程等部分详细介绍了如何搭建DDPM。Diffusion models领域发展神速,最近半年代表作品有OpenAI的GLIDE、DALL-E 2,Google Brain的ImageGen,海森堡大学的Latent Diffusion。这篇博客针对入门新手讲解一下如何利用已有的资源快速搭建自己的Diffusion models。.........

沉迷单车的追风少年 1万+

扩散模型+CV与NLP科研笔记专栏文章汇总:【Diffusion Models】

CLIP是一个多模态的大模型,用了4亿个(图像、文本)对进行对比学习,学习之后可以直接进行zero-shot推理,并且不需要像ImageNet那样标注1000个类,而是可以人为给出文本提示,进行图片和文本之间的相似度计算,而且迁移效果很好。那么基于此,提出了Classifier-Free Diffusion Guidance,后续非常多的工作都是基于其来进行的,例如DALL·E 2、Imagen等吸引人眼球的模型基本上都是以它为基础做的。直接用训练好的非条件的扩散模型,无需重复训练。

zik的博客 5688

Apk脱壳圣战之---脱掉“梆梆加固”的保护壳

一、前言 现如今Android用户的安全意识不是很强,又有一些恶意开发者利用应用的名字吸引眼球,包装一个恶意锁机收费的应用,在用户被骗的安装应用之后,立马手机锁机,需要付费方可解锁。这样的恶意软件是非常让人痛恨的。所以本文就用一个案例来分析如何破解这类应用,获取解锁密码,让被骗的用户可以找回爽快! 二、分析软件锁机原理 本文用的是一款叫做:安卓性能激活.apk,关于样本apk文件后面会...

尼古拉斯.赵四的博客 5048

E2000 RGMII0通讯异常问题总结

飞腾E2000 RGMII接YT8521,RGMII0路不通问题。

乌拉大喵喵 1624

PCIe网卡驱动实现分析(三)--- cache一致性

在现代处理器系统中,CPU的主频远高于主存读写速度,主存的读写速度成为程序执行效率的瓶颈;为了解决这个问题,在CPU和主存之间引入了Cache存储器,基于程序执行的局部性原理,在程序执行时,将正在使用的数据从主存拷贝一份到Cache,这样CPU就可以直接从Cache读写数据以改善主存读写速度慢的问题;

a935854743的博客 1774

SRA数据库

简介 序列读取存档(sequence Read Archive,SRA)数据是可通过多个云提供商和NCBI服务器获得的,它是最大的可公开获得的高通量测序数据存储库。 SRA接受来自生活各个部门以及宏基因组学和环境调查的数据。 SRA存储原始测序数据和比对信息,以提高可重复性并通过数据分析促进新发现。 NCBI网站储存二代测序原始数据的数据库 SRA官网 从Entrez搜索结果中下载SRA序列 例如查找SRA Entrez中BALB / c小鼠淋巴结组织的RNA-Seq记录 获取搜索结果 SRA se

qq_44520665的博客 5894

AI编程工具深度对比:Cursor、Copilot、Trae与Claude Code,2025年开发者该如何选择?

2025年AI编程工具市场已形成四大主力阵营:Cursor(AI原生IDE)、GitHub Copilot(行业标准)、Trae(中国免费方案)和Claude Code(终端交互)。核心差异体现在技术能力(代码生成准确率85%-95%)、智能体协作程度和上下文处理能力(8K-200K tokens)。用户体验方面,Trae对中文支持最佳且免费,Copilot企业集成强,Cursor平衡易用与功能,Claude Code适合高阶开发者。实际测试显示,不同工具在原型开发、算法实现等场景各有优势

fudaihb的博客 6490

Codex 100个真实案例 - 全系列总结与Codex最佳实践全解析

历经100个案例的淬炼,我们终于来到了终点!本篇是整个系列的压轴之作——全面回顾100个案例的分类统计、提炼Codex使用的核心技巧和最佳实践、总结Prompt工程的精华要点、剖析常见错误及解决方案、展望AI编程的未来趋势,并为不同水平的读者规划学习路径。这不仅是一篇总结,更是一本Codex实战手册!

yueyeguzhuo的专栏 129

定位精度再突破!Inner-MPDIoU让YOLOv11边界框回归更精准

Inner-MPDIoU 凭借辅助边框与最小点距离的双机制创新,彻底解决了传统 IoU 损失在边界框回归上的精度瓶颈。本教程从原理到代码实现,再到工业场景适配,完整呈现了其在 YOLOv11 中的集成路径。只需简单修改两处核心脚本,你的目标检测模型就能在边界框定位精度上实现跨越式提升——无论是学术研究中的指标突破,还是工业场景下的精细检测需求,Inner-MPDIoU 都能成为你攻克边界框回归难题的利器。现在就动手尝试,让你的检测模型在定位精度上再上一个台阶吧。

FJN110的博客 154

双像素传感器的AI计算摄影实战:单目深度估计与图像去模糊的融合创新

本文介绍了双像素传感器技术在计算机视觉中的应用,包括深度估计、图像去模糊和图像重建等任务。双像素传感器通过两个子单元捕捉视差信息,使摄像头能够分析场景的三维结构和运动轨迹。文章以图像去模糊为例,详细展示了从数据准备到模型训练的完整流程,包括构建自定义数据集、设计双像素特征提取模块、训练去模糊模型及推理测试。通过模拟双像素的"双视角"信息融合,该AI算法能有效恢复模糊图像的清晰细节。

know_F0727的博客 253

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

上一篇: opencv(8)--摄像头探测人脸(haar)、人脸识别
CRwake
博客等级 码龄8年 7粉丝 20原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
