RAG知识库三大痛点深度剖析:分块粗糙、检索不准、缺乏大局观,附解决方案+收藏必学指南

RAG 常见分块策略全解析:一文了解7种分块方法【附代码】 然而,生成模型(如大型语言模型,LLM)的上下文窗口是有限的,这意味着它能够处理的输入文本长度是有限制的。如果检索到的文本块过大,超出了这个限制,就无法完整地输入到生成模型中,从而可能导致生成的响应不准确或不完整。通过将文档分块,可以确保每个块的大小都在生成模型的上下文窗口范围内,从而使模型能够有效地处理和生成高质量的响应。例如,在一个包含多个主题的长文档中,分块可以将不同主题的内容分割开来,使得检索系统能够针对特定主题进行更精确的检索。在检索增强生成(RAG)系统中,分块策略是决定系统性能的基石。 阅读详情

本文剖析RAG知识库三大痛点:分块方式粗糙导致上下文断裂,检索不精准匹配相关度低,缺乏大局观难以处理结构化数据。针对这些问题,提出使用重排序模型提升检索精度,建议对统计性问题采用关系型数据库替代方案,并通过具体案例展示优化效果,为构建高效知识库提供实用指导。
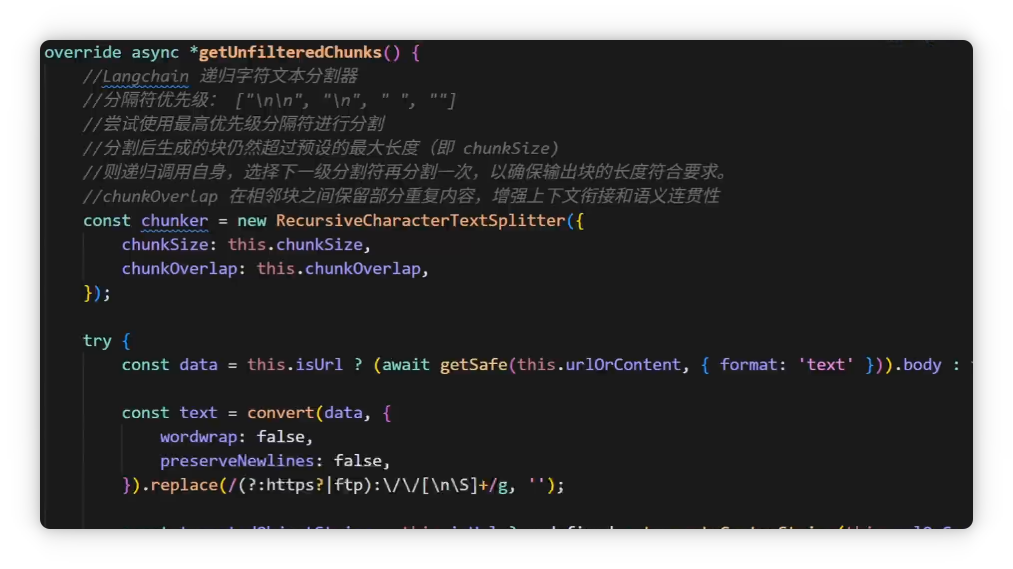
切片简单粗暴

这种分块方式较为简单,基本按段落分块,若段落过长则按固定字数切分,因此常常会把句子截断。

回到 Cherry Studio,来看刚刚检索到的“刘备”相关信息:
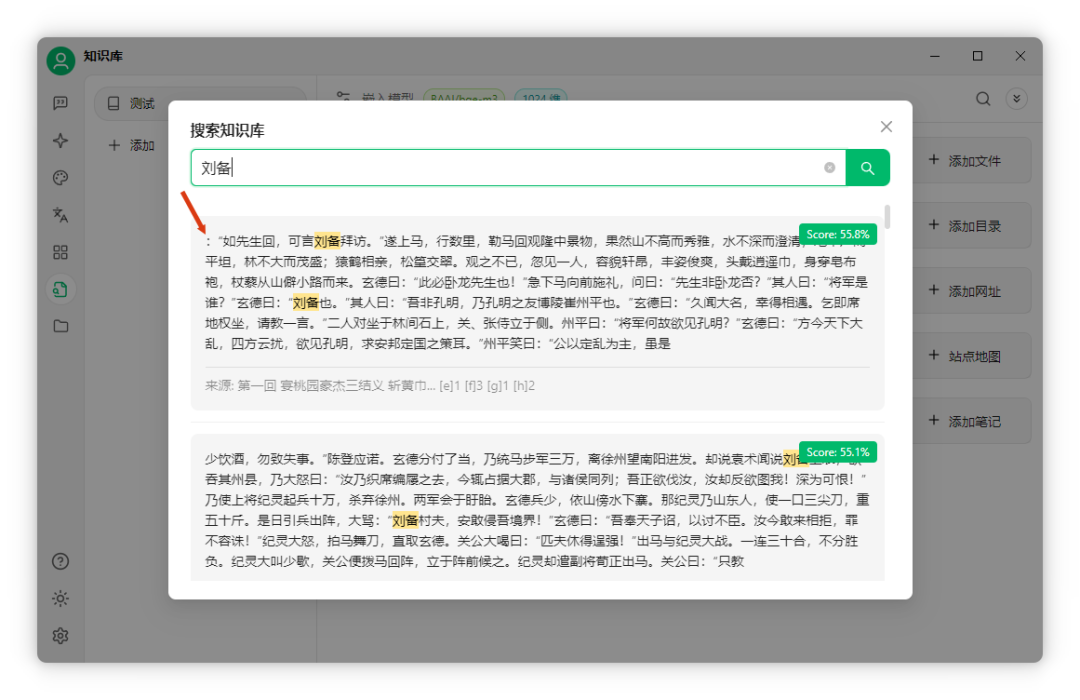
可以看到“:”前明显有内容被截断,结尾“虽是”也没说完。由于分块长度上限为 300 字,前后句都被强行截断。

这暴露了 RAG 知识库的一个缺陷:分块方式粗糙,AI 拿到被拆碎的段落后难以理解上下文,导致回答不够精准。

虽然现在也有基于语义分析等更复杂的分块方法,但大多还不成熟,效果甚至不如简单分割器。

检索不精准

再来看传统 RAG 的第二个问题:检索不精准。比如我搜索“曹操兵器”,想找关于曹操倚天剑的信息。

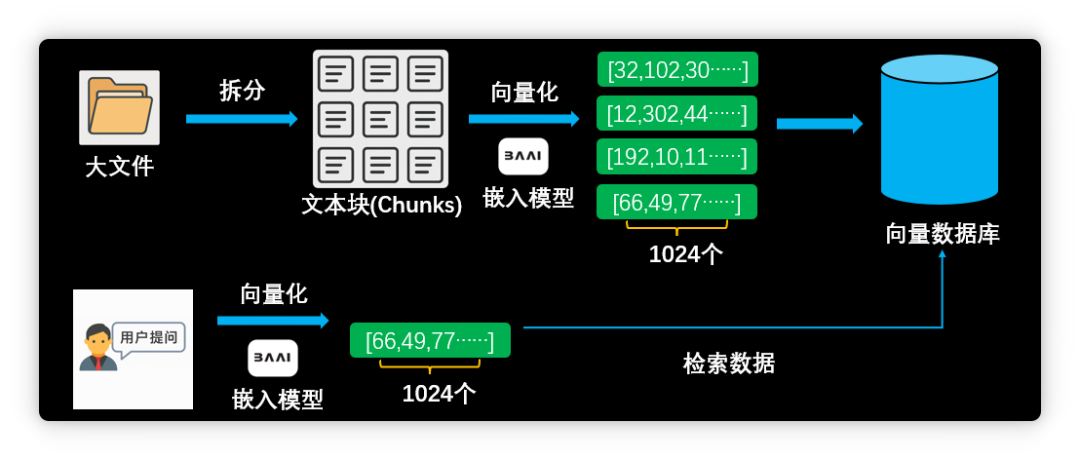
检索时,系统将用户问题与向量数据库匹配,仅基于数字相似度,无法真正理解文本含义。筛选出的片段可能相关,也可能无关,难以做到精准匹配。
比如匹配度最高的结果,内容却与和曹操的武器无关。
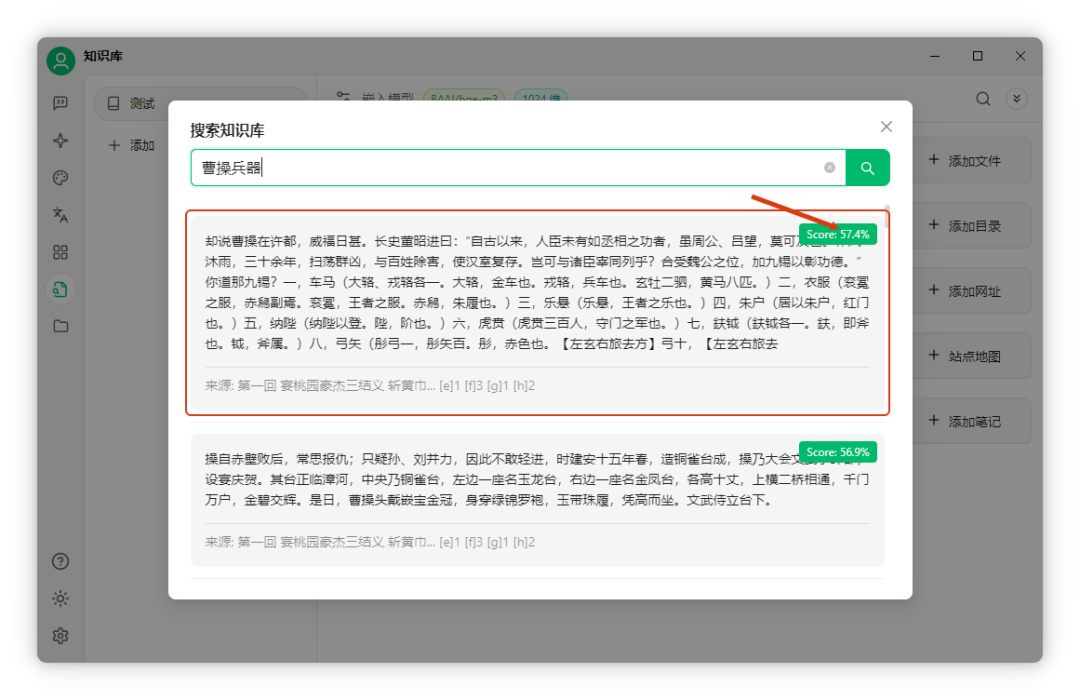
匹配出来的内容都不理想,这正是 RAG 系统的痛点之一:向量检索不够精准,前几条结果往往不是我们想要的信息。

目前较好的改进方案是引入重排序模型。先用向量数据库初步检索,再用专用重排序模型做更深入的语义分析,根据问题相关性重新排序。
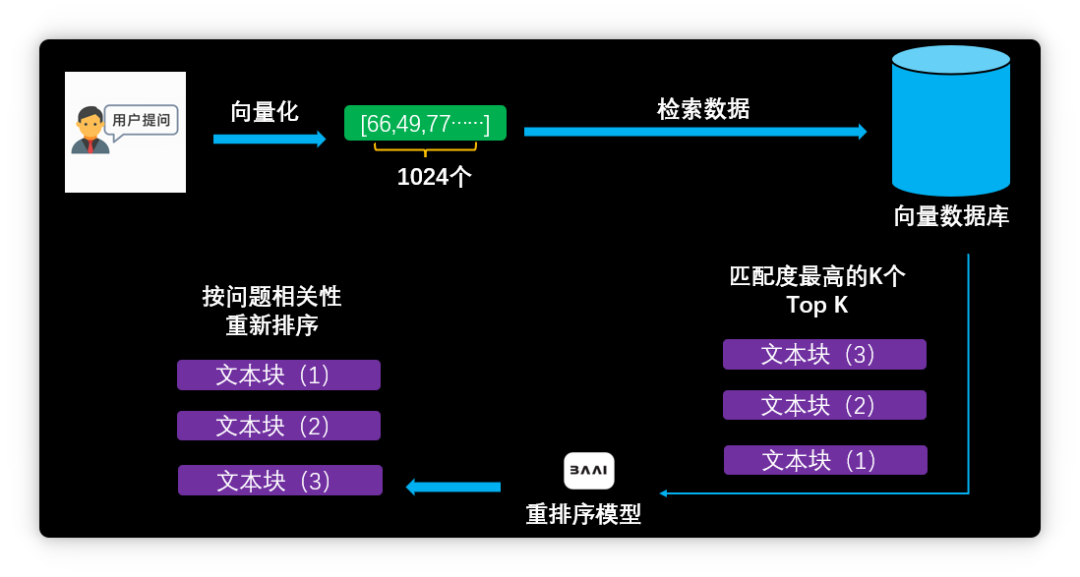
这样可以把最相关的数据排在前面,再交给大模型处理,实现“先粗后细”的两步检索,提升检索精度。
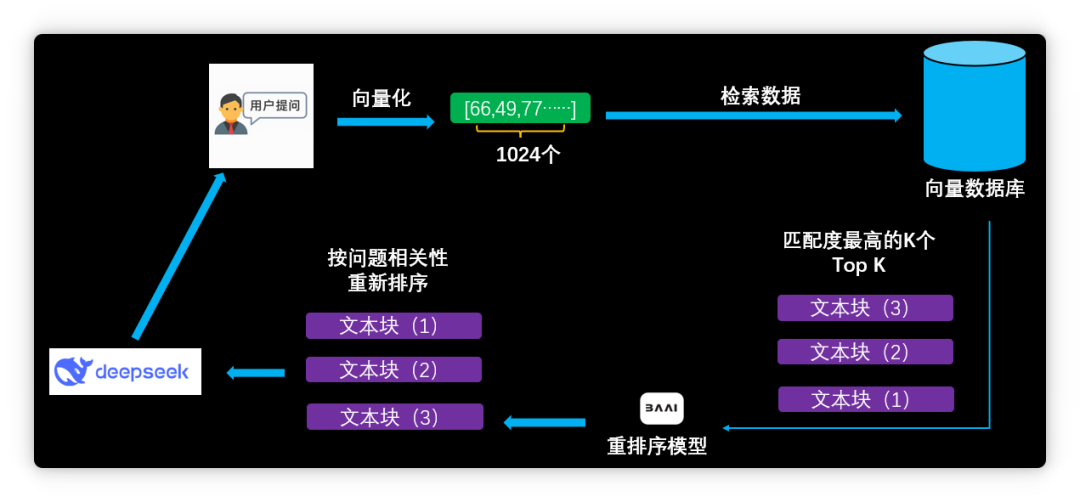
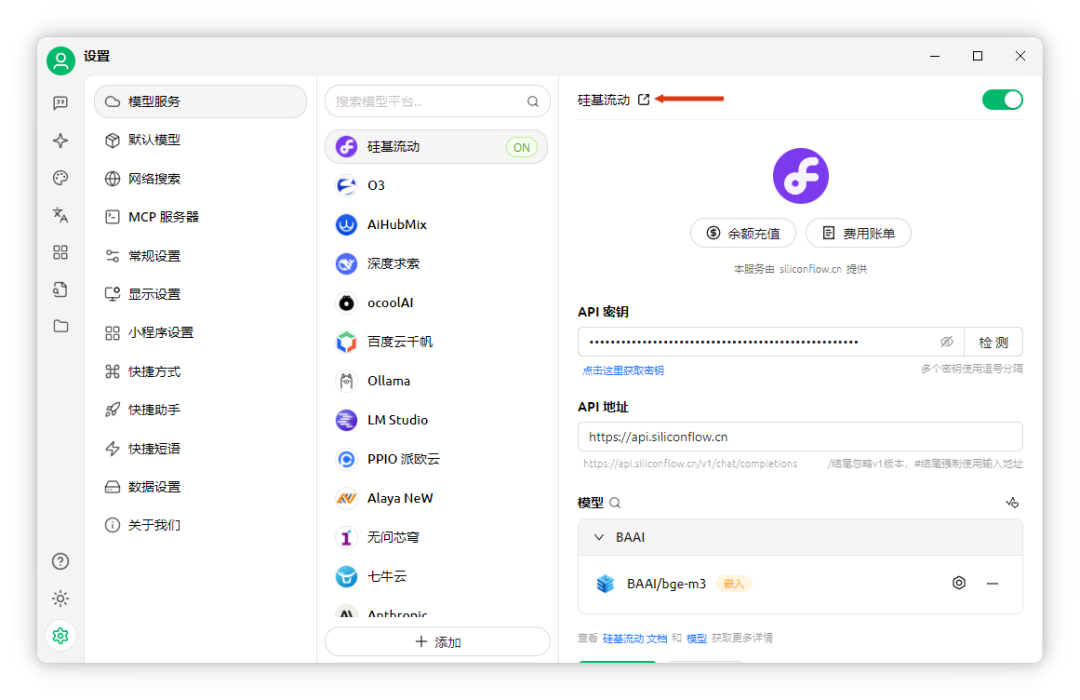
以“曹操兵器”为例,之前找不到倚天剑的信息。现在我为知识库添加了重排序模型,看看效果是否提升。点击设置,进入模型服务,找到硅基流动,添加重排序模型。
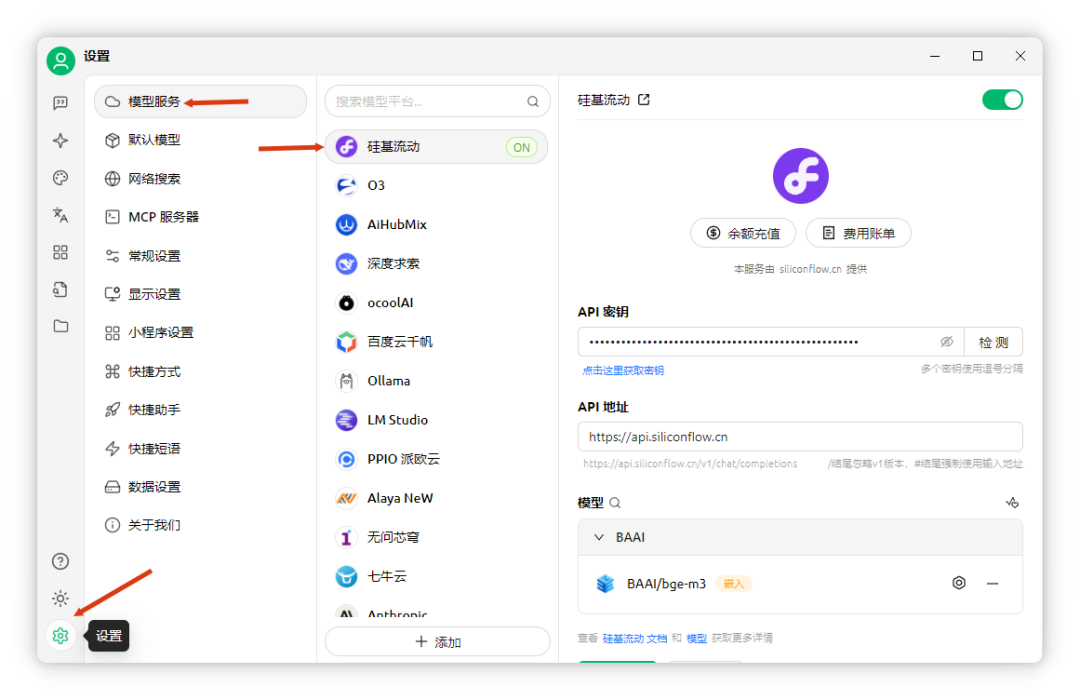
点击硅基流动链接。
在模型广场筛选器中选择“重排序”类型。
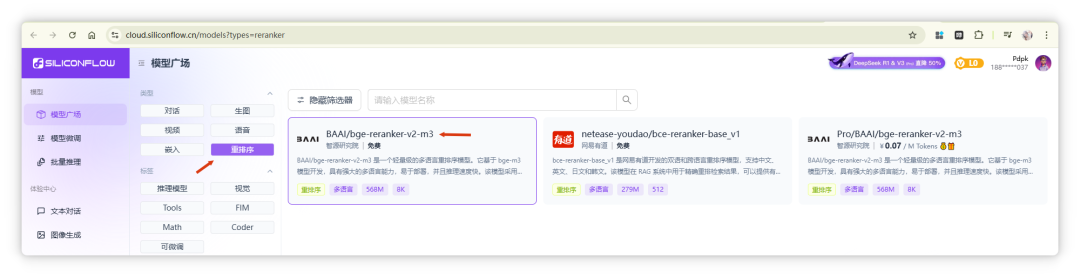
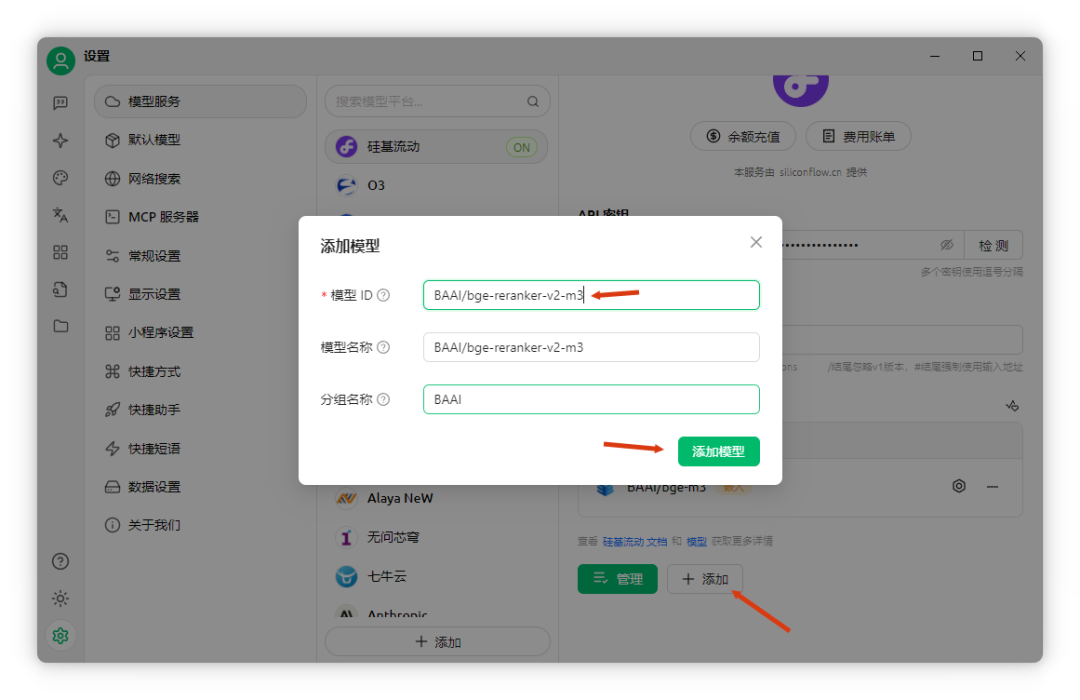
复制免费的重排序模型名称,回到 Cherry Studio,进入模型模块,点击添加按钮,将模型添加进去。
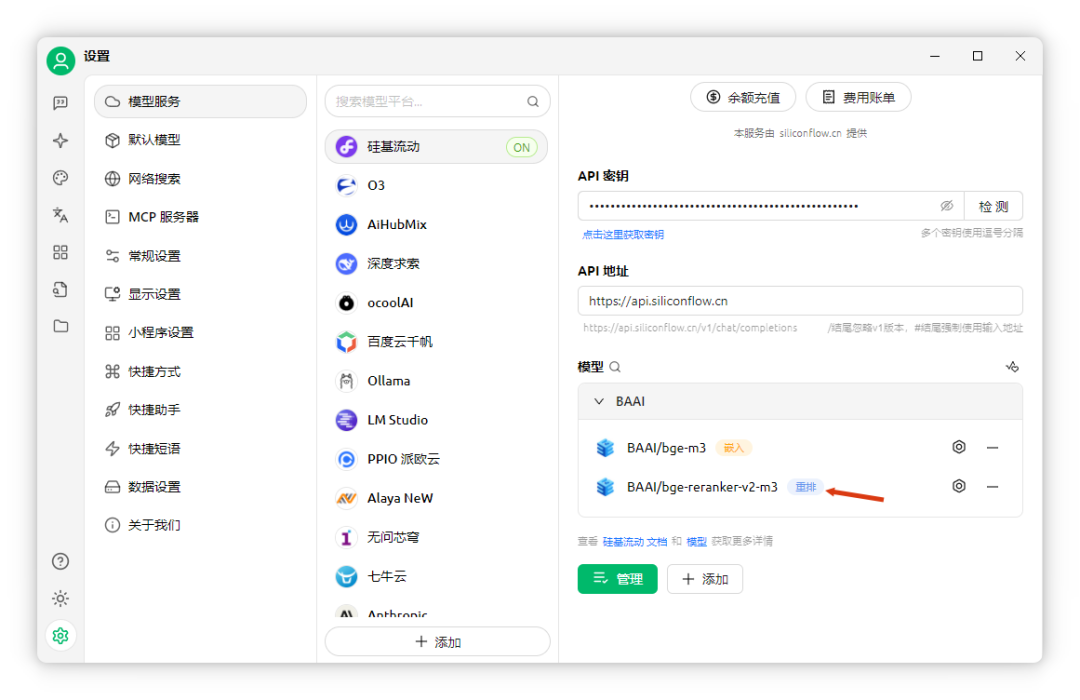
这样就拥有了重排序模型。
回到知识库,右键进入知识库设置。
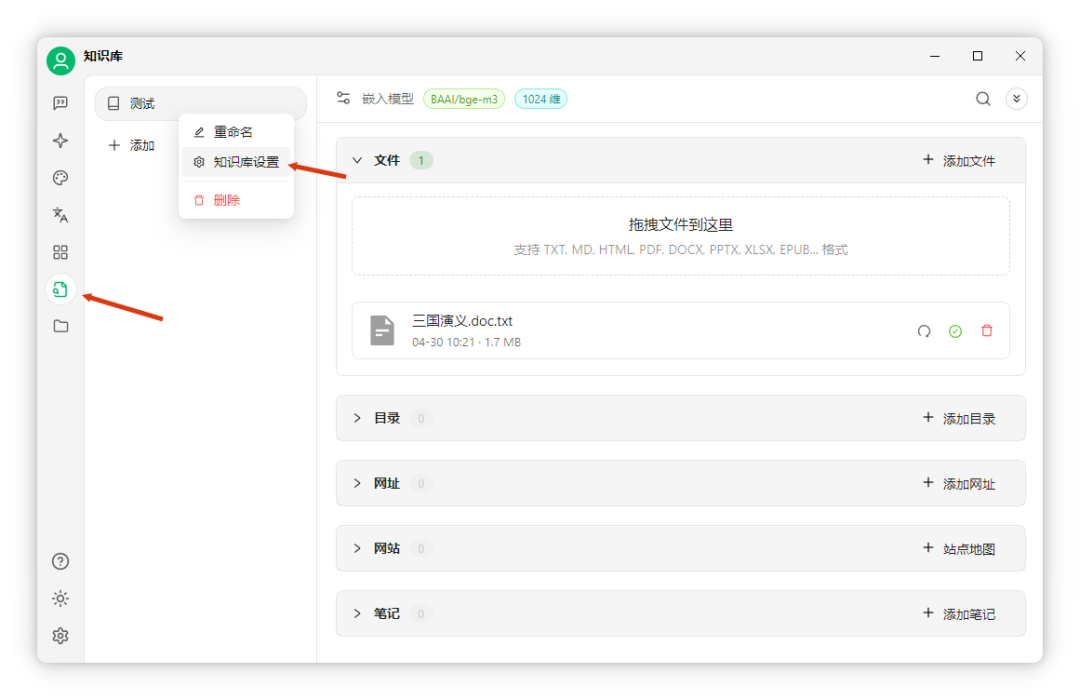
把重排序模型添加进来,点击确定。
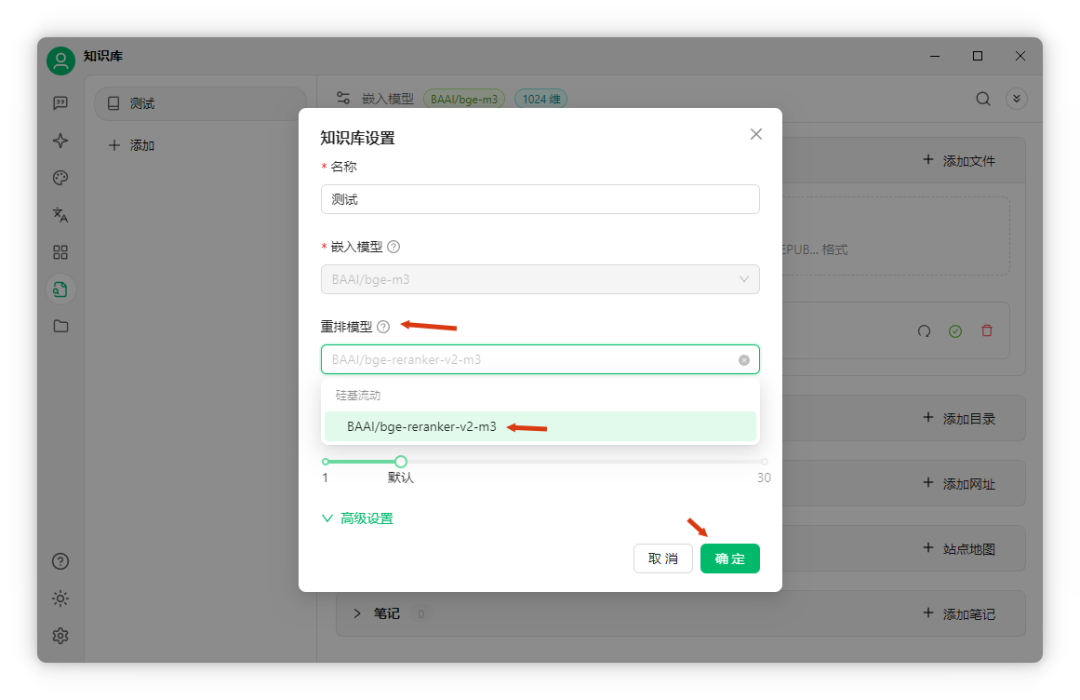
再次搜索“曹操兵器”测试。
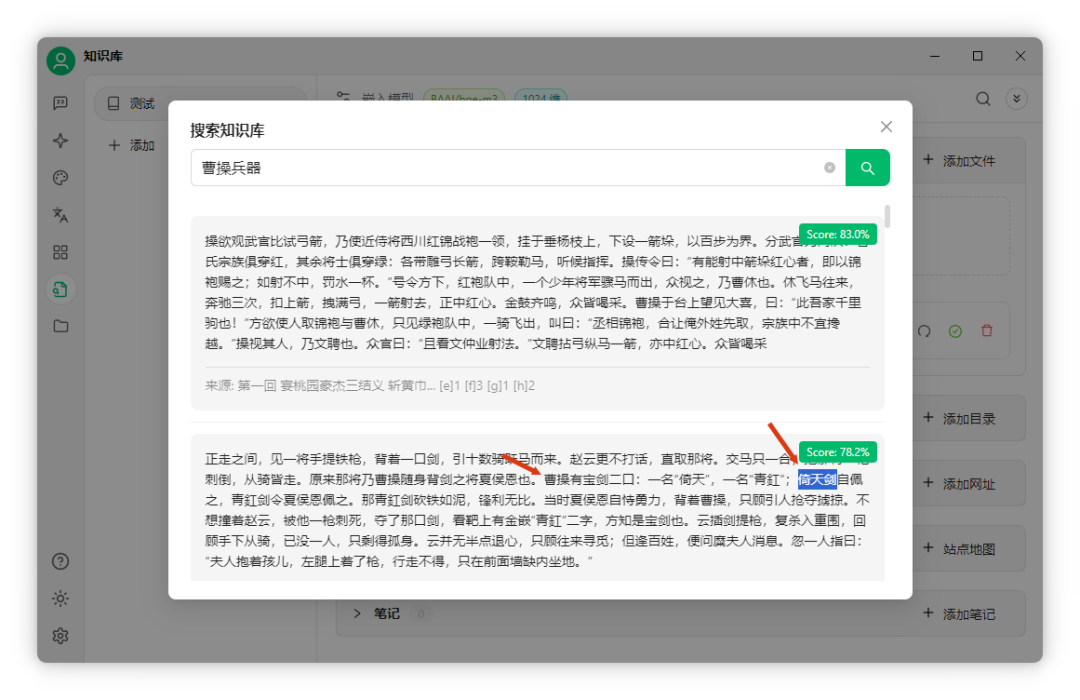
这次倚天剑的信息排到了第二位,分数达到 78%。使用重排序模型后,RAG 知识库检索精度明显提升。

缺乏大局观

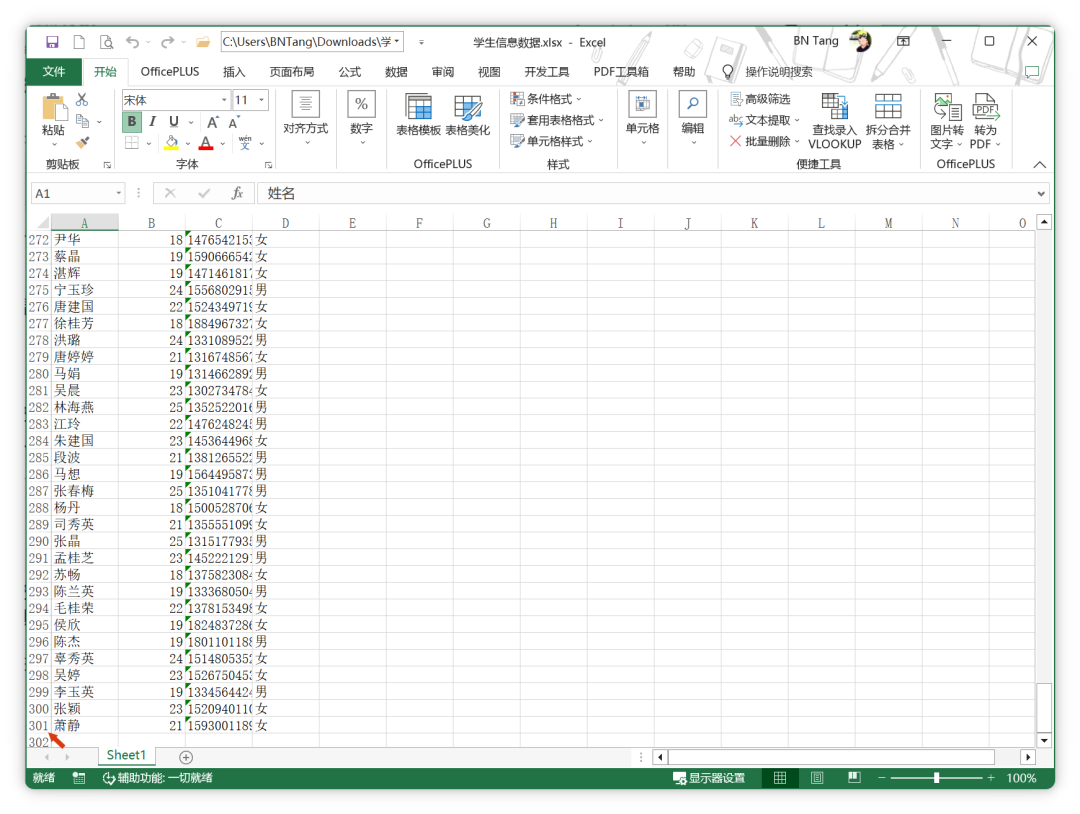
第三个痛点是缺乏大局观。我用 AI 生成了 300 条测试数据:
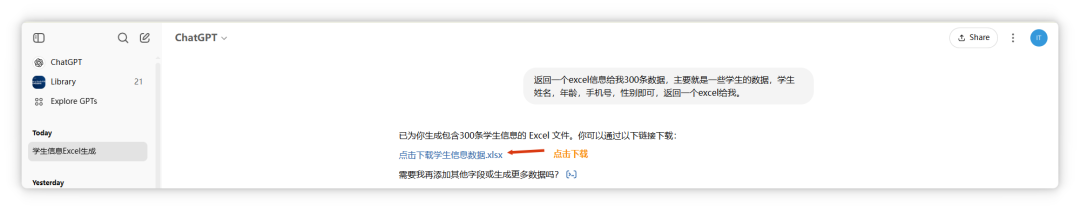
这些都是学生统计信息。如果想用知识库做统计分析,比如求最大最小值等,RAG 技术基本无能为力。向量数据库只能匹配文本块,再交给大模型处理。

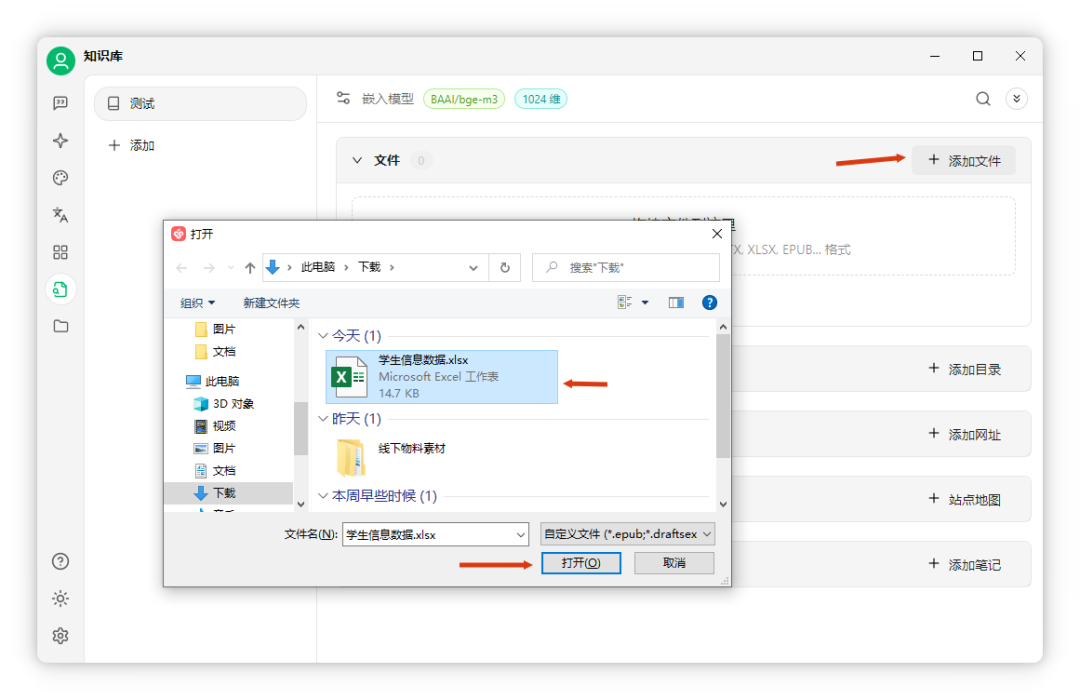
这种情况下,大模型无法从碎片化数据中做出准确总结。我们来试试:先把 Excel 文件添加到知识库。
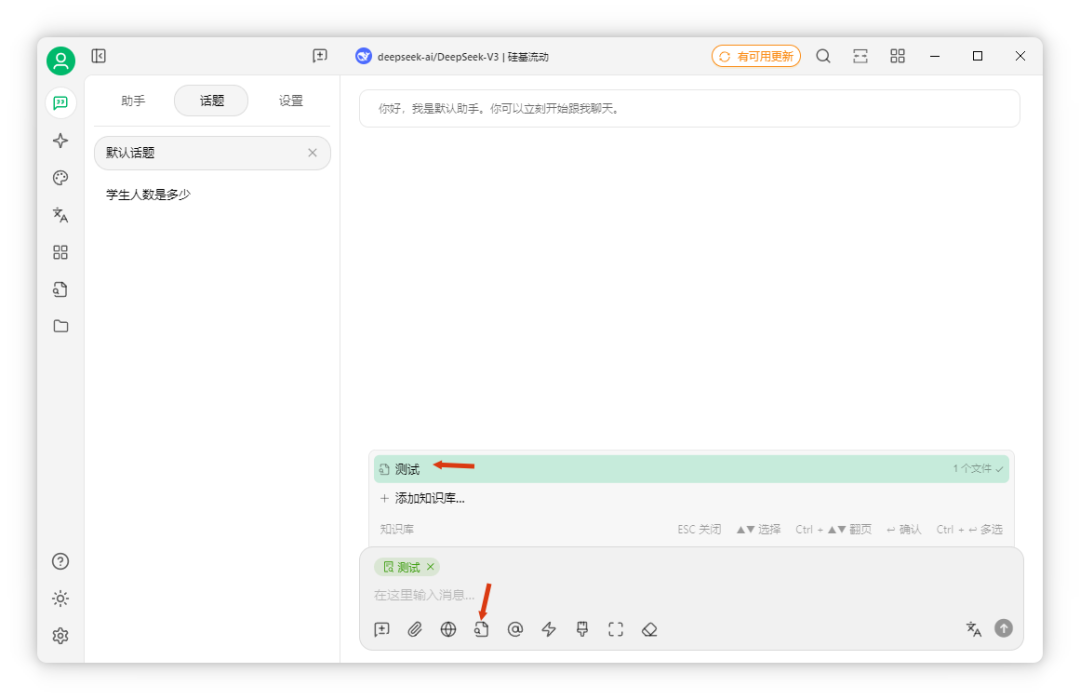
回到聊天界面,这里用的是 DeepSeek(硅基流动所提供),开启知识库。
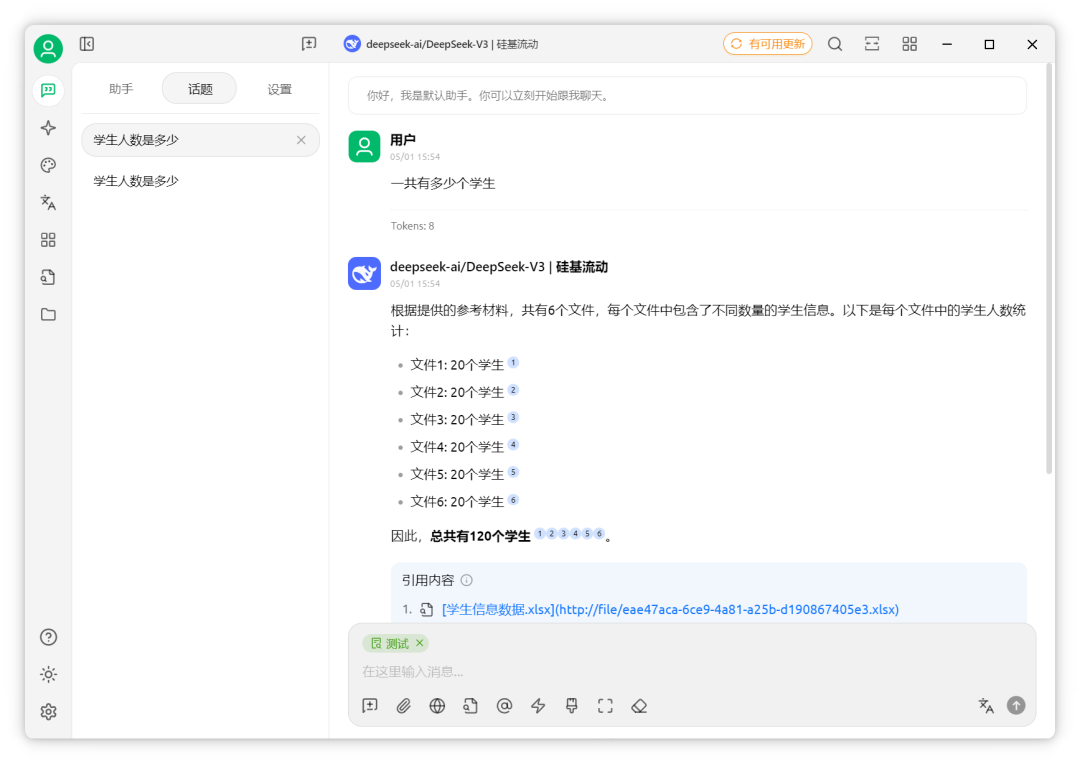
我问“一共有多少个学生”,AI 只拿到六个零散片段。
实际上 Excel 里有 300 个学生。
AI 却回答只有 120 个。
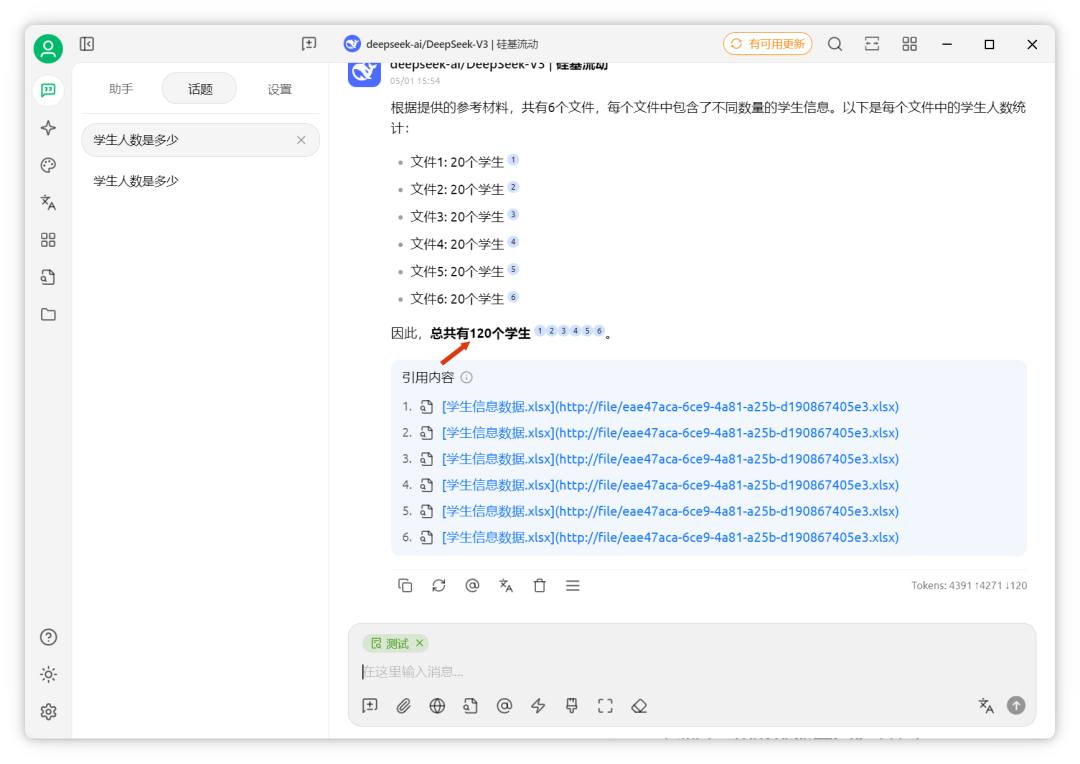
所以,面对结构化或统计性问题,知识库方案难以胜任。此类需求建议用关系型数据库。现在有了 MCP,可以让 AI 通过 MCP Server 操作关系型数据库,是很好的解决方案。本文到此结束,下篇将介绍如何用 MCP Server 将数据库接入大模型。

那么,如何系统的去学习大模型LLM?

作为一名从业五年的资深大模型算法工程师,我经常会收到一些评论和私信,我是小白,学习大模型该从哪里入手呢?我自学没有方向怎么办?这个地方我不会啊。如果你也有类似的经历,一定要继续看下去!这些问题啊,也不是三言两语啊就能讲明白的。

所以我综合了大模型的所有知识点,给大家带来一套全网最全最细的大模型零基础教程。在做这套教程之前呢,我就曾放空大脑,以一个大模型小白的角度去重新解析它,采用基础知识和实战项目相结合的教学方式,历时3个月,终于完成了这样的课程,让你真正体会到什么是每一秒都在疯狂输出知识点。

由于篇幅有限,⚡️ 朋友们如果有需要全套 《2025全新制作的大模型全套资料》,扫码获取~
在这里插入图片描述

为什么要学习大模型?

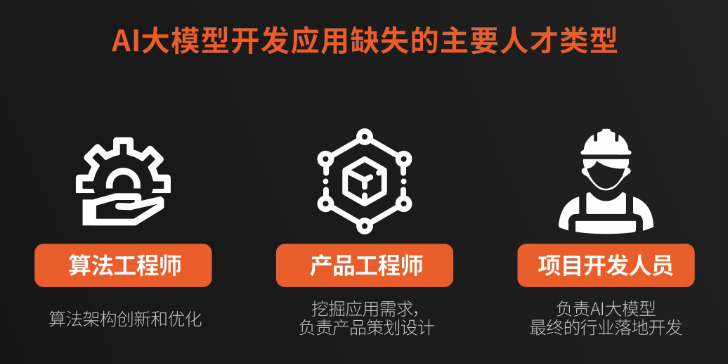
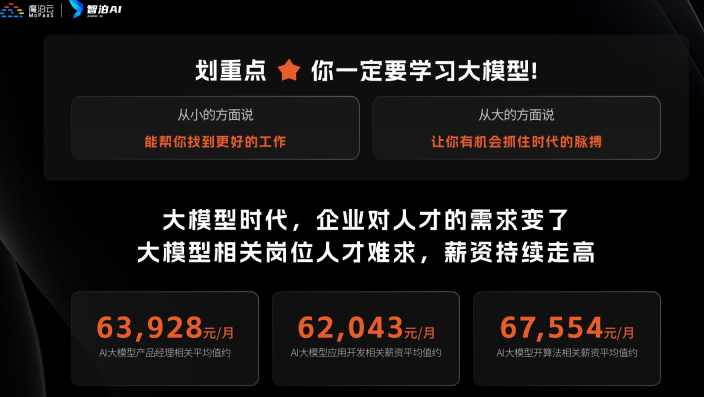
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
在这里插入图片描述

在这里插入图片描述

👉大模型学习指南+路线汇总👈

我们这套大模型资料呢,会从基础篇、进阶篇和项目实战篇等三大方面来讲解。
在这里插入图片描述
在这里插入图片描述

👉①.基础篇👈

基础篇里面包括了Python快速入门、AI开发环境搭建及提示词工程,带你学习大模型核心原理、prompt使用技巧、Transformer架构和预训练、SFT、RLHF等一些基础概念,用最易懂的方式带你入门大模型。
在这里插入图片描述

👉②.进阶篇👈

接下来是进阶篇,你将掌握RAG、Agent、Langchain、大模型微调和私有化部署,学习如何构建外挂知识库并和自己的企业相结合,学习如何使用langchain框架提高开发效率和代码质量、学习如何选择合适的基座模型并进行数据集的收集预处理以及具体的模型微调等等。
在这里插入图片描述

👉③.实战篇👈

实战篇会手把手带着大家练习企业级的落地项目(已脱敏),比如RAG医疗问答系统、Agent智能电商客服系统、数字人项目实战、教育行业智能助教等等,从而帮助大家更好的应对大模型时代的挑战。
在这里插入图片描述

👉④.福利篇👈

最后呢,会给大家一个小福利,课程视频中的所有素材,有搭建AI开发环境资料包,还有学习计划表,几十上百G素材、电子书和课件等等,只要你能想到的素材,我这里几乎都有。我已经全部上传到CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
在这里插入图片描述
相信我,这套大模型系统教程将会是全网最齐全 最易懂的小白专用课!!

深度剖析 RAG 架构:从向量检索到答案生成的全链路技术解析 RAG 架构通过 “检索 - 生成” 的闭环设计,实现了领域知识的精准增强与可控生成。随着多模态融合、动态知识库和个性化交互技术的突破,RAG 将在智能客服、医疗诊断、工业质检等领域发挥更大价值。检索与生成的深度协同:强化学习优化交互流程多模态统一表示:开发跨模态大模型(如 FLAVA)实时知识更新:流式数据接入与在线学习伦理与安全:偏见检测与可解释性增强。 阅读详情

相关推荐

选择合适自己的检索增强生成(RAG)技术:综合指南

在人工智能领域不断发展的进程中,检索增强生成(RAG)技术已成为提升大型语言模型(LLM)性能的关键力量。它通过整合外部知识源,有效弥补了 LLM 自身知识的局限性,在众多应用场景中展现出巨大潜力。今天我们一起聊一下如何选择合适的 RAG 技术(),希望对大家有帮助。

llm_way的博客 3430

如何提高RAG系统准确率?12大常见痛点及巧妙解!

我们探讨了开发 RAG 管道中的 12 个痛点(其中 7 个来自论文,5 个是额外补充)并提供了相应的解决方案。以下是改编自论文《Seven Failure Points When Engineering a Retrieval Augmented Generation System》的图表。

python12345_的博客 1544

彻底告别LLM幻觉!RAGFlow:企业级RAG应用知识库构建的神兵利器

RAGFlow:一站式企业级RAG引擎解决LLM幻觉问题 摘要: 大语言模型(LLM)在实际应用中存在"幻觉"问题,即生成不准确或虚构内容。检索增强生成(RAG)技术通过结合外部知识库检索来解决这一问题。RAGFlow是由InfiniFlow团队开发的一站式企业级RAG引擎,具有三大核心技术优势:1)智能文档处理引擎,支持多格式解析和基于语义的智能分块;2)高效多模态检索系统,结合Milvus向量数据库实现多路召回与融合;3)灵活的LLM集成,支持主流API和本地私有模型。RAGFlow

wylee的博客 1147

RAG实战篇:检索召回结果不准确?试试这三种实用方法

在这篇文章中,围绕检索召回(Retrieval),风叔详细介绍如何优化RAG系统的召回结果,提升LLM大模型的回答准确度。在检索召回的时候,用户的问题会被输入到嵌入模型中进行向量化处理,然后系统会在向量数据库中,搜索与该问题向量语义上相似的知识文本或历史对话记录并返回。在Naive Rag中,系统会将所有检索到的块直接输入到 LLM生成回答,导致出现中间内容丢失、噪声占比过高、上下文长度限制等问题。

2401_85375186的博客 3231

【Dify】RAG开源框架Dify:技术深度剖析与实践指南

Dify作为一个开源的RAG框架,凭借其强大的数据集管理功能、可视化的Prompt编排、高效的RAG管道、灵活的Agent功能以及多种大型语言模型的支持,为开发者提供了一个快速搭建生产级AI应用的平台。无论是对于技术人员还是非技术人员来说,Dify都大大降低了AI应用开发的复杂度,使得更多人能够参与到AI应用的开发和创新中来。未来,随着技术的不断进步和应用场景的不断拓展,Dify有望在人工智能领域发挥更加重要的作用。例如,通过引入更多的自然语言理解和生成技术,Dify可以进一步提升其问答和文本生成的能力。

后端研发工程师Marion的博客 3538

零基础学习大气污染模式(WRF、WRF-chem、smoke、camx等)

零基础学习大气污染模式(WRF、WRF-chem、smoke、camx等)

weixin_56135535的博客 644

【建议收藏】RAG优化全攻略:解决检索不准、不全、生成不稳的企业级实战指南

RAG优化围绕"检索器→索引与分块→生成器"三大环节,通过混合检索、两阶段检索、查询改写提升检索精度;采用语义分块、元数据和图结构优化知识组织;借助Prompt工程和事实校验降低生成幻觉。企业级落地需结合向量库调优、数据优化及评测指标体系,前沿方向包括Multi-hop RAG、GraphRAG和Active Retrieval等技术。

weixin_72959097的博客 659

随机森林文本分类

随机森林原理及代码实现 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 例如:第一章 Python 机器学习入门之pandas的使用 提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录随机森林原理及代码实现前言一、集成算法是什么?二、随机森林是什么三、 数据预处理3.1 先来看一下我们的文本数据3.2 预处理3.3 统计评论情感值积极与消极的占比二、使用步骤参数介绍(4个)属性1.引入库2.参数调参方法总结 前言 提示:这里可以添加本文要记录的大概内容: 例如

m0_46579176的博客 5798

RAG 技术困境:为何单纯依赖向量嵌入不可靠?

RAG(Retrieval-Augmented Generation)是一种结合了检索和生成的自然语言处理技术。它通过检索相关文档来增强语言模型的生成能力,旨在提高生成文本的质量和相关性。在 RAG 系统中,首先使用检索模块从大规模文档集合中检索与用户查询最相关的文档片段,然后将这些文档片段作为上下文信息输入到生成模块,生成模块基于这些上下文信息生成回答。

GZM888888的博客 846

光电转换器件PMT,APD总结

PMT和APD都属于单点探测器,只能探测光子信息,可以通过扫描方式测光谱。 1. PMT PMT:光电倍增管,是光子技术器件中的一个重要产品,它是一种具有极高灵敏度和超快时间响应的光探测器件。 原理:光电倍增管是一种真空器件。它由光电发射阴极(光阴极)和聚焦电极、电子倍增极及电子收集极(阳极)等组成。当光照射到光阴极时,光阴极向真空中激发出光电子。这些光电子按聚焦极电场进入倍增系统,并通过进一步的二次发射得到的倍增放大。然后把放大后的电子用阳极收集作为信号输出。 优点:因为采用了二次发射倍增系统,.

Ammon_Zhang的博客 1万+

Xilnx大学计划/XUP ZYNQ ZU开发板

TUL PYNQ™-ZU板,基于Xilinx Zynq UltraScale+ MPSoC,是为Xilinx大学项目设计的,以支持Xilinx PYNQ (Python Productivi-ty for Zynq)开源框架和嵌入式系统开发。

weixin_57025922的博客 942

AI检索不准?99%的人都忽略了这一步!

语义切分,说白了就是让AI“按内容分块”,而不是“按长度分尸”。它是RAG系统“检索-生成”闭环的关键一环,直接决定了AI的“知识召回率”和“答题准确率”。一句话,想让你的AI像“懂王”一样,问啥都能答到点子上?先把语义切分练到极致!最后,欢迎大家留言讨论:你在RAG项目中遇到过哪些“切分翻车”的坑?你觉得还有哪些更骚的切分方法?评论区见!

许泽宇的技术分享 1062

simulink求解器选择的小tip

给出了simulink选择求解器的一种tip,与积分初值有关。

高能阿博特的博客 2047

企业级RAG知识库构建:从痛点到解决之道

在企业数字化转型的浪潮中,RAG(检索增强生成)技术以其连接海量知识与大模型的能力,成为知识管理领域的焦点。然而,当这一技术蓝图遭遇企业实际场景——海量文档、结构复杂的表格与严苛的业务指标时,往往呈现出理想与现实的巨大落差。

qq_46094651的博客 1258

Python连接StarRocks全流程实践: SQL文件调用与Pandas混合优化

通过这种分阶段混合计算, 既能发挥StarRocks处理海量数据的性能优势, 又能保留Pandas在内存计算中的灵活性, 实现效率与功能的完美平衡.结合SQL的高效聚合与Pandas的灵活计算, 实现查询和数据处理的深度融合.该库基于SQLAlchemy 2.x开发, 仅支持Python 3.x环境.对大批量数据的写入, 建议进行分块. 分块写入较单条插入速度会有显著提升.这样可以避免python代码的查询与SQL耦合, 支持版本化管理.将DDL, DML分离为独立文件, 例如。: 调整连接复用参数。

t.y.Tang的博客 2774

uniapp [全端兼容] - 实现上传本地视频到后端服务器及在线预览播放视频+移除视频+进度条上传,将已选视频上传服务端并可预览视频和删除功能,上传单个或多个视频文件及大文件(H5、小程序、app)

uni-app,h5移动端网页,微信小程序,支付宝小程序,Android安卓,苹果ios,app,nvue,uniapp+uview上传视频并预览,UNI-APP视频上传组件,实现视频文件上传视频回显,上传视频并预览、上传多个视频,实现上传视频功能+预览,上传显示视频功能,上传视频预览移除,批量上传视频,上传超大视频文件,视频上传并预览效果,uniapp上传视频,使用uview上传视频及预览,上传视频和删除视频功能,视频流上传播放功能,上传视频到后端,视频上传与实时预览功能,upload上传组件,视频播放器

🏆 前端领域优质创作者 1万+

检索增强生成(RAG)技术深度剖析:从基础到前沿应用(必学收藏)

检索增强生成(RAG)技术通过结合大模型参数化知识与外部知识库,有效解决了模型知识截止和幻觉问题。当前最佳RAG系统采用多阶段优化策略,包括混合搜索(融合词法与语义)、重排模型精炼结果、查询转换理解用户意图,以及自适应检索实现自我修正。构建高性能RAG系统应从高质量文本切分和顶级嵌入模型开始,逐步引入高级技术,并建立科学的评估框架。RAG正演变为复杂智能系统,与Agent技术结合将开启更广阔的应用前景。

2401_85375186的博客 1406

PostgreSQL面试题及详细答案120道(101-120)

本文针对PostgreSQL数据库提供全面的性能优化方案,涵盖10个关键面试题解析。主要内容包括:1)并发参数调优(max_connections、worker_processes);2)缓存设置(effective_cache_size);3)WAL日志优化;4)慢查询监控与日志配置;5)会话管理与阻塞处理;6)高写入场景优化策略;7)存储类型参数调整;8)自动清理机制配置;9)大表DDL操作避坑指南;10)性能瓶颈诊断方法论。对DBA和开发者具有实操指导价值

大剑师兰特的GIS世界 845

【建议收藏】RAG技术深度剖析:从原理到实践,小白也能轻松掌握的检索增强生成指南

我感觉LangChain4j 中文文档(RAG (检索增强生成) | LangChain4j 中文文档)中的介绍还挺有趣:“RAG 是一种在发送给 LLM 之前,从你的数据中找到并注入相关信息片段到提示中的方法。这样 LLM 将获得(希望是)相关信息,并能够使用这些信息回复, 这应该会降低产生幻觉的概率。”我的理解是:例如,向 LLM 提问一个问题(qustion),RAG 从各种数据源检索相关的信息,并将检索到的信息和问题(answer)注入到提示词模板中,LLM 最后给出答案。

kaka0722ww的博客 742

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

【珍藏指南】RAG技术深度剖析:从Naive到Modular,构建高效大模型检索增强系统

【珍藏指南】RAG技术深度剖析:从Naive到Modular,构建高效大模型检索增强系统

kaka0722ww的博客 1199

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

RAG分块策略深度剖析:原理、实践与应用

摘要:本文介绍了RAG(检索增强生成)技术中的关键环节——分块策略,详细解析了五种常见方法:1)固定大小分块适用于大规模文本但可能破坏语义;2)语义分块基于嵌入相似度合并内容,提升准确性但计算复杂;3)递归分块通过分层处理平衡结构完整性与长度限制;4)文档结构分块利用标题/段落等标记保持逻辑性;5)基于LLM的分块依赖大模型智能划分。每种策略均附实现代码(如Python的langchain库)及适用场景(新闻、法律文档等)。选择策略需权衡语义连贯性、计算成本与实现复杂度。

没事学AI的博客 921

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

RAG 完整流程深度剖析:从数据准备到智能生成的端到端指南

回顾 RAG 的完整流程,你会发现它早已超越了"向量检索+LLM 调用"的简单组合。一个生产级 RAG 系统需要在索引阶段精心设计分块策略、嵌入模型选型和向量索引配置;在推理阶段优化查询改写、检索融合、重排序和提示工程。每一个环节都像精密钟表中的一个齿轮,协同运转才能输出高质量、可溯源、可信赖的 AI 答案。理解这个端到端流程,是构建真正可用的 RAG 应用的第一步。底部锚点⬆ ⬆ 顶部 ⬆ ⬆⬇ ⬇ 底部 ⬇ ⬇⬆ ⬆ 顶部 ⬆ ⬆。

✨ 欢迎来到【Seal ^_^ 的CSDN博客】!✨ 467

RAG 检索增强生成深度剖析:从分片到向量检索,LLM 的知识缺口是怎么被补上的?

检索增强生成(RAG)是解决大模型知识滞后、幻觉、私有数据接入难题的主流方案。本文完整拆解 RAG 技术体系,讲解离线分片、Embedding、向量存储,以及在线混合召回、重排、生成全链路。对比 HyDE、Self-RAG、CRAG、Graph RAG、Agentic RAG 等进阶方案,结合企业知识库问答实战案例,介绍查询改写、增量索引、幻觉防控等工程优化,梳理落地常见问题与解决方案,帮助读者构建系统化 RAG 知识体系,适合项目开发、面试学习参考。

sjsi13的博客 1005

深度拆解!带你吃透检索增强生成(RAG)全流程

今天我用最接地气的话,把 RAG 从基础原理到实战项目全拆明白,不管是想搞技术研究,还是落地项目,都能找到干货,快跟紧啦!

2401_82469710的博客 1077

RAG技术深度剖析:awesome-generative-ai-guide检索增强生成完整实践指南

在人工智能快速发展的今天,大型语言模型(LLM)虽然展现出了强大的文本生成能力,但仍然面临着几个关键挑战:知识更新滞后、容易产生幻觉(Hallucination)、缺乏领域专业知识。传统LLM依赖训练时的静态知识,无法实时获取最新信息,这在需要准确、及时知识的场景中成为了致命缺陷。 **检索增强生成(Retrieval-Augmented Generation,RAG)** 技术应运而生,它通过...

gitblog_00587的博客 997

干货|Dify智能体揭秘:RAG技术深度剖析与知识库实战攻略!

摘要:检索增强生成(RAG)技术通过动态检索与智能生成的结合,解决了传统大模型的知识时效性和幻觉问题。文章详细解析了RAG系统的三大核心组件(智能检索、文档处理、生成优化)及其在企业知识库、医疗问诊等场景的应用效果(如准确率提升90%)。同时指出当前面临的长文本检索、多文档整合等挑战,并展望了多模态RAG、自治式系统等未来发展趋势。该技术正重塑AI在专业领域的应用范式。

2401_84494441的博客 930
上一篇: 干货收藏:35+程序员的AI转型之路:大模型如何让你的经验成为优势
下一篇: 【必学干货】OceanBase seekdb:AI原生数据库实现多模态混合搜索,解决传统RAG的“盲人摸象“难题
大模型开发
博客等级 码龄4年 4798粉丝 2629原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值