


先描述一个场景,你看看熟不熟悉。
需求评审会。产品经理讲完业务流程,转头问了一句:"这个页面什么时候能点?"
五年前,这句话跟你没关系。你会说接口下周给到,前端那边自己接。会议到此结束,你回去写你的 Controller。
现在不一样了。你会发现所有人的目光都落在你身上,因为这次排期表里,前后端都写着你的名字。
一、代码变便宜之后,账被重新算了一遍
这件事不是凭感觉。Sonar 在 2026 年发布的开发者调查(1149 名开发者参与)里有几个数字,值得多看两眼:
- AI 生成或辅助完成的代码,已经占到交付代码的 42%
- 开发者预计到 2027 年,这个比例会涨到 65%
- 72% 的开发者每天都在用 AI 编码工具
超过四成的代码不是人一行行敲出来的,而且这个比例还在往上涨。
这对团队意味着一件事:写代码这件事本身,正在快速变便宜。
便宜到什么程度?便宜到老板们开始重新算账了。
过去十年,Java 后端的岗位画像非常稳定:熟悉 Spring Boot、MyBatis、MySQL,能写 CRUD,能调接口,能修 bug。这套能力对应的是交付链条上的一环——前面有人做需求,后面有人做测试,你负责把中间那段代码写出来。
这个分工之所以成立,是因为"把代码写出来"这件事本身很贵,值得专门设一个岗位。
现在这个前提松动了。一个工程师配上 AI 工具,写代码的产出能翻几倍,很多团队已经验证过这件事。产出上来之后,管理者自然会问下一个问题:既然中间那段变便宜了,那我为什么还要为"只会写中间那段"付溢价?
这就是"被要求一个人交付整个系统"的真正来源——不是你突然要学前端了,是岗位的定价逻辑变了。
二、边界扩出去的那一格,具体是什么
很多人一听"全栈",第一反应是"我要学个前端框架"。
这个理解偏差得有点远。
从"我负责接口"到"我负责这个需求能用起来",中间隔着的东西,比一个框架多得多。拆开看大概是三类:
第一类:状态。
接口是无状态的,请求来了处理完就走。页面不是。一个列表页上有筛选条件、分页、勾选状态、未保存的编辑内容、加载中的遮罩、失败后的重试入口。这些东西后端工程师平时完全不需要操心,因为它们在别人那一侧。
第二类:错误呈现。
后端处理异常,是抛一个码、记一条日志。到了页面上,"异常"要变成一句人能看懂的话,要决定是弹窗还是行内提示,要判断是重试还是回退。这不是技术问题,是判断问题——而判断需要知道用户在这个页面上是谁、在干什么。
第三类:边界确认。
以前需求不清楚,你可以等产品补。现在你既写接口又写页面,需求里那个说不清的地方会在你手上卡住——因为你两边都得动,含糊过去就得返工两次。
这三类东西的共同点是:它们都不是"写代码"能解决的。
所以"去学个前端框架"这件事,最多只能覆盖到第二类里的一小部分。
它们要求你在动手之前,先搞清楚这个需求到底要什么。而这恰恰是 AI 帮不上忙的那部分。
三、交付边界扩到哪,产物就该跟到哪
问题来了:判断力要落地,得有东西可判断。
一个人交付整个系统,最容易失控的地方不是代码量,是中间那几份没人给你写、但你又不能没有的东西——需求到底要什么、接口怎么定、表怎么设计、页面从哪份接口长出来。
这些在传统分工里是"别人给的"。现在你自己交付,它们要么你补上,要么就没有。
飞算 JavaAI 的智能会话里有一条"全栈"指令,它做的事情本质上是把这个缺口接住:把需求分析、前后端设计、前端开发、后端开发这四个环节放在同一次推进里完成。走法是——先解析原始需求,产出需求文档和业务设计文档,遇到边界模糊的地方先发起澄清,而不是闷头往下写;再由前后端设计环节读上游文档,做数据库设计和 API 接口设计,然后依据这份接口设计产出前端页面设计,同时给出一份技术栈决策;前端工程落在项目的 frontend 目录,后端代码遵循前面定下的接口规范执行。所有产物都写进项目的 docs 目录。
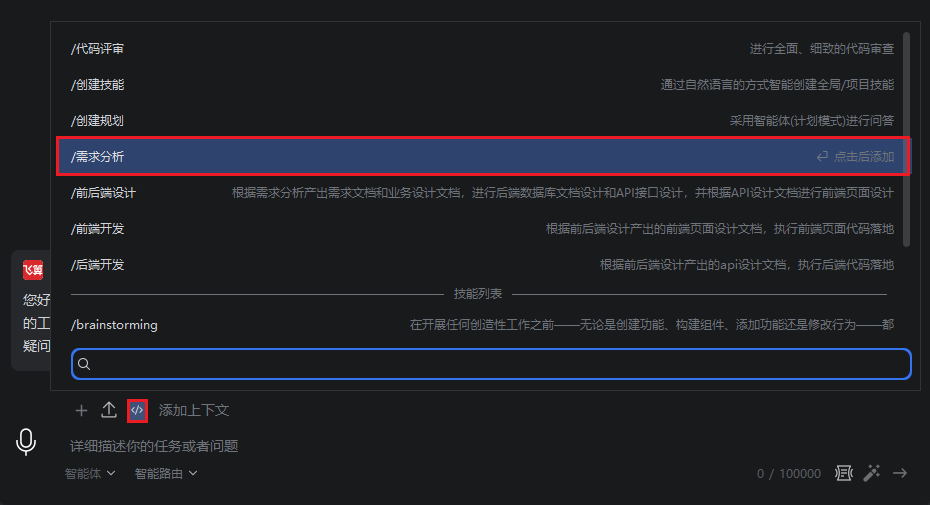
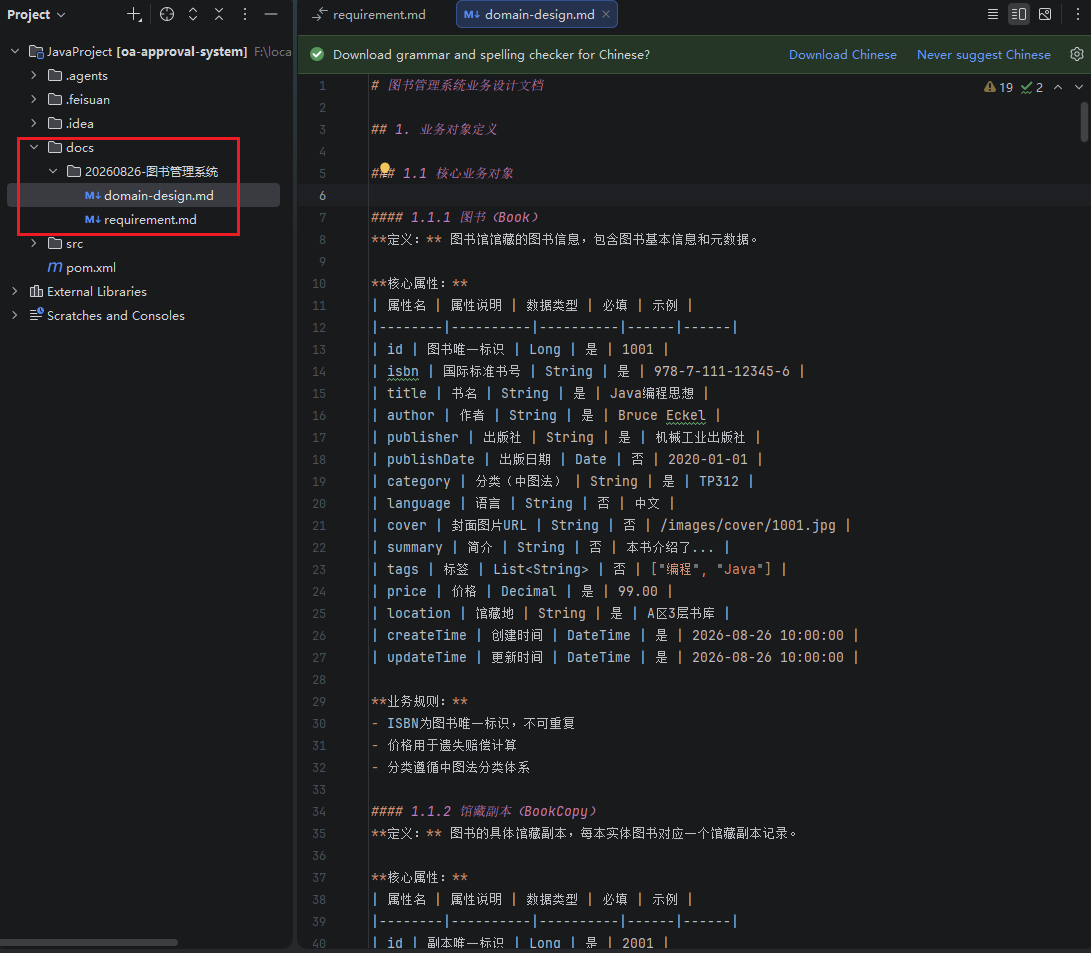
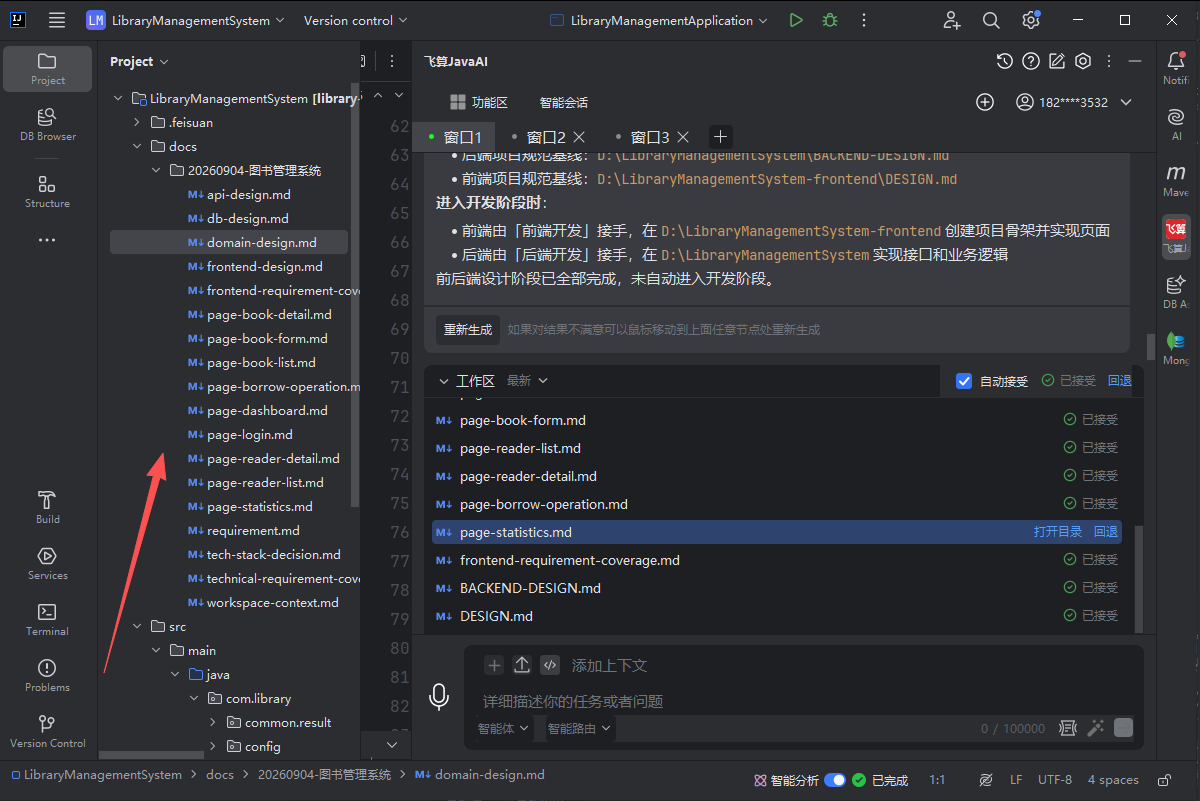
它的价值不在"帮你写了多少代码",而在交付边界往外扩的那一格,有对应的产物跟着一起扩。
你要对整条链负责,那整条链就得有可复查的东西。需求文档让你不用靠回忆确认当初说好的范围,接口设计让你在写页面之前就知道字段叫什么,技术栈决策让半年后接手的人知道当初为什么这么选。
边界要诚实一点:它不会替你做业务判断,也不会替你决定一个页面该长什么样。需求里的模糊地带,它也只是先问你,而不是替你猜一个答案。能把"问"这一步做出来,已经比直接开写强很多了。
四、不是让你精通前端,是让你对判断负责
产物补齐之后,剩下的才是真正属于你自己的那部分工作。
这里有个反直觉的数据,还是那份 Sonar 2026 调查:
- 96% 的开发者表示,他们不完全信任 AI 生成代码的正确性
- 但只有 48% 的人会在提交前始终做检查
- 验证 AI 代码消耗了开发者约 35% 的工作时间
一边是几乎没人信,一边是只有不到一半的人真的查。中间这 48 个百分点的缺口,就是眼下最真实的风险来源。
这组数字说明了一件很关键的事:当写代码变便宜,贵的那部分就变成了"判断它写得对不对"。
而判断力,恰恰是后端工程师本来就有的东西。
你能看出一个 SQL 走没走索引,能看出一个事务边界划得对不对,能看出一个接口的幂等性有没有问题。这些能力不是"写"的能力,是"判"的能力。
前端那一侧同理。你不需要背下所有组件的 API,你需要的是能判断:这个字段为什么要放在这里、这个状态该由谁持有、这个错误提示放在哪一层最合理。
所以"转全栈"真正要转的,是把你的判断力从后端那一层,延伸到整条交付链上。
代码可以让工具写,判断没人替你做。而且现在的分工是——AI 写得越多,你判断的责任越重。
五、如果明天就被要求一个人交付,先补这三件事
不用急着去学框架。按优先级排,真正该先补的是这三件:
第一,把"需求确认"变成一个有产物的动作。
不是开会聊完就算,而是聊完有一份写下来的东西,能回到项目里被查到。一个人交付时,需求理解错了的代价是双倍的——接口和页面都得改。
第二,把接口契约放在写代码之前。
接口先定死,页面才有出处。反过来做的话,你会陷入"页面这么写比较顺手,那接口改一下吧"的循环,最后两边都不干净。
第三,给自己的判断留出可复查的依据。
选型为什么这么选、这个字段为什么这么命名、这个异常为什么在这一层处理——这些决定的理由,决定了半年后你(或者接手的人)能不能看懂这个工程。
至于前端框架本身,反而是这三件事之后才需要考虑的。框架可以边做边学,上面这三件事做不牢,学再多框架也只是换个地方返工。
六、一句可能不太好听的话
"Java 转全栈"这个话题,这两年被讲得很多,讲法大多是"要不要学前端"。
但如果你去看真实发生的岗位变化,会发现驱动它的不是"前端缺口",而是写代码这件事不再值钱了。
当一段能力变便宜,市场就会重新给拥有这段能力的人定价。这是经济规律,不是行业偏见。


 扫一扫


 238

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


