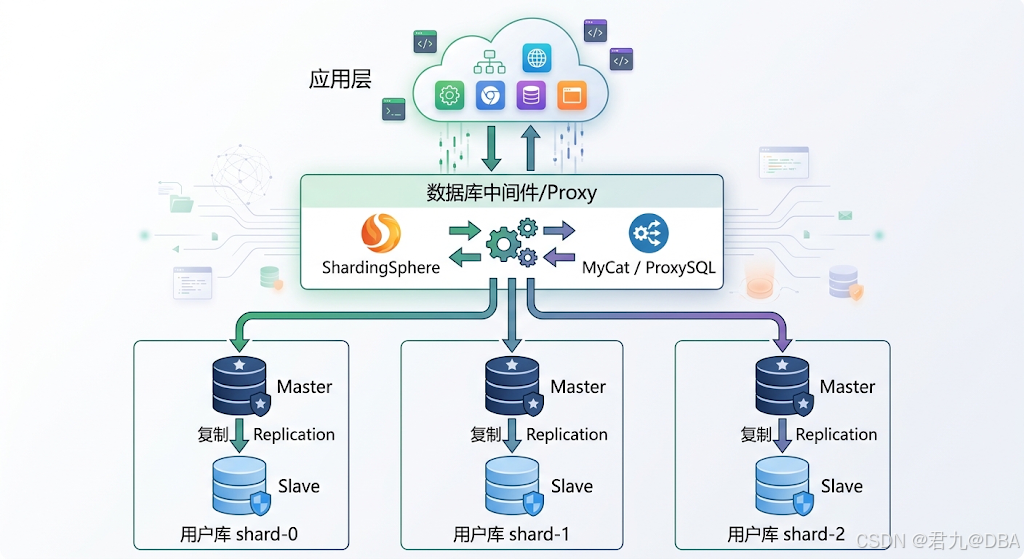
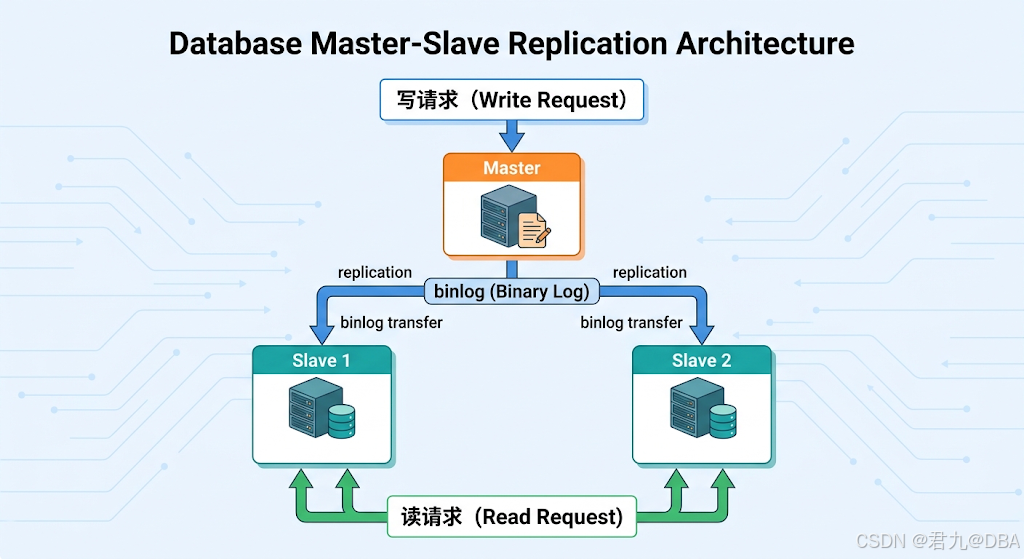
MySQL 数据库分布式是怎么做的 MySQL 数据库分布式是怎么做的 最基础:主从复制 数据量太大:分库分表 怎么知道 SQL 去哪个 MySQL? 真正生产环境通常是:分片 + 主从 高可用怎么做? MySQL 分布式最麻烦的其实不是“拆”,而是查询 JOIN 也会变麻烦 分布式事务也是大问题 ID 也不能再简单 AUTO_INCREMENT 扩容也是一个难点 所以一个典型互联网 MySQL 架构可能是 MySQL 数据库分布式是怎么做的 MySQL 本身严格来说不是一个“原生分布式数据库”,实际项目里所谓的 MySQL 分布式,通常是把多个 MySQL 实例通过 主从复制 + 分库分表 + 中间件 + 高可用组件 组合起来。 可以先把它理解成下面这张逻辑图: 核心其实就解决 4 个问题:容量、并发、高可用、一致性。 最基础:主从复制 先不分库,把一个 MySQL 变成多个实例: Master 接收: INSERT UPDATE DELETE Slave 主要负责:


 超级会员免费看

 订阅专栏 解锁全文



 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言

 1265
被折叠的 条评论
为什么被折叠?
到【灌水乐园】发言


