


实验环境:windows10,linux服务器(Centos)
文章目录
双歧杆菌基因组序列批量下载
此模块介绍在PATRIC数据库中检索下载所有不同双歧杆菌菌株(大概1400株左右)的csv文件,再通过数据筛选和清洗得到我们将要下载的基因组序列信息。利用python脚本批量下载基因组序列(gbk文件或fasta文件)。
注:antiSMASH推荐使用gbk文件进行基因簇挖掘。
一、双歧杆菌基因组信息检索及下载
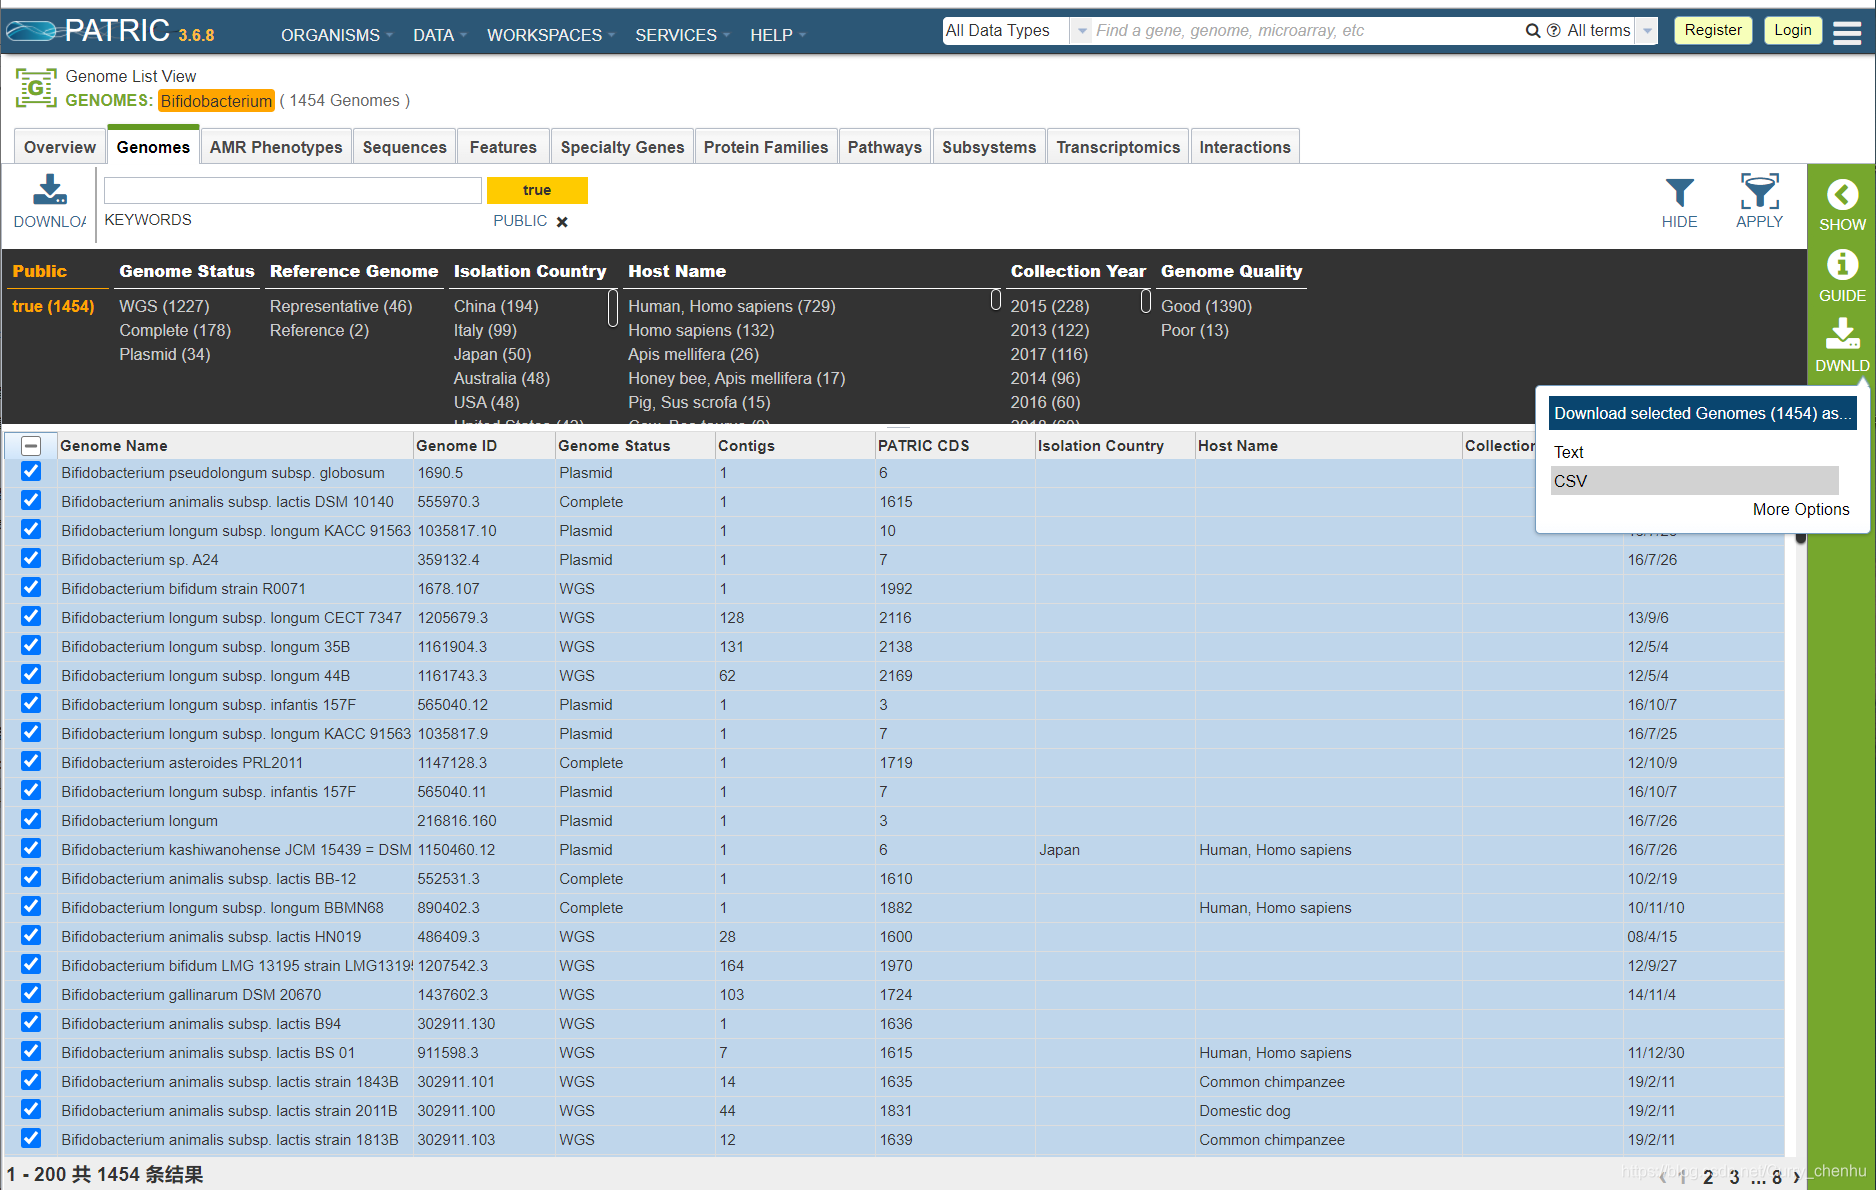
1.PATRIC数据库检索双歧杆菌(Bifidobacterium) 并下载序列信息csv文件
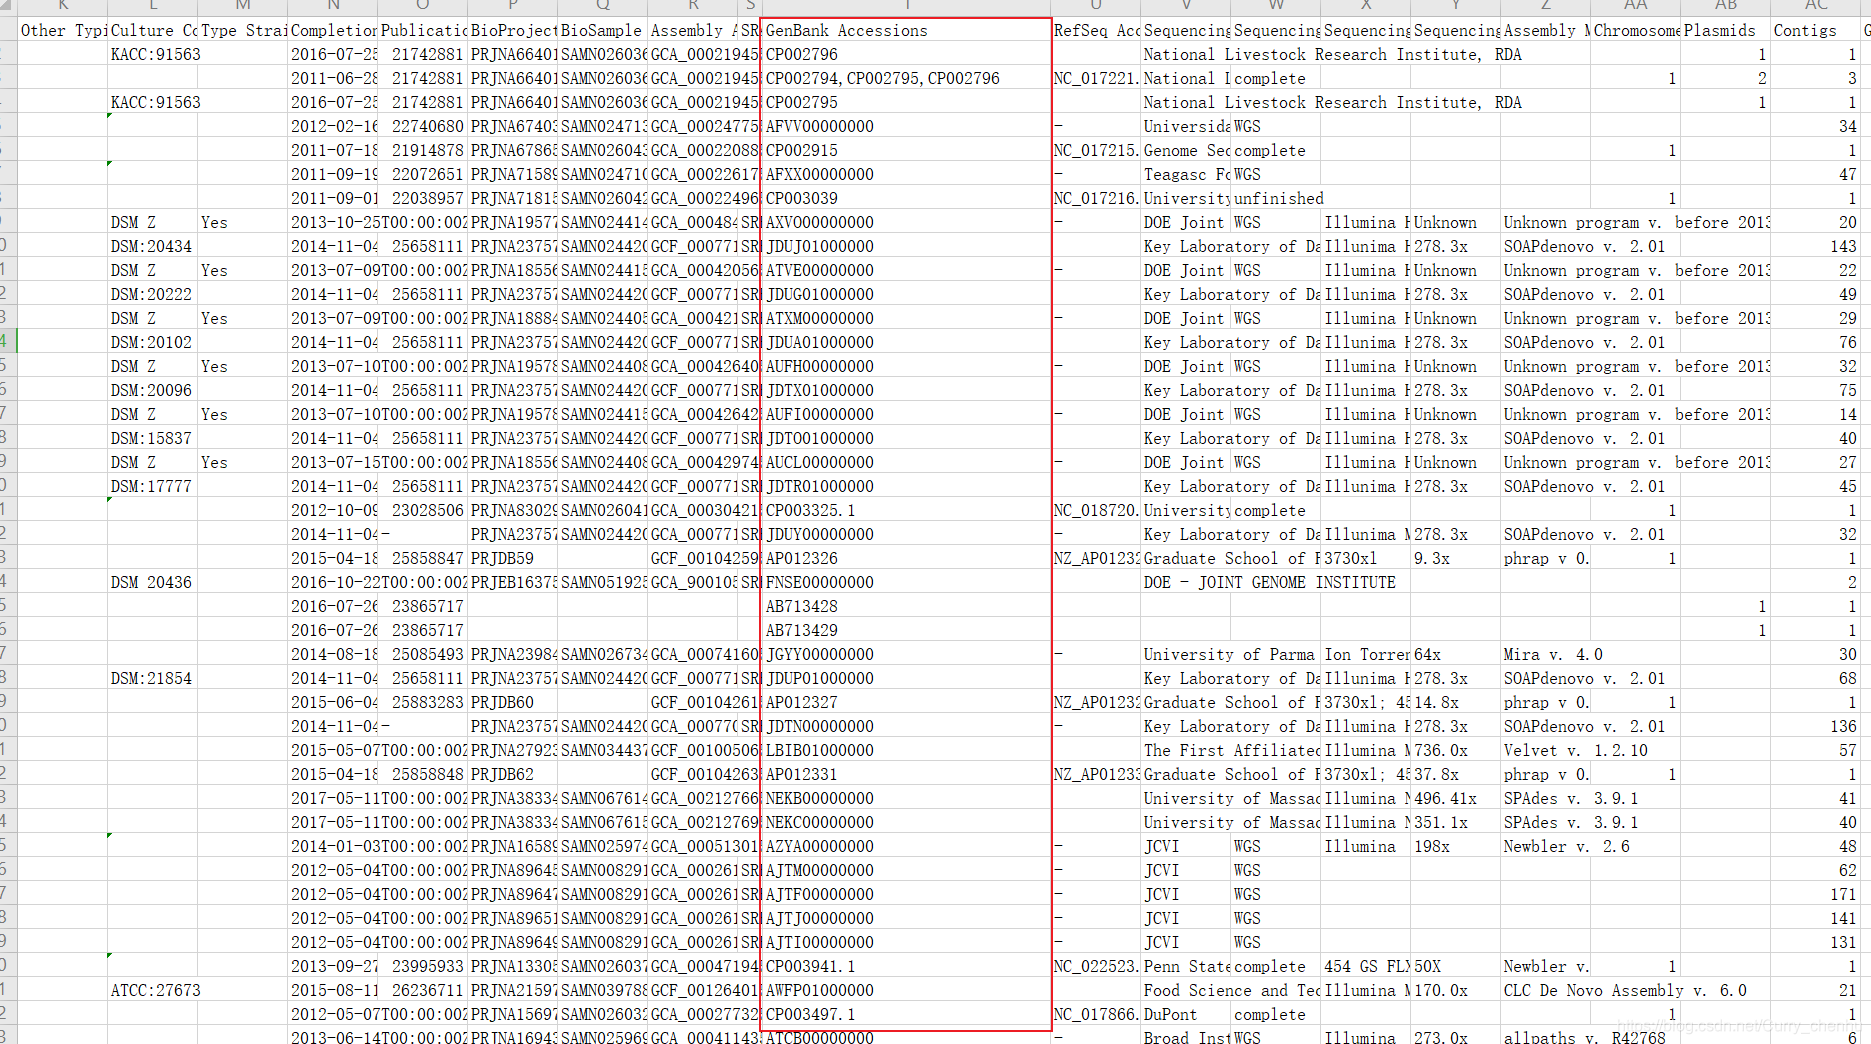
下载后的csv文件如下图所示,对这些序列信息进行筛选清洗,筛选出不重复的菌株序列。“GenBank Accessions”用于基因组序列下载(NCBI数据库)。
二、基因组序列批量下载
python脚本代码
from Bio import Entrez
import csv


# 参数设置
Entrez.email = "example@163.com"
Entrez.tool = "exampleScript"

csv_file = "complete2.csv"   # csv文件路径


def get_gbk(csv_file):
    """
    从csv文件中获取GenBank Accessions,返回基因组登记号列表(gbk_List)
    :param csv_file: csv文件
    :return: 含有所有GenBank Accessions的列表
    """
    gbk_list =[]  # 存储GenBank Accessions
    # 读取csv文件
    csv_flie = csv.reader(open(csv_file))

    # 确定“GenBank Accessions”所在位置(即索引)
    goal_index = 0
    for l in csv_flie:
        goal_index = l.index("GenBank Accessions")
        break
    # 读取所有组的信息找到对应的"GenBank Accessions"
    for line in csv_flie:
        gbk_list.append(line[goal_index])

    return gbk_list


def download_gbk(gbk_list,goal_path):
    """
    下载提供的基因组登记号列表中对应的genbank格式基因组序列,并存储到本地
    :param gbk_list: "GenBank Accessions"列表
    :param goal_path: gbk文件存储路径
    :return: failed_list
    """

    # 下载失败的基因组序列列表
    failed_list = []
    print("开始下载gbk格式基因组序列文件")
    for gbk_id in gbk_list:
        file_name = goal_path + gbk_id + ".gbk"  # 指明路径:以GenBank Accessions命名文件
        try:
            handle = Entrez.efetch(db="nucleotide",id=g

 7214


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


