



QLoRA 原理与实战:4-bit 量化如何让单卡微调 70B 大模型
摘要:全参微调 7B 模型需要约 66GB 显存,QLoRA 却能用 7GB 显存微调 7B、用单张 48GB 显卡微调 65B。本文拆解 QLoRA 的三大创新(NF4 量化、Double Quantization、Paged Optimizers),给出显存账本对比,并附一段可直接运行的生产级微调代码。
一、引言:一张消费级显卡的极限挑战
“我想在 24GB 的 4090 上微调 7B 模型”——这是社区里最常被问起的问题之一。先算一笔账:7B 模型以 bf16 加载需要 14GB 权重;全参微调还要存梯度(14GB)、Adam 优化器的动量与方差(28GB,fp32 双份)以及前向激活值(约 10GB)。合计约 66GB,远超 24GB,更别说 70B 模型——它连权重都装不下,需要 140GB。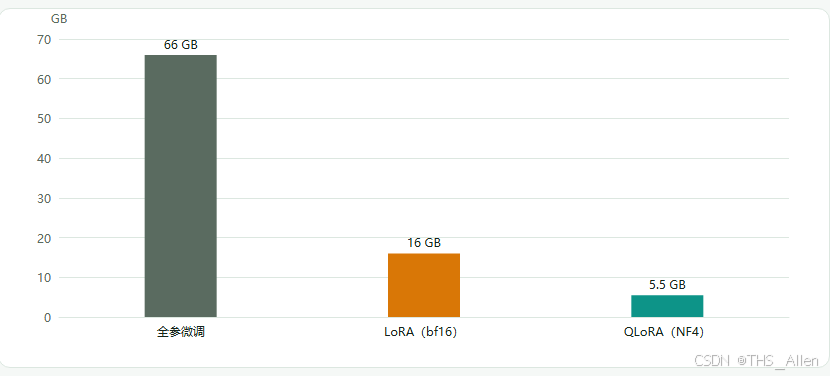
全参微调是巨头们的游戏。个人开发者与中小团队真正依赖的路径,是 LoRA → QLoRA 这条参数高效微调(PEFT)路线。前者把训练参数量砍到 0.1%~0.5%,后者再叠加 4-bit 量化把基座模型压缩 4 倍——两者相乘,显存需求从 66GB 骤降到 7GB 级别。
二、先看懂 LoRA:为什么"低秩"有效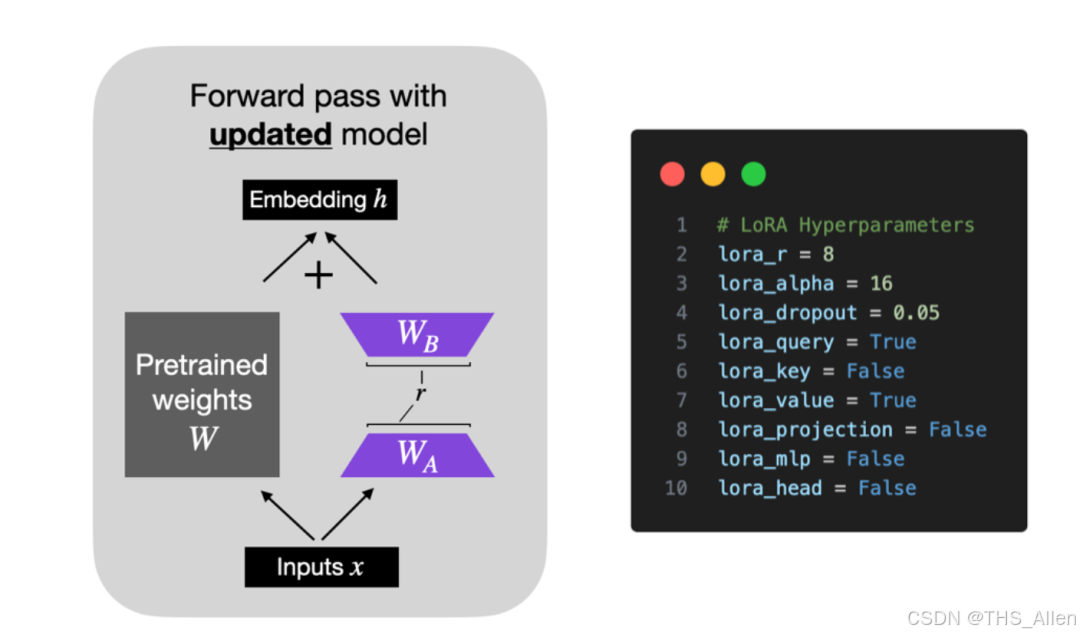
LoRA(Low-Rank Adaptation)的核心观察是:预训练权重 W(形状 d×d)在微调时不需要整体更新,其增量 ΔW 具有低秩结构。于是 LoRA 将增量分解为两个小矩阵的乘积:
W' = W + B·A
其中 B ∈ R^(d×r),A ∈ R^(r×d),r 远小于 d(常见 r = 8/16/32)
训练时冻结 W,只优化 B·A。以 7B 模型为例,若对全部线性层挂上 r=16 的 LoRA,可训练参数量仅约 3000 万,占总参数的 0.4% 左右。推理时把 B·A 合并回 W,不增加任何推理延迟。这套思路已被 PEFT 库完整工程化,是当前开源微调的事实标准。
三、QLoRA 的三大创新
QLoRA(Quantized LoRA)论文发表于 2023 年,核心命题只有一句:把基座模型量化到 4-bit 并冻结,让梯度穿过量化权重反传到 LoRA 适配器。论文用单张 48GB 显卡微调了 65B 模型,且效果追平 16-bit 微调。它由三个创新叠加而成。
3.1 NF4:为权重分布定制的 4-bit 数据类型
普通 INT4/FP4 假设数值均匀分布,但大模型权重近似正态分布——绝大多数权重落在均值附近,尾部少数权重绝对值很大。NF4(NormalFloat4)基于分位数设计:先估计权重的分位点,再把 4-bit 码本按分位点排布,让量化误差与分布对齐。直观理解:均匀量化像是用一把"等间距的尺子"去量正态分布,中间区域浪费了精度、尾部区域又不够用;NF4 则像"等概率的尺子",每一档都覆盖相同比例的权重,中间细、尾部粗,误差自然更小。相比 FP4,NF4 在 4-bit 下的精度损失显著更小,这是 QLoRA 效果追平 16-bit 微调的第一块基石。
3.2 Double Quantization:连量化常数也要省
量化本身要付出"管理费用":NF4 按每 64 个权重共享一个 fp32 缩放常数的方式分块量化,平均每个参数占用 4 + 32/64 = 4.5 bit。这 0.5 bit 的管理开销看着不大,70B 模型就是约 4.4GB。
Double Quantization(双重量化)的思路很直接:把这些 fp32 缩放常数再量化成 fp8(每 256 个常数一组,再配一个第二级 fp32 常数)。于是每个参数的平均占用从 4.5 bit 降到约 4.125 bit,仅此一项就省下约 0.37~0.4 bit/参数,65B 模型合计约 3GB 显存。
3.3 Paged Optimizers:优化器状态的分页管理
微调显存的大头之一,是 Adam 优化器保存的 fp32 动量与方差。QLoRA 借用了与 vLLM 同源的"操作系统分页"思想:当 GPU 显存不足时,把优化器状态页(page)换出到 CPU RAM,需要更新时再按页换回,避免整块搬移导致的碎片与尖峰。工程上表现为 bitsandbytes 的 paged_adamw_8bit 优化器——一行参数,显存压力大减。
四、显存账本:QLoRA 为什么能省这么多
把三大创新组合起来,7B 模型三种微调方式的显存账本对比如下:
| 显存组件 | 全参微调 | LoRA(bf16) | QLoRA(NF4) |
|---|---|---|---|
| 模型权重 | 14GB | 14GB | 约 3.5GB |
| 梯度 | 14GB | 约 0.1GB(仅适配器) | 约 0.1GB |
| Adam 优化器状态 | 28GB | 约 0.2GB | 约 0.2GB |
| 激活与临时量 | 约 10GB | 约 1.5GB | 约 1.5GB |
| 合计 | 约 66GB | 约 16GB | 约 5.5GB |
账本背后的逻辑值得多说一句:全参微调里权重、梯度、优化器状态三者等量齐观,各占约 14/14/28GB;LoRA 把后两者从 14GB 级压到 0.1GB 级;QLoRA 再把权重从 14GB 压到 3.5GB。量化的不是"训练过程",而是被冻结的基座——梯度依然以高精度(bf16)在适配器上流动,这正是 QLoRA 精度不塌的原因。
把账本放大到 65B 再验算一遍:权重 NF4 + 双重量化后约 65B × 4.125bit / 8 ≈ 33.5GB,加上适配器、优化器与激活,总占用约 38~39GB,恰好落进单张 48GB 的专业卡——论文里"单卡 48GB 微调 65B"就是这么算出来的。而同样的 65B 若走全参微调,权重、梯度、优化器状态加起来要 600GB 以上,至少需要 8 张 H100 组成的集群。
五、实战:用 PEFT 微调一个 7B 模型
下面是一段基于 transformers + bitsandbytes + peft 的生产级 QLoRA 微调代码(以 Qwen2.5-7B-Instruct 为例,约 7GB 显存可跑):
import torch
from transformers import (
    AutoModelForCausalLM, AutoTokenizer,
    BitsAndBytesConfig, Trainer, TrainingArguments
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

# 1) 4-bit 加载:NF4 + Double Quantization
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",          # NormalFloat4
    bnb_4bit_use_double_quant=True,     # 双重量化,省 ~0.4 bit/参数
    bnb_4bit_compute_dtype=torch.bfloat16,  # 计算仍走高精度
)

model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen2.5-7B-Instruct",
    quantization_config=bnb_config,
    device_map="auto",
)
model = prepare_model_for_kbit_training(model)   # 梯度检查点等预处理

# 2) 挂载 LoRA 适配器
lora_config = LoraConfig(
    r=16, lora_alpha=32, lora_dropout=0.05,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                    "gate_proj", "up_proj", "down_proj"],
    bias="none", task_type="CAUSAL_LM",
)
model = get_peft_model(model, lora_config)

# 3) 训练:Paged AdamW 把优化器状态页化到 CPU
trainer = Trainer(
    model=model,
    args=TrainingArguments(
        output_dir="./qlora-out",
        per_device_train_batch_size=1,
        gradient_accumulation_steps=8,
        learning_rate=2e-4,
        optim="paged_adamw_8bit",       # Paged Optimizers
        logging_steps=10,
        num_train_epochs=3,
    ),
    train_dataset=dataset,
)
trainer.train()
训练结束后,model.save_pretrained() 只保存约 60MB 的适配器权重;合并回基座时用 merge_and_unload() 得到完整 bf16 模型,或直接导出 GGUF 走 llama.cpp 部署。
数据侧同样有讲究。SFT 数据建议整理为 instruction / input / output 的结构化格式(ChatML 模板尤佳),并用 tokenizer.apply_chat_template 统一模板;单条样本过长会导致批内 padding 浪费显存,实践中常把样本截断到 1024~2048 token。数据量方面,千条量级就能看到领域风格迁移,万条量级通常已接近该任务的可学习上限——盲目堆数据不如先做一轮去重与质量筛选,脏数据对微调的伤害远大于数据量不足。
六、效果与调优:QLoRA 到底损失了什么
很多人担心 4-bit 会"教坏"模型。论文的实验结论是:NF4 + Double Quantization 的 QLoRA,在多项基准上与 16-bit LoRA 持平,与全参微调差距在 1 个百分点以内。原因前面说过——被量化的是冻结的基座权重,梯度路径始终是 bf16。真正容易踩的坑反而是训练侧:
- r 的选择:r=8 适合数据量少、任务简单的场景;r=16/32 适合代码、对话等复杂任务。r 翻倍,适配器参数量与显存也近似翻倍。
- target_modules 要覆盖 MLP:很多教程只挂注意力四件套(q/k/v/o),但 LoRA 论文与社区经验表明,gate/up/down 投影同样承载大量知识,建议全部覆盖。
- 学习率:LoRA 训练通常用 1e-4~3e-4,比全参微调高一个数量级;
lora_alpha = 2 × r是社区常用的稳妥起步值。 - 与 FlashAttention 叠加:显存进一步下降;追求极致时可用 Unsloth 等优化框架,官方在 Llama 3.1 8B 上实测训练提速约 2 倍、显存降低约 70%。
- 警惕灾难性遗忘:LoRA 权重初始化时 B 为全零矩阵,训练初期模型输出应与基座完全一致;若发现刚训练几步输出就剧烈漂移,优先检查学习率是否过大、
lora_dropout是否被设成 0。
七、什么时候不该用 QLoRA
QLoRA 并非银弹。三类场景建议直接上 LoRA 甚至全参:一是数据量很大(数十万条以上)且任务复杂,4-bit 基座的表达上限可能成为瓶颈;二是显存充足(单卡 80GB+)且追求极致效果,bf16 LoRA 的精度天花板更高、每步训练也更快(省去反量化开销);三是基座本身很小(1B 以下),量化省下的显存意义有限。一句话总结选型:显存紧张选 QLoRA,效果优先选 LoRA,钱多数据多选全参。
八、结语
QLoRA 的价值不在于"省显存"这三个字,而在于它把大模型微调从算力竞赛变成了人人可做的工程实践:NF4 用分位数设计保住精度,双重量化连管理开销都抠干净,Paged Optimizers 把最后一块显存压榨出来。配合 LoRA 的低秩假设,单张消费级显卡微调 7B、单张专业卡微调 70B,已经是 2026 年的日常。下一次有人问"24GB 显卡能微调大模型吗",你可以把本文的代码直接丢给他。
参考链接
- QLoRA 论文:Efficient Finetuning of Quantized LLMs(arxiv.org/abs/2305.14314)
- PyTorch torchtune 文档:使用 QLoRA 微调 Llama2(pytorch.ac.cn)
- HuggingFace PEFT 库:QLoRA 文档与代码(github.com/huggingface/peft)
- Unsloth 官方文档:模型微调与显存优化(unsloth.ai)


 扫一扫


 197

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


