


一周四发之后:模型能力趋同的 7 分差距,与黄仁勋那句"AGI 已到"
2026 年 9 月的第一周,可能是大模型行业历史上发布密度最高的一周。
9 月 1 日到 3 日,Anthropic、Meta、Google、OpenAI 四家在三天内接连交出旗舰:Claude Fable 5.1、Muse Spark 1.3、Gemini 3.8 Flash、GPT-6 Astra。同周,阿里刷新了 Qwen3.8-Max,阿布扎比 MBZUAI 开源了 K2 Horizon 系列,英伟达则以 129 亿美元把 Hugging Face 收入囊中。
热闹背后,一个此前被发布会声量盖住的问题浮出水面:当四款旗舰的智能指数差距缩小到个位数、价格却差了 100 倍,行业竞争的主战场是不是已经换了?
而 9 月 7 日,英伟达 CEO 黄仁勋在社交媒体上的一句话,又把讨论推向了顶点——"AGI 已到。"
一、先看事实:三天四发的完整时间线
按发布时间梳理,这一周的节奏是这样的:
- 9 月 1 日(周二):Anthropic 发布 Claude Fable 5.1 与 Claude Mythos 5.1。两者共享同一基础模型,区别在安全防护等级——Fable 5.1 面向所有用户,Mythos 5.1 仅通过受信访问计划提供给经过审核的机构。Anthropic 称这是"全球最先进的编程和知识工作模型"。
- 9 月 2 日(周三):两家同时出手。Meta 发布 Muse Spark 1.3,首席 AI 官称这是"迄今在模型性能上最大的一次跃升",编程能力超过 GPT-5.6 Sol、与 Fable 5.1 持平;Google 上线 Gemini 3.8 Flash 和 Gemini 3.8 Flash Cyber——这是六周内的第三款 Flash,距离上一代 3.7 Flash 只有三周。
- 9 月 3 日(周四):OpenAI 发布 GPT-6 Astra(及 Astra Pro),总裁布罗克曼以"欢迎进入 AGI 时代"收尾。
- 同周:阿里 Qwen3.8-Max 刷新;英伟达宣布完成对 Hugging Face 的收购。
Altman 事后对节奏加速的解释很直白:"我们都在加快迭代节奏。"他甚至把部分原因归给了一个谁都没想到的因素——"大家都结束暑假回来了。"
二、数字真相:智能只差 7 分,价格差 100 倍
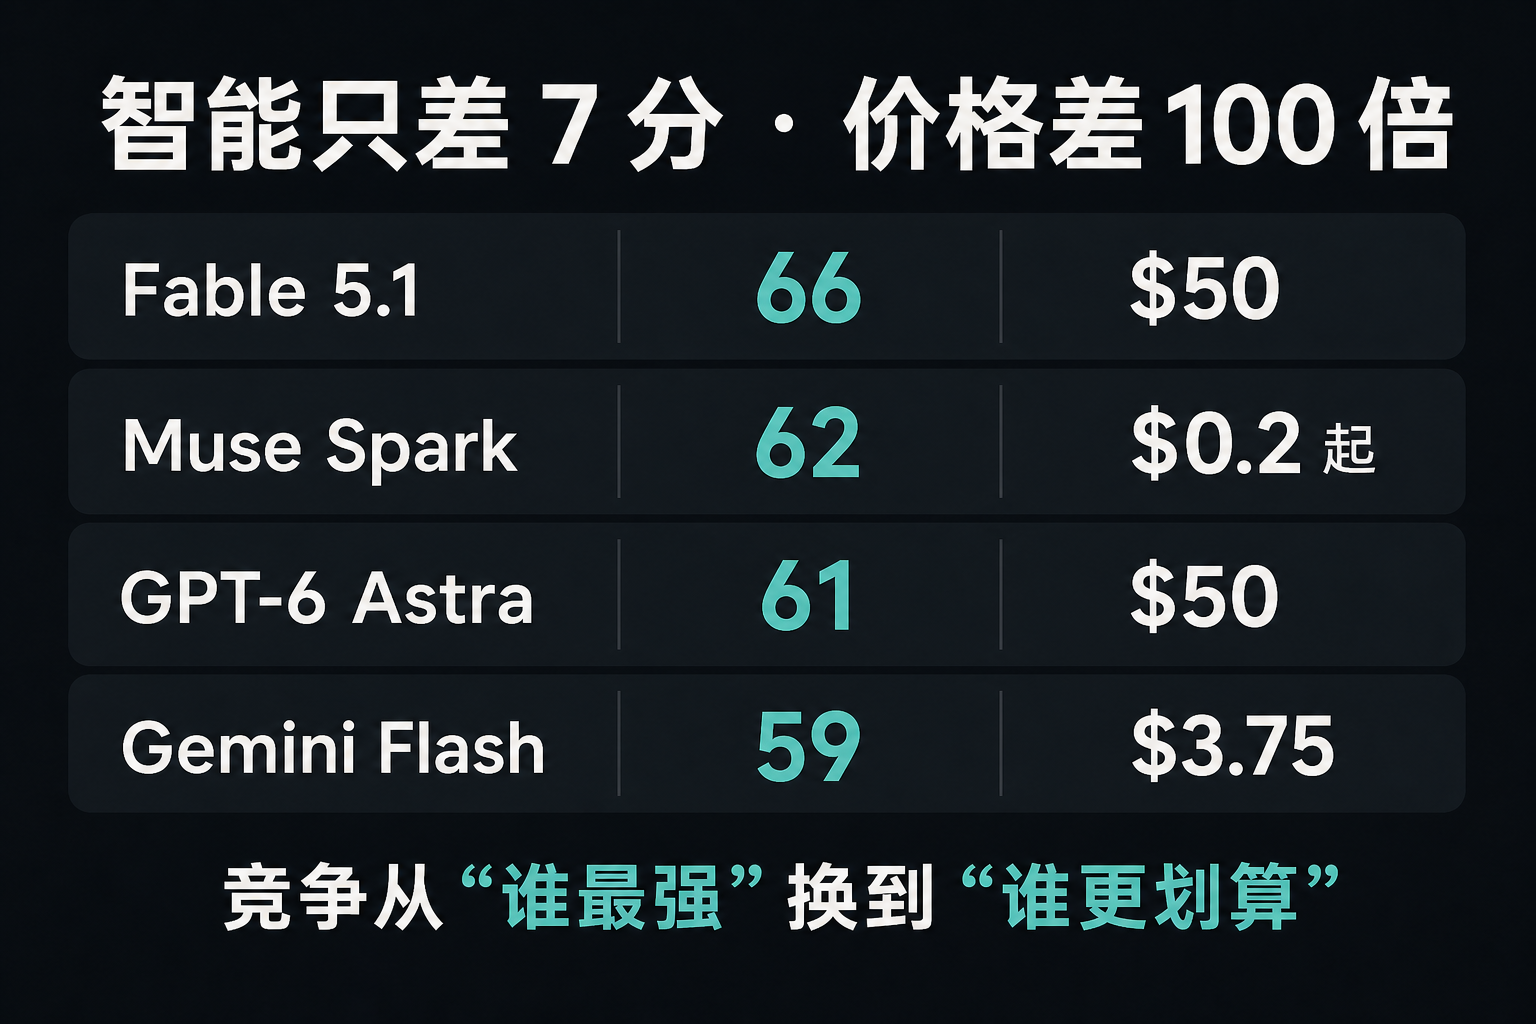
把四款旗舰放进同一张表,最能说明问题的不是各自的宣传口径,而是横向对比:
| 模型 | 发布方 | Artificial Analysis 智能指数 | 输出价格(/百万 token) |
|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 66 | $50 |
| Muse Spark 1.3 | Meta | 62 | 最低档 $0.2(可用数据训练) |
| GPT-6 Astra | OpenAI | 61 | $50 |
| Gemini 3.8 Flash | 59 | $3.75 |
按 Artificial Analysis 的智能指数,四款模型的差距只有 7 分——最高与最低几乎在同一个能力档位内。但每百万 token 的输出价格,从 Gemini 3.8 Flash 的 3.75 美元到 Fable 5.1 / Astra 的 50 美元,相差 13 倍;如果算上 Meta 允许用自有数据训练的 0.2 美元档位,价差被拉到 100 倍以上。
换句话说:过去一年,旗舰之间的能力差距是"代际"的;现在,差距是"价位"的。 你在意的不是选谁更聪明,而是选谁更划算、更符合你的任务类型。
独立评测也在印证"能力趋同"的判断。在 DeepSWE 编程基准上,Gemini 3.8 Flash 拿到 73.7%,几乎追平 Claude Opus 5 的 74.0%——而它的价格只有后者的零头。Muse Spark 1.3 在部分编程测试中甚至冲到 75.4%。综合最强的是 Fable 5.1,但它也是"完成任务最贵"的模型:独立成本测算里,它平均每个任务约 3.69 美元,比上一代 Fable 的 3.14 美元更贵。
Astra 则靠"偏科"取胜:它不追求全面第一,但在计算机操作、网络安全、抽象推理上拉开身位——ExploitBench 满分、能在加固浏览器里找到代码执行路径,这是它首个达到"关键"级网络安全风险阈值的底气,也是它敢定价 50 美元的原因。
这一周最重要的产业信号:模型的能力天花板在趋同,竞争焦点从"谁最强"转向"谁的经济学更匹配我的任务"。 对开发者来说,"最优模型"的单一答案正在消失,取而代之的是按任务选模型的常态。


 扫一扫


 2541

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


