


课程:B站大学
记录学习极客时间团队MySQL45讲,进阶数据分析和数据处理
MySQL主库和备库
MySQL为什么临时表可以重名?
一、问题背景
上一讲在优化 join 查询时用到了临时表:
create temporary table temp_t like t1;
alter table temp_t add index(b);
insert into temp_t select * from t2 where b>=1 and b<=2000;
select * from t1 join temp_t on (t1.b=temp_t.b);
一个自然的问题是:为什么要用临时表?直接用普通表不行吗?
先厘清一个常见误解——临时表 ≠ 内存表,两者完全不同:
| 对比项 | 内存表 | 临时表 |
|---|---|---|
| 引擎 | 固定使用 Memory 引擎 | 可使用任意引擎(InnoDB/MyISAM/Memory) |
| 数据存放 | 全在内存 | InnoDB/MyISAM 写磁盘,也可选 Memory |
| 重启表现 | 数据清空、表结构保留 | session 结束自动删除 |
二、临时表的特性
通过下面这个操作序列理解临时表的特性:
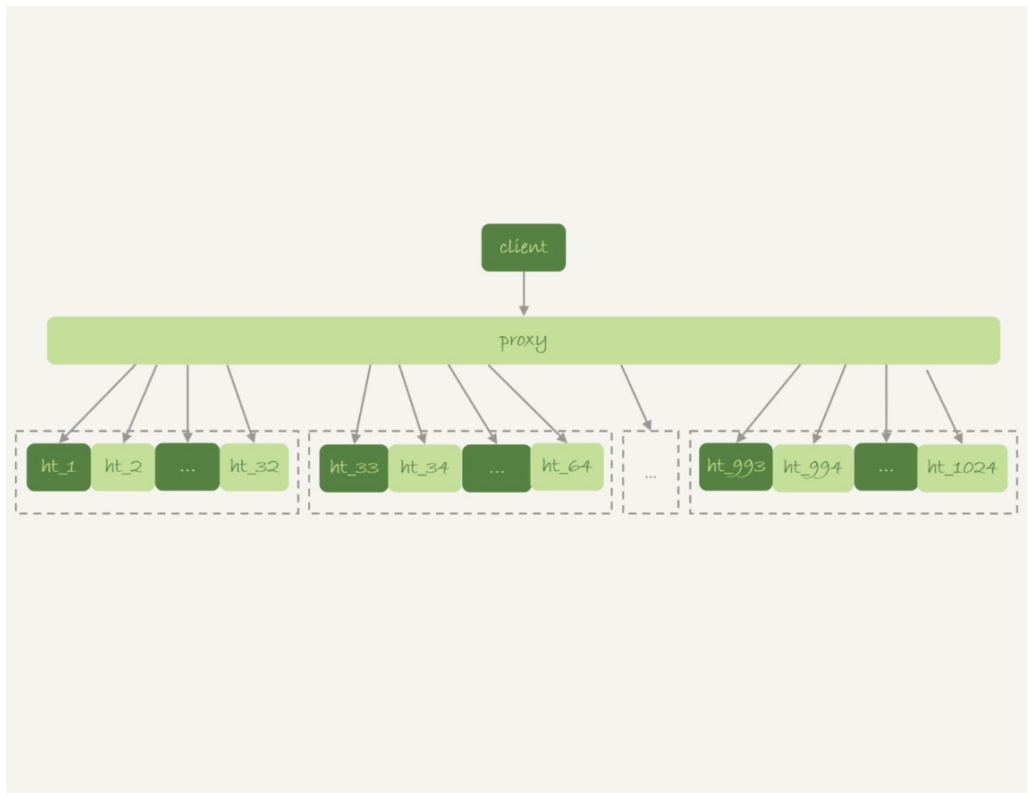
图1:临时表特性示例
临时表的核心特点:
- 建表语法:
create temporary table ...。 - session 私有:只能被创建它的 session 访问,对其他线程不可见(session B 看不到 session A 的临时表)。
- 可与普通表同名。
- 同名优先:session 内同时存在同名的临时表和普通表时,
show create及增删改查都优先操作临时表。 show tables不显示临时表。
由于临时表只在创建它的 session 内可见,session 结束时会自动删除,因此特别适合 join 优化这类中间过程:
- 不同 session 的临时表可以重名,多线程并发执行 join 优化不用担心表名冲突;
- 不需要手动清理中间数据,即使客户端异常断开或数据库重启,也能自动回收。
三、临时表的应用:分库分表跨库查询
临时表常用于复杂查询的中间结果汇总,典型场景是分库分表系统的跨库查询。
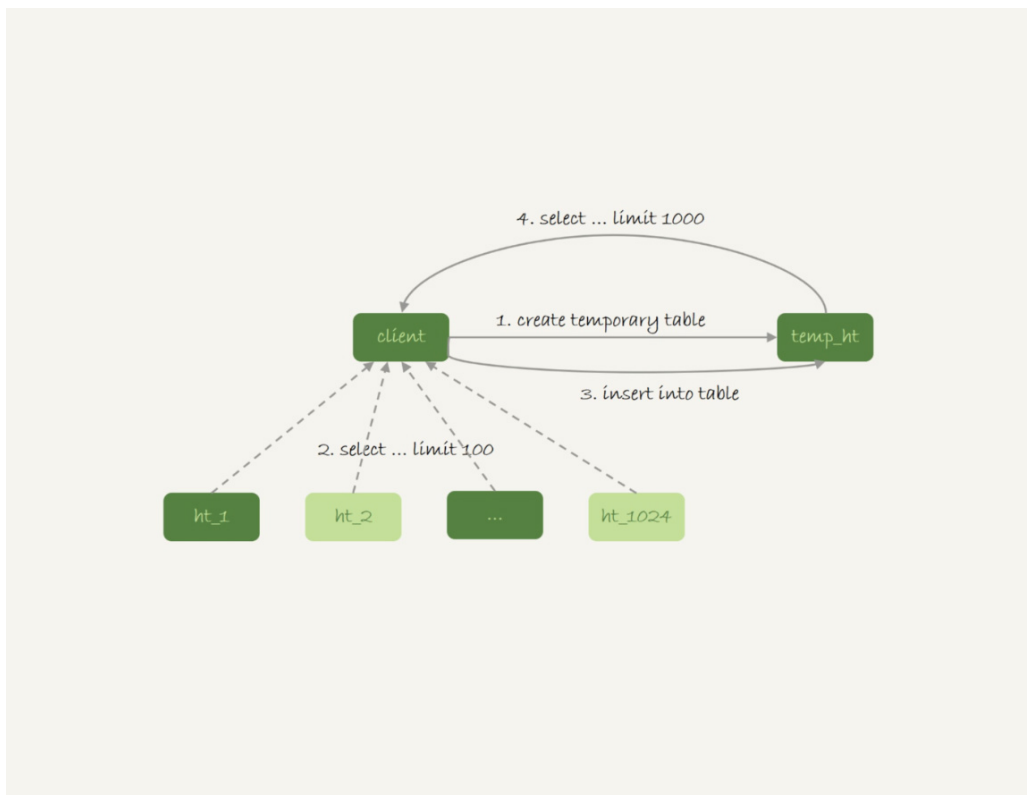
图2:分库分表结构示意
将一个逻辑大表 ht 按字段 f 拆成 1024 个分表、分布到 32 个数据库实例。分区键的选择以"减少跨库跨表查询"为依据。
- 带分区键的查询(如
where f=N):可直接路由到单个分表,是理想形态。 - 不带分区键的查询(如
where k>=M order by t_modified desc limit 100):需要访问所有分库,再做聚合/排序。
后者的两种常用思路:
| 思路 | 做法 | 优缺点 |
|---|---|---|
| proxy 层内存计算 | 在 proxy 进程代码中汇总排序 | 速度快,但开发量大、proxy 易成内存/CPU瓶颈 |
| 汇总到临时表 | 各分库结果插入汇总库的临时表,再在汇总实例上做逻辑操作 | 实现简单,适合复杂聚合 |
临时表在分库分表中的应用:将各分库结果插入汇总库(或某个分库)的临时表 temp_ht,再在临时表上完成 order by / limit 等操作。由于临时表自动回收,无需担心中间数据残留。
四、为什么临时表可以重名?
4.1 磁盘文件名不同
执行 create temporary table temp_t(id int primary key) engine=innodb; 时:
- 表结构:在临时文件目录(
@@tmpdir)生成.frm文件,前缀为#sql{进程id}_{线程id}_序列号。 - 表数据:
- 5.6 及之前:在临时目录创建同名前缀、
.ibd后缀的数据文件; - 5.7 起:引入临时表空间,不再单独创建 ibd 文件。
- 5.6 及之前:在临时目录创建同名前缀、
即使用户建的表名叫 t1,MySQL 在存储层面实际使用的是带线程 id 的唯一文件名,所以与普通表 t1 不冲突。
4.2 内存中的 table_def_key 不同
MySQL 内存中靠 table_def_key 区分不同表:
| 表类型 | table_def_key 构成 |
|---|---|
| 普通表 | 库名 + 表名 |
| 临时表 | 库名 + 表名 + server_id + thread_id |
所以两个 session 创建的同名临时表 t1,磁盘文件名和 table_def_key 都不同,可以并存。
每个线程维护自己的临时表链表:操作表时先遍历链表,命中临时表则优先操作;session 结束时自动执行 DROP TEMPORARY TABLE。
图3:临时表的表名(进程id + 线程id 保证唯一)
注:上图与图1同源,为原文示意图,CSDN 外链可直接加载。
五、临时表与主备复制
5.1 为什么临时表操作要写 binlog?
考虑主库执行序列:
create table t_normal(id int primary key, c int) engine=innodb;      -- Q1
create temporary table temp_t like t_normal;                        -- Q2
insert into temp_t values(1,1);                                     -- Q3
insert into t_normal select * from temp_t;                          -- Q4
如果不记录临时表操作,备库执行到 Q4 时会报错"表 temp_t 不存在"。
- binlog 为 statement/mixed:临时表相关语句会记录到 binlog,传到备库执行;主库 session 退出时自动删除临时表,但备库同步线程常驻,因此需要额外传
DROP TEMPORARY TABLE给备库。 - binlog 为 row:记录的是具体行数据(write_row event),临时表操作不记录到 binlog。
5.2 drop table 的 binlog 改写
drop table 可以一次删多个表,系统记录 binlog 时会改写成标准格式并标注 /* generated by server */,例如:
DROP TABLE `t_normal` /* generated by server */
原因:row 格式下备库没有临时表,把命令改写后再传备库执行,才不会让同步线程停止。
5.3 备库如何区分同名临时表
主库上不同 session 创建的多个同名临时表 t1,都会传到备库,由共用的应用日志线程顺序执行,为何不冲突?
MySQL 记录 binlog 时会带上主库执行线程的 thread_id,备库据此构造临时表的 table_def_key:
- session A 的
t1:库名 + t1 + M的server_id + session A的thread_id - session B 的
t1:库名 + t1 + M的server_id + session B的thread_id
table_def_key 不同,因此备库应用线程中也不会冲突。
六、核心总结
| 主题 | 要点 |
|---|---|
| 临时表 vs 内存表 | 临时表可用任意引擎、可落盘;内存表固定 Memory、重启丢数据 |
| 五大特性 | session 私有、可与普通表同名、同名优先、show tables 不显示、session 结束自动删除 |
| 典型应用 | 分库分表跨库查询的中间结果汇总 |
| 可重名原理 | 磁盘文件名带线程id;内存 table_def_key 含 server_id + thread_id |
| 主备复制 | statement/mixed 记录临时表操作;row 格式不记录;备库靠 thread_id 区分同名表 |
上一讲(第35讲 join 语句优化)的思考题:对于三表 join,改写成 straight_join 如何指定连接顺序、如何建索引。
核心原则:尽量使用 BKA 算法,每次参与 join 的驱动表数据集越小越好。从三个过滤条件中选出过滤后数据最少的表作为第一个驱动表:
- 若驱动表是
t1:连接顺序t1->t2->t3,在t2.a、t3.b建索引; - 若驱动表是
t3:连接顺序t3->t2->t1,在t2.b、t1.a建索引; - 同时在第一个驱动表的过滤字段(如
c)上建索引。
MySQL什么时候会使用内部临时表?
一、问题背景
在第16讲和第34讲中,我们分别介绍了 sort buffer、内存临时表和 join buffer。这三个数据结构都是用来存放语句执行过程中的中间数据,以辅助 SQL 执行的:
- 排序时用
sort buffer - join 语句时用
join buffer - 需要二维表特性(唯一约束、多字段累计统计)时用内部临时表
那么,MySQL 什么时候会使用内部临时表?本文通过 union 和 group by 两个例子来分析,并给出优化思路。
二、union 执行流程
1. 准备数据
create table t1(id int primary key, a int, b int, index(a));

delimiter ;;
create procedure idata()
begin
  declare i int;
  set i = 1;
  while(i <= 1000) do
    insert into t1 values(i, i, i);
    set i = i + 1;
  end while;
end;;
delimiter ;
call idata();
2. 示例语句
(select 1000 as f) union (select id from t1 order by id desc limit 2);
语义:取两个子查询结果的并集,重复行只保留一行(去重)。
explain 结果如下,Extra 字段显示 Using temporary,说明对子查询结果集做 union 时使用了临时表。
3. 执行流程
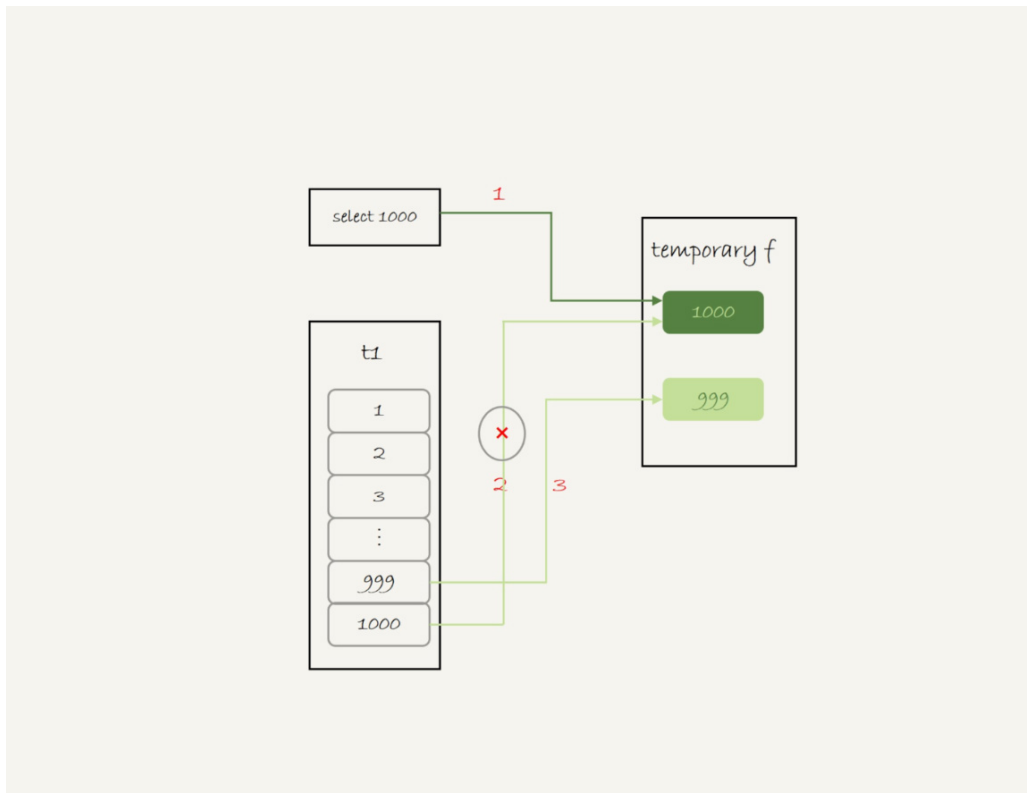
- 创建内存临时表,只有一个整型字段
f,且f是主键(唯一约束); - 执行第一个子查询,得到
1000,存入临时表; - 执行第二个子查询:
- 取第一行
id=1000,试图插入,因违反唯一约束插入失败; - 取第二行
id=999,插入成功;
- 取第一行
- 从临时表按行取出数据返回,并删除临时表。结果为
1000和999。
流程图如下。内存临时表既起到暂存数据的作用,又利用主键唯一性约束实现了 union 的去重语义。
4. union vs union all
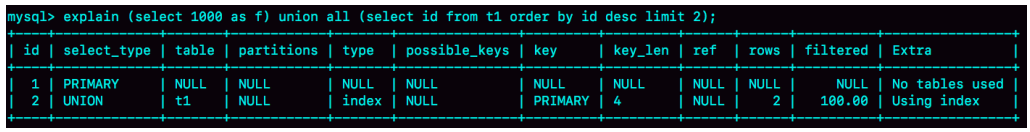
如果把 union 改成 union all,就没有"去重"语义,执行时直接把各子查询结果作为结果集一部分发给客户端,不再需要临时表。
Extra 字段只显示 Using index(覆盖索引),没有临时表。
三、group by 执行流程
1. 示例语句
select id%10 as m, count(*) as c from t1 group by m;
逻辑:把 t1 数据按 id%10 分组统计,按 m 排序后输出。
Extra 字段有三个信息:
Using index:使用覆盖索引(索引 a),无需回表;Using temporary:使用了临时表;Using filesort:需要排序。

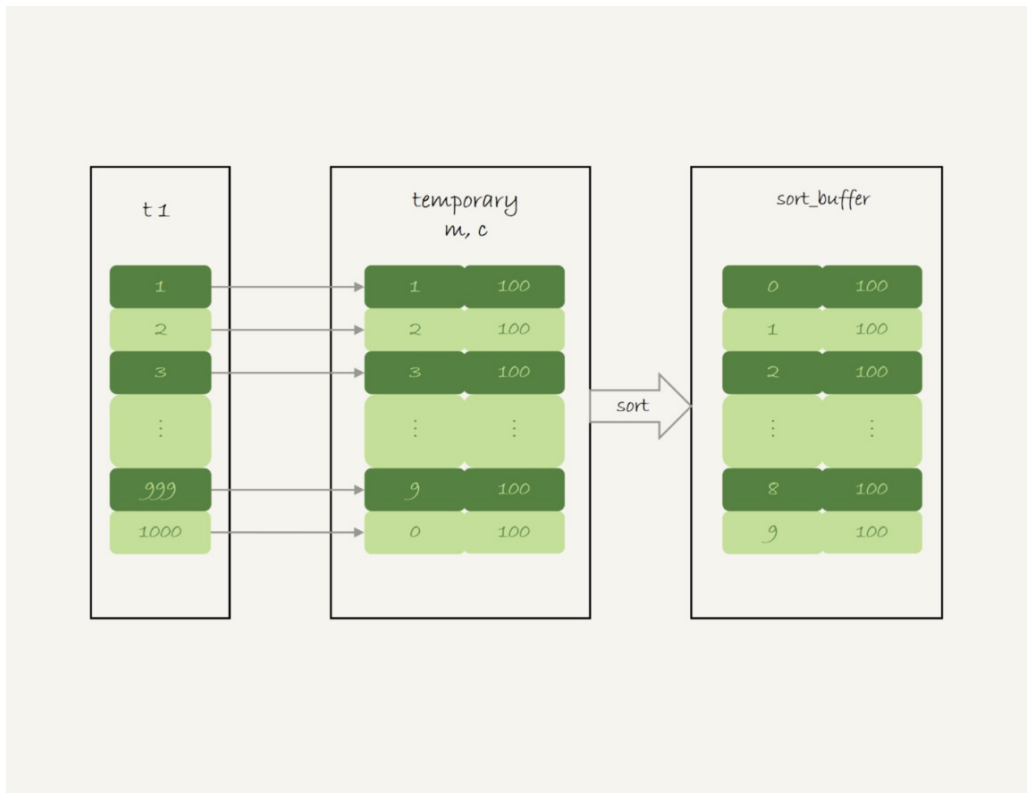
2. 执行流程
- 创建内存临时表,两个字段
m(主键)和c; - 扫描表
t1的索引 a,依次取id,计算id%10记为x:- 临时表中没有主键为
x的行 → 插入(x, 1); - 已有
x→ 将该行c值加 1;
- 临时表中没有主键为
- 遍历完成后,按字段
m排序,返回结果集。
执行图如下:
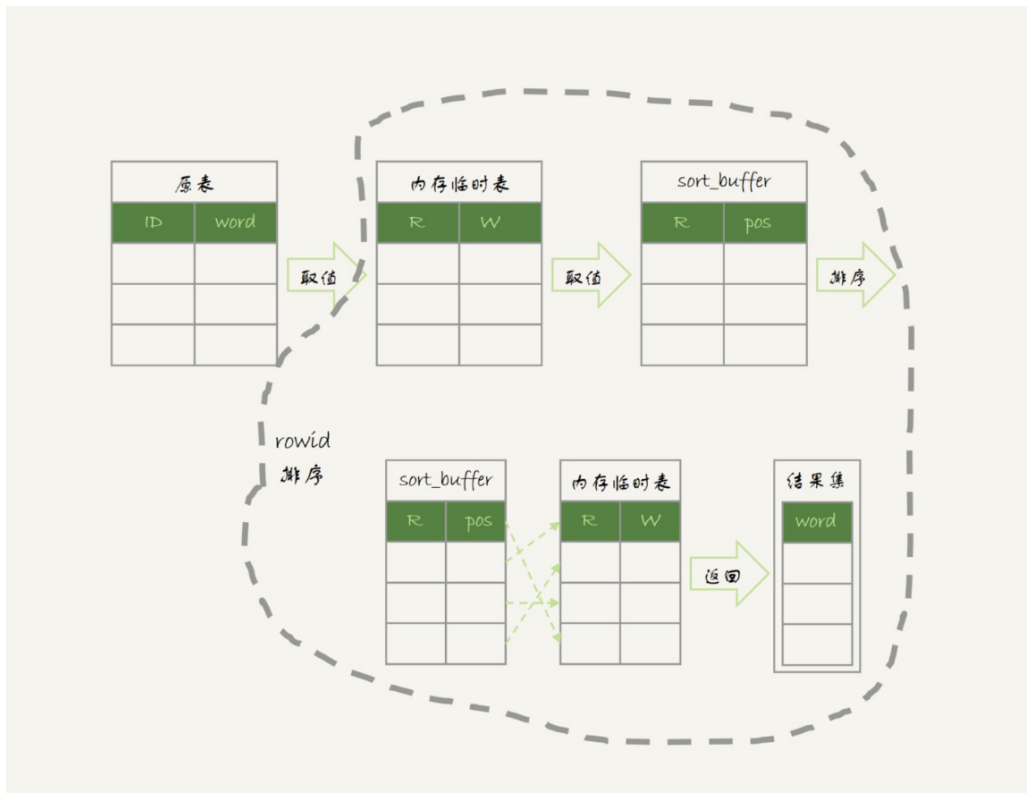
其中对内存临时表的排序过程,引用第17讲的图回顾:
3. 去掉排序:order by null
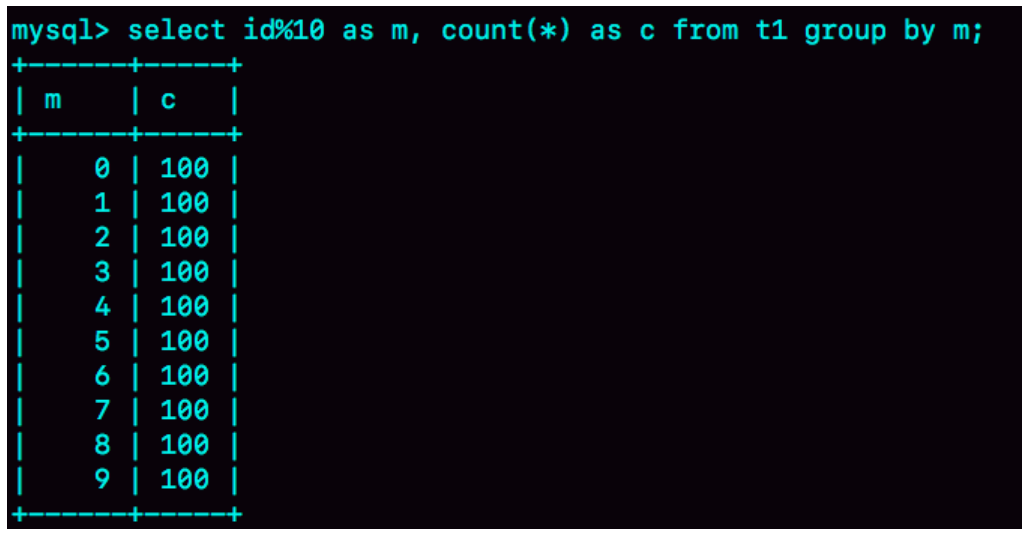
如果不需要排序结果,可在末尾加 order by null:
select id%10 as m, count(*) as c from t1 group by m order by null;
这样跳过最后排序阶段,直接从临时表取数据返回。由于 id 从 1 开始,m=0 最后才插入,所以结果集最后一行是 0。
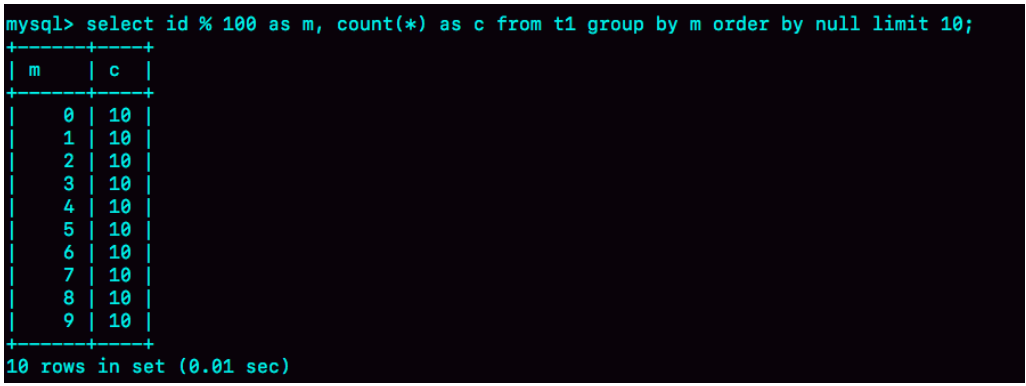
4. 内存临时表 → 磁盘临时表
内存临时表大小受 tmp_table_size 控制(默认 16M)。当数据量超出限制时,会转成磁盘临时表(默认引擎 InnoDB)。
set tmp_table_size = 1024;
select id%100 as m, count(*) as c from t1 group by m order by null limit 10;
将内存上限设为 1024 字节、id%100 产生 100 行数据,内存临时表放不下,转为磁盘临时表。由于 InnoDB 是索引组织表、按主键顺序存储,结果第一行就是 0(与内存临时表顺序不同)。
四、group by 优化方法
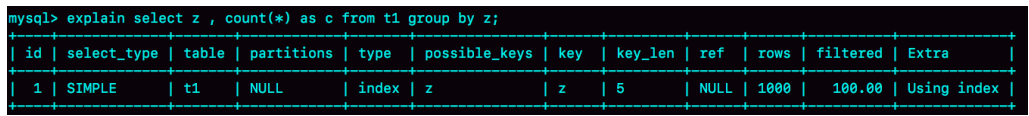
优化一:利用索引(让数据有序)
group by 需要临时表,根本原因是 id%100 的结果无序。如果能保证扫描时数据有序,就可以省掉临时表和排序。
alter table t1 add column z int generated always as (id % 100), add index(z);
select z, count(*) as c from t1 group by z;
优化后 Extra 不再有 Using temporary 和 Using filesort。
优化二:SQL_BIG_RESULT(直接排序)
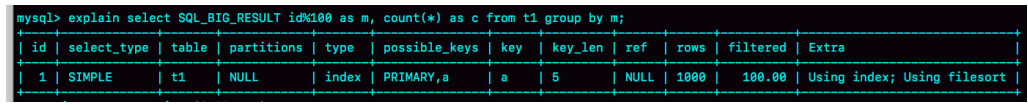
如果不适于建索引、且数据量很大,可用 SQL_BIG_RESULT 提示优化器:直接用磁盘临时表 / 排序算法,避免"先内存、再转磁盘"的浪费。
select SQL_BIG_RESULT id%100 as m, count(*) as c from t1 group by m;
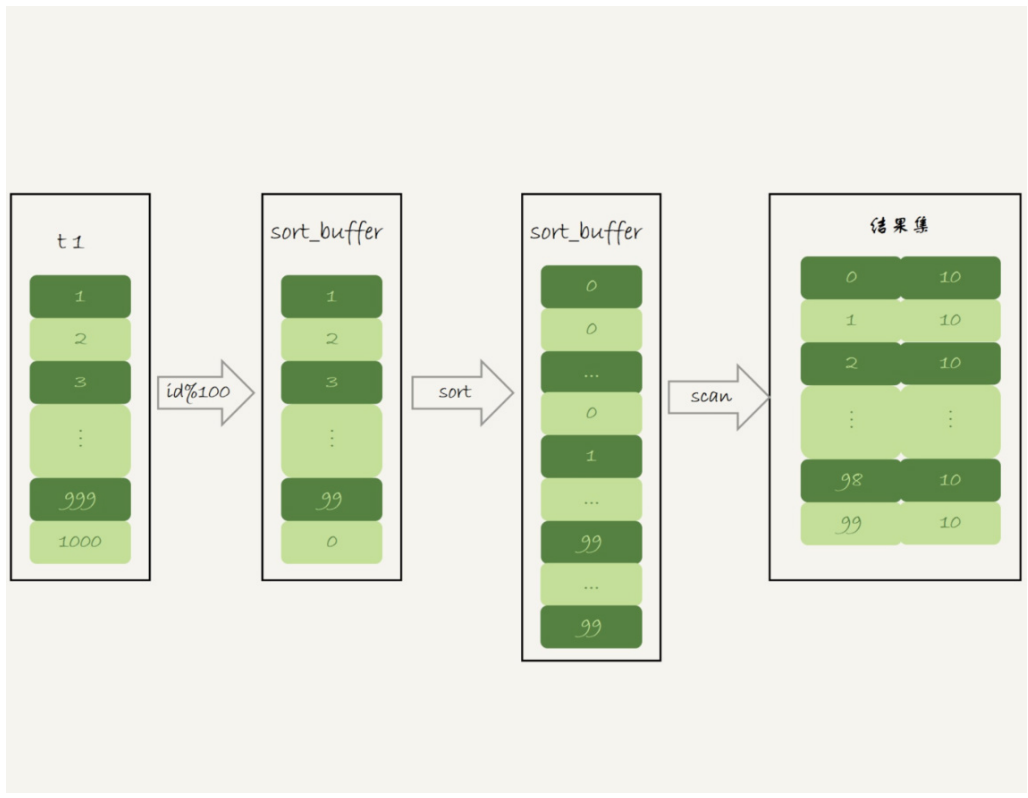
执行流程:
- 初始化
sort_buffer,放入整型字段m; - 扫描索引 a,把
id%100存入sort_buffer; - 对
sort_buffer排序(内存不够则用磁盘临时文件辅助); - 排序完成后得到有序数组,据此统计不同值及出现次数。
执行流程图与 explain 结果如下,Extra 显示没有用临时表,直接用了排序算法。
说明:
SQL_BIG_RESULT最终语义是"直接用排序算法",因为优化器认为用sort_buffer直接排序性能更好,就不再使用内存/磁盘临时表。
五、什么时候会使用内部临时表?
- 如果语句执行可以一边读数据一边直接得到结果,不需要额外内存;否则需要额外内存保存中间结果;
join_buffer是无序数组,sort_buffer是有序数组,临时表是二维表结构;- 如果执行逻辑需要用到二维表特性,就会优先考虑临时表——例如
union需要唯一索引约束,group by还需要另一个字段存累计计数。
六、使用指导原则
- 对
group by结果没有排序要求时,语句末尾加order by null; - 尽量让 group by 用上索引,确认方法:
explain结果中没有Using temporary和Using filesort; - 数据量不大时,尽量只用内存临时表,可适当调大
tmp_table_size避免转磁盘; - 数据量太大时,用
SQL_BIG_RESULT提示优化器直接用排序算法得到结果。
七、核心总结
| 场景 | 是否用临时表 | 关键机制 |
|---|---|---|
| union(去重) | 是(内存) | 主键唯一约束去重 |
| union all | 否 | 直接拼接结果 |
| group by(无索引) | 是(内存/磁盘) | 二维表累计统计 + 排序 |
| group by + order by null | 是 | 跳过排序阶段 |
| group by + 索引 | 否 | 数据有序,无需临时表 |
| group by + SQL_BIG_RESULT | 否(用排序) | sort_buffer 直接排序 |


 扫一扫


 675

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


