OpenAI官宣新一代视频生成模型Sora 2!附完整发布实录,现实与虚幻共存。

OpenAI Sora视频生成机制:时空补丁 AI如何将静态图像转化为动态、逼真的视频?OpenAI 的 Sora 通过时空补丁(spacetime patches)的创新使用给出了答案。 阅读详情

 Datawhale分享 

最新:Sora 2,编译:新智元

实属没想到,在这国庆第一天,没有预告,OpenAI进行了一场突袭直播——

正式官宣新一代AI视频模型:Sora 2。

下面是完整的中英字幕发布直播:

新一代Sora在物理准确性、逼真度上,一举刷新SOTA,并在一致性、可控性上实现了巨大飞跃。

值得一提的是,Sora 2首次实现「音画同步」。

Sora 2出世,视频GPT-3.5时刻来临

说到AI视频生成,过去总有种「梦里啥都有」的感觉——篮球瞬移进筐、人物刚刚还在左边,下一帧就冒出来个分身。

技术进步快没错,但「假」也总是藏不住。

直到Sora 2推出,第一次让人觉得,AI终于开始尊重物理和常识,生成世界不再是「随便编编」,而是真能照进现实。
2024年2月,Sora首次放出,堪称视频界的「GPT-1时刻」!这是首次,让所有人看到视频生成真的可用了。

过去半年,OpenAI团队死磕「如何让模型真正学会模拟实际运行」这个关键,如今终于取得重大突破。

基于海量视频数据的预训练和后训练技术,Sora 2的高光时刻降临。

正如官博所言,Sora 2开启了「视频领域的GPT-3.5 时刻」!
接下来,具体看看Sora 2历经一年多,究竟取得了哪些重大突破?
AI穿帮,终于被揪出来了

最让人感慨的,是Sora 2在物理细节上的进化。

别小看这个点,比如你让它生成人投篮,旧模型为了「满足」指令,球会强行飞进篮筐(哪怕角度完全不合理);

现在的Sora 2,球打板弹开、甚至投丢都成常态,动作有惯性、受力和材质都说得通。

头顶一只猫咪并完成三周半跳?奥运冠军能否做到尚未可知,但Sora认为完全不在话下。
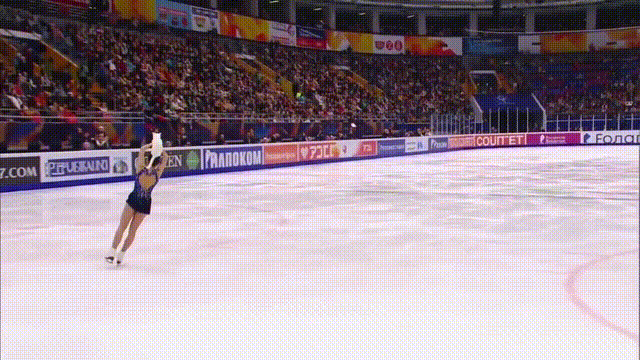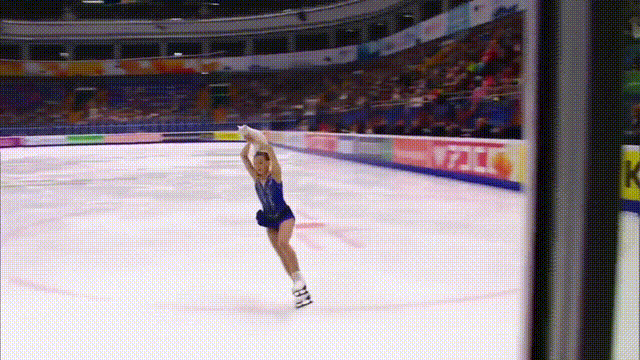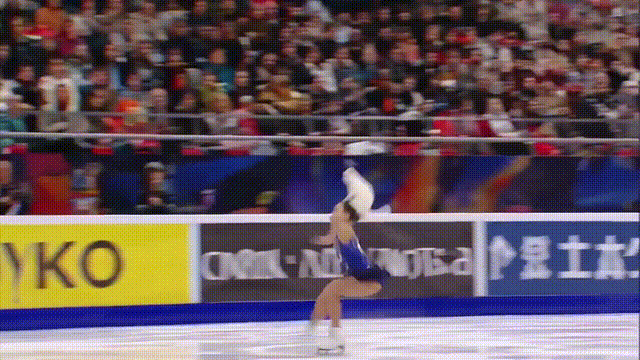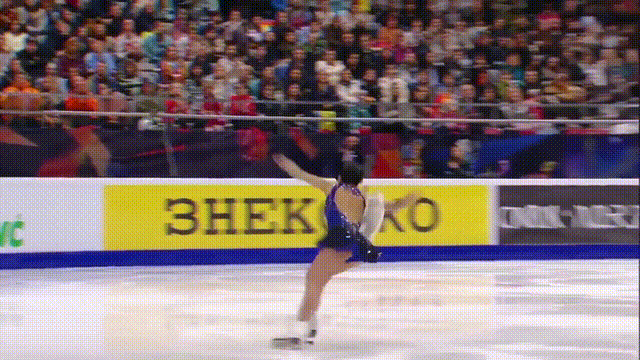
Prompt: figure skater performs a triple axle with a cat on her head

被业界封为「AI体操界的图灵测试」,Sora 2一次性就通过了。
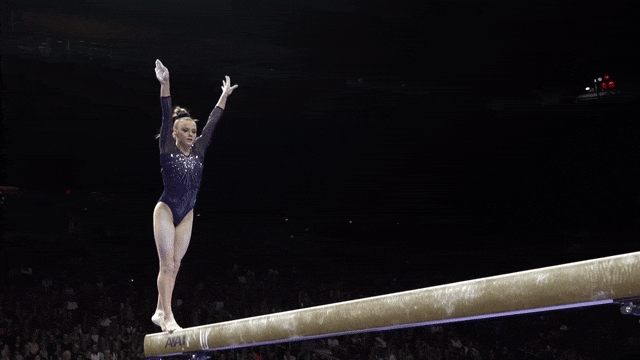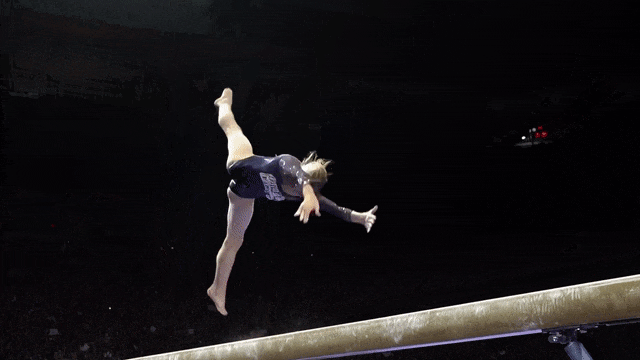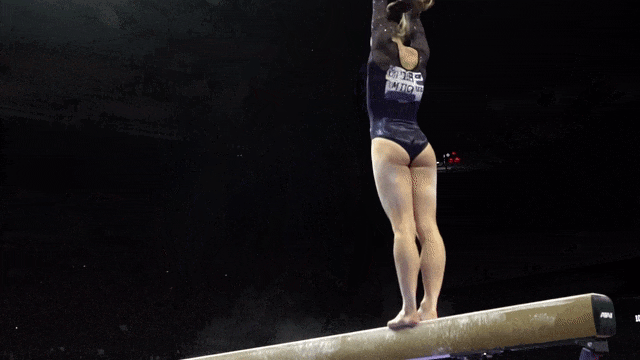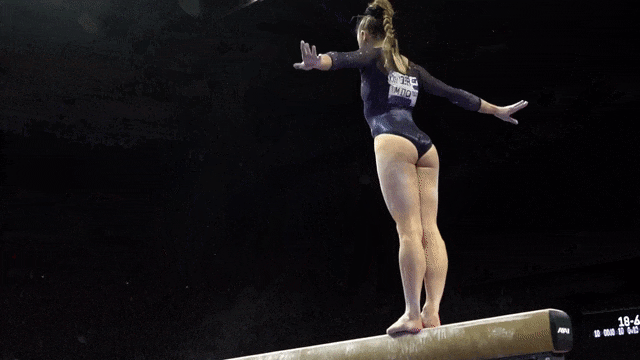
Prompt: a gymnast flips on a balance beam. cinematic

就连这种不符合逻辑的奇葩操作:一名男子骑在一匹马背上,而这匹马又骑在另一匹马背上,Sora 2也能以意想不到方式完成。
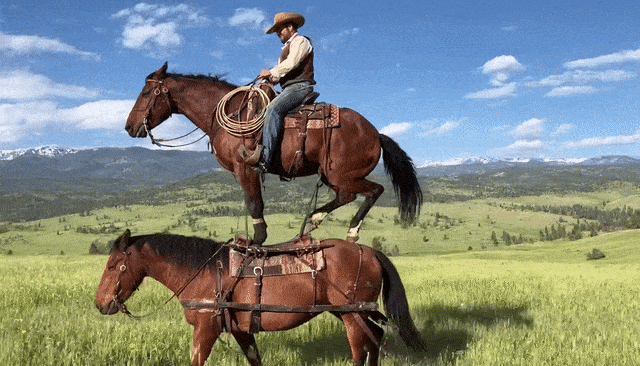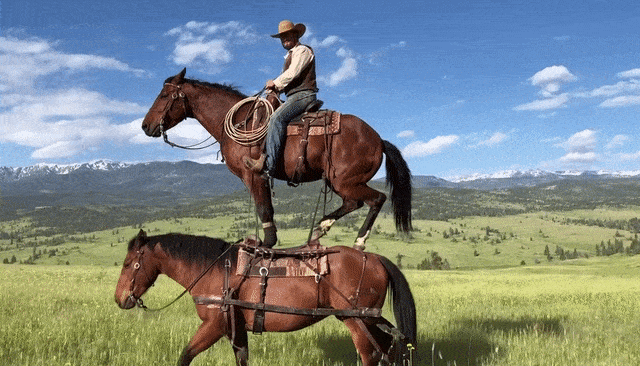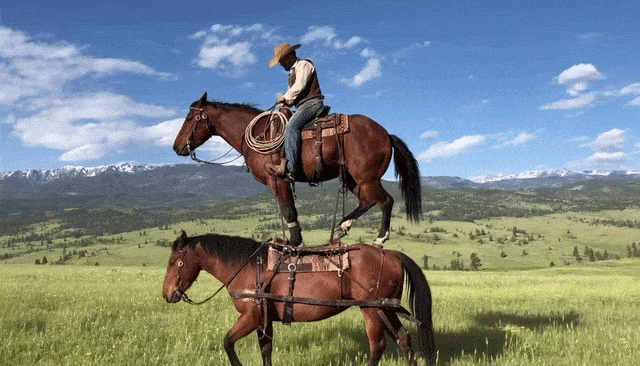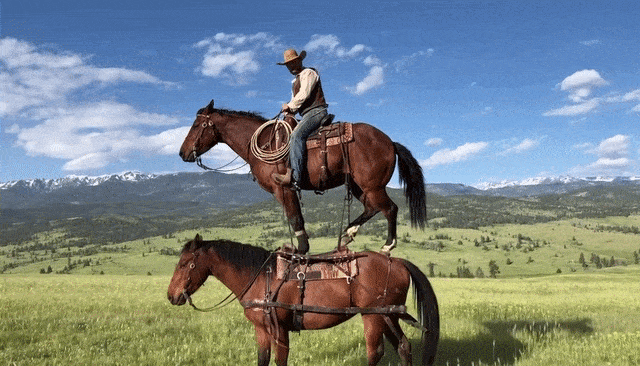
Prompt: a man rides a horse which is on another horse

桨板上的后空翻也不是P上去的,而是力学能自洽地演绎。

Prompt: a man does a backflip on a paddleboard

你甚至能感受到角色的失误、尝试、挣扎,而不是一味「全都对」。

有点像在看小型纪录片——会成功,但也会失败。

Prompt: Title — Lanterns Above, Distance Between (10.0s, Live Action Black & White Festival Night)

Sora 2还能生成各类复杂环境声,效果十分惊艳,几乎听不出AI生成的痕迹。

Prompt: Two mountain explorers in bright technical shells, ice crusted faces, eyes narrowed with urgency shout in the snow, one at a time

「世界模拟器」这词,终于有点底气了。
多镜头、多风格,连贯成片不是梦

以前你让AI连续生成几个镜头,角色的衣服总莫名其妙换了、光线乱飘、道具没了。

Sora 2这次特别强调「世界状态」连续性——哪怕你让角色从厨房走到阳台,镜头切换时阳光、服饰、甚至地上洒的水都能一气呵成,不再穿帮。

你还可以像导演一样指定每个镜头的顺序、节奏、景别变化,把握故事节奏。

风格上,它已经能写实、能做电影质感;

Prompt: Vikings Go To War — North Sea Launch (10.0s, Winter cool daylight / early medieval)

甚至连日漫那种「超现实高燃」也能做得行云流水。

比如生成一场刀光剑影的动漫打斗,每一帧都能让二次元粉感叹「这比PPT流畅多了」。
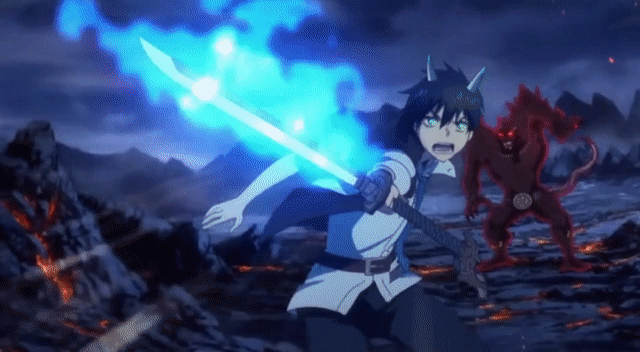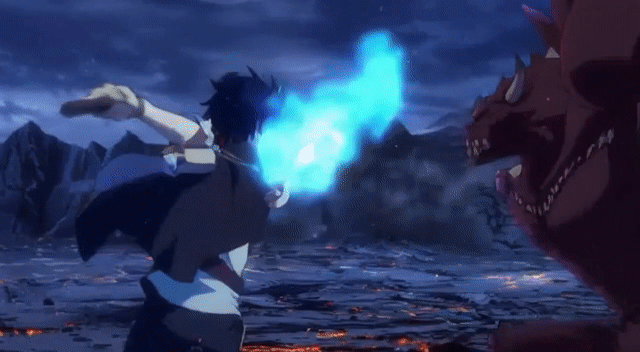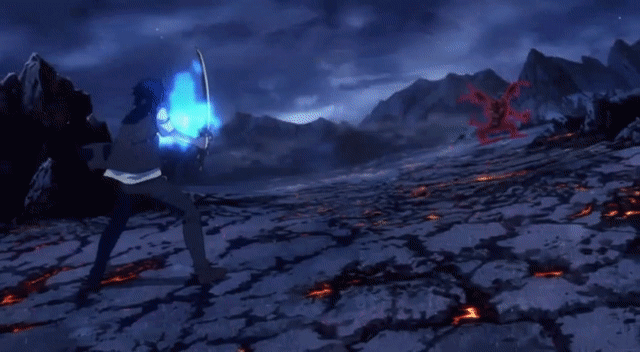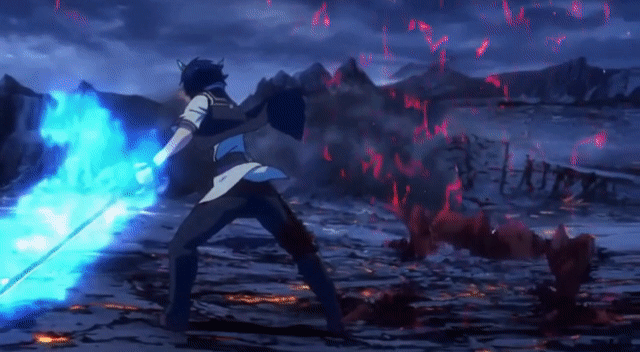
还有曾经爆火全网的吉卜力风格,Sora 2在生成效果上也能拿捏。
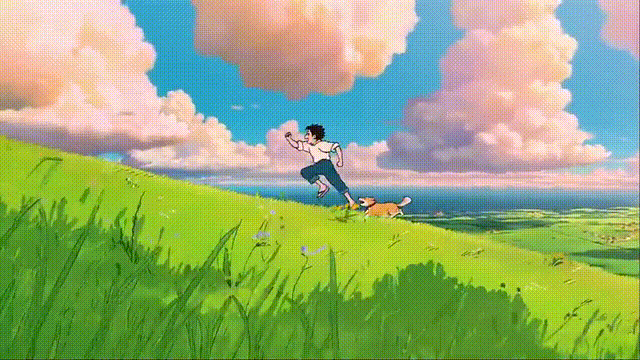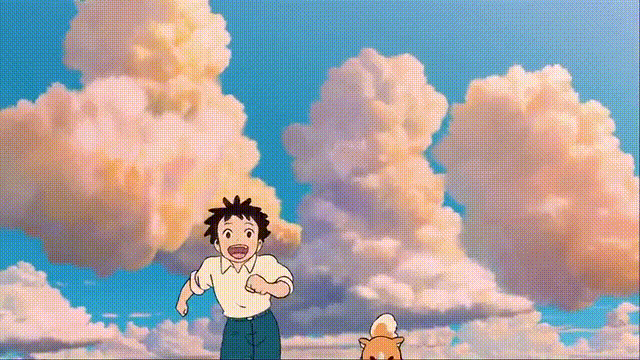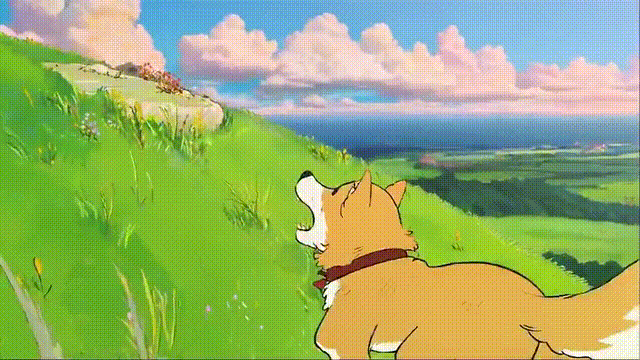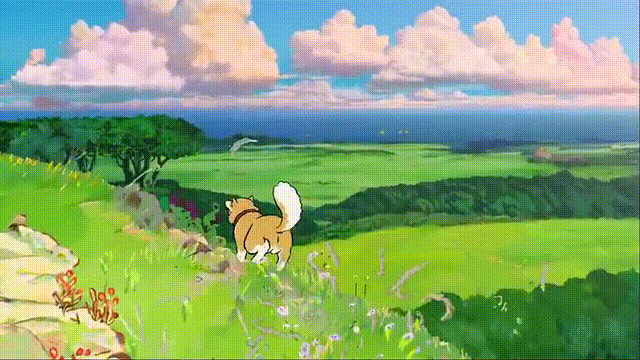
Prompt: in the style of a studio ghibli anime, a boy and his dog run up a grassy scenic mountain with gorgeous clouds, overlooking a village in the distant background

而且音频直接跟上,不仅对白和口型对齐,连环境音、动作声效都随场景变化,给人一种「拿来即用」的感觉,省去后期剪辑音频的繁琐。

就比如,一位年长的教授可以英语无缝切换德语讲话。

Prompt: old professor talks in english then german

更多Sora 2官方惊艳Demo一览:
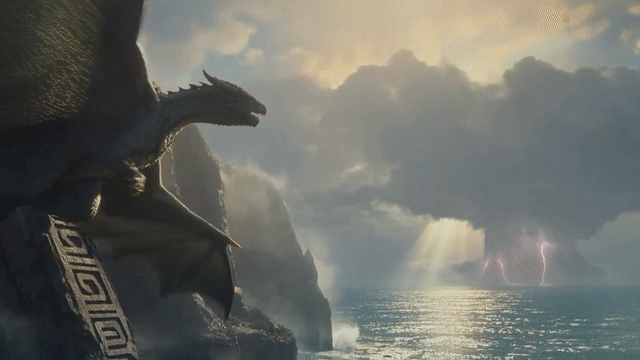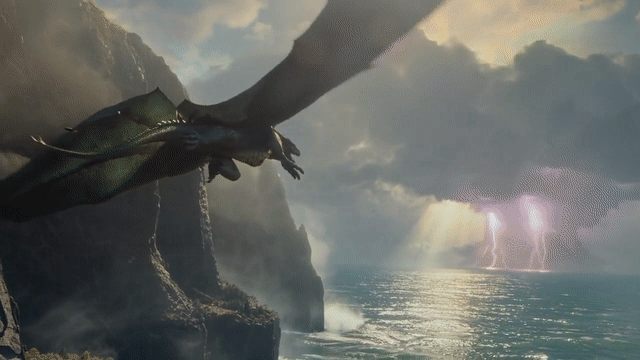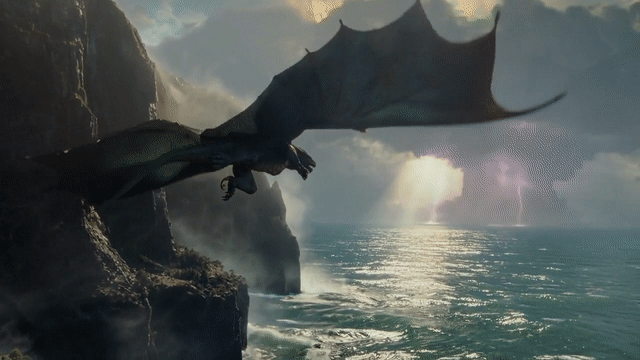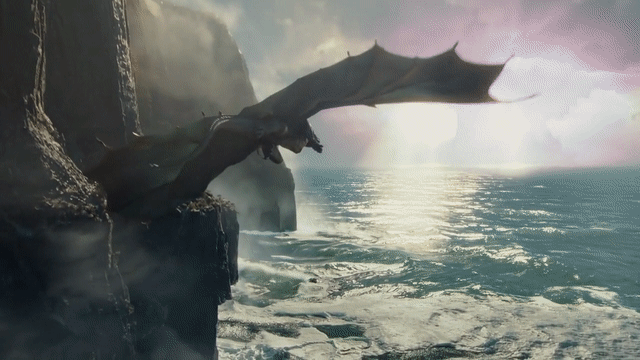
左右滑动查看

新玩法:Sora App 让你「投影」自己进故事

除了模型本身,这次最让人感到「时代变了」的,是全新iOS 社交App——Sora。

打开App,只需要录一小段带声音的视频,系统验证身份和采集形象后,你或朋友,马上就能把你的样子和声音准确「扔进」任意生成场景:

可以让自己出现在巴黎铁塔前开派对、和熊猫打乒乓,甚至和马斯克同框唱歌(当然,公众人物暂时不支持哈)。

Sora 2可以直出一只鸵鸟叼走男子的帽子,在农场里奔跑的视频,效果非常自然,让人辨别不出这是AI生成的。
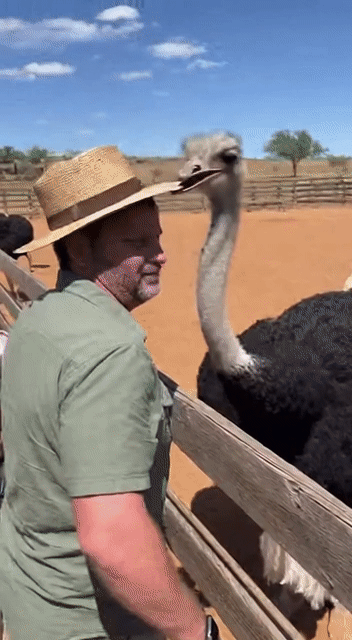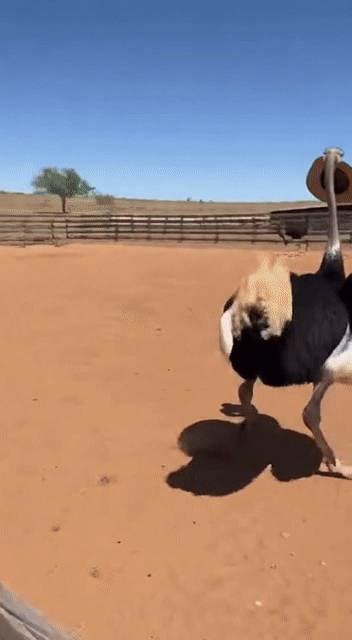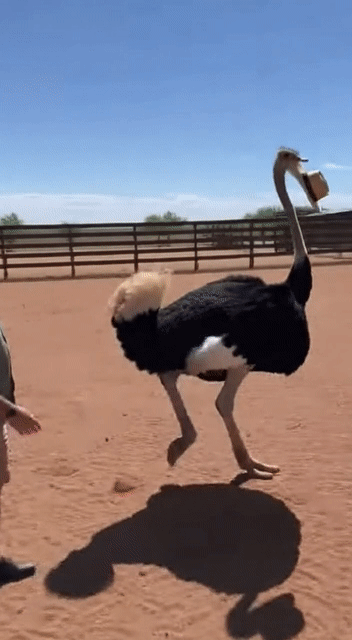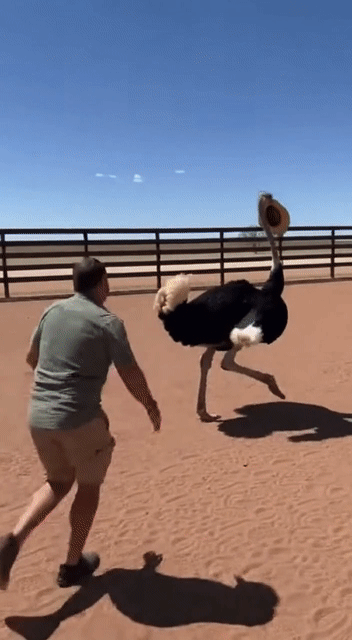
Prompt: an ostrich steals dads hat and dad chases after it

更令人惊喜的是,在Sora 2中还能赋予一个人「超能力」——飞起来,一个Prompt就可实现。

这个功能还用于Sora App,带来了一种全新的社交互动方式。

Prompt: Add @kendra except she can actually fly

「狗超人」拯救人类的剧情,在Sora 2中上演了。
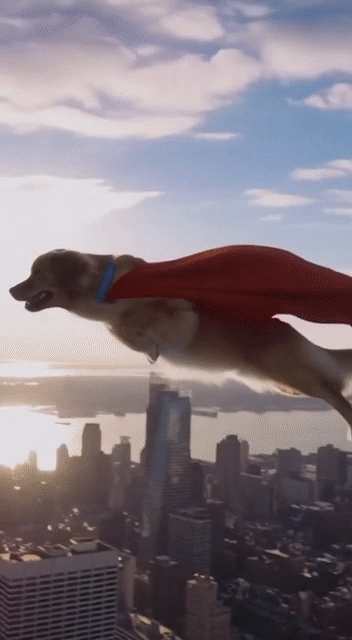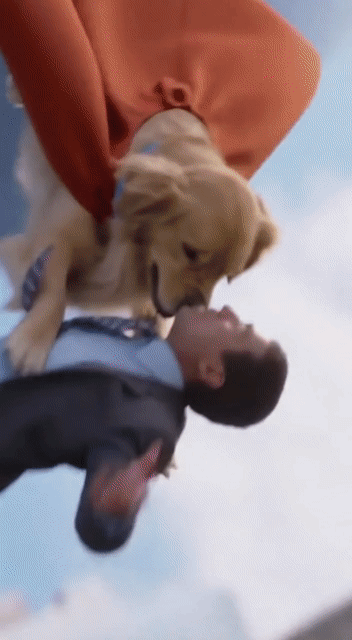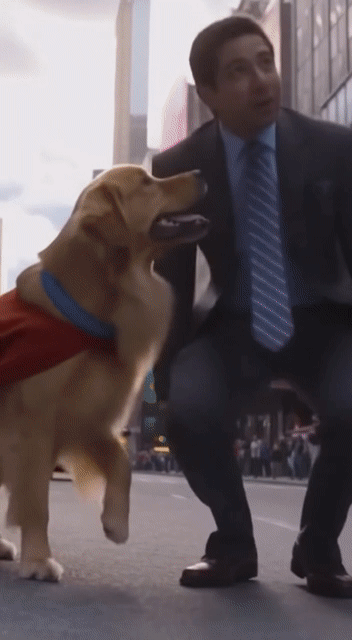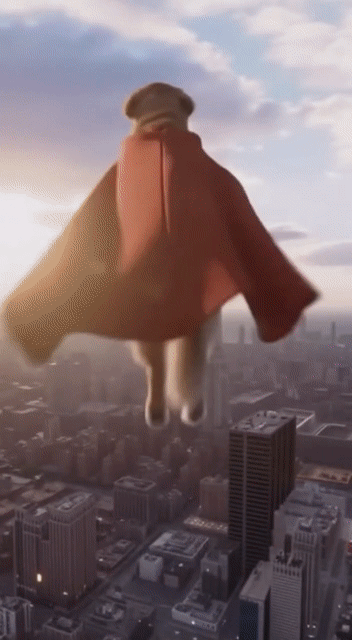
Prompt: @rocket is a superpowered superhero dog, flying through the sky and saving new york city

还有更多的惊艳Demo,以第一视角带你畅玩。
左右滑动查看

这个「Cameo」功能用一次就停不下来,很多OpenAI内测员工说靠它结识了新朋友,AI不止能生成内容,还能创造社交纽带。

Sora的分发逻辑也颇有趣:推荐更偏向于「有二创价值」的视频,而不是单纯让你无脑刷时长。

你可以用自然语言告诉系统想看什么类型、什么风格、哪种故事,算法会主动调整推荐。

起步是邀请制,先在美加上线,后续很快扩展。

拿到邀请码还能上sora.com网页体验,高质量Pro版则专属ChatGPT Pro用户。

历史作品不会丢,API也在路上。

安全与治理:Sora 2十分重视

能力强了,风险也大了。

Sora 2在每一个环节都布下「安全网」:

  • 三层审核:文本提示、上传素材、视频逐帧、自动生成的场景描述和音频转写,全流程分层分类拦截。有些内容在输入就会被拦,有的生成完还要二次封堵,尤其未成年场景严上加严。

  • 肖像权与公众人物保护:刚上线时,禁止用别人的视频做「换脸」,不支持生成公众人物。只有你自己验证授权后,别人才可以用你的形象做视频,所有涉及你形象的作品你都能查到、撤回。

  • 青少年守护:青少年账号内容和Cameo权限都有限制,家长可以通过ChatGPT平台控制推荐、管理私信甚至关掉个性化推荐。

  • 可追溯性:视频下载会带动态水印,所有内容都嵌入行业标准元数据。官方还开发了检测工具,方便未来判断「是不是AI造的」。

  • 压力测试:在成人内容、极端主义、自伤、暴力、误导性政治等维度,都有专门评测和红队攻防。对违规拦截率、误杀率的数据都透明公布,核心指标大多在95-99%区间。

核心团队介绍

在Sora 2官博最后,OpenAI放出了所有参与的成员名单,阵容超豪华。
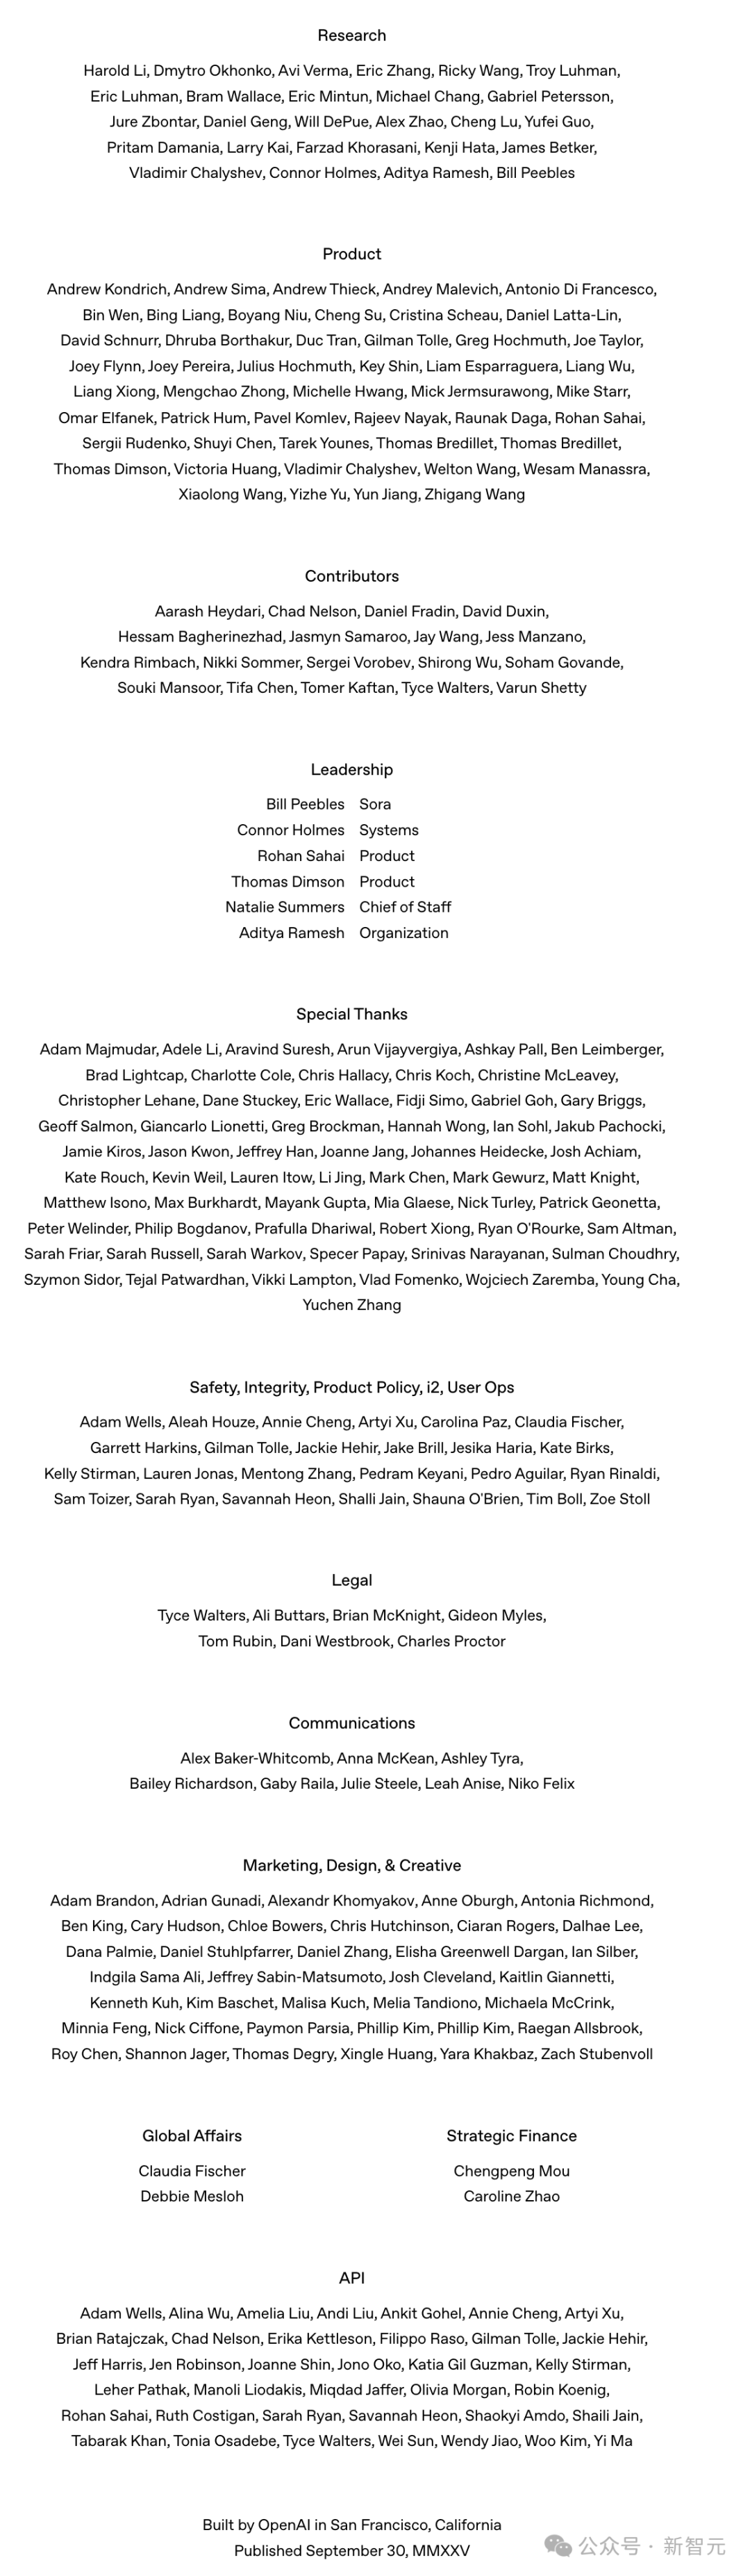
上下滑动查看

在这份「电影谢幕工作人员表」中,OpenAI的几乎所有员工都被拉出来谢幕。

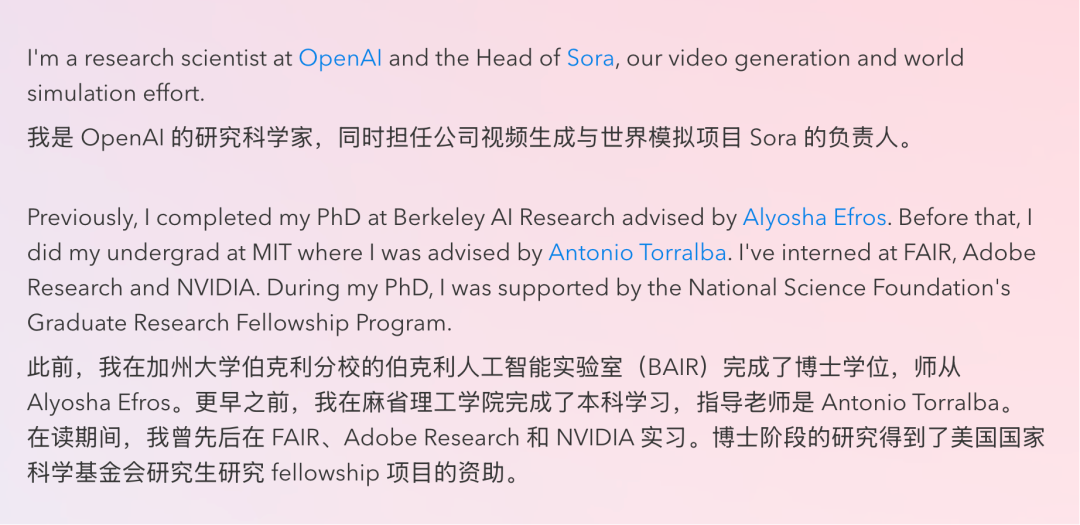
而为我们带来这场如梦如幻的电影的「总导演」,也就是Sora负责人Bill Peebles。
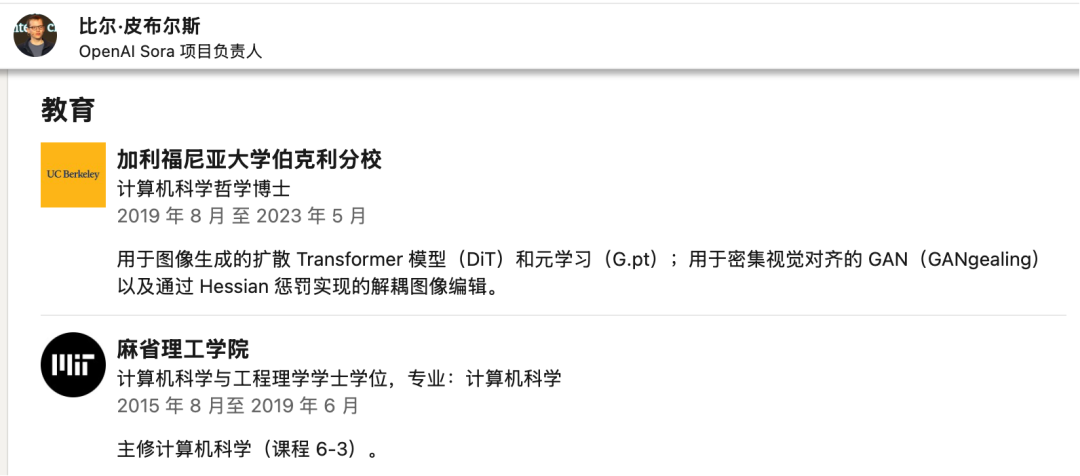
他是一名95后,本科毕业于MIT计算机专业,后于加州伯克利取得计算机博士学位。
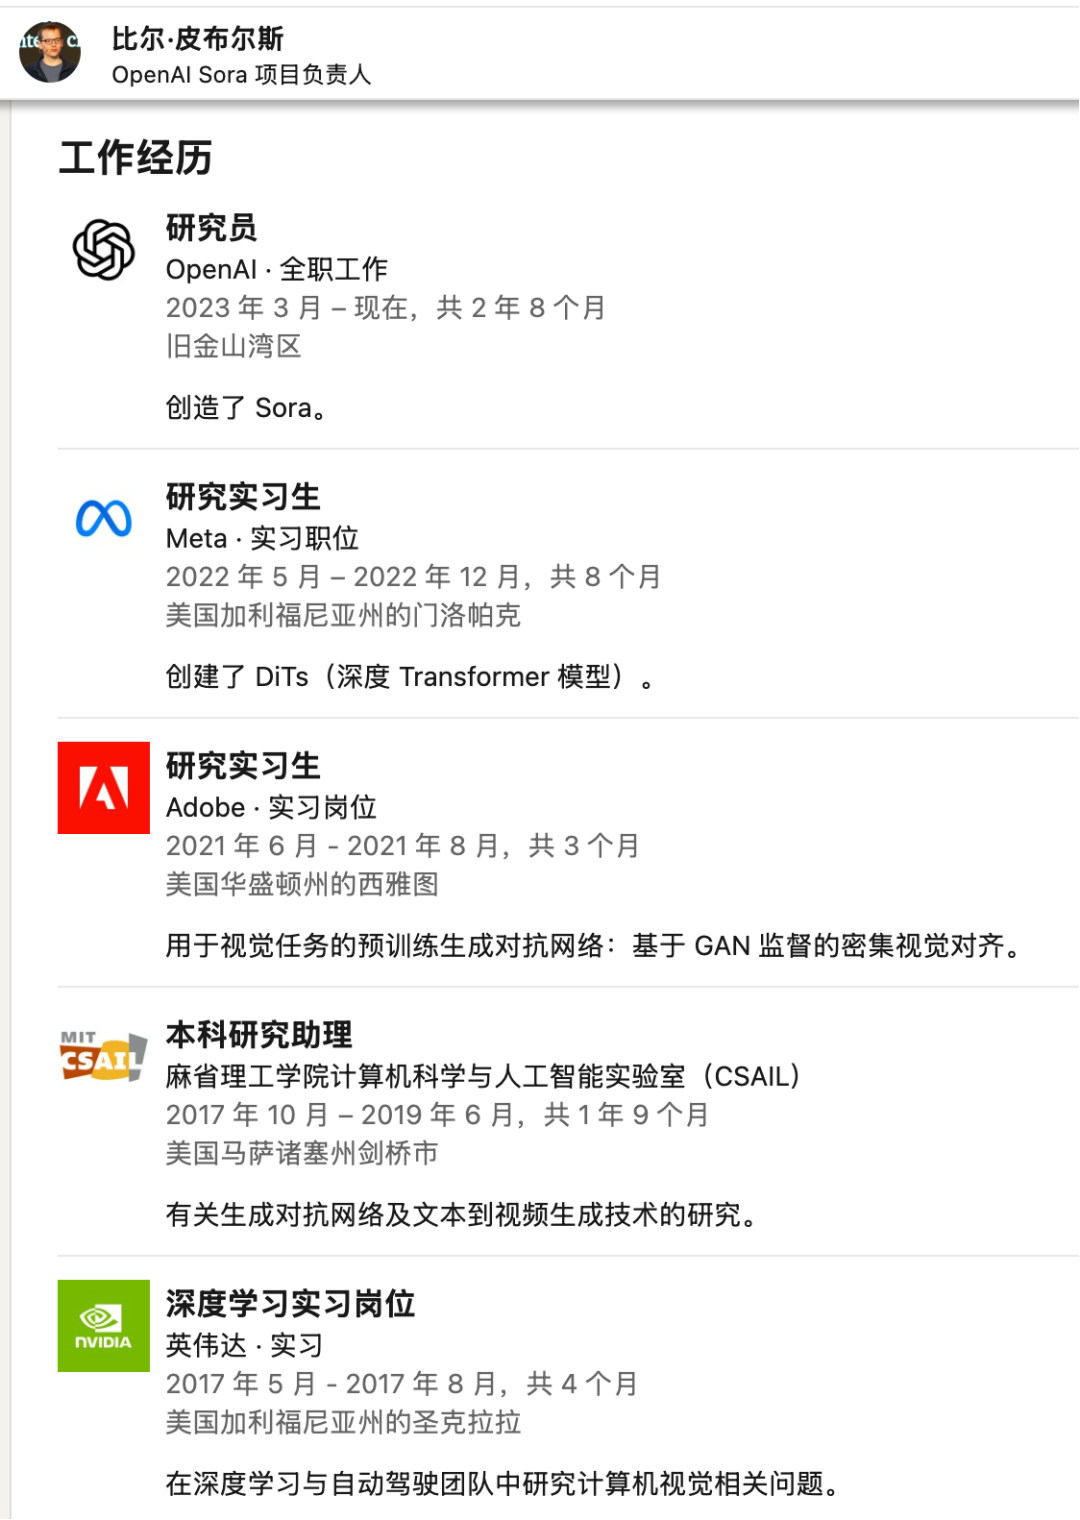
他曾先后在英伟达、Adobe、Meta的AI岗实习,博士毕业后直接加入了OpenAI,工作的最大业绩是Created Sora(创造出了Sora)。
字越少事越大,言简意赅。
下一步:从玩内容到「世界模拟」

OpenAI说,Sora 2不会是终点。

OpenAI坦言它还会犯错,但路线已经明朗:继续用更多、更高质量的视频数据喂养模型,世界模拟的准确性和细节感会越逼真。

这个进化带来的不仅仅是让你玩得爽,更会影响影视广告、动画分镜、教育科普、产品演示,甚至是未来AI机器人「在现实世界里学本事」。

当然,这也意味着欺诈、非自愿肖像、青少年保护等问题会更加突出,需要靠技术、产品、社区和政策一起盯着。

你想把自己「丢」进哪个世界?

Sora 2这一波,是真正把视频生成从「像不像」推向「合不合理」,物理逻辑、镜头控制、音画同步、可玩性和安全性全线升级;

Cameo则把创作从「看别人」变成「玩自己」,让每个人都能成为主角。

不妨现在就想想:如果有30秒,让你出现在任何场景,你最想玩点啥?

是和偶像穿越打怪,还是带宠物环游地球,或者干脆做自己的动漫主角?

欢迎在评论区留言告诉我们你的第一条Sora 2创意。

参考资料:

1.https://openai.com/index/sora-2/

2.https://openai.com/index/sora-2-system-card/

3.https://cdn.openai.com/pdf/50d5973c-c4ff-4c2d-986f-c72b5d0ff069/sora_2_system_card.pdf

4.https://www.youtube.com/watch?v=gzneGhpXwjU

图片一起“点赞”三连↓

Sora专辑|OpenAI大杀器Sora这么火,我们必须了解其背后的技术及其深远的影响 阅读详情

相关推荐

Meta、谷歌、特斯拉,竞争对手联合起来吐槽 OpenAI:Sora 不懂物理世界,它只是 GPT3!

昨天,Meta与Open AI的Sora一起发布了一个新的人工智能模型,名为视频联合嵌入预测架构(V-JEPA)。V-JEPA通过分析视频中对象之间的交互,提高了机器对世界的理解。该模型延续了Meta副总裁兼首席人工智能科学家Yann LeCun的愿景,即创造与人类学习相似的机器智能。上周,OpenAI的第一个视频生成模型Sora在互联网上疯传。然而,与此同时,来自竞争对手公司的一批人工智能专家和研究人员迅速剖析和批评了Sora的Transformer模型,引发了一场物理辩论。

leyang0910的博客 1047

OpenAI最新模型Sora到底有多强?眼见为实的真实世界即将成为过去!

OpenAI全新发布的Sora到底有多强大?眼见为实的真实世界即将成为过去!

吴秋霖的博客 2468

Claude code-review 插件深度解析:AI 驱动的智能代码审查系统

Claude Code Review 插件深度解析:AI 驱动的智能代码审查系统 该插件通过多 Agent 并行工作方式自动审查 PR,采用置信度评分机制(80+分保留)过滤误报,确保高质量反馈。核心功能包括: 5个专业化 Agent 并行审查(规范合规性、bug检测、历史分析等) 8步工作流程:从资格检查到 GitHub 评论发布 创新性置信度评分系统(0-100分),严格过滤7类误报 结合 CLAUDE.md 规范和历史 PR 评论实现一致性审查 技术亮点: 多 Agent 架构(Haiku/Sonne

虚心若愚 2249

【AIGC大模型】Sora--首个大型视频生成模型

Sora通过分析大量的视频数据、学习物理规律的表现,并利用先进的算法理解和模拟时空连续性,从而能够生成看起来符合物理规律的视频。这一过程涉及到复杂的计算和大量的数据处理,最终使得Sora生成的视频在视觉上既真实又符合逻辑。AGI的未来或许真的不远了!

TU商的博客 1986

【时序列】时序列数据如何一步步分解成趋势(trend)季节性(seasonality)和误差(residual)- 详细理解python sm.tsa.seasonal_decompose

【时序列】时序列数据如何一步步分解成趋势(trend)季节性(seasonality)和误差(residual)- 详细理解python sm.tsa.seasonal_decompose 在做时序列分析的时候,好多教程都告诉你要把时序列分解成趋势,季节性,残差,然后画图看一下有没有趋势变化,有没有季节性。像这样: import statsmodels.api as sm decomposition = sm.tsa.seasonal_decompose(train['Count'] ,model='add

weixin_47442572的博客 2万+

Geneformer实战:如何用Hugging Face Transformers快速搭建单细胞转录组分类模型

本文详细介绍了如何使用Geneformer和Hugging Face Transformers快速搭建单细胞转录组分类模型。通过环境准备、数据预处理、模型加载与配置、训练Pipeline构建等步骤,帮助读者掌握基于Transformer架构的单细胞数据分析技术,提升分类准确率和效率。

rl6adventurer的博客 601

OpenAI Sora视频模型技术原理报告解读

OpenAI Sora视频生成模型技术报告解读

周红伟讲AI 1985

Avellaneda & Stoikov’s market-making strategy 工程化处理

前2篇文章详细介绍了AS存货模型的做市策略,这次对于这些公式里面一些希腊字母的取值是如何计算的,如何做工程化并应用到生产环境中做一些说明。这个里面有一些重要参数:很直观,可以直接取值的有:s = current market mid price (中间价,也就是【最佳卖价+最佳买价】/2)q = quantity of assets in inventory of base asset (也就是买入多少价值的股票数量)

weixin_42480337的博客 7064

Sora专辑|OpenAI Sora视频生成模型技术报告中英全文+总结+影响分析

•简单来说,在别家做视频模型的时候还是基于“小”模型的思路(基于上一帧预测下一帧,并且用文字或者笔刷遮罩做约束)的时候,OpenAI则是用做“大”模型的思路做视频生成——准备足够大量的视频,用多模态模型给视频做标注,把不同格式的视频编码成统一的视觉块嵌入,然后用足够大的网络架构+足够大的训练批次(batch size)+ 足够强的算力,让模型对足够多的训练集做全局拟合(理解),在模型更好地还原细节的同时让模型出现智能涌现能力——例如在一定程度上理解真实世界的物理影响和因果关系。Sora是一个扩散模型;

weixin_68987230的博客 1853

uniapp - 解决控制台提示“同步资源失败,未得到同步资源的授权,请停止运行后重新运行,并注意手机上的授权提示”,uniApp安卓/苹果App真机运行调试显示同步资源失败,无任何授权提示且无法连接

uni-app,报错,安卓Android,苹果ios,安卓app端,苹果App端,uniapp苹果安卓app,提示错误解决,HbuilderX,uniapp同步资源失败,未得到同步资源的授权,请停止运行后重新运行,并注意手机上的授权提示同步失败,安卓基座调试,没有反应,真机没有提示怎么办,如何解决这个问题,苹果ios手机,电脑模拟器运行,adb连接,连接失败,报错出错,uniapp真机运行的时候显示同步资源失败,未得到同步资源的授权,plugins里面没有tools,找不到tools,还是不行,重新打基座

🏆 前端领域优质创作者 1万+

《QGIS空间数据处理与高级制图》【目录】

《QGIS空间数据处理与高级制图》是一本面向GIS技术人员和学生的进阶手册,重点提升数据处理效率和专业制图标准化水平。全书涵盖空间数据预处理、矢量编辑、栅格处理、坐标系统应用和符号化设计等核心内容。书中详细介绍了批量数据转换、拓扑检查、遥感影像处理、自定义坐标系创建等实用技能,并提供了模型构建器和PyQGIS脚本实现自动化操作。通过大量实战案例和问题排查指南,帮助读者从基础使用进阶到专业应用,适合测绘、规划、环保等行业的GIS从业者参考使用。

LuckyHanMo的博客 357

OpenAI-Sora:60s超长长度、超强语义理解、世界模型。浅析文生视频模型Sora以及技术原理简介

1. Sora的训练受到了大语言模型(Large Language Model)的启发。这些模型通过在互联网规模的数据上进行训练,从而获得了广泛的能力。Sora是一种扩散模型,它能够通过从一开始看似静态噪声的视频出发,经过多步骤的噪声去除过程,逐渐生成视频。Sora不仅能够一次性生成完整的视频,还能延长已生成的视频。通过让模型能够预见多帧内容,团队成功克服了确保视频中的主体即便暂时消失也能保持一致性的难题。与GPT模型类似,Sora采用了Transformer架构,从而实现了卓越的性能扩展。

Kindred6的博客 2256

黑猫带你学eMMC协议第26篇:eMMC的硬件复位操作(H/W reset)

本文依据eMMC JEDEC5.1及个人工作经验整理而成,如有错误请留言。 文章为个人辛苦整理,付费内容,禁止私自转载。 文章所在专栏:《黑猫带你学:eMMC协议详解》 1 概述 什么是硬件复位? 硬件复位就是使用一个特殊硬件信号(这个信号在RST_n这根实实在在的物理线路上传输)将emmc复位到pre-idle state,而不需要使用cmd0或者power cycle讲emmc复位到pre-idle state。 如何进行硬件复位? 1、设置RST_n_FUNCTION [162]为1,使emm.

黑猫奥利奥的博客 6304

OpenAI的Sora深度解析

Sora的训练受到了大型语言模型(Large Language Model)的启发,这些模型通过在互联网规模的数据上进行训练,获得了广泛的能力。这意味着Sora能够通过逐步消除视频中的噪声,从一开始看似静态噪声的视频出发,逐步生成清晰的视频内容。通过这种方式,Sora能够在更广泛的视觉数据上进行训练,覆盖了不同的时长、分辨率和画面比例,从而实现了前所未有的扩展性能。其融合了大型语言模型、扩散型变换器模型和重新标注技术等多种技术,实现了对视频生成的颠覆性突破,为未来的人工智能发展带来了新的可能性。

qq_43552933的博客 1496

华为自研 ERP、Oracle EBS 与 SAP 上线时系统配置思路设计差异深度分析

本文对比分析了华为自研ERP、Oracle EBS和SAP S/4HANA三大ERP系统在上线配置思路上的核心差异。从架构设计看,华为采用分布式微服务架构,SAP采用分层服务架构,Oracle采用集中式一体化架构;在模块配置上,华为以业务场景为导向,SAP基于行业模板,Oracle强调模块独立性;数据迁移方面,华为侧重业务规则清洗,SAP注重数据质量监控,Oracle依赖标准化工具;流程适配上,华为系统随流程调整,SAP在框架内优化,Oracle需定制开发;定制开发模式差异明显,华为采用插件化扩展,SAP使

金牌架构师 1437

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

OpenAI Sora视频生成模型技术报告中英全文+总结+影响分析

简单来说,在别家做视频模型的时候还是基于“小”模型的思路(基于上一帧预测下一帧,并且用文字或者笔刷遮罩做约束)的时候,OpenAI则是用做“大”模型的思路做视频生成——准备足够大量的视频,用多模态模型给视频做标注,把不同格式的视频编码成统一的视觉块嵌入,然后用足够大的网络架构+足够大的训练批次(batch size)+ 足够强的算力,让模型对足够多的训练集做全局拟合(理解),在模型更好地还原细节的同时让模型出现智能涌现能力——例如在一定程度上理解真实世界的物理影响和因果关系。Sora是一个扩散模型;

renhongxia1的博客 1303

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

探索OpenAI Sora 背后的原理

正如 NaViT 模型通过将来自不同图像的多个补丁打包到单个序列中来展示显着的训练效率和性能提升一样,Sora 利用时空补丁在视频生成中实现类似的效率。在生成模型的世界里,我们已经看到了许多方法,从GAN到自回归和扩散模型,都有自己的优势和局限性。训练数据的质量和多样性对于生成模型的性能至关重要。传统的视频模型是在限制性更强的数据集、更短的长度和更窄的目标上进行训练的。然而,视觉转换器对图像训练数据的限制是固定的,这些数据的大小和纵横比是固定的,这限制了质量,并且需要大量的图像预处理。

Meta.Qing的博客 1189

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

这应该是全网第一篇全面解读OpenAI Sora报告的文章,精读报告:Video generation models as world simulators

今天是2024年2月16号,大年初七,年还没过完,早晨起来朋友圈就被Sora刷屏了。本来以为没啥,都是公众号或者视屏啥的,都没点开看,直到看到我导也发了Sora的文章,我就知道这个事情不简单了。先来看一段非常炸裂的效果,就是下面这个视频。真的,如果你不跟我说这是AI生成的,我还以为是哪个电影的镜头呢。这场景,这运镜,这清晰度,放大之后连脸上的斑都清晰可见,Oh my God,现实不存在了,现实真的不存在了。Tokyo walk。

Alex 3596

解释 OpenAI Sora 的时空补丁:关键因素

人工智能如何将静态图像转换为动态、逼真的视频?OpenAI 的 Sora 通过创新地使用时空补丁来引入答案。在快速发展的生成模型领域,脱颖而出,成为一个重要的里程碑,有望重塑我们对视频生成的理解和能力。我们解读及其在图像、视频和 3D 内容创作方面激发新一代模型的潜力。cat-on-bed上面的演示是由 OpenAI 使用提示生成的:一只猫叫醒了熟睡的主人,要求吃早餐。主人试图无视猫,但猫尝试了新的策略,最后主人从枕头下掏出一个秘密的零食,让猫多呆一会儿。

qq_45939907的博客 1326

Sora 来了!

英伟达的科学家认为,Sora是一个数据驱动的物理引擎。腾讯科技认为, Sora 表现出六种强大能力,包括文本到视频生成能力、复杂场景和角色生成能力、语言理解能力、多镜头生成能力、从静态图像生成视频能力、物理世界模拟能力。

铅笔楼的专栏 693

Sora已来! Sora视频生成模型技术报告中英全文+总结+影响分析

击上方关注 “终端研发部”设为“星标”,和你一起掌握更多数据库知识▌01.OpenAI Sora 视频生成模型技术报告总结•不管是在视频的保真度、长度、稳定性、一致性、分辨率、文字理解等方面,Sora都做到了SOTA(当前最优)。•技术细节写得比较泛(防止别人模仿)大概就是用视觉块编码(visual patch)的方式,把不同格式的视频统一编码成了用transformer架构能够训练的emb...

这个时代,作为程序员可能要学习小程序 305

Sora了解资料

在 2024 年 2 月 16 日,Open AI 宣布推出全新的生成式人工智能模型“Sora”。据了解,通过文本指令,Sora 可以直接输出长达 60 秒的视频,并且包含高度细致的背景、复杂的多角度镜头,以及富有情感的多个角色。这意味着,继文本、图像之后,OpenAI 将其先进的 AI 技术拓展到了视频领域。OpenAI 亦表示,Sora 是能够理解和模拟现实世界的模型的基础,这一能力将是实现 AGI(通用人工智能)的重要里程碑。

sorrylk_maker的博客 2633

Sora背后的技术原理解析(简单易懂版本)

本篇文章是OpenAI发布的最强AI视频生成工具Sora技术详解(非官方),然而,Sora的野心远不止是视频生成,而是作为一个世界模型。之前的文章中已经介绍了很多关于文生图的相关技术,相信有了文生图的基础后再来学习文生视频就会容易接受许多。本文的内容参考从openai sora[1]的技术报告首段可以看出sora的野心远远不止视频生成,他们的目标是通过视频数据来学习一个或者,这才是真正令人兴奋和激动的部分。

AIGC Studio:分享AIGC前沿知识和好玩应用,公众号同名。 2614

去魅Sora: OpenAI 鲜肉小组的小试牛刀

不知道这是不是Tim的毕业设计,毕业后就去了Google, Marc Levoy带领的计算摄影组,做了Unprocessing算法实现RGB -> raw数据的合成和降噪算法,后来又跟Tianfan Xue学长、Jon Barron大神等人参与了Pixel的超级夜景算法,这个算法非常牛逼,后来我们基于Deep Learning做了个更好的,也去投SIGGraph,被审稿人拍的很惨。当然,作为搞学术的人,看到这样好的实验结果,我们想的是如何复现,也就是复刻一个 Sora 出来。

具身机器人和通用AI 935
上一篇: 节前最后一波实测,智谱最新模型GLM-4.6
下一篇: 精细整理!AI大佬们的有问必答合集( 必看)
Datawhale
Datawhale 领域专家: 物联网技术领域 领域专家: 物联网技术领域
博客等级 码龄8年 8899粉丝 1080原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值