


 本文系统讲解四种提升大模型推理能力的核心范式:CoT(思维链)、ReAct(推理+行动)、ToT(思维树)和结构化输出。重点阐述其原理、适用场景、实现要点及典型陷阱,强调范式本质是为模型提供草稿空间、外部事实接入、回溯能力与输出约束,而非提升模型固有智能。内容聚焦技术实践,含Java类比、LangChain4j集成、Token代价分析与生产级避坑指南。
本文介绍了四种提升大模型推理能力的范式:CoT(让模型写出草稿)、ReAct(让模型查询事实)、ToT(让模型多线程思考)和结构化输出(让模型按表格格式输出)。通过这些方法,即使是小白或程序员也能显著提高大模型的正确率。文章还提供了具体的实现示例和注意事项,帮助读者更好地理解和应用这些范式。
让一个成年人心算 37 × 48,他得盯着天花板想好久;递给他纸和笔,一边写一边算,不仅更快,基本也不会出错。
大模型也是个爱心算的人——一口气往下写,写完也不改,中间连打草稿的地方都不留。
说白了,推理范式就是往模型手里塞东西:塞一支笔写草稿(CoT)、塞一部电话问事实(ReAct)、塞一张能擦的草稿纸想岔了能退回来(ToT)、最后塞一张标准表格让推理被程序读走。同一个模型、换一种"想问题的方式",正确率能差出十几倍。
接下来就让我们一起看一看:一句"让我们一步步思考"凭什么让正确率翻几倍?推理到一半,怎么顺手查一次真实数据?想岔了能不能退回来?那三十行 ReAct 循环,又为什么非得手写一遍?
一、CoT:先给它一支笔
1.1 一个几乎零成本的实验
先看两段提示词,内容完全相同,只差最后一句:
【A】商店原有 24 个苹果,上午卖出 3 箱、每箱 8 个,下午又进货 15 个,现在还剩多少个?答:
【B】商店原有 24 个苹果,上午卖出 3 箱、每箱 8 个,下午又进货 15 个,现在还剩多少个?
让我们一步步思考。
差别只有一句话。但 Kojima 等人在 2022 年的论文《Large Language Models are Zero-Shot Reasoners》里给出的数据是这样的:
| 任务 | 直接回答 | 加上"Let’s think step by step" |
|---|---|---|
| GSM8K(小学数学应用题) | 10.4% | 40.7% |
| MultiArith(算术应用题) | 17.7% | 78.7% |
测试模型是当时的 text-davinci-002(175B)。同一批题、多了一句话,正确率翻了几倍。
Note
论文测的是英文原句;中文场景用"让我们一步步思考"这类等效指令也能起效,但增益幅度需用自己的测试集验证。
这不是模型变聪明了,而是你终于允许它把草稿打出来。
1.2 为什么"写出来"就真的准了
一句提示词凭什么有这么大威力?三个层面:
① 中间结果变成了"可见输入"。 下一个 token 只能基于已生成的内容预测,写出来的中间结果就成了下一步推理可复用的输入——心算时它只存在于隐藏状态里,稍纵即逝。
② 把计算摊到更多次前向传播上。 串行计算步数受层数上限约束,一步到位只能硬算;摊成一个个 token,计算量就分散到了更多生成步里。
③ 它见过海量的人类解题过程。 网上的解题过程、代码注释几乎都是"一步步写"的,给出同样的形式,它就更可能落回"认真解题"的状态。
用 Java 类比
模型默认的输出是
return computeAnswer(input);——一行表达式硬算到底。CoT 相当于让它改成方法调用链:先算中间变量、打印日志、再返回结果。日志不是废话,日志就是它的工作内存。
1.3 CoT 的三种强度,按需选
| 方式 | 做法 | 成本 | 什么时候用 |
|---|---|---|---|
| Zero-shot CoT | 加一句"让我们一步步思考" | 几乎为零 | 默认先试这个 |
| Few-shot CoT | 给几个带完整推导的示例(原论文用 8 个) | 提示词变长 | 步骤有特定格式要求时 |
| Self-Consistency | 温度调高,采样 N 条推理路径,对答案投票 | N 倍 | 答案可比较,且错误是随机的 |
Self-Consistency 的实现骨架,Java 开发者一眼就懂:
// 采样 N 条推理路径,取出现次数最多的答案
public String selfConsistent(String question, int n) {
    Map<String, Integer> votes = new HashMap<>();
    for (int i = 0; i < n; i++) {
        // 温度调高,让每次推理路径都不一样
        String reasoning = chat(question + "/n让我们一步步思考", 0.7);
        votes.merge(extractFinalAnswer(reasoning), 1, Integer::sum);
    }
    return votes.entrySet().stream()
            .max(Map.Entry.comparingByValue())
            .map(Map.Entry::getKey)
            .orElseThrow();
}
关键点:只有最终答案参与投票,推理路径各不相同——多条独立路径同时出错的概率,远低于单条出错。
Warning
Self-Consistency 只对"答案可以投票"的任务有效——数值、选项、分类标签。写作文、写代码没用,投票投不出更好的代码。
1.4 三个真实的坑
Warning
坑一:CoT 是"规模涌现"的能力。 收益要等模型规模足够大才显现。小模型上输出可能只是一堆像推理的废话,比直接作答还差——上生产前用自己的测试集验证。
坑二:不是所有任务都该"思考"。 分类、信息抽取、格式转换这类任务硬加推理步骤,模型会在推理里编出原文根本没有的依据。正确做法是低温度 + 结构化输出。
坑三最要命:推理的时候,模型接触不到任何新信息。 不知道订单的真实状态,它会一本正经地写下"订单 ORD-123456 已于昨日发货,因此……“,再基于编造的结论往下推。CoT 会让幻觉变得"更有逻辑”,而不是更少。
这正是 ReAct 要解决的问题:让推理过程能够从外部世界拿到事实。
二、ReAct:再把电话递给它
2.1 Thought → Action → Observation
ReAct 是 “Reasoning + Acting” 的缩写(Yao 等人,2022,ICLR 2023)。它的核心就是一个循环:

CoT 的推理只依赖模型自己写下的内容;ReAct 在推理之间插入了行动,每一步思考都多了一次拿外部事实的机会。
用户问"我买的鞋子今天降价了,能退差价吗",纯 CoT 会编出一套看起来合理的退差价规则;ReAct 则先调 queryOrder 查订单、再调 queryPricePolicy 查价格保护规则,两个事实到手才生成答复。少了哪个工具,这条链就断在那里,而不是靠编补上。
2.2 手写一遍 ReAct 循环
框架把循环藏起来了。先不用框架,用最朴素的方式写出来——整个实现只有四块:工具定义、提示词、循环、解析。
第一步,定义工具。 名字和描述是写给模型看的,执行函数是你的业务代码:
// 描述里的参数说明是给模型看的,不是给人看的
public record ToolSpec(String name,
                       String description,
                       Function<Map<String, String>, String> handler) {
}

Map<String, ToolSpec> tools = Map.of(
    "queryOrder", new ToolSpec(
        "queryOrder",
        "查询订单状态。参数 orderId,形如 ORD-123456。仅在用户询问订单或物流时调用。",
        args -> {
            String orderId = args.get("orderId");
            if (orderId == null || !orderId.matches("ORD-//d{6}")) {
                // 错误信息要写成"模型能照着改"的形式
                return "ERROR: orderId 格式不正确,应为 ORD-123456 格式";
            }
            return "订单 " + orderId + " 已发货,预计明天 18:00 前送达";
        })
);
第二步,把格式约定写进系统提示词:
String buildSystemPrompt(Collection<ToolSpec> tools) {
    StringBuilder sb = new StringBuilder("""
        你是一个可以调用工具的助手。每次只输出一轮,格式严格如下:

        Thought: <现在缺什么信息、该调哪个工具>
        Action: <工具名>
        Action Input: <JSON 对象,如 {"orderId":"ORD-123456"}}

        收到 Observation 后继续下一轮。信息足够时改用:
        Final Answer: <给用户的最终回答>

        可用工具:
        """);
    for (ToolSpec t : tools) {
        sb.append("- ").append(t.name()).append(":").append(t.description()).append("/n");
    }
    return sb.toString();
}
第三步,循环本体。 这就是 ReAct 的全部——一个 while 循环:
public String run(Collection<ToolSpec> tools, String question, int maxSteps) {
    Map<String, ToolSpec> registry = tools.stream()
            .collect(Collectors.toMap(ToolSpec::name, Function.identity()));

    // 模型是无状态的:每一轮都要把完整上下文重新发过去
    String context = "Question: " + question + "/n";

    for (int step = 0; step < maxSteps; step++) {          // ① 硬性步数上限
        String output = chat(buildSystemPrompt(tools), context); // temperature = 0.0

        if (output.contains("Final Answer:")) {
            return output.substring(output.indexOf("Final Answer:") + 13).trim();
        }

        String action = extract(output, "Action:");
        String input  = extract(output, "Action Input:");
        if (action == null || input == null) {
            // 格式跑偏:把错误提示塞回去,让模型重来
            context += output + "/nObservation: 输出格式错误,请严格按 Thought / Action / Action Input 格式重新输出/n";
            continue;
        }

        ToolSpec tool = registry.get(action);
        String observation = (tool == null)
                ? "ERROR: 不存在工具 " + action + ",可用工具:" + registry.keySet()
                : executeSafely(tool, input);              // ② 解析 JSON + 超时 + 异常兜底

        context += output + "/nObservation: " + observation + "/n"; // ③ 结果回灌上下文
    }
    return "任务超过 " + maxSteps + " 步仍未完成,已终止。";
}
第四步,也是最脏的一步——解析:
String extract(String text, String label) {
    int start = text.indexOf(label);
    if (start < 0) {
        return null;
    }
    String rest = text.substring(start + label.length()).trim();
    int end = rest.indexOf("/n");
    return (end < 0 ? rest : rest.substring(0, end)).trim();
}
这三十行就是 ReAct 的全部骨架。 跑通它之后你会发现一个残酷的事实:真正花时间的不是循环,而是那个 extract()。
Function Calling 不是 ReAct 的替代品
现代生产里你几乎不会真的去解析
Action:文本——原生 Function Calling 和 LangChain4j 的@Tool,只是把 Action 那一步交给了模型的训练对齐层,你拿到的是现成的函数名和参数对象。但循环还是那个循环:模型决定调什么 → 你的代码执行 → 结果回灌 → 模型决定下一步。手写一遍的价值,是让你看得懂框架日志里那串tool_calls为什么会在某一步卡住。
2.3 手写之后才看得见的四个坑
| 坑 | 真实现象 | 处理方式 |
|---|---|---|
| 格式漂移 | 写成中文冒号 Action:、把参数写成 queryOrder(orderId="ORD-123456") 的函数调用风格、给 JSON 套一层 markdown 代码块 | 改解析器治标;换原生 Function Calling 治本 |
| 死循环 | 反复调用同一个工具、同一个参数,一轮轮烧 Token | maxSteps 硬上限 + (工具名, 参数) 去重检测,重复即终止并转人工 |
| 错误不会自愈 | 工具返回异常后,模型继续顺着编 | 返回结构化错误(原因 + 该怎么改),而不是空串或堆栈 |
| 上下文越滚越长 | 每一轮的 Observation 都堆进上下文,Token 成本指数增长 | 只保留最近 N 条 Observation,更早的用摘要替换 |
死循环:让 Agent 无限循环,等于让一个不确定的程序烧你的 Token 预算。maxSteps 不是优化项,是安全项——给它一个和"线程池设队列长度"同级别的硬边界,再叠一层 (工具名, 参数) 去重,因为模型卡住时往往就是原地打转。
错误自愈:工具失败时返回 ERROR: orderId 格式不正确,应为 ORD-123456 格式,模型下一轮大概率会改对参数;返回空串或一段 Java 堆栈,它只能瞎猜。错误信息是写给模型看的调试信息。
2.4 ReAct 的死穴
ReAct 是一条直线走到底的:每一步都建立在上一轮的结果上。它没有"回头"的机制。
一旦中间某步错了——选错工具、填错参数、拿到个误导性结果——后面的推理就建立在错误前提上,越走越远;它也没法同时考虑几个方向,一次只能选一个 Action。
用 Java 类比
ReAct 是单线程、且没有事务回滚的代码。 想让它具备回溯能力,就得把"一条链"变成"一棵树"。
三、ToT:允许它擦掉重写
3.1 一道 CoT 注定做不对的题
经典题 Game of 24:用 4、9、10、13 这四个数,每个数恰好用一次,通过加减乘除凑出 24。
答案是 (10 − 4) × (13 − 9) = 24。
这道题的关键在于第一步必须选对。模型只能走一步定一步,一旦第一步选了 4 + 9,剩下的 10 和 13 怎么组合都凑不出 24——可它不会停下来,会硬着头皮往下算,最后给出一个错误的等式,语气还很自信。
ToT 论文的误差分析印证了这一点:约 60% 的 CoT 样本在第一步(生成第一个等式)就已经错了,后面几步全是错误前提上的无用功。
用 Java 类比
这不是"计算能力不够",这是贪心算法撞上了需要回溯的问题。
3.2 把链变成树
ToT(Tree of Thoughts,Yao 等人,2023)的思路就是把"一条线"改成"一棵树",它靠三个组件协作:

评估器是 ToT 的灵魂。 它不出答案,只判断"这个中间状态有没有希望",输出 sure / maybe / impossible 三档。"判断有没有希望"比"算出正确答案"简单得多,模型做得到的概率也高得多——这才是 ToT 能 work 的根本原因:用便宜判断换昂贵搜索。
它的骨架就是一个带剪枝的 BFS:每层生成候选 → 评估 → 只留最有希望的 top-b。这里的 breadth 就是"用多少 Token 换多少正确率"的旋钮——b=5 比 b=1 多出 29 个百分点的成功率,代价是每层多生成和评估 5 倍候选。
| ToT(每层保留 5 个候选) | 74% |
这张表里有两个必须记住的细节:
第一,CoT 在这类题上比"直接回答"还差(4.0% vs 7.3%)。 "一步步思考"把它推上了一条一错到底的路,还让错误看起来更有逻辑。推理范式用错场景,比不用更糟。
第二,Self-Consistency 采样 100 条也只到 9.0%。 投票生效的前提是"多数路径是对的",而这道题里绝大多数路径从第一步就跑偏了——民主投票救不了系统性错误。
3.4 代价与选型
Warning
ToT 贵得离谱:每层生成 N 个候选、每个还要单独评估一轮,Token 消耗是单次 CoT 的数倍到数十倍,延迟也成倍上升。它绝不是默认选项。
几种推理范式的选型,一张表说清:
| 范式 | 一句话 | 适合的任务 | 不适合的任务 |
|---|---|---|---|
| CoT | 把草稿写出来 | 单步推理、答案唯 |
一、不需要外部信息(算术、逻辑、改写) | 需要外部事实、需要多步探索 |
| Self-Consistency | 多算几遍再投票 | 答案可比较、错误是随机的 | 系统性错误、开放生成 |
| ReAct | 边想边查,拿事实 | 需要外部信息、步骤不固定(查询、诊断、客服) | 一步错就步步错、无法中途发现 |
| ToT | 想多个方向,能回头 | 搜索型、需要回溯(任务规划、组合优化、方案设计) | 简单任务、成本敏感、延迟敏感 |
Tip
落地原则:从最便宜的往上加。 先上 CoT,加一句提示不要钱;不行上 ReAct,给它接工具;真是"搜索型"、前两者都救不了,才考虑 ToT。
到这里,推理的"想"这一层算是补齐了。但只要你真的落地一次,就会撞上最后一堵墙——模型想得再好,它的输出还是自由文本,你的程序接不住。
四、结构化输出:让它写在标准表格里
4.1 三层靠谱程度
ReAct 循环里那个 extract() 就是证据:把自由文本的推理过程硬翻译成程序能读的数据,这件苦力活本来不该由你干。
同样是"让模型输出 JSON",可靠性差着两个数量级:
| 方案 | 保证什么 | 不保证什么 | 失败率量级 |
|---|---|---|---|
| 纯文本 + 正则 | 什么都保证不了 | 格式、字段、类型 | 15% ~ 30% 解析失败 |
JSON 模式 (json_object) | 输出是合法 JSON | 字段名、类型、必填项 | 2% ~ 8% 字段级错误 |
严格 JSON Schema (strict) | 完全符合你给的 schema | 内容语义是否正确 | <0.1% |
Note
上表失败率来自社区评测,不同模型差异很大,但量级关系是稳定的。
为什么严格模式能这么稳?因为它换了机制:约束解码(Constrained Decoding)。

Tip
JSON 模式是"求模型好好输出 JSON",严格模式是"解码器在物理上不允许它输出非法 token"。 一个是请求,一个是约束,差距就来自这里。
同一套机制自部署也能用:llama.cpp 的 GBNF、vLLM 的 XGrammar、微软的 llguidance。你不用自己实现,但知道它存在,选型时才问得出对的问题。
4.2 LangChain4j 里怎么用
在 Java 这边,LangChain4j 已经把这件事封装得很顺:方法直接返回一个 POJO,框架自动生成 JSON Schema 发给模型。
import dev.langchain4j.model.output.structured.Description;
import static dev.langchain4j.model.chat.Capability.RESPONSE_FORMAT_JSON_SCHEMA;

// ① 用 record 描述你要的结构,@Description 是写给模型看的字段说明
public record OrderDecision(
        @Description("推理过程:先说明用户诉求、查到的订单状态、依据的售后规则")
        String reason,
        @Description("决策结果,只能是这三个值之一")
        Decision decision,
        @Description("给用户的回复正文")
        String reply) {
}

public enum Decision { REFUND, EXCHANGE, REJECT }

// ② 方法直接返回这个类型,不再返回 String
interface OrderAssistant {
    OrderDecision handle(String userMessage);
}
// ③ 关键:显式开启 JSON Schema 能力,它默认是关闭的
ChatModel model = OpenAiChatModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName("gpt-4o-mini")
        .supportedCapabilities(RESPONSE_FORMAT_JSON_SCHEMA)
        .strictJsonSchema(true)   // OpenAI / Azure / Mistral 需要这个开关
        .temperature(0.0)
        .build();

OrderAssistant assistant = AiServices.builder(OrderAssistant.class)
        .chatModel(model)          // LangChain4j 1.x 写法;0.x 请用 .chatLanguageModel(model)
        .tools(new OrderTools())  // 你的工具类,用 @Tool 注解方法即可;结构化输出与工具调用可以同时使用
        .build();

OrderDecision d = assistant.handle("我上周买的鞋子不合脚,能退吗");
System.out.println(d.decision() + " / " + d.reason());
静默降级是生产事故的经典温床
supportedCapabilities(RESPONSE_FORMAT_JSON_SCHEMA)不写,框架不会报错。 它会悄悄退化成"把格式说明拼进用户消息"的老办法——那种"求模型好好输出 JSON"的不可靠做法。
另外 provider 差异要注意:OpenAI / Azure / Mistral 要 strictJsonSchema(true),Gemini、Ollama、Bedrock 只配 supportedCapabilities。
4.3 三个真实的坑
字段顺序就是逻辑
坑一(最重要):
reason必须排在decision前面。 模型逐 token 顺序生成,写完就定死——结论排前面,它会在还没推理时就把结论吐出来,reason沦为事后找补。把reason排最前,等于把 CoT 固化进数据结构。
Warning
坑二:默认所有字段都是可选的。 强制必填要显式标
@JsonProperty(required = true);可选的基本类型字段漏填会静默变成0/false,全程没有任何异常。关键字段都要写单测。坑三:不是所有类型都能进 schema。 POJO、枚举、String、List / Set、数值和 boolean 没问题;
BigDecimal、Date、LocalDate、Map不在支持范围,会自动退回 prompting 模式——而金额和日期恰恰是最常见的两类业务字段,金额建议用 String 传。记住:schema 校验只是第一道门,业务校验(金额范围、日期合理性、枚举与业务状态是否匹配)一个都不能省。
4.4 最终形态:让推理过程本身成为 schema 的一部分
public enum Confidence { HIGH, MEDIUM, LOW }

public record Diagnosis(
        @Description("排查推理过程:列出你检查了哪些指标、排除了哪些假设")
        String reasoning,
        @Description("判定结论")
        String conclusion,
        @Description("置信度:high / medium / low;证据不足时给 low,不要强行下结论")
        Confidence confidence) {
}
这么写一步到位:reasoning 先于 confidence 生成,CoT 被固化进字段;排查时 reasoning 直接可查,不用翻散落的日志;评测时 confidence 能批量统计"什么情况下模型会给 low"——这是 Agent 评测里最难拿到的一手数据。
Tip
给模型留一个"我不确定"的出口:如果你把 schema 约束成只能输出确定答案,模型不确定时就会编一个出来。 加一个
null或UNKNOWN枚举值让它能诚实弃权,比逼它胡说要好控制得多。
总结:你递出去的四样东西
回到最开始的类比,四种"范式"其实是四件不同的工具:
- CoT —— 一支笔。 让它把草稿写出来,中间结果就成了可见输入。
- ReAct —— 一部电话。 让它能在推理中途打给外部世界,把事实取回来。
- ToT —— 一张可擦的草稿纸。 允许它同时想几个方向,允许它擦掉重来。
- 结构化输出——一张标准表格。 让它写在格子里,你的程序才接得住。
推理范式的升级,从来不是"让模型变聪明",而是让它的推理过程获得默认状态下没有的东西:草稿、事实、回溯,和约束。
落地顺序也就很清楚了:先用一句"让我们一步步思考"试试——它一分钱不花,却能让同一个模型的正确率翻好几倍。不够,就按 ReAct → ToT 的顺序往上加;并且在第一步就把输出结构定下来,让每一步推理都落进字段里。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
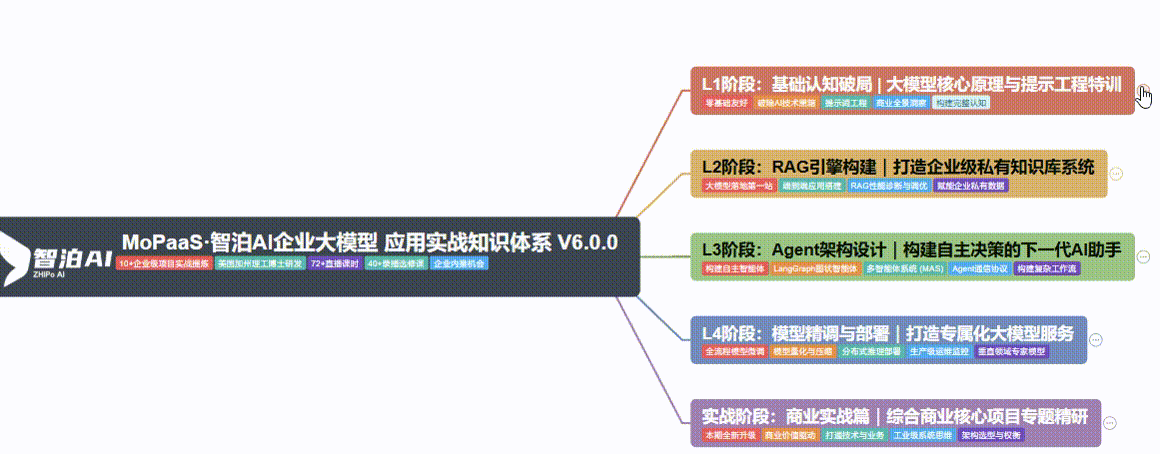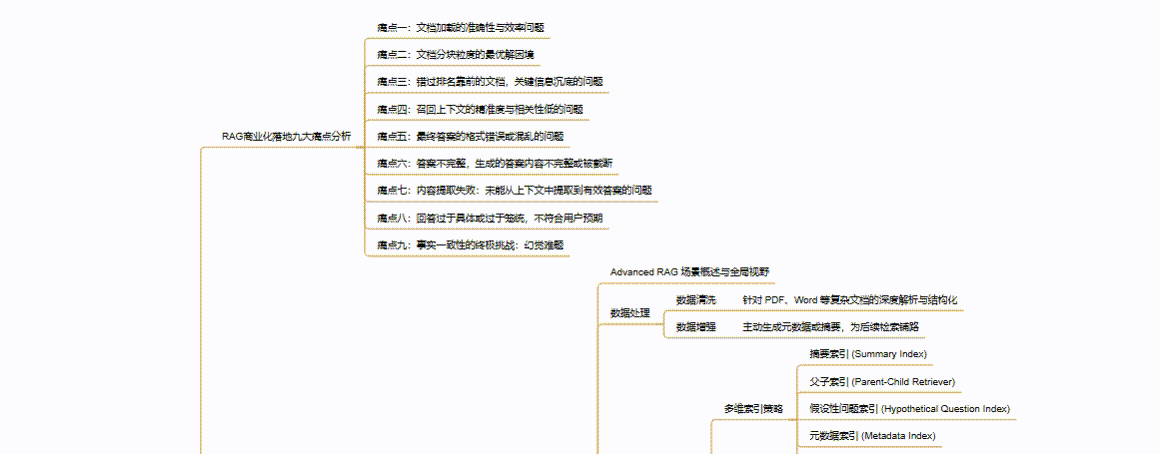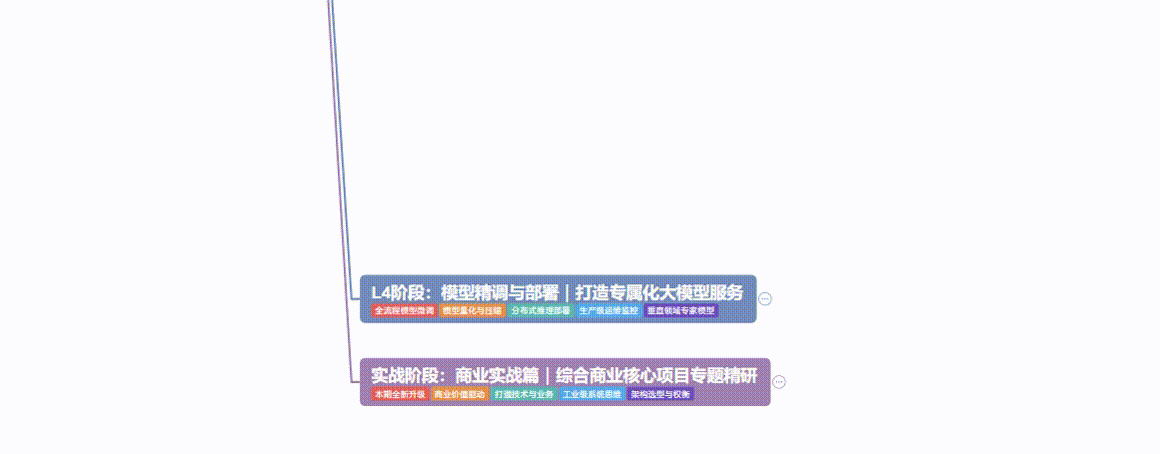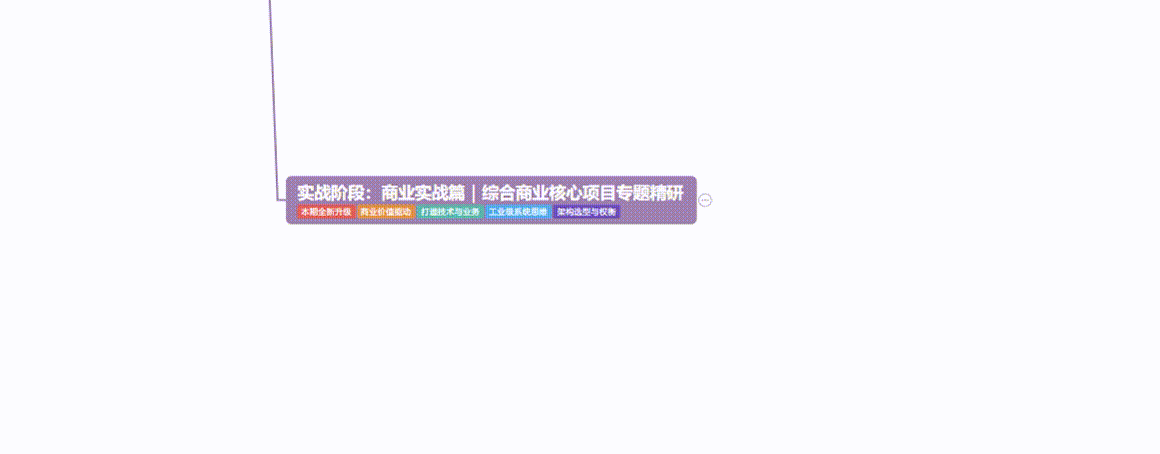
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
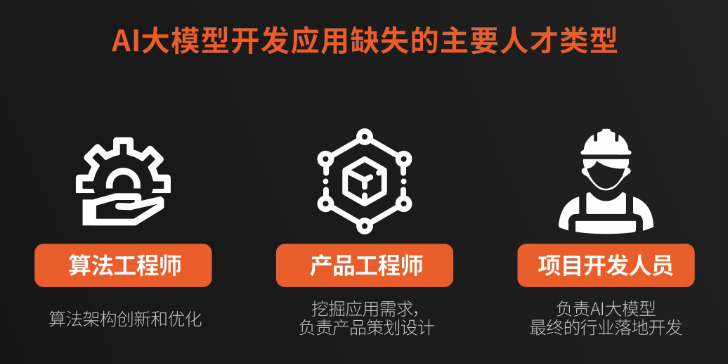
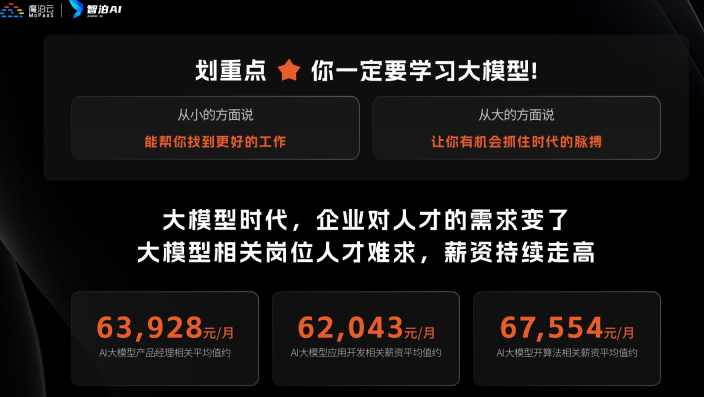
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
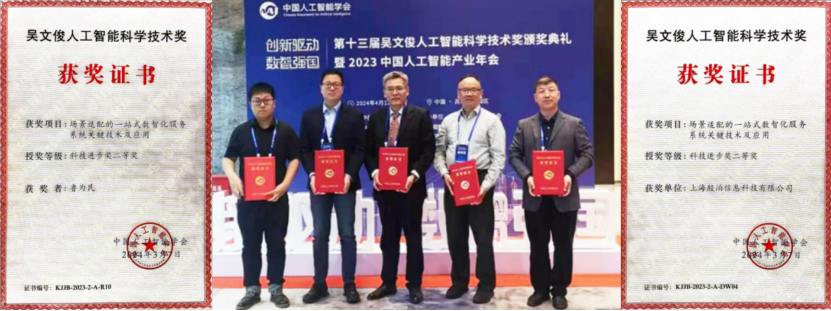
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


 扫一扫


 6万+

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


