2 大数据电商数仓项目——项目需求及架构设计

开发者福利!热门AI工具限时免费用 购周边即赠Coding Plan Lite,Claude Code、Cursor等20+工具畅享,效率翻倍! 阅读详情

2 大数据电商数仓项目——项目需求及架构设计

2.1 项目需求分析

  1. 用户行为数据采集平台搭建。
  2. 业务数据采集平台搭建。
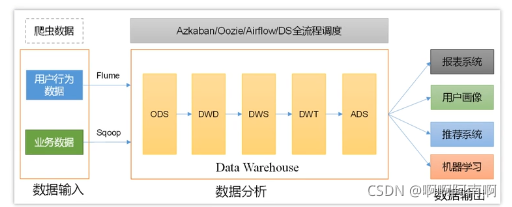
  3. 数据仓库维度建模(核心):主要设计ODS、DWD、DWS、AWT、ADS等各个层的具体功能与实现方法。
  4. 分析设备、会员、商品、地区 、活动等电商核心主题,统计的报表指标近100个。
  5. 采用即席查询工具,随时进行指标分析。
  6. 对集群性能进行监控,发生异常需要报警。
  7. 元数据管理:最常用的是hive元数据以及存于MySQL中的,能够帮助实现任务调度中的可视化实现。
  8. 数据质量监控:主要是监控数据的变化与以及质量分析。
  9. 权限管理。
    在这里插入图片描述

2.2 项目架构

2.2.1 技术选型

那么根据以上需求我们提出的思考问题:

  1. 项目技术如何选型?
    技术选型主要考虑因素:数据量大小、业务需求、行业内经验、技术成熟度、开发维护成本、总成本预算

数据采集传输: Flume(用户行为数据)、Kafka(较大数据量时可以先缓冲数据)、Sqoop(业务数据)、Logstash(简单的日志数据)、DataX(业务数据)。
数据存储: MySQL(小量数据存储,如ADS查看报表)、HDFS(海量数据存储,如DWD)、HBase(存储kylin多维分析)、Redis(主要用于实时计算)、MongoDB(如存储爬虫数据,需要同步到数仓里)。
数据计算: Hive、Tez、Spark、Flink、Storm。放在不同的引擎中,计算速度等会有所不同。
数据查询: Presto(快速离线查询)、Kylin(离线查询)、Impala、Druid(快速实时查询)、ClickHouse(实时查询)、Doris。
数据可视化: Echarts(开源免费)、Superset、QuickBI(离线)、DataV(实时快速)。
任务调度: Azkaban(中小企业适用,易上手)、Oozie、DolphinScheduler(国内开源)、Airflow(Python)。
元数据管理: Atlas。
权限管理: Ranger、Sentry。
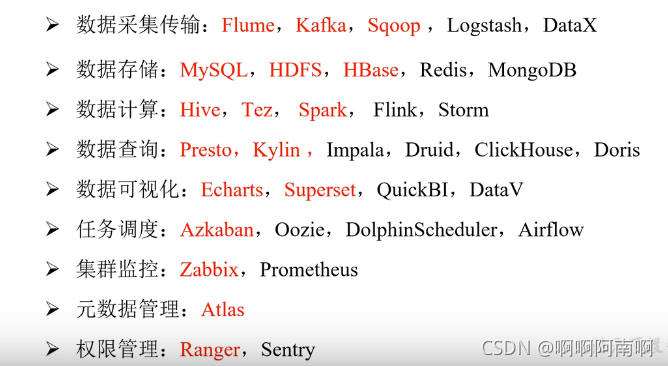
标红的一般是比较主流易上手的,也是本项目中几乎用到的。

  • 框架版本如何选型(Apache、CDH、HDP)?
  • 服务器使用物理机还是云主机?
  • 如何确认集群规模?(确认服务器的大小以及数量)

2.2.2 项目流程设计

  • 项目需求
  • 集群规模
  • 服务器选型
  • 框架版本选型
  • 技术选型

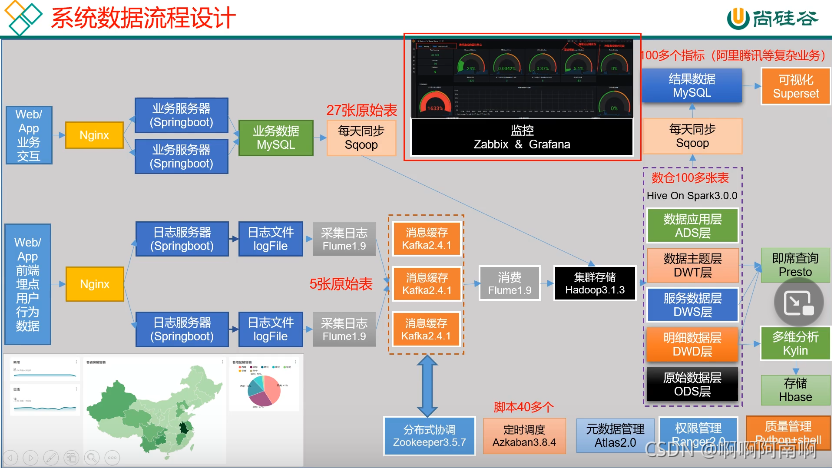
系统数据流程设计

思考问题:

  • flume采集日志: flume组成、put事务、take事务、flume三个器、flume优化
  • kafka消息缓存: kafka基本信息、kafka挂了、kafka丢了、kafka重复、kafka积压、kafka优化、kafka高效读写原因。
  • zookeeper分布式协调: 部署多少台、内部选举机制。
  • HDFS: Har归档、CombineTextInputformat、JVM重用。
  • sqoop数据同步: 需要考虑常出现的空值、一致性、数据倾斜问题,以及每天导入的数据量、执行时间。
  • hive on spark: 数仓分层。
  • klyin多维分析: 其处理后的数据存储在HBase中。
    系统框架图

2.2.3 框架版本选型

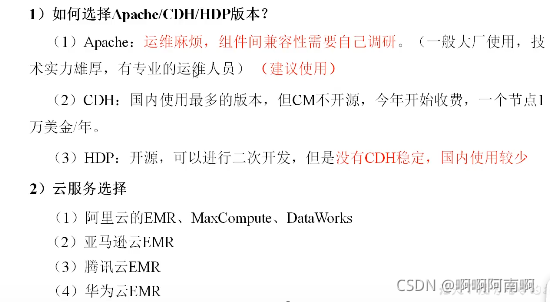
见下图所示:
框架发行版本选型其中,EMR框架只需要直接选择相应框架的数量等即可一键搭建与部署;MaCcomputer、DataWorks提供独立于EMR之外的一个数据分析框架。

具体版本型号:(以Apache为例)
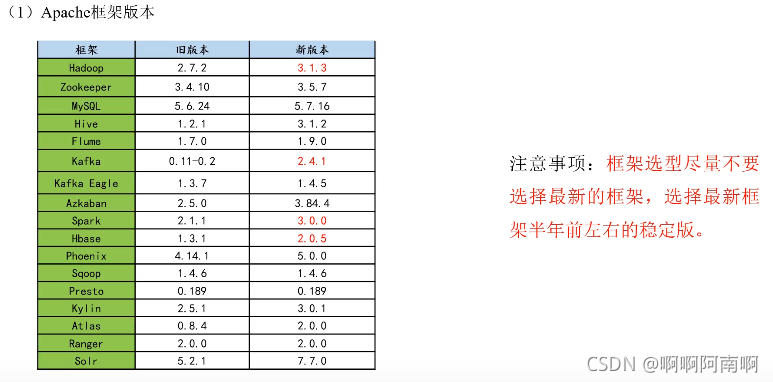
在这里插入图片描述

2.2.4 服务器选型

服务器选物理机还是云主机?
物理机:
一般物理机寿命5年左右,需要专业的运维人员以及考虑电费、放置环境等,一般有长期打算且资金充足的企业会选择物理机。
云主机:
几乎不需要考虑运维工作等因素,直接付费就可以使用,十分适合短期使用,可以即使释放资源。

2.2.5 集群规模

  1. 如何确认集群规模?(假设:每台服务器8T磁盘,128G内存)
    (1)每天日活跃用户100万,每人一天平均100条:100万100条=1亿条
    (2)每条日志1K左右,每天1亿条:100000000/1024/1021=约100G
    (3)半年内不扩容服务器来算:100G
    180天=约18T
    (4)保存3个副本:18T3=54T
    (5)预留20%~30%Buf=54T/0.7=77T
    (6)算到这:约8T
    10台服务器
    2.如果考虑数仓分层?数据采用压缩?需要重新再计算

集群资源规划设计

在企业中通常会搭建一套生产集群和测试集群,生产集群运行生产任务,测试集群用于上线前代码编写和测试。

生产集群规划原则:

  1. 消耗内存的分开,如Hadoop的nn和rm
  2. 数据传输数据比较紧密的放在一起(如kafka、zookeeper)
  3. 客户端尽量放在一到两台服务器上,方便外部访问(如hive和spark)
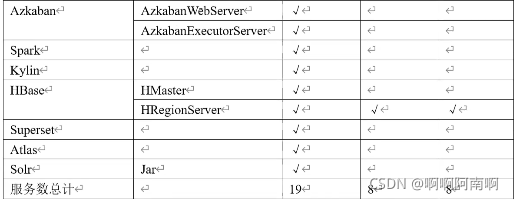
  4. 有依赖关系的尽量放到同一台服务器(例如Hive和Azkaban Executor)
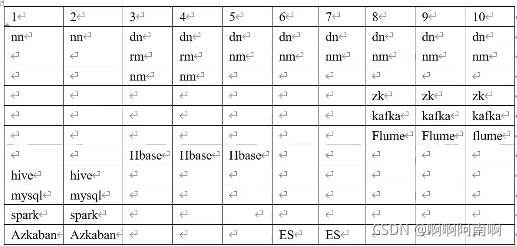
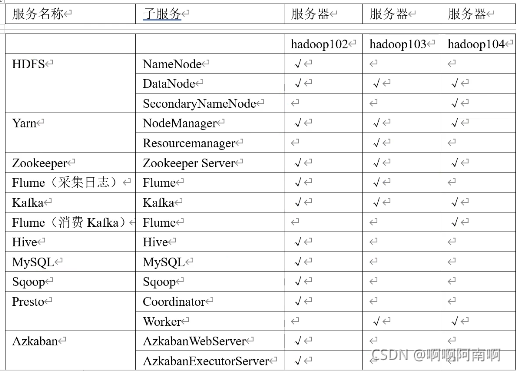
    以10台服务器为示例测试集群服务器规划:

一般测试集群三台服务器即可。
测试集群示例(1)测试集群示例(2)下一章,我们将开始介绍数据生成模块的实现。

尚硅谷大数据项目商数5.0】学习笔记 阅读详情

相关推荐

商数项目总结

数据采集:Flume,Kafka,Datax数据存储:Mysql,HDFS数据计算:Hive,Saprk任务调度:DolphinScheduler数据可视化:Superset高可用:Zookeeper别克商城分PC、WAP、微信小程序埋点PC、WAP为自动埋点 微信小程序为手动埋点浏览(页面加载的时候)点击(点击页面某个点位)停留(近入下一个页面或者离开当前页面时在当前页面的停留时间)曝光 (开屏、轮播等显示日志) 用来算 CTR(Click-Through-Rate) 点击通过率留资、订单关联 (在

qq_42575907的博客 4973

项目实战01:商数架构介绍

1.数分层概述 数据库分为三层,自下而上为: 数据引入层(ODS,Operation Data Store) 数据公共层(CDM,Common Data Model) 数据应用层(ADS,Application Data Service) 数据引入层(ODS,Operation Data Store):将原始数据几乎无处理的存放在数据库系统,结构上与源系统基本保持一致,是数据库的数据准备区。 数据公共层(CDM,Common Data Model,又称通用数据模型层),包含DIM维度表、DWD

qq_28286027的博客 2699

商数(dws 层)

一、dws 层介绍 统计各个主题对象的当天行为,服务于 DWT 层的主题宽表,以及一些业务明细数据,应对特殊需求(例如,购买行为,统计商品复购率)。 二、dws 层用户行为数据 2.1 每日设备行为 dws_uv_detail_daycount 1、介绍 每日设备行为,主要按照设备 id 统计。 2、数据来源 dwd_start_log 3、建表 drop table if exists dws...

a1786742005的博客 6250

【离线数面试】数架构:架构、输入输出、流程、框架选型及版本、项目集群规模、分层架构、分层原因...

1、数架构介绍 神策数据: 云上数:https://www.aliyun.com/solution/datavexpo/datawarehouse 2、数的输入输出 输入系统:用户埋点行为数据、后台产生的业务数据、爬虫数据。 输出系统(BI):报表系统、大屏展示、用户画像系统、推荐系统 3、系统流程 4、框架选型 1)Apache:运维麻烦,需要对组件兼容性进行维护 2)CDH:国内使用...

USTSD的博客 413

数据项目-整体架构

1.1技术选型 数据采集:flume 存储平台:hdfs 基础设施:hive(数据库基础设施) 运算引擎:mapreduce/spark 资源调度:yarn 任务调度:azkaban/oozie 元数据管理:atlas(或自研系统) OLAP引擎:kylin/presto (或clickhouse) 前端界面:superset(或自研javaweb系统) 存储系统:底层存储HDFS, 产出存储(hbase,elastic search,click house,kylin,mysql) 1,数..

. 1593

大数据项目商数、数据库概念、项目需求架构设计

比如用户在商网站中登录、下单、支付等过程中,需要和网站后台数据库进行增删改查交互,产生的数据就是业务数据。:用户在使用产品过程中,通过埋点收集与客户端产品交互过程中产生的数据,并发往日志服务器进行保存。数据库,并不是数据的最终目的地,而是为数据最终的目的地做好准备。这些准备包括对数据的:备份、清洗、聚合、统计等。(2)CDH:国内使用最多的版本,但CM不开源,今年开始收费,一个节点1万美金/年。2、框架版本如何选型(Apache、CDH、HDP)

Redamancy06的博客 7162

大数据项目商数一(用户行为采集)

是为企业所有决策制定过程,提供所有系统数据支持的战略集合。

2301_79478575的博客 1475

构建商数大数据项目实战代码解析

数据库(Data Warehouse,DW)是支持企业进行数据分析和决策的重要系统之一。商行业的数据库尤其关键,因为它能够整合和管理大规模的业务数据,为商企业提供有关客户、产品、交易和市场趋势的深入见解。这些见解对于提高运营效率、改善客户服务、增强市场竞争力以及开拓新的商业机会至关重要。在本章节中,我们深入了解了数据源的分类、特点和数据治理与质量管理的重要性。下一章,我们将探讨数据集成流程的重要性以及ETL/ELT技术和实际案例,敬请期待。

weixin_42097508的博客 1158

项目6.0(一)

数据同步工具种类繁多,大致可分为两类,一类是以DataX、Sqoop为代表的基于Select查询的离线、批量同步工具,另一类是以Maxwell、Canal为代表的基于数据库数据变更日志(例如MySQL的binlog,其会实时记录所有的insert、update以及delete操作)的实时流式同步工具。DataX的使用,用户只需根据数据的数据源和目的地选择相应的Reader和Writer,并将Reader和Writer的信息配置在一个json文件中,然后执行如下命令提交数据同步任务即可。

qq_58551342的博客 2811

大数据项目商数离线计算

本次项目是基于企业大数据商经典案例项目大数据日志以及网站数据分析),业务分析、技术选型、架构设计、集群规划、安装部署、整合继承与开发和web可视化交互设计。 1.系统数据流程设计 我这里主要分享下系统数据大致流通的过程。 商数据来源为两部分: 第一部分是java以及前端等程序员在网站做的埋点,用户点击产生的日志数据,通过springboot以及nginx等将数据分发到日志...

迷途的菜鸟 4869

[AI 生成] 大数据面试题

大数据面试精要】150字摘要 本文系统梳理大数据核心面试考点: 架构设计:分层建模(ODS/DWD/DWS/ADS)、实时离线方案对比(Flink vs Hive) 建模实战:事实表三大类型(事务/周期/累积)、SCD解决方案(拉链表实现) 性能优化:数据倾斜处理(两阶段聚合/MapJoin)、存储策略(ORC/Parquet选型) 新技术:湖一体(Hudi/Iceberg)、OLAP引擎(ClickHouse/Doris对比) 生产案例:亿级数据同步优化、实时维度更新方案 涵盖建模方法到调优实

水帘洞天 1239

实时商数建设V4.0

基于Lambda架构的实时商数建设

ytp552200ytp的博客 921

大数据项目商数(用户行为采集平台)

大数据项目商数(用户行为采集平台) 版本:V5.0 第1章 数据库概念 数据库(Data Warehouse),是为企业制定决策,提供数据支持的。可以帮助企业,改进业务流程、提高产品质量等。 数据库的输入数据通常包括:业务数据、用户行为数据和爬虫数据等 业务数据:就是各行业在处理事务过程中产生的数据。比如用户在商网站中登录、下单、支付等过程中,需要和网站后台数据库进行增删改查交互,产生的数据就是业务数据。业务数据通常存储在MySQL、Oracle等数据库中。 用

qq_42042882的博客 1123

大数据商数(1) | 项目需求架构设计

目录项目需求项目框架技术选型系统数据流程设计框架版本选型服务器选型集群资源规划设计 项目需求 一、项目需求 ➢1、 数据**采集平台搭建** ➢2、 实现**用户行为数据库的分层搭建 ➢3、 实现业务数据库的分层搭建 ➢4、针对数据库中的数据进行,留存、转化率、GMV、复购率、活跃等报表分析** 二、思考题 ➢1、 项目技术如何选型 ? ➢2、框架版本如何选型( Apache、 CDH、HDP) ➢3、 服务器使用**物理机还是云主机? ➢4、 如何确认集群规模**? (假设每台服务器8T硬盘) 项目

Knight 1742

视频教程-大数据商数项目-大数据

大数据商数项目 尚硅谷讲师,辽宁工程技术大学硕士,曾先后就职于交大思诺...

weixin_32310825的博客 763

商数项目

3 商数库系统 内部表与外部表的区别: 删除内部表时,会把元数据和原始数据全部删除;删除外部表时,只删除元数据,原始数据保留 什么场景创建内部表?外部表 多人使用的表创建外部表 自己用的临时表创建内部表 ...

Bingmous的博客 572

【尚硅谷】商数V4.0丨大数据数据项目实战【学习记录】第一节

【尚硅谷】商数V4.0丨大数据数据项目实战【学习记录】思考问题?1. 为什么用hive on spark来处理数据?1. 数据库概念1.1 原始数据备份到ODS中1.2 DWD完成数据的清洗1.3 join形成大的分表(DWS,DWT)1.4 ADS 结果报表1.5 输出1.5.1 报表系统1.5.2 用户画像1.5.3 推荐系统1.5.4 机器学习2. 项目需求架构设计2.1 项目需求2.2 项目框架2.2.1 技术选型2.2.2 系统数据流程设计2.2.3 框架发行版本选型2.2.4 服务器

prague6695的博客 2877

尚硅谷数据库实战之1项目需求架构设计

笔记 数据库和数据集市详解:ODS、DW、DWD、DWM、DWS、ADS 尚硅谷数实战之1项目需求架构设计 尚硅谷数实战之2分层+维度建模 尚硅谷数实战之3数搭建

weixin_42526326的博客 4415

商数(用户行为数据采集)

bin/bash case $1 in "start"){ for i in hadoop102 hadoop103 hadoop104 do echo ---------- zookeeper $i 启动 ------------ ssh $i "/opt/module/zookeeper-3.5.7/bin/zkServer.sh start" done };元数据层面:每个小文件都有一份元数据,其中包括文件路径,文件名,所有者,所属组,权限,创建时间等,这些信息都保存在Namenode内存中。

weixin_39458365的博客 859
上一篇: 1 大数据电商数仓项目——数仓概念
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值