




 博客详细介绍了如何解决poj1273 Drainage Ditches问题,即从池塘到小溪的最大排水量计算。文章通过实例解释了EKarp算法的核心思路,包括利用反向边避免超容量问题,以及在BFS中寻找增广路和更新流量的过程。同时,博主分享了对Dinic算法的理解,强调其通过BFS分层和DFS递归寻找增广路径,从而提高效率。这两种算法都体现了对最满意结果的贪心思想,并探讨了反向边在提供“后悔”机会中的作用。
http://poj.org/problem?id=1273
题意:农夫的田野每次一到下雨就会被淹没,这让他很苦恼。于是修了好多渠沟,编号为1作为池塘,编号为n作为小溪,求从池塘到小溪的最大排水量。
ps:最大流第一题。
思路:花了一段时间来入门,这个是EKarp的教程,并且参考了这个代码。现在感觉这个算法好神奇。首先扩展方式精辟,按照我们普通的想法,每找到一条增广路,就将其加上求得源点的最大流。但是这样离源点近路的流量就有可能超过容量限制,解决办法自然是加判断条件。但是每一条都判断很麻烦,所以就索性变成容量相减的形式,这种减容量的方法明显要强于加流量。
整体思路是用bfs找增广路,并记录前驱。找到后逆向往回找增广路流量。流量求出后再逆向往回分别对正反流量更新。总的来说所有操作都在一个bfs操作里进行,bfs是主线。
不过最精辟的还是反向边的建立,我们再拿神图来说明:
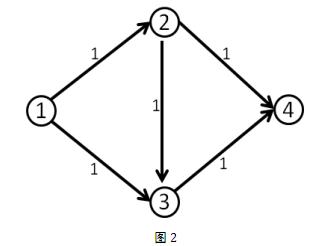
通过原博客的分析,走了1234这条路,就无法走其他的路了。换句话说,本来124和134最大流为2的方案变成了1。根本原因就是没有一个后悔的机会,而建立反向边就可以解决,相当于退回流量。
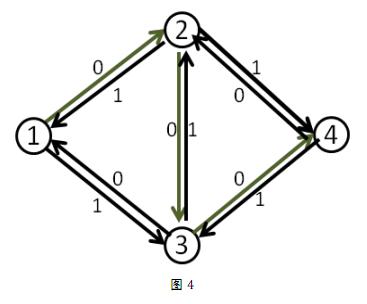
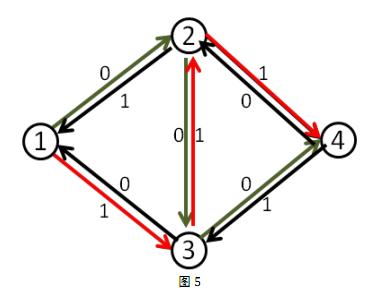
加一点我自己的理解,打个比方两个人AB是敌人,都想通过自己的方案来得到一种物品,但过程是坎坷的。A走到一半发现B的方案比自己好,以为自己得不到想要的,就中途放弃自己的抢了B的方案。看吧,本来两个人都能得到这种物品(上帝视角),被A捣乱的只有一个人能得到,但是如何能达到原来最满意的效果呢?B表示不想和A讲话并向A扔了一坨屎,然而A依旧不让步,可怜的B没办法了,就想,你抢我的方案,那我也能抢你的啊,于是接手了原先A放弃的方案。A不知道原来自己的方案也能成功,所以勤恳的B按照自己的方案和自己同时获得了物品。当然这前提是AB原本的方案都可行,如果原本A不可行B可行,那AB就只能打架了,然而不管谁赢最满意的结果也都是一个人获得。
感觉自己叙述的有点辣鸡,多看看那个大牛的博客,自己模拟一下就好~本质上还是比较像贪心思想的,因为想达到最满意的结果嘛。
#include <stdio.h>
#include <algorithm>
#include <stdlib.h>
#include <string.h>
#include <iostream>
#include <queue>
#include <stack>
#include <ctype.h>

using namespace std;

typedef long long LL;

const int N = 1005;
const int INF = 0x3f3f3f3f;

int cap[N][N], pre[N];//cap表示每条路的容量
bool vis[N];
int n, m;

int EKarp()
{
    int num = 0;//最大流
    while(1)
    {
        queue<int>que;
        memset(vis, false, sizeof(vis));
        memset(pre, 0, sizeof(pre));
        que.push(1);
        vis[1] = true;
        while(!que.empty())
        {
            int cnt = que.front();
            que.pop();
            if(cnt == n) break;
            for(int i = 1; i <= n; i++)
            {
                if(!vis[i] && cap[cnt][i]>0)//未被访问并且这路容量大于0,可以走
                {
                    vis[i] = true;
                    que.push(i);
                    pre[i] = cnt;
                }
            }
        }
        if(vis[n] == false) break;//做完了搜索仍然没有到达汇点,那么就说明找不到增广路了
        int minf = INF;
        //逆向往回找不超过这整条路任一段限制的最大流量,也就是增广路
        for(int i = n; i != 1; i = pre[i])
        {
            minf = min(minf, cap[pre[i]][i]);
        }
        //逆向往回更新容量,将其路上每一段的容量减去增广路流量
        //注意流量加一通过将其看成容量减一,以方便程序实现
        for(int i = n; i != 1; i = pre[i])
        {
            cap[pre[i]][i] -= minf;//正向容量减去增广路的容量,表示已经流过
            cap[i][pre[i]] += minf;//反向容量加上增广路的容量,表示退回流量新建一条路,给“潜在的路”一次选择的余地
        }
        num+=minf;
    }
    return num;
}

int main()
{
   // freopen("in.txt", "r", stdin);
    int s, t, w;
    while(~scanf("%d%d", &m, &n))
    {
        memset(cap, 0, sizeof(cap));
        for(int i = 1; i <= m; i++)
        {
            scanf("%d%d%d", &s, &t, &w);
            cap[s][t] += w;//重边
        }
        int ans = EKarp();
        printf("%d\n", ans);
    }
    return 0;
}
Dinic算法:
ps:这个模板理解+变成自己的几乎总结了一天,归根结底还是对两种搜索结合的邻接表示不熟悉吧。
思路:首先是教程,参考了这个代码。整体思路是先用bfs将可以增广的路分层,然后用dfs在已经分层的基础上按照层次递归。这样dfs相当于O(n)的复杂度,整体还是bfs最费时间,但是相对于Ekarp多了分层减去了好多不必要的操作,所以从16ms减到了0ms~。里面的反向边同样是“后悔”的操作,和上面的原理一样,理解了就不觉得难了。但是说是这么说的,具体实现我认为挺繁琐的,看代码里的注释吧。
#include <stdio.h>
#include <algorithm>
#include <stdlib.h>
#include <string.h>
#include <iostream>
#include <queue>
#include <stack>
#include <ctype.h>

using namespace std;

typedef long long LL;

const int N = 1005;
const int INF = 0x3f3f3f3f;

int head[N], dis[N], cur[N];//dis代表层数
bool vis[N];
int n, m, cnt;

struct Edge
{
    int to, cap, flow, next;
}edge[N*2];

void add(int u, int v, int w)//双向加边
{
    edge[cnt] = (struct Edge){v, w, 0, head[u]};
    head[u] = cnt++;
    edge[cnt] = (struct Edge){u, 0, 0, head[v]};//反向容量设为0
    head[v] = cnt++;
}

bool bfs(int start, int endd)
{
    memset(dis, -1, sizeof(dis));
    memset(vis, false, sizeof(vis));
    queue<int>que;
    dis[start] = 0;//起点入队列,是第0层
    vis[start] = true;
    que.push(start);
    while(!que.empty())
    {
        int u = que.front();
        que.pop();
        for(int i = head[u]; i != -1; i = edge[i].next)
        {
            Edge E = edge[i];
            if(!vis[E.to] && E.flow<E.cap)//若没被访问过且有可以增广的流量,则将下一个节点定义为下一层
            {
                dis[E.to] = dis[u]+1;
                vis[E.to] = true;
                if(E.to == endd) return true;//如果到终点了,则返回已经找到了路
                que.push(E.to);
            }
        }
    }
    return false;//没找到就返回false
}

int dfs(int x, int res, int endd)//x代表递归那一层的层号,res代表可增流量空间的大小,endd代表终点
{
    if(x==endd || res==0) return res;//到达终点或者没有可增流量,返回还可以增加的流量
    int flow = 0, f;//flow代表增广路的流量,每次递归返回此值。f代表上次递归回来的流量,只是个中介。
    for(int& i = cur[x]; i != -1; i = edge[i].next)
    {
        Edge E = edge[i];
        if(dis[E.to]==dis[x]+1)
        {
            //如果符合比上一层低才能进行下一层操作
            f = dfs(E.to, min(res, E.cap-E.flow), endd);//往下递归并更新流量
            if(f>0)//如果返回的流大于0
            {
                edge[i].flow+=f;//正向加流量
                edge[i^1].flow-=f;//反向减流量
                flow+=f;//增广路流量加上
                res-=f;//剩余可增空间流量减去
                if(res == 0) break;//减去后如果没有剩余,则停止继续递归
            }
        }
    }
    return flow;//返回当前增广路的流量
}

int max_flow(int start, int endd)
{
    int flow = 0;
    while(bfs(start, endd))//只要可以找到他的增广路,就把他的流量加上
    {
        memcpy(cur, head, sizeof(head));
        flow += dfs(start, INF, endd);
    }
    return flow;
}

void init()
{
    cnt = 0;
    memset(head, -1, sizeof(head));
}

int main()
{
   // freopen("in.txt", "r", stdin);
    int s, t, w;
    while(~scanf("%d%d", &m, &n))
    {
        init();
        for(int i = 1; i <= m; i++)
        {
            scanf("%d%d%d", &s, &t, &w);
            add(s, t, w);
        }
        int ans = max_flow(1, n);
        printf("%d\n", ans);
    }
    return 0;
}


 扫一扫


&spm=1001.2101.3001.5002&articleId=52910920&d=1&t=3&u=6b0da54d3c0b4f44aad0ee5bcff67a0e)
 276

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


