


文章目录
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看, 传送门https://blog.csdn.net/HHX_01
前言
先问一个送命题:手上有六个字符串,想拼成一句完整的话,你打算怎么写?
正常人:for 循环加个加号,三分钟收工。
我:先造两个 DMA 通道,配一个环形缓冲,再给它们拴一根链子,让硬件自己干,CPU 全程在旁边喝茶。
对,我就是那种能把一秒钟的活干成一下午的人。
但你先别急着笑。这个实验跑通的那一刻,我甚至觉得 CPU 终于活成了我理想中的样子——上班不用干活,全靠下属自觉。
1. 这实验到底在干嘛
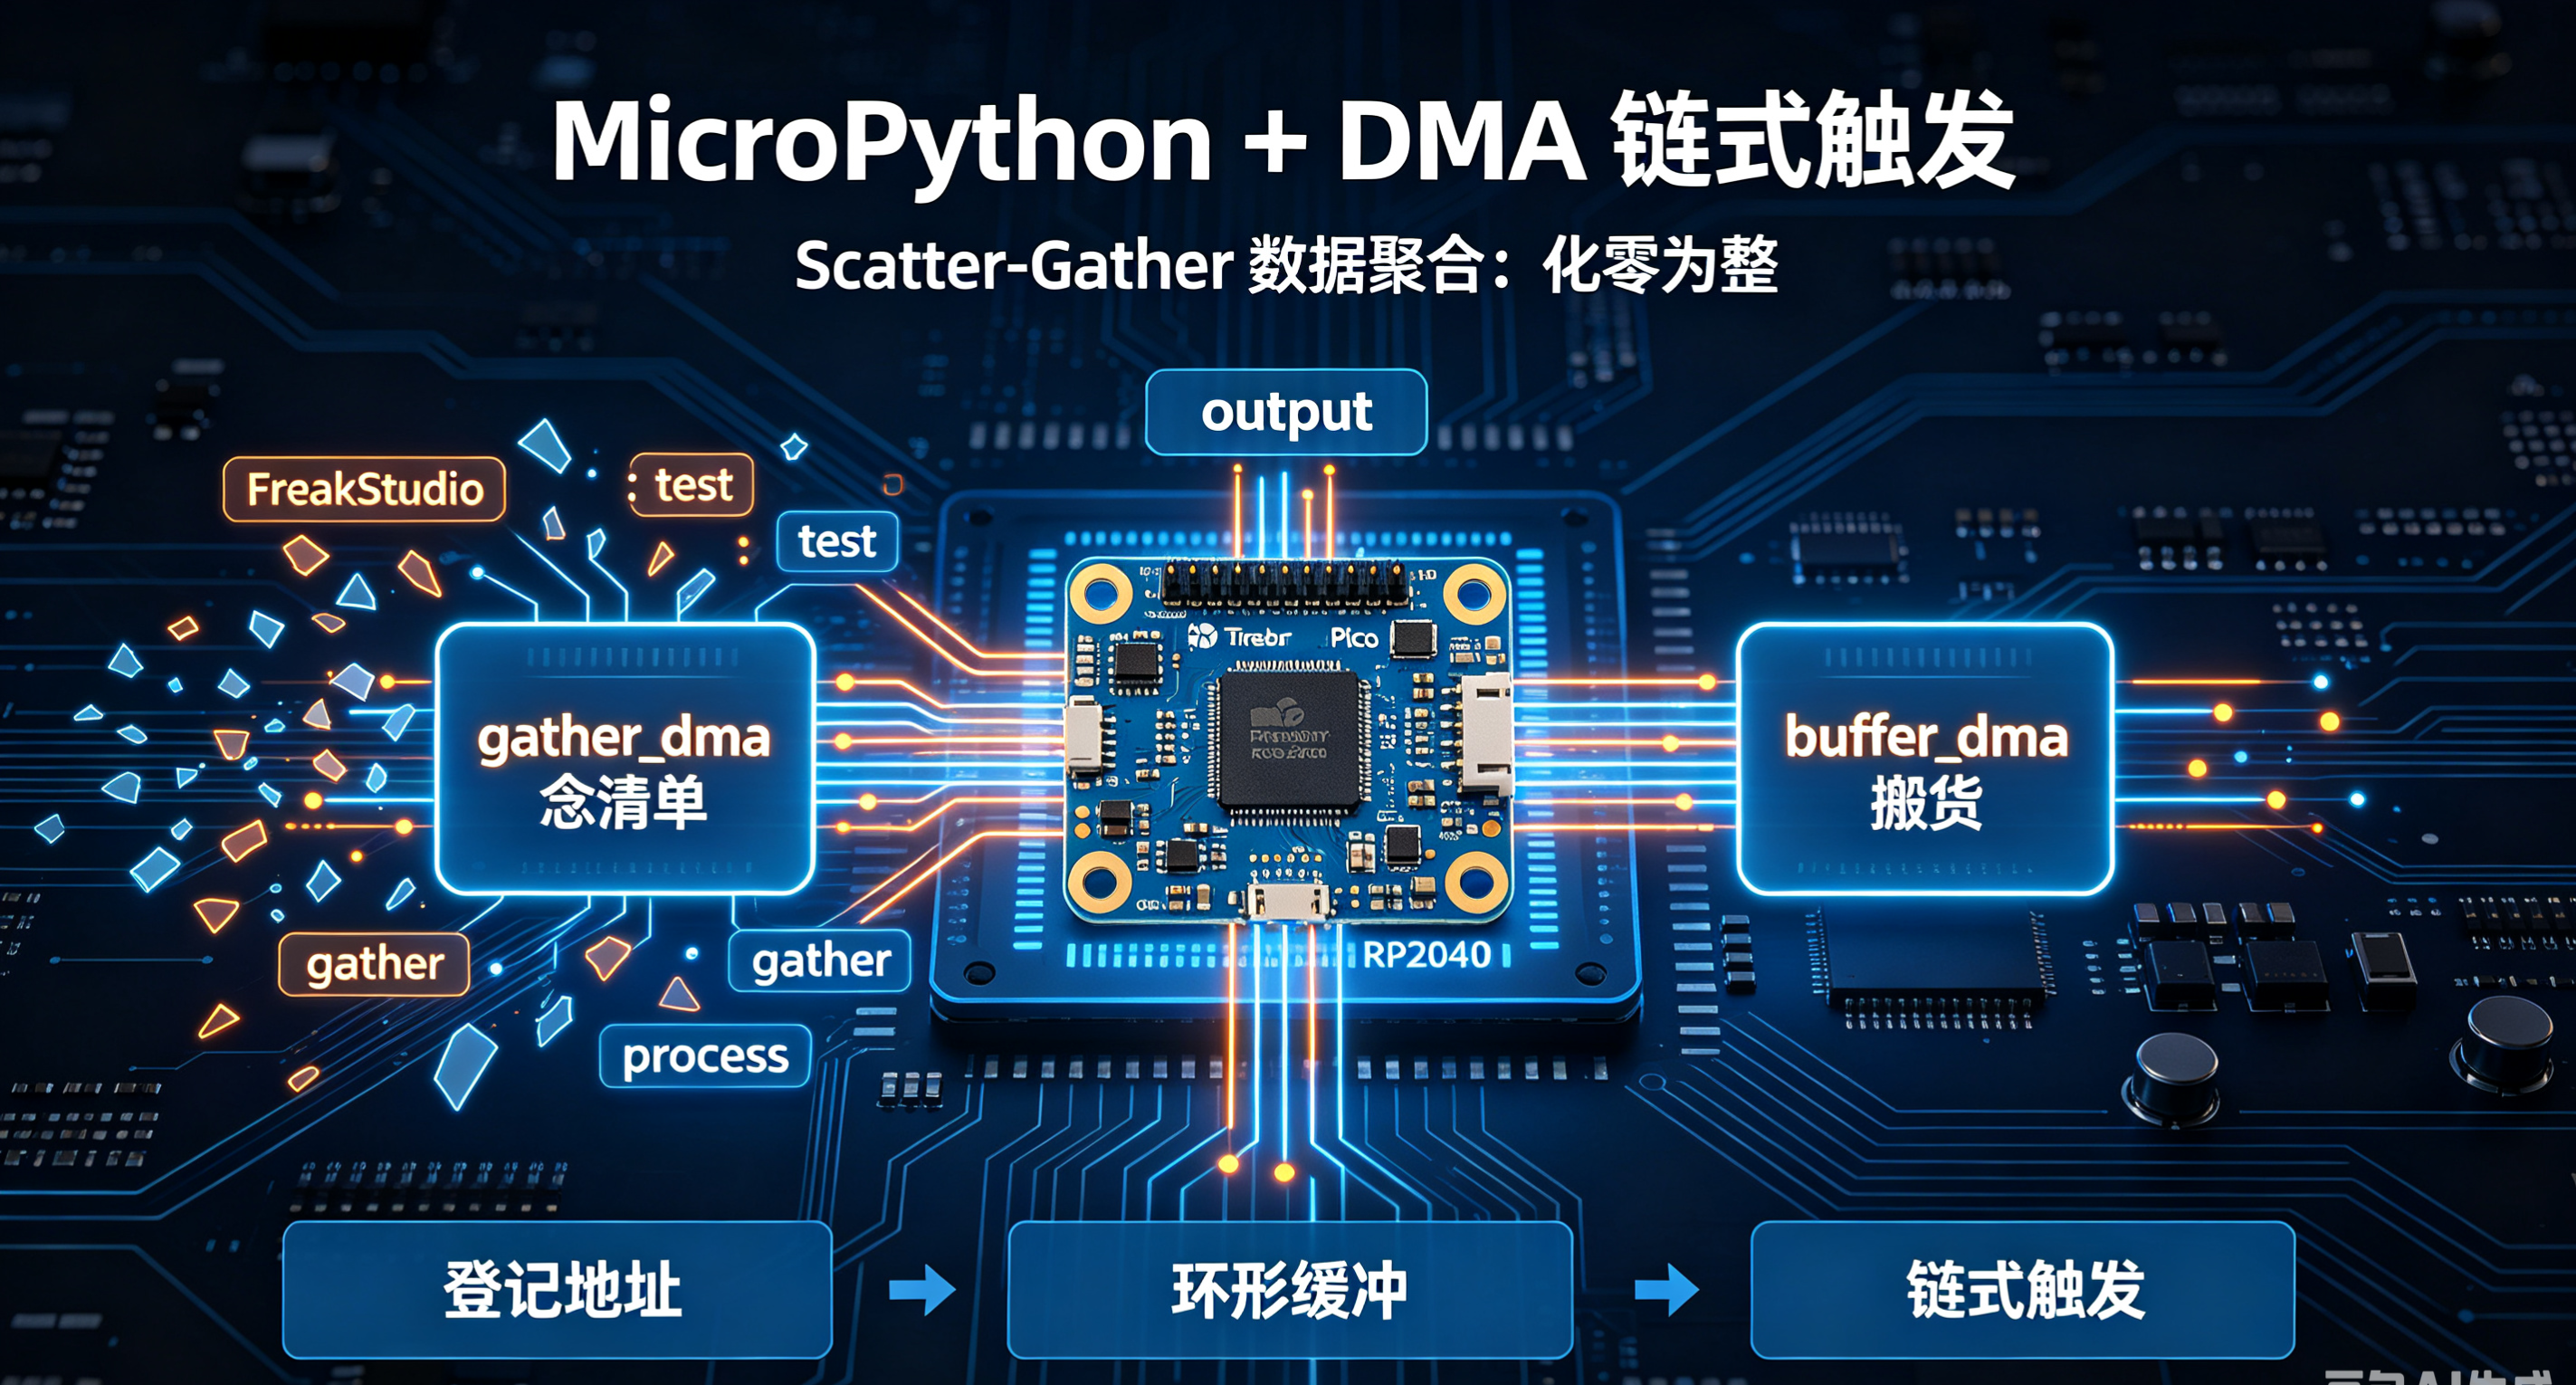
先把需求说成人话:散落在内存各个角落的字符串,要聚到一个缓冲区里,拼成一句完整的话。专业术语叫 Scatter-Gather,翻译过来就是四个字:化零为整。
这跟把散落一地的乐高零件收进一个盒子,本质上是同一件事。区别在于:乐高收错了顶多拼不出城堡,内存地址搞错了,轻则乱码,重则直接重启。两种我都见过,都很精彩。
1.1 为什么不让 CPU 亲自搬
理论上,这活 CPU 三行代码就能干完。但你想,CPU 什么身份?嵌入式世界的老板。
老板的职责是开会、拍板、应对突发状况——对应到单片机,就是跑主循环、处理中断、响应按键。你让老板亲自搬砖,一次搬六块,它累不累先不说,ADC、UART、定时器这些员工全在工位上干等,生产线直接停摆。
所以正确的职场逻辑是:老板把活儿派给中层(DMA),中层自己调度,老板只需要在验收的时候说一句"干得不错"。
1.2 双人组合:一个动嘴,一个动手
整个方案的核心是两个 DMA 通道,分工明确,谁也不越界:
- gather_dma:负责念清单。每个字符串多长、住在哪个地址,它一项一项报。
- buffer_dma:负责搬货。听到地址就去取货,搬到目标缓冲区放下。
一个动嘴,一个动手。这组合让我想起我和我同事的日常:他负责说"这活很简单",我负责加班。
2. 准备工作:内存里的通讯录
2.1 gather_list:登记个人信息
开工之前,先把六个字符串的"个人信息"登记到一张表里,也就是 gather_list 数组。登记格式很讲究:长度、地址、长度、地址……成对出现。
长度用 len(s),地址用 addressof(s)。注意,addressof 拿到的是字符串在内存里的门牌号,不是家门口的快递柜号。搞混了,DMA 会跑去邻居家搬货。
2.2 名单结尾的两个 0,是暗号
数组末尾追加了两个 0。这不是写嗨了顺手多打的,这叫空触发(Null Trigger)。
你可以把它理解为名单最后一行的"以上"。DMA 念到 0 就知道:名单念完了,收工。比领导的"我就简单说两句"可靠多了——它说停,是真停。
2.3 那两个神秘的寄存器
gather_dma 把数据写进哪?buffer_dma 的 14 号和 15 号寄存器。一个叫 TRANS_COUNT,管传输次数;一个叫 READ_ADDR_TRIG,管读取地址。
重点是这个 TRIG。往这个寄存器里写个非零值,buffer_dma 就自动开机干活。写地址等于按启动键,物理世界里按一下就行,这里写一下就启动,还挺讲道理。
3. 让 DMA 学会原地打转
接下来是最反直觉的部分:寄存器只有两个坑位,写一轮就得回到起点再写一轮。所以得给 DMA 开跑步机模式:环形缓冲(ring mode)。跑完一圈自动回到原点,永远在同一台跑步机上踩步。
3.1 ring_size=3:强迫症的胜利
ring_size=3 是什么意思?2 的 3 次方等于 8,也就是 8 字节对齐。传输粒度是 4 字节(size=2 表示 32 位),一次传两个(count=2),凑成一对正好 8 字节。
为什么非要是 8?因为每一对数据——长度占 4 字节,地址占 4 字节——加起来不多不少 8 字节,一对一个坑,整整齐齐。
我严重怀疑 DMA 硬件工程师当年也是强迫症:连对齐尺寸都算得让你挑不出毛病。
3.2 读地址前进,写地址原地踏步
ring_sel=True 的含义是:环形模式只对写地址生效。
读地址照常递增——念完一家换下一家;写地址原地打转——永远写进同一对寄存器。
一个负责前进,一个负责原地待命。这大概就是团队协作的真谛:有人往前冲,有人守在坑里,谁也别抢谁的活。
4. 链式触发:你干完,我上
现在到了全场最骚的操作:chain_to。
buffer_dma 的配置里写了 chain_to=gather_dma.channel。意思很直白:我干完这一单,自动把下一个同事喊醒,不用老板催。
这就叫链式触发。像接力赛,交接棒都不用喊,前一棒跑完,后一棒自己起跑。
4.1 完整流程,比流水线还流水线
把整个流程串起来看:
- CPU 把两个 DMA 都配置好,喊一声"开工"——
gather_dma.active(1)。 - gather_dma 从通讯录里念第一组:长度 + 地址。
- 数据写进 buffer_dma 的 14、15 号寄存器。写
READ_ADDR_TRIG这一步等于按下启动键,buffer_dma 立刻开跑。 - buffer_dma 按地址取货,按长度搬运,货物落进目标缓冲区。
- 搬完,链子自动触发,gather_dma 接着念下一组。
- 如此循环,直到撞上名单末尾的两个 0。
全程 CPU 就干三件事:配置、喊开工、然后站在旁边等。这要是在公司,属于典型的"领导已经把活安排明白了"。
5. 代码,拿去烧
废话不多说,完整代码在这。环境是 MicroPython v1.23.0,板子树莓派 Pico(RP2040)。代码里注释写得比我文章还细,重点看 gather_strings 这个函数,核心就五步:登记、配控制块、配链式、开工、干等。
# Python env : MicroPython v1.23.0
# -*- coding: utf-8 -*-
# @Time : 2024/9/8 上午11:04
# @Author : 李清水
# @File : main.py
# @Description : DMA类实验,外设到内存传输,DMA从ADC外设的FIFO传输数据到内存
# ======================================== 导入相关模块 =========================================
import time
from uctypes import addressof
from rp2 import DMA
from array import array
# ======================================== 全局变量 ============================================
# 定义了要拼接的字符串列表
input = ["FreakStudio", ":", "test", " of the scatter", " gather", " process"]
# 创建了 64 字节的目标缓冲区(bytearray),用于存储拼接后的字符串
output = bytearray(64)
# ======================================== 功能函数 ============================================
def gather_strings(string_list: list, buf: bytearray) -> None:
    """
    使用DMA将字符串列表中的字符串拼接并存入目标缓冲区。
    通过双DMA通道协作实现:
    1. gather_dma通道:传输字符串元数据(长度+地址)
    2. buffer_dma通道:实际数据搬运到目标缓冲区
    Args:
        string_list (list): 要拼接的字符串列表,元素应为MicroPython字符串类型
        buf (bytearray): 目标缓冲区,需预分配足够空间
    Returns:
        None
    Raises:
        ValueError: 如果输入参数类型不符合要求
        RuntimeError: 如果DMA传输过程中发生错误
    """
    # 声明两个DMA通道:gather_dma和buffer_dma
    gather_dma = DMA()   # 用来处理字符串长度和地址信息
    buffer_dma = DMA()   # 用来处理实际的数据复制
    # 声明一个整型数组,用来存放字符串的长度和内存地址
    gather_list = array("I")
    # 数据按顺序存储为:字符串长度、字符串地址
    for s in string_list:
        gather_list.append(len(s))         # 添加字符串长度
        gather_list.append(addressof(s))   # 添加字符串的内存地址
    # 打印gather_list中内容
    # gather_list: array('I', [11, 536906720, 1, 536904296, 4, 536904298, 15, 536906752, 7, 536904303, 8, 536904311])
    print("gather_list: ", gather_list)
    # 为了标记列表的结束(以0结尾),在列表末尾添加两个0
    # 实现空触发(Null Trigger),即向触发寄存器写入全0值的操作
    gather_list.append(0)
    gather_list.append(0)
    # 配置 gather_dma 传输控制寄存器
    # ring_size设置为3,表示8字节对齐;启用寄存器环形缓冲区
    gather_ctrl = gather_dma.pack_ctrl(ring_size=3, ring_sel=True)
    # 配置 gather_dma 通道,写入地址为TRANS_COUNT寄存器和READ_ADD_TRIG寄存器位于最后一个寄存器别名
    # 即 寄存器 14 和 15
    gather_dma.config(
        read=gather_list,                 # 读取gather_list数组
        write=buffer_dma.registers[14:16],  # 将数据写入buffer_dma的寄存器
        count=2,                          # 传输两个字节
        ctrl=gather_ctrl                  # 传输控制寄存器的设置
    )
    # 打印 gather_dma 传输控制寄存器中的参数
    # gather_ctrl: {'inc_read': 1, 'high_pri': 0, 'write_err': 0, 'ring_sel': 1,
    # 'enable': 1, 'treq_sel': 63, 'sniff_en': 0, 'irq_quiet': 1, 'read_err': 0,
    # 'chain_to': 0, 'busy': 0, 'inc_write': 1, 'ring_size': 3, 'bswap': 0, 'size': 2, 'ahb_err': 0}
    print("gather_ctrl:", gather_dma.unpack_ctrl(gather_ctrl))
    # 设置buffer_dma传输控制寄存器,单字节传输并配置链式传输
    # 当 buffer_dma 完成时会启动 gather_dma 进行下一个传输
    buffer_ctrl = buffer_dma.pack_ctrl(size=0, chain_to=gather_dma.channel)
    # 将目标缓冲区 buf 设为 buffer_dma 的写入目标,实际字符串数据会通过此 DMA 通道被写入 buf
    buffer_dma.config(write=buf, ctrl=buffer_ctrl)
    # 启动 gather_dma 的 DMA 传输
    gather_dma.active(1)
    # 计算 gather_list 的最后一个地址
    end_address = addressof(gather_list) + 4 * len(gather_list)
    # 不停地检查 gather_dma 是否完成了传输
    while gather_dma.read != end_address:
        pass
# ======================================== 初始化配置 ==========================================
# 上电延时3s
time.sleep(3)
# 打印调试信息,表示开始主程序
print("FreakStudio: DMA Chaining Triggers Test")
# ======================================== 主程序 ===========================================
# 打印目标缓冲区初始时数据
print(output)
# 使用DMA将字符串列表input中的字符串存入缓存数组output
gather_strings(input, output)
# 打印目标缓冲区最终数据
print(output)
至于那个 while gather_dma.read != end_address: pass——对,空语句,纯干等。我称之为"老板式监控":不看过程,只看结果。
6. 跑起来看看
烧录、连串口、mpremote connect COM8,回车。屏幕上先滚出三样东西:
- 初始的目标缓冲区:全是 0,像一张没写完的作业。
- gather_list:一排长度和地址,数字大得像我银行卡余额的位数。
- gather_ctrl:一长串配置,谁看谁头大。
最后一行是拼好的字符串:
FreakStudio: DMA Chaining Triggers Test
bytearray(b'\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00')
gather_list: array('I', [11, 536906720, 1, 536904296, 4, 536904298, 15, 536906752, 7, 536904303, 8, 536904311])
gather_ctrl: {'inc_read': 1, 'high_pri': 1, 'write_err': 0, 'ring_sel': 1, 'enable': 1, 'treq_sel': 63, 'sniff_en': 0, 'irq_quiet': 1, 'read_err': 0, 'chain_to': 0, 'busy': 0, 'inc_write': 1, 'ring_size': 3, 'bswap': 0, 'size': 2, 'ahb_err': 0}
bytearray(b'FreakStudio:test of the scatter gather process\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00')
看到最后这行的瞬间,我差点从椅子上站起来。不是激动,是怕死机——毕竟我那个 while 循环还在那傻等着呢。
7. 图啥?图个安静
你可能会问:绕这么大一圈,就为了拼一个字符串?for 循环三行代码的事,你搁这儿表演杂技?
对,就是图个安静。
数据搬运这种"量大、无脑、重复"的活,交给 DMA 之后,CPU 就能腾出手来干正事——刷屏幕、解析协议、处理中断,样样都在排队等它。
说白了:重复劳动外包给硬件,CPU 只负责思考。这跟职场一个道理——琐事能甩就甩,精力留给能加薪的活。
最后提醒一句:别学我写 while 循环加 pass 干等。虽然它真能跑,但它也是真的傻。
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看,传送门https://blog.csdn.net/HHX_01


 扫一扫


 408

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


