


第一卷:大模型 基础篇
第3章 模型能力认知
第5节:AI到底怎么知道自己回答得好不好?——从大模型评测到Agent Evaluation
《Agent开发工程师成长指南》系列教程
引言
前面我们已经讨论了一个问题:
为什么同一个问题,AI每次回答可能都不一样?
我们知道,大模型本质上是一个概率系统。
因此,当你开始真正开发AI应用时,很快会遇到另一个更加现实的问题:
我做了一个AI应用
↓
感觉好像能用
↓
但是……
↓
它到底做得好不好?
例如,你开发了一个企业知识库助手。
测试时问:
公司的年假制度是什么?
AI回答:
员工根据工龄不同,可以享受不同天数的年假。
看起来没什么问题。
但是继续问:
工作满5年的员工,到底有几天年假?
AI可能回答:
10天。
再换一种问法:
我已经工作6年了,今年有多少年假?
它可能回答:
7天。
这时候你会发现:
AI不是简单的“能用”或者“不能用”。
它可能:
理解正确
但是答案不完整
也可能:
答案流畅
但是事实错误
还可能:
回答正确
但是没有使用正确的Tool
甚至:
最终答案正确
但是调用了10次Tool
成本极高
耗时20秒
那么问题来了:
AI到底怎么知道自己回答得好不好?
更准确地说:
我们应该如何评价一个LLM或者Agent到底做得好不好?
这就是:
Evaluation
也是从:
AI Demo
走向:
AI Engineering
必须跨越的一道门槛。
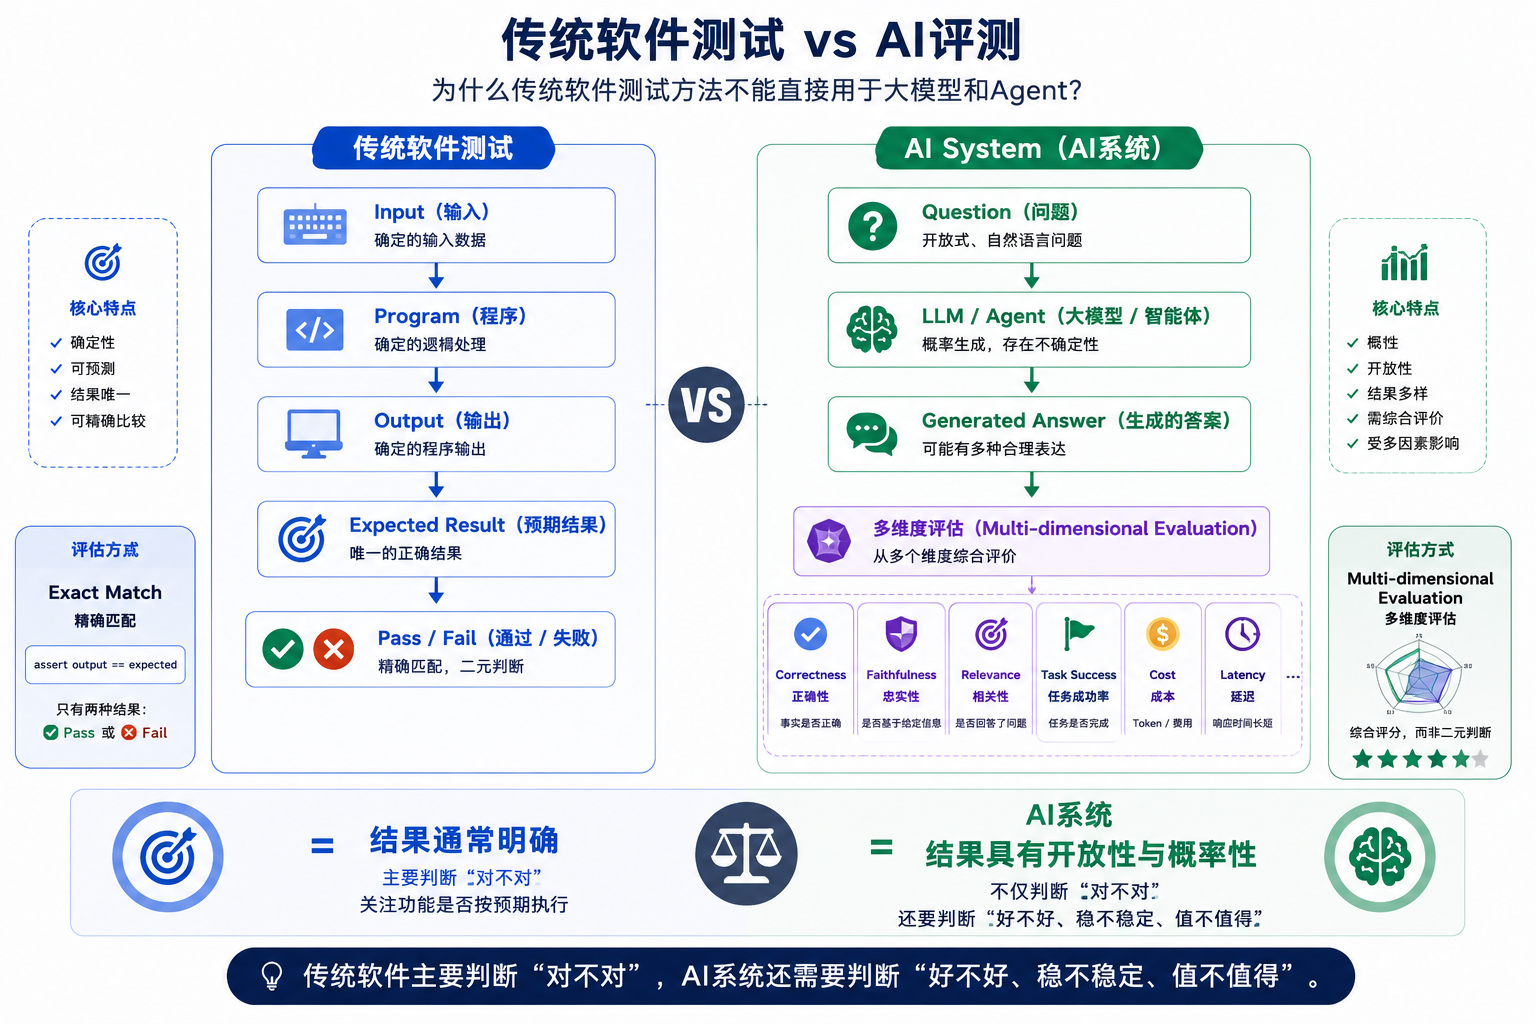
一、为什么传统软件测试的方法,不能直接用于AI?
传统软件开发中,我们非常熟悉:
Input
↓
Program
↓
Expected Output
↓
Assert
例如:
assert add(1, 2) == 3
结果只有:
Pass
或者:
Fail
但是AI的问题完全不同。
例如:
问题:
请总结这篇文章。
标准答案可能是:
文章主要介绍了RAG系统的基本架构,包括Embedding、Vector Database、Retrieval和LLM生成。
AI回答:
本文介绍了企业知识库系统如何通过向量检索找到相关信息,并结合大模型生成最终答案。
虽然两句话完全不同。
但是:
语义基本正确
如果使用传统:
String Equals
测试:
标准答案 ≠ AI答案
结果就是:
Fail
但实际上:
AI回答可能是正确的。
这就是LLM Evaluation和传统软件测试最大的区别。
二、AI评测的核心难点:答案不唯一
传统程序:
1 + 1
↓
2
标准答案唯一。
但是:
请解释什么是RAG。
可能有很多正确答案。
例如:
RAG是一种通过检索外部知识增强大模型回答能力的技术。
也可以回答:
RAG会先从知识库中检索相关信息,再将这些信息放入Context,帮助LLM生成更准确的答案。
甚至:
RAG = Retrieval + Augmented + Generation
都可能是正确的。
所以:
AI Output
不能简单通过:
Exact Match
判断。
而需要建立:
多个维度
进行评估。
三、评价一个LLM,到底应该看什么?
对于普通AI聊天系统,我们通常至少需要关注几个维度。
1. Correctness:正确性
最基本的问题:
回答是不是正确?
例如:
用户:
北京是中国的首都吗?

AI:
是。
正确。
但是对于复杂业务问题,Correctness往往没有这么简单。
例如:
用户:
我们公司的采购审批流程是什么?
回答可能:
流程基本正确
但是:
审批金额阈值错误
那么最终依然可能导致业务风险。
2. Relevance:相关性
AI有没有真正回答用户的问题?
用户问:
今年华东地区销售额是多少?
AI回答了一大段:
华东地区市场潜力巨大……
公司近年来持续发展……
销售团队表现优秀……
但是没有告诉用户:
销售额是多少。
这就是:
语言很流畅
但是不相关
所以:
说得多,不代表回答得好。
3. Faithfulness:忠实性
这个概念对于RAG尤其重要。
假设知识库提供:
员工工作满5年,可享受10天年假。
AI回答:
员工工作满5年,可以享受15天年假。
这时候问题不是:
表达能力差
而是:
回答没有忠实于Context。
所以Faithfulness可以理解为:
AI Answer
是否真正基于
Retrieved Context
4. Completeness:完整性
用户问:
如何申请企业VPN?
正确答案可能包括:
申请条件
↓
申请入口
↓
审批流程
↓
安装客户端
↓
登录方式
AI只回答:
请联系IT部门申请。
虽然没有错误。
但是:
信息不完整
所以:
Correct
≠
Complete
5. Consistency:一致性
同一个问题换不同说法:
公司年假有多少?

工作5年有多少年假?

我入职6年了,今年有多少年假?
AI应该得到:
逻辑一致
如果:
第一次:10天

第二次:7天

第三次:15天
那么说明系统存在一致性问题。
四、RAG Evaluation:不仅要评价答案,还要评价检索
这是很多初学者容易忽略的地方。
一个RAG系统通常是:
用户问题
 ↓
Embedding
 ↓
Vector DB
 ↓
Retrieval
 ↓
相关文档
 ↓
Context
 ↓
LLM
 ↓
Answer
最终回答不好,问题不一定在LLM。
可能是:
Retriever
出了问题。
例如:
用户问:
公司VPN怎么申请?
系统检索出来:
员工年假制度
采购审批流程
差旅报销制度
然后LLM无论多聪明,都很难回答正确。
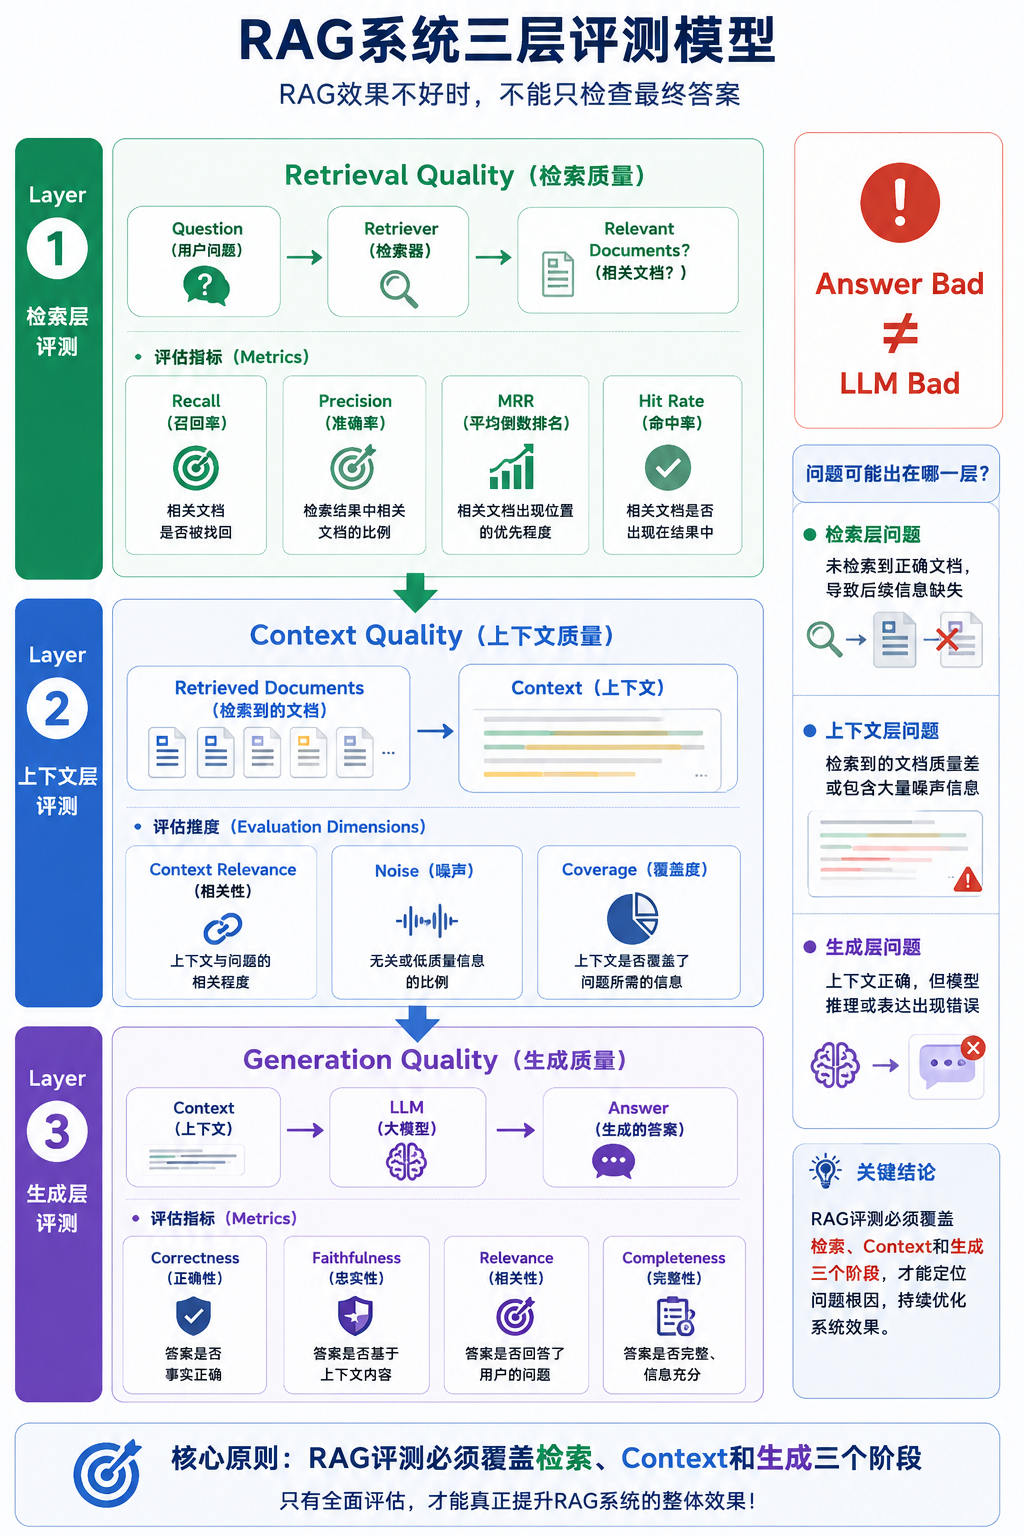
所以RAG需要分层评估。
第一层:Retrieval Quality
问题:
检索到了正确的文档吗?
例如:
Question
↓
Retriever
↓
Top 5 Documents
检查:
Relevant Document是否出现?
常见指标包括:
Recall
Precision
MRR
Hit Rate
简单理解:
Recall
=
正确资料有没有被找到

Precision
=
找到的资料里面,有多少是真正相关的
第二层:Context Quality
即使检索到了正确文档,也可能存在问题。
例如:
正确文档
+
大量无关文档
最终:
Context
过长
模型注意力被分散。
所以还需要评价
Context Relevance
也就是:
给模型的Context,到底是不是有用?
第三层:Generation Quality
最后才是:
LLM Answer
需要评估:
Correctness
Relevance
Faithfulness
Completeness
因此完整链路应该是:
Question
 ↓
Retrieval Evaluation
 ↓
Context Evaluation
 ↓
Generation Evaluation
 ↓
Final Quality
五、Agent Evaluation比LLM Evaluation复杂在哪里?
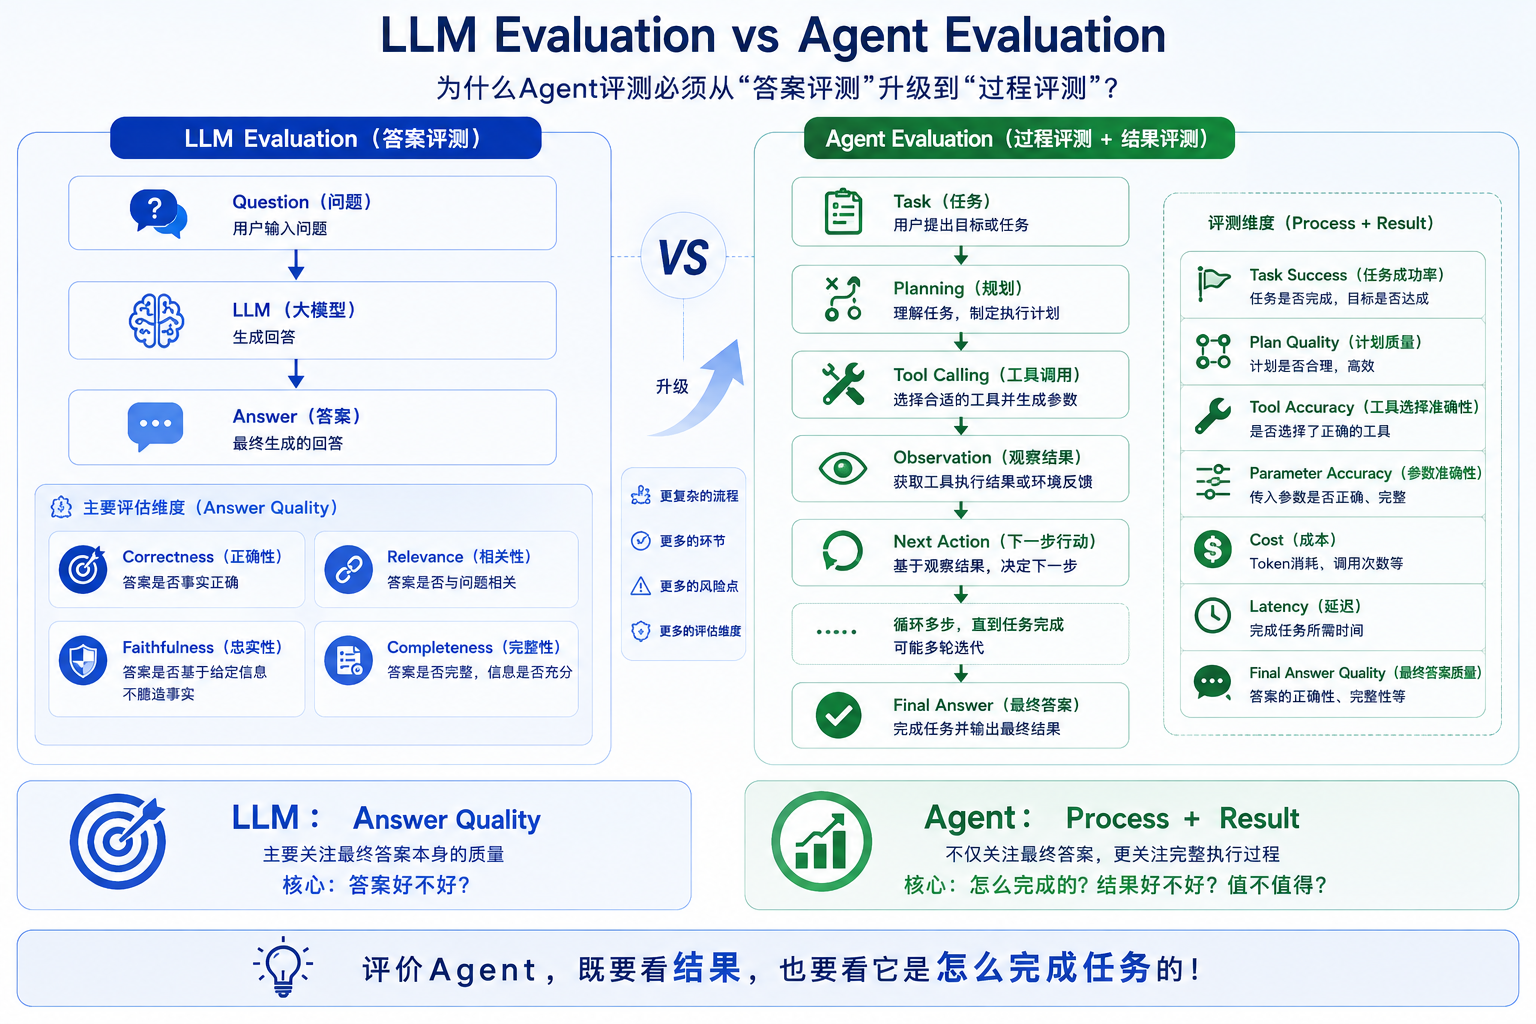
普通LLM:
Question
 ↓
LLM
 ↓
Answer
相对简单。
但是Agent可能:
User
 ↓
Understand Task
 ↓
Planning
 ↓
Tool Calling
 ↓
Tool Result
 ↓
Context Update
 ↓
Reasoning
 ↓
Next Action
 ↓
……
 ↓
Final Answer
所以Agent需要评价的,不只是:
最终回答
还包括:
有没有理解任务?
Plan是否合理?
Tool有没有选对?
参数有没有填对?
执行步骤是否正确?
是否完成任务?
执行成本高不高?
耗时长不长?
这意味着:
Agent Evaluation是系统级评测。
六、一个Agent可能“答案正确,但过程很差”
例如用户问:
帮我查询上个月上海地区的销售额。
Agent A:
理解问题
 ↓
调用Sales API
 ↓
获取数据
 ↓
Answer
总耗时:
2秒
Tool调用:
1次
Agent B:
搜索客户
 ↓
查询订单
 ↓
查询产品
 ↓
重新规划
 ↓
再次查询
 ↓
调用Calculator
 ↓
调用Sales API
 ↓
Answer
最终答案完全一样。
但是:
耗时:18秒

Tool调用:7次

成本:更高
所以:
Final Answer Correct
并不意味着:
Agent Good
Agent还需要评估:
Efficiency
Cost
Latency
Tool Accuracy
Task Success
七、Agent最重要的指标:Task Success Rate
对于Agent来说,一个非常重要的指标是:
Task Success Rate——任务成功率
例如:
测试100次:
查询订单

成功:92
失败:8
那么:
Task Success Rate
=
92%
这个指标往往比:
回答写得是否优美
更加重要。
例如:
用户说:
帮我取消订单A123。
Agent最终回答:
订单已成功取消。
但实际上:
API调用失败。
那么:
语言回答 = 看起来正确

真实任务 = 失败
所以Agent必须建立:
LLM Output
与:
Real World Result
之间的验证。
八、Tool Calling应该如何评测?
假设系统有:
SearchCustomer
SearchOrder
CancelOrder
CreateOrder
QueryInventory
用户说:
查询订单A123。
正确应该调用:
SearchOrder
但是模型调用:
SearchCustomer
那么Tool Selection错误。
所以Tool Calling至少可以评估:
Tool Selection Accuracy
应该调用哪个Tool?
↓
模型选对了吗?
Parameter Accuracy
例如:
{
  "order_id": "A123"
}
如果Agent生成:
{
  "order_id": "A132"
}
那么:
Tool正确
但是参数错误
Execution Success
Tool调用:
HTTP 200
不代表任务成功。
例如:
API返回:

{
    "success": false,
    "message": "Order not found"
}
所以:
HTTP Success
≠
Business Success
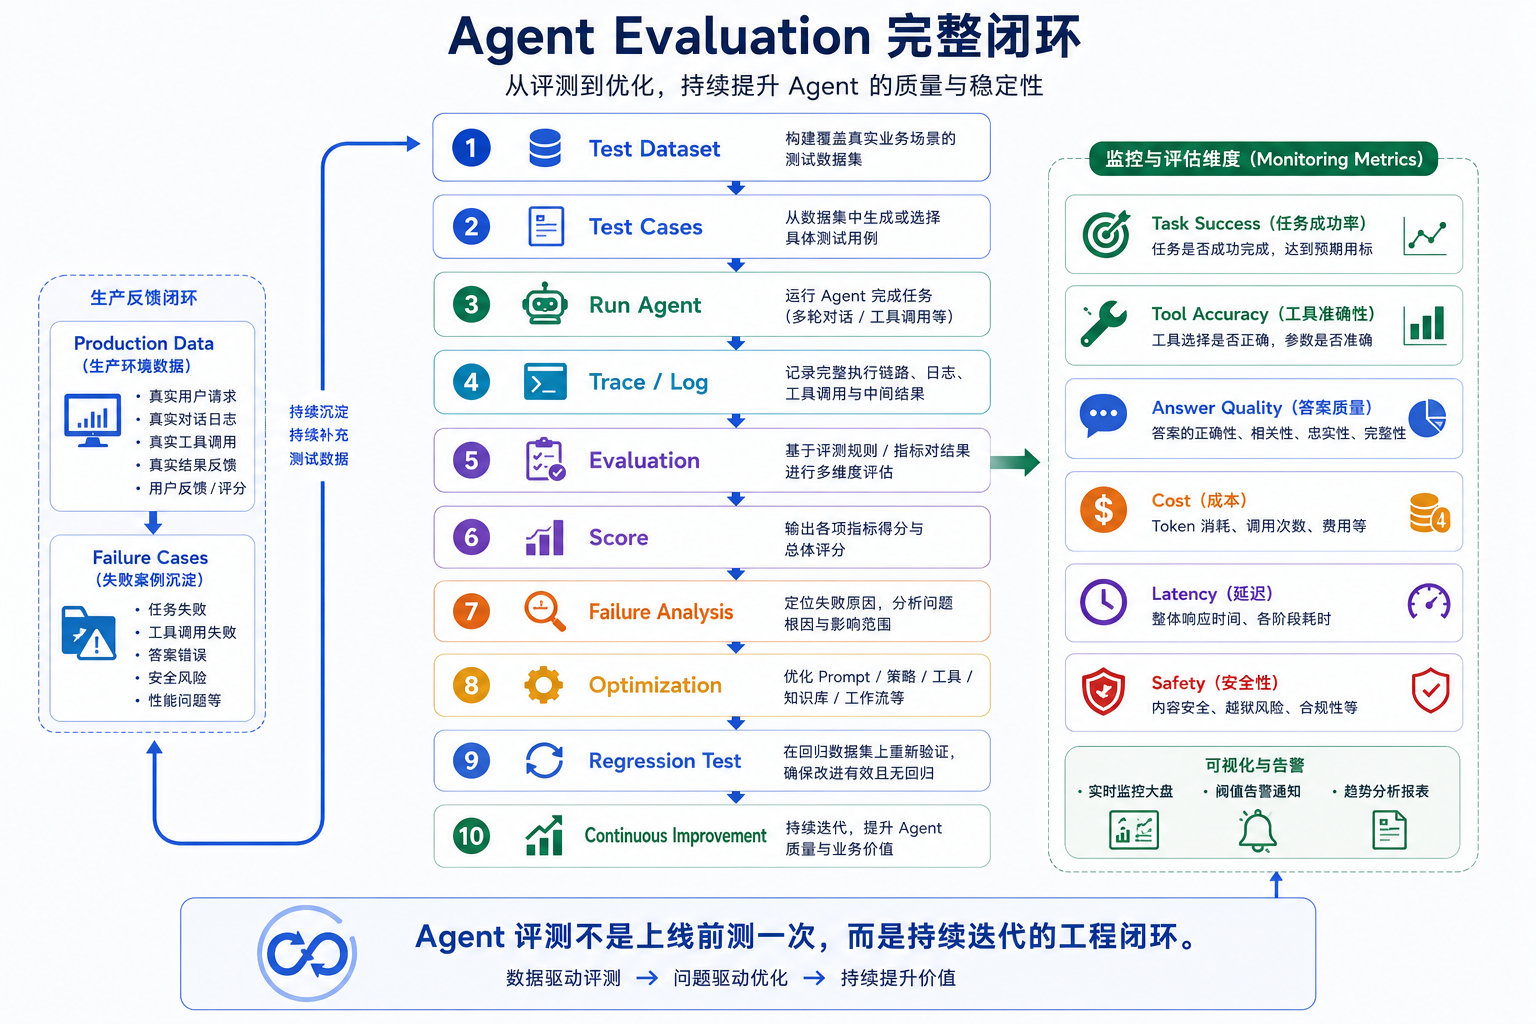
九、一个成熟Agent应该如何进行完整评测?
可以建立
Agent Evaluation Pipeline
例如:
Test Dataset
 ↓
Test Case
 ↓
Run Agent
 ↓
Trace
 ↓
Evaluate
 ↓
Score
 ↓
Failure Analysis
 ↓
Optimize
 ↓
Regression Test
其中:
Test Dataset
应该包含真实业务问题。
例如:
简单问题
复杂问题
多轮对话
模糊问题
异常输入
边界情况
Tool失败
权限不足
RAG无结果
不要只测试:
标准Demo问题。
否则很容易出现:
Demo表现很好,上线以后问题不断。
十、LLM-as-a-Judge:让AI来评价AI
这里会出现一个非常有意思的问题。
如果:
AI答案没有唯一标准
那谁来判断:
AI回答得好不好?
一种方法是:
人工评测。
例如:
Question
↓
AI Answer
↓
Human Reviewer
↓
Score
但是如果每天有:
100000条对话
显然无法全部人工检查。
于是出现了一种常见方法:
LLM-as-a-Judge
也就是:
AI Answer
 ↓
Judge LLM
 ↓
评分
例如:
Question:
什么是RAG?

Reference Answer:
RAG通过检索外部知识增强LLM回答。

AI Answer:
RAG会先从知识库检索相关资料,再结合这些资料生成回答。

Judge:
Correctness = 9/10
Relevance = 10/10
但是这里存在一个问题:
AI评价AI,会不会也出错?
答案是:
会。
因此不能盲目信任。
更加合理的架构是:
Human Evaluation
        ↓
Golden Dataset
        ↓
LLM-as-a-Judge
        ↓
Automatic Evaluation
        ↓
Human Spot Check
也就是:
人工定义标准,模型扩大评测规模。
十一、Golden Dataset:企业AI系统必须有自己的“标准题库”
传统软件有:
Unit Test
Integration Test
Regression Test
AI系统同样需要:
Golden Dataset
例如企业知识库Agent可以建立:
问题:
员工入职满3年,有多少年假?

Expected Knowledge:
根据员工手册第5章第3条。

Expected Answer:
8天。
还可以记录:
Expected Tool
Expected Parameters
Expected Documents
Expected Result
完整结构:
Test Case
 ├── User Query
 ├── Expected Intent
 ├── Expected Retrieval
 ├── Expected Tool
 ├── Expected Parameters
 ├── Expected Result
 └── Evaluation Criteria
这样每次:
修改Prompt
更新模型
修改RAG
增加Tool
之后,都可以重新运行。
这就是:
AI Regression Test——AI回归测试。
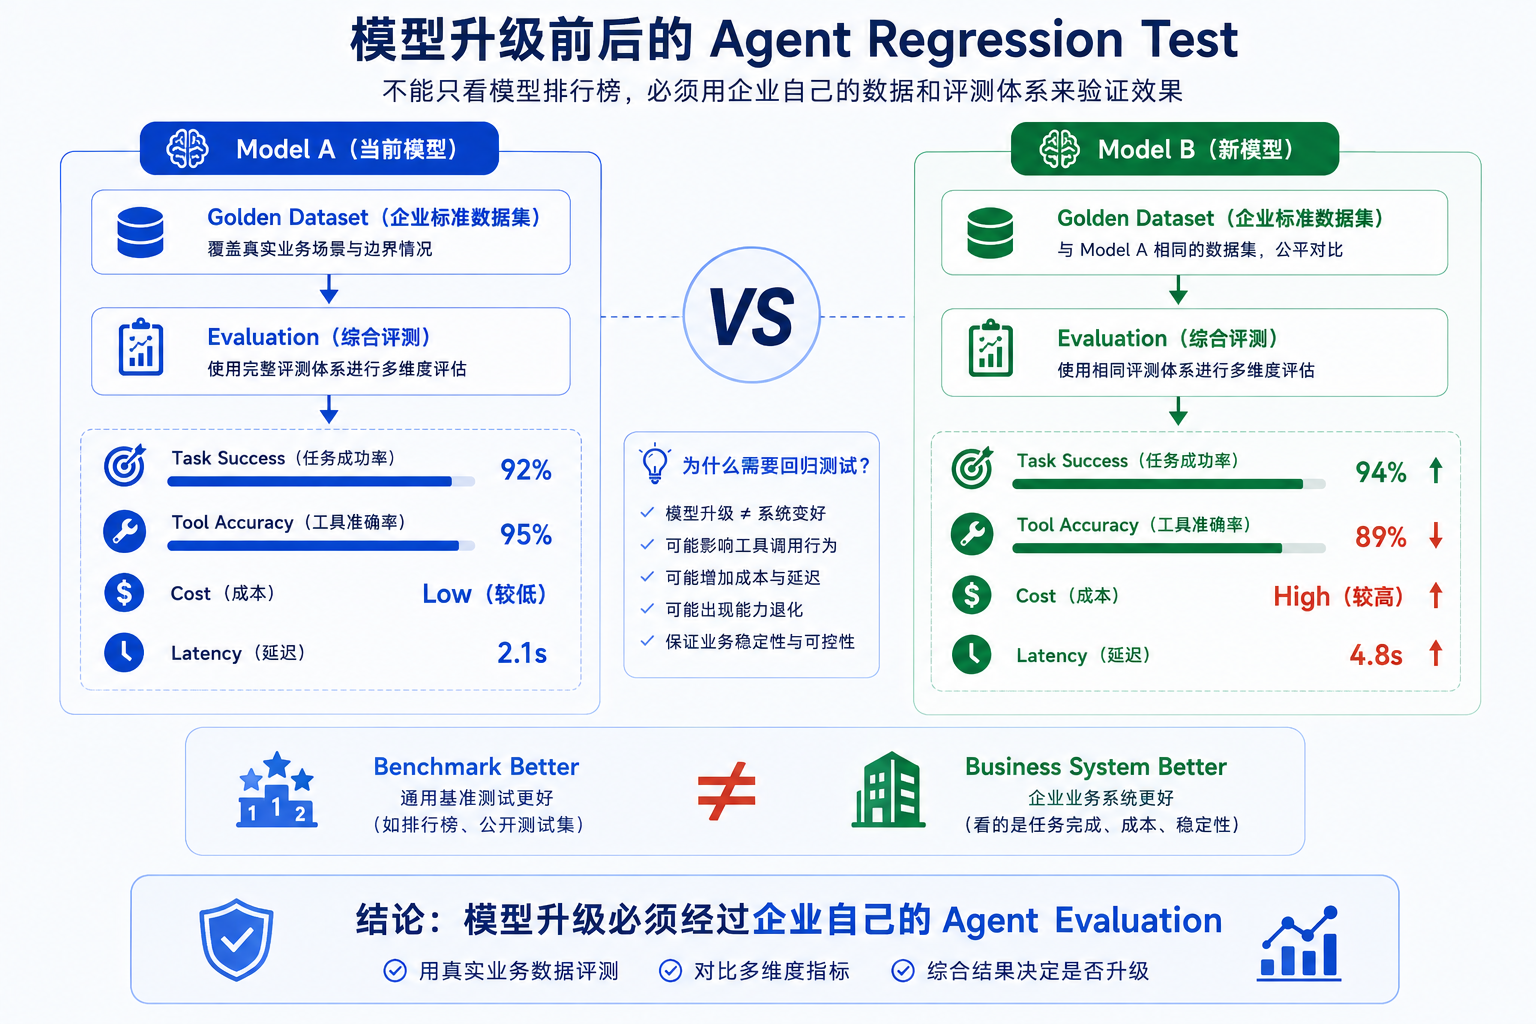
十二、为什么模型升级必须重新评测?
假设:
Model A
升级成:
Model B
你可能认为:
Model B Benchmark更高
所以应该更好。
但对于你的企业Agent来说,不一定。
例如:
Model B
可能:
推理能力更强
但是:
Tool Calling格式变化
或者:
更容易调用多余的Tool
又或者:
成本提高3倍
甚至:
Latency增加
所以:
General Benchmark Better
不等于:
Your Agent Better
企业真正需要的是:
New Model
↓
Golden Dataset
↓
Evaluation
↓
Compare
↓
Decision
而不是:
看到排行榜
↓
直接升级
十三、企业级Agent评测,不只是准确率
一个成熟的企业级AI评测体系至少可以包括:
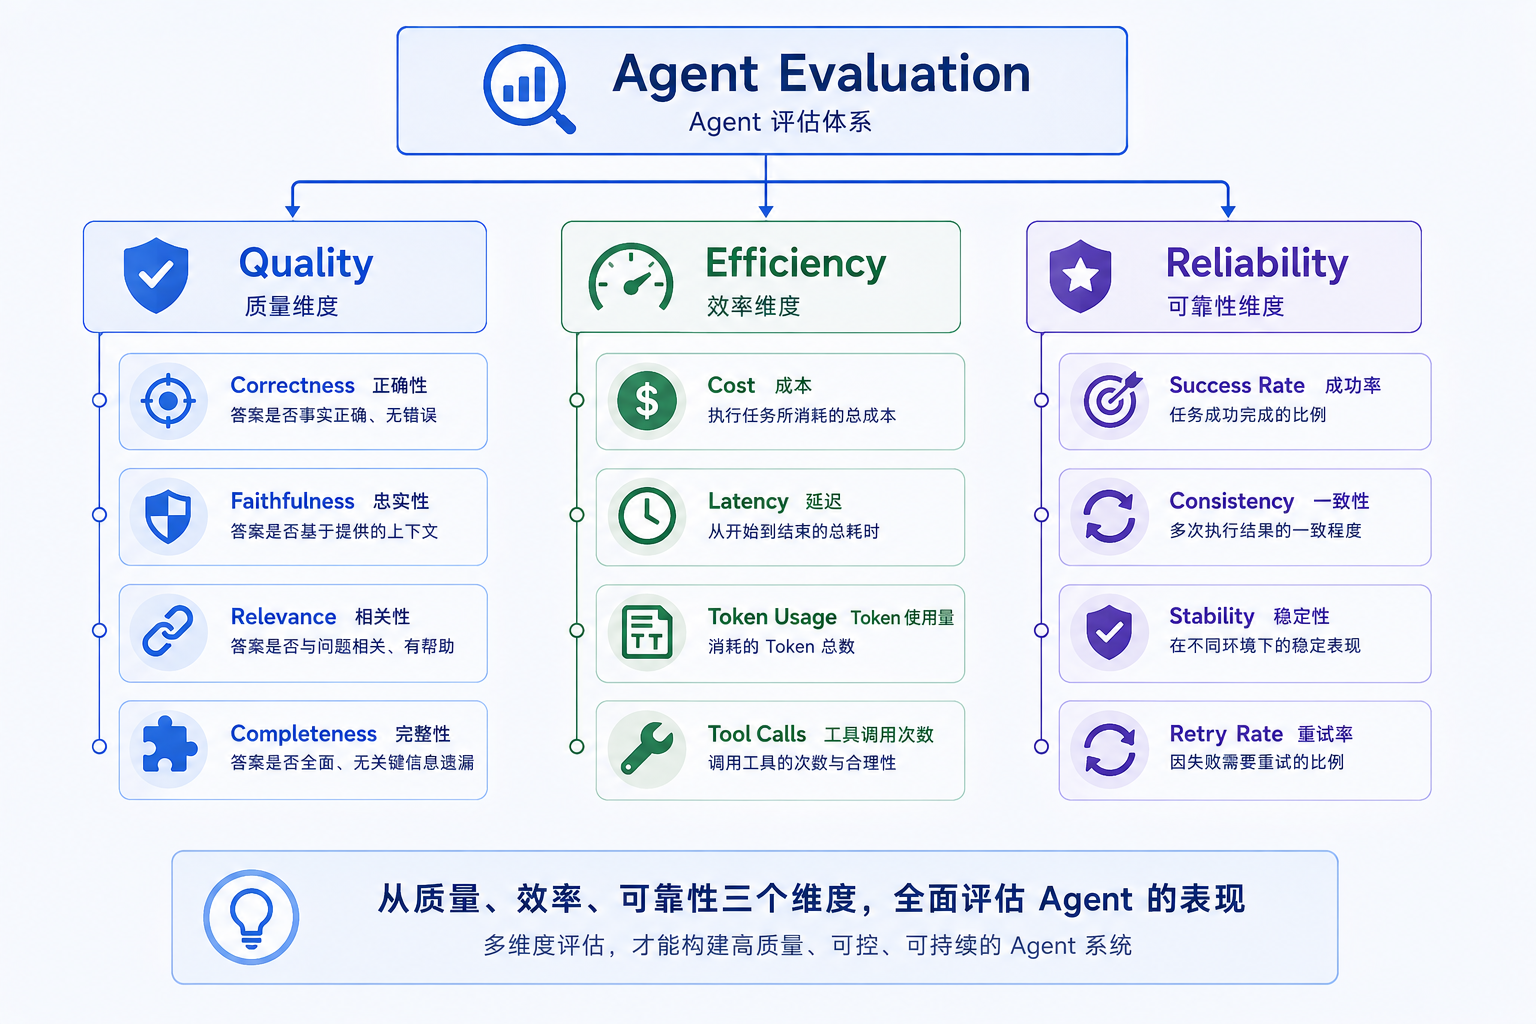
同时还需要:
Security
Permission
Compliance
Safety
最终形成:
Quality
+
Cost
+
Latency
+
Reliability
+
Security
而不是只看:
回答正确率
十四、如何设计一个企业级Agent Evaluation平台?
一个成熟架构可以是:
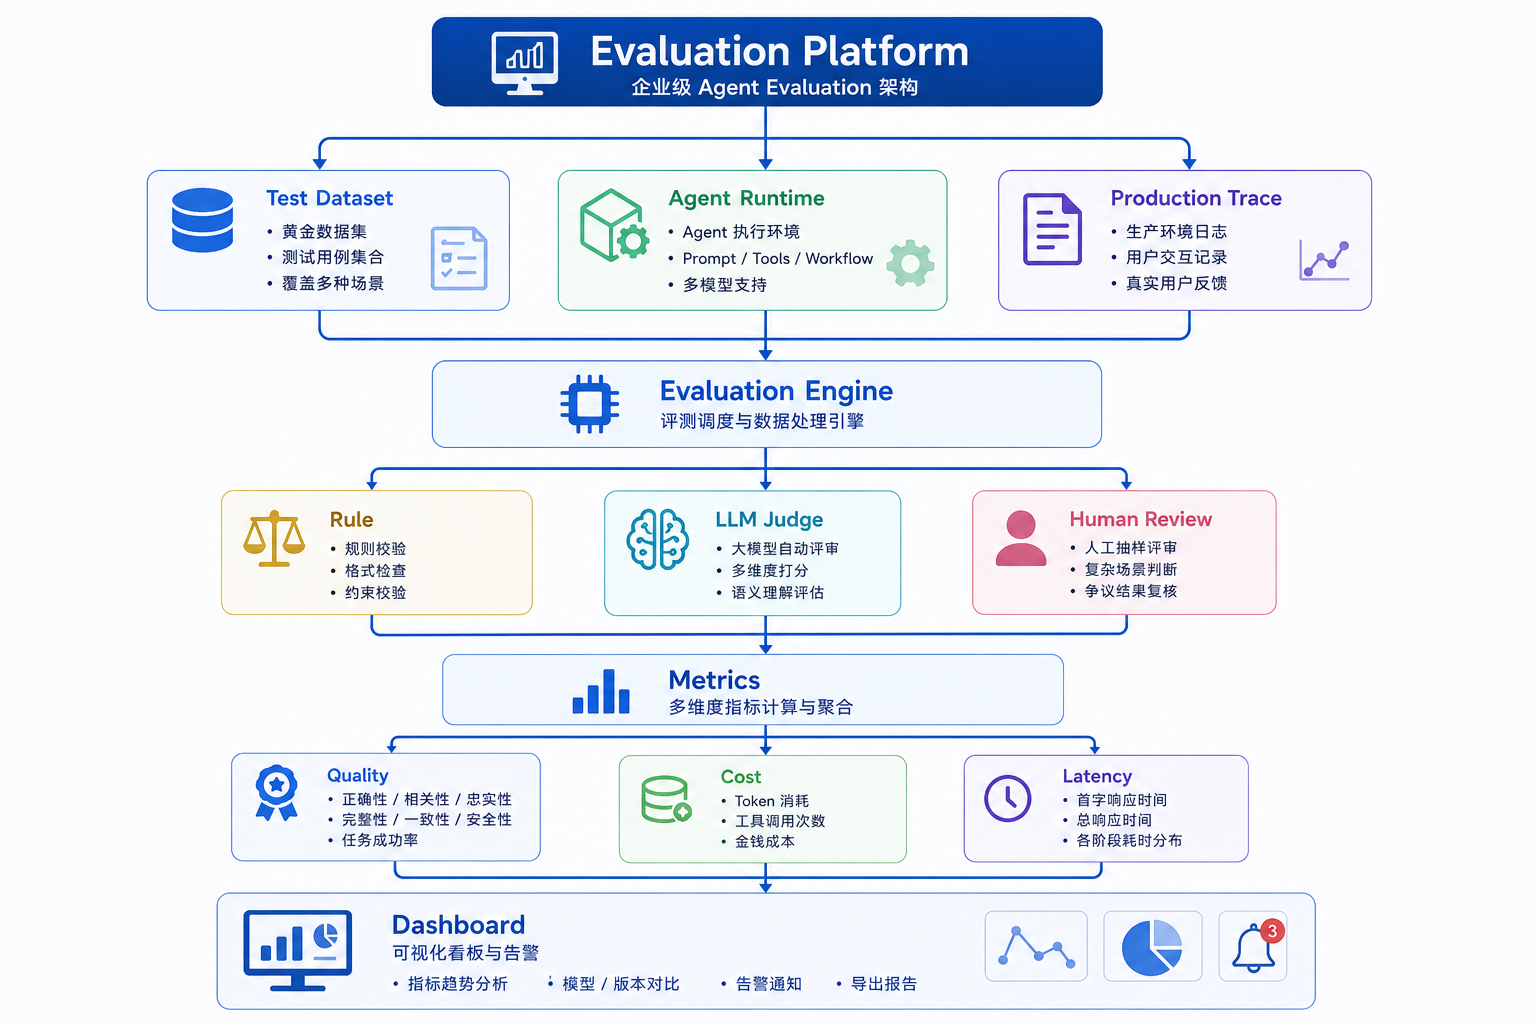
最终:
Monitoring
+
Tracing
+
Evaluation
形成完整体系。
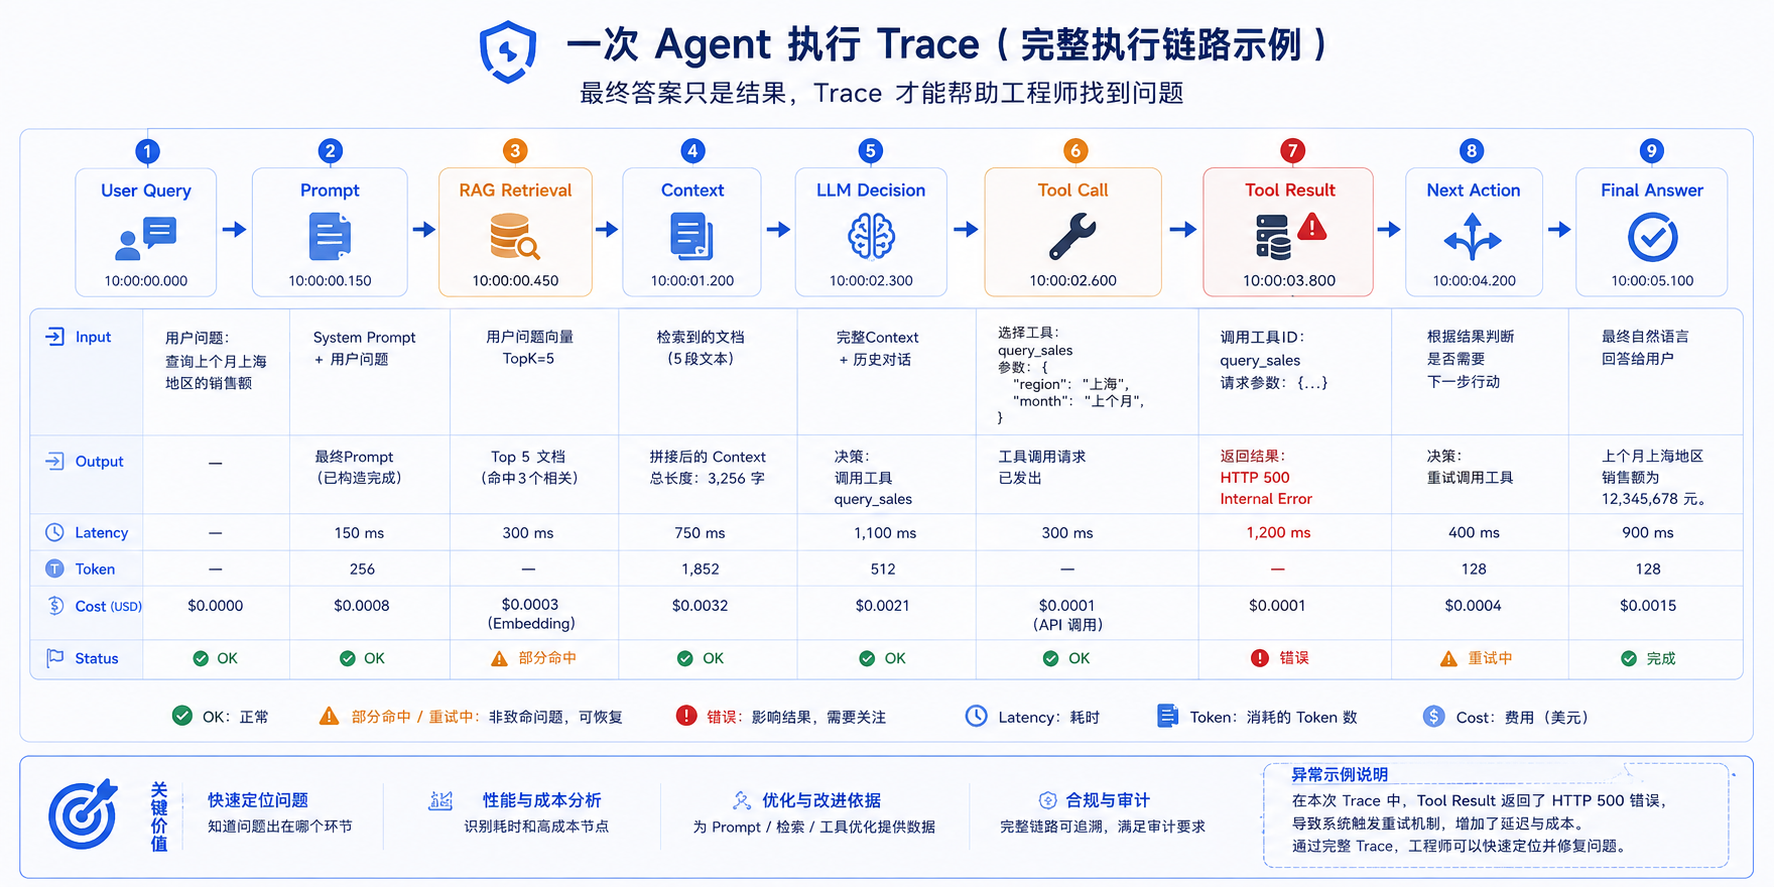
十五、Agent为什么必须有Trace?
如果用户反馈:
这个AI回答错了。
你不能只看:
Final Answer
还需要看到:
User Query
↓
System Prompt
↓
Retrieved Documents
↓
Context
↓
Model Output
↓
Tool Calls
↓
Tool Results
↓
Agent Decisions
↓
Final Answer
这就是:
Trace——执行链路追踪。
否则你根本不知道问题来自:
Prompt?

RAG?

Model?

Tool?

Workflow?

Context?
所以:
没有Trace,就很难真正做Agent Evaluation。
十六、从Evaluation进一步进入Agent Engineering
到这里,你应该能够发现:
最初的问题只是:
AI回答得好不好?
但是继续深入以后,我们需要解决的是:
回答正确吗?
↓
回答是否忠实于知识库?
↓
检索是否正确?
↓
Tool是否选对?
↓
参数是否正确?
↓
任务是否完成?
↓
成本是否合理?
↓
系统是否稳定?
↓
模型升级后是否退化?
这时候,AI开发已经不再只是:
Prompt Engineering
而逐渐进入:
Agent Engineering
真正的Agent工程需要:
Model
↓
Prompt
↓
Context
↓
RAG
↓
Tool
↓
Workflow
↓
Trace
↓
Evaluation
↓
Monitoring
↓
Optimization
面试题
问题1
传统软件测试和LLM Evaluation最大的区别是什么?
参考答案:
传统软件通常具有明确输入和预期输出,可以使用:
Expected Output
==
Actual Output
进行判断。
但LLM具有开放式生成特征,同一个问题可能存在多个正确答案,因此不能只依赖字符串完全匹配,而需要从正确性、相关性、忠实性、完整性等多个维度进行评价。
问题2
RAG系统回答错误,应该直接认为是LLM的问题吗?
参考答案:
不应该。
RAG系统至少需要分层分析:
Retrieval
↓
Context
↓
Generation
如果Retriever没有找到正确文档,那么LLM可能根本没有获得正确知识。
因此需要分别评估:
Retrieval Quality
Context Quality
Generation Quality
问题3
为什么Agent Evaluation比LLM Evaluation更复杂?
参考答案:
因为普通LLM通常主要评价:
Question
↓
Answer
而Agent存在完整执行过程:
Planning
Tool Calling
Observation
Next Action
Workflow
因此除了最终答案,还需要评估:
Task Success
Tool Selection
Parameter Accuracy
Execution Path
Cost
Latency
也就是:
Agent Evaluation需要同时评价过程和结果。
问题4
什么是LLM-as-a-Judge?
参考答案:
LLM-as-a-Judge是使用另一个大模型对AI生成结果进行自动评价的方法。
它可以根据预设标准,对:
Correctness
Relevance
Faithfulness
Completeness
等维度进行评分。
但它本身也可能产生误判,因此企业实践中通常应该结合:
Golden Dataset
+
Rule Evaluation
+
LLM-as-a-Judge
+
Human Review
形成组合评测体系。
问题5
为什么企业Agent需要Golden Dataset?
参考答案:
Golden Dataset可以理解为企业自己的AI测试集。
其中保存:
真实业务问题
Expected Knowledge
Expected Tool
Expected Result
Evaluation Criteria
当:
Prompt变化
Model升级
RAG调整
Tool修改
后,可以重新执行评测,判断系统是否发生能力退化。
这就是AI系统中的:
Regression Test。
本节小结
✅ 核心概念
AI系统不能简单地判断:
能用
/
不能用
而需要建立多维评测体系。
✅ LLM Evaluation
主要关注:
Correctness
Relevance
Faithfulness
Completeness
Consistency
✅ RAG Evaluation
必须分层:
Retrieval Quality
↓
Context Quality
↓
Generation Quality
最终答案不好:
不一定是LLM的问题。
✅ Agent Evaluation
Agent需要从:
Answer Quality
升级到:
Process + Result
重点关注:
Task Success
Planning
Tool Calling
Parameter Accuracy
Cost
Latency
Reliability
✅ 工程解决方案
企业级Agent需要建立:
Golden Dataset
↓
Automated Evaluation
↓
LLM-as-a-Judge
↓
Human Review
↓
Trace
↓
Monitoring
↓
Regression Test
↓
Continuous Improvement
最终形成持续优化闭环。
最重要的一句话
AI系统真正的工程化,不是让模型“看起来很聪明”,而是建立一套能够持续回答“它到底做得好不好、哪里出了问题、升级之后有没有变差”的质量评估体系。
下一篇
接下来,我们继续进入Agent开发中一个更加核心的问题:
《第3章 第6节:为什么AI会调用错工具?——Tool Calling背后的模型决策机制》
我们将开始从:
LLM生成文本
进一步进入:
LLM
↓
理解任务
↓
识别能力
↓
选择Tool
↓
生成参数
↓
调用外部系统
↓
获得真实结果
你会逐渐理解:
Agent真正改变软件世界的地方,并不是让AI更会聊天,而是让大模型开始能够理解任务,并连接API、数据库、搜索引擎、企业系统和真实世界。


 扫一扫


 394

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


