Harness 多模型/Agent 路由与评测策略文档

AI Agent可控性关键:Harness Engineering与SDD如何协同落地 随着AI Agent进入生产环境,如何让模型行为可控、不越界成为工程化落地的核心议题。Harness Engineering作为一套围绕智能体构建的约束装置,通过输入过滤、工具白名单、输出校验等手段,实现了系统层面的行为管控。然而,约束装置本身需要明确的标准来定义“什么是正确的行为”,这正是规范驱动开发(SDD)的专长。SDD通过需求分析、规范定义、模型设计、验证确认等环节,将业务需求转化为无歧义的工程契约,为Harness的评测和拦截规则提供了权威依据。传统SDD在确定性系统中行之有效,面对LLM的概率性 阅读详情

Harness 多模型/Agent 路由与评测策略文档
一、策略设计总则
1.1 核心目标
围绕 Harness 8 个任务阶段,实现「模型/Agent 最优匹配」,在保证任务质量的前提下,平衡执行效率、成本控制与结果可靠性;通过持续评测与数据积累,让路由策略实现自迭代,同时解决多模型矛盾/背书场景的决策难题,支撑复杂任务全流程顺畅推进。
核心原则

  • 阶段适配:模型/Agent 选型与当前阶段的核心需求强绑定(如推理复杂度、上下文长度、操作类型);
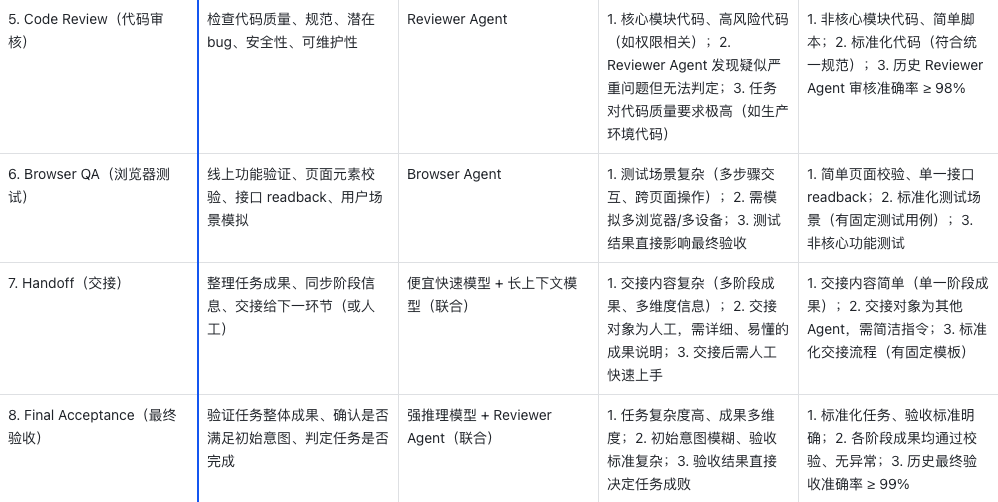
  • 动态调优:基于任务反馈、模型表现数据,自动调整路由策略,实现“能降级则降级、需升级则升级”;
  • 成本可控:优先使用低成本、快速模型完成基础任务,仅在必要时升级强推理模型;
  • 结果可验:所有模型/Agent 输出均需经过校验,明确“可采纳”标准,杜绝无效输出;
  • 可追溯:完整记录模型调用、输出结果、评测数据,为策略迭代和问题排查提供支撑。
    涉及模型/Agent 能力梳理
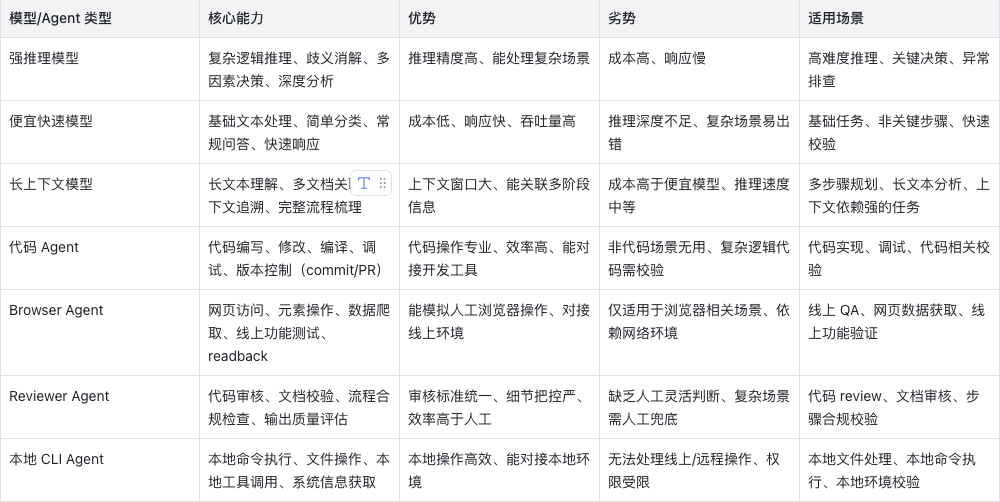
    在这里插入图片描述

二、分阶段模型/Agent 路由策略(核心)
结合 8 个任务阶段的核心需求,明确每个阶段的「默认模型/Agent」「升级条件」「降级条件」,实现动态路由,平衡质量、效率与成本。
2.1 各阶段路由详情
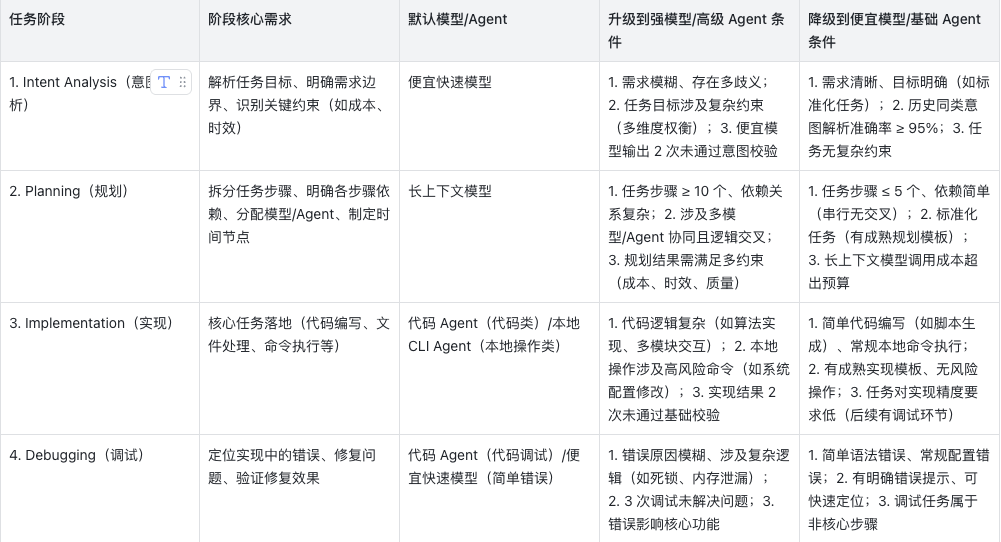
在这里插入图片描述在这里插入图片描述

2.2 路由触发机制

  • 默认触发:进入对应任务阶段后,自动调用「默认模型/Agent」,无需人工干预;
  • 升级触发:满足该阶段「升级条件」时,由 Supervisor 自动终止当前模型/Agent 调用,切换为强模型/高级 Agent,记录升级原因和时间;
  • 降级触发:满足该阶段「降级条件」时,由 Supervisor 自动切换为便宜模型/基础 Agent,若已调用强模型,可终止当前调用(节省成本),记录降级原因和时间;
  • 人工干预:特殊场景下(如模型输出异常、任务紧急调整),人工可手动调整模型/Agent,操作记录留存至日志。
    三、模型输出可采纳判定标准
    为避免无效输出、错误输出进入下一环节,明确所有模型/Agent 输出的「可采纳标准」,由 Supervisor 或对应校验 Agent 执行判定,未通过则触发重试、模型升级或人工介入。
    3.1 通用可采纳标准(所有模型/Agent 均需满足)
  • 相关性:输出内容与当前阶段任务目标高度相关,无无关信息、无偏离主题;
  • 完整性:覆盖当前阶段核心需求,无关键信息缺失(如规划步骤无遗漏、代码无语法错误);
  • 一致性:输出内容内部无逻辑矛盾,与前序阶段成果、任务意图无冲突;
  • 可验证:输出结果可通过后续步骤、工具或 Agent 校验(如代码可编译、QA 可验证)。
    3.2 各模型/Agent 专属可采纳标准
  • 强推理模型/便宜快速模型:输出逻辑清晰、结论明确,无歧义;复杂推理需附带简要推理过程,便于校验;
  • 长上下文模型:上下文关联准确,能复用前序阶段信息,无上下文脱节、信息混淆;
  • 代码 Agent:代码可编译通过、无语法错误;符合预设代码规范;核心逻辑能实现预期功能;
  • Browser Agent:操作步骤可复现;能准确获取目标页面/接口数据;测试结果与预期一致(无漏测、误判);
  • Reviewer Agent:审核意见具体、有依据(如指出具体代码行问题);无遗漏严重问题;审核标准与预设一致;
  • 本地 CLI Agent:命令执行成功(无报错);操作结果符合预期(如文件修改正确、命令输出正常);无权限异常。
    3.3 判定流程与处理逻辑
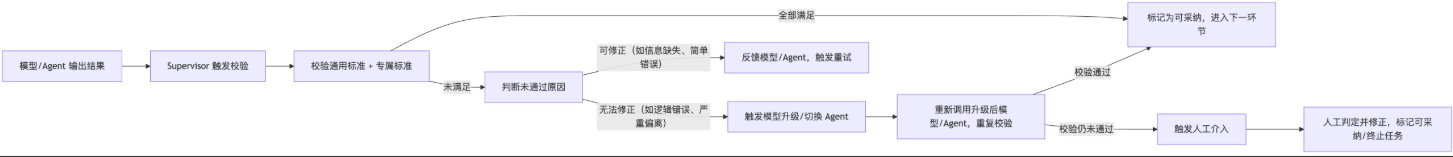
    在这里插入图片描述

补充说明:重试次数默认不超过 3 次,每次重试间隔 5-10s;升级模型后仍未通过,立即触发人工介入,避免无效消耗。
四、评测体系设计(benchmark/replay/golden task)
建立完善的评测体系,通过「基准测试、回放测试、黄金任务测试」,持续评估模型/Agent 表现,为路由策略优化提供数据支撑,确保策略的科学性和有效性。
4.1 Benchmark(基准测试):建立性能基线
4.1.1 基准指标设计
围绕「质量、效率、成本」三大核心维度,设计可量化的基准指标,覆盖所有模型/Agent 和任务阶段:
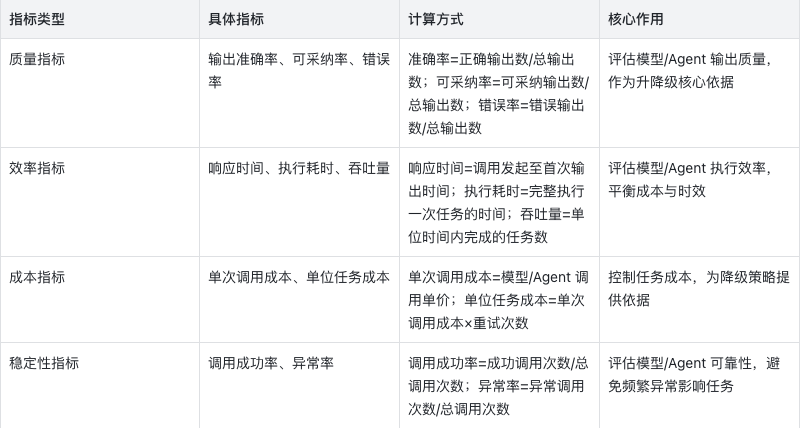
在这里插入图片描述

4.1.2 基准测试执行

  • 初始化基准:在系统上线初期,对所有模型/Agent 进行全阶段基准测试,记录各指标 baseline(基线值);
  • 定期复测:每周执行一次基准测试,每月执行一次全量基准复测,更新指标数据,对比基线值,识别模型表现变化;
  • 异常触发:当某模型/Agent 指标出现大幅波动(如准确率下降 ≥ 10%、异常率上升 ≥ 15%),立即触发紧急基准测试,排查原因。
    4.2 Replay(回放测试):复现真实场景
    基于历史真实任务数据,进行回放测试,模拟实际运行场景,评估模型/Agent 在真实任务中的表现,避免基准测试与实际场景脱节。
    4.2.1 回放数据采集
  • 采集范围:历史完成的任务(成功/失败)、模型调用记录、输出结果、校验记录、人工干预记录;
  • 数据筛选:优先筛选高频任务、复杂任务、曾出现异常的任务,确保回放场景的代表性;
  • 数据脱敏:对敏感信息(如核心代码、隐私数据)进行脱敏处理,确保数据安全。
    4.2.2 回放测试执行
  • 自动回放:每周自动回放 100-200 条历史任务数据,使用当前路由策略调用模型/Agent,记录表现指标;
  • 对比分析:将回放测试结果与历史真实结果对比,评估路由策略的优化效果(如可采纳率提升、成本降低);
  • 问题定位:若回放测试中出现模型输出异常、路由错误,定位原因(如模型版本更新、策略参数不合理),及时优化。
    4.3 Golden Task(黄金任务):标准化校验
    设计一批标准化的“黄金任务”,覆盖 8 个任务阶段、不同复杂度场景,作为模型/Agent 表现的“标准校验工具”,确保评测的一致性。
    4.3.1 黄金任务设计原则
  • 覆盖性:每个任务阶段设计 5-10 个黄金任务,涵盖简单、中等、复杂三种复杂度;
  • 标准化:每个黄金任务有明确的输入、预期输出、验收标准,无歧义;
  • 稳定性:黄金任务不频繁修改,仅在任务流程、模型能力升级时更新;
  • 可量化:验收标准可量化(如代码编译通过率 100%、QA 测试通过率 100%),便于自动评测。
    4.3.2 黄金任务应用
  • 模型准入:新模型/Agent 接入 Harness 时,需通过对应阶段的黄金任务测试,指标达标方可接入;
  • 日常校验:每日执行一次黄金任务测试,快速检测模型/Agent 表现是否稳定;
  • 策略优化:通过黄金任务测试结果,对比不同模型/Agent 在同一任务中的表现,优化路由策略(如调整默认模型、升降级条件)。
    五、模型表现记录与路由策略自迭代机制
    建立“记录-分析-优化-迭代”的闭环,完整记录模型表现数据,通过数据分析识别问题,自动优化路由策略,实现策略随时间持续改进。
    5.1 模型表现记录规范
    5.1.1 记录内容(全量可追溯)
  • 基础信息:任务 ID、任务阶段、调用的模型/Agent 类型、调用时间、结束时间;
  • 输入输出:模型/Agent 的输入参数、输出结果、可采纳判定结果、校验记录;
  • 性能指标:响应时间、执行耗时、调用成本、准确率、可采纳率、异常信息;
  • 路由信息:是否触发升级/降级、升级/降级原因、人工干预记录;
  • 关联数据:与该模型/Agent 相关的前序/后续步骤成果、黄金任务测试结果、回放测试结果。
    5.1.2 记录存储与检索
  • 存储介质:采用“MySQL + ElasticSearch”联合存储,MySQL 存储结构化数据(如指标、基础信息),ElasticSearch 存储非结构化数据(如输出结果、日志);
  • 检索维度:支持按任务 ID、任务阶段、模型/Agent 类型、时间范围、性能指标检索,便于数据分析;
  • 数据留存:历史数据留存 1 年,核心数据(如黄金任务、异常记录)永久留存,用于长期策略优化。
    5.2 路由策略自迭代机制
    基于模型表现记录、评测数据,由 Supervisor 自动触发策略优化,每月进行一次全量迭代,紧急异常时触发临时迭代。
    5.2.1 迭代分析维度
  • 模型表现分析:识别各模型/Agent 在不同阶段、不同复杂度任务中的优势/劣势(如某便宜模型在简单意图分析中准确率达 98%,可扩大其使用场景);
  • 升降级逻辑分析:统计升级/降级触发的频率、原因,优化升降级条件(如某阶段升级强模型后准确率提升不明显,可调整升级阈值);
  • 成本效率分析:对比不同模型/Agent 的“成本-质量”比,优先选择性价比高的模型(如便宜模型准确率仅比强模型低 2%,但成本低 80%,可调整默认模型);
  • 异常分析:统计模型异常、输出不可采纳的高频场景,优化路由策略(如某模型在复杂规划中异常率高,可直接将复杂规划的默认模型升级为强模型)。
    5.2.2 迭代执行流程
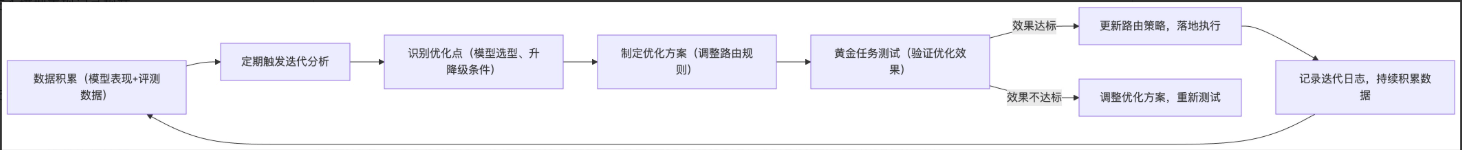
    在这里插入图片描述

5.2.3 人工兜底优化
每月迭代后,人工审核优化效果,针对自动迭代无法解决的问题(如多模型矛盾场景、复杂任务路由不合理),手动调整策略;每季度进行一次全量策略复盘,结合业务场景变化,优化模型选型和路由逻辑。
六、多模型矛盾/背书场景的 Supervisor 决策策略
当多个模型/Agent 针对同一任务输出(或同一环节)出现「矛盾」(输出不一致)或「背书」(输出一致)时,Supervisor 需基于证据、模型表现、任务优先级,做出科学决策,确保任务推进的正确性。
6.1 多模型背书场景(输出一致):优先采纳,谨慎校验
背书定义
2 个及以上不同类型/不同等级的模型/Agent,针对同一任务输出(或同一校验点),给出一致的结果(如 Reviewer Agent 与强推理模型均认为代码无问题)。
决策策略

  • 基础原则:优先采纳背书结果,减少人工干预,提升效率;
  • 校验要求:若背书模型包含强推理模型/Reviewer Agent,可简化校验流程(仅执行核心校验);若仅为便宜模型/基础 Agent 背书,需执行完整校验,避免“集体出错”;
  • 特殊处理:若背书结果与前序阶段成果、任务意图有轻微偏差,触发简单重试;若偏差较大,即使背书一致,也需人工介入核查。
    6.2 多模型矛盾场景(输出不一致):分层决策,证据优先
    矛盾定义
    2 个及以上不同类型/不同等级的模型/Agent,针对同一任务输出(或同一校验点),给出相互冲突的结果(如代码 Agent 认为代码无错,Reviewer Agent 认为存在严重 bug)。
    决策优先级(从高到低)
  1. 第一步:基于证据校验矛盾结果
  2. 第二步:结合模型表现数据决策
  3. 若强推理模型与便宜模型矛盾,且强推理模型表现更优(准确率 ≥ 95%),优先采纳强推理模型;若便宜模型表现接近(准确率 ≥ 93%),且成本更低,可触发人工复核后决定;
  4. 若同类型模型矛盾(如两个代码 Agent),优先采纳历史表现更优、调用成功率更高的模型;
  5. 若 Agent 与模型矛盾(如 Browser Agent 测试通过,强推理模型认为测试不完整),优先采纳 Agent 输出(Agent 更贴近实际操作,证据更直观)。
  6. 第三步:结合任务优先级决策
  7. 高优先级任务(如生产部署、核心功能开发):优先采纳强推理模型/Reviewer Agent 输出,触发人工复核,确保结果正确;
  8. 普通优先级任务:优先采纳成本低、效率高的模型输出,后续通过调试、QA 环节验证;
  9. 低优先级任务:可随机采纳一个结果,后续若发现错误,触发重试和模型升级。
  10. 第四步:人工介入兜底
    6.3 决策记录与优化
    所有多模型矛盾/背书场景的决策过程、结果、依据,均需完整记录至日志;每月迭代时,分析矛盾/背书高频场景,优化路由策略(如调整模型选型、增加校验环节),减少矛盾场景的出现。
    七、总结
    本策略围绕 Harness 8 个任务阶段,实现了多模型/Agent 的精准路由、动态升降级,通过明确的输出可采纳标准、完善的评测体系,确保任务质量与成本平衡;同时建立了策略自迭代机制和多模型决策规则,解决了复杂场景下的模型选型与决策难题。
    策略落地后,可通过持续的评测数据积累、策略迭代,逐步提升模型调用的性价比和任务执行的可靠性,支撑 Harness 长期稳定运行,适配复杂工程任务的全流程需求。后续可结合实际业务场景,进一步优化模型表现指标、升降级条件和决策规则,提升策略的灵活性和适配性。

智能执行层与AI Agent开发实战:从LangChain到DeepSeek Harness 在人工智能应用开发领域,智能执行层(Intelligent Execution Layer)作为协调和管理多个AI Agent完成复杂任务的关键技术框架,正成为连接大语言模型(LLM)与实际业务场景的核心枢纽。其工作原理是通过编排器(Orchestrator)将用户指令分解为子任务,并动态调度具备特定能力的Agent及工具集(Toolkit)来执行,同时管理任务状态与记忆。这一架构的技术价值在于解决了直接调用大模型API时面临的任务复杂性、状态管理、可靠性与可观测性等工程挑战,使开发者能聚焦业务逻辑而非底层 阅读详情

相关推荐

多Agent协作实战:Hermes与DeepSeek Harness从配置到排错

在大模型应用开发中,单个智能体(Agent)的能力边界往往受限于任务编排与工具调用的工程复杂度。Harness作为承接模型与业务逻辑的执行框架,承担着上下文管理、工具路由和状态追踪等关键职责,是多Agent协作从概念走向落地的核心枢纽。本文从智能体、Harness、Skill三层概念辨析出发,结合Hermes框架与DeepSeek Harness的完整部署流程,讲解如何声明式定义Agent能力、注册可复用Skill,并基于workflow配置驱动多个Agent在共享上下文中协同完成代码审查与文档更新任务。同

weixin_34197488的博客 491

learn-harness-engineering 之 harness-creator Skill 实战指南:为 AI 编码 Agent 构建、审计与评测生产级 Harness

本指南以 learn-harness-engineering 仓库中随课程交付的 `harness-creator` skill 为核心,讲解如何用它将任意代码仓库武装成 AI 编码 Agent 可靠工作的"护栏系统"——覆盖指令、状态、验证、范围与生命周期五大子系统。读完本文,你将掌握从零脚手架一个 harness、对既有 harness 进行五维评分审计、生成可分享的评估报告,以及理解支撑这些

gitblog_01079的博客 663

AI Agent工程化落地:从Harness框架到并发安全与评测实践

大语言模型能力日趋成熟,真正制约AI Agent落地的已从模型效果转向工程化能力。Agent作为以LLM为核心的智能体,需要Harness框架来管理循环、工具调用与上下文,需要编排层解决并行调度与记忆分配,更需要安全机制应对提示注入和记忆投毒。在生产环境中,高并发场景下如何通过信号量、队列与降级策略扛住流量,以及如何借助LLM as Judge实现自动化评测,都是从Demo走向稳定服务的关键。本文围绕agent框架选型、内存管理、容错控制与评测回流等实践,分享了一套可复用的工程方法论。

weixin_42537499的博客 244

semantic-router Agent Harness 接入指南:vllm-sr/auto 虚拟入口、路由策略与工具循环会话连续性

本篇基于 [Connect an agent harness](https://link.gitcode.com/i/03d4c401485331ce2f4cfedb3b575af6) 文档,讲解如何把 Claude Code、Codex CLI 等 agent harness 接入 semantic-router 的 Router 入口点:如何配置推理连接与协议路径、如何验证 `vllm-sr/

gitblog_00323的博客 365

科技中介服务机构如何提升技术评估的智能化与专业化水平?.docx

科易网基于AI模型+行业大数据,在技术转移、成果转化、技术经纪、知识产权、产业创新、科技招商等垂直领域的多样化应用场景,推出科技创新领域的AI+工具与数智化解决方案,推动科技创新与产业创新智能化发展。

CV领域交叉注意力机制:QKV在图像特征增强中的核心作用解析

本文深入解析了CV领域中交叉注意力机制的核心组件QKV在图像特征增强中的关键作用。通过通俗类比和实战案例,阐述了Q(查询)、K(键)、V(值)如何协同实现动态权重分配,从而在目标检测、图像分割与生成等任务中显著提升模型性能与语义对齐能力。

weixin_29194817的博客 414

harness engineering 实战:用 TaoToken 统一 Key 打通多模型评测流水线

评测脚本密钥散落、切换模型要改代码?本文用 harness engineering 思路把多模型评测收敛到统一通道:一份 Key 与 Base URL 外置到环境变量,MODELS 列表控制模型切换,并给出可复制的 Python/TypeScript 代码与 401、local proxy failed 等报错排查。接入 TaoToken 官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 即可跑通对比流水线。

LapisLion88的博客 206

Quantum Espresso Hands-On实战训练(四)——PDOS计算与轨道分析

本文详细介绍了Quantum Espresso中PDOS计算与轨道分析的实战方法,重点解析了PDOS在材料电子结构研究中的核心价值,包括原子级分辨率、轨道级解析和自旋极化分析。通过具体案例和操作步骤,帮助读者掌握从输入文件准备到结果解读的全流程,并提供了高级分析技巧和疑难问题解决方案。

weixin_29211309的博客 498

Agent harness 复现率 28%:5 基座 harness 屠夫榜

本文对2026年Q3主流AI基座在Agent评测链路中的适配性进行横评对比。测试聚焦工具调用合规性、多轮状态保持等核心指标,发现仅有28%的公开评测脚本能在第三方模型上原样跑通。Claude Opus 4.7以97%的通过率高居榜首但价格昂贵,Qwen3.7-Plus以95%通过率成为性价比最优选。研究同时揭示了各基座的场景短板:如DeepSeek-V3.2在多跳QA场景掉链率达29%,ERNIE-4.0-8K在长代码任务中因上下文限制表现不佳。

gl366的博客 766

群晖Web Station实战:从零搭建个人静态导航站

本文详细介绍了如何利用群晖NAS自带的Web Station套件,从零开始搭建个人静态导航站。通过安装Web Station、上传静态网站源码、配置网页服务与网络门户等步骤,无需代码基础即可实现内网访问。文章还分享了文件权限设置、个性化定制及常见问题排查等实用技巧,帮助用户高效管理个人常用网址,充分挖掘NAS的服务器潜能。

tea88的博客 1321

Zynq 【SDK裸机开发之PS】——DDR的内存分配使用详解

Zynq如果跑操作系统的话,内存管理的工作都会交给系统来操作,但是如果是裸机的话,则需要自己对DDR3的内存进行管理。

shizhibuyi1234的博客 7369

Agent Harness架构解析:从零实现到企业级落地

大模型应用开发中,模型本身只负责文本生成,真正决定业务能否落地的是外围工程层。function calling 虽然能让模型返回结构化参数,但实际生产还必须处理循环控制、工具权限、上下文膨胀、安全防护与效果评测等问题。Harness 正是连接模型与业务系统的中间件,它通过统一模型接入、工具注册、记忆管理、控制循环和安全 Guard,让 Agent 在真实场景中稳定运行。本文从零基础视角拆解 Harness 的七个核心组件,用 Python 实现一个最小可运行的 Agent Harness,并扩展至企业级分层

weixin_34026276的博客 413

银河麒麟V10 SP1忘记密码?3分钟搞定单用户模式密码重置(附详细截图)

本文详细介绍了银河麒麟V10 SP1操作系统忘记登录密码后的应急恢复方法。核心是通过GRUB引导菜单进入单用户模式,无需密码即可获得root权限,从而快速重置用户密码。文章提供了从捕捉GRUB界面、编辑启动参数到执行密码修改命令的完整步骤图解与常见问题解决方案,帮助用户在几分钟内恢复系统访问。

w3x4y的博客 901

别只给 AI 产品接模型:Agent 能做成事,靠的是策略和 Harness

AI 产品不只是接入模型。真正让 Agent 做成事的,是策略、交互、评测和 Harness 形成的运行闭环。

AI 小老六的博客 558

为什么你的XGBoost多分类效果不如预期?可能是这5个参数没调对

本文深度剖析了XGBoost模型在处理多分类问题时效果不佳的五大关键参数陷阱。针对多分类问题的独特性,文章提供了max_depth、learning_rate、采样参数及正则化参数等核心参数的量化调整策略与诊断方法,帮助开发者精准调优,有效提升模型在各类别上的均衡性能与泛化能力。

weixin_29182481的博客 293

Cadence 批量一次性修改title 页码标题

本文介绍如何在Cadence软件中对DSN文件进行标题栏的批量编辑操作,包括选择编辑对象、使用快捷键打开属性面板以及如何修改标题、页码等关键信息。

tianpu2320959696的博客 969

上线不是结束——从 V3 午夜事故到 Auto Harness 评测驱动的安全发布

本文以构造的V3系统发布事故为背景,阐述AutoHarness在发布前的能力评测闭环如何通过五步循环(评测→识别差距→规划→实施→再评测)提前发现并修复技能命中率从95%降至78%的严重退化问题。结合灰度发布与A/B测试,构建“评测→灰度→A/B→全量→持续优化”的三道防线体系,强调跳过任一环节均可能导致类似午夜事故。文中唯一真实证据为4.6节六轮复现日志与4.7节真实发布门禁实录,验证了评测机制的有效性。核心结论:真正安全的发布不在于事后回滚,而在于事前拦截——AutoHarness让问题从未进入生产环境

七夜zippoe的博客 2万+

HFSS实战项目——微带带通滤波器设计

本文详细介绍并设计了一款微带带通滤波器,通过HFSS三位电磁仿真软件对其进行仿真设计及优化,仿真结果表明,本文设计的滤波器表现出优良的滤波性能,符合设计要求。

2401_87464239的博客 5382

MoviePilot Agent 与 Codex Harness 对齐路线:真实模型评测、配对验收与工具闭环落地指南

> 本文基于仓库内 [agent-codex-parity-plan.md](https://link.gitcode.com/i/8c8bb5da5ff071c45f0cea29adb66f19) 编写,结合 `scripts/evaluation/` 评测框架源码、`skills/moviepilot-api/SKILL.md` 工具合同与相关测试展开。这是一份面向开发者的路线图解读与实操指南

gitblog_00074的博客 86

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

深度解析:AI Agent Harness Engineering 行为策略模型与奖励机制——用 TaoToken 统一 Key 跑通多工具 Agent 评测

用 TaoToken 统一 Key 跑通 Cline MCP、Windsurf BYOK 与 Claude Code 多工具 AI Agent 评测,固定 endpoint 为常量,让行为策略模型与奖励机制成为唯一变量。含可复制配置片段、奖励信号回传脚本与 401、local proxy failed、reading choices、OAuth 四类报错排查。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42610671的博客 50

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

VS Code 中 GitHub Copilot 的 Coding Harness 深度解析:Agent 循环、工具编排与 VSC-Bench 评估

> 2026 年 5 月,VS Code 团队(Julia Kasper、Megan Rogge 与 Aaron Munger)在官方博客中系统阐述了 GitHub Copilot 在 VS Code 中的核心工程概念——**coding harness(编码驱动层)**。本文以此为基础,结合本仓库(vscode-docs)中 [Agent harnesses 概念文档](https://link

gitblog_00973的博客 319

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

LangGraph + Harness 评测体系,实现一个能够执行长程任务的 AI 量化 Agent

大语言模型(LLM)结合 Agent 架构,在金融量化领域掀起降维打击的根本原因。今天,我们将完全抛开烂俗的“AI理财”营销话术,从极客与系统架构的视角,硬核拆解如何利用 LangGraph 与 Harness 评测体系,手搓一个能够执行长程任务的 AI 量化 Agent,实盘跑赢 CPI。

SOOOOOOOOO的专栏 587

Prompt 之外,生产级 Agent Harness 到底在控制什么

生产级Agent Harness的六层控制体系 摘要:生产级AI Agent仅靠Prompt无法保证约束执行,需通过外置Harness实现六层控制: 任务契约 - 结构化定义目标、权限与验收条件 状态管理 - 维护最小必要上下文与恢复快照 调度层 - 控制工具并发/模型路由/幂等执行 预算监督 - 多维资源管控与强制停止权 验证恢复 - 基于证据的状态迁移与回滚 事件账本 - 全链路审计与回归分析 核心原则:将必须成立的规则(如权限、预算)从Prompt移至确定性的控制层,通过结构化层间交接物(如依赖图、状

谢谢你的喜欢 我们一起无限进步 602

PostHog 沙箱化 Eval Harness 架构解析:一次引导共享基础设施、并发跑完所有 Agent 评测套件

本篇文章深入解析 PostHog 开源仓库中 `products/posthog_ai/eval_harness/harness/` 这一套独立的**沙箱化评测运行器(Sandboxed Eval Harness)**。它以一套共享基础设施(测试数据库、进程内 Django 服务器、LLM 网关、MCP 服务器、Temporal 服务与 worker)的一次性引导为核心,在单一事件循环上并发执行全

gitblog_00207的博客 449
上一篇: Agent Harness 异常场景分析及优化方案
HiHi_Peter
博客等级 码龄6年 725粉丝 194原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

HiHi_Peter

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值