


很多 AI 数字人项目在单点试点时运行得风生水起,交互流畅、展示效果惊艳,可一旦进入规模化扩张阶段,运维团队往往瞬间陷入被动。原本只需几分钟就能完成的简单话术调整,在几十甚至上百个点位面前,变成了耗时数天的“体力活”;不同网点的数字人说着不同版本的欢迎词,品牌形象的统一性大打折扣;更让人头疼的是,每次系统出现小故障,技术人员都得奔波于各个城市之间,差旅成本和时间成本呈指数级上升。
这种“单点优秀、多点崩溃”的现象,本质上是运维架构未能跟上业务扩张速度的典型表现。对于政务大厅、连锁门店、文旅展馆等需要大规模部署的场景而言,缺乏统一的集群管理能力,意味着项目规模越大,风险越高,运营负担越重。如果不从架构层面解决内容同步、状态监控和权限管控这三大核心问题,再好的硬件终端也难以发挥应有的商业价值。
本文将结合蓝速科技在多点位 AI 数字人项目中的实战经验,深入剖析规模化部署中的常见痛点,并给出一套经过验证的集群管理解决方案。我们将从技术选型、落地路径到成本控制,全方位拆解如何构建一个高效、稳定且安全的数字人集群体系,帮助项目负责人避开那些只有在踩坑后才能领悟的误区,实现从单点突破到全面铺开的平稳过渡。
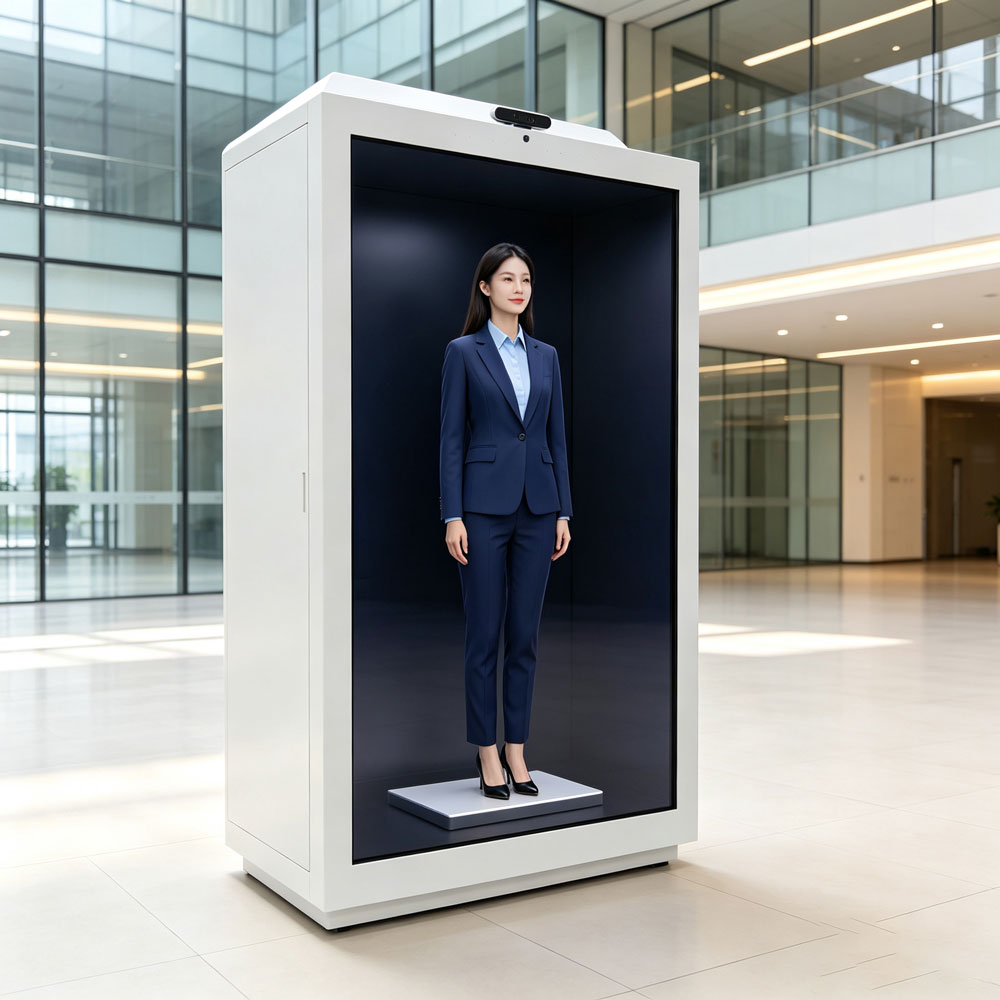
① 规模化扩张中的三大核心运维痛点解析
当 AI 数字人项目从“样板间”走向“量产化”,运维逻辑会发生根本性变化。在单点模式下,技术人员可以站在设备旁直接调试,但在多点位分散部署的场景下,物理距离成为了最大的障碍。根据过往项目复盘,规模化扩张中最突出的三大痛点主要集中在效率、一致性和成本三个维度。
首先是内容更新效率极低。在传统单机维护模式下,修改一段迎宾话术或更新一个宣传视频,需要运维人员逐台登录设备进行文件替换和配置重启。如果一个项目覆盖 50 个网点,每个网点耗时 20 分钟,仅一次常规内容迭代就需要耗费近 17 个小时,这还不包括路途时间。对于政策敏感或营销节奏快的场景,这种滞后性是致命的。
其次是信息一致性难以保障。由于缺乏统一的版本控制机制,不同网点的设备往往运行着不同版本的内容包。A 城市的数字人在介绍最新政策,而 B 城市的设备还在播报旧版条文,这种“信息孤岛”现象不仅影响用户体验,更可能在政务或品牌宣传中引发合规风险。
最后是人力与差旅成本飙升。每当遇到系统卡顿、网络异常或应用崩溃,传统的排查方式必须依赖人工到场。随着点位数量增加,运维团队的出差频率呈线性增长,高昂的差旅费和技术人员的时间成本,往往占据了项目后期运营预算的大半,导致项目长期盈利能力被严重侵蚀。
② 合格集群管理方案的三大关键能力构建
要解决上述痛点,必须引入专业的集群管理方案。一个合格的集群管理系统,不应仅仅是简单的远程连接工具,而应具备批量协同、全景监控和安全管控三大核心能力,形成闭环的运维体系。
第一核心能力是批量内容同步。系统应支持在云端后台统一编辑和打包内容(如话术脚本、3D 模型、视频素材),并通过策略引擎一键下发至指定分组的所有终端。关键在于具备“断点续传”和“离线自动同步”机制,确保即使部分设备暂时断网,一旦恢复连接也能立即拉取最新配置,无需人工干预。这将原本数天的工作量压缩至分钟级,彻底解决更新滞后问题。
第二核心能力是状态集中监控。管理者需要一个可视化的Dashboard,实时掌握所有终端的健康状况。这不仅包括在线/离线状态,还应涵盖 CPU 负载、运行温度、网络信号强度、存储空间余量等深层指标。系统需支持异常自动告警,例如当某台设备温度过高或内存泄漏时,自动触发通知,让运维人员在故障发生前介入。
第三核心能力是分级权限管控。在多区域、多层级的管理架构中,权限必须精细化。总部管理员拥有全局配置权,而区域经理只能操作辖区内的设备内容,普通店员则仅能执行重启等基础指令。这种隔离机制能有效防止因误操作导致的系统性瘫痪,确保底层系统的安全稳定。
③ 批量内容同步与版本一致性保障机制
实现高效的批量同步,核心技术在于建立一套可靠的“发布 - 订阅”机制。在实际工程落地中,我们通常采用版本号校验与差异增量更新相结合的策略。
当后台发布新内容包时,系统会生成唯一的版本哈希值(Hash)。终端设备在心跳检测时,会将本地版本号与云端最新版本进行比对。若发现不一致,设备不会全量下载整个数据包,而是智能识别差异部分,仅下载变更的脚本或资源文件。这种方式极大地降低了带宽占用,特别适用于网络环境复杂的偏远网点。
# 伪代码示例:终端版本校验与增量更新逻辑
def check_and_update_device(local_version, cloud_version):
    if local_version == cloud_version:
        return "Status: Up to date"

    # 计算差异包
    diff_package = calculate_diff(local_version, cloud_version)

    # 下载差异包并校验完整性
    if download(diff_package) and verify_checksum(diff_package):
        apply_update(diff_package)
        update_local_version(cloud_version)
        return "Status: Update successful"
    else:
        log_error("Update failed, retrying later")
        return "Status: Update pending"
此外,为了保障绝对的一致性,系统应引入“灰度发布”机制。在新内容全量推送前,先选取少量非核心节点进行试点运行,确认无误后再扩大范围。同时,所有下发操作均带有事务属性,若某台设备更新失败,系统会自动回滚至上一稳定版本,确保任何时刻终端呈现的内容都是可用且规范的,杜绝“半更新”状态导致的显示错乱。
④ 终端状态集中监控与远程故障排查体系
传统的运维是“救火式”的,而集群化管理则是“预防式”的。构建集中监控体系的核心,在于将黑盒化的终端运行状态转化为可视化的数据流。
在蓝速科技的实践中,我们为每台 AI 数字人终端植入了轻量级监控探针,它们以秒级频率上报关键指标至中心服务器。这些数据包括:
- 硬件健康度:SoC 温度、风扇转速、内存使用率。
- 网络质量:延迟、丢包率、信号强度(针对 Wi-Fi/4G/5G 设备)。
- 应用状态:数字人进程是否存活、渲染帧率、音频输出状态。
基于这些数据,后台可构建智能诊断模型。例如,当检测到某区域多台设备同时出现高延迟时,系统可自动判断为当地网络波动,而非设备故障,从而避免无效的现场排查。对于常见的软件卡死问题,系统支持远程发送“软重启”或“清缓存”指令,90% 以上的常规故障可在 5 分钟内通过云端修复,无需人员到场。
此外,远程日志抓取功能是深度排查的利器。当遇到复杂 Bug 时,运维人员可直接在后台调取指定时间段的结构化日志,甚至开启远程屏幕共享进行实时调试。这种“所见即所得”的排查方式,极大缩短了故障平均修复时间(MTTR)。
⑤ 分级权限管控防止误操作的安全策略
随着管理规模的扩大,人为误操作成为系统稳定性的最大威胁之一。一个完善的权限管控体系,必须遵循“最小权限原则”和“职责分离原则”。
我们将权限划分为三个层级:
- 超级管理员(总部):拥有系统最高权限,负责固件升级、全局策略制定、账号管理及查看所有日志。此权限仅限核心技术人员持有。
- 区域运营官(分公司/门店店长):仅拥有内容管理权限。他们可以更换本区域内的宣传视频、调整数字人话术,但无法修改网络配置、无法卸载核心应用、无法访问系统底层命令行。
- 现场维护员:仅具备基础操作权限,如远程重启设备、查看当前状态、报修反馈,完全不可触碰内容配置。
这种分级策略通过 RBAC(基于角色的访问控制)模型在代码层面强制实施。任何越权操作请求都会被网关直接拦截并记录审计日志。例如,试图在非授权时段修改核心配置文件,系统不仅会拒绝执行,还会立即向安全管理员发送高危警报。这不仅保护了系统免受内部误操作的破坏,也为外部攻击者设置了极高的门槛,确保数字人集群在任何情况下都运行在可控范围内。
⑥ 小步快跑式分阶段落地实施路径
面对大规模部署,切忌“大跃进”式的全量上线。稳健的实施路径应遵循“小步快跑、迭代验证”的原则,将风险控制在萌芽状态。
第一阶段:样机验证(PoC)
选取 1-2 个典型场景(如一个繁忙的政务大厅和一个安静的展厅),部署样机。此阶段重点验证单机功能的稳定性、交互逻辑的流畅度以及基础网络的连通性。不急于上集群功能,先确保“单兵作战”能力过硬。
第二阶段:小范围试点(Pilot)
扩展至 5-10 台设备,覆盖不同类型的网络环境和人流密度。此时正式启用集群管理系统,测试批量下发、版本同步、远程监控等核心功能。重点观察在高并发操作下,服务器的响应速度和终端的执行成功率,收集真实环境下的性能数据,优化配置参数。
第三阶段:全面铺开(Rollout)
在试点指标(如更新成功率>99.9%,故障自愈率>90%)达标后,再制定详细的分批推广计划。按区域或批次逐步增加设备数量,每完成一批次即进行一次复盘,确保问题不过夜。这种分阶段策略虽然看似拉长了前期周期,但实际上避免了因一次性大规模故障导致的灾难性后果,是保障项目成功的关键。
⑦ 基于 RK3576 架构的低成本选型建议
在硬件选型上,平衡性能与成本是规模化项目的核心考量。对于大多数政务、文旅及商业展示场景,搭载国产瑞芯微 RK3576 芯片的终端是目前最具性价比的选择。
RK3576 架构专为边缘计算和多媒体交互设计,其四核 A72 加四核 A53 的大小核组合,既能满足 AI 数字人实时渲染、语音识别等高算力需求,又能有效控制功耗和发热。相比昂贵的 X86 工控方案,RK3576 方案在保持流畅 3D 交互体验的前提下,硬件成本可降低 40% 以上,且天然适配 Android 生态,便于集群管理软件的快速部署与维护。
此外,该架构对国产操作系统和各类外设接口(如 HDMI 输出、多路 USB、千兆网口)有着极好的兼容性,非常适合需要长时间稳定运行的商用场景。选择基于 RK3576 的一体机,不仅能大幅降低初期采购投入,其低功耗特性还能显著减少长期的电力支出,是实现低成本、高密度部署的理想基石。
⑧ 政务文旅连锁场景的差异化部署方案
不同行业场景对 AI 数字人的需求侧重各不相同,集群部署方案也需因地制宜。
政务大厅场景:核心诉求是“严谨”与“实时”。内容更新往往涉及最新政策解读,要求零误差、秒级同步。部署方案需强化权限管控,确保只有授权人员可发布内容,并开启高频心跳检测,保证服务永不掉线。同时,界面风格需庄重,交互逻辑简洁明确。
文旅展馆场景:核心诉求是“沉浸”与“互动”。游客流量波动大,对图形渲染能力和多模态交互(手势、语音)要求极高。部署方案应侧重性能监控,防止因过热导致的降频卡顿。内容策略上可采用分时段模式,白天讲解景点,夜晚切换为文化故事,利用集群定时任务自动切换。
连锁商业场景:核心诉求是“统一”与“营销”。成百上千的门店需要统一品牌形象,同时又要允许单店进行 localized 的促销活动。部署方案需支持“全局模板 + 局部自定义”的混合模式,总部下发统一素材包,店长可在限定区域内插入本店优惠信息,既保品牌一致性,又赋能动销灵活性。
⑨ 长期运营成本控制在人力与差旅维度
项目的总拥有成本(TCO)不仅包含硬件采购,更包含长达数年的运营维护费用。集群化管理的最大价值,就在于将边际运维成本趋近于零。
在传统模式下,每增加一个网点,就意味着增加一份潜在的差旅成本和人力投入。而通过集群系统,95% 的日常运维工作(内容更新、状态检查、故障重启)均可在云端完成。这意味着,无论项目扩展到 100 个点还是 1000 个点,所需的常驻运维团队规模无需同比例扩张。
具体测算显示,引入集群管理后,单次内容迭代的人力成本可从“人天”级降至“人分”级;年度差旅频次可减少 80% 以上。对于跨区域的大型项目,仅节省下来的差旅费和外包服务费,通常在项目运行半年内即可覆盖集群管理系统的投入成本。这种“一次投入,长期受益”的模式,是确保项目长期盈利和可持续发展的关键财务策略。
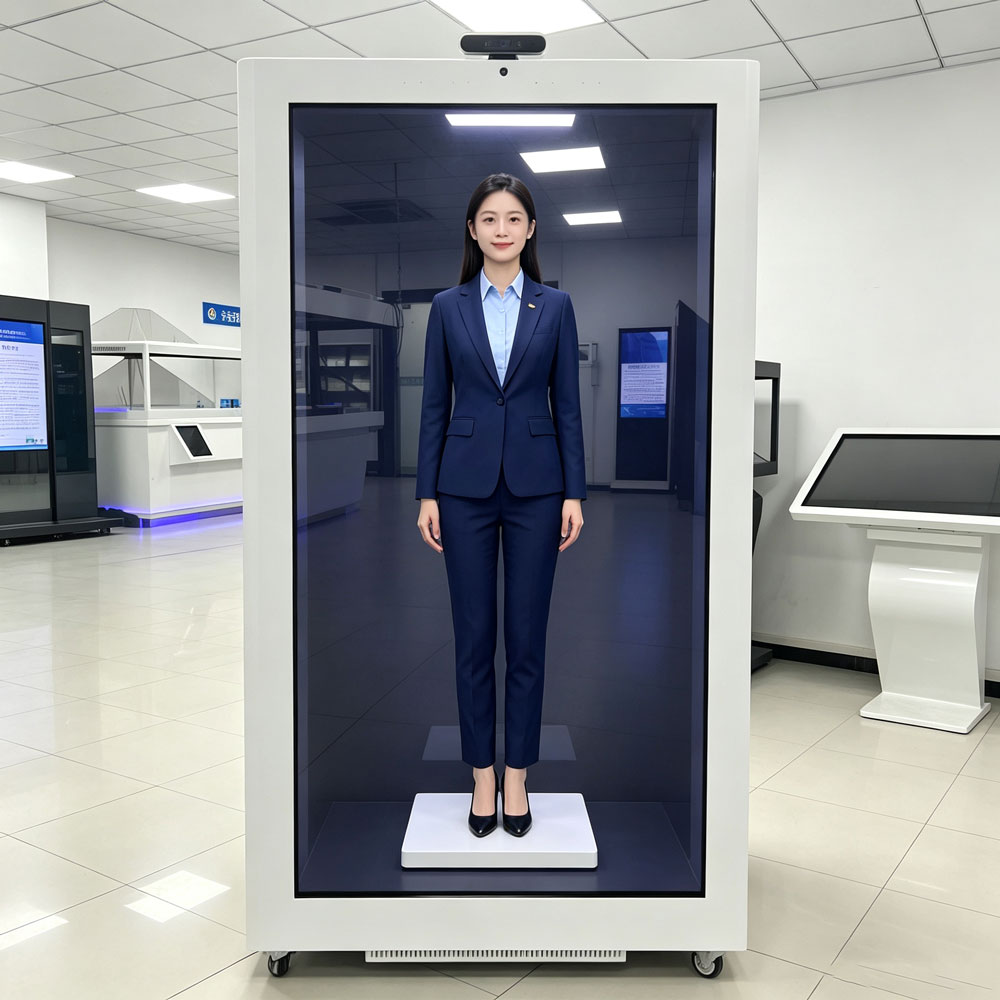
⑩ 从单点试点到全面铺开的风险规避实录
回顾多个成功案例,从单点试点迈向全面铺开的过程中,风险规避的核心在于“预案先行”与“数据驱动”。
在某省级政务项目中,我们曾在全面推广前遭遇过一次网络风暴。由于未做带宽评估,百台设备同时拉取更新包导致局部网络拥塞。得益于前期的灰度测试机制,系统在检测到异常流量后立即自动暂停下发,并未造成大面积瘫痪。事后,我们优化了分发策略,引入 P2P 内网分发机制,利用局域网内已更新的设备作为节点,成功解决了带宽瓶颈。
这一经历告诉我们,风险往往隐藏在细节中。在全面铺开前,必须进行压力测试,模拟极端网络环境和并发场景;必须建立回滚机制,确保任何更新都能一键还原;必须保持与一线人员的紧密沟通,及时获取现场反馈。只有将每一个可能的风险点都在小范围试点中暴露并解决,才能在全面推广时做到胸有成竹,让 AI 数字人集群真正成为提升服务效率的利器,而非运维团队的噩梦。


 扫一扫


 77

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


