



论文题目:Image-to-Point Cloud Feature Back-Projection for Multimodal Training of 3D Semantic Segmentation(用于 3D 语义分割多模态训练的图像到点云特征反投影)
会议:CVPR 2026
摘要:有效融合并利用相机与 LiDAR 获取的多模态数据,对感知系统至关重要。本文提出 Image-to-Point Cloud Feature Back-Projection(IPFP),一种新的多模态融合网络训练方法。IPFP 从未与点云投影位置严格对齐的图像像素中聚合图像特征中心,再借助估计深度图将其反投影到点云特征集合中。这样,图像特征与点云特征处于同一三维空间,可在网络前向传播过程中自然地将图像信息注入点云表示。该过程可以只在训练阶段开启,而当测试时只能获得 LiDAR 时关闭。实验表明,IPFP 能稳定提升先进 3D 语义分割模型,同时保留 LiDAR-only 推理能力。
一、研究背景:为什么还要重新设计多模态 Fusion?
图像提供颜色和纹理,LiDAR 提供精确几何。传统方法通常为两种模态分别设计 Backbone,再做高层融合,即典型 dual-branch architecture,但两套网络会增加训练成本,有些方法甚至需要裁剪图像来控制计算量。
另一个问题是 Camera 与 LiDAR 的 FOV 不一致。LiDAR 往往覆盖更大范围,而相机只有有限视角;如果融合依赖严格 point-to-pixel 对齐,图像外的 LiDAR 点就无法获得视觉信息。IPFP 因此提出另一种思路:不把点云投到图像中寻找对应特征,而是把图像特征反投影成“3D 点”,直接和 LiDAR 一起进入同一个 3D Backbone。
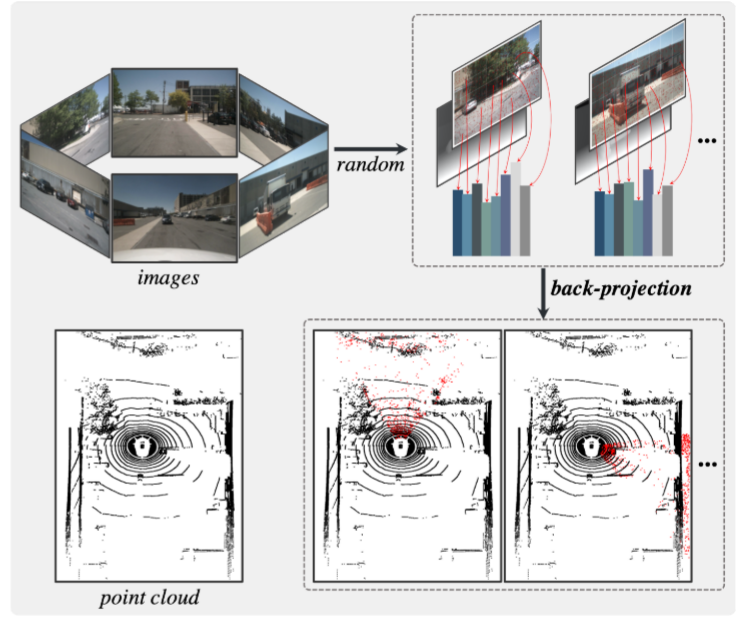
论文 Figure 1:聚合图像特征反投影到真实 3D 空间
Figure 1 中黑色点是 LiDAR,红色点是反投影后的图像特征点。两者进入同一个物理 3D 空间后,可以直接借助原有 3D 网络的空间邻域聚合进行联合学习。
二、IPFP 整体框架:训练时多模态,推理时纯 LiDAR
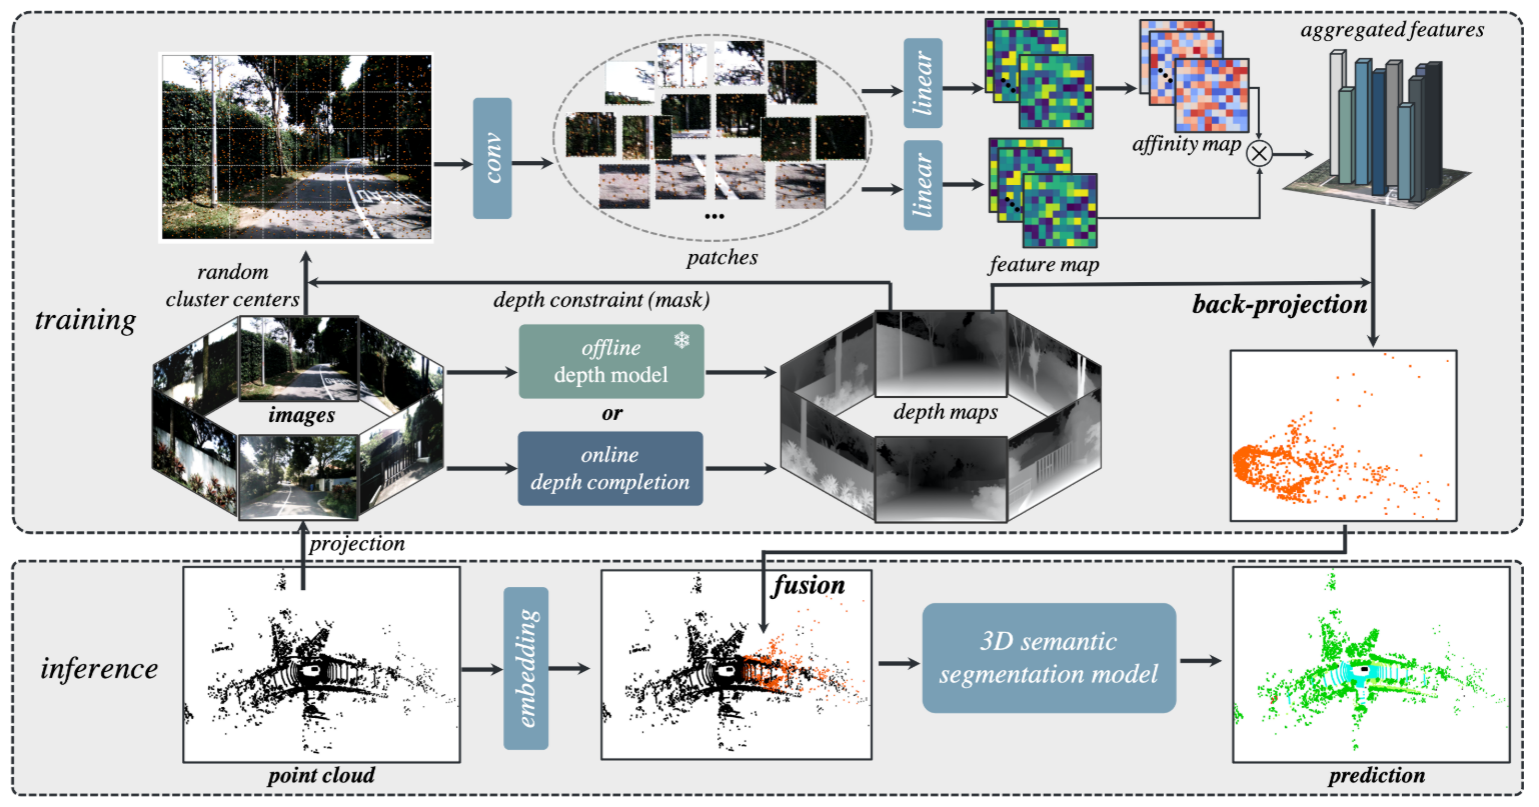
论文 Figure 2:IPFP 整体架构
整体流程可以概括为:
Image → Depth → Cluster Sampling → Feature Aggregation → 3D Back-Projection
LiDAR + Back-Projected Image Features → 3D Backbone → Semantic Prediction
训练阶段,图像先得到深度图,再在深度约束范围内采样 cluster centers。每个 center 聚合周围图像特征,并依据深度和相机参数反投影到真实 3D 坐标,形成带视觉语义的“特征点”。这些点与 LiDAR point feature 合并后共同进入 PTv3、SPVCNN 等 3D 网络。
关键在于,IPFP 没有为图像维护完整的 2D 语义 Backbone,图像侧只包含轻量卷积、线性映射与局部聚合。推理时整套图像生成与反投影模块都可以删除,只保留原始 3D 网络。
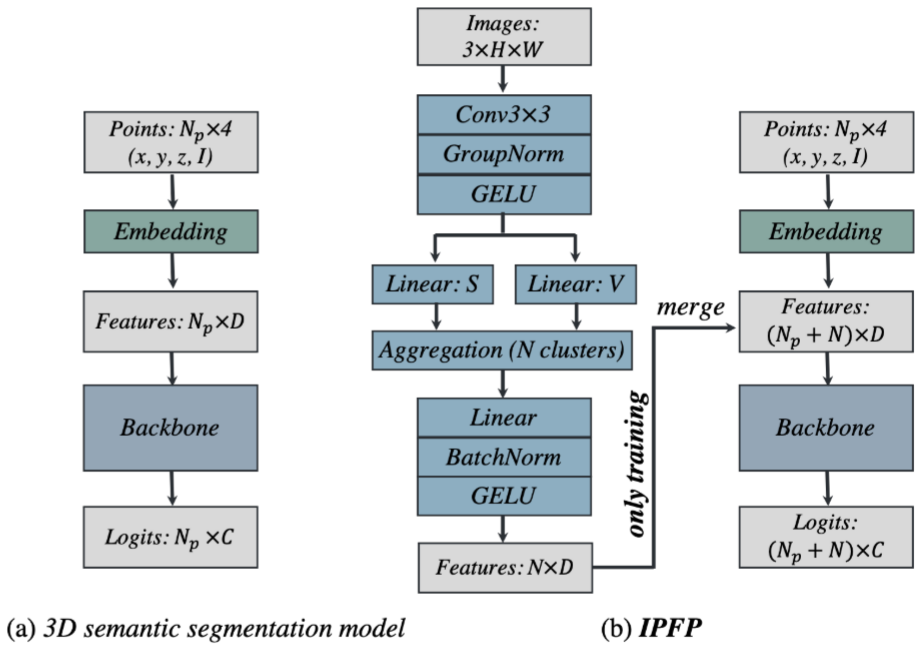
论文 Figure 6:Base Model 与 IPFP 网络结构对比
Figure 6 说明 IPFP 只在训练时把 N × D 的图像聚合特征加入点特征;推理结构与 baseline 相同。因此多模态信息在这里更像一种训练期增强信号,而不是部署时必须保留的输入。
三、Depth-Constrained Feature Aggregation:哪些图像信息值得变成 3D 点?
图像对应的 metric depth 可以来自 Depth Anything V2、UniDepth,也可以来自 IP-BASIC 在线 depth completion。若模型只输出 relative depth,论文利用 LiDAR 投影点恢复 scale 和 shift,得到 Dm = sDr + t。
随后根据 LiDAR 投影深度分布设置上下百分位阈值,并构造:
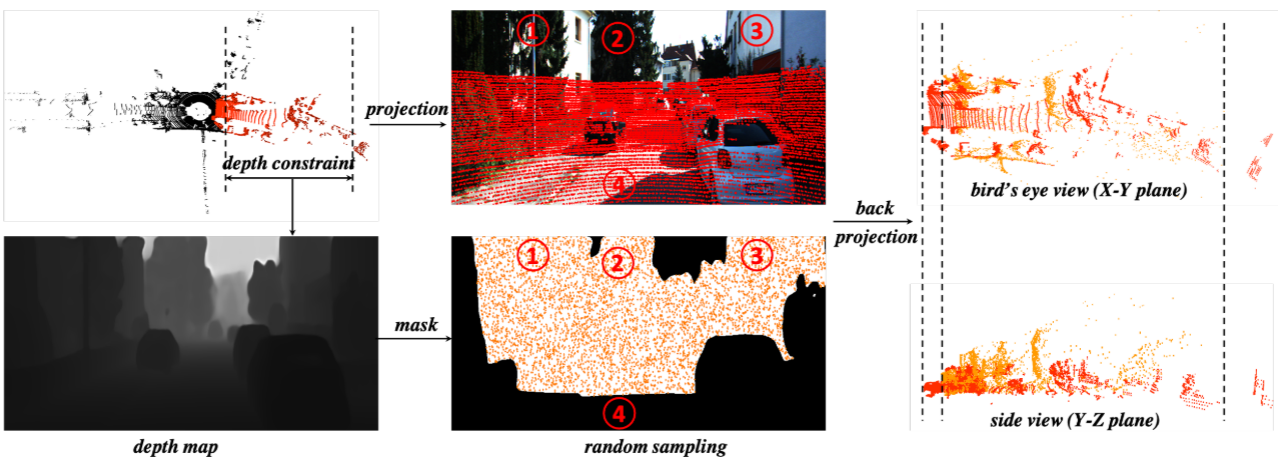
论文 Figure 3:Depth-constrained cluster center sampling
Figure 3 展示了这一设计的目的。近场 LiDAR 本身已经很密,视觉信息增量有限;中远距离点云更稀疏,图像信息更有价值。因此作者利用 depth mask 过滤近场低信息区域,同时允许在已有 LiDAR 投影点之外随机采样新的 cluster centers,从而扩大视觉信息覆盖。
每个 center 不是简单读取单个 pixel feature,而是根据局部 cosine similarity 对 patch 内像素加权聚合,得到 D 维特征 fc。语义相似度越高的邻域像素,对 center 的贡献越大。
四、Feature Back-Projection:直接把图像特征并入 3D Backbone
对 cluster center (ur, vr) 及其 metric depth dm^r,利用相机内参 K 和外参 T 可以得到真实 3D 坐标:
于是图像侧得到点集 Pc 与特征 Fc,LiDAR 侧得到 P 与 embedding 特征 F。IPFP 直接合并 P ∪ Pc 与 F ∪ Fc。PTv3、SPVCNN 本身已有空间邻域传播机制,因此这些视觉点可以直接参与后续层级特征聚合,不需要额外显式 fusion module。
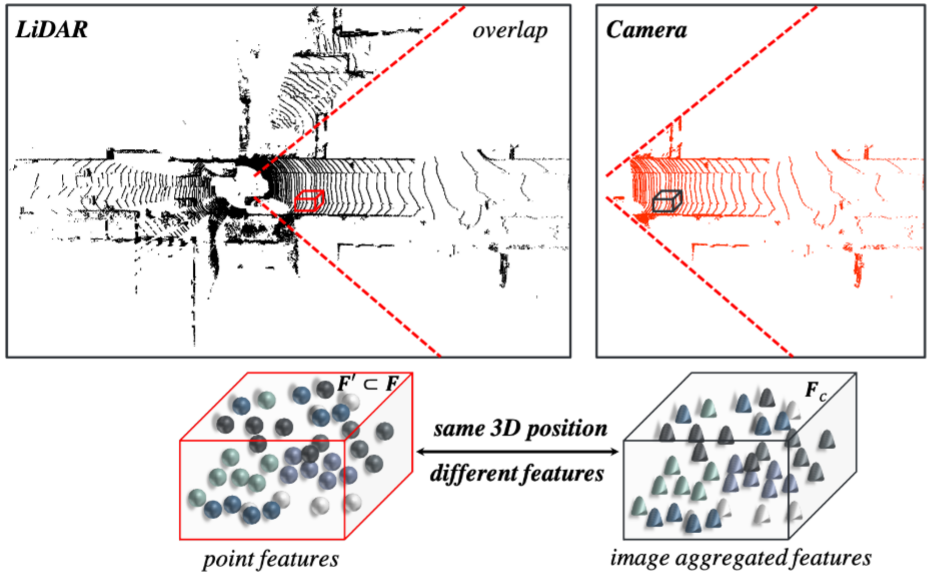
论文 Figure 4:Projection-aligned cluster center 的特征重叠问题
如果 cluster center 恰好落在已有 LiDAR 投影位置,反投影后可能出现“同一 3D 坐标、两组不同特征”的 overlap ambiguity。IPFP 因此采用前面的非严格对齐随机采样,而不是仅从已有 LiDAR projection 中选择 center。
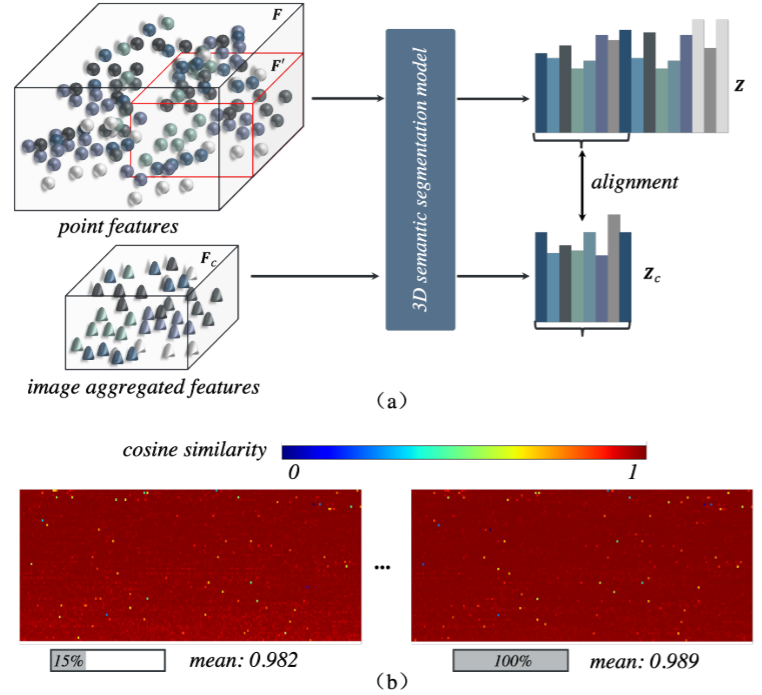
论文 Figure 5:Aligned mode 下的多模态输入解耦实验
Figure 5 中,作者把点云特征和图像聚合特征分开输入同一模型并做在线蒸馏。两种模态输出在训练 15% 时 cosine similarity 均值已约 0.982,训练结束后约 0.989,说明严格对齐提供的新信息有限。论文据此支持使用非对齐视觉特征扩大训练信息增量。
为了避免网络过度依赖图像,IPFP 还会随机丢弃部分 back-projected feature:以概率 γ 启用 discard operator,启用后每个图像特征点再以概率 δ 被丢弃。这等价于在训练期间主动模拟“测试时只有 LiDAR”。
五、实验结果与消融分析
实验覆盖 SemanticKITTI、nuScenes 和 Waymo,评价阶段全部只使用 LiDAR。IPFP 分别接入 PTv3 与 SPVCNN,用于验证方法的 Backbone 泛化性。
5.1 主实验
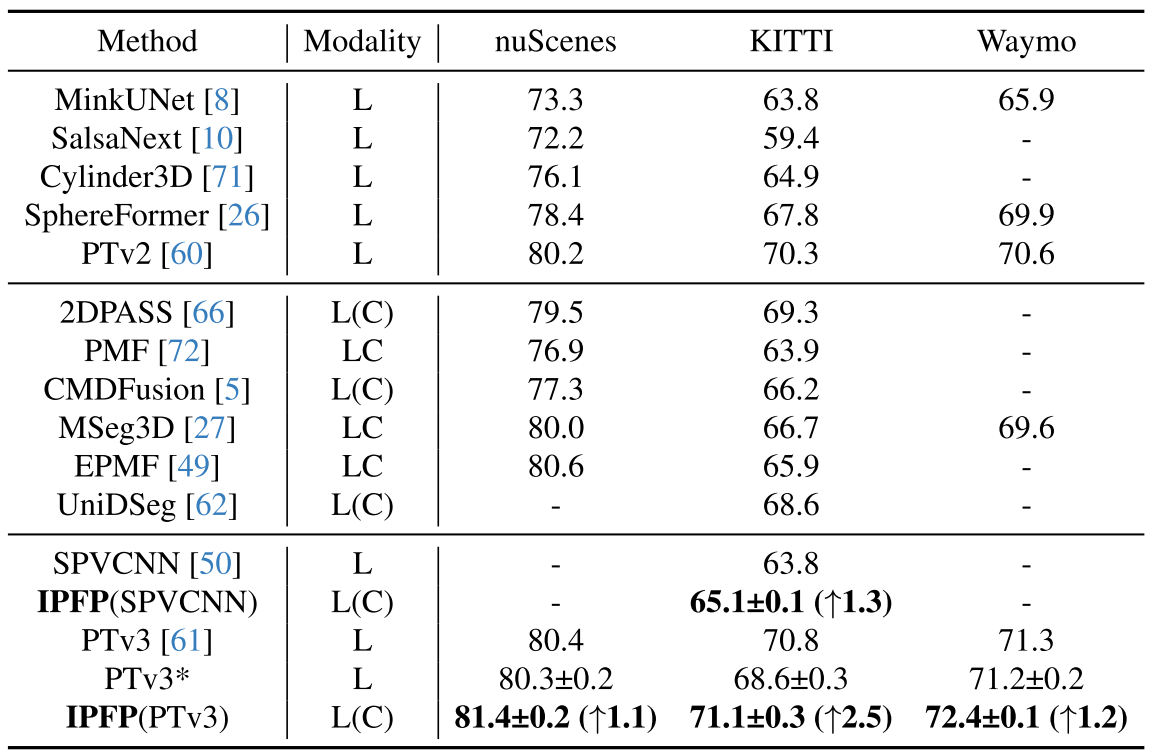
论文 Table 1:3D 语义分割 mIoU 对比
基于 PTv3 官方实现/预训练模型的 baseline,在 nuScenes、SemanticKITTI、Waymo 上分别为 80.3、68.6、71.2 mIoU;加入 IPFP 后提升到 81.4、71.1、72.4,对应 +1.1、+2.5、+1.2。换成 SPVCNN,SemanticKITTI 也由 63.8 提升到 65.1。表中的 L(C) 表示训练使用 LiDAR + Camera,而推理只用 LiDAR,这正是 IPFP 的核心部署属性。
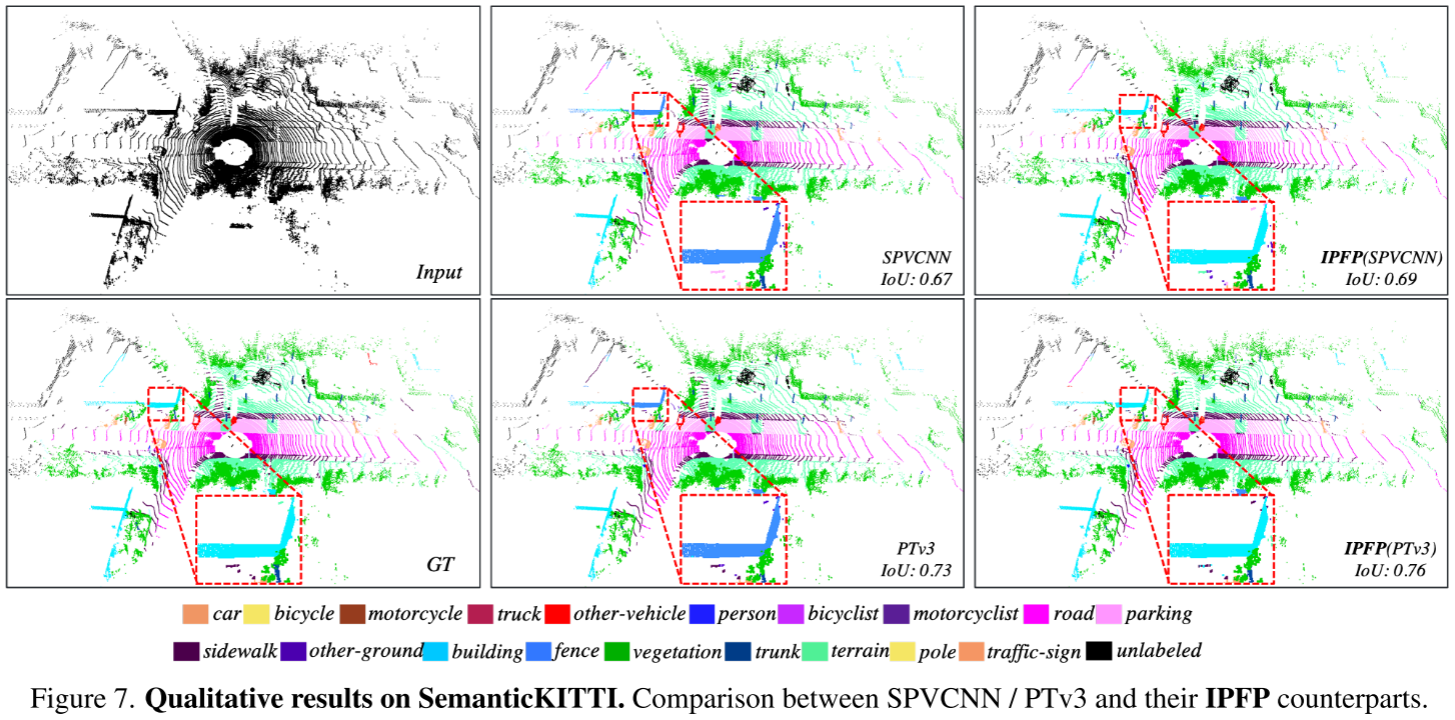
论文 Figure 7:SemanticKITTI 定性结果
Figure 7 中,IPFP-SPVCNN 与 IPFP-PTv3 相比各自 baseline 在车辆、道路边界和部分小目标区域的预测更完整,与 Table 1 的定量提升一致。
5.2 训练效率
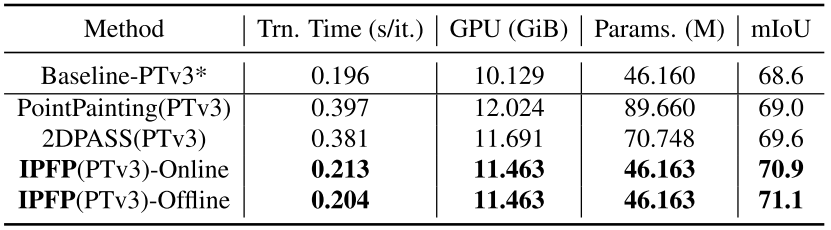
论文 Table 2:不同 Fusion 方法效率对比
Baseline PTv3 每次迭代 0.196 s,PointPainting 为 0.397 s,2DPASS 为 0.381 s;IPFP 在线 depth completion 为 0.213 s,离线 depth map 为 0.204 s。参数量方面,Baseline 为 46.160M,IPFP 为 46.163M。论文指出图像特征提取模块只有约 0.03M 参数,因此训练开销明显低于完整双分支方案。
5.3 Depth 与 Sampling 消融
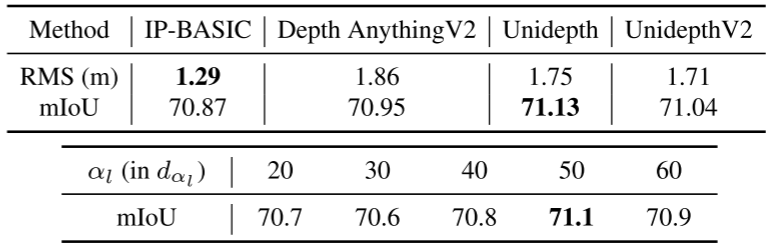
论文 Table 3:Depth Estimation 与 Depth Threshold
使用 IP-BASIC、Depth Anything V2、UniDepth、UniDepthV2 时,mIoU 都保持在约 71.0。作者解释,反投影坐标主要承担空间索引作用,后续传播依赖 3D 网络局部 receptive field,因此模型并不强依赖极高精度的深度。下界百分位 αl 从 20 到 60 时结果也只在 70.6–71.1 间变化。
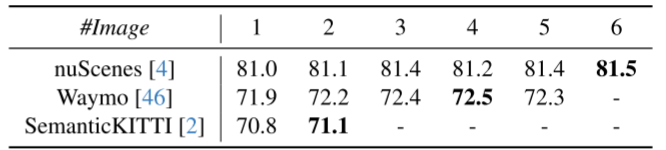
论文 Table 4:每个场景反投影图像数量
nuScenes 从 1 张增加到 3 张时,mIoU 从 81.0 增到 81.4,继续增加收益趋于饱和;Waymo 在 4 张时达到 72.5。因此主实验中 nuScenes 和 Waymo 每个场景只使用 3 张图像,以平衡效果与训练成本。
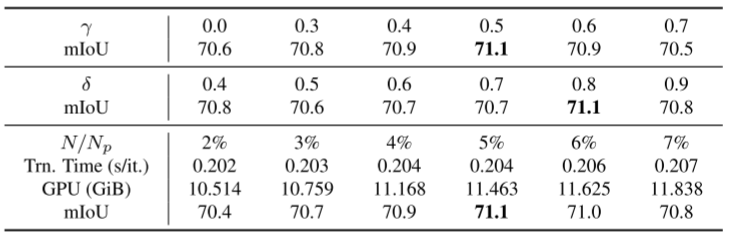
论文 Table 5:γ、δ 与 cluster center 数量
随机丢弃有助于 LiDAR-only inference:γ = 0.5 时达到 71.1,高于不启用时的 70.6;δ = 0.8 时同样达到 71.1。cluster centers 约占原始点数 5% 时最好,为 71.1;继续增加只带来少量训练时间和显存增长,却可能引入更多无标签特征并增加训练不稳定性。
5.4 Cluster Module 需要复杂 2D Backbone 吗?
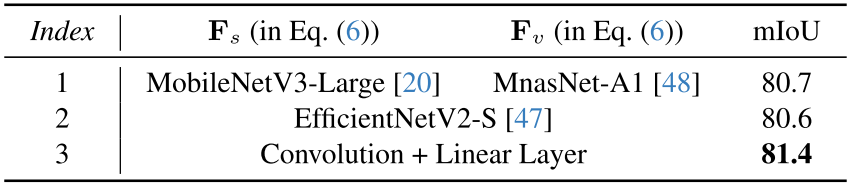
论文 Table 6:Cluster Module Network 对比
MobileNetV3-Large、EfficientNetV2-S 分别得到 80.7 和 80.6 mIoU,而简单 Convolution + Linear Layer 达到 81.4。这说明 IPFP 不依赖复杂 2D Backbone,轻量、可与反投影过程联合优化的图像映射反而更有效。
六、总结与思考
如果把 IPFP 压缩成一句话:它把少量聚合后的图像特征“变成 3D 点”,直接塞进原来的点云网络一起训练,推理时再把这些视觉点全部拿掉。
相比传统 dual-branch fusion,IPFP 的关键变化是把 Fusion Space 转移到真实 3D 空间,并让图像与点云共享同一个 3D Backbone。Table 1 说明它在 PTv3、SPVCNN 和三个数据集上都能带来稳定收益,Table 2 说明训练成本接近原始模型,Table 3–6 则表明方法对 depth 精度、图像数量和 sampling 参数具有一定容忍度。
论文在 Conclusion 中还提出两个后续方向:获得更高质量的 back-projected feature,以及利用这些没有显式语义标签的反投影特征加入无监督约束。也就是说,IPFP 已经验证了“图像特征作为额外 3D 训练点”的可行性,后续问题会更多集中在这些视觉点应该如何生成、筛选和监督。


 扫一扫


IPFP:把图像特征反投影到 3D,用单分支完成多模态训练&spm=1001.2101.3001.5002&articleId=165847798&d=1&t=3&u=47b0477cb0b943c69fe18547561a480d)
 336

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


