


目录
abstract
接下来的几节主要介绍下面内容:(注意谭升大佬是讲的老架构,博主将会边学习边更新差异性)
- 理解流和事件的本质
- 理解网格级并发
- 重叠内核执行和数据传输
- 重叠CPU执行和GPU执行
- 理解同步机制
- 调整流的优先级
- 注册设备回调函数
- 通过NVIDIA可视化性能分析器显示应用程序执行时间轴
一般来说CUDA程序有两个几倍的并发:
- 内核级并行
- 网格级并行
我们前面说有都是在研究内核级别的并行,通过同一内核多线程的并行来完成并行计算,提高内核级别并行我们前面用了基本所有的篇幅介绍了以下三种途径:
- 编程模型
- 执行模型
- 内存模型
这三个角度是优化内核级并行的最主要也是最基础的方法,更高级的方法虽然高级但是提升效率幅度绝没有这三种基础角度来的更有效率。
本章我们在内核之上研究并行,也就是多个内核的并行,这在一个完整应用中是很常见的,实际中的应用程序多半都不是单个内核的,多个内核最大程度的并行也就是最大限度的使用GPU设备,是提高整个应用效率的关键。总结
学习的总框架就是如何调度多个核函数,我们之前都是学的单个核函数如何最优化,博主觉得可以从三个方面考虑:带宽,占有率,算法
那这几节学的就是多个核函数之间,如何运转去协调去榨干GPU性能
整体框架梳理
┌─────────────────────────────────────────────────────────────────┐
│                        主机端 (CPU)                             │
│  ┌───────────────────────────────────────────────────────────┐  │
│  │ 1. 程序启动,操作系统为进程分配虚拟地址空间 (UVA)          │  │
│  │ 2. 第一次调用 CUDA API → CUDA 运行时库自动初始化:         │  │
│  │    - 创建 GPU 上下文 (Context)                             │  │
│  │    - 建立 GPU 页表,映射虚拟地址空间                       │  │
│  │    - 加载驱动到内核态                                      │  │
│  │ 3. cudaMalloc:驱动在显存中分配物理空间,更新 GPU 页表      │  │
│  │    → 返回虚拟地址指针给主机端代码                          │  │
│  │ 4. cudaMemcpy / cudaMemcpyAsync:                          │  │
│  │    - 驱动把虚拟地址翻译成物理地址                          │  │
│  │    - 向 GPU 命令处理器提交 DMA 传输命令                    │  │
│  │    - GPU 内部 DMA 引擎通过 PCIe 总线搬运数据               │  │
│  └───────────────────────────────────────────────────────────┘  │
│                              │ PCIe 总线                         │
│                              ▼                                   │
└─────────────────────────────────────────────────────────────────┘

┌─────────────────────────────────────────────────────────────────┐
│                        GPU 设备端                                │
│  ┌───────────────────────────────────────────────────────────┐  │
│  │ 命令处理器 (Command Processor)                             │  │
│  │   - 接收主机端提交的硬件命令                               │  │
│  │   - 把 DMA 命令分派给 DMA 引擎                             │  │
│  │   - 把核函数启动命令分派给 GigaThread Engine              │  │
│  └──────────────────────────┬────────────────────────────────┘  │
│                             ▼                                    │
│  ┌──────────────────────────────────────────────────────────┐   │
│  │ GigaThread Engine (全局调度器)                            │   │
│  │   - 把 Grid 中的所有 Block 动态分配给可用的 SM           │   │
│  │   - 跟踪每个 Block 的完成状态                             │   │
│  └──────────────────────────┬───────────────────────────────┘   │
│                             ▼                                    │
│  ┌──────────────────────────────────────────────────────────┐   │
│  │ SM (流多处理器) × 24                                      │   │
│  │ ┌──────────────────────────────────────────────────────┐  │   │
│  │ │ 寄存器文件 (256 KB/SM)                               │  │   │
│  │ │ L1 数据缓存 / 共享内存 (128 KB/SM, 可配置)           │  │   │
│  │ │ 常量缓存                                           │  │   │
│  │ │ 指令缓存                                              │  │   │
│  │ │                                                      │  │   │
│  │ │ Warp Scheduler × 4 ──→ CUDA 核心 × 128               │  │   │
│  │ │                    ──→ Tensor Core × 4                │  │   │
│  │ │                    ──→ SFU × 4                        │  │   │
│  │ │                    ──→ LSU × 16                       │  │   │
│  │ └──────────────────────────────────────────────────────┘  │   │
│  └──────────────────────────────────────────────────────────┘   │
│                             │                                   │
│                           ─────                             │
│                             ▼                               │
│                   ┌──────────────────────┐                  │
│                   │ L2 缓存 (24 MB)       │                  │
│                   │ 所有 SM 共享          │                  │
│                   │ 128 字节 Cache Line  │     │
│                   │ 32 字节 Sector 标记  │             │
│                   └──────────────────────┘             │                        │
│                   ┌──────────────────────┐               ▼                             │                   │ 显存控制器 (Memory   │
│                     Controller)          │
│                     与片外 DRAM 通信     │
└                    ──────────┬───────────┘
│  ┌──────────────────────────────────────────────────────────┐   │
│  │ 片外显存颗粒 (8 GB GDDR6)                                │   │
│  │   - 全局内存 (cudaMalloc)                                │   │
│  │   - 本地内存 (寄存器溢出)                                │   │
│  │   - 常量内存 (64 KB __constant__ 区域)                   │   │
│  │   - 纹理内存 (通过纹理对象绑定)                          │   │
│  └──────────────────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────────────────┘
数据来的时候先经过显存控制器,然后显存控制器写入L2,因为L2有写分配,然后把128字节的cache Line加载进来之后,标记为脏,下次换出去
流和事件概述
流,就是一个独立的任务队列。它把你在代码里按顺序写的一大堆CUDA操作,变成一个有序的流水线,让你可以同时管理多条流水线。
异步操作:就是你提交之后cpu不会等待,会接着往下执行,cpu只是提交到了流同步操作:提交给默认流,cpu会进入阻塞状态,gpu执行完毕之后通过中断唤醒cpu
单个流:严格按照你书写的代码顺序执行,因为你的代码顺序就是你提交的顺序多个流:单个流内部顺序,流和流之间不保证
流的三种操作:这些都可以被组织到流里面
主机与设备间的数据传输:主要是异步的数据拷贝,如
cudaMemcpyAsync。这就是让你的“运输车队”去搬运数据。核函数启动:也就是
kernel<<<...>>>(...)。这就是给你的“车间”下达生产指令。其他的由主机发出的设备执行的命令:这是更广义的命令,比如在设备端进行内存初始化(
cudaMemsetAsync),或者在流中插入一个事件(cudaEventRecord)来记录时间戳等。可以看一种场景:数据传输
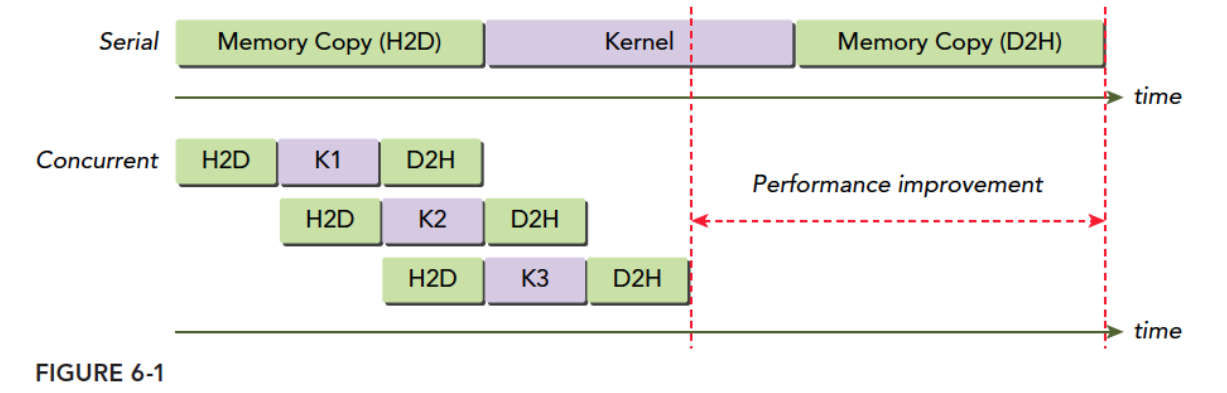
之前我们是这样做的:
时间轴 →
[主机: cudaMemcpy H2D 阻塞等待]
                        [设备: 拷贝数据]
                        [核函数计算]
                        [设备: 拷回数据]
[主机: cudaMemcpy D2H 阻塞等待]
阻塞串行,无法高效的并发
现在可以通过流来管理
时间轴 →
主机: [调用cudaMemcpyAsync] [调用kernel<<<..., stream>>>] [调用cudaMemcpyAsync D2H] [干别的活]
设备:                     [H2D拷贝] [核函数计算] [D2H拷贝]
也就是你提交任务之后就不管了,你完全可以不用阻塞,cpu和gpu就可以并行
所以流是用来重叠数据拷贝和核函数计算的,隐藏数据传输开销(本质就是提高并行性,传输数据的同时,GPU也在工作,而不是之前的串行只能一个一个来,可以kernel1在跑,kernel2的数据在传输,kernel1跑完,kernel2可以直接上来跑)
CUDA流
其实我们之前就用到过流,只不过我们没有感受出来,因为提交到了默认流,我们称这种为隐式声明的流,叫做空流,当然还有显式声明的流,叫做非空流
空流、默认流是无名字的,我们可以通过默认数字0来管理
所以要想管理,就要手动创建非空流
基于流的异步内核启动和数据传输支持以下类型的粗粒度并发
- 重叠主机和设备计算
- 重叠主机计算和主机设备数据传输
- 重叠主机设备数据传输和设备计算
- 并发设备计算(多个设备)
什么是重叠?重叠也就是并发,主机的和设备的可以并发一起计算,主机提交之后异步不需要等待,直接回来接着计算,但是这就麻烦主机和设备之间如何通信,他们不知道对方在干嘛,完成任务了之后要干嘛,要想提升程序的整体性能,异步操作是不可避免的
异步操作:cudaError_t cudaMemcpyAsync(void* dst, const void* src, size_t count,cudaMemcpyKind kind, cudaStream_t stream = 0);Async就是异步的意思,其他的基本都是显然易见的了,就是cudaMemcpy的异步版本
声明一个非空流:
cudaStream_t a;
cudaError_t cudaStreamCreate(cudaStream_t* pStream);

//回收一个流:释放流的资源
cudaError_t cudaStreamDestroy(cudaStream_t stream);
简单来说就是创建一个流所需要的资源,a就是这个非空流的名字,流的释放是一个异步操作,但不会终止流的任务,而是等待全部执行完毕之后再释放
注意注意注意!!!
执行异步传输的时候,内存必须是固定的,非分页的,因为后续DMA来控制传输的时候不能被os换出,否则就会出错
记得分配固定内存cudaError_t cudaHostAlloc(void **pHost, size_t size, unsigned int flags);启动核函数的时候要引入一个额外参数stream指定用什么流
kernel_name<<<grid, block, sharedMemSize, stream>>>(argument list);查询流的执行:查流到哪一步了
cudaError_t cudaStreamSynchronize(cudaStream_t stream);
cudaError_t cudaStreamQuery(cudaStream_t stream);
cudaStreamSynchronize是一个阻塞等待的同步操作
行为:CPU 调用后会一直阻塞等待,直到指定流中所有已提交的异步操作全部完成,函数才会返回。
返回值:成功返回
cudaSuccess。如果流中某个任务执行出错,会返回相应的错误码。适用场景:当你必须确保流中任务全部完成,才能继续后续操作时。比如,你需要读取GPU计算结果,或者需要释放该流使用的主机内存,就必须先同步。
cudaStreamQuery是一个立即返回的非阻塞查询操作
行为:CPU 调用后立即返回,绝不阻塞。它只是查询一下流中所有任务是否已经全部完成。
返回值:
返回
cudaSuccess→ 流中所有任务已全部完成。返回
cudaErrorNotReady→ 流中还有任务正在执行,尚未完成。返回其他错误码 → 流中某个任务执行出错了。
适用场景:当你想轮询流的完成状态,而不希望 CPU 被阻塞时。比如,在一个循环中,你每隔一段时间检查一下流是否完成,如果没完成,CPU 可以先去做别的事。
类似同步和阻塞行为一样
典型流的使用场景
for (int i = 0; i < nStreams; i++) {
    int offset = i * bytesPerStream;
    cudaMemcpyAsync(&d_a[offset], &a[offset], bytePerStream, streams[i]);
    kernel<<grid, block, 0, streams[i]>>(&d_a[offset]);
    cudaMemcpyAsync(&a[offset], &d_a[offset], bytesPerStream, streams[i]);
}
for (int i = 0; i < nStreams; i++) {
    cudaStreamSynchronize(streams[i]);
}
不断的拷贝数据,GPU计算,拷贝数据回去给CPU
我们希望的就是跟流水线一样并发,减少了大量的时间,达到传输数据和核函数的执行重叠
注意以上是最理想的情况,但现实往往是残酷的
PCIe 硬件特性:H2D 与 D2H 两个方向可以同时执行(全双工);同方向拷贝(多个 H2D)不能并行,要排队抢占 Copy Engine。
并发 kernel 受硬件资源约束:SM、寄存器、共享内存会限制同时能跑的网格数量,资源打满再多流也只能排队。
Hyper是一种硬件,是gpu的硬件队列,Ada架构有32个,老的架构可能就只有1个
- Hyper‑Q 不是软件,是 GPU 硬件特性,提供多条独立硬件命令队列(Hardware Work‑Queue,硬件环形 Ring‑Buffer)
- 软件 CUDA Stream ≠ 硬件队列,是多对多映射;软件流数量可以远超硬件队列,驱动会多路复用,多个软件流合并复用到同一条硬件队列NVIDIA。
- 硬件命令队列 与 GigaThread Engine(GTE)职责严格分开,不要混为一谈:
- 硬件命令队列:接收来自 PCIe 的命令包(launch‑kernel、memcpy‑async、event‑record、stream‑wait‑event);
- GigaThread Engine:只处理计算任务(Grid/kernel),把 Grid 拆成 Block,分配给各个 SM;它不处理拷贝命令。
- 如果有多条硬件队列,还有个硬件调度器,有算法去调度的,而且保证依赖关系
CPU应用代码
    ↓
CUDA Runtime(CPU侧)每个stream维护软件任务列表
    ↓
NVIDIA驱动:批量打包命令包(Packet),映射到硬件队列,通过PCIe MMIO门铃(doorbell)通知GPU有新任务到来
    ↓
GPU片上:多条独立硬件命令队列(Hyper‑Q通道,硬件Ring‑Buffer)
    ├─如果是【拷贝命令】→送给Copy Engine拷贝引擎执行(H2D/D2H)
    └─如果是【kernel启动命令】→交给GigaThread Engine
流的优先级
cudaError_t cudaDeviceGetStreamPriorityRange
(int *leastPriority, int *greatestPriority);
作用:查询当前GPU设备支持的流优先级的数值范围。不同GPU设备支持的优先级范围可能不同,所以你不能随便填一个优先级数字,必须先查询。
参数:
leastPriority:输出参数,返回最低优先级的数值。
greatestPriority:输出参数,返回最高优先级的数值。返回值:如果设备不支持流的优先级特性,返回
0;否则返回一个非零值。优先级规则:数值越小,优先级越高。
greatestPriority是最大优先级(最高),leastPriority是最小优先级(最低)。这是我的4060的结果
cudaError_t cudaStreamCreateWithPriority
(cudaStream_t* pStream, unsigned int flags,int priority);
作用:创建一个具有指定优先级的CUDA流。
参数:
pStream:输出参数,返回创建好的流句柄。
flags:阻塞流和非阻塞流的时候有详细讲解
priority:你想要设置的优先级数值。这个数值必须在cudaDeviceGetStreamPriorityRange返回的范围内,否则创建失败。使用要求:你必须先调用
cudaDeviceGetStreamPriorityRange查询合法的优先级范围,然后在这个范围内选一个值作为priority参数。注意
实时处理场景:比如你的程序需要一边做后台计算,一边实时响应用户交互(如实时渲染、传感器数据处理)。实时响应任务可以放在高优先级流里,避免被后台大批量计算阻塞。
多任务并发:当你使用多个流同时执行不同的核函数时,如果某些流的任务是延迟敏感的,可以给它们更高的优先级。
- 只影响 kernel 计算任务调度;
- 对 Copy Engine 拷贝任务 (H2D/D2H) 没有优先级效果,拷贝不受 priority 控制;
注意:优先级的生效是概率性的,不是绝对的。GPU 硬件会尽量优先执行高优先级流的任务,但不保证高优先级任务一定能抢在低优先级之前执行。如果高优先级流的 Block 需要的资源暂时不够,低优先级流的 Block 依然可以先上。

CUDA事件
事件(cudaEvent_t)是流时间轴上的一个 "标记点",本身不执行任何计算,只用来标记 "流执行到这里了"。
用来计时
流: [H2D] → [event_start] → [kernel] → [event_stop] → [D2H]
                ↑_____________________↑
                    测这一段的时间
用来同步
流A: ... → [event_done] ...
流B: ... → [等待 event_done] → [继续执行] ...
API
1. 创建 / 销毁
cudaEvent_t event;
cudaEventCreate(&event);           // 创建默认事件
cudaEventDestroy(event);           // 销毁
注意:
cudaEventDestroy也是异步返回的。如果事件还没完成,GPU 跑完之后才真正释放资源;调用之后句柄立刻作废,不能再用。2. 把事件 "钉" 到流上
cudaEventRecord(event, stream); // 把事件记录到指定流
事件被放进流的任务队列里;
流执行到事件这个位置时,事件就被标记为 "已完成";
事件前面所有操作都做完了,事件才算完成。
不传 stream 参数(或传 0)= 记录到默认流。
3. 查询 / 等待事件完成
cudaEventQuery(event);       // 非阻塞查询:完成返回 cudaSuccess,未完成返回 cudaErrorNotReady
cudaEventSynchronize(event); // 阻塞主机:CPU卡住,直到事件完成才返回
4. 计算两个事件之间的时间
float ms;
cudaEventElapsedTime(&ms, start, stop);
返回值单位:毫秒(ms),float 类型;
精度:微秒级(设备时钟测量,非常准);
⚠️ 前提:stop 事件必须已经完成,否则结果未定义。通常前面先
cudaEventSynchronize(stop)。5. 跨流等待(最强大的功能)
cudaStreamWaitEvent(stream, event, 0); // 让 stream 等待 event 完成
event 可以在另一个流里;
这条命令本身是异步的,立刻返回主机;
GPU 端:stream 执行到这条命令时,会停下来等 event 完成,才继续往后跑;
等待发生在 GPU 硬件队列内部,不需要 CPU 轮询参与。
这是实现多流流水线、构建复杂依赖图的核心 API。
事件的其他 flag
cudaEventCreateWithFlags(&event, flags);
cudaEventDefault:默认,支持计时 + 同步cudaEventDisableTiming:禁用计时,只用来同步,开销更小cudaEventBlockingSync:cudaEventSynchronize用阻塞等待(让出 CPU),默认是忙等轮询cudaEventInterprocess:可以在进程间共享// create two events cudaEvent_t start, stop; cudaEventCreate(&start); cudaEventCreate(&stop); // record start event on the default stream cudaEventRecord(start); // execute kernel kernel<<<grid, block>>>(arguments); // record stop event on the default stream cudaEventRecord(stop); // wait until the stop event completes cudaEventSynchronize(stop); // calculate the elapsed time between two events float time; cudaEventElapsedTime(&time, start, stop); // clean up the two events cudaEventDestroy(start); cudaEventDestroy(stop);
流同步
之前提到过同步:通过__syncthreads()/栅栏,一个实现block内的同步,一个实现数据可见性的同步
当然流也有同步
流分成阻塞流和非阻塞流,这里的阻塞和非阻塞不是说和CPU阻塞不阻塞,而是再说会不会和默认流阻塞,会不会和默认流互相等,注意是和默认流
阻塞流(
cudaStreamDefault)
cudaStreamCreate()默认创建的就是阻塞流。它的特殊行为:和默认流(stream 0)之间有隐式同步。
什么意思呢?假设你创建了一个阻塞流
s1:cudaStream_t s1; cudaStreamCreate(&s1); // 默认是阻塞流 kernel_A<<<grid, block, 0, s1>>>(); // 往阻塞流提交kernel_A kernel_B<<<grid, block>>>(); // 往默认流提交kernel_B你以为 kernel_A 和 kernel_B 会并行跑? 不会。
实际执行顺序:
- kernel_A 先开始跑(因为先提交)
- kernel_B 提交到默认流时,GPU 一看:"阻塞流 s1 还有任务没做完,我得等它全部做完才能开始默认流的任务"
- 等 kernel_A 跑完了,kernel_B 才开始
反过来也一样:默认流有任务没做完,阻塞流的任务也得等。(互相阻塞,只要你混用默认流和阻塞流,多流并发就废了,全部串行。)
非阻塞流(
cudaStreamNonBlocking)创建的时候指定 flag:
cudaStreamCreateWithFlags(&stream, cudaStreamNonBlocking);非阻塞流完全不甩默认流,各跑各的,互不干涉。
cudaStream_t s1;
cudaStreamCreateWithFlags(&s1, cudaStreamNonBlocking);

kernel_A<<<grid, block, 0, s1>>>();   // 非阻塞流
kernel_B<<<grid, block>>>();          // 默认流
这两个 kernel 可以真正并行执行。
写多流代码,一律用非阻塞流。
不要用默认的阻塞流,也尽量不要往默认流扔任务。
需要同步就用
cudaStreamSynchronize或者事件,不要靠隐式同步。
显式同步和隐式同步
隐式同步:cudaMemcpy,这个函数内部包含了同步
显式同步:cudaDeviceSynchronize
隐式的少用,因为会阻塞cpu端,如果cpu端被阻塞了,那流水线就会出现空闲段,因为没有新的任务提交,而且如果隐式同步提交到阻塞流,那关于阻塞流的那边又会被阻塞,非阻塞流还好,但是都会出现空闲段,所以少用
总结
后面就是不断围绕以上的理论知识,进行实验,发挥最大并行能力


 扫一扫


 1834

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


