动态规划(Dynamic Programming)与贪心算法(Greedy Algorithm)

动态规划dynamic programming贪心算法greedy algorithm 《算法导论》动态规划笔记动态规划的方法是付出额外的内存空间来节省计算时间,是典型的时空权衡(time-memory trade-off)的例子。时间上的节省可能是非常巨大的,有可能将指数时间的解转化为多项式时间的解。应用动态规划方法求解的优化问题应该具备的两个要素:最优子结构和子问题重叠。最优子结构:如果一个问题的最悠久包含其子问题的最优解,我们就称此问题具有最优子结构性质。对于不同问题领域,最优... 阅读详情

动态规划算法(Dynamic Programming)

动态规划问题的属性

  动态规划问题一般有两个性质。

性质一:最优子结构性质,即问题实例(关于问题实例,举个例子,排序是问题,输入一串具体的待排序的数就是问题实例)的最优解包含子问题的最优解。也就是说我们的问题可以抽象出父问题关于子问题的递推关系式(dp的重点)。

  但是仅有性质一,我们完全可以用递归法来解决。性质二的出现引出了动态规划算法。

性质二:重叠子问题性质,即根据性质一得到的递推关系式,用递归法解决,存在很多重复的子问题被反复计算。

  针对性质二,我们可以利用备忘录法,即存储计算过的子问题,下次碰到就不再计算。但是存储计算过的子问题,会额外增加存储空间的开销。因此引出了自底向上的动态规划算法,自底向上的意思是,我们先从最简单的子问题开始求解,引出更复杂的子问题的解,最终求出问题实例的解。

  设计优秀的动态规划算法,意识十分重要,其重点是,是否能找到合适的父问题关于子问题的递推关系式。一些问题的动态规划解法,并不能直接求出最终的解,而是求一个中间过程解,通过中间过程解在设计求出最终解,例如下面的最长公共子序列问题。

应用实例:最长公共子序列问题(Longest Common Subsequence, LCS)

问题描述:
  求出X,Y的一个最长公共子序列
输入:
   X : A , B , C , B , D , A , B X:A, B, C, B, D, A, B XA,B,C,B,D,A,B
   Y : B , D , C , A , B , A Y:B, D, C, A, B, A YB,D,C,A,B,A
输出:
   B D A B BDAB BDAB B C A B BCAB BCAB B C B A BCBA BCBA

分析:
  暴力法,设 X X X的长度是 m m m Y Y Y的长度是 n n n,找出 X X X的所有子序列,时间复杂度 O ( 2 m ) O(2^{m}) O(2m),在 Y Y Y中查找是否有对应的子序列,时间复杂度 O ( n ⋅ 2 m ) O(n·2^{m}) O(n2m),指数阶时间复杂度速度很慢。

  设 X X X的长度是 m m m Y Y Y的长度是 n n n,令 C [ i , j ] C[i,j] C[i,j]表示,截取 X X X的索引从1到 i i i,同时截取 Y Y Y的索引从1到 j j j的子序列的最长公共子序列的长度(这是一个中间过程解),我们并没有一开始就定义最长子序列是什么,而是计算最长子序列的长度,最后通过回溯法重建最长子序列。这样我们就不难得到递推表达式: C [ i , j ] = { C [ i − 1 , j − 1 ] + 1    i f    X [ i ] = Y [ j ] m a x ( C [ i − 1 , j ] , C [ i , j − 1 ] )    i f    X [ i ] ≠ Y [ j ] C[i,j]=\begin{cases} C[i-1,j-1]+1~~& if~~X[i]=Y[j] \\ max(C[i-1,j],C[i,j-1]) ~~&if~~ X[i] \neq Y[j] \end{cases} C[i,j]={ C[i1,j1]+1  max(C[i1,j],C[i,j1])  if  X[i]=Y[j]if  X[i]=Y[j]

计算最长公共子序列的长度的问题就满足上面的性质一,根据这个递推表达式,我们可以建立递归的方法来执行,但是不难发现,如果想要知道 C [ i , j − 1 ] C[i,j-1] C[i,j1] C [ i − 1 , j ] C[i-1,j] C[i1,j]的结果(假设 X [ i ] ≠ Y [ j − 1 ] X[i] \neq Y[j-1] X[i]=Y[j1] X [ i − 1 ] ≠ Y [ j ] X[i-1] \neq Y[j] X[i1]=Y[j]),我们均需要求 C [ i − 1 , j − 1 ] C[i-1,j-1] C[i1,j1]的结果,这就导致了 C [ i − 1 , j − 1 ] C[i-1,j-1] C[i1,j1]需要被计算两次,计算最长公共子序列的长度的问题就满足上面的性质二,我们可以利用备忘录法,也就是判断 C [ i − 1 , j − 1 ] C[i-1,j-1] C[i1,j1]在之前是否被计算,并保存计算结果,避免重复计算,但是这样就增加了保存计算结果的存储开销。

  下面就利用动态规划法来解决,动态规划法就是把执行顺序变成自底向上,所以我们优先要知道初始状态。这一问题中,我们需要知道的初始状态包括 C [ 0 , j ] C[0,j] C[0,j]以及 C [ i , 0 ] C[i,0] C[i,0],即 X , Y X,Y X,Y有一个为空的情况,不难推断出: C [ i , 0 ] = 0 C [ 0 , j ] = 0 C[i,0]=0 \\ C[0,j]=0 C[i,0]=0C[0,j]=0

接下来我们就自底向上,循环求解,时间复杂度 O ( m n ) O(mn) O(mn),python示意代码如下:

# 初始化C[i,0], C[0,j] = 0
for j in range(1,n):
    for i in range(1,m):
        if X[i] == Y[j]:
            C[i,j] = C[i-1,j-1] + 1
        else:
            C[i,j] = max(C[i-1,j],C[i,j-1])

我们用下面的图来表示该算法执行步骤:
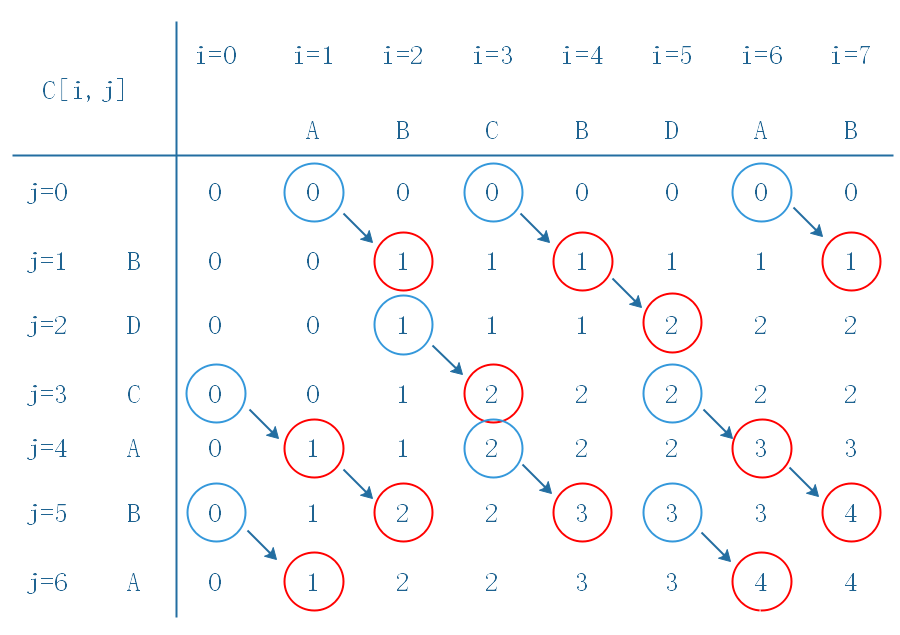
动态规划的问题在找到递推关系式后,我们都可以建立动态规划表(DP table),如上图二维表,当然还可能是一维、三维等。上图两条垂直直线把图像分成四部分,右下部分就是 C [ i , j ] C[i,j] C[i,j]的值, i = 0 , 1 … m , j = 0 , 1 … n i=0,1\dots m,j=0,1\dots n i=0,1m,j=0,1n,红圈就是发生 X [ i ] = Y [ j ] X[i]=Y[j] X[i]=Y[j]的地方,对应的 C [ i − 1 , j + 1 ] C[i-1,j+1] C[i1,j+1]用篮圈表示,两者之间用箭头连接。

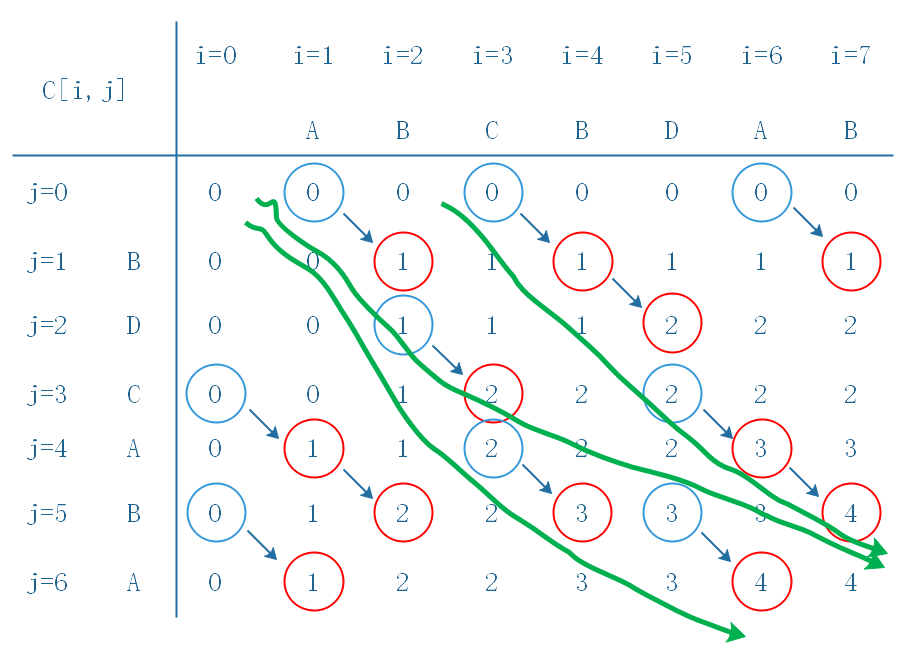
这样我们就求出来了最长公共自序列的长度,具体的最长公共子序列需要我们用回溯法构建,下图就是利用回溯法,回溯法的解空间就是上面的 C C C,python示意代码如下。

import copy

rt = [] # 用于保存最终的输出
tmp = [] # 用于保存每一个LCS
X = ['A', 'B', 'C', 'B', 'D', 'A', 'B']
Y = ['B', 'D', 'C', 'A', 'B', 'A']

def backtrack(n, m, X, Y, rt, tmp, num):
    """
    一行一行的进行回溯
    
    Input
    ------
    n是当前第几层
    m表示当前层需要从第m列开始遍历
    X是最长公共子序列问题输入中的X
    Y是最长公共子序列问题输入中的Y
    rt用于保存最终的输出
    tmp用于保存每一个LCS
    num是确定的最长公共自序列长度
    """
    if (len(tmp) == num):
        rt.append(copy.deepcopy(tmp))  # 这里一定要用深拷贝!!!!
        return
    if (n == len(Y)):
        return
    for i in range(m, len(X)):
        if(X[i] == Y[n]):
            tmp.append(Y[n])
            backtrack(n+1, i+1, X, Y, rt, tmp, num)
            del(tmp[-1])  # python的列表删除操作
                # 用tmp = tmp[:-1]删除不成功,使用id(tmp)可以看出,
                # python认为tmp=tmp[:-1]生成的tmp是新生成的列表,和最初的tmp地址不一样。
        else:
            backtrack(n+1, i, X, Y, rt, tmp, num)

backtrack(0, 0, X, Y, rt, tmp, 4)
print(rt)

# 输出
# [['B', 'C', 'B', 'A'], ['B', 'C', 'A', 'B'], 
#  ['B', 'D', 'A', 'B'], ['B', 'D', 'A', 'B']]

上面算法输出4条最长公共子序列,其中有一个重复,你能找出重复的路径吗?最长公共子序列的三条路径(绿线表示)如下:

贪心算法(Greedy Algorithm)

贪心算法的属性

  贪婪(心)算法要求每一次选择时,都选择局部最优的选择,当把这些选择累计起来得到的全局解,也是全局最优解。换句话说,想要使用贪婪算法,问题同样必须具有最优子结构,同动态规划不同的是,我们要用贪心选择来改写一般的动态规划的最优子结构。但并不是所有的最优子结构都可以有贪心选择来改写,如果问题可以改用贪心选择来改写最优子结构,我们称这个问题具有贪心选择属性。

  贪心选择属性:我们可以通过作出局部最优的选择,来构造全局最优解。即贪心选择得到的解与剩余子问题的最优解的组合,就是全局最优解或全局最优解之一。在利用贪心算法求解时,我们需要先证明问题具有贪心选择属性

  动态规划问题一般是自下向上求解,贪心算法多数是自上向下,在一个大问题上我们进行贪心选择,得到一个贪心选择项加上一个子问题,在对子问题进行贪心选择。当然也有自下向上设计的贪心算法,例如最小生成树中用到的Prim算法。

应用实例:活动选择问题

  假设我们有n个活动

分治法、动态规划、贪心法 3 大算法范式对比:从 4 个维度解析适用场景 本文深入对比了分治法、动态规划和贪心法三大算法范式的核心特点应用场景。从问题分解方式、子问题关系、求解顺序、最优性保证和实现复杂度4个维度进行解析,帮助开发者根据具体问题特征选择最合适的算法设计范式,提升算法效率正确性。 阅读详情

相关推荐

Analysis of Algorithms笔记一

I.Reduction Convert a problem to something you already know how to solve. 1.Brute Force Wikipedia: Proof by exhaustion, also known as proof by cases, proof by case analysis, complete induction, or the...

叫我咸鱼就好 850

贪心算法知识整理

一、贪心算法的概念 贪心算法是一种对某些求最优解问题的更简单、更迅速的设计技术。贪心算法的特点是一步一步地进行,常以当前情况为基础根据某个优化测度作最优选择,而不考虑各种可能的整体情况,省去了为找最优解要穷尽所有可能而必须耗费的大量时间。贪心算法采用自顶向下,以迭代的方法做出相继的贪心选择,每做一次贪心选择,就将所求问题简化为一个规模更小的子问题,通过每一步贪心选择,可得到问题的一个最优解。虽然每一步上都要保证能获得局部最优解,但由此产生的全局解有时不一定是最优的,所以贪心算法不要回溯。...

Sciengaint的博客 4132

旅行商问题算法实战:从枚举到动态规划的精确求解

组合优化是计算机科学中解决复杂决策问题的核心领域,其目标是在有限集合中寻找最优解。旅行商问题作为该领域的经典代表,要求寻找访问所有城市并返回起点的最短回路,其解空间随城市数量呈阶乘级增长,是算法设计性能分析的理想试金石。动态规划通过状态压缩和递推关系,将问题分解为重叠子问题,以O(n²·2ⁿ)的时间复杂度实现精确求解,显著优于枚举法的O(n!)。回溯法则通过深度优先搜索剪枝策略,在搜索过程中舍弃无效分支,平衡了搜索效率精确性。这些算法在物流路径规划、电路板钻孔和基因测序等场景中具有重要应用价值,本文以

weixin_33834628的博客 328

【算法概论】贪心算法

本文参考:《算法的乐趣》,老师上课ppt 贪心算法,又称贪婪法Greedy algorithm 一般将求解过程分为若干个步骤,在每个步骤都应用贪心原则,选择当前状态下最好或最优的解。 贪心算法其他算法最大的不同: 贪婪法每一步选择结束后,局部最优解就确定了,不再进行回溯处理。也就是说,每一个步骤的局部最优解确定后,就不再进行修改,直到算法结束。 the difference betw...

t11383的博客 520

hdu 1159, LCS, dynamic programming, recursive backtrack vs iterative backtrack vs incremental, C++

hdu 1159, LCS, dynamic programming, recursive backtrack vs iterative backtrack vs incremental, C++

qeatzy的博客 962

软考:分治法、动态规划贪心算法和回溯法分析练习

(2)当n为奇数时,将前后两部分,即1~(n-1)/2和(n+1)/2+1~n,放在天平的两端,较轻的一端里有假币,继续在较轻的这部分硬币中用同样的方法找出假币;若两端重量相等,则中间的硬币,即第(n+1)/2枚硬币是假币。(1)当n为偶数时,将前后两部分,即1~n/2和n/2+1~0,放在天平的两端,较轻的一端里有假币,继续在较轻的这部分硬币中用同样的方法找出假币。假币问题:有n枚硬币,其中有一枚是假币,已知假币的重量较轻。first,last://当前考虑的硬币数组中的第一个和最后一个下标。

程序吟游的博客 1万+

[Leetcode]Jump Game II

Given an array of non-negative integers, you are initially positioned at the first index of the array. Each element in the array represents your maximum jump length at that position. Your goal i

NoooName的专栏 347

Python算法学习终极指南:如何用algorithms库快速掌握数据结构算法

还在为学习算法而烦恼吗?想找到一套清晰、简洁、实用的Python算法实现库?algorithms这个开源项目正是为你准备的!它包含了Python中最精简、最实用的数据结构和算法实现,无论你是编程新手还是经验丰富的开发者,都能从中受益。这个库的设计理念就是"最小化、清晰化、文档化",让你能够快速理解和应用各种经典算法。 ## 为什么你需要这个算法库? 学习算法是每个程序员成长的必经之路,但传统的

gitblog_00990的博客 909

小代码、小算法

我喜欢的小代码、算法集锦第一个question Given an array of non-negative integers, you are initially positioned at the first index of the array. Each element in the array represents your maximum jump length at th

he_0123的专栏 813

Wooden Sticks

Wooden Sticks Time Limit: 1000MS Memory Limit: 10000K Total Submissions: 21785 Accepted: 9296 Description There is a pile of n wooden sticks. The length and w

wjhuihuii的博客 248

从食堂打饭到银行排队:用‘接水问题’讲透贪心调度,附Python/Java双语言代码

本文通过食堂打饭、银行排队等生活场景,深入浅出地讲解了贪心算法在资源调度中的应用,特别是经典的'接水问题'。文章提供了Python和Java双语言实现,详细比较了不同实现方式的性能差异,并探讨了算法在操作系统调度、云计算资源分配等高级场景中的实际应用。

weixin_30587927的博客 403

算法宇宙中的材料革命:当Python遇见原子世界

在代码晶格的交汇处,一场静默的革命正在发生。我们不再仅仅通过试管和显微镜观察材料,而是通过算法和神经网络理解物质的本质。Python算法库中的每一个模块,都是这场变革的微小齿轮,共同驱动着从经验直觉到数据智能的范式转变。 ## 从概率分布到材料命运:高斯函数的双重隐喻 [![高斯分布热力图](https://raw.gitcode.com/GitHub_Trending/pyt/Python

gitblog_00240的博客 880

美赛A题解题框架:从问题剖析到模型构建求解策略

数学建模是解决复杂现实问题的核心方法,其本质是将实际问题抽象为数学语言,通过构建模型寻找最优解。其原理在于利用数学工具(如优化理论、概率统计)对系统进行描述分析。在工程实践中,数学建模的价值在于为决策提供量化依据,尤其在资源调度、路径规划等场景中至关重要。本文以“共享单车调度优化”为例,深入探讨如何将实际问题转化为严谨的数学模型,并规划高效的求解路径。针对这类典型的组合优化问题,文中详细阐述了从问题拆解、符号定义到建立混合整数规划模型的全过程,并重点分析了遗传算法等启发式算法在求解大规模问题时的应用策略。

weixin_30697239的博客 320

雅思常用习语词汇积累

常见雅思习语词汇总结

工匠精神coding,终生学习 495

【信息科学工程学】【数据科学】数据科学领域 第六篇 算法设计 07 堆、栈、表、矩阵、集合、队列、数组、字符串、树、图、动态规划、结构体、元组的算法01

当前段必须包含所有字符的最后出现位置。1. 字符串分割成最多片段2. 基因序列功能域划分3. 文本段落划分4. 音频声道分离5. 图像色彩分区6. 社交网络社群划分7. 蛋白质结构域8. 音乐乐章分段9. 代码模块划分10. 章节划分特征:一次扫描,贪心确定边界。

weixin_49199313的博客 1174

【信息科学工程学】计算机科学技术——第七十七篇 系统架构设计02

编号类型模型配方企业资本运作的方法/规则/条件/依据及所有的步骤(​风险处理/异常处理/危机应对关联知识法律法规和裁决依据​​由发起人(通常是知名投资人、投行或产业资本)先设立一个只有现金、无实际业务的特殊目的收购公司(SPAC),通过IPO募集资金并在交易所上市。然后在规定时间内(通常24个月)寻找一家非上市公司进行合并(De-SPAC),使目标公司迅速实现上市,规避传统IPO的复杂流程和不确定性。1.:在开曼或特拉华注册空壳公司,注入少量种子资金。2.

weixin_49199313的博客 226

【信息科学工程学】【通信工程】计算机科学自动化——第二百三十三篇 云NaaS服务 系列二01

国家骨干网(含核心网、IP骨干网、OTN骨干网)/城域网【含3G/4G/5G接入网/PON接入网/OTN接入网+OTN/IP城域网+其他】/中心云(多/双/单Region+多AZ/双AZ/单AZ)+边缘DC+边缘计算节点+端计算节点包括IoT传感器、移动终端、CPE设备。通过5G NR(n78频段,带宽100MHz,子载波间隔30kHz)或GPON(下行2.5Gbps,上行1.25Gbps)接入。本地缓存小于10GB,主要用于临时数据暂存。位于地市级机房,部署MEC服务器(Intel Xeon Platin

weixin_49199313的博客 1258
上一篇: 集成学习(Ensemble Learning):Boosting、Bagging、Random Forest、Stacking
下一篇: 时间卷积网络(TCN):结构+pytorch代码
Leon_winter
博客等级 码龄10年 254粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
