


一、引言
C++ 经常会遇到一个棘手的编译问题:两个类之间存在相互引用或调用的情况。就是那种“你中有我,我中有你”的关系!设计上合理,但 C++编译器的严格规则下,却会有编译错误。
比如:
Promise类的方法要返回Future类型的对象。Future类的方法要持有或访问Promise类型的对象。
这种相互依赖很难决定哪个类应该先被定义。
编译器会报出未声明的类型 或 成员变量类型不完整 的错误。
这些报错的原因是因为C++编译器的基本工作方式:单遍扫描 。编译器自上而下读取代码要知道一个类型的完整定义才能:
- 创建该类型的对象:因为要知道对象的大小,以便在内存分配空间。
- 访问该类型的成员函数或成员变量:因为要知道类的内存布局和成员的偏移量。
但是,如果只是声明一个指向该类型的指针或引用 ,编译器只要知道这个类型的名字 就可以,因为所有指针和引用的大小是固定的。
于是,陷入了一个“先有鸡还是先有蛋”的问题。
二、前置声明和延后实现
无法改变编译器的“单遍扫描”,那就用 C++ 的语法特性来“欺骗”编译器的时序感。
解决循环依赖的策略分三步:前置声明、只声明不定义 以及 延后实现。
逻辑就是:先告诉编译器“名字”的存在,可以用指针或引用;等所有类的都构建完毕,再回头去填充具体的函数逻辑。
Step 1: 前置声明。
在文件最开头告诉编译器:“有一个类,具体细节稍后给出,先声明名字。”
template <typename T>
class Future;
有了这一行,就可以在 Promise 声明 Future<T>* 或 Future<T>&,在函数返回值写 Future<T>(只要不立即生成对象)。
Step 2: 声明但不定义。
在类内部绝对不要写那些依赖完整定义的函数体。 否则编译器会报错,因为它此时只知道 名字,不知道类的构造函数长什么样,也不知道占用多少内存。
所以,只写函数原型:
template <typename T>
class Promise {
public:
    // 只声明,不写函数体!
    Future<T> GetFuture();

    // 其他不依赖 Future 的方法可以正常实现
    void SetValue(const T& val) { /* ... */ }
};
Step 3: 延后实现。 完整定义类。
// 定义 Future 类
template <typename T>
class Future {
public:
    // Promise 已经定义完整,直接用
    explicit Future(Promise<T>* p) : promise_(p) {}

private:
    Promise<T>* promise_;
};

// --- 延后实现 ---
template <typename T>
Future<T> Promise<T>::GetFuture() {
    return Future<T>(this); // 终于可以写函数体了
}
实现纯头文件会根据类是否是模板类,处理方式略有不同。
- 模板类。 上面的
Promise<T>和Future<T>都是模板。C++ 标准规定,模板的定义必须对用它的每个翻译单元可见。所以,把上面所有代码(声明、定义、延后实现)都写在同一个.hpp文件是完全合法的,不用额外的关键字。 - 普通类。 如果写的不是模板类,而是普通的
class Promise和class Future,并且把函数的实现放在了类定义之外(即.hpp文件的下方),那么必须加上inline关键字。如果不加inline,这个.hpp被多个.cpp文件包含时,链接器会发现Promise::GetFuture被定义多次,报出“多重定义”错误。
普通类的写法:
class Future; // 前置声明

class Promise {
public:
    Future GetFuture(); // 声明
};

class Future {
public:
    Promise* p;
    Future(Promise* _p) : p(_p) {}
};

// 必须加 inline,否则链接报错!
inline Future Promise::GetFuture() {
    return Future(this);
}
通过前置声明让编译器认识名字,通过类内只声明避开类型不完整的检查,最后通过类外延后实现完成逻辑闭环。
这套方法完美解决语法层面的报错,让代码能够顺利编译。
但是,细心点的会注意到:Promise 持有 Future 的生产能力,而 Future 持有 Promise 的指针,这种双向强耦合在资源管理和生命周期上是否安全?如果 Promise 先被销毁了,Future 手里的指针岂不是变成了悬垂指针?
三、原理深挖——编译器在想什么?
要真正理解为什么前置声明和延后实现能够解决循环依赖问题,就要深入了解 C++ 编译器在处理类型定义时的一些基本原则。这不只是语法的记忆,也是对 C++ 语言底层机制的洞察。
不完整类型 : 编译器遇到一个类的前置声明,它只知道 Future 是一个类型名。它不知道 Future 类内部有什么成员变量、有什么成员函数,也不知道这个类对象在内存中会占用多少字节。这时,Future 就是一个不完整类型。
对于不完整类型,编译器能做的事情非常有限:
- 声明指向它的指针或引用:
Future* p;或Future& r;。因为所有的指针和引用在内存中都占用固定的字节数,编译器不用知道Future的具体大小就能为指针或引用分配空间。 - 声明函数原型:
Future GetFuture();。函数原型只涉及参数和返回值的类型名称,不涉及实际的对象创建或成员访问。
完整类型: 编译器遇到一个类的完整定义(包含所有成员变量和成员函数的声明)才能确定这个类的完整结构、大小以及内存布局。这时,Future 就是一个完整类型。
对于完整类型,编译器可以做所有的事情:
- 创建对象实例:
Future f;。编译器知道f要多少内存。 - 访问成员变量或成员函数:
f.member_var;或f.member_func();。编译器知道member_var或member_func在f对象内存的偏移量。 - 作为基类或派生类。
现在回到 Promise::GetFuture() 这个方法:
// 在 Promise 类内部
Future<T> GetFuture(); // 声明
和
// 在 Promise 类外部
template <typename T>
Future<T> Promise<T>::GetFuture() {
    return Future<T>(this); // 实现
}
在 Promise 类内部声明 GetFuture() 时: Future<T> 只是一个不完整类型(因为只有前置声明)。编译器处理 Promise 类的成员函数声明只关心 GetFuture 的签名(参数类型和返回类型)。因为 Future<T> 是作为返回类型,不涉及实际对象的创建或成员访问,所以编译器允许这个声明通过。
在 Promise 类外部实现 GetFuture() 时 ,编译器处理 Promise<T>::GetFuture() 的函数体 return Future<T>(this); 要做:
- 构造一个
Future<T>对象:要求Future<T>必须是一个完整类型,这样编译器才知道如何调用其构造函数,以及为这个对象分配多少内存。 - 涉及到
Future<T>内部成员的访问:如果Future<T>的构造函数要访问Promise<T>的某些成员,或者Future<T>内部有复杂的逻辑,编译器也要这些信息。
因为是 Future 类的完整定义之后才去实现 Promise<T>::GetFuture(),编译器已经完全了解Future<T> 的所有细节,已经是一个完整类型。所以,所有关于 Future<T> 对象的创建、构造函数调用等操作都可以顺利进行,不再报错。
把译器的行为类比:
- “不耐心”:当它在类定义内部遇到任何需要知道类型大小或成员布局的操作(如定义成员变量、创建局部对象),而该类型尚未完整定义时,它会立即报错。因为它需要这些信息来确定当前类的内存布局。
- “耐心”:当它遇到一个函数声明(无论是成员函数还是自由函数),只要参数和返回值的类型名是已知的(即使是不完整类型),它就会“忍住”,先不报错。它知道函数体会在稍后被解析,届时这些类型可能会变得完整。这就是为什么我们可以声明
Future<T> GetFuture();。
通过这种“先告诉名字,再补充细节”的策略,规避编译器的“不耐心”,利用它的“耐心”,从而在语法层面解决了类之间的循环依赖问题。
虽然这种方法解决了编译问题,但它并没有从根本上解决设计上的耦合问题。
四、进阶:架构层面的解耦
前置声明和延后实现虽然解决 C++ 编译器在语法层面的报错,代码能够顺利编译。但是,这种解决方案只是语法糖,并没有从根本上解决设计的问题。
再次来重新看一下 Promise 和 Future 之间的关系:
Promise要知道Future的存在,以便创建并返回它。Future要知道Promise的存在(或其句柄),以便最终获取Promise设置的结果。
如果 Future 内部直接持有 Promise 的裸指针或引用,那么 Promise 对象生命周期结束,而 Future 仍然存活并尝试访问该指针就会导致悬垂指针。即使用 std::shared_ptr,如果 Promise 和 Future 互相持有对方的 shared_ptr,也会形成循环引用 ,造成内存泄漏。
C++ 的std::promise 和 std::future 的实现就提供了一个非常不错的解决方案,彻底打破 Promise 和 Future 之间的直接依赖,通过引入一个中间层 —— 共享状态 来实现解耦。
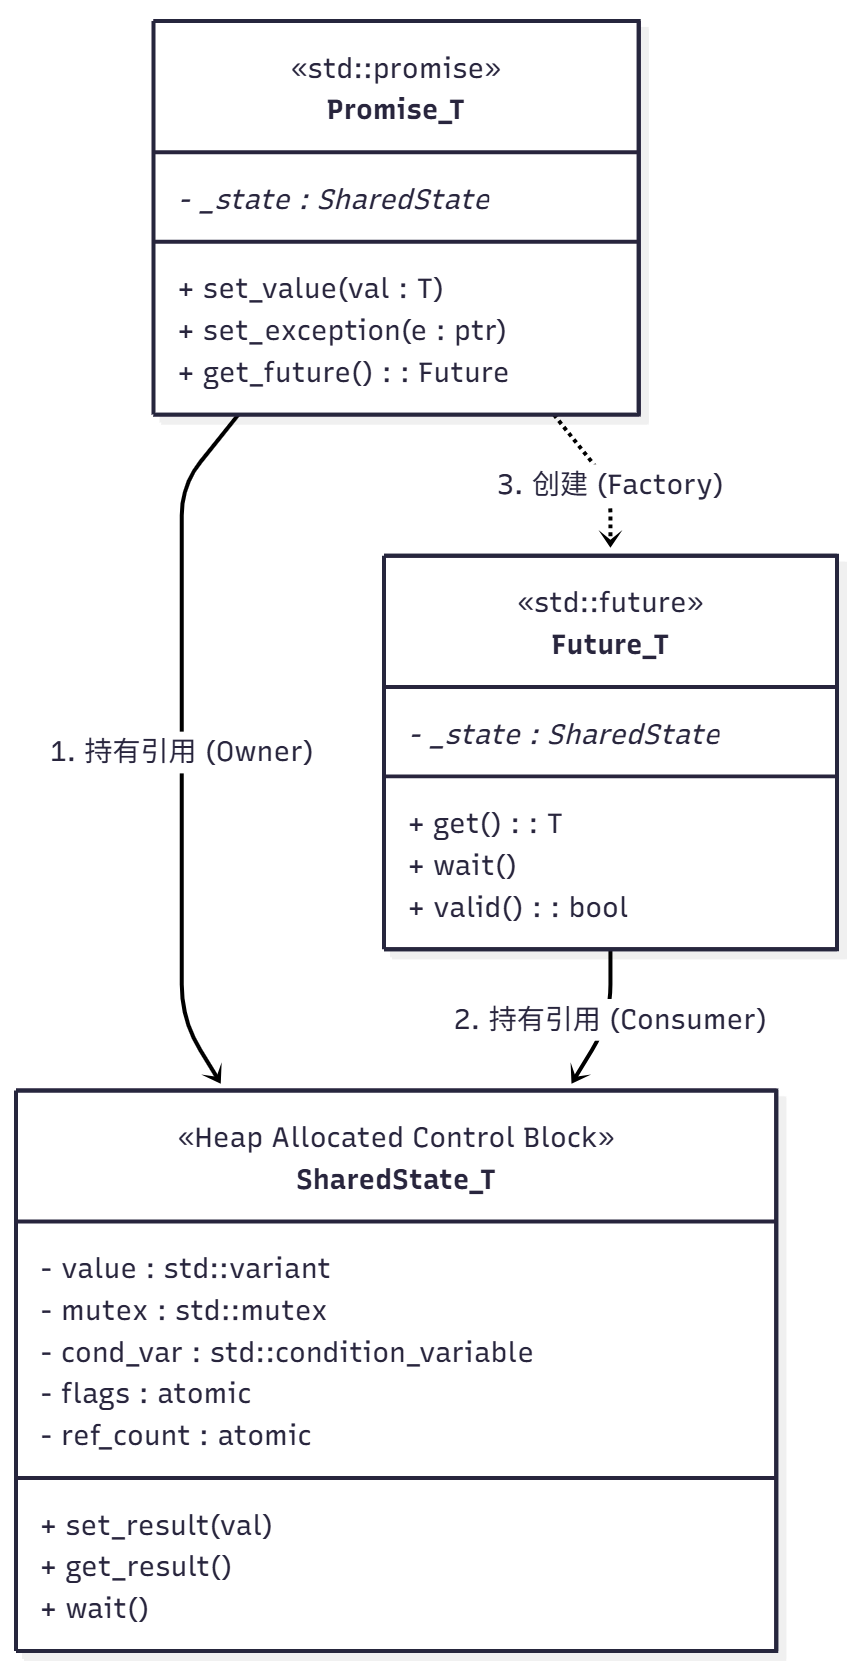
核心思想: Promise 和 Future 不再直接互相持有或依赖,都转去依赖一个第三方的、独立的共享状态对象。这个共享状态对象负责存储异步操作的结果(或异常),以及管理结果的就绪状态和同步机制。
共享状态的组成:
- 结果值:
T value_(或std::optional<T>),存储Promise设置的最终结果。 - 就绪标志:
bool ready_,指示结果是否已经准备好。 - 异常指针:
std::exception_ptr exception_,存储Promise抛出的异常。 - 同步原语:
std::mutex mutex_和std::condition_variable cv_,保护共享状态的并发访问,并允许Future阻塞等待结果。
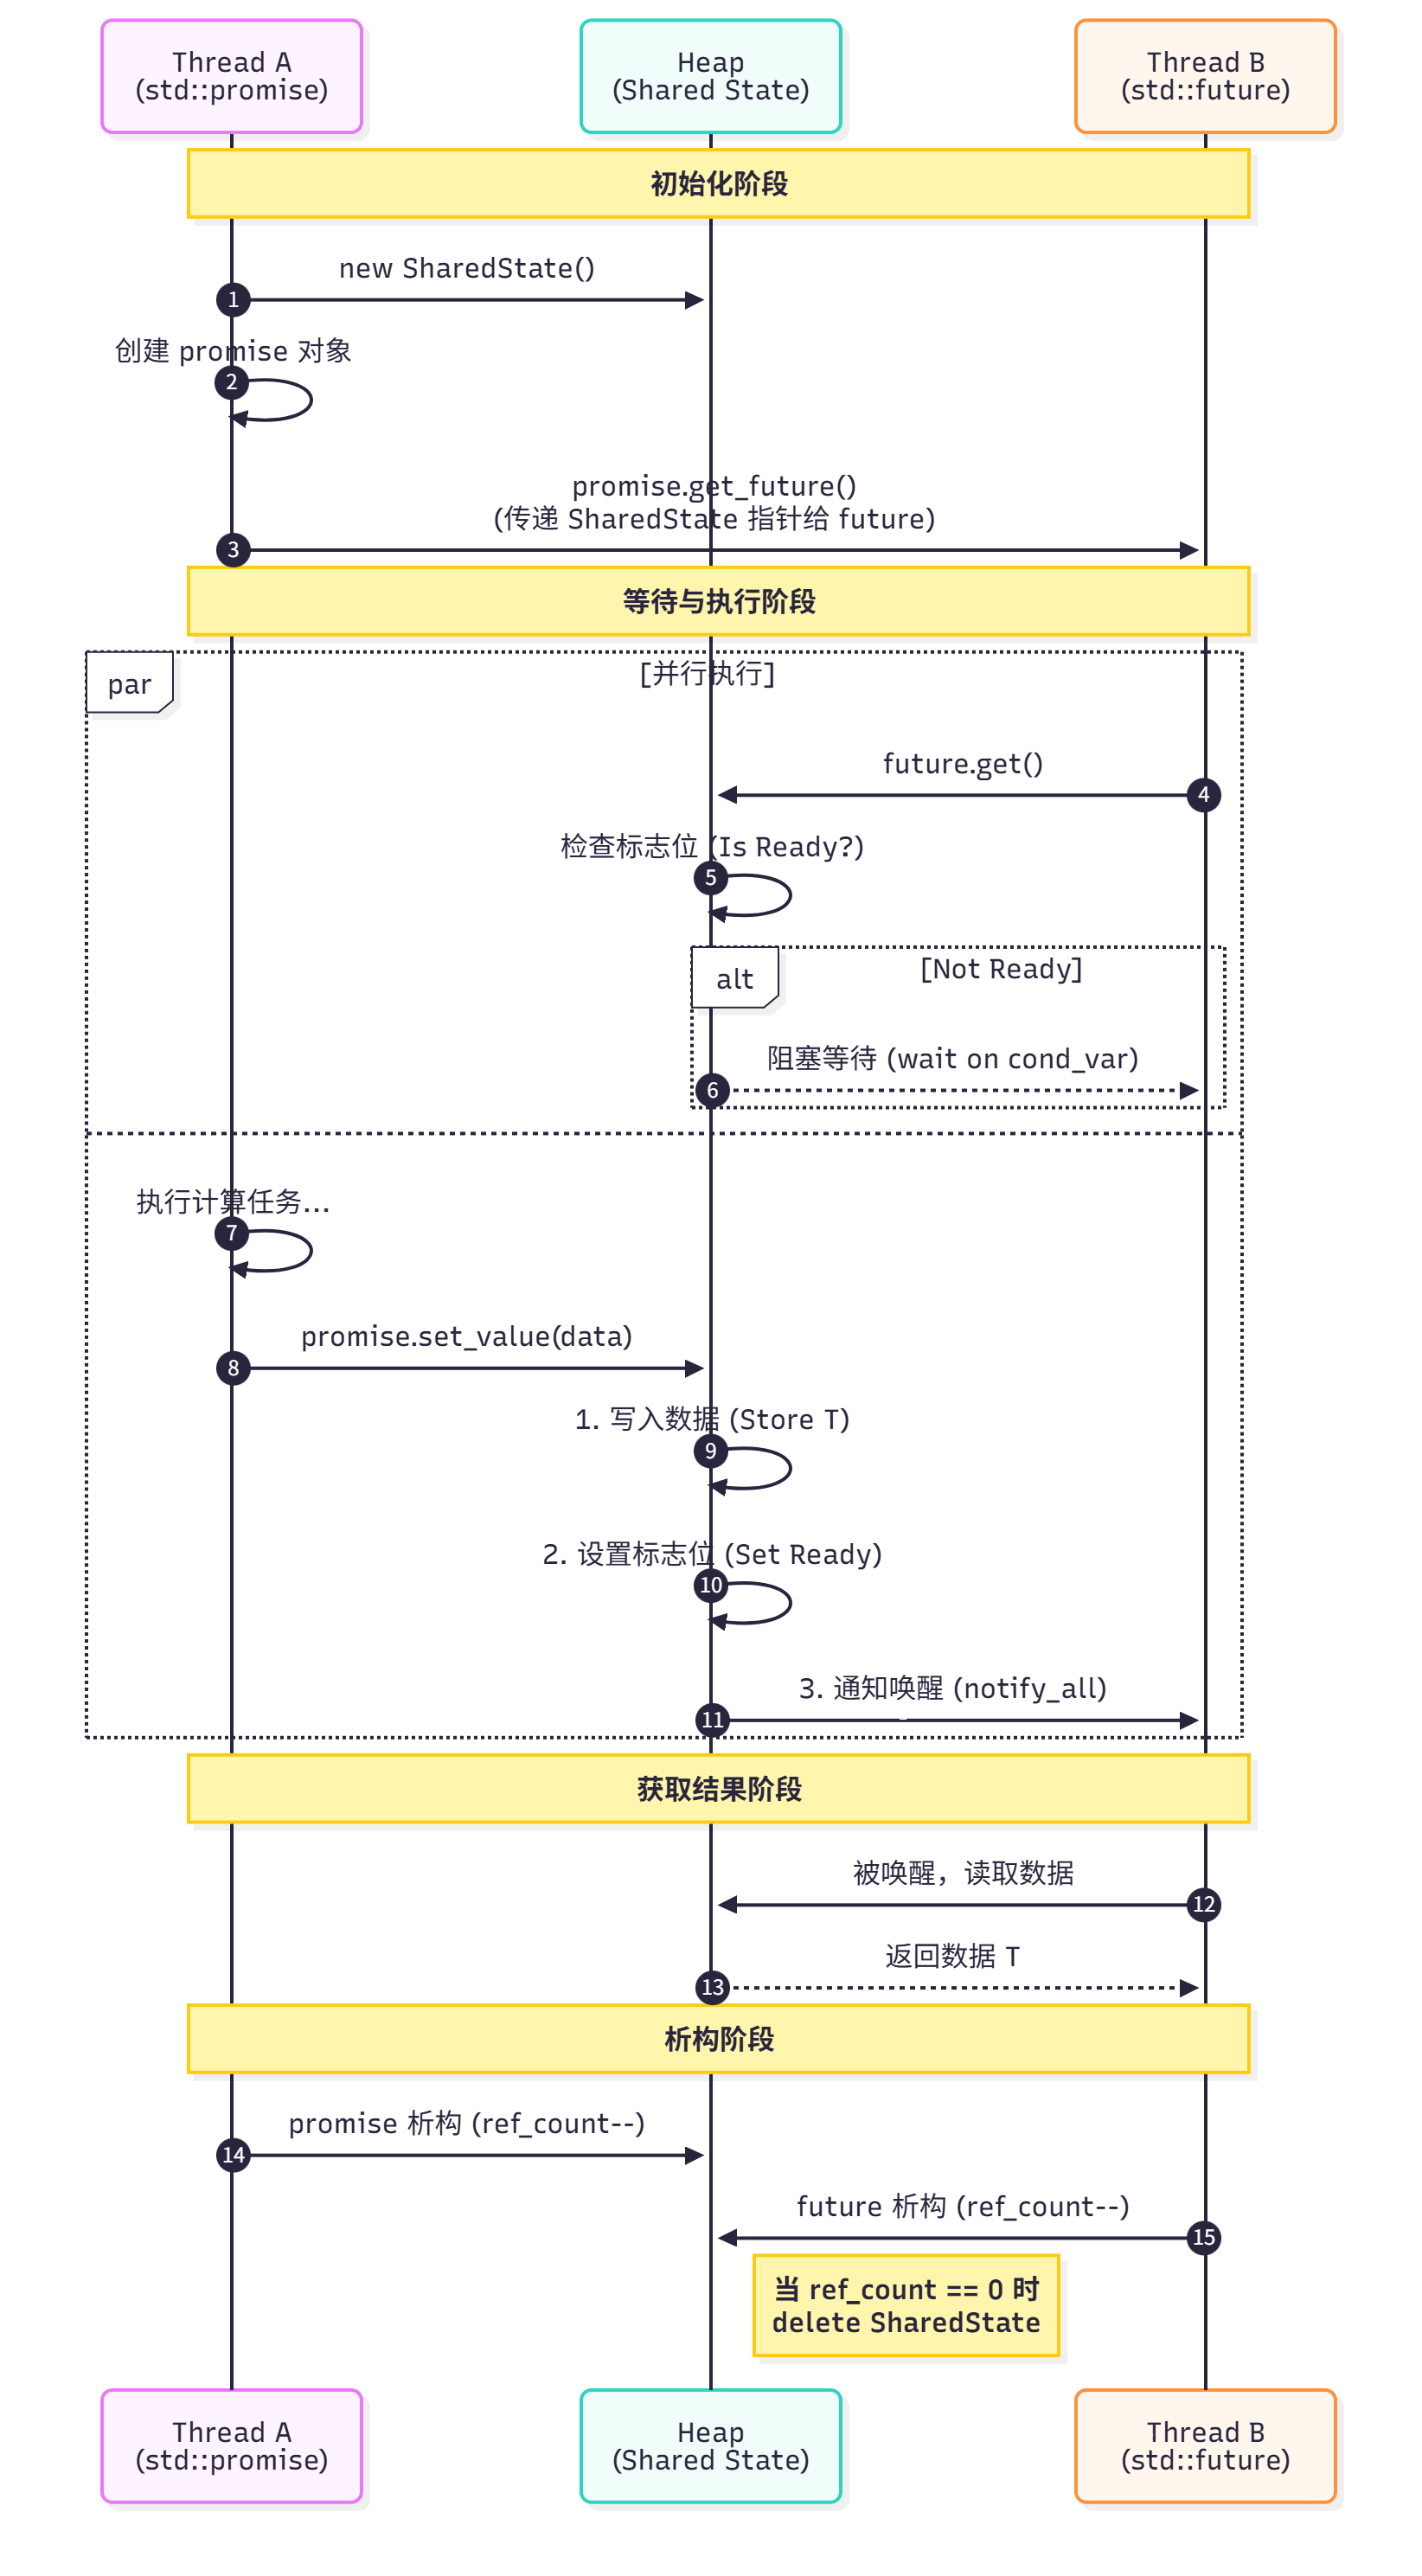
引入 SharedState 后,依赖关系是如何变化的:
旧关系 (双向强耦合):
+---------+       +---------+
| Promise | <---> | Future  |
+---------+       +---------+
(Promise 返回 Future,Future 持有 Promise 的指针)
新关系 (通过中间层解耦):
      +-------------+
      | SharedState |
      +-------------+
       ^           ^
      /             \
     /               \
+---------+       +---------+
| Promise |       | Future  |
+---------+       +---------+
(Promise 和 Future 都持有 SharedState 的 std::shared_ptr)
定义 SharedState 类:这个类不依赖 Promise 或 Future。内部包含结果、就绪标志和同步原语。
#include <memory>
#include <mutex>
#include <condition_variable>
#include <exception>

template <typename T>
class PromiseFutureSharedState {
private:
    T value_;
    bool ready_ = false;
    std::exception_ptr exception_;
    std::mutex mutex_;
    std::condition_variable cv_;

public:
    void SetValue(const T& val) {
        std::lock_guard<std::mutex> lock(mutex_);
        value_ = val;
        ready_ = true;
        cv_.notify_one();
    }

    void SetException(std::exception_ptr ex) {
        std::lock_guard<std::mutex> lock(mutex_);
        exception_ = ex;
        ready_ = true;
        cv_.notify_one();
    }

    T GetValue() {
        std::unique_lock<std::mutex> lock(mutex_);
        cv_.wait(lock, [this]{ return ready_; });
        if (exception_) {
            std::rethrow_exception(exception_);
        }
        return value_;
    }
};
修改 Future 类:Future 不再持有 Promise 的指针,而是持有 SharedState 的 std::shared_ptr。
#include <memory>

template <typename T>
class PromiseFutureSharedState;

template <typename T>
class Future {
private:
    std::shared_ptr<PromiseFutureSharedState<T>> shared_state_;
public:
    // Future 构造时接收 shared_ptr
    explicit Future(std::shared_ptr<PromiseFutureSharedState<T>> state)
        : shared_state_(state) {}

    T Get() {
        return shared_state_->GetValue();
    }
};
修改 Promise 类:Promise 也持有 SharedState 的 std::shared_ptr。当 Promise 创建 Future 时,它会把自己的 shared_state_ 传递给 Future。
template <typename T>
class Promise {
private:
    std::shared_ptr<PromiseFutureSharedState<T>> shared_state_;
public:
    Promise() : shared_state_(std::make_shared<PromiseFutureSharedState<T>>()) {}

    // 共享状态传递过去
    Future<T> GetFuture() {
        return Future<T>(shared_state_);
    }

    void SetValue(const T& val) {
        shared_state_->SetValue(val);
    }

    void SetException(std::exception_ptr ex) {
        shared_state_->SetException(ex);
    }
};
优势:
- 彻底打破编译依赖:
Promise和Future都不用知道对方的完整定义,只要知道SharedState的完整定义。SharedState自身不依赖Promise或Future。头文件包含顺序变得简单:先定义SharedState,再定义Future和Promise。 - 通过
std::shared_ptr,SharedState的生命周期由所有持有它的Promise和Future实例共同管理。只要有一个Promise或Future存活,SharedState就会存活,避免悬垂指针和内存泄漏(除非有循环shared_ptr,但这里Promise和Future只是各自持有SharedState,不存在它们之间的循环引用)。 - 职责分离:
Promise的职责是“设置结果”。Future的职责是“获取结果”。SharedState的职责是“存储和同步结果”。
SharedState内部封装了mutex和condition_variable,支持多线程环境的并发访问。
五、结语
C++ 纯头文件库的类之间的循环依赖是很常见的问题。
C++编译器单遍扫描的工作机制是导致“类型未声明”或“不完整类型”错误的原因。两个类互相要对方的完整定义会让编译器陷入“先有鸡还是先有蛋”的困境。
为应对编译器的这一限制,可以用前置声明和延后实现这样的标准语法技巧。
从根本上消除设计上的双向强耦合。要用共享状态(Shared State)模式 ,打破编译依赖,实现架构层面的解耦。


 扫一扫


 381

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


