


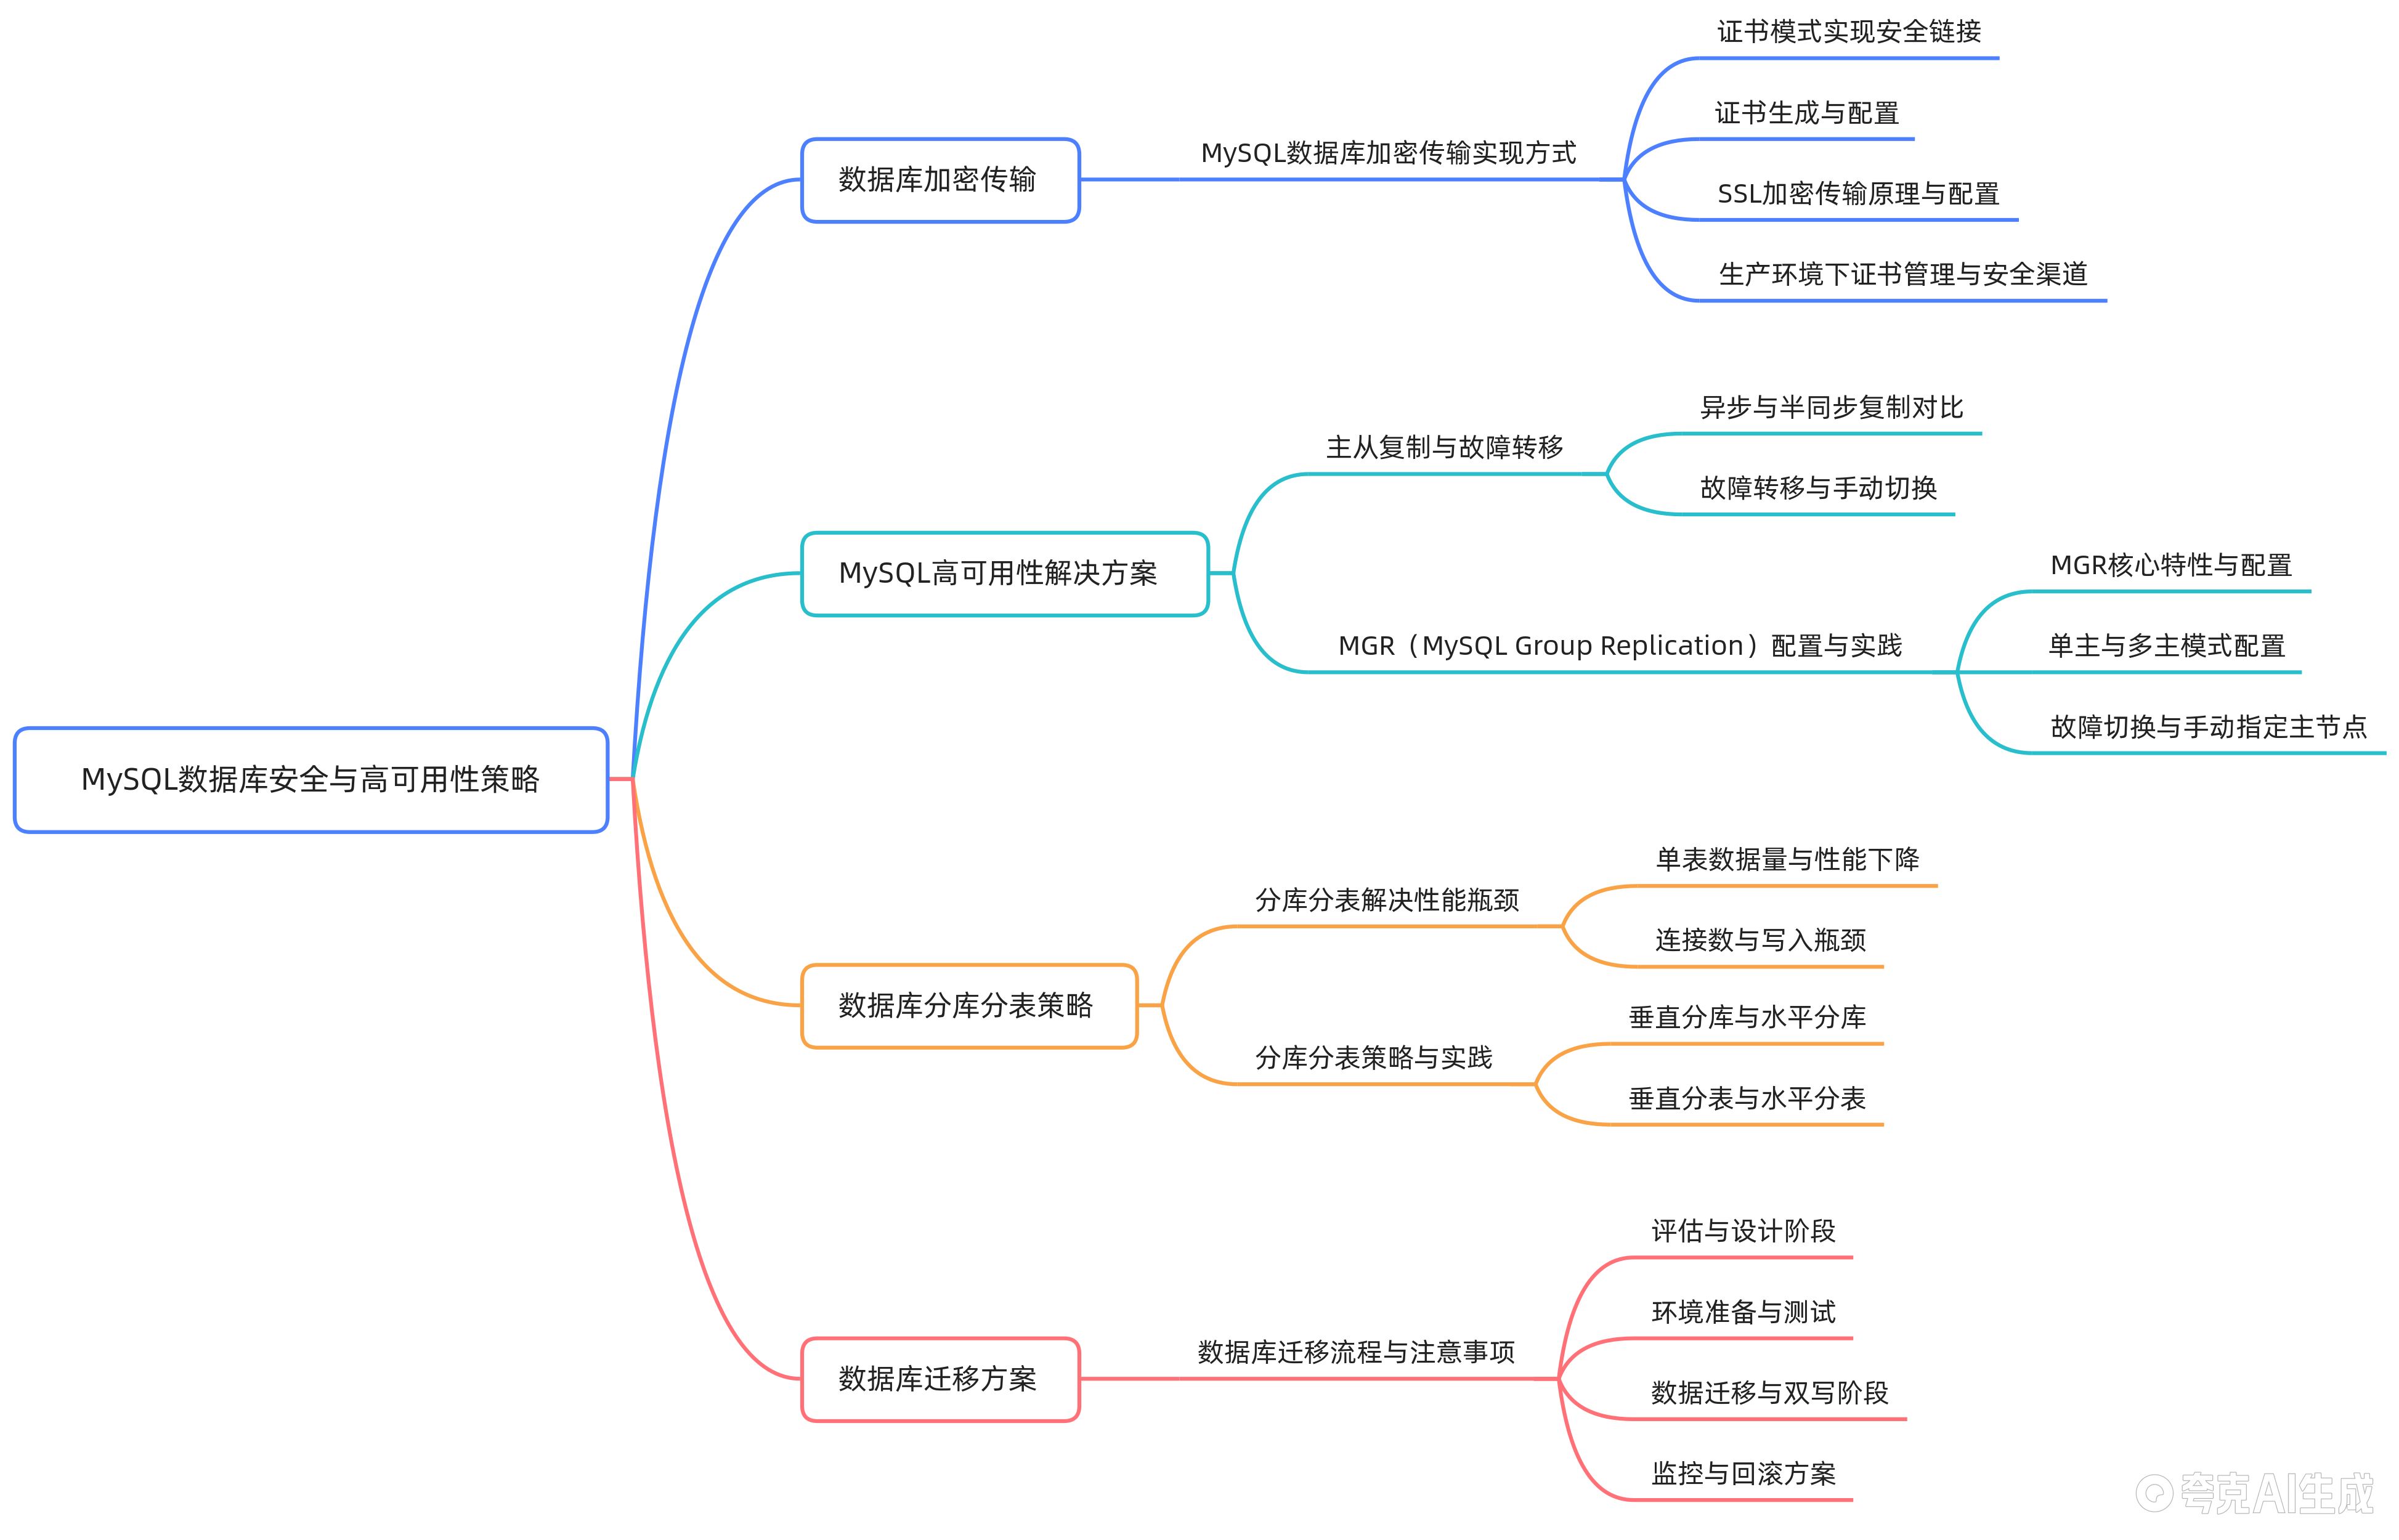
本次笔记记录了MySQL SSL加密传输原理与配置、Group Replication (MGR) 高可用集群部署、分库分表策略与数据迁移全流程
一、SSL加密传输实现原理与配置
1.1SSL加密传输目的与三大作用
| 作用 | 说明 |
| 身份验证 | 防止假冒网站与恶意攻击者窃取客户数据 |
| 数据加密 | 传输全程加密,防窃听与篡改 |
| 合规要求 | 满足国家登记保护二级测评上线要求 |
1.2身份验证与数据加密的秘钥机制
| 场景 | 加密方式 | 解密方式 |
| 身份验证 | 服务端私钥加密信息 | 客户端用服务端公钥解密,验证服务端身份 |
| 数据加密 | 客户端服务端公钥加密数据 | 服务端用自身私钥解密,确保数据未被篡改 |
1.3MySQL证书类型与生成方式
证书类型
| 类型 | 适用场景 |
| 自签名证书 | MySQL初始化后自动生成,适用测试环境 |
| CA证书 | 向证书颁发机构申请,生产环境使用,建立信任链 |
证书生成方式
1.启动 mysql 进程时自动生成
2.使用MySQL内置证书生成工具
3.手动用过UpenSSL指令生成CA证书,服务端证书及客户端证书
1.4服务端SSL配置要点
ini

   [mysql]
   #启用SSL
   ssl = ON
   #或强制SSL连接
   #ssl_mode = REQUIRED

   #指定证书路径
   ssl_ca = /path/to/ca.pem
   ssl_cert = /path/to/server-cert.pem
   ssl_key = /path/to/server-key.pem

   #可选:强制客户端证书验证
   require_secure_transport = ON
1.5客户端SSL连接方式
方式一:命令参数行
bash

    mysql -u user -p --ssl-mode=REQUIRED
方式二:配置文件
ini

   [client]
   ssl-ca = /path/to/ca.pem
   ssl-cert = /path/to/client-cert.pem
   ssl-key = /path/to/clien-key.pem
方式三:创建用户时强制SSL
sql

   CREATE USER 'user'@'host' REQUIRE SSL;
1.6SSL连接状态验证
sql

   --查看连接状态
   STATUS;

   --或查看SSL相关状态
   SHOW STATUS LIKE 'Ssl%';
成功标志
| 字段 | 期望值 |
| Ssl_cipher | 费空(如 ECDHE-RSA-AES128-GCM-SHA256 ) |
| Ssl_version | TLSv1.2 或 TLSv1.3 |
1.7SSL排错常见问题
| 问题 | 说明 |
| 证书过期或路径错误 | 检查证书有效期和文件路径 |
| TLS协议版本不匹配 | 客户端仅支持TLSv1.0,服务端要求TLSv1.2 |
| 证书域名/IP不一致 | 证书中域名/IP与实际访问地址不一致 |
| 文件权限错误 | 建议证书文件权限设限为600,仅mysql用户可读 |
1.8生产环境加固建议
| 项目 | 建议 |
| 证书有效期 | 服务端证书建议一年一换,CA证书可十年 |
| 安全分发 | 适用SCP等安全通道分发客户端证书,禁用U盘、FTP等非加密方式 |
| 加密套件 | 优先选用TLSv1.2/TLSv1.3及现代加密算法(如 ECDHE-ECDSA-AES256-GCM-SHA384 ) |
| 访问控制 | 结合IP白名单与防火墙限制访问源 |
二、MySQL Group Replication(MGR)高可用集群
2.1MGR核心特性与使用场景
核心特性
1.基于Paxos分布式一致性协议
2.强一致性:多数派共识后提交
3.自动故障转移
4.弹性扩展:最多9节点
5.多主/单主模式可选
适用场景
金融、电商等核心业务系统
2.2MGR与传统复制对比
| 复制类型 | 数据一致性 | 故障转移 | 说明 |
| 异步复制 | 无确认,存在丢失风险 | 手动 | 性能最高,一致性最差 |
| 半同步复制 | 至少一个从库返回ACK | 手动 | 数据一致性提升,仍需手动切换 |
| MGR | 多数派同一才提交 | 自动 | 自动完成故障检测与切换 |
2.3MGR架构模式
| 模式 | 说明 | 特点 |
| 单主模式 | 仅一个节点可读写(Primary),其余只读(Secondary) | 无需冲突检测 |
| 多主模式 | 所有节点均可读写 | 需启用冲突检测机制,避免并发写入导致数据不一致 |
2.4MGR关键配置项
| 配置项 | 说明 |
| server_id | 各节点必须唯一 |
| binlog_format=ROW | 强制基于行的复制(MGR唯一支持模式) |
| gtid_mode=ON | 启用GTID,用于事务唯一标识与冲突检测 |
| enforce_gtid_consistency=ON | 确保GTID一致性 |
| plugin_load_add=' group_replication.so ' | 加载MGR插件 |
| group_replication_group_name | 集群唯一UUID,所有节点必须一致 |
|
group_replication_local_address | 本节点集群通信地址(IP:PORT,非MySQL端口3306) |
| group_replication_group_seeds | 集群内所有节点地址列表(逗号分离) |
| group_replication_bootstrap_group | 仅首个节点启动时设为ON,其余为OFF |
2.5MGR部署流程
步骤1:初始化各节点MySQL实例
略
步骤2:修改配置文件并重启服务
ini

   [mysqld]
   server_id = 1
   binlog_format = ROW
   gtid_mode = ON
   enforce_gtid_consistency = ON
   plugin_load_add = 'group_replication.so'
   group_replication_group_name = 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee'
   group_replication_local_address = '192.168.1.1:33061'
   group_replication_group_seeds = '192.168.1.1:33061,192.168.1.2:33061,192.168.1.3:33061'
   group_replication_bootstrap_group = OFF
步骤3:创建复制用户并授权
sql

   CREATE USER 'repl'@'%' IDENTIFIED BY 'password';
   GRANT REPLICATION SLAVE ON *.* TO 'repl'@'%';
   GRANT GROUP_REPLICATION_ADMIN ON *.* TO 'repl'@'%';
步骤4:配置复制通道
sql

   CHANGE REPLICATION SOURCE TO
   SOURCE_USER = 'repl',
   SOURCE_PASSWORD = 'password'
   FOR CHANNEL 'group_replication_recovery';
步骤5:加载插件
sql

   INSTALL PLUGIN group_replication SONAME 'group_replication.so';
步骤6:启动引导模式(仅首个节点)
sql

   SET GLOBAL group_replication_bootstrap_group = ON;
   START GROUP_REPLICATION;
   SET GLOBAL group_replication_bootatrap_group = OFF;
步骤7:其他节点加入集群
sql

   START GROUP_REPLICATION;
2.6MGR状态检查与故障模拟
查看成员状态
sql

    SELECT * FROM performance_schema.replication_group_members;
| 字段 |
正常状态 |
| MEMBER_STATE | ONL INE |
|
MEMBER_ROLE |
PRIMARY 或 SECONDARY |
故障模拟
模拟主节点宕机后,集群自动选举新Primary,Secondary节点状态同步更新。
2.7MGR运维管理指令
sql

   --查看成员
   SELECT * FROM performance_schema.replication_group_members;

   --手动指定Primary
   SELECT group_replication_set_as_primary('mameber_uuid');

   --添加新节点(在新节点执行)
   START GROUP_REPLICATIONL;

   --移除节点
   STOP GROUP_REPLICATION

   --然后从group_replication_group_seeds删除其他地址
三、分库分表原理、策略与行业实践
3.1分库分表触发条件
| 指标 | 阈值 | 说明 |
| 单表数据量 | >1000万行或>10GB | 索引效率下降 |
| 单裤OPS | >1万 | 写入竞争加剧 |
| 单裤TPS | >5200 | 写入瓶颈 |
| 单裤连接数 | >1000 | 等待时间增长 |
| 硬件瓶颈 | CPU、内存、磁盘IO、网络带宽 | 无法垂直扩展 |
3.2分库策略
垂直分库
按业务模块拆分(如用户库、订单库、商品库)
适用场景:模块耦合度低、访问量差异大
水平分库
同一业务表按分片键(如用户ID、订单ID)哈希或范围拆分至多个库
使用场景:解决单库性能与容量瓶颈
3.3分表策略
垂直分表
将大字段(如TEXT、BLOB)或低频访问字段拆至扩展包
效果:减少主表IO压力
水平分表
同一表结构按分片键拆为多个子表(如 order_00 ~ order_99 )
效果:提升单表查询能力
3.4分库分表对比
| 策略 | 说明 | 适用场景 |
| 垂直分库 | 按业务模块拆分 | 模块耦合度低、访问量差异大 |
| 水平分库 | 按分片键拆分至多个库 | 单库性能与容量瓶颈 |
| 垂直分表 | 大字段/低频字段拆出 | 减少主表IO压力 |
| 水平分表 | 同表结构拆分为多子表 | 提升单表查询性能 |
3.5数据迁移五阶段流程
阶段一:评估与设计→阶段二:环境准备→阶段三:数据迁移→间断四:应用切换→阶段五:监控与回滚
阶段一:评估与设计
1.评估数据量
2.设计分片策略
3.定制迁移方案(DBA与开发主导)
阶段二:环境准备
1.搭建目标集群
2.部署中间件
3.验证复制与性能(运维主导)
阶段三:数据迁移
1.历史数据全量迁移
2.增量同步
3.数据效验(确保完整性)
阶段四:应用切换
1.双写过渡:旧库+新库同时写
2.灰度切换:边缘业务先切
3.全量切换
阶段五:监控与回滚
1.监控系统指标(QPS、延迟、错误率)
2.预设回滚方案应对异常
3.6典型行业分库分表案例
电商
| 项目 | 数据规模 |
| 日均订单 | 500万+ |
| 总订单 | 50亿+ |
方案:水平分库表+分片键(用户ID哈希)
金融
| 项目 | 数据规模 |
| 日交易量 | 1亿+ |
| 日账目 | 5亿+ |
方案:MGR多主+垂直分库(强一致性要求)
社交
| 项目 | 数据规模 |
| 日活 | 500万+ |
| 日消息 | 50亿+ |
方案:按用户ID分库+消息类型分表+冷热分离
游戏
| 项目 | 数据规模 |
| 日活 | 500万+ |
| 角色总数 | 5000万+ |
方案:按区服(shard)分库+角色基础数据、背包、任务分表
loT
| 项目 | 数据规模 |
| 设备数 | 1000万+ |
| POS机 | 海量接入 |
方案:按设备ID哈希分库+时间范围分表(如按月)
四、数据库高可用技术生态概览
4.1高可用方案对比
| 方案 | 特点 | 适用场景 |
| MGR | 官方原生,强一致、自动切换 | 核心系统 |
| ProxySQL/MaxScale | 读写分离中间件,支持自动故障转移 | 读写分离场景 |
| MyCat | 阿里开源分库分表中间件 | 历史遗留分表需求(多年未更新) |
| Galera Cluster | 第三方同步复制集群 | 高一致性需求 |
| 主从复制+Keepalived | 传统VIP飘逸方案 | 需手动干预 |
4.2技术选型原则
1.架构师根据业务场景(数据量、一致性要求、运维能力)选型
2.运维人员需理解各方案原理,能解释“为何选此而非彼”
选型实例
| 业务场景 | 推荐方案 |
| 强一致金融场景 | MGR |
| 历史遗留分表需求 | MyCat |
| 读写分离需求 | ProxySQL/MaxScale |
总结
| 模块 | 核心要点 |
| SSL加密 | 身份验证+数据加密,生产环境使用CA证书,注意TLS版本匹配 |
| MGR集群 | Paxos协议强一致,自动故障转移,支持单主/多主模式 |
| 分库分表 | 单表>1000万行触发,垂直/水平拆分,五阶段迁移流程 |
| 高可用选型 | 根据业务场景,MGR适合强一致,中间件适合读写分离 |
SSL保障传输安全,MGR保障数据一致与高可用,分库分表解决性能瓶颈;技术选型需结合业务场景综合考虑。


 扫一扫


 320

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


