


LaRA:检索增强生成与长上下文LLMs的基准测试 —— 长上下文或RAG路由并无万能解决方案
LaRA: Benchmarking Retrieval-Augmented Generation and Long-Context LLMs - No Silver Bullet for LC or RAG Routing

摘要
将外部知识有效整合到大型语言模型(LLMs)中,对于增强其能力并满足现实需求至关重要。检索增强生成(RAG)通过检索最相关的片段并将其引入LLMs,提供了一种实现这一目标的有效方法。然而,LLMs在上下文窗口大小方面的进步提供了另一种替代方案,这就引发了一个问题:RAG是否仍然是有效处理外部知识的必要手段?现有的一些研究对RAG与长上下文(LC)LLMs之间的比较得出了不一致的结果,这主要是由于基准设计的局限性所致。
在本文中,我们提出了LaRA,一个专门设计用于严格比较RAG和LC LLMs的新型基准。LaRA涵盖了四个实用问答任务类别和三种自然发生的长文本类型,共计2326个测试案例。通过对七个开源和四个专有LLMs进行系统评估,我们发现,RAG与LC之间的最佳选择取决于多种因素的复杂相互作用,包括模型的参数规模、长文本处理能力、上下文长度、任务类型以及检索片段的特性。我们的研究结果为从业者提供了可操作的指导,帮助他们在开发和部署LLM应用时有效利用RAG和LC两种方法。
我们的代码和数据集可在以下网址获取:https://github.com/Alibaba-NLP/LaRA。
1. 引言
尽管大型语言模型(LLMs)在各个领域表现卓越,但信息的动态特性对其有效获取新知识的能力提出了重大挑战。当前的研究揭示了LLMs的一些局限性,包括处理长文本时的高计算成本、容易产生事实错误和幻觉、难以适应专业领域,以及倾向于生成过于泛化的回答(Gao等, 2023)。为了解决这些问题,研究人员探索了检索增强生成(RAG)(Guu等, 2020;Lewis等, 2020)。RAG通过从上传的文档、知识库或网站中检索最相关的片段,使LLMs能够高效利用外部知识。然而,近期LLMs的进步,例如GPT-4o(OpenAI, 2024)、Llama 3.2(Meta, 2024a)、Claude 3.5(Anthropic, 2024)和Qwen 2.5(Yang等, 2024),现在支持长达128k个token的输入长度,提供了一种替代方案——直接将相关信息的完整上下文输入模型。这引发了关于RAG是否仍然必要的疑问,因为这些模型现在可能直接访问和处理所需的信息。因此,系统地比较RAG与长上下文(LC)LLMs的优劣变得尤为重要。
许多研究探讨了RAG与直接向LLMs提供完整长上下文之间的性能差异。例如,Xu等人发现,在几个传统的问答数据集上,RAG的表现优于LC。最近,Li等人认为,在几乎所有情况下,LC的表现始终优于RAG。然而,Yu等人随后进行的实验表明,RAG并不一定比LC弱。这种缺乏共识的情况很可能源于现有基准测试评估流程设计中的若干缺陷,包括语料库问题(例如文本过短、替换失败)、评估指标和不切实际的任务设计。
为了解决这些问题并促进RAG与LC之间的稳健比较,我们提出了LaRA,一个用于评估长上下文LLMs与RAG竞争的基准。在构建LaRA时,我们遵循以下标准:(1) 上下文长度应在LLMs的输入限制内最大化,以避免因截断而掩盖模型的真实能力。(2) 上下文应由自然发生的长文本组成,而非人工构造的例子,以反映真实世界的使用场景。(3) 回答问题应需要借助提供的上下文信息,确保LLM无法仅凭其内部知识作答。(4) 问题应有明确的答案,以便通过LLMs进行准确评估。(5) 问题应反映人类在现实世界中使用LLMs时可能提出的实际查询。LaRA旨在作为设计有效的RAG或LC规划系统的指南,因此所有包含的问题都必须有意义、相关,并反映真实世界的信息需求。
具体而言,LaRA涵盖了三种最常见的长上下文类型——小说、学术论文和财务报表,这些类型被选用来代表多样化的写作风格和信息密度。LaRA包含四种问答任务,旨在评估处理长上下文的关键能力:定位特定信息、比较文本的不同部分、对内容进行推理以及检测幻觉。问答对的构建结合了人工标注和LLM辅助生成,我们通过迭代优化种子示例和提示,直到生成的问答对达到预设的通过率。为了确保评估的准确性和可靠性,我们使用GPT-4o作为评判者来确定预测的正确性,并通过计算LLM与人类评估之间的Cohen’s Kappa系数进一步验证结果,确认了高度的一致性。
我们在LaRA上的广泛实验表明,RAG与LC之间的选择并非微不足道,因为它会因模型规模、查询类型、任务类型、上下文长度、上下文类型和检索片段数量等因素而显著变化。如果我们能确定RAG优于LC的具体场景,就可以更好地设计工作流,将每个查询路由到RAG或LC,从而在成本和性能之间实现优化,进而开发出更高效和有效的LLM应用。我们的主要发现如下:
- 模型强度:RAG对较弱模型的提升更为显著。我们的分析表明,模型强度与RAG的有效性之间存在相关性:模型越弱,RAG带来的改进越大。例如,在128k上下文长度下,RAG在Llama-3.2-3B-Instruct和Mistral-Nemo-12B上的准确率分别比LC高出6.48%和38.12%。对于具有强大长文本处理能力的模型,如GPT-4o和Claude-3.5-sonnet,LC通常优于RAG,证明了这些模型在直接处理广泛上下文方面的有效性。
- 上下文长度:随着上下文长度的增加,RAG的优势变得更加明显。在32k上下文长度下,LC在所有模型上的平均准确率比RAG高出2.4%。然而,在128k上下文长度下,这一趋势逆转,RAG的表现比LC高出3.68%。
- 任务表现:RAG在单点任务中的表现与LC相似,并在识别幻觉方面具有显著优势。相比之下,LC在推理任务和比较任务中表现出色。
2. 重新审视RAG与长上下文基准测试
尽管已有大量基准被用于比较RAG与向语言模型提供长上下文的效果,但关于何时何地RAG会比长上下文更具优势,目前尚缺乏明确的指导和结论。Xu等人和Bai等人在RAG与LC在传统问答数据集上的表现孰优孰劣得出了相反的结论。最近,Li等人认为,在几乎所有场景下,LC的表现都优于RAG;而Yu等人随后声称,在同一基准上,RAG可以击败LC。在本节中,我们对现有的基准和分析进行了详细探讨,并发现关键问题源于其评估流程中的若干重大缺陷。为简化起见,我们的分析主要集中于基于长上下文的问答任务。
2.1 外部上下文的问题
不足的上下文长度
随着LLM基础模型的不断发展,“长上下文”的定义也在发生变化,从早期4k token的限制扩展到如今普遍支持的128k上下文长度。一些早期工作利用了如Qasper(QASP)(Dasigi等, 2021)、NarrativeQA(NQA)(Kociský等, 2018)和QuALITY(QLTY)(Pang等, 2022)等数据集来比较RAG与LC。例如,Xu等人在这些数据集上进行实验,发现RAG可以增强大型模型(如Llama2-70B和GPT-43B)的表现。同样,Lee等人将这些数据集组合创建了一个新基准以进行进一步评估。然而,这些数据集已不再符合当前“长上下文”的定义。例如,QASP和QLTY的平均上下文长度分别为4912和6592 token,远远低于现代LLMs的上下文长度能力。此外,RAG通常使用300–600 token的片段大小,并通过检索5–20个片段,使得RAG的总上下文长度与全上下文输入相当,从而减少了两种方法之间的差异。
数据泄露
由于LLMs在训练过程中使用的数据集越来越多,数据泄露问题变得愈发严重。同时,验证这些早期数据集是否是LLMs训练数据的一部分也颇具挑战性,这可能导致模型记住了答案。例如,尽管NarrativeQA的平均上下文长度为84,770 token,Gemini 1.5pro在此数据集上达到了100%的准确率(Lee等, 2024),这表明该数据集本身或其上下文很可能已被纳入模型的训练过程。
不恰当的上下文处理
∞-bench(Zhang等, 2024a)是一个近期广泛用于比较RAG与LC的基准(Li等, 2024b;Yu等, 2024),包含两个任务:En.QA和En.MC,其平均上下文长度分别为192.6k和184.4k token。然而,其处理过长上下文的方法存在问题。当上下文超出LLM的最大上下文长度时,中间部分会被截断。鉴于大多数模型的限制为128k token甚至更少,答案很可能在截断过程中被移除。在这种情况下,无法回答问题反映的是截断问题,而非模型的能力。为验证这一点,我们将En.QA和En.MC中的超长案例拆分为若干部分,每部分均在上下文长度限制内。这些部分分别与查询配对并单独输入LLM。LLM被指示首先判断问题是否可回答;如果不可回答,则拒绝提供答案。在获得多个答案后,采用投票机制得出最终答案。结果列于表1。
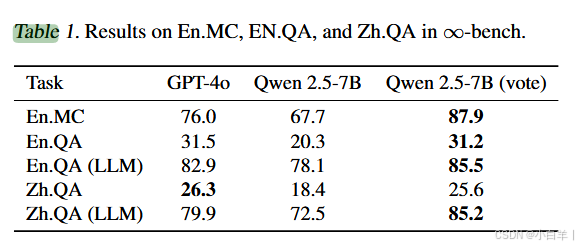
我们观察到,在采用分段输入和投票机制后,Qwen-2.5-7B的表现甚至超过了GPT-4o。
此外,为了防止与LLM训练期间见过的数据重叠,∞-bench采用了关键实体替换作为对策。然而,经过仔细检查,我们发现一些替换并未成功。例如,问题中提到的一些实体在提供的上下文中不存在,反之亦然[1]。
2.2 不准确的评估
不合理的指标
许多先前的评估使用了诸如F1分数和精确匹配(EM)等自动化指标(Chen等, 2024;Zhang等, 2024c),这些指标对于自然语言生成(NLG)任务而言并不可靠(Novikova等, 2017)。例如,如果真实答案是“Allyson Kalia”,而模型的回答是“Allyson Kalia因谋杀Kiran的弟弟Rosetta而被判有罪。”,预测显然是正确的。然而,其F1分数仅为0.29。这也是为什么在∞-bench(Zhang等, 2024a)的En.QA任务中得分往往非常低的原因。我们使用LLM重新评估,结果如表1所示。准确率显著提高,表明这些数据集并不像表面上看起来那么困难。
缺乏专用基准
过去一年中,引入了多个长上下文基准,例如ZeroSCROLLS(Shaham等, 2023)、LongBench(Bai等, 2024a)、BAMBOO(Dong等, 2024)、LooGLE(Li等, 2024a)、Ruler(Hsieh等, 2024)、∞-bench(Zhang等, 2024a)和LongBench-V2(Bai等, 2024b),文本长度逐步从20k增加到200k token。然而,这些基准主要侧重于测试模型处理长文本的能力。虽然其中一些基准包含与RAG相关的实验,但它们缺乏对RAG与LC之间更为系统的比较。此外,现有的RAG基准通常使用不到10k token的上下文长度(Chen等, 2024;Zhang等, 2024c;Stolfo, 2024;Lyu等, 2024;Saad-Falcon等, 2024),未能充分应对长上下文带来的挑战。尽管像LONG2RAG(Qi等, 2024)这样的同期工作探索了长上下文RAG,但其平均文本长度仍小于LaRA,且其重点在于评估长篇回答。类似地,Loong(Wang等, 2024)引入了用于比较RAG与LC在多文档问答中的任务,但其查询存在同质化问题。例如,聚类任务仅涉及确定论文之间的引用关系,推理问题只需提供引用链。这些查询脱离了具体内容,适用于任何类似文本,未能捕捉LLMs和RAG在多样化场景和上下文分布中的泛化能力。
3. LaRA
在本节中,我们将介绍LaRA的构建方式,以及它如何解决第3节中提到的现有基准测试中存在的问题。LaRA的统计数据详见附录A。
3.1 长上下文数据收集
在我们的上下文选择过程中,我们遵循以下原则:
(1) 时效性:我们选择近期高质量的长上下文,以防止数据泄露问题,确保它们不太可能被纳入LLM的训练数据中。
(2) 适当长度:考虑到主流商业和开源权重模型通常支持32k和128k的上下文长度,我们选择尽可能接近这些窗口大小但不超过它们的上下文。
(3) 自然性:所选上下文是自然发生的长文档,而不是人工构造或由不相关的短文本拼接而成,以确保基准能够反映真实世界使用的复杂性和多样性。
(4) 权威性:所有上下文都被视为可靠且可信的信息来源,因为其背后作者或机构的专业性、声誉和资质提供了保障。
为了确保上下文的多样性,我们选择了小说[2]、财务报表[3]和学术论文[4]作为上下文。对于小说,我们选择中篇小说和长篇小说的txt格式分别作为32k和128k的上下文。财务报表包括2024年美国上市公司的最新季度报告(32k)和年度报告(128k)。为了为学术论文创建适当长度的上下文,我们将2024年发表在arXiv上的几篇通过引用关系相关的论文进行组合。
实体替换
为了降低小说可能存在于LLMs训练数据中的数据泄露风险,我们进行了实体替换。先前的工作采用了类似的策略(Zhang等, 2024a;Li等, 2022),但我们发现许多实体替换存在错误或不一致,导致评估不准确。为了解决这一问题,我们使用GPT-4o精确识别并替换角色实体,并针对替换后的实体设计问题,确保小说文本与问题之间的一致性。详细信息见附录B。<




 扫一扫


 152

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


