


9月10日,DeepSeek新价格生效:Flash系列缓存命中输入价从0.05元/百万token降到0.02元,砍掉60%。
同一天,负责ChatGPT和Codex产品的Tibo Sottiaux在X上宣布暂停200美元Pro套餐的新订阅——“这些套餐给系统带来的压力最大”。购买页上最贵那一档变灰了,鼠标挪上去是一个禁止符号。
一边砍价六成,一边把最贵的档位下架。这两件事其实是同一本账的两面。
停售的不是模型,是“不限量”
那条推文里最容易被略过的是最后一句:其他套餐和API都不受影响。
这句话比“暂停订阅”更重。200美元档卖的是固定价格下不封顶的长任务,API卖的是按量计费的token。前者价格是死的、用量是活的,后者价格和用量同步。当Astra的单位算力开销比上一代更高,同一张卡能服务的Pro用户数就掉下来了。
所以被停的是包月制,不是模型。Astra没限流,走API的开发者照常调用。
OpenAI也没少加算力,从2023年的约0.2吉瓦扩到2025年的约1.9吉瓦。但需求更快:Astra 9月3日发布,9月7日就有人拿它做Blender建模把额度烧光,9月10日门就关了。
降价的钱,不是省出来的
DeepSeek凭什么降60%?答案在架构里:V4.1 Flash的全局KV缓存压到890字节/token,约为上一代的四分之一,长上下文最贵的那块开销直接砍掉约75%。
但这只是降价的一半条件,另一半在那份容易被跳过的融资公告里。智谱9月13日晚宣布完成约50亿美元融资,其中约30亿美元是零息可转债,转股价比公告前收盘价还溢价约12.5%——投资人愿意借钱给一家仍在亏损的公司,不收利息,还愿意用高于市价的价格等转股。
公告里有个比融资额更值得看的数字:截至8月底,智谱平台词元调用量比年初增长超40倍,API平均售价提升约101%。
在一个都在谈降价的行业里,这家公司的API均价翻了一倍,开放平台毛利率从-0.4%修到24.6%;它的GLM Coding Plan三档月费从49/149/469元提到118/538/1078元,最高那档涨了261%。降价的永远是标准品的入场券,涨价的是真正被用起来的部分。
钱去哪了:日均2.2亿港元
50亿美元里约六成投向下一代GLM和算力基础设施。烧钱速度公告里也有数:7月配售的313.75亿港元,到8月31日已用掉109.55亿——50天,日均2.2亿港元,比IPO阶段加速近十倍。
账面还有两百多亿为什么急着再融?公司的解释很直白:万卡乃至十万卡集群建设中,采购网络互联设备、锁定长期算力产能、定制高带宽内存都要付大比例预付款,等钱见底就错过供应链窗口了。智谱已建成一座1GW级数据中心,全部用国产芯片;DeepSeek也在乌兰察布招数据中心人员,计划再加1GW。
需求那头同样在放量:9月7日到13日,全球AI模型总调用量127万亿token,环比增长10.43%;中国模型61.17万亿,连续二十周超过美国。
你要付的是两笔钱
价格正在分成两条曲线。一条是能力价格——每百万token多少钱,它继续下探。另一条是容量价格——能不能在需要时稳定拿到算力,它在往上走,只是不写在任何价目表上:它表现为排队、限流阈值收紧、促销价到期不续,以及那个禁止符号。
对独立开发者,这意味着三件事:包月制在算力紧张时最脆弱,按量付费反而最稳,把关键链路押在订阅额度上,等于把可用性交给别人的容量余量;选型清单里该加一栏“可用性”,和价格、跑分并列;永远留第二家,因为旗舰模型的供给能在几小时内从敞开变成关门。
这两条曲线的分叉,也意味着“统一管理调用”比以往更重要。EasyAPI这类聚合入口的价值不在于它比官方便宜多少,而在于把不同渠道的可用性和成本放在同一个视图里——哪家限流了、哪家促销到期了、哪家还能稳定调用,一眼能看清,切换只改配置不碰业务代码。
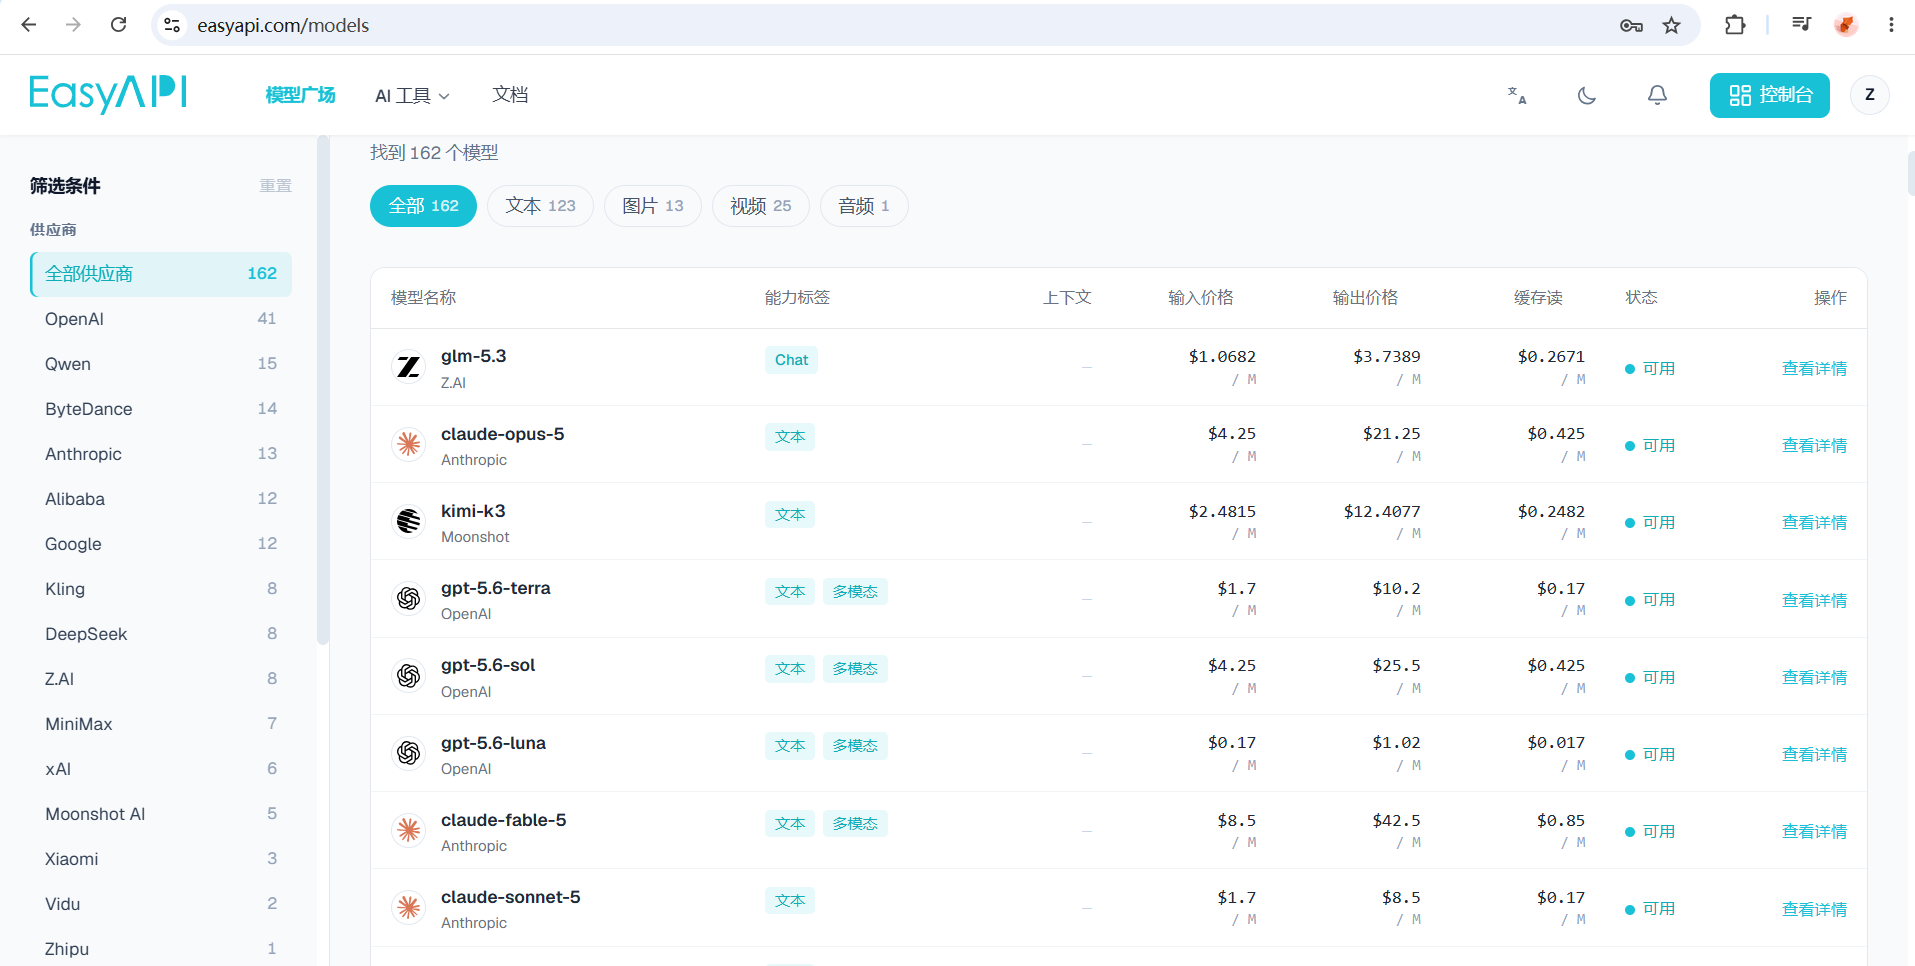
价格战还在打,只是战场从“谁能更便宜”挪到了“谁能一直被调用”。前者写在价目表上,后者写在服务器里。


 扫一扫


 293

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


