计算机体系结构补充篇----静态超标量流水线及循环展开(一)

代码执行流水之循环展开优化 IF:Instruction Fetch,取指令 ID:Instruction Decode,译码(应该是取数同时译码的过程) EX:Exec,执行 MEM:访存,从数据存储器中读 WB:Write Back,写回,将数据写到寄存器中。 https://www.cnblogs.com/CorePower/p/CorePower.html 链接贴上,日后来补! ... 阅读详情

本文严禁转载,仅供学习使用。参考资料来自中国科学院大学计算机体系结构课程PPT以及《Digital Design and Computer Architecture》、《超标量处理器设计》、同济大学张晨曦教授资料。如有侵权,联系本人修改。

计算机体系结构----静态超标量流水线及循环展开(一)

摘要

本文先简要介绍静态编译器流水线调度(消除数据冒险),再介绍循环展开(Loop Unrolling)技术(消除控制冒险),最后再结合静态超标量流水线技术(增加IPC)和循环展开技术对示例代码进行优化分析。

静态编译器流水线调度

假定有如下代码

for(i = 1000; i >0 ; i--)
	x[i] = x[i] + s;

上述代码转换成MIPS的汇编代码如下
(注意汇编代码段1先忽略各条指令之间的stall,即假定各条指令之间无stall)
汇编代码段1

 L.D F0, 0(R1) ; F0 = array element
 ADD.D F4, F0, F2 ; add scalar
 S.D F4, 0(R1) ; store result
 DADDUI R1, R1,# -8 ; decrement address pointer
 BNE R1, R2, Loop ; branch if R1 != R2
 NOP

现在我们做如下规定
LD -> any : 1 stall
FPMUL -> any: 5 stalls
FPMUL>ST : 4 stalls
IntALU ->BR : 1 stall
FPALU -> ST :2stalls
FPALU-> any: 3stalls
BR指的是分支指令。
每个BR指令后续都存在一个Stall。

那么汇编代码段1在上述假定下,实际执行情况如下
汇编代码段2

 L.D F0, 0(R1) ; F0 = array element
 stall
 ADD.D F4, F0, F2 ; add scalar
 stall
 stall
 S.D F4, 0(R1) ; store result
 DADDUI R1, R1,# -8 ; decrement address pointer
 stall
 BNE R1, R2, Loop ; branch if R1 != R2
 stall

汇编代码段2一共花费10 cycles。

在经过编译器的调度后,汇编代码段2变成如下代码段(注意,此时各条指令间不是不存在stall,而是被“合理”消除了))
汇编代码段3

 L.D F0, 0(R1) 
 DADDUI R1, R1,# -8
 ADD.D F4, F0, F2 
 stall
 BNE R1, R2, Loop
 S.D F4, 8(R1) 

汇编代码段3一共花费6 cycles。

实际上汇编代码段3真正在工作的时间只有ADD.D L.D S.D这三条指令,DADDUI BNE指令都是循环判断指令,知道了这个信息后,那我们还有再优化的空间吗?我们希望把几乎每个循环都控制在三个有效指令在工作,不想在每个循环中都加上循环判断指令。

循环展开

上面的汇编代码段3还可以依靠循环展开来二次优化。优化后的结果如下。
汇编代码段4(注意汇编代码段4先忽略各条指令之间的stall,即假定各条指令之间无stall)

 L.D F0, 0(R1) 
 ADD.D F4, F0, F2 
 S.D F4, 0(R1)
 L.D F6, -8(R1)
 ADD.D F8, F6, F2
 S.D F8, -8(R1)
 L.D F10,-16(R1)
 ADD.D F12, F10, F2
 S.D F12, -16(R1)
 L.D F14, -24(R1)
 ADD.D F16, F14, F2
 S.D F16, -24(R1)
 DADDUI R1, R1, #-32
 BNE R1,R2, Loop

如果我们考虑上汇编代码段4的各条指令间的stall,再合理的调度指令把stall给消除,可以得到如下代码段。(注意,此时各条指令间不是不存在stall,而是被“合理”消除了)
汇编代码段5

 L.D F0, 0(R1) 
 L.D F6, -8(R1)
 L.D F10,-16(R1)
 L.D F14, -24(R1)
 ADD.D F4, F0, F2 
 ADD.D F8, F6, F2 
 ADD.D F12, F10, F2
 ADD.D F16, F14, F2
 S.D F4, 0(R1)
 S.D F8, -8(R1)
 DADDUI R1, R1, # -32
 S.D F12, 16(R1)
 BNE R1,R2, Loop
 S.D F16, 0(R1)

汇编代码段5一共花费14 cycles,但是却做了汇编代码段2 40个cycles的事!
汇编代码段5每个原循环的cycle数为14/4 = 3.5 (14/4 中的14表示4个循环的总cycle数,4表示4个循环)
我们把这种一个循环展开四次在英文术语上称为Degree4,即循环展开N次,称为DegreeN。

当然,这还不是我们的极限,我们还可以使用静态超标量流水线继续加速!

静态超标量流水线
在这里插入图片描述
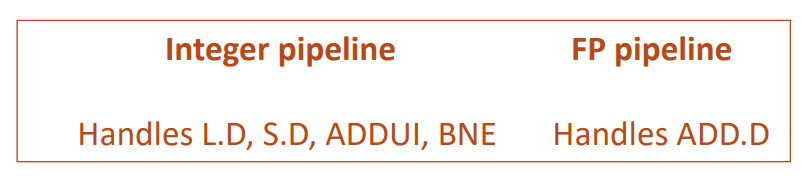
静态超标量可以简单理解成,处理器一次性发射两条指令,一条是整数指令,一条是浮点指令,以此来实现IPC > 1的效果。
将汇编代码段5改写成静态超标量流水线的形式,同时汇编代码段5的四次循环展开Degree4变成Degree5,代码段如下。
汇编代码段6,

Integer pipeline    FP pipeline
 L.D F0,0(R1)        NOP
 L.D F6,-8(R1)       NOP
 L.D F10,-16(R1)     ADD.D F4,F0,F2
 L.D F14,-24(R1)     ADD.D F8,F6,F2
 L.D F18,-32(R1)     ADD.D F12,F10,F2
 S.D F4,0(R1)        ADD.D F16,F14,F2
 S.D F8,-8(R1)       ADD.D F20,F18,F2
 S.D F12,-16(R1)     NOP
 DADDUI R1,R1,# -40  NOP
 S.D F16,16(R1)      NOP
 BNE R1,R2,Loop      NOP
 S.D F20,8(R1)       NOP

记住我们做的如下规定,注意汇编代码段6是建立在这个规定下的。
LD -> any : 1 stall
FPMUL -> any: 5 stalls
FPMUL>ST : 4 stalls
IntALU ->BR : 1 stall
FPALU->ST : 2stalls
FPALU-> any: 3stalls
BR指的是分支指令。
每个BR指令后续都存在一个Stall。

NOP = No option 即无操作。

计算机体系结构要点 chapter1 计算机的种类 大型主机 小型机,超级计算机 微处理器 互联网与服务器 个人计算机,嵌入式,便携式,普式计算 摩尔定律 集成电路芯片上所集成的电路的数目,每隔18个月就翻一番。 2、微处理器的性能每隔18个月提高一倍,而价格下降一倍 计算机体系结构定义—>两个概念 概念结构与功能特性 抽象层设计 计算机系统结构与计算机组成,实现的关系 程序员看到的计算 阅读详情

相关推荐

计算机系统结构:Pipelining 基本流水线技术

如何让程序运行更快? CPU性能公式:CPU时间 = CPI × 所执行的指令条数 × 时钟周期时间 关于流水线的几个问题: Pipeline Hazard(Data hazard、structure hazard、control) 流水线的性能评价 非线性流水线调度 程序的基本块 分支预测 静态调度:循环展开 动态调度:计分牌&Tomasulo算法 基本流水线技术 流水线的思想 如果顺序操作 如果流水线操作 流水线工作原理(review) 流水锁存器 流水线的每一个阶段称为流水步、流水段、流水

weixin_40064300的博客 4234

Computer Architectrure: Quantitative Approch 第三章第一、二节

Instruction-Level Parallelsim: Concepts and Challenge 本章主要介绍一些概念: 数据依赖性 1. 指令i的结果用在了指令j的计算里 2. 指令j依赖于指令i的结果,指令j依赖于指令k的结果(传递性) 命名依赖性 1. j在i后执行,j会对i中使用的寄存器进行改写 2.j和i顺次执行会写入相同的地址 数据冒险:囊括了数据依赖性和命名依赖性两种情况,主要有WAW WAR RAW 控制依赖性:执行的结果依赖于跳转指令,因此需要将跳转指令做完才能知道正确结果。 B

qq_33146555的博客 601

计算机组成与体系结构之指令系统与流水线技术

指令系统与流水线技术通过优化指令执行流程与硬件资源分配,共同提升了计算机系统的性能。未来趋势包括更深度的流水线设计、动态调度算法改进(如AI驱动的分支预测),以及指令集与硬件的协同创新(如RISC-V生态扩展)。

DKPT的博客 1226

【广工考试笔记】计算机系统结构考试速成笔记

【广工考试笔记】计算机系统结构考试速成笔记

weixin_51712663的博客 2933

计算机系统结构实验,流水线中的相关,循环展开及指令调度,记分牌算法和Tomasulo算法,Cache性能分析

计算机系统结构实验,流水线中的相关,循环展开及指令调度,记分牌算法和Tomasulo算法,Cache性能分析,伪相联Cache与虚拟Cache(选做),LRU页面置换算法模拟(选做)

八股已死、场景当立(Docker篇)

本文总结了Docker相关的面试八股文,重点介绍了Docker在Java开发中的应用。主要内容包括:Docker容器与虚拟机的区别及其对Java应用性能的影响;如何为Java应用构建优化镜像;Docker常用命令在Java容器管理中的使用;Docker网络模式与数据卷在Java微服务中的配置;使用Docker Compose部署Java+MySQL微服务的方法;以及为Java应用配置健康检查的重要性。文章还通过具体示例说明了Nginx容器挂载、日志收集等常见场景的实现方式,为Java开发者提供了实用的Doc

qq_55253420的博客 711

MIPS指令集:寄存器

   不同的计算机架构中寄存器的种类和数量也不相同。MIPSmips中用到的寄存器按照功能分为有通用寄存器、协处理器0、浮点寄存器、乘法部件寄存器。通用寄存器共32个,是没有特殊限制,一般程序员可以使用的寄存器。协处理器0寄存器也叫控制寄存器,共32个,用来控制并管理CPU。浮点寄存器和乘法部件寄存器都是专用寄存器。浮点寄存器也叫协处理器1寄存器,共32个,用来存储和浮点计算相关的数据。乘法部件...

海棠花的博客 1万+

SAP Fiori单点登录避坑指南:从SAML原理到实战,解决‘第一次登录跳转主页失败’和‘偶发进不了单点’

本文深入解析SAP Fiori单点登录(SSO)的SAML实战与疑难排查,涵盖SAML协议核心机制、SICF登录优先级控制及安全诊断工具的高级用法。针对‘首次登录跳转主页失败’和‘偶发单点登录失效’问题,提供从配置优化到生产环境稳定运行的全面解决方案,助力企业高效实现数字化转型。

weixin_29327977的博客 397

计算机体系结构期末复习

计算机体系结构期末复习 文章目录计算机体系结构期末复习5 流水线技术5.1 知识点5.2 大题(完) 5 流水线技术 5.1 知识点 计算机体系结构在向着多核并行的趋势发展,包括数据级并行(DLP),指令级并行(ILP),线程级并行(TLP),请求级并行(RLP)。本章主要讲解ILP。ILP实现有三种方式,第一种是superpipelining,流水线或超流水线处理机;第二种是super-scal...

a634238158的博客 4112

iOS WKWebView H5微信支付跳转

iOS WKWebView H5微信支付跳转 需求:iOS客户端实现嵌入H5进行微信支付跳转到微信客户端,支付完成后再跳转回我们的APP,解决WKWebView无法跳转回APP的BUG. 阅读前提: 了解WKWebView基本初始化及使用 了解如何利用URL Schemes进行应用间跳转 公司或个人已经在微信后台注册了一级域名 GitHub地址(附代码) :iOS WKWebView H5微信支付跳转 简书地址 :iOS WKWebView H5微信支付跳转 博客地址 :iOS WKWe...

ForeverMyheart的博客 2041

生成对抗网络(GAN、DCGAN、ACGAN)-----学习笔记

生成对抗网络学习笔记 生成对抗网络有两个关键结构:生成模型、判别模型。 生成模型:输入是一个服从正态分布的N维向量,利用这个N维向量生成一张图片。 判别模型:对于生成模型输出的图像判别它是不是真的图像。 生成模型和判别模型的博弈关系在于:生成模型的目的是生成让判别模型无法判别真伪的图像,而判别模型的目的是判断输入图像的真伪。 结合代码来看生成对抗网络中,生成器和判别器的训练过程: 判别模型的训...

weixin_43227526的博客 5482

【计算机组成原理】指令流水线常见问题解答:什么是超标量流水线?

本文深入探讨超标量流水线技术,这是现代CPU提升性能的核心方法。超标量通过多指令并行执行实现IPC>1,相比普通流水线增加了空间并行性。文章以问答形式解析超标量关键技术:动态调度、乱序执行、寄存器重命名机制;分析其性能瓶颈(数据依赖、缓存未命中等);比较超标量与超流水线、VLIW的区别;阐述其在ARM和RISC-V架构中的应用现状。文章指出,虽然单核IPC提升面临瓶颈,但通过与多核、超线程等技术协同,超标量仍是现代处理器设计的基石。

小李独爱秋的博客 1774

计算蛋白质结构中氨基酸之间的方向和方位

方向 (Direction):通过相邻氨基酸的 CαCα​ 原子坐标差值,得到方向向量,描述两个氨基酸之间的几何方向。方位 (Orientation):可以通过二面角(如 Psi)来表示相邻氨基酸之间的旋转关系,或者通过局部坐标系(基于 NN、CαCα​、CC 原子)描述残基的空间取向。这些计算是研究蛋白质结构动力学、折叠过程、以及相互作用的基础,尤其是在使用机器学习和深度学习模型进行蛋白质结构预测时,这些几何信息有助于更好地捕捉残基之间的空间关系。

qq_27390023的博客 1674

超标量体系结构_计算机体系结构——以多发射和静态调度来开发ILP

本文翻译摘录自“ComputerArchitecture : A Quantitative Approach (6th Edition)”。前面文章介绍的技术可以用来消除数据与控制停顿,从而使得CPI达到理想1。为了进一步提高性能,我们希望将CPI降低至小于1,但如果每个时钟周期仅发射一条指令,那CPI是不可能降低小于1的。多发射处理器的目标就是运行在一个时钟周期中发射多条指令。多发射处...

weixin_39553753的博客 1280

Arduino开发实例-EMG 肌肉信号传感器

在医学研究中,测量肌肉的活动、收缩和扩张非常重要。 EMG 肌肉传感器测量肌肉活动并产生信号以显示扩张和收缩量。 因此,输出取决于所选肌肉的活动量。 3 绿色、红色和黄色电极连接到模块,用于传输来自肌肉运动的电信号。

视觉与物联智能 1687

游戏引擎揭秘:大厂为何死磕自研?

游戏引擎本质与商业价值解析 游戏引擎是集成了渲染、物理、动画等核心功能的开发工具包,其价值在于让开发者免于重复编写底层代码,专注于游戏内容创作。商业引擎(如Unity/Unreal)虽降低了开发门槛,但头部厂商仍坚持自研引擎,主要基于以下考量: 经济性:长期项目分摊自研成本后,比商业引擎分成更划算; 可控性:完全掌握底层代码,能针对性优化核心玩法需求; 技术壁垒:专属引擎成为厂商的竞争优势,如米哈游的跨平台渲染技术; 项目适配:超大型游戏(开放世界/MMO)需要深度定制解决方案。 这种"短期高投入

本博客聚焦游戏开发技巧、创业实战心得及大学热门课程干货。这里既有技术深度,也有思维广度,无论你是开发者、创业者还是高校学子,都能在这里找到适合自己的成长之路! 253

计算机系统结构知识点讲义第二十讲——循环展开和指令调度

循环展开与指令调度是提升程序性能的核心技术,尤其在静态超标量架构中,通过编译器主导的静态调度和寄存器重命名,可显著提高指令级并行性。然而,需在实际应用中平衡代码膨胀、寄存器压力与性能收益,结合具体硬件特性进行参数调优。

小李独爱秋的博客 1581

Vue3 - Element Plus 下拉选择器 el-select 覆盖修改 placeholder样式,解决覆盖不生效问题(支持修改文字颜色、文字大小、选择器边框、hover效果、宽高等任意样式

vue3,element-plus,el-select,下拉选择器,下拉选择框,Select选择器,deep覆盖无效怎么办,怎么修改placeholder文字颜色,选择器select修改边框样式,修改文字大小,elementPlus选择器如何覆盖hover效果,使用deep改不了样式,修改边框颜色,select去掉边框,vue3+elementPlus中select选择器如何修改placeholder文字样式,修改el-select样式,select选择器样式覆盖不了咋办,el-select如何覆盖原样式,

🏆 前端领域优质创作者 1万+

计算机体系结构——计算机并行性的实现

实现计算机并行运算的硬件技术

知识,既贵,又便宜。 3273

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

计算机组成原理学习笔记——指令流水线

将一个重复的过程分解成若干子过程,每个子过程与其他子过程并行执行,这种方式称为流水线;指令流水线就是将一条指令分成若干段,然后按照先后次序执行,与一次性执行一整条指令不存在结果上的差异。指令流水线在并行处理中广泛应用。

御承扬的博客 2万+

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

计算机体系结构--多指令发射

多条指令发射 为了使流水线的CPI更好(更小)于1,并更好地利用指令级并行性(ILP),必须在同一流水线周期中发出多个独立的指令。 两种类型: 超标量:在同一周期内发出多条指令(2-8条),由编译器静态调度或动态调度(Tomasulo)。 超长指令字:固定数量的指令(3-6)被格式化为一个长指令字或包(由编译器静态调度)。 静态调度超标量流水线 每个周期可以发出两条指令(two-issue超标量)。其中一个指令是integer(包括load/store,branch)。另一条指令是浮点运算。 超长指令

QingerBig的博客 2883

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

计算机体系结构----指令级并行的开发(五)--基于编译器

计算机体系结构之指令级并行

输出每日所学,供大家学习使用 2205

计算机组成原理之超标量和动态流水线的基本概念

这种方式提高了流水线的吞吐率和处理器的性能。工作方式:动态流水线允许在同一时间内将不同的功能段连接成不同的功能子集(前提条件是功能部件的使用不发生冲突),以完成不同的运算功能。应用背景:随着处理器技术的不断发展,为了提高处理器的性能,需要处理器具有每个周期能发射执行多条指令的能力。特点:超标量处理器的指令发射频率高,相关的检测和解决策略的优劣将直接影响超标量处理器的性能。定义:动态流水线是指在流水线的各段可以进行不同的链接,在不同时间内,或者在同一时间内,通过不同的方式实现不同的功能。

DKPT的博客 919

超标量处理器基础笔记

现代处理器设计经典书籍,2004年出版

qq_42248523的博客 816

计算机组成原理与系统结构——指令级并行与超标量处理器

另一种方法是寄存器重命名,当创建一个新寄存器值时,为该值分配一个新寄存器,后续把该值作为源操作数的指令访问寄存器时,必须经过重命名过程(修改执行指令中的寄存器引用,以使其指向包含所需值的寄存器)。3)无序发射,无序完成——CPU无法提前看到冲突点后面的指令可能是独立于已在流水线中的指令,且可能被有效地引入流水线中,因此分离流水线的译码和执行,使用一个被称为指令窗口的缓冲区来实现无序发射和完成。1)指令获取策略通常利用预测条件分支指令的结果,以及获取条件分支指令之外的指令,来同时获取多条指令。

天問*的后花园 1065
上一篇: 超大规模集成电路设计----学习框架(一)
下一篇: 超大规模集成电路设计----基本概念(二)
MinJohnson
博客等级 码龄7年 394粉丝 69原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
