


目录
前言
目标
优化策略
一、感知性能优化
1.loading
2.骨架屏
二、HTML优化
1.压缩 HTML
2.删除不必要的注释
3.删除不必要的属性
4.使用语义化标签
5.减少iframe数量
6…削减DOM数量和层级数量
7.减少 HTTP 请求次数
8.减少重排重绘
三、JavaScript优化
1.javascript脚本放到页面底部
2.将javascript和css从外部引入
3.删除重复的脚本
4.减少DOM访问
5.节流与防抖
6.合理的ajax恳求
7.长列表虚拟滚动优化
8 .代码结构的优化
四、CSS优化
1.尽量少用@import
2.避免!important,可以选择其他选择器
3.不要在ID选择器前面进行嵌套其它选择器
4.CSS文件压缩
5.CSS层级嵌套最好不要超过3层
6.删除无用的css
7.慎用*通配符
8.删除不必要的单位和零
9.异步加载非首屏css
10.将样式表放到页面顶部
11.不使用IE的Filter
12.检测工具推荐
五、图片优化
1.根据实际需要选择色深,压缩。
2.小图片引入雪碧图。
3.图片懒加载
4…缩小 favicon.ico 并缓存
5.img图片的alt属性要写, 合理使用target=“_blank”
6.采用svg图片或者字体图标
7.Base64
六、webpack构建优化
1. 线程加载器
2. 缓存加载器
3.Hot update
4.exclude & include
5.缩小 CSS 代码
6.缩小 JavaScript 代码
7.tree-shaking
8.source-map
9.Bundle Analyzer
10.模块懒加载
11.压缩包
12.base64
13.正确配置哈希
七、资源加载优化
1.使用 Web Workers
2.DNS预解析
3.预加载 preload
八、浏览器缓存策略
1.缓存位置
2.缓存策略
3.缓存场景
4.用户操作行为与缓存
九、服务器优化
1.静态资源使用 CDN
2.添加Expires或者Cache-Control响应头
3.对组件使用Gzip压缩
4.配置ETag
5.提供来自相同协议的文件
6.开启http2(多路复用,并行加载)
7.服务端渲染
8.分域存放资源
9.减少页面重定向
补充
性能测试网站推荐
1.WebPageTest
2.Web Page Analyzer
3.GT Matrix
4.Pingdom
5.36全球网站性能测试 (强烈推荐)
前言
在项目开发过程中,任何一个细节都有可能影响网站的访问速度,如果不了解性能优化知识,很多不利网站访问速度的因素会形成累加,从而严重影响网站的性能,导致网站访问速度变慢,用户体验低下,最终导致用户流失。
目标
让你的网站访问速度飞起来,性能体验留住你的客户。让你面试披荆斩棘,收获各大厂心仪offer,废话不多说,直接开整。
优化策略
一、感知性能优化
对于用户来说,用户的感知性能才是最重要的,简单讲,就是让用户感觉你的网站访问很快,并且感知性能没有衡量标准。如果一个页面的加载时间很长,我们也可以通过一些方式让用户觉得没有那么慢。
1.loading
最基础的菊花等待~。

推荐给大家一个loading gif网址,可以选择自己喜欢的动图使用哦。
网页动态加载(loading)GIF图标 - GIF图标 - 素材集市
2.骨架屏
原理:
使用一张占位骨架图(svg / lottie / gif)来代替 loading 效果,当数据加载完成后对替换掉骨架图。
实现方案:
1.HTML + CSS:主流。基本是自己在项目中以侵入式方式围绕html“定制”;微信小程序的骨架屏生成方案本质上也是这种。
2. 像React, Angular, Vue 使用的UI框架 ant-design,ng_zorro,Element ui 自带一些基础简单的骨架屏可以直接使用。如下图:

3.自动生成。利用一些手段在业务代码之外生成骨架屏,但最终还要依托架构插入到业务中。
二、HTML优化
1.压缩 HTML
HTML代码压缩,将注释、空格和新行从生产文件中删除。删除所有不必要的空格、注释和中断行将减少HTML的大小,加快网站的页面加载时间,并显著减少用户的下载时间。
2.删除不必要的注释
注释对用户来说是没有用的,应该从生产环境文件中删除。可能需要保留注释的一种情况是:保留远端代码库(keep the origin for a library)。
我们可以使用HTML minify插件删除注释。
3.删除不必要的属性
像 type="text/javascript" or type="text/css" 这样的属性应该被移除。
<!-- Before HTML5 -->
<script type="text/javascript">
    // Javascript code
</script>

<!-- Today -->
<script>
    // Javascript code
</script>
类型属性不是必需的,因为HTML5把text/css和text/javascript作为默认值。没用的代码应在网站或应用程序中删除,因为它们会使网页体积增大。
4.使用语义化标签
使用语义化标签可以提高代码的可读性和可维护性,并有助于搜索引擎优化。例如,使用 标签来定义页面头部,使用 标签来定义导航等。

语义化优势:
- 易于用户阅读,样式丢失的时候能让页面呈现清晰的结构。
- 有利于SEO,搜索引擎根据标签来确定上下文和各个关键字的权重。
- 方便其他设备解析,如盲人阅读器根据语义渲染网页
- 有利于开发和维护,语义化更具可读性,代码更好维护,与CSS3关系更和谐。
5.减少iframe数量
尽量少用iframe标签,爬虫是不会读取iframe的内容的。
6…削减DOM数量和层级数量
HTML 中标签元素越多,标签的层级越深,浏览器解析 DOM 并制作到浏览器中所花的时间就越长,所以应尽或许坚持 DOM 元素简洁和扁平化的层级。
7.减少 HTTP 请求次数
将多个 CSS 和 JavaScript 文件合并为一个文件,可以减少 HTTP 请求次数,从而提高页面加载速度。同时,使用浏览器缓存可以避免每次请求相同的文件。
8.减少重排重绘
重排:
当渲染树中的一部分(或全部)因为元素的规模尺寸,布局,隐藏等改变而需要重新构建, 这就称为回流(reflow)。每个页面至少需要一次回流,就是在页面第一次加载的时候。
哪些操作可以影响重排:
- 添加/删除元素
- display:none
- 移动元素位置
- 操作styles
- offsetLeft, scrollTop, clientWidth
- 修改浏览器大小,字体大小
重绘:
重绘是指一个元素外观的改变所触发的浏览器行为,浏览器会根据元素的新属性重新绘制,使元素呈现新的外观。重绘发生在元素的可见的外观被改变,但并没有影响到布局的时候。
划重点:
重排必定会引发重绘,但重绘不一定会引发重排。
三、JavaScript优化
1.javascript脚本放到页面底部
脚本的下载和执行,会阻塞其他资源(样式文件或图片)的下载。因此,将
2.将javascript和css从外部引入
将样式和脚本代码放到外部文件中,并使用链接或脚本标签来引用,可以提高页面加载速度。减少 DOM 操作:DOM 操作往往是页面加载速度缓慢的主要原因之一。尽量减少 DOM 操作的次数和复杂度,可以提高页面的响应速度和性能。
3.删除重复的脚本
一个页面中如果有两次使用到同一个JavaScript文件,那这将对页面性能产生很大的影响。主要有以下两点:
- 增加了不必要的HTTP请求。
- JavaScript执行所花费的时间。
4.减少DOM访问
访问DOM元素是有代价的,修改DOM元素则更为昂贵,因为它会导致浏览器重新计算页面的几何变化。如下代码:
// 频繁操作dom案列
<script type="text/javascript">
  function insertHtml () {
    for(let count = 0; count < 15000; count++){
      document.getElementById('dom').innerHTML+='循环操作dom';
    }
  }
</script>
访问DOM的次数越多,代码运行速度越慢。因此,在有其他方案可以代替的时候,我们要尽量减少访问DOM的次数。
5.节流与防抖
日常开发过程中,滚动事件做复杂计算频繁调用回调函数很可能会造成页面的卡顿,这时候我们更希望把多次计算合并成一次,只操作一个精确点,JS把这种方式称为debounce(防抖)和throttle(节流)。
防抖函数:
function debounce(fn, wait) {
    let timeout = null;      //定义一个定时器
    return function() {
        if(timeout !== null)
                clearTimeout(timeout);  //清除这个定时器
        timeout = setTimeout(fn, wait);
    }
}
// 处理函数
function handle() {
    console.log(Math.random());
}
// 滚动事件
window.addEventListener('scroll', debounce(handle, 1000));
节流函数:
let throttle = function(func, delay) {
    let prev = Date.now();
    return function() {
        let context = this;   //this指向window
        let args = arguments;
        let now = Date.now();
        if (now - prev >= delay) {
            func.apply(context, args);
            prev = Date.now();
        }
    }
}
function handle() {
    console.log(Math.random());
}
window.addEventListener('scroll', throttle(handle, 1000));
防抖和节流能有效减少浏览器引擎的损耗,防止出现页面堵塞卡顿现象。
6.合理的ajax恳求
关于回来内容相同的恳求,没必要每次都直接从服务端拉取,合理运用 AJAX 缓存能加快 AJAX 呼应速度并减轻服务器压力。
7.长列表虚拟滚动优化
虚拟列表是一种用来优化长列表的技术。它可以保证在列表元素不断增加,或者列表元素很多的情况下,依然拥有很好的滚动、浏览性能。它的核心思想在于:只渲染可见区域附近的列表元素。下图左边就是虚拟列表的效果,可以看到只有视口内和临近视口的上下区域内的元素会被渲染。

推荐几个基于框架的开源实现:
- 基于React的
[react-virtualized](https://www.npmjs.com/package/react-virtualized "react-virtualized") - 基于Vue 的
[vue-virtual-scroll-list](https://www.npmjs.com/package/vue-virtual-scroll-list "vue-virtual-scroll-list") - 基于Angular的
[ngx-virtual-scroller](https://www.npmjs.com/package/ngx-virtual-scroller "ngx-virtual-scroller")
8 .代码结构的优化
1.设置Viewport:HTML的viewport可加快页面的渲染。
2.减少DOM结点:DOM结点太多会影响页面的渲染。
3.尽量使用css3动画:合理使用requestAnimationFrame动画代替setTimeout。
4.优化高频事件:scroll、touchmove等事件尽量使用函数防抖节流等进行限制。
-
不滥用WEB字体:WEB字体需要下载、解析、重绘当前页面,尽量减少使用。
-
文件命名规则须统一且要有意义,同类型文件归类到相同的文件夹中。
7.删除无效注释。
四、CSS优化
1.尽量少用@import
主要有两个原因:
1.使用@import引入CSS会影响浏览器的并行下载。使用@import引用的CSS文件只有在引用它的那个css文件被下载、解析之后,浏览器才会知道还有另外一个css需要下载,这时才去下载,然后下载后开始解析、构建render tree等一系列操作。这就导致浏览器无法并行下载所需的样式文件。
2.多个@import会导致下载顺序紊乱。在IE中,@import会引发资源文件的下载顺序被打乱,即排列在@import后面的js文件先于@import下载,并且打乱甚至破坏@import自身的并行下载。
2.避免!important,可以选择其他选择器
因为这破坏了样式表中固有的级联规则,使调试bug变得更加困难。它很容易使用不当,而且容易成倍增加,尤其是在滥用时。您可以轻松地!important得出一个带有要覆盖的规则的元素,这时您通常不得不重构样式,或使用另一个!important规则来加剧问题。
如果你一定要使用,最好定义基本样式尽可能靠近html或body元素,并且要覆盖时,请尽量避免使用特殊性。这样,您就有足够的空间进行更改。
3.不要在ID选择器前面进行嵌套其它选择器
主要有两个原因:
1.ID选择器本来就是唯一的而且人家权值那么大,前面嵌套,完全是浪费性能。
// 浪费性能。
.content #dom {}
2.除了嵌套,在ID选择器前面也不需要加标签或者其它选择器。比如 div#dom 或者.box#dom。这两种方式完全是多余的,理由就是ID在页面就是唯一的。前面加任何东西都是多余的!
// 多余写法
div#dom {}
4.CSS文件压缩
这应该是最容易想到的一个方法了,通过压缩CSS文件大小来提高页面加载速度。现在的构建工具,如webpack、gulp/grunt、rollup等也都支持CSS压缩功能。压缩后的文件能够明显减小,可以大大降低了浏览器的加载时间。
5.CSS层级嵌套最好不要超过3层
一般情况下,元素的嵌套层级不能超过3级,过度的嵌套会导致代码变得臃肿,沉余,复杂。导致css文件体积变大,造成性能浪费,影响渲染的速度!而且过于依赖HTML文档结构。这样的css样式,维护起来,极度麻烦,如果以后要修改样式,可能要使用!important覆盖。尽量保持简单,不要使用嵌套过多过于复杂的选择器。
6.删除无用的css
我们应该尽可能地提取公共类,减少重复。对于后者,在不同开发者进行代码维护的过程中,总会产生不再使用的CSS的代码,当然一个人编写时也有可能出现这一问题。
7.慎用*通配符
有时候可能会写下面这种代码来消除一些标签的默认样式或统一浏览器对标签渲染的差异化
*{
  margin:0;
  padding:0;
}
开发时尽量避免使用通配符选择器。
8.删除不必要的单位和零
CSS 支持多种单位和数字格式,可以删除尾随和跟随的零,零始终是零,添加维度不会为包含的信息附带任何价值。
.dom {
  padding: .2px;
  margin: 24px;
  width: 20px;
}
9.异步加载非首屏css
CSS会阻塞DOM的渲染,所以我们将首屏关键CSS内联后,剩余的非首屏CSS内容可以使用外部CSS,并且异步加载,防止非首屏CSS内容阻塞页面的渲染。
10.将样式表放到页面顶部
我们希望浏览器尽早渲染获取到的任何内容。这对大页面和网速慢的用户很重要。给用户视觉反馈,比如进度条的重要性已经被大量研究和记录。在我们的情况中,HTML 页面就是进度条。当浏览器逐步加载页面头部,导航条,logo 等等,这些都是给等待页面的用户的视觉反馈。这优化了整体用户体验。
11.不使用IE的Filter
在图片加载过程中,这个滤镜会阻塞渲染,卡住浏览器,还会增加内存消耗而且是被应用到每个元素的,而不是每个图片,所以会存在一大堆问题。
12.检测工具推荐
给大家推荐两个检测和优化css的工具:
Online CSS Analyzer - Project Wallace
CSS Performance Testing Tool — Maker’s Aid
五、图片优化
1.根据实际需要选择色深,压缩。
减小图片的大小可以减少页面加载时间。可以使用图片压缩工具来压缩图片,以减小文件大小。
2.小图片引入雪碧图。
雪碧图(CSS Sprite)又叫CSS精灵图主要用于把一堆小图标整合在一张背景透明的大图上,通过设置对应的位置来显示不同的图片,目的是大幅减轻服务器对图片的请求数量,是前端性能优化的一种方式。

优势:
1、减少网页的HTTP请求,提高页面性能
2、减少图片命名的困扰
劣势:
1、需要计算每个图片的位置
2、后期维护困难
3.图片懒加载
一般来说,我们访问网站页面时,其实很多图片并不在首屏中,如果我们都加载的话,相当于是加载了用户不一定会看到图片, 这显然是一种浪费。解决的核心思路就是懒加载:实现方式就是先不给图片设置路径,当图片出现在浏览器可视区域时才设置真正的图片路径。
4…缩小 favicon.ico 并缓存
有利于 favicon.ico 的重复加载,由于一般一个 Web 运用的 favicon.ico 是很少改动的。
5.img图片的alt属性要写, 合理使用target=“_blank”
<img src="图片地址" alt="图片keyword"/> alt属性一定要写
合理而不频繁使用target=“_blank” 是可以在一定程度上位站点带来回旋流量和点击的。同一时候。在细节上使用 target=“_blank” ,可以增强站点总体用户体验 。
6.采用svg图片或者字体图标
因为字体图标或者SVG是矢量图,代码编写出来的,放大不会失真,而且渲染速度快。字体图标使用时就跟字体一样,可以设置属性,例如 font-size、color 等等,非常方便,还有一个优点是生成的文件特别小。
7.Base64
将图片的内容以Base64格式内嵌到HTML中,可以减少HTTP请求数量。但是,由于Base64编码用8位字符表示信息中的6个位,所以编码后大小大约比原始值扩大了 33%。
六、webpack构建优化
1. 线程加载器
多线程可以提高程序的效率,我们也可以在 Webpack 中使用。而thread-loader是一个可以在Webpack中启用多线程的加载器。
安装:
npm i thread-loader -D
webpack.config.js中配置:
module.exports = {
  module: {
    rules: [
      {
        test: /\.js$/,
        include: path.resolve("src"),
        use: [
          {
            loader: "thread-loader",
            options: {
              workers: 2,
              workerParallelJobs: 50,
              workerNodeArgs: ['--max-old-space-size', '1024'],
              poolTimeout: 2000,
              poolParallelJobs: 50
            }
          },
          "expensive-loader"
        ]
      }
    ]
  }
}
注意:
不一定使用该Loader就一定能提升效率,因为进程之间的通信也会消耗时间,一般在处理文件比较耗时的Loader后面使用该Loader。
2. 缓存加载器
在我们的项目开发过程中,Webpack 需要多次构建项目。为了加快后续构建,我们可以使用缓存,与缓存相关的加载器是缓存加载器。
安装:
npm i cache-loader -D
Webpack 的配置如下 :
module.exports = {
    module: {
        // 如果babel-loader耗时比较长,配置cache-loader
        rules: [
            {
                test: /\.jsx?$/,
                use: ['cache-loader','babel-loader']
            }
        ]
    }
}
3.Hot update
当我们在项目中修改一个文件时,Webpack 默认会重新构建整个项目,但这并不是必须的。我们只需要重新编译这个文件,效率更高,这种策略称为Hot update。Webpack 内置了Hot update插件,我们只需要在配置中开启Hot update即可。
Webpack 的配置如下 :
const webpack = require('webpack');
module.exports = {
    module: {
      plugins: [
        new webpack.HotModuleReplacementPlugin()
    ],
    devServer: {
        hot: true
    }
  }
}
4.exclude & include
一些文件和文件夹永远不需要参与构建。所以我们可以在配置文件中指定这些文件,防止Webpack取回它们,从而提高编译效率。
- exclude : 不需要编译的文件。
- include : 需要编译的文件。
//webpack.config.js
const path = require('path');
module.exports = {
    //...
    module: {
        rules: [
            {
                test: /\.js[x]?$/,
                use: ['babel-loader'],
                include: [path.resolve(__dirname, 'src')]
            }
        ]
    },
}
5.缩小 CSS 代码
css-minimizer-webpack-plugin 可以压缩和去重 CSS 代码。
安装:
npm i css-minimizer-webpack-plugin -D
webpack.config.js中配置:
const MiniCssExtractPlugin = require("mini-css-extract-plugin");
const CssMinimizerPlugin = require("css-minimizer-webpack-plugin");

module.exports = {
  module: {
    rules: [
      {
        test: /.s?css$/,
        use: [MiniCssExtractPlugin.loader, "css-loader", "sass-loader"],
      },
    ],
  },
  optimization: {
    minimizer: [
      // 在 webpack@5 中,你可以使用 `...` 语法来扩展现有的 minimizer(即 `terser-webpack-plugin`),将下一行取消注释
      // `...`,
      new CssMinimizerPlugin(),
    ],
  },
  plugins: [new MiniCssExtractPlugin()],
};
这将仅在生产环境开启 CSS 优化。
如果还想在开发环境下启用 CSS 优化,请将 optimization.minimize 设置为 true:
module.exports = {
  optimization: {
    // [...]
    minimize: true,
  },
};
6.缩小 JavaScript 代码
terser-webpack-plugin 可以压缩和去重 JavaScript 代码。
安装:
npm i terser-webpack-plugin -D
webpack.config.js中配置:
module.exports = {
  optimization: {
    minimize: true,
    minimizer: [
      new TerserPlugin({
        terserOptions: {
          ecma: undefined,
          parse: {},
          compress: {},
          mangle: true,
          module: false,
          output: null,
          format: null,
          toplevel: false,
          nameCache: null,
          ie8: false,
          keep_classnames: undefined,
          keep_fnames: false,
          safari10: false,
        },
      }),
    ],
  },
};
7.tree-shaking
作用是把js文件中无用的模块或者代码删掉。而这通常需要借助一些工具。在webpack中tree-shaking就是在打包时移除掉javascript上下文中无用的代码,从而优化打包的结果。在webpack5中已经自带tree-shaking功能,在打包模式为production时,默认开启 tree-shaking功能。
module.exports = {
  mode: 'production'
}
8.source-map
当我们的代码出现bug时,source-map可以帮助我们快速定位到源代码的位置。但是这个文件很大。因此根据不同的环境来配置。
开发模式:
生成更准确(但更大)的 source-map。
module.exports = {
  mode: 'development',
  devtool: 'eval-cheap-module-source-map'
}
生产方式:
生成更小(但不那么准确)的源映射。
module.exports = {
  mode: 'production',
  devtool: 'nosources-source-map'
}
9.Bundle Analyzer
我们可以使用 webpack-bundle-analyzer 来查看打包后的 bundle 文件的体积,然后进行相应的体积优化。
安装:
npm i webpack-bundle-analyzer -D
1.webpack.config.js配置:
const BundleAnalyzerPlugin = require('webpack-bundle-analyzer').BundleAnalyzerPlugin
module.exports={
  plugins: [
    new BundleAnalyzerPlugin()  // 使用默认配置
    // 默认配置的具体配置项
    // new BundleAnalyzerPlugin({
    //   analyzerMode: 'server',
    //   analyzerHost: '127.0.0.1',
    //   analyzerPort: '8888',
    //   reportFilename: 'report.html',
    //   defaultSizes: 'parsed',
    //   openAnalyzer: true,
    //   generateStatsFile: false,
    //   statsFilename: 'stats.json',
    //   statsOptions: null,
    //   excludeAssets: null,
    //   logLevel: info
    // })
  ]
}
2.配置 package.json 文件
{
 "scripts": {
    "dev": "webpack --config webpack.dev.js --progress"
}
3.命令启动
npm run dev
看到项目资源包的交互式可视化树形分析图。

10.模块懒加载
如果模块没有延迟加载,整个项目的代码会被打包成一个js文件,导致单个js文件体积非常大。那么当用户请求网页时,首屏的加载时间会更长。
使用模块来加载后,大js文件会被分割成多个小js文件,加载时网页按需加载,大大提高了首屏的加载速度。
const routes = [
  { // 未使用懒加载
    path: '/index',
    name: 'index,
    component: index
  },
  {
    path: '/detail',
    name: 'detail',
    // 启用懒加载
    component: () => import('../views/detail/detail.vue'),
  },
]
11.压缩包
Gzip是一种常用的文件压缩算法,可以提高传输效率。但是,此功能需要后端配合。
安装:
npm i compression-webpack-plugin -D
修改vue.config.js配置:
const CompressionWebpackPlugin = require('compression-webpack-plugin');
const isProdOrTest = process.env.NODE_ENV !== 'development'
module.exports = {
    productionSourceMap: false,// 设为false,既可以减少包大小,也可以加密源码
    transpileDependencies: ['element-ui'],//指定某个库在打包的时候需要编译
    chainWebpack(config) {
        config.plugins.delete('prefetch');//默认开启prefetch(预先加载模块),提前获取用户未来可能会访问的内容 在首屏会把这十几个路由文件,都一口气下载了 所以我们要关闭这个功能模块
        if (isProdOrTest) {
            // 对超过10kb的文件gzip压缩
            config.plugin('compressionPlugin').use(
                new CompressionWebpackPlugin({
                    test: /\.(js|css|html)$/,// 匹配文件名
                    threshold: 10240,
                })
            );
        }
    }
}
同时需要nginx开启gzip压缩功能(nginx配置参考服务器优化gzip压缩配置)。
12.base64
对于一些小图片,可以转成base64编码,这样可以减少用户的HTTP请求次数,提升用户体验。url-loader 在 webpack5 中已被弃用,我们可以使用 assets-module 代替。
我也顺便也可以添加一些字体图片的配置、音频配置、Eslint配置、babel配置。
npm i eslint-webpack-plugin eslint -D
npm i babel-loader @babel/core @babel/preset-env -D
const path = require("path");
const ESLintWebpackPlugin = require("eslint-webpack-plugin");

module.exports = {
  entry: "./src/main.js",
  output: {
    path: path.resolve(__dirname, "dist"),
    filename: "static/js/main.js", // 将 js 文件输出到 static/js 目录中
    clean: true, // 自动将上次打包目录资源清空
  },
  presets: ["@babel/preset-env"],
  module: {
    rules: [
      {
        // 用来匹配 .css 结尾的文件
        test: /\.css$/,
        // use 数组里面 Loader 执行顺序是从右到左
        use: ["style-loader", "css-loader"],
      },
      {
        test: /\.less$/,
        use: ["style-loader", "css-loader", "less-loader"],
      },
      {
        test: /\.s[ac]ss$/,
        use: ["style-loader", "css-loader", "sass-loader"],
      },
      {
        test: /\.styl$/,
        use: ["style-loader", "css-loader", "stylus-loader"],
      },
      {
        test: /\.(png|jpe?g|gif|webp)$/,
        type: "asset",
        parser: {
          dataUrlCondition: {
            maxSize: 10 * 1024, // 小于10kb的图片会被base64处理
          },
        },
        generator: {
          // 将图片文件输出到 static/imgs 目录中
          // 将图片文件命名 [hash:8][ext][query]
          // [hash:8]: hash值取8位
          // [ext]: 使用之前的文件扩展名
          // [query]: 添加之前的query参数
          filename: "static/imgs/[hash:8][ext][query]",
        },
      },
      {
        test: /\.(ttf|woff2?)$/,
        type: "asset/resource",
        generator: {
          filename: "static/media/[hash:8][ext][query]",
        },
      },
      {
        test: /\.js$/,
        exclude: /node_modules/, // 排除node_modules代码不编译
        loader: "babel-loader",
      },
    ],
  },
  plugins: [
    new ESLintWebpackPlugin({
      // 指定检查文件的根目录
      context: path.resolve(__dirname, "src"),
    }),
  ],
  mode: "development",
};
**13.**正确配置哈希
我们可以将哈希添加到捆绑文件中,这样可以更轻松地处理缓存。
output: {
    path: path.resolve(__dirname, '../dist'),
    filename: 'js/chunk-[contenthash].js',
    clean: true,
  },
七、资源加载优化
1.使用 Web Workers
Web Worker 是一个独立的线程(独立的执行环境),这就意味着它可以完全和 UI 线程(主线程)并行的执行 js 代码,从而不会阻塞 UI,它和主线程是通过 onmessage 和 postMessage 接口进行通信的。
Web Worker 使得网页中进行多线程编程成为可能。当主线程在处理界面事件时,worker 可以在后台运行,帮你处理大量的数据计算,当计算完成,将计算结果返回给主线程,由主线程更新 DOM 元素。
2.DNS预解析
浏览器对网站第一次的域名DNS解析查找流程依次为:
浏览器缓存 ->系统缓存 ->路由器缓存 ->ISP DNS缓存 ->递归搜索
DNS预解析的实现:
用meta信息来告知浏览器, 当前页面要做DNS预解析:
<meta http-equiv="x-dns-prefetch-control" content="on" />
在页面header中使用link标签来强制对DNS预解析:
<link rel="dns-prefetch" href="https://code-nav.top" />
dns-prefetch最大的缺点就是使用它太多。过多的预获取会导致过量的DNS解析,对网络是一种负担。
3.预加载 preload
- 遇到link标签时,立刻下载并放到内存中,不执行js。
- 遇到script标签时,将预加载的js执行。
- 对跨域的文件进行preload时,必须加上 crossorigin 属性
<link rel="preload" crossorigin href="./zone.js" as="script">
基于标记语言的异步加载:
<link rel="preload" as="style" href="asyncstyle.css" onload="this.rel='stylesheet'">
八、浏览器缓存策略
原理:
缓存是浏览器的一种机制,可以把请求过的web资源(html、css、js、图片等)拷贝一份副本存储在浏览器中,并根据请求配置选择是否使用该副本。缓存是浏览器中一种重要的并且简单高效的一种性能优化的方式。一个优秀的缓存策略起到以下作用:
1.缩短网页请求资源的距离,减少延迟,增加用户体验
2.缓存文件可以重复利用,还可以减少带宽,降低网络负荷。
3.降低服务器压力。
1.缓存位置
Service Worker
Service Worker 的缓存与浏览器其他内建的缓存机制不同,它可以让我们自由控制缓存哪些文件、如何匹配缓存、如何读取缓存,并且缓存是持续性的。当 Service Worker 没有命中缓存的时候,我们需要去调用 fetch 函数获取数据。也就是说,如果我们没有在 Service Worker 命中缓存的话,会根据缓存查找优先级去查找数据。但是不管我们是从 Memory Cache 中还是从网络请求中获取的数据,浏览器都会显示我们是从 Service Worker 中获取的内容。
Memory Cache
Memory Cache 也就是内存中的缓存,读取内存中的数据肯定比磁盘快。但是内存缓存虽然读取高效,可是缓存持续性很短,会随着进程的释放而释放。 一旦我们关闭 Tab 页面,内存中的缓存也就被释放了。
当我们访问过页面以后,再次刷新页面,可以发现很多数据都来自于内存缓存

那么既然内存缓存这么高效,我们是不是能让数据都存放在内存中呢?
先说结论,这是不可能的。首先计算机中的内存一定比硬盘容量小得多,操作系统需要精打细算内存的使用,所以能让我们使用的内存必然不多。内存中其实可以存储大部分的文件,比如说 JSS、HTML、CSS、图片等等。但是浏览器会把哪些文件丢进内存这个过程就很玄学了,我查阅了很多资料都没有一个定论。
当然,我通过一些实践和猜测也得出了一些结论:
- 对于大文件来说,大概率是不存储在内存中的,反之优先
- 当前系统内存使用率高的话,文件优先存储进硬盘
Disk Cache
Disk Cache 也就是存储在硬盘中的缓存,读取速度慢点,但是什么都能存储到磁盘中,比之 Memory Cache 胜在容量和存储时效性上。
在所有浏览器缓存中,Disk Cache 覆盖面基本是最大的。它会根据 HTTP Herder 中的字段判断哪些资源需要缓存,哪些资源可以不请求直接使用,哪些资源已经过期需要重新请求。并且即使在跨站点的情况下,相同地址的资源一旦被硬盘缓存下来,就不会再次去请求数据。
Push Cache
Push Cache 是 HTTP/2 中的内容,当以上三种缓存都没有命中时,它才会被使用。并且缓存时间也很短暂,只在会话(Session)中存在,一旦会话结束就被释放。
Push Cache 在国内能够查到的资料很少,也是因为 HTTP/2 在国内不够普及,但是 HTTP/2 将会是日后的一个趋势。
- 所有的资源都能被推送,但是 Edge 和 Safari 浏览器兼容性不怎么好
- 可以推送
no-cache和no-store的资源 - 一旦连接被关闭,Push Cache 就被释放
- 多个页面可以使用相同的 HTTP/2 连接,也就是说能使用同样的缓存
- Push Cache 中的缓存只能被使用一次
- 浏览器可以拒绝接受已经存在的资源推送
- 你可以给其他域名推送资源
2.缓存策略
通常浏览器缓存策略分为两种:强缓存和协商缓存,并且缓存策略都是通过设置 HTTP Header 来实现的。
协商缓存:
如果缓存过期了,就需要发起请求验证资源是否有更新。协商缓存可以通过设置两种 HTTP Header 实现:Last-Modified 和 ETag 。
当浏览器发起请求验证资源时,如果资源没有做改变,那么服务端就会返回 304 状态码,并且更新浏览器缓存有效期。

Last-Modified 和 If-Modified-Since
Last-Modified 表示本地文件最后修改日期,If-Modified-Since 会将 Last-Modified 的值发送给服务器,询问服务器在该日期后资源是否有更新,有更新的话就会将新的资源发送回来,否则返回 304 状态码。
但是 Last-Modified 存在一些弊端:
- 如果本地打开缓存文件,即使没有对文件进行修改,但还是会造成
Last-Modified被修改,服务端不能命中缓存导致发送相同的资源 - 因为
Last-Modified只能以秒计时,如果在不可感知的时间内修改完成文件,那么服务端会认为资源还是命中了,不会返回正确的资源
因为以上这些弊端,所以在 HTTP / 1.1 出现了 ETag 。
ETag 和 If-None-Match
ETag 类似于文件指纹,If-None-Match 会将当前 ETag 发送给服务器,询问该资源 ETag 是否变动,有变动的话就将新的资源发送回来。并且 ETag 优先级比 Last-Modified 高。
以上就是缓存策略的所有内容了,看到这里,不知道你是否存在这样一个疑问。如果什么缓存策略都没设置,那么浏览器会怎么处理?
对于这种情况,浏览器会采用一个启发式的算法,通常会取响应头中的 Date 减去 Last-Modified 值的 10% 作为缓存时间。
强缓存:
强缓存可以通过设置两种 HTTP Header 实现:Expires 和 Cache-Control 。强缓存表示在缓存期间不需要请求,state code 为 200。
Expires
Expires: Wed, 22 Oct 2022 08:41:00 GMT
Expires 是 HTTP/1 的产物,表示资源会在 Wed, 22 Oct 2018 08:41:00 GMT 后过期,需要再次请求。并且 Expires 受限于本地时间,如果修改了本地时间,可能会造成缓存失效。
Cache-control
Cache-control: max-age=30
Cache-Control 出现于 HTTP/1.1,优先级高于 Expires 。该属性值表示资源会在 30 秒后过期,需要再次请求。
Cache-Control 可以在请求头或者响应头中设置,并且可以组合使用多种指令

从图中我们可以看到,我们可以将多个指令配合起来一起使用,达到多个目的。比如说我们希望资源能被缓存下来,并且是客户端和代理服务器都能缓存,还能设置缓存失效时间等等。
接下来我们就来学习一些常见指令的作用。

3.缓存场景
频繁变动的资源
对于频繁变动的资源,首先需要使用 Cache-Control: no-cache 使浏览器每次都请求服务器,然后配合 ETag 或者 Last-Modified 来验证资源是否有效。这样的做法虽然不能节省请求数量,但是能显著减少响应数据大小。
代码文件
这里特指除了 HTML 外的代码文件,因为 HTML 文件一般不缓存或者缓存时间很短。
一般来说,现在都会使用工具来打包代码,那么我们就可以对文件名进行哈希处理,只有当代码修改后才会生成新的文件名。基于此,我们就可以给代码文件设置缓存有效期一年 Cache-Control: max-age=31536000,这样只有当 HTML 文件中引入的文件名发生了改变才会去下载最新的代码文件,否则就一直使用缓存。
4.用户操作行为与缓存
| 用户操作 | Expires/cache-control | last-Modified/Etag |
|---|---|---|
| 地址栏回车 | 有效 | 有效 |
| 页面链接跳转 | 有效 | 有效 |
| 新开窗口 | 有效 | 有效 |
| 前进后退 | 有效 | 有效 |
| F5刷新 | 无效 | 有效 |
| Ctrl+F5强制刷新 | 无效 | 无效 |
主要有 3 种:
- 打开网页,地址栏输入地址: 查找 disk cache 中是否有匹配。如有则使用;如没有则发送网络请求。
- 普通刷新 (F5):因为 TAB 并没有关闭,因此 memory cache 是可用的,会被优先使用(如果匹配的话)。其次才是 disk cache。
- 强制刷新 (Ctrl + F5):浏览器不使用缓存,因此发送的请求头部均带有
Cache-control: no-cache(为了兼容,还带了Pragma: no-cache),服务器直接返回 200 和最新内容。
九、服务器优化
1.静态资源使用 CDN
用户与服务器的物理距离对响应时间也有影响。把内容部署在多个地理位置分散的服务器上能让用户更快地载入页面, CDN就是为了解决这一问题,在多个位置部署服务器,让用户离服务器更近,从而缩短请求时间。

2.添加Expires或者Cache-Control响应头
使用cach-control或expires这类强缓存时,缓存不过期的情况下,不向服务器发送请求。强缓存过期时,会使用last-modified或etag这类协商缓存,向服务器发送请求,如果资源没有变化,则服务器返回304响应,浏览器继续从本地缓存加载资源;如果资源更新了,则服务器将更新后的资源发送到浏览器,并返回200响应。
3.对组件使用Gzip压缩
在服务器端对文件进行紧缩,在浏览器端对文件解紧缩,可有用削减通讯传输的数据量。
在nginx上配置开启:
http {
    gzip on;
    gzip_static on;
    gzip_min_length 1k;
    gzip_buffers 8 16k;
    gzip_http_version 1.1;
    gzip_comp_level 6;
    gzip_types text/plain application/javascript application/x-javascript text/javascript text/css application/xml image/png image/gif image/jpeg image/ico image/jpg;
    gzip_vary on;
    gzip_proxied expired no-cache no-store private auth;
    gzip_disable "MSIE [1-6]\.";
    limit_conn_zone $binary_remote_addr zone=perip:10m;
    limit_conn_zone $server_name zone=perserver:10m;
}
在控制台查看到请求头有gzip配置成功,如下图

4.配置ETag
Entity tags(ETags)(实体标签)是web服务器和浏览器用于判断浏览器缓存中的内容和服务器中的原始内容是否匹配的一种机制(“实体”就是所说的“内 容”,包括图片、脚本、样式表等)。增加ETag为实体的验证提供了一个比使用“last-modified date(上次编辑时间)”更加灵活的机制。Etag是一个识别内容版本号的唯一字符串。唯一的格式限制就是它必须包含在双引号内。原始服务器通过含有 ETag文件头的响应指定页面内容的ETag。
HTTP/1.1 200 OK

Last-Modified: Tue, 12 Dec 2023 03:03:59 GMT

ETag: “10c24bc-4ab-457e1c1fd”

Content-Length: 1323
5.提供来自相同协议的文件
避免网站使用HTTPS同时使用HTTP来提供相同源地址的文件。
6.开启http2(多路复用,并行加载)
HTTP2带来了非常大的加载优化,所以在做优化上首先就想到了用HTTP2代替HTTP1。
优点:
- 解析速度快
- 多路复用
- 请求头压缩
- 服务器推送
在nginx上配置开启:
配置http2,首先要添加SSL证书,添加完证书后,在端口后面添加http2即可。
server {
        listen 80;
        #开启http2
        listen 443 ssl http2;
        server_name  code-nav.top;
        #配置证书
        ssl_certificate /www/nginx/cert/code-nav.top.pem;
        ssl_certificate_key  /www/nginx/cert/code-nav.top.key;
        ssl_session_timeout 5m;
        #请按照以下协议配置
        ssl_protocols TLSv1.2 TLSv1.3;
        #请按照以下套件配置,配置加密套件,写法遵循 openssl 标准。
        ssl_ciphers ECDHE-RSA-AES128-GCM-SHA256:HIGH:!aNULL:!MD5:!RC4:!DHE;
        ssl_prefer_server_ciphers on;
        location / {
            proxy_pass https://myblog;
            proxy_set_header Host $proxy_host;
        }

        access_log /www/wwwlogs/access.log;
    }
在控制台查看到http2配置成功,如下图

7.服务端渲染
服务端返回 HTML 文件,客户端只需解析 HTML。首屏渲染快,SEO 好。
缺点:
配置麻烦,增加了服务器的计算压力。
8.分域存放资源
由于浏览器同一域名并行下载数有限,利用多域名主机存放静态资源,增加并行下载数,缩短资源加载时间。
9.减少页面重定向
补充
性能测试网站推荐
1.WebPageTest
在线web性能测试工具(https://www.webpagetest.org), 提供多地点测试。他只能测试已经发布了的网站。输入需要测试的网页地址,点击start test按钮就开始测试了,可以选择测试地理位置,测试的浏览器等。

2.Web Page Analyzer
它是一种强大的速度测试工具,为您提供了详细现场分析以及如何改进的建议。它提供许多功能包括网页速度报告,全球报告,外部文件计算,加载时间,分析和建议等。
3.GT Matrix
GTmetrix可以帮助您开发更快,更高效的网站体验,能全方位改善网站体验。它对你的网站性能继续分级,并提供可行的建议,以解决发现的任何问题。
4.Pingdom
Pingdom的是一个非常棒的工具,它可以帮助用户通过生成大量报道,如页面大小,浏览器缓存,性能等级等等来确定网站的加载时间。它允许您从不同的位置跟踪历史表现和行为测试。可以设置每隔几分钟测试你的网站,每周发送邮件总结一周内你的网站平均加载时间,可以用来实时监控网站的响应性能。
5.36全球网站性能测试 (强烈推荐)

工具一开始是起飞页和虎翼商城的内部测试工具,专门用来测试网站的国外访问速度。虽然国内也不乏其它可以测试网站速度的工具,但他们都只能给出简单的CURL和WGET的时间,并没有详细的渲染时间和可交互时间,更没有SEO评测,可用性评测。大家茶余饭后没事的时候可以来测试一下网站速度,讨论提升网站速度的心得。
欢迎在评论区交流。如果文章对你有所帮助,❤️关注+点赞❤️鼓励一下!博主会持续更新。。。。
性能优化点实践参考:https://code-nav.top
往期回顾
vue3.x使用prerender-spa-plugin预渲染达到SEO优化
vue3.x使用prerender-spa-plugin预渲染达到SEO优化
vue3中使用prismjs或者highlight.js实现代码高亮
什么是 XSS 攻击?什么是 CSRF?什么是点击劫持?如何防御
2025开年,AI技术打得火热,正在改变前端人的职业命运:
阿里云核心业务全部接入Agent体系;
字节跳动30%前端岗位要求大模型开发能力;
腾讯、京东、百度开放招聘技术岗,80%与AI相关……
大模型正在重构技术开发范式,传统CRUD开发模式正在被AI原生应用取代!
最残忍的是,业务面临转型,领导要求用RAG优化知识库检索,你不会;带AI团队,微调大模型要准备多少数据,你不懂;想转型大模型应用开发工程师等相关岗,没项目实操经验……这不是技术焦虑,而是职业生存危机!
曾经React、Vue等热门的开发框架,已不再是就业的金钥匙。如果认为会调用API就是懂大模型、能进行二次开发,那就大错特错了。制造、医疗、金融等各行业都在加速AI应用落地,未来企业更看重能用AI大模型技术重构业务流的技术人。
如今技术圈降薪裁员频频爆发,传统岗位大批缩水,相反AI相关技术岗疯狂扩招,薪资逆势上涨150%,大厂老板们甚至开出70-100W年薪,挖掘AI大模型人才!
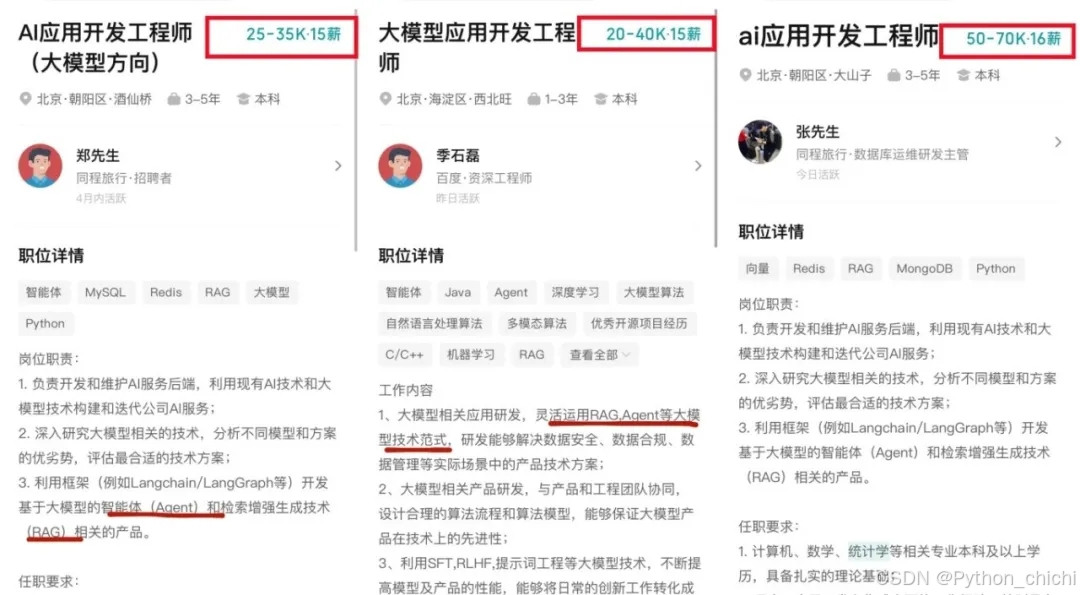
不出1年 “有AI项目开发经验”或将成为前端人投递简历的门槛。
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
大模型目前在人工智能领域可以说正处于一种“炙手可热”的状态,吸引了很多人的关注和兴趣,也有很多新人小白想要学习入门大模型,那么,如何入门大模型呢?
下面给大家分享一份2025最新版的大模型学习路线,帮助新人小白更系统、更快速的学习大模型!
2025最新版CSDN大礼包:《AGI大模型学习资源包》免费分享**
一、2025最新大模型学习路线
一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场
L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程
L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践
L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
二、大模型经典PDF书籍
书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程
对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战
学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题
面试不仅是技术的较量,更需要充分的准备。
在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取



 1640


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


