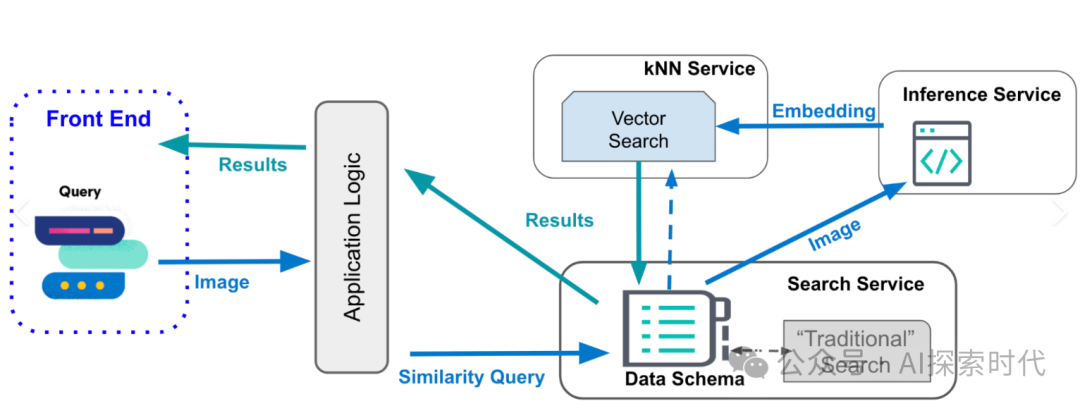
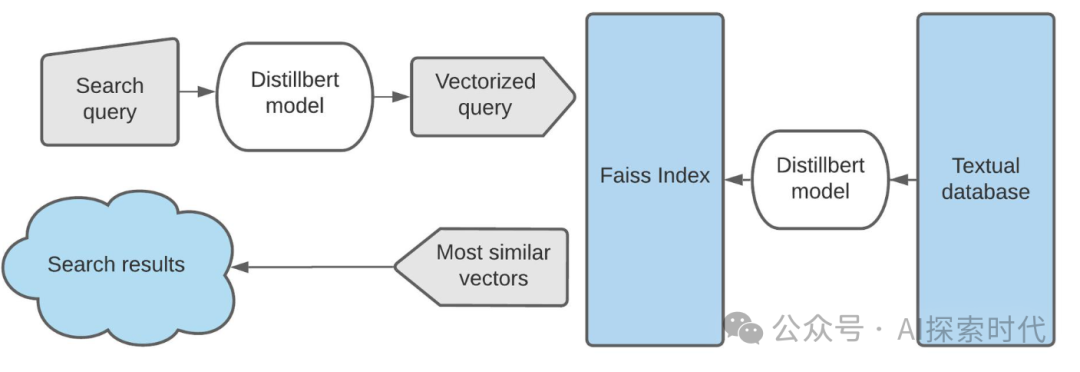
什么是相似性搜索?大模型的底座技术

万亿赛道!向量数据库--AI 大模型技术底座解决方案深度分析 2024 向量数据库作为新型技术,发展时间较短,开源和上云是目前的主流趋势。在向量数据库领域早期的探索,主要是以Zilliz、Weaviate和Pinecone等初创型公司引领。在AI大模型未被普遍应用之前,该产品的需求较少,因此,初创型公司开发的向量数据库产品多以开源的形式培育社区生态,以及上云的方式扩大用户覆盖面。随着向量数据库在AI大模型中应用的重要性逐渐被挖掘,各厂商加大了该领域的研发。 阅读详情

“ 语义分析是人工智能实现的基础,而语义分析实现的基础却是向量 ”

说到相似性搜索可能有些人听说过这个词,而有些人可能都没听过这个词;相似性搜索可能很多人都不清楚,但语义搜索应该很多人都听说过;在某种条件下,可以把相似性搜索等价于语义搜索;但相似性搜索又不完全等价于语义搜索。

今天,我们就来一起聊一下什么是相似性搜索,这个RAG技术中的大杀器,也是人工智能时代不可或缺的一个技术。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

相似性搜索

在传统的计算机技术中,绝大部分搜索都是通过字符匹配实现的;最常见的就是我们在搜索引擎中输入某个问题,然后会得到一些响应,这些响应中就包含你搜索的关键字;这个就是字符匹配。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

而如果是做过技术的人,一定知道什么是字符匹配了;最典型的就是SQL语句,根据某个字符串查询数据。‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍‍

但相似性搜索有一个很明显的缺点,那就是不能根据语义进行搜索;还拿四大名著来说,如果使用字符匹配的方式进行搜索。‍‍‍‍

比如说输入孙悟空,那么就只能搜索到与孙悟空三个字相关的内容;但孙猴子,齐天大圣这些和孙悟空有关的内容可能就搜索不到了。‍‍‍‍‍

而相似性搜索是什么样的? ‍‍‍

比如你搜索——一只和尚带着一只猴子,一头猪经历多重困难的故事;这时就应该能搜索到西游记;虽然里面没有提到任何和孙悟空,唐僧等有关的东西,但根据语义理解这就是四大名著之一的西游记。‍‍‍‍‍‍‍‍‍‍‍

这就是语义搜索。‍‍‍‍

显而易见语义搜索的好处是什么?‍‍‍‍‍

语义搜索能够让计算机更好的理解人类的语言和需求;它能够根据你的语义理解你想做什么;而不是你必须给出明确的指令,它才能明白你想做什么。‍‍‍

比如说,我忙了一天了脚不沾地,又饿又困累;这时人工智能就能明白你是想吃饭了;吃完饭之后需要洗个澡,然后好好的睡一觉。而不是说告诉它,我要吃饭,然后它让你去吃饭;我要洗澡,然后让你去洗澡;我要睡觉,然后让你去睡觉。

语义理解是自然语言的基础,也是实现人工智能必不可少的一环;因为语义理解是人类与机器打交道的通道。‍‍‍‍‍

所以,语义理解就是相似性搜索的一个重要应用;但为什么说相似性搜索和语义搜索又不完全一样呢?‍‍

原因在于,相似性搜索还可以应用到图像搜索,混合搜索,只能推荐等多种应用场景。‍‍‍‍

那怎么才能实现这个相似性搜索呢?

要想实现相似性搜索,那么就不得不提的一个东西,那就是——向量。‍

向量由于其强大的功能特性,广泛应用于人工智能的各种场景中;而相似性搜索作为人工智能领域的重要环节,向量就成了其必不可少的一项工具。‍‍‍

在之前的互联网行业中,大部分都是结构化的数据,比如关系型数据库;但随着互联网技术的发展,非结构化数据变得越来越多,比如图像,音视频,图文混合等等多种类型的数据格式。‍‍‍‍‍‍

这时,不同格式的数据处理起来就成为一件很麻烦的事;更重要的是这些数据虽然是非格式化的,但并不代表着这些数据是没有关系的数据。‍

因此,具体怎么处理这些不同类型的数据,就成为了一个难点;后来发现向量特别适合于这种场景,技术人员只需要把文本等数据转化为向量表示的数据即可。‍‍‍‍‍‍‍‍

而后,计算机就可以根据不同向量之间的关系,如距离,长度,方向等去计算不同格式数据之间的相关性。‍‍‍

而现在实现的相似性搜索,主要就是通过欧式距离和余弦相似度等算法来计算不同向量之间的关系,最后实现语义搜索。‍‍‍‍‍‍‍‍‍

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

通用性技术底座AI大模型与各行业专用性AI小模型搭建(第二篇) 在选择行业专用AI小模型的架构时,需要考虑以下几个关键因素:1. **任务类型**:- 不同的任务类型(如分类、回归、序列生成、图像识别等)对应着不同的模型结构。例如,文本分类问题可能选用简单的卷积神经网络(CNN)或循环神经网络(RNN),而自然语言理解任务则可能会使用预训练的BERT、RoBERTa等Transformer模型。2. **数据特性**:- 数据的特征和结构也会影响模型的选择。例如,对于时间序列数据,可以选择长短时记忆网络(LSTM)或者门控循环单元(GRU)。 阅读详情

相关推荐

构建推荐系统的相似检索技术:从距离度量到深度学习的快速了解

相似检索方法是一种用于从大量数据中找到与查询数据相似的数据项的技术。这种方法通常用于信息检索、推荐系统、图像处理、自然语言处理等领域。相似检索主要方法可以总体分为以下几类:这些方法各自有其适用的场景和特点,选择合适的相似检索方法取决于应用的需求、数据类型和性能要求。通常,研究和实践中会根据具体情况采用不同的方法或它们的组合来解决相似检索问题。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 11万+

python 实现similarity search相似性搜索算法

相似性搜索(Similarity Search)算法是信息检索、数据挖掘、多媒体处理等领域中常用的一类算法,目的是在大量数据中找到与给定查询项最相似的对象或数据项。这些算法广泛应用于图像检索、推荐系统、文本检索、生物信息学等领域。基于哈希的相似性搜索:局部敏感哈希(LSH, Locality-Sensitive Hashing):LSH 是一种通过哈希技术来减少搜索空间的方法,它设计哈希函数使得相似的数据项以较高的概率被哈希到相同的桶(bucket)中,而不相似的数据项则几乎不可能被哈希到相同的桶中。

luthane的博客 1734

理解相似性搜索(也称为语义搜索)的指南

人工智能最新阶段的关键发现之一是能够基于相似性搜索来搜索和查找文档。相似性搜索是一种根据信息的含义而不是通过关键字来比较信息的方法。

gongdiwudu的专栏 3610

Elasticsearch:理解人工智能相似性搜索

我认为,知识检索和相似性搜索是企业成功实施人工智能的切入点。过去,关键词搜索对所有网站来说几乎是必须的,但我们很快会看到,知识检索将成为最基本的标准。当我尝试使用没有知识搜索功能的 API 文档时,我已经感到非常沮丧。我期待看到你利用知识检索和相似性搜索提出的新颖而惊人的想法。更多关于向量搜索的知识,请详细阅读专栏 “AI。

Elastic 中国社区官方博客 2531

《向量数据库指南》——腾讯云全面升级向量数据库 BAT集体加注AI大模型底座技术

在腾讯云数据库副总经理罗云看来,在AGI时代,需要更智能化的数据调度范式,向量数据库就是数据平台的中枢。目前,通用大模型的关注度正被垂类大模型逐渐夺去,向量数据库的价值与众多企业默默耕耘的行业大模型契合。为了更好理解行业语义,执行专业性更强任务,行业大模型会进一步对垂直细分场景数据进行针对性的训练和调优,这才是向量数据库发挥价值真正找到用武之地。随着智能化数据平台需求增多,将吸引越来越多向量数据库加入竞逐。AI大模型“百花齐放”之际,被看作是大模型的重要底座的向量数据库也得到了前所未有的关注。

实战AI智能体 308

无刷直流电机矢量控制(四):基于滑模观测器的无传感器控制

无刷直流电机矢量控制,采用转速、电流双环控制,电流环dq解耦,d轴采用id=0控制,q轴采用转速外环。采用滑模观测器(SMO),根据电压电流信息进行电机位置角度动态估算,模型可直接运行,转速和角度跟踪精度较高。 本文整理了该方法的基本原理,介绍了在MATLAB/Simulink中的建模和仿真过程,最后附上完整的模型文件。 一、基本原理 滑模观测器(下文简称SMO)是基于滑模变结构控制方法的一种状态观测器。其针对无刷直流电机转子位置估算的实现过程如下。 假设采用矢量控...

Forster-C的博客 6858

五种视觉嵌入模型在相似性搜索中的实战对比

视觉嵌入是图像检索、以图搜图和内容去重等任务的核心基础,其本质是将图像映射到可度量的语义向量空间。不同训练范式(如监督分类、自监督学习、多模态对齐、混合架构)导致嵌入向量在语义粒度、鲁棒性与场景理解能力上存在根本差异。EfficientNet依赖标注数据,适合结构化商品图;ViT通过全局注意力增强构图感知;DINO-v2凭借自监督机制获得强光照/形变鲁棒性;CLIP引入语言先验,提升零样本泛化;BLIP-2则通过Q-Former实现细粒度叙事理解。实际应用中,嵌入质量直接决定Faiss近邻搜索的业务效果——

weixin_30530939的博客 393

保姆级教程:在Win10/Win11上搞定AppScan 10.0.0安装与许可证激活(含常见报错解决)

本文提供AppScan 10.0.0在Win10/Win11上的详细安装与许可证激活指南,涵盖环境准备、分步安装、文件替换技巧及常见报错解决方案。通过专业的安全测试工具部署实践,帮助用户高效完成安装并避免常见陷阱,提升Web应用安全扫描效率。

weixin_30800987的博客 421

简墨的进化之路:打造大模型数据计算系统的云存储底座

最底层的是简墨的存储访问抽象层,简墨利用抽象 API 与任何类型的存储进行交互,包括云对象存储(例如 S3)、HDFS 等。通过这种方式,简墨确保了所有存储引擎的兼容性。此外,简墨对文件系统进行了包装,以进一步优化存储功能,例如提供监控和各种读写策略等。简墨会在这一层支持多种文件格式,并具备统一的访问接口来简化对数据的访问操作,从而让用户的数据可自由的选择不同的文件格式来存储,用户数据。

OpenPie的博客 1266

ITIL 4 Foundation 自学通关笔记1

ITIL 4 Foundation 自学通关笔记

m0_58817196的博客 936

架构决策之消息中间件MQ系列六-Pulsar

一、架构

恰恰虎的博客 7246

企业级AI搜索解决方案:阿里云AI搜索开放平台

随着信息技术的飞速发展,搜索引擎作为信息获取的重要工具,扮演着不可或缺的角色。阿里云 AI 搜索开放平台以其强大的技术支持和灵活的开放性,持续为用户提供高效的搜索解决方案。

科技很有意思 1615

基于QT与STM32的电力参数采集系统(华为云IOT)(211)

本项目构建一款集多功能于一体的电力参数采集系统,该系统以高性能、低功耗的STM32F103RCT6微控制器为核心,集成多种传感器与通信模块,实现对电力设施如电压、电流、功率、电能及环境温度等关键参数的实时精确采集,并通过GPS模块获取设备地理位置信息,满足了电力设备状态全面监控的需求。

2893

大模型知识库——检索增强(RAG)技术与向量数据库的选择_rag 向量数据库 对比

RAG技术的关键在于结合了检索与生成的优点,检索系统能提供具体相关的事实和数据;而生成模型能够灵活的构建回答,并融入更广泛的语境和信息。 这种结合使得 RAG 模型在处理复杂的查询和生成信息丰富的回答方面非常有效,在问答系统、对话系统和其他需要理解和生成自然语言的应用中非常有用。

2401_85373396的博客 369

【Bug已解决】Codex App returns 401 Missing bearer/basic authentication after login on multiple Windows la

原始报错:Codex App returns 401 Missing bearer/basic authentication after login on multiple Windows laptops场景:用户在 Windows 笔记本上登录应用成功了,但随后每个业务请求都返回 401,提示"Missing bearer/basic authentication"。登录态像是"假的"——明明登了,请求却没带任何认证信息。多台 Windows 设备都能复现。

一键难忘的博客 573

【Bug已解决】[Bug]: ValueError: No user query found in messages QWEN 3.5 27B VLLM 0.16.0 NIGHTLY 解决方案

用 vLLM 0.16.0 nightly 给发聊天请求时,服务端在处理消息时抛ValueError,请求失败。

博客 379

基于大模型 + 知识库的 Code Review 实践

一句话介绍就是:基于开源大模型 + 知识库的 Code Review 实践,类似一个代码评审助手(CR Copilot)。飞书文档没有格式要求,能看懂正确代码是怎样就行这里直接使用 LangChain 提供的LarkSuitechunk_size: 控制每个块的长度。例如设置为 1024,则每个块包含 1024 个字符。: 控制相邻两个块之间的重叠长度。例如设置为 128,则每个块会与相邻块重叠 128 个字符。

ytt0523_com的博客 4357

uniapp - 超详细 H5 网页引入百度地图教程,附地图示例 / 获取当前设备定位的省市区、详细地址、经纬度信息 / 用户当前 IP 属地定位地理位置等等(新手小白快速上手,详细配置及使用全流程)

uniapp百度地图,uniapp百度地图ip属地定位,uniapp百度地图获取省市区详细地址经纬度等,uniapp百度地图当前用户设备定位省份市区详细所在地ip属地等详细教程示例,uniapp网页h5引入百度地图详细教程,uniapp h5网站使用百度地图详细教程,uniappH5端如何接入使用百度地图api,uniapp H5网页端百度地图获取地理位置信息,uniapp h5页面引入百度地图,uniapp h5平台百度地图获取城市信息,uniapp百度地图获取经纬度,uniapp 百度地图拿省市区用什么

🏆 前端领域优质创作者 6203

10分钟搞懂向量数据库:AI时代的新型搜索引擎

想象你在使用 ChatGPT 处理工作文档。你上传了一份 200 页的公司手册,然后问"我们的年假政策是什么?"AI 瞬间就能找到相关段落并回答你。这背后不是把整个手册都塞进 AI 的"大脑",而是用了一种特殊的数据库——**向量数据库**。它能理解你问题的"意思",然后在海量信息中找到语义最相关的内容。

DrLai的博客 573

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

解读阿里云搜索开发工作台如何快速搭建AI语义搜索及RAG链路

本文介绍阿里云搜索开发工作台如何通过内置数据处理、查询分析、排序、效果测评、大模型等服务,结合阿里云搜索引擎及开源引擎,灵活打造AI语义搜索及RAG链路。

科技很有意思 1434

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

FAISS从入门到实战:构建亿级向量相似性检索系统

相似性搜索是大模型时代的基础技术,广泛应用于推荐召回、图片去重、知识库问答等场景。当向量规模达到百万级以上,暴力计算已无法满足实时检索的要求。FAISS作为业界成熟的相似性搜索算法库,通过倒排索引、乘积量化与图索引等机制,在查询速度、内存占用与召回精度之间提供了灵活调节能力。本文从Embedding向量基础出发,介绍L2距离与内积度量的选择,详解IVF、PQ、HNSW等核心索引原理,并给出从精确基准到近似检索的完整代码实现与调参经验,帮助开发者从零搭建高效、可扩展的语义搜索与向量召回服务。

weixin_29056101的博客 276
上一篇: 李开复:在AI2.0 时代,拥抱 AI 的公司才会胜出,明年是AI应用爆发的元年
下一篇: OpenAI提供大模型的提示缓存(Prompt Caching):GPT-4o系列模型输入价格下降一半,访问速度提升80%
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2812原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值