Runway Gen-4.5刷屏发布,把重量、尘土和光影都做对了,网友:颠覆

西风 鹭羽 发自 凹非寺
量子位 | 公众号 QbitAI

“视频生成AGI时刻”,这是Runway Gen-4.5突袭发布后获得的评价。

趁着ChatGPT发布三周年,AI圈开始过年啦(doge)。

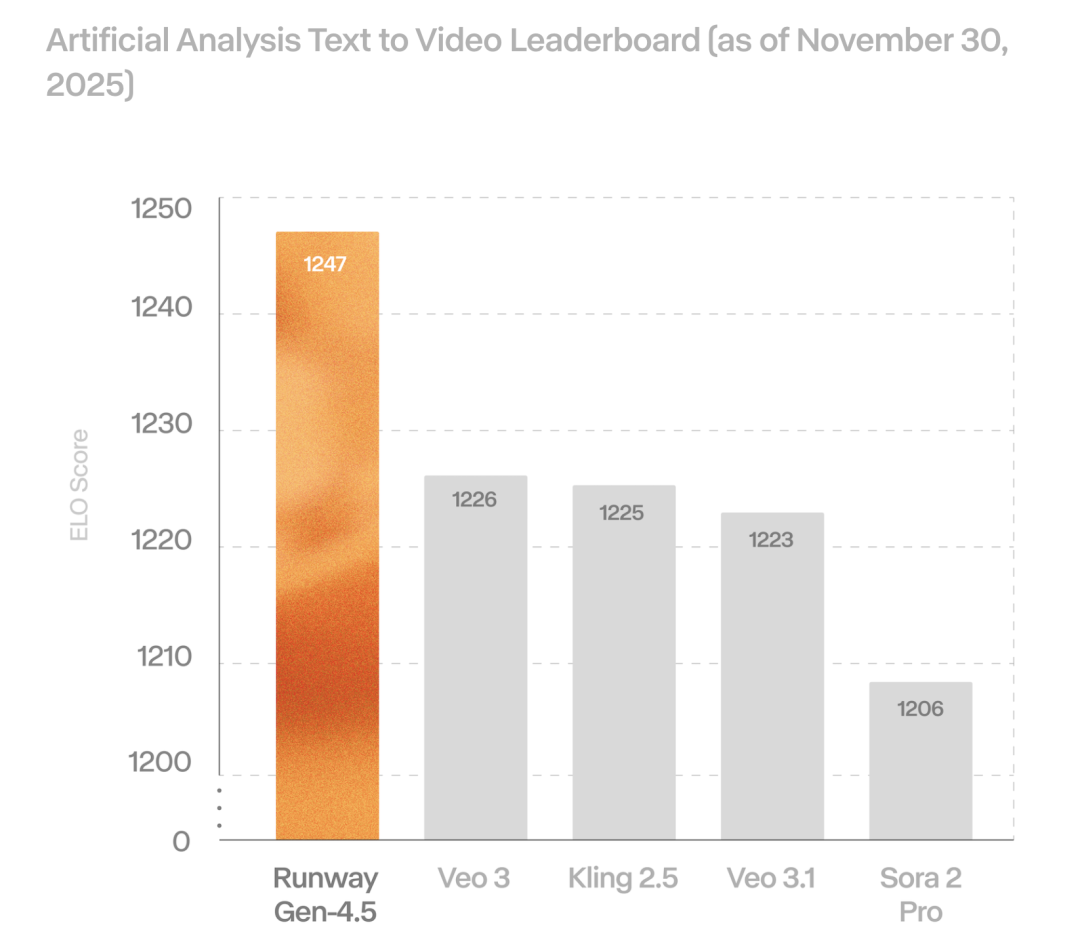
最新发布的Runway Gen-4.5以1247 Elo评分——在Artificial Analysis文本转视频基准测试中拿下SOTA,超越所有现有模型。
直接来看效果。

运镜、视角切换很丝滑,文字也能很好地生成:
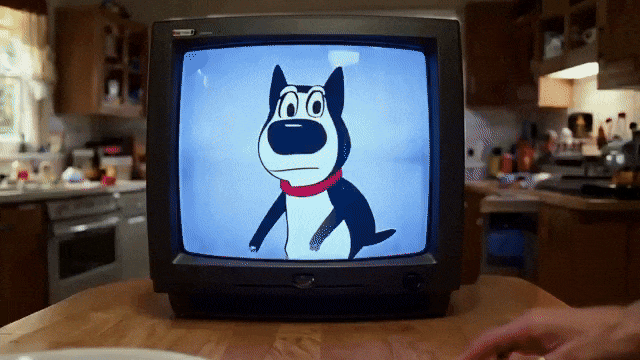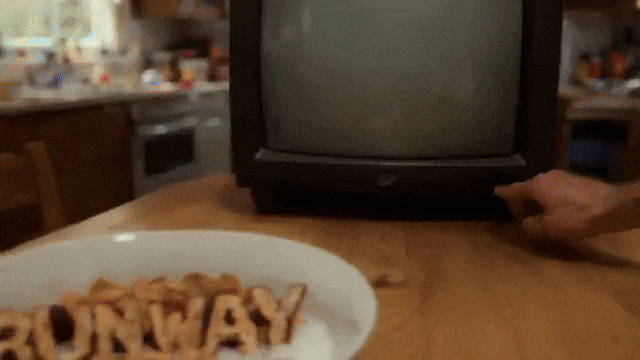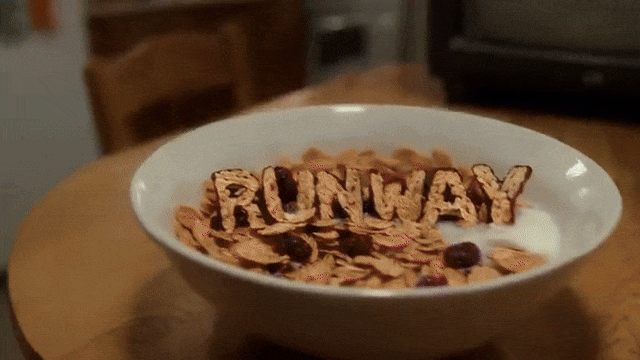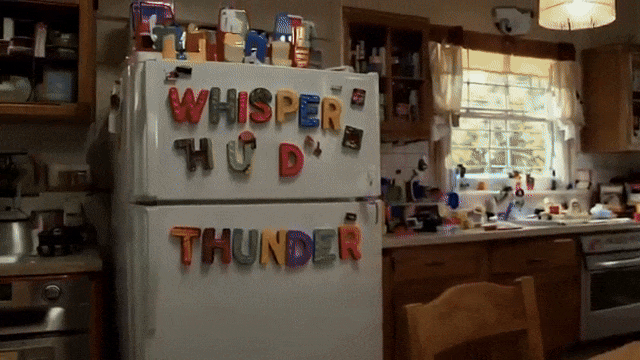
人照镜子这种复杂场景,几乎看不出破绽:
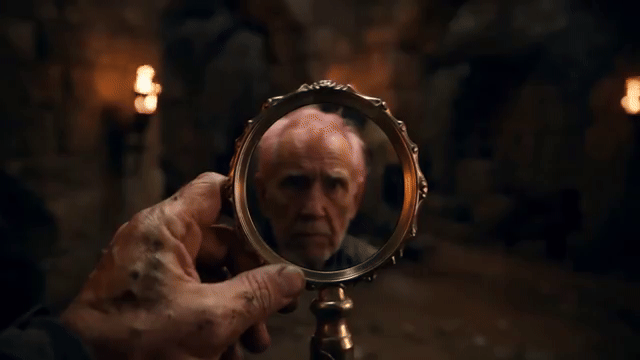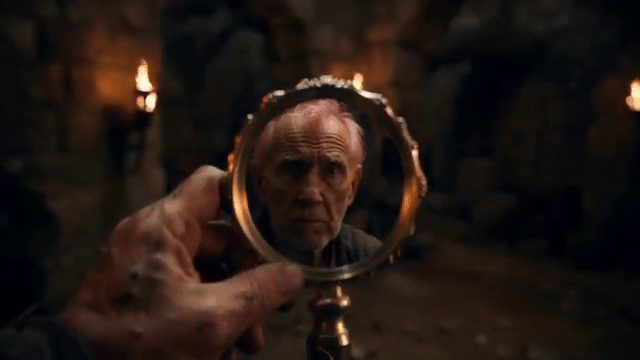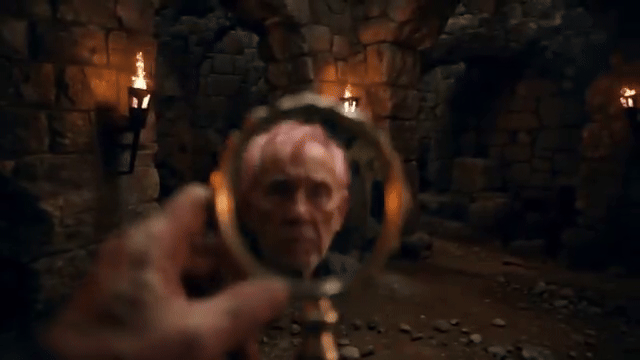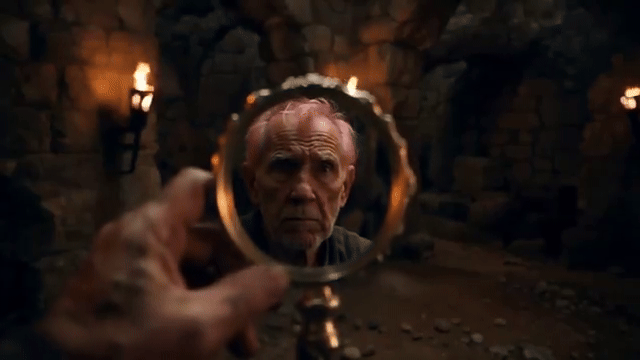
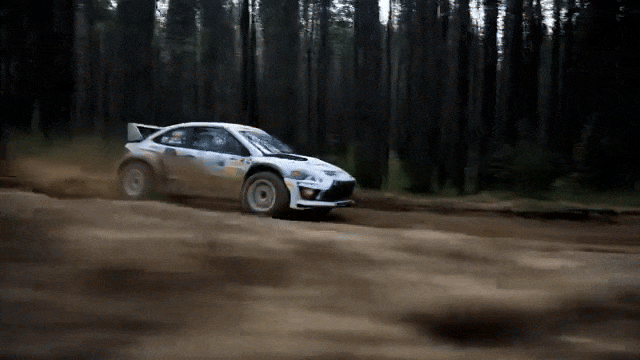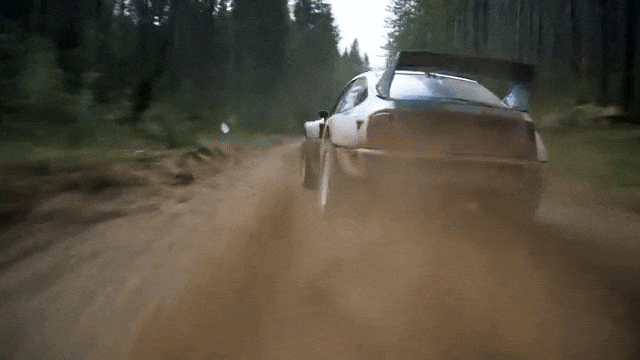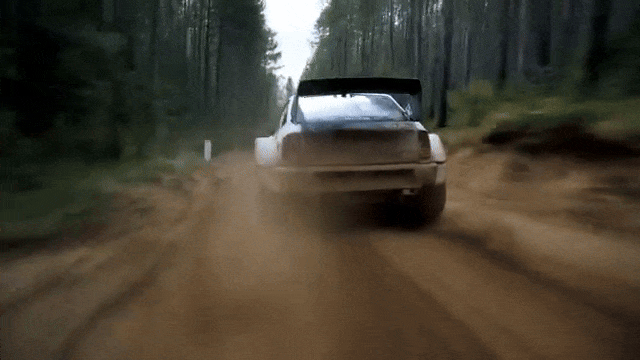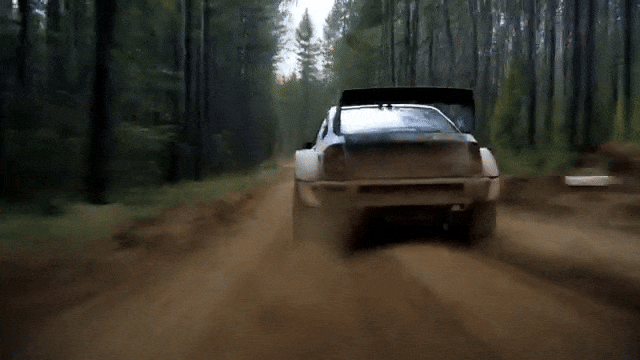
汽车疾驰尘土飞扬,还有很真实的颠簸感:
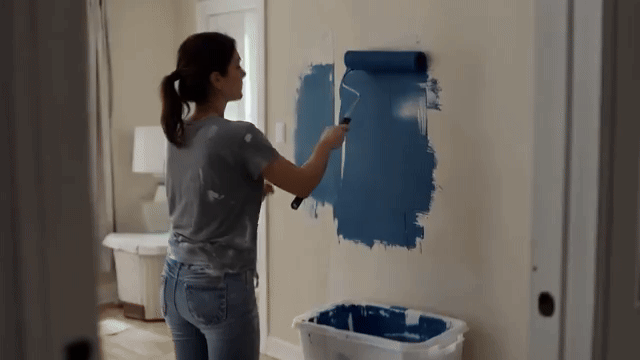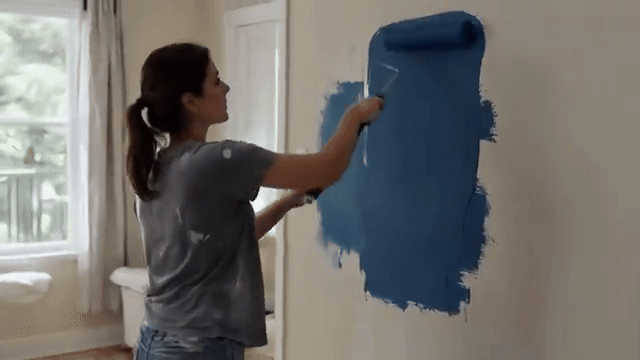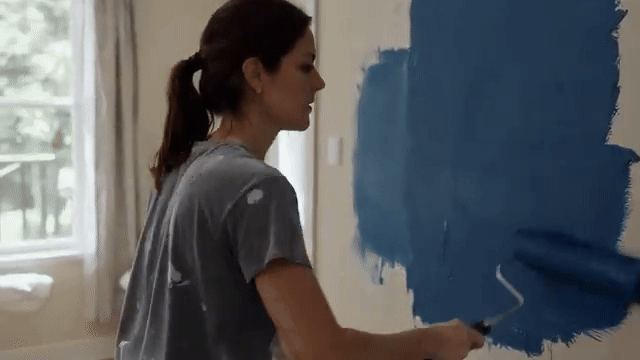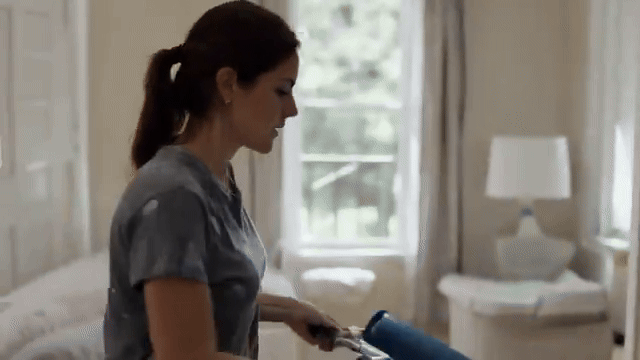
下面这个刷墙视频也能看到很多细节,已经刷过的地方颜料干了,颜色会稍微浅一点:
纵观Gen 1到Gen4.5两年迭代,质感全面蜕变:

网友们纷纷评价道:“颠覆者”。
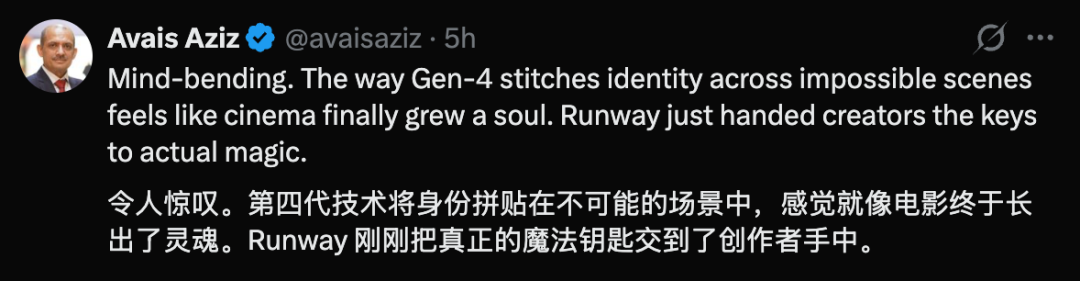
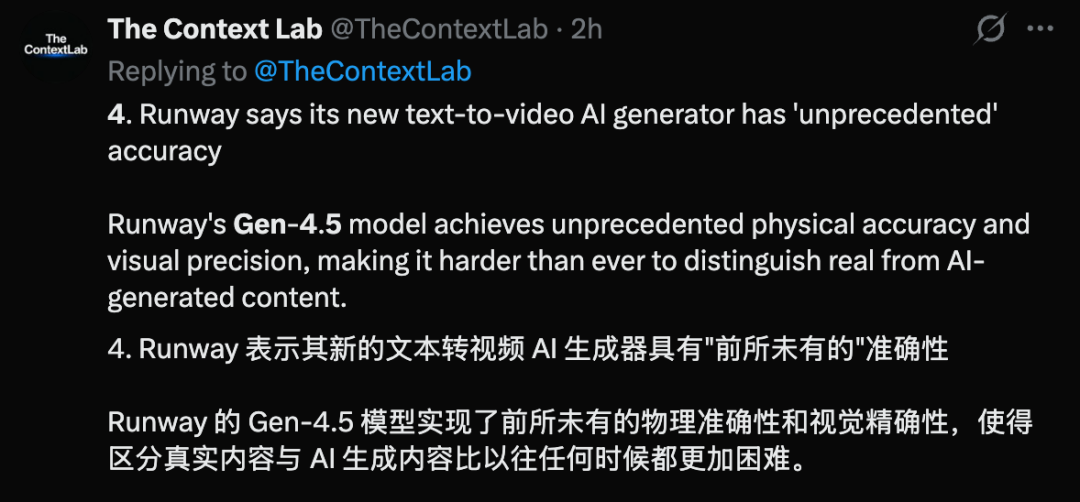
尤其是其前所未有的物理和视觉准确性,不只是更美观,这下真实内容与AI生成内容更难以区分了。
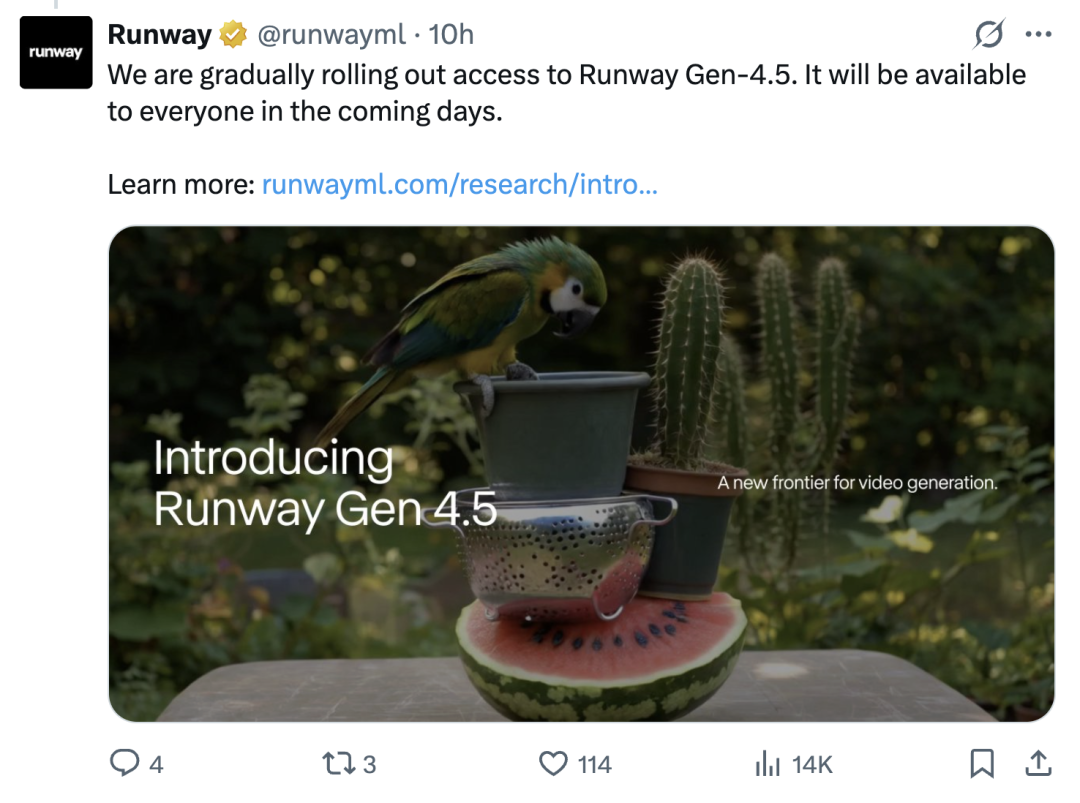
官方表示正在逐步开放Runway Gen-4.5的使用权限,未来几天内所有用户都能体验到。

并且“加量不加价”,会以和当前订阅套餐相近的价格全面开放。
超强物理还原度与视觉精准度

下面来看官方介绍。

首先,Gen-4.5主打擅长理解并执行复杂的序列式指令。

换句话说,你可在单个提示词中精准指定详细的镜头运镜方式、复杂的场景构图、事件的精确时间节点,以及细微的氛围变化。
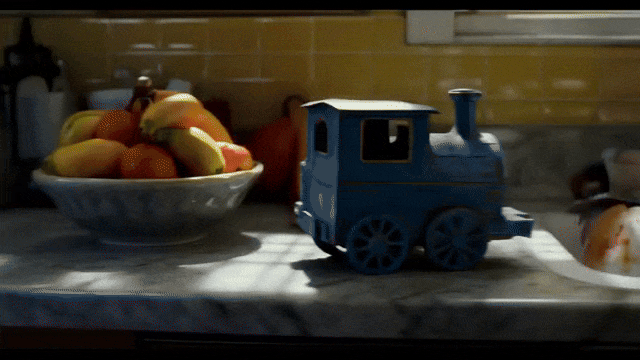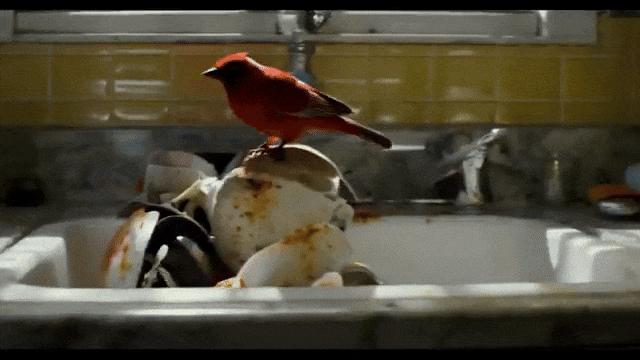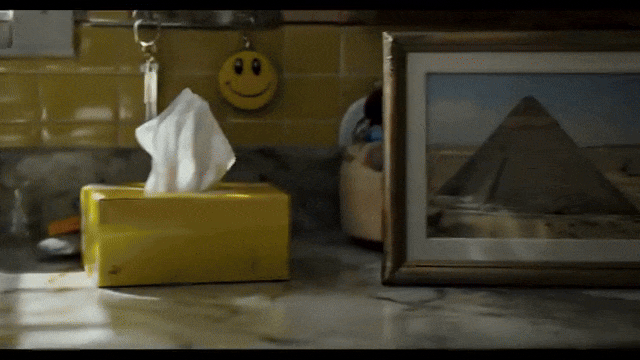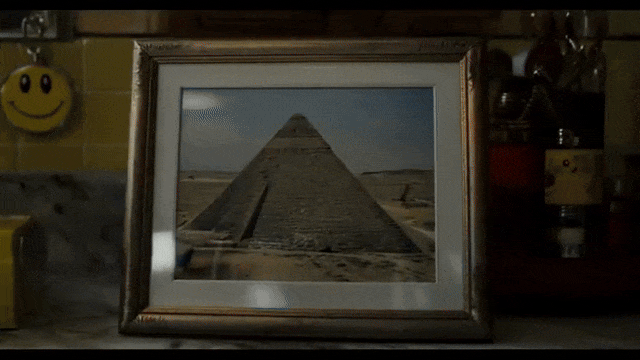
Gen-4.5既保留了Gen-4在速度和效率上的核心优势,又实现了画质层面的突破性提升。
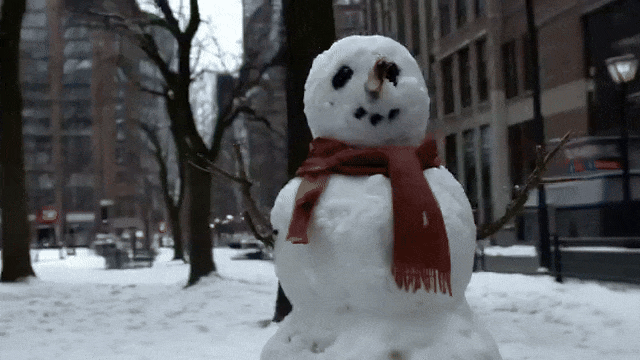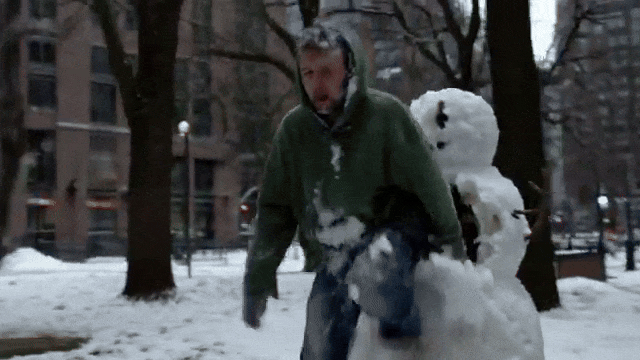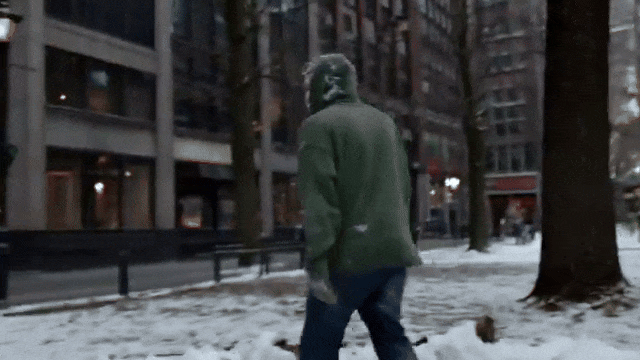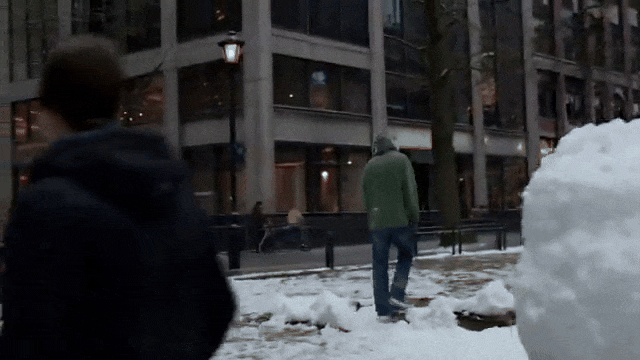
对比Gen-2,运行相同的提示be like:
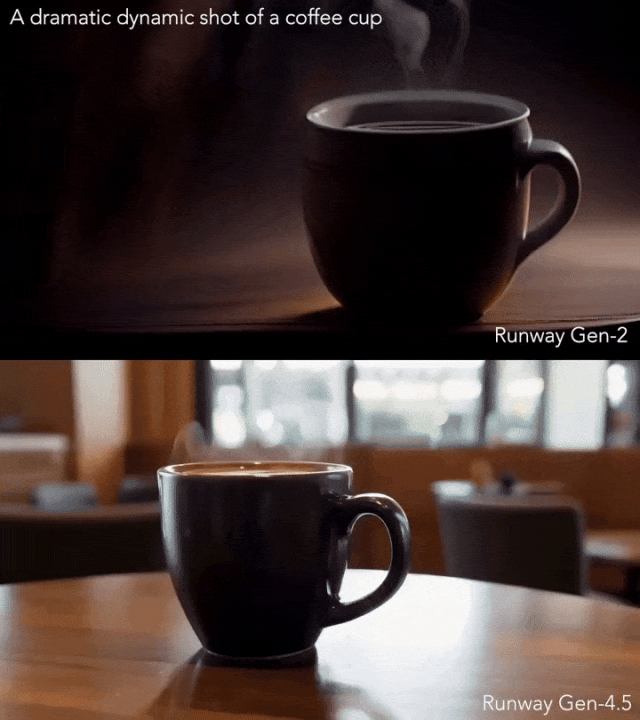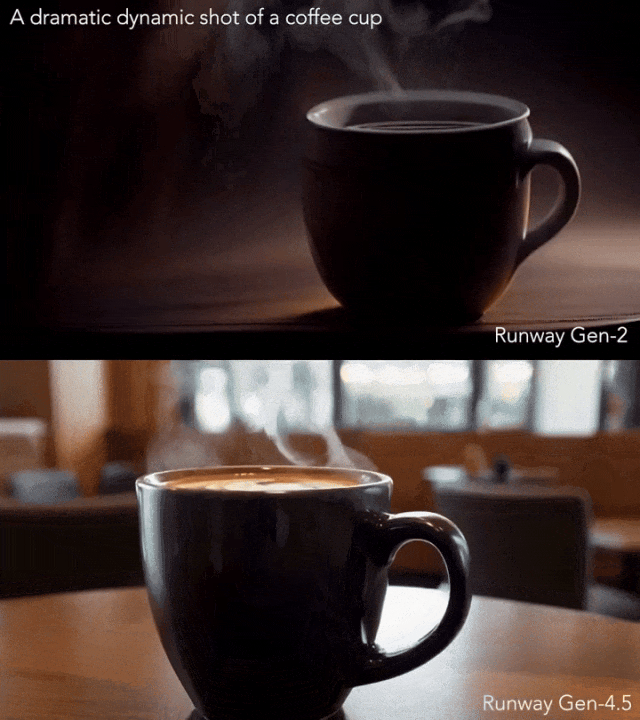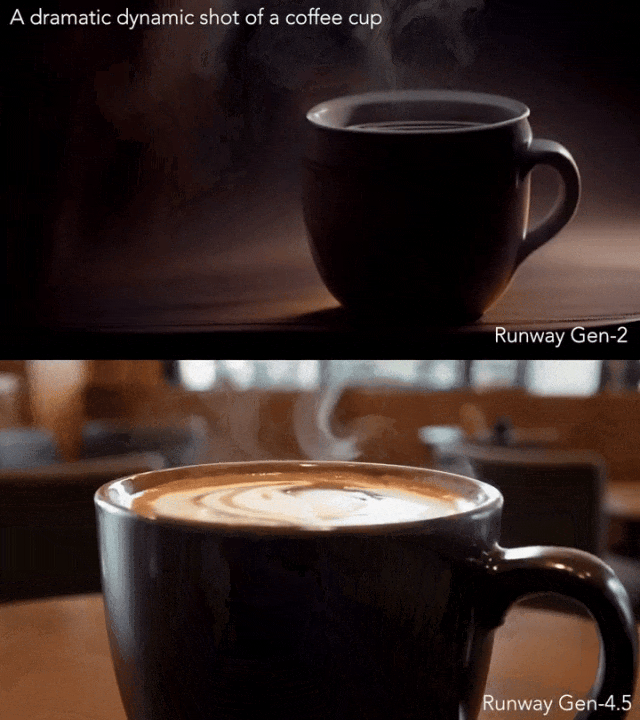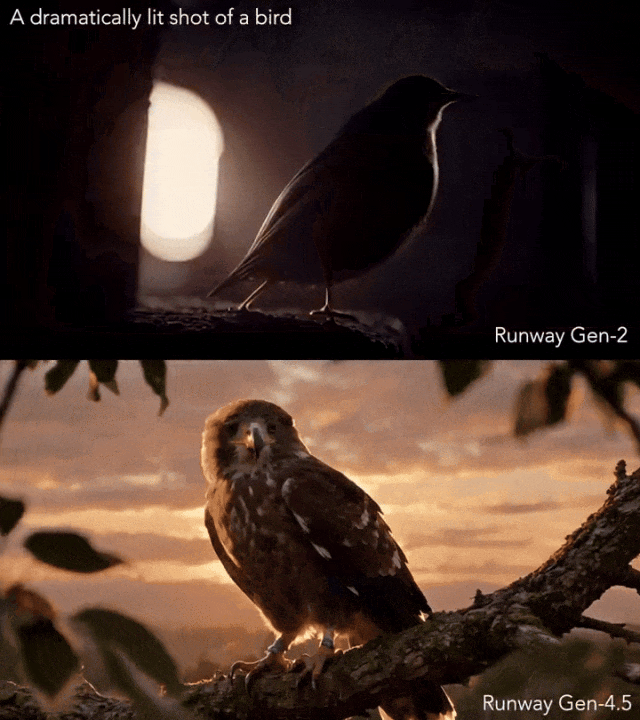
其次,物理还原度与视觉精准度也是一大核心卖点。

其生成的视频物体移动具备符合现实的重量感与动量特征,物体表面呈现出与现实世界一致的物理特性。
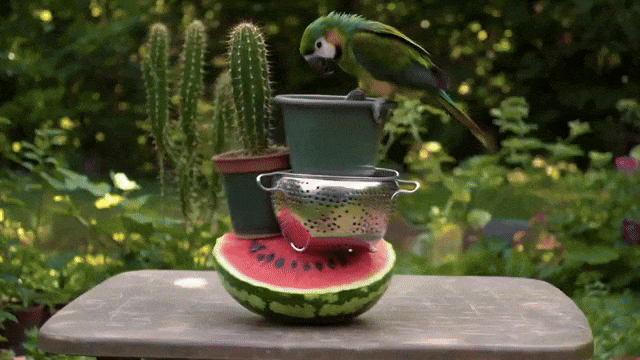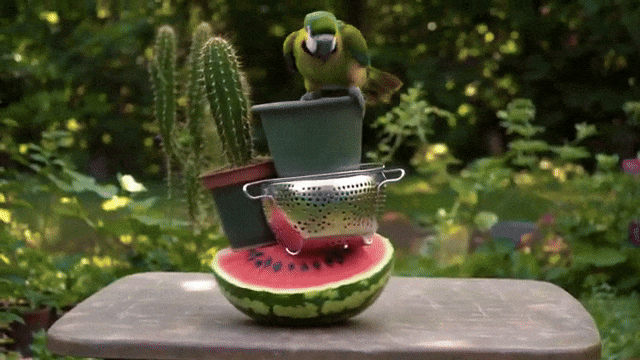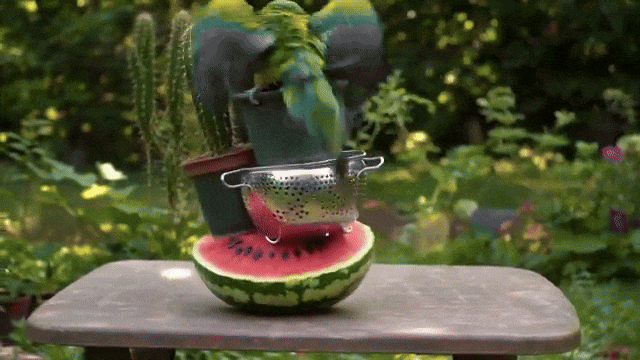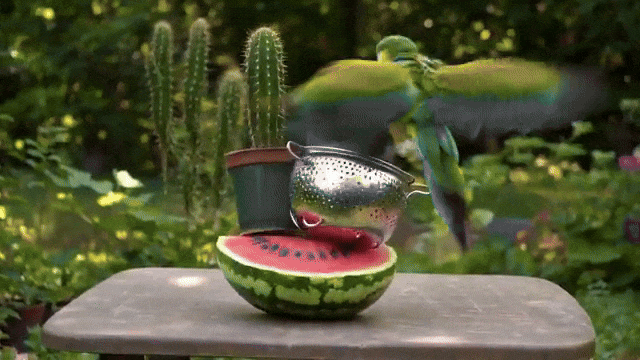
街头滑滑板效果很逼真:
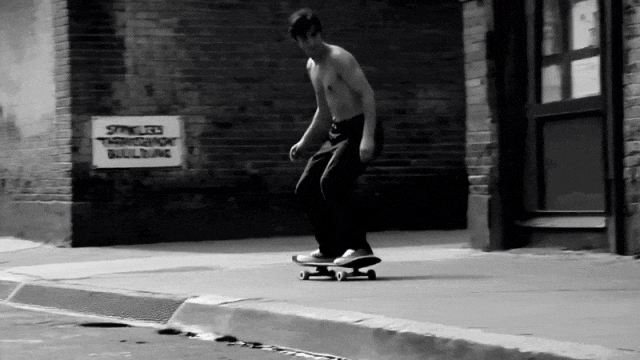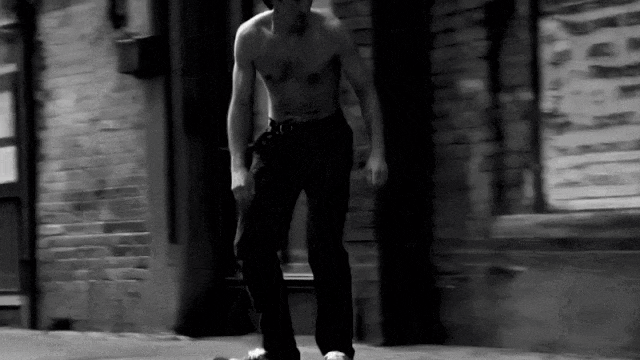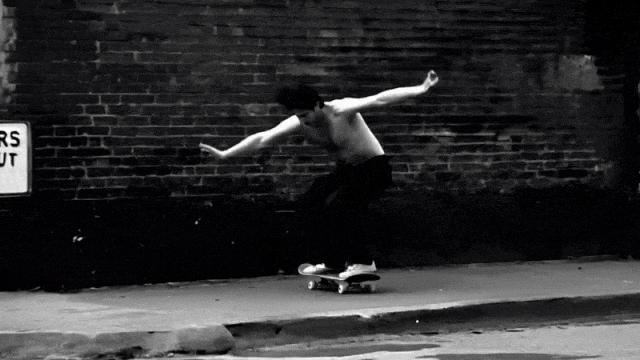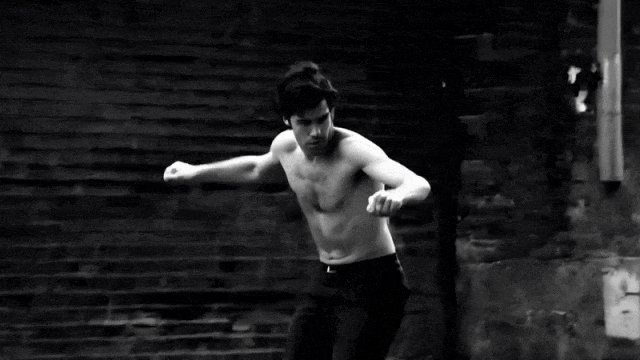
速度提升,背景模糊处理也很有质感:
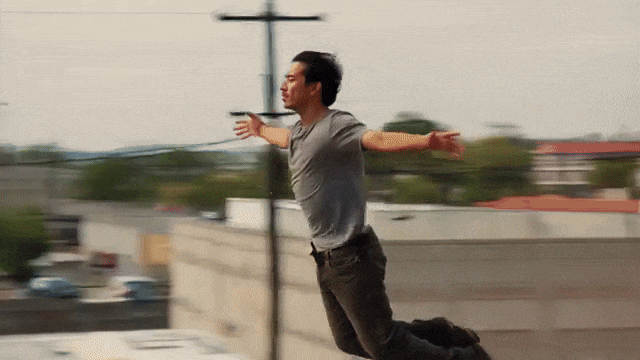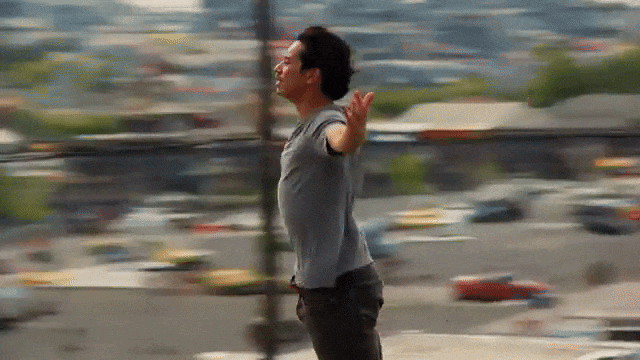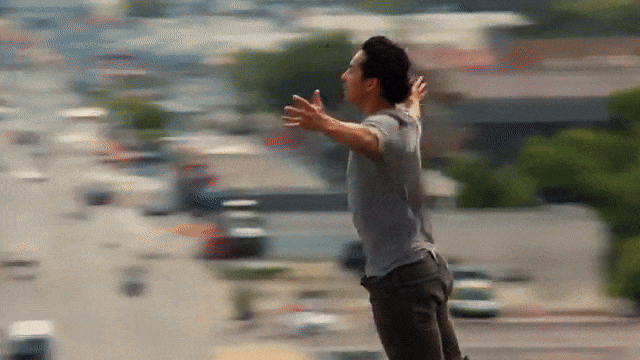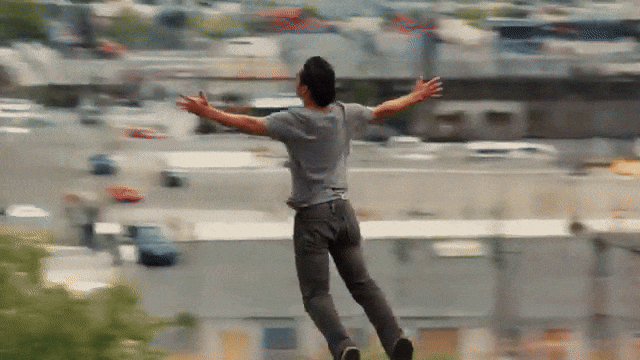
当然,遵循还是突破物理定律,全靠你的创作构想。

你也可以让小羊拉北极熊(doge):
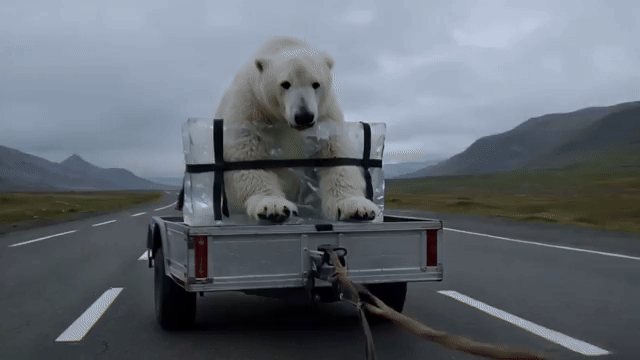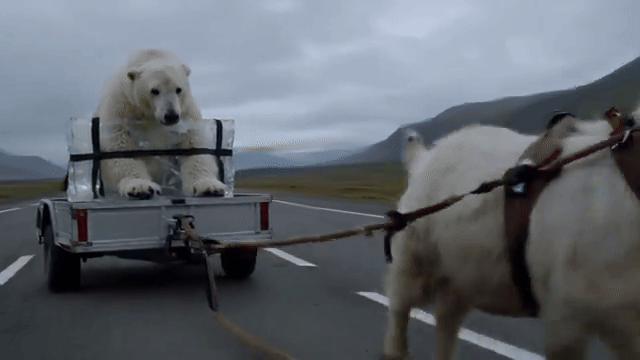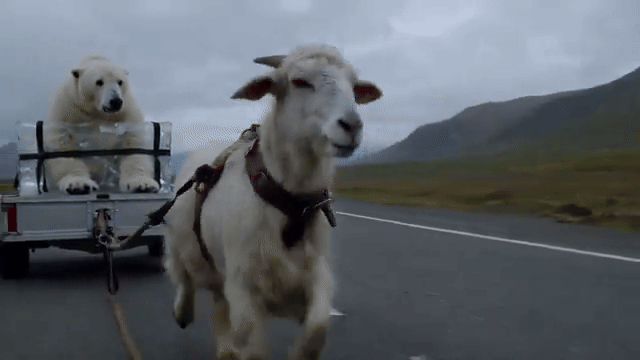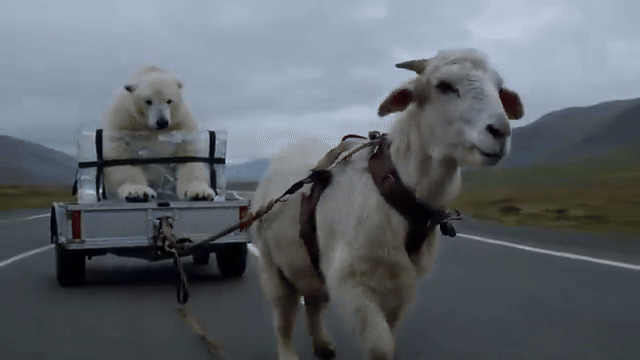
各种风格都能驾驭:
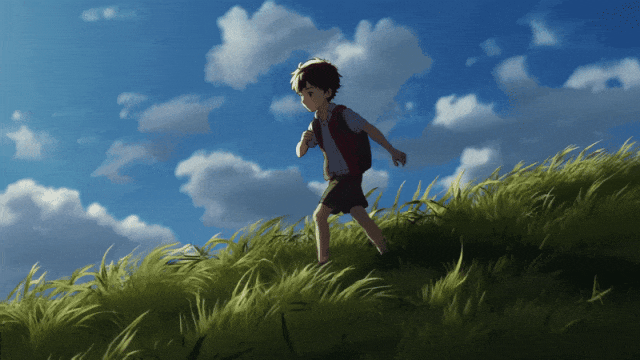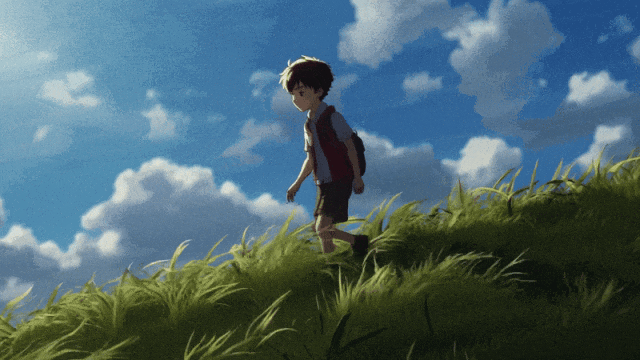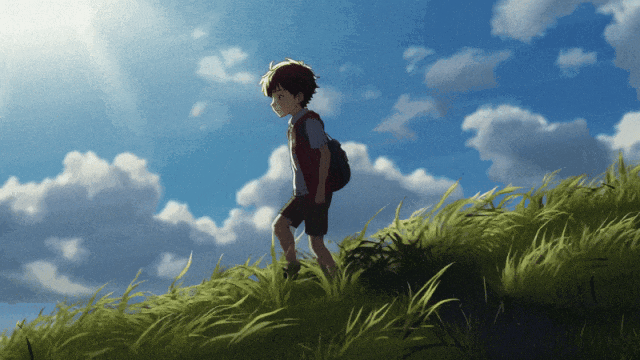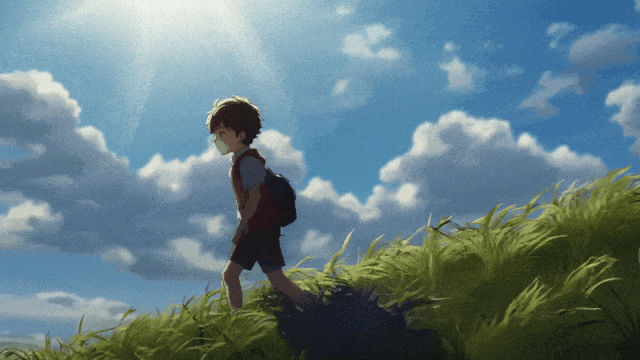
3D绘画风格也可以:
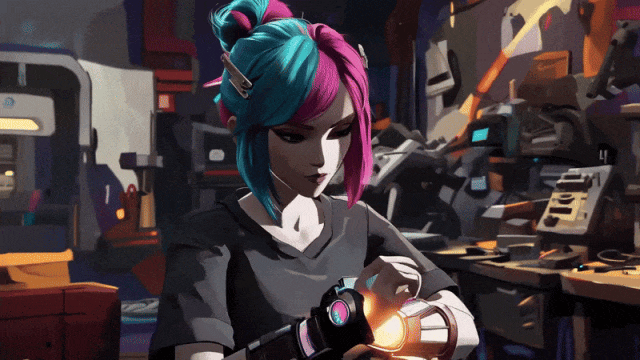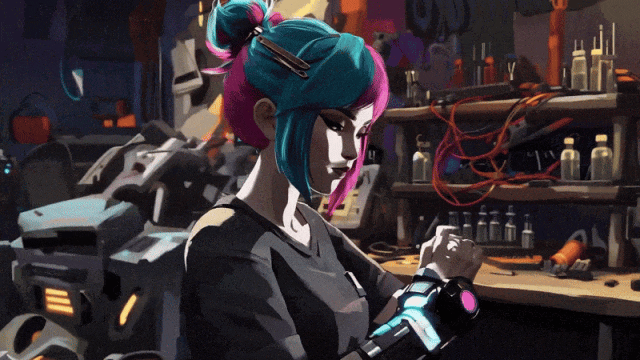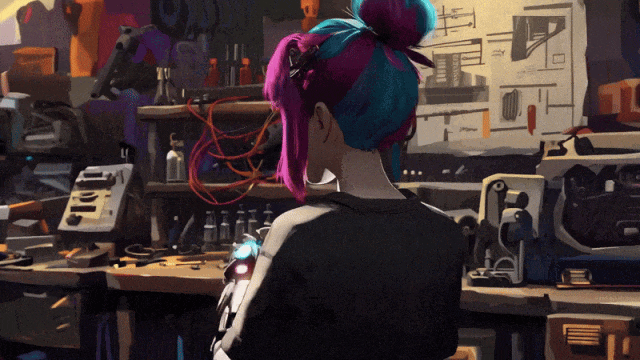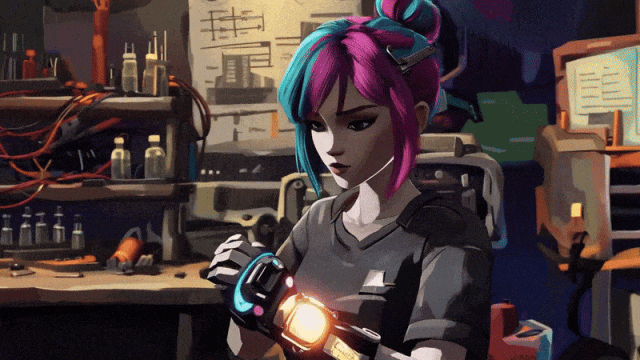
在网友们都关心的可控性方面,官方表示除了文本生成视频,会为Gen-4.5适配所有已有的控制模式,比如图片转视频、关键帧生成、视频转视频等。

值得一提的是,官方还毫不避讳模型局限性:

尽管该模型的能力实现了质的飞跃,但仍存在一些局限性,例如因果推理与物体恒存性(即理解“物体即使看不见也依然存在”的认知能力)方面表现不足。

好消息是,目前团队正在进行相关优化了。

最后再来看两个长视频展示~

一键三连「点赞」「转发」「小心心」

欢迎在评论区留下你的想法!

— 完 —

🔊 不到2周,量子位MEET2026智能未来大会就要来了!

‍张亚勤、孙茂松等AI行业重磅嘉宾,以及百度、高通、亚马逊等头部AI企业已确认出席,RockAI、太初元碁、自变量、小宿科技等业内新秀也将参与分享,还有更多嘉宾即将揭晓 👉 了解详情

‍    📍 12月10日

    📍 北京金茂万丽酒店

一键报名线下参会,期待与你共论AI行业破局之道 
🌟 点亮星标 🌟

相关推荐

DeepSeek V4芯模协同背后,国产算力生态开始飞轮加速

更关键的是,CANN开始逐步兼容主流AI生态。开发者每一次正向反馈、每一个优化结果、每一个创新应用,都能通过昇腾和华为的生态快速走向产业界,形成技术、商业、生态的完整闭环。之前,昇腾与不少模型进行过协同探索,但V4是第一次在大规模、高强度、工程化的尺度上,验证了这种“芯模协同”的可行性与效率。开源以后,我们能更充分地学习业界的优秀实践,在此基础上进行适配和优化,也能将一些好的经验应用到自己的项目中。可以说,从“能跑”到“有人长期建设”,从“厂商推动”到“生态自增长”,华为算力生态,正在进入新的阶段——

量子位 512

世界模型接棒语言模型,这家公司全球首创物理AGI“双金字塔”体系,通用机器人进入“家庭时代”

毕竟在现阶段,家庭场景对机器人的真实刚需,是稳当地端水、收拾餐具、抱起脏衣篮、把零食递到孩子手上,而不是在客厅里完成酷炫的跑酷动作。可以说,这支团队完整经历了CV、自动驾驶、具身基模、世界模型等物理AI过去十年的发展历程,并在每个阶段都做出了行业领先的世界级成果。该模型实现了从感知、理解到行动的完整闭环,能够自主识别物体与场景、规划路径,并执行包含抓取、对齐、折叠、归类等多步骤的。他主导了业内首个智能驾驶数据闭环系统的落地,有效提升了数据的处理效率,为智能驾驶技术的发展提供了重要的基础设施支持。

量子位 239

LeCun新证明:世界是高斯的

论文借用这个框架证明,要让转移算子的第一个特征函数恰好是仿射函数(即线性函数加常数),潜变量的分布必须满足一个非常严格的条件——它的对数密度的导数必须是线性的,而满足这个条件的分布恰好只有高斯分布。从理论角度看,对于高斯分布,描述变量如何在时间上演化的转移算子有一组特殊的特征函数,叫做Hermite多项式,它们是高斯分布下函数空间的自然正交基,类似于周期函数里的傅里叶级数。真正有用的表示,应该对应世界的真实自由度,比如物体的位置、速度、颜色这些独立的内在变量,而不是它们被观测过程扭曲之后的混合产物。

量子位 185

玻璃里跑AI!华中科大&上交大科研成果登Nature子刊

更进一步的,光本位科技还将独有的相变材料存算一体光计算方案引入玻璃光计算芯片中,利用相变材料的非易失性,能够避免在玻璃中引入额外的相移器,从而实现计算过程几乎不耗能的三维光子神经网络系统。它既解决了三五族平台器件密度不足的问题,又突破了固定场景的应用限制,相变材料的引入,使得芯片在推理过程中保持极高能效比的同时芯片参数仍然可根据不同模型实时调整,适配性更强。尽管与论文中直接在玻璃中实现三维结构有所差异,但是同样在玻璃平台上提供了三维集成的完整方案,通过单层玻璃芯片堆叠的方式最终实现相同的三维输入效果。

量子位 166

5篇AI生成的数学论文被接收!00后创始人洪乐潼融资14个亿

如果一个 AI 系统能把数学证明交给机器逐步检查,那么同样的“生成、形式化、验证”闭环,也可能被拿去处理其他学科,以及高风险决策场景。她的创业合作伙伴Shubho Sengupta也从Meta辞职,两人从AI与数学推理的交叉可能性出发,决心解决AI的幻觉问题。创始人洪乐潼,2001年出生于广州,本科MIT三年拿下数学与物理双学位,还拿过北美数学本科生的最高荣誉罗德奖学金和摩根奖。2019年,17岁的洪乐潼考入MIT,仅用三年时间便完成了数学与物理双学位的学业,本科期间就发表了9篇学术论文。

量子位 211

AI正在重写软件行业?8岁孩子做操作系统,一人公司拿下千万订单丨百度秒哒朱广翔 @AIGC2026

这些都完成之后,我们再选择分发给谁,比如百度搜索、小红书投流,或者去微信发送到私域社群里,或者说去App store上架,分发流量之后有了用户数据再去回流、去分析、去运营,指导下次迭代,形成下个循环,每个色块就是一个真人。在很多企业里,原来提需求的是业务人员,他们自身没有开发能力,将需求提到研发部门,研发部门又不懂业务人员的痛点,需要反复沟通、调整,但现在业务人员自己就可以开发软件了。我非常荣幸能从事这个赛道,因为在这个过程中、在这一年半的时间里,我不仅看到了产品的变化,还更多地看到了整个时代的变化。

量子位 419

清华有了新老师:黄仁勋

既包括科技圈顶流如马斯克、微软CEO纳德拉、Meta扎克伯格等,也不乏金融圈大拿,如摩根大通的杰米·戴蒙、贝莱德的拉里·芬克、花旗的简·弗雷泽。,使命是加强学院与外部各界的联系,提升学院在科研和教学方面的整体水平,帮助学院建设成为世界一流的经济管理学院。后来黄仁勋转学,并且一直学业成绩优异,在高中时连跳两级,16岁毕业,进入。,除了讨论学院的国际化战略和长期发展方向,也会给经管学院的学生做讲座。不过,比起这些头衔,老黄最近最出圈的,可能还是他在夜市的花式插队——可口可乐、西门子、通用汽车、BP、塔塔。

量子位 174

「斯隆奖」得主戴亮全职加盟复旦

曾担任波士顿咨询合伙人,副总裁,中国区首席数据科学家,百度研究院大数据实验室和商业智能实验室的主任,和美国俄勒冈大学计算机和信息科学系正教授(终身教职)。,覆盖面相当宽:从宇宙大尺度结构与演化,到暗物质及其通过引力透镜留下的观测信号,再到天体物理引力波。2024年起到复旦大学物理系工作,现任复旦大学特聘教授、复旦大学天文与天体物理中心主任。获奖者覆盖数学、物理、天文、计算机、经济、生物等领域,成长路线相当恐怖,很多后来成了。继袁峰、季索清之后,复旦的天文版图,再迎一位顶尖天体物理学者。

量子位 160

高分辨率视频生成不再慢半拍:让大模型保留“原味”的同时提速十余倍

为此,SURF训练了一个轻量级Refiner,它从线性上采样后的预览latent出发,学习低分辨率latent到高分辨率latent 的flow mapping,只需少量去噪步骤,就能补足高清纹理。因为这些步骤决定了视频最终“会长成什么样”,等到整体结构、主体关系和运动方向基本稳定后,SURF再将latent 下采样到低分辨率,在保留全局结构的前提下,快速完成预览。原因在于,每个预训练模型都有自己的“舒适区”,通常接近它的训练分辨率,一旦分辨率不匹配,模型原本学到的布局、语义和运动先验,就可能被破坏。

量子位 136

大模型也需要睡觉!让AI打个盹,醒来更聪明

Transformer的核心是注意力机制,但注意力有一个天生的短板就是,上下文越长,算力平方级往上蹿,KV缓存也线性往上涨。,让大模型上下文窗口快满的时候别硬撑了,打个盹把最近的上下文反复咀嚼几遍,压缩进长期权重,清空缓存,醒了再接着干。依靠可学习的局部规则,反复对信息进行提炼整合,逐步更新SSM模块内的快速权重,完成信息的深度压缩与消化。这里的“睡眠时长”,本质上就是信息迭代处理的轮次,轮次越多,代表模型对上下文内容的梳理、打磨次数越充分。

量子位 152

1400亿Agent入场,“流量”这条护城河要塌了

因为人要睡觉,但Agent不会睡觉,所以Agent时代的交易呈现7×24小时不间断、极小额、高频次、多形态的特征,此外,支付金额的最小单位可能低于1分钱,成本大幅下降。如果说担保交易解决了电商早期敢不敢买、敢不敢卖的信任问题,移动支付解决了移动互联网时代能不能随时随地交易的效率问题,那么AI支付面对的,就是Agent时代的新问题。早在今年年初,支付宝联合千问App、淘宝闪购、Rokid、大麦、阿里云百炼等伙伴,正式发布中国首个ACT协议,提供一套智能体跨终端、跨系统的“通用语言”。

量子位 156

7B打败o3、GPT-5!医学AI智能体让模型学会“看哪里、怎么看”

是上海创智学院面向下一代医学AI Agent、视觉推理与多模态大模型的青年交叉研究团队,聚焦Visual Reasoning、Agentic RL、Clinical Tools,推动模型从“生成答案”走向基于证据的观察、验证与行动。Ophiuchus的价值不只是让医学大模型多了几个视觉工具,而是让模型学会在诊断过程中主动“看哪里、怎么看、看完如何修正”。当模型能够在思考中主动回看影像、放大病灶、截取视频、验证证据,医学AI才真正从“会回答问题”走向“会进行临床视觉推理”。

量子位 161

AI越用越聪明,自主+自进化是关键拼图丨盛大邓亚峰EverMind@AIGC2026

另一方面,我们认为,未来的AI Memory的Layer(记忆层),服务的可能不仅是资深的开发者,将来很多人都会构建AI应用。我们在token节省和模型成本方面也取得了显著的效果,原因是利用强化学习的方法训练了很小的模型——我们的4B模型在记忆提取和检索使用上的效果可媲美几百B的模型,并且已有不少学术成果发表。当前,大家看到模型进展非常快,但在记忆方面的工作,今年才逐渐多起来,去年这个时候我们和行业里一些团队开始交流AI Memory,这方面的关注还非常少。的爆火,我简单谈谈我的理解。

量子位 746

让大模型“边看边改”,视觉分割准确率直接上涨9% | ICML 2026

给模型一张图、一句话,让它把目标区域的像素圈出来——听起来直接,但一旦目标含糊、被遮挡,或者需要推理才能定位,一次性猜出正确的掩码就变得相当困难。模型不再一次性输出mask,而是先观察图像、进行推理、调用视觉工具、读取反馈,再根据历史结果迭代修正,最终生成更可靠的准确掩码。而RSAgent总体框架如下,包括多轮交互、工具调用、观察反馈、cold-start SFT与agentic RL。痛点不是单纯追求更复杂的分割头,而是让模型在开放语义任务中具备“先判断、再行动、看反馈、再修正”的能力。

量子位 179

OpenAI挖来了个F1级别车手搞公关

在我职业生涯早期,我曾效力于红牛车队,参加过F1级别的职业比赛。后来无论是Salesforce、ServiceNow,还是现在的OpenAI,他几乎每一次跳槽,踩中的都是技术范式切换最剧烈的时候。毕竟现在的OpenAI,既是全球最炙手可热的AI公司,也是最复杂、最难做品牌管理的公司之一。当年从赛道退下来后,他没有选择一条更稳妥的路,而是直接跨进了一个与赛车几乎毫无关系的行业,从零开始做市场与品牌。Salesforce后来之所以能从一家卖CRM的软件公司,变成云计算时代的行业代表,这是很重要的一步。

量子位 142

5秒完成3D场景编辑,北大&港中文&上海AI Lab搞出VGGT-Edit,120倍加速太炸了

尤其是在添加家具、调整位置、修改材质这些复杂任务中,很多传统方法仍然会出现明显的“贴图感”和几何漂移,但VGGT-Edit生成的结果,会明显更像一个真实稳定的3D空间。而这件事,可能比“会生成3D”本身更重要。对于机器人、AR/VR、空间智能这些方向来说,这几乎是致命问题——这些场景真正需要的,不是“某一个角度看起来对”,而是整个3D世界始终稳定一致。对于原生3D编辑来说,这一步非常关键——模型真正需要学习的,不只是“图像变化”,而是同一个编辑,在不同视角下如何始终保持空间一致。但问题也恰恰出在这里。

量子位 144

触觉具身来了个梦之队:天使轮近亿

背靠产学研与地方政策双重加持,作为复旦大学与静安区战略合作的重要落地成果,公司在初创期便获得静安区科经委与市北高新集团的大力培育,先后获得静安区战略性资金及上海市经信委促进产业高质量发展专项资金的支持,上海市科委也针对其核心视触觉传感器的研发给予了专项经费支持,全面加速公司的技术攻关进程。能够夹起衣物,却无法实时感知布料的滑移状态与张力分布,难以完成精准的褶皱整理。对于后发企业而言,沿着先行者的轨迹亦步亦趋难以实现突破,唯有找到行业尚未解决的核心难题,从新的技术变量切入,才能构建起不可替代的竞争壁垒。

量子位 154

DeepSeek陈德里开发自动研究Skill,写一篇论文人类只动脑2小时

论文共迭代6次(V1:4 次,V2:1 次,V3:1 次),总耗时6天,进行了约108轮Agent调用,消耗64.8万token,写了2234行LaTeX代码。,智能体可自主选题、分配资源、长期积累知识、跨领域持续研究,是当前未实现的理想状态,核心瓶颈为持续知识积累、可靠自我评估、架构规模化。早期智能体框架CAMEL、AutoGen、MetaGPT等为代表,特点是分工协作、多视角纠错,成本较高,沟通易混乱。,人类仅提供研究目标、评估最终成果,智能体可完成多步实验、代码、论文撰写,但无法自主选择研究问题。

量子位 185

双榜SOTA!微软ACL2026新作重新定义AI长记忆

结果它找到了Boston和San Francisco,却完全遗漏了Detroit——因为“attended a conference in Detroit”被埋藏在一条长消息中,与“去过哪些城市”的语义相似度不够高。最终,System-1确保语义直接匹配的记忆不遗漏,System-2确保结构相关但语义距离较远的记忆被覆盖,两者。团队认为,真正的AI记忆应当是有组织的、可推理的、双模式的、并能持续进化的。记忆系统的质量,很大程度上取决于“存储时做了什么”,而不仅仅是“检索时怎么找”。

量子位 175

将DSA注意力引入多模态,快手Keye2.0开启强化推理新范式

情感与主题的深度升华:模型并没有停留在“建雪雕”的表层,它提取了画面中巨大的“振兴东北”刻字,关联了片中“老程盼女儿、小李回流家乡”的人物背景,在总结中直指故事内核:“极寒的温度冻不住东北人的热血,冰雪项目不仅是奇观,更是承载着东北人振兴家乡、呼唤游子归乡的炽热情感与现实路径。当接收到“请找出视频中的高光时刻,并给出你的依据,时间戳用[mm:ss]的形式来表示”的指令时,Keye-VL-2.0- 30B-A3B没有陷入传统AI“哪里有击杀提示就截取哪里”或“只看画面元素剧烈变化”的机械逻辑。

量子位 180

专治世界模型幻觉!ECCV 2026 Workshop征稿,Sergey出席,帝国理工等联合发起

ergey Levine(UC Berkeley)、Jiajun Wu(Stanford)等国际顶级学者做特邀报告,同步举办具身动作世界模型挑战赛,以及主题为From Synthesis to Deployment:Bridging Academic and Industry Focuses on World Models的圆桌讨论,旨在弥合学术界在世界模型合成方面的进展与工业界对部署需求之间的差距。世界模型作为智能体的内部模拟器,在执行前预判风险、规避危险,实现风险感知决策。

量子位 185

卡帕西Anthropic最新头衔:技术员工(MTS)

但尴尬的是,这些案例的争议其实很大,都被吐槽过说没有宣传的那么美好,所谓扁平会变成隐性权力,表面没老板,实际有老员工、核心圈层……头衔都一样,竞争对手就没法通过头衔判断谁是L7谁是L5,推断一个员工具体做什么方向,定向挖人的难度直接上升。一个很直观的事实是,整个商业史上,能在没有层级制度的情况下完成规模化的组织,一只手数得过来。后来离开Ins,自己做了个新闻聚合App,叫Artifact,同样是联创+CTO的标签。这些说不在意职称的,一旦离职,就开始在领英自称上「副总裁」了(hehe)。

量子位 76

把VLM塞进隐式世界模型,港大&小鹏机器人新框架让机器人长出物理直觉

通过将人类的姿态对齐到机器人的动作空间,双系统能够共同从多样的人类动作数据(如EgoDex)中汲取养分:System-2负责从人类视频中提取通用的任务逻辑,而System-1则从人类动作标签中蒸馏通用的运动先验。借鉴认知科学中的双系统理论,不仅让强大的VLM直接在其原生的ViT特征空间中进行轻量化的隐式世界建模(Latent World Modeling),更关键的是,它将这种隐式视觉预见构建为一个可微的结构化瓶颈。System-1则在真实未来特征的指导下,专心学习从感知到精准动作的映射。

量子位 86

留给人类数学家的悬赏不多了!谷歌DeepMind一口气解决9道埃尔德什问题

同时,AlphaProof Nexus还在OEIS整数序列百科里证明了44个开放猜想,在代数几何那边解决了一道希尔伯特函数对数凹性的15年悬案,凸优化那边改进了一个锚定梯度下降法的理论边界。这个结果或许也在预示着,未来随着大模型能力持续升级,复杂的多工具组合系统,可能不再是刚需,只用大模型+专业校验工具这套简单循环,就能搞定大多数数学难题。简单理解就是,这群数字之间,既不能一个数整除另一个数,也不能一个数整除另外两个数的和,同时数字还要分布得相对密集,不能只挑寥寥几个数投机取巧。

量子位 124

龙虾之父教你省钱:开源Skill给你的Skill减肥

严格遵循Codex计费规则(UTF8字节数/4向上取整),以模型上下文2%为默认技能预算基数,结合技能优先级排序规则(系统技能>内置技能>插件技能>仓库自定义技能),核算全量技能原始占用令牌、最小渲染令牌、预算内可用令牌。同时可模拟真实运行场景,计算预算不足时的技能描述截断字符数、被省略技能数量,精准输出预算使用率、剩余预算、上下文占用比例等核心指标,直观展示技能体系的资源负载情况。跨Codex内置库、插件缓存、代码库、个人技能根目录,扫描同名技能、描述/内容高度相似的重复技能,标记冗余项。

量子位 81

刚刚,国产AI自己造了AI,全球首例!

在MMLU-Pro、MMLU-Redux、AIME-2025、AIME-2026、BFCL-v4、AA榜单等项目上,也给出了对应成绩。我们完全可以给不同的模型、不同的硬件、不同的任务,分别写专用的代码。如果人不够,那就用AI来凑!更直白一点说,就是当AI写代码的成本越来越低,未来软件不一定非要做成一套通用大框架,也可以针对不同模型、不同硬件、不同任务,现场锻造一套专用代码。这也让MiniCPM5-1B的价值更明确了,它不只是一个小尺寸模型,而是一个在参数规模、部署成本和实际能力之间重新找平衡点的端侧模型。

量子位 637

画数独、烧蜡烛都不翻车了?浙大&阿里让AI先三思再下笔|ACL 2026

让模型画 “数独解完后的样子”、“蜡烛燃烧6小时后的状态”,开源模型要么出现逻辑幻觉,要么无法把文字指令转化为精准视觉操作,形成难以跨越的执行鸿沟。研究者设计了一个独立的Thinker模块,它不直接生成像素,而是充当大脑,负责将模糊的用户意图分解为分层、结构化、且对下游生成器友好的中间表示。阶段,Thinker产生的多条推理路径直接由生成图像的视觉质量打分反馈,这迫使模型放弃空洞的辞藻,转而学习生成“视觉可执行”的指令。这种双向反馈机制,真正实现了脑与手的深度协同。

量子位 57

0.9B跑出90%真机成功率!上海交大为VLA补上空间感

从多视角RGB提取紧凑的隐式深度表征,再以轻量方式融入视觉-语言通路,最后通过flow-matching动作专家输出连续动作。参数,不额外增加硬件负担,用紧凑的隐式深度编码把空间感写进VLA策略里,仿真与真机同时兼顾性能与部署效率。论文中,IDEM骨干约0.13B参数,并结合多视角深度预训练初始化,在轻量条件下引入与深度相关的归纳偏置。值得注意的是,相比只关注benchmark分数,论文也给出了部署侧开销与实时性指标。从RGB学几何,省了硬件,但不少方案依赖较重的基础模型,训练和推理成本偏高。

量子位 76

Grok最新模型吃上Cursor「加餐」,马斯克:Coding实现巨大改进

Cursor数据其实更可能告诉模型,开发者在真实项目里,是怎么描述需求、定位问题、让AI读上下文、修改文件、修复报错、再继续追问的。更大的模型容量,往往能让它更好地理解复杂上下文、进行更长的链式思考,以及处理更具挑战性的真实开发任务~要知道,毕目前承载Grok所有生产流量都由0.5T的v8-small模型,也只有0.5T的大小。用户输入需求后,Grok Build不会直接动手,而是先制定详细执行计划,让用户确认后再执行。这边,也被马斯克亲口点名,补充训练里加入了大量Cursor数据,后续还会继续添加。

量子位 109

刚刚,国产Agent模型闯入全球第一梯队!限时免费

从训练的第一天起,它的目标就不是聊天,而是干活。就像我在实测中感受到的那样,做完桌宠它问你要不要存成Skill,做完周报它提醒你设成定时任务,昆仑万维瞄准的显然不只是一个模型,而是一整套Agent工作生态。发现没,自从模型进入Agent时代后,大部分玩家在推主力模型时都会附带一个轻量版,这也很好理解,就像前段时间Snapchat前机器学习工程师说的那样:。一只小猫,能在屏幕上随机溜达,点击会说打工人语录,右键能切工作模式和摸鱼模式,工作模式带番茄钟倒计时,还要有喝水提醒、远眺提醒、拉伸提醒这些健康功能。

量子位 531
上一篇: DeepSeek-V3.2系列开源,性能直接对标Gemini-3.0-Pro
下一篇: 库克不忍了!挥刀优化苹果AI大总管
QbitAl
QbitAl 企业官方账号 企业官方账号
博客等级 码龄7年 2万+粉丝 2173原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值