


作者:陈明雨,Apache Doris PMC Chair
导读:Apache Doris 5.0 多模湖仓预告( 4)|场景方案篇:
Variant 是 Apache Doris 从 2.1 版本起提供的列类型,专门存放 JSON 这类半结构化数据:用户在建表不用预先定义字段,写入时自动拆成类型化子列,既有 JSON 的灵活写入,又有接近列存的分析性能。Apache Doris 5.0 把 Variant 类型从内表扩展到了 Iceberg / Paimon 等开放湖格式,使用同一种 VARIANT 类型、同一套 SQL、同一个执行引擎,即可处理不同格式的 Variant 数据。本文从一条 Agent 轨迹的数据链路说起,介绍为什么要做这件事、能解决哪些业务痛点,以及内表 Variant 与湖上 Variant 的选型建议。
一、从 Agent 轨迹说起:Variant 生产者和消费者的割裂困境
一条 AI Agent 的执行轨迹天然是 JSON。MCP、A2A 这些协议都基于 JSON-RPC:工具调用的参数、模型的输出、每一步的 span 属性都是嵌套结构;一条完整轨迹从几十 KB 到几 MB,嵌套七八层。模型一迭代,工具列表和参数就跟着变,昨天的 8 个字段今天变成 12 个,无法预先定义出稳定的 schema。
过去,分析系统应对这类数据有三种方案:
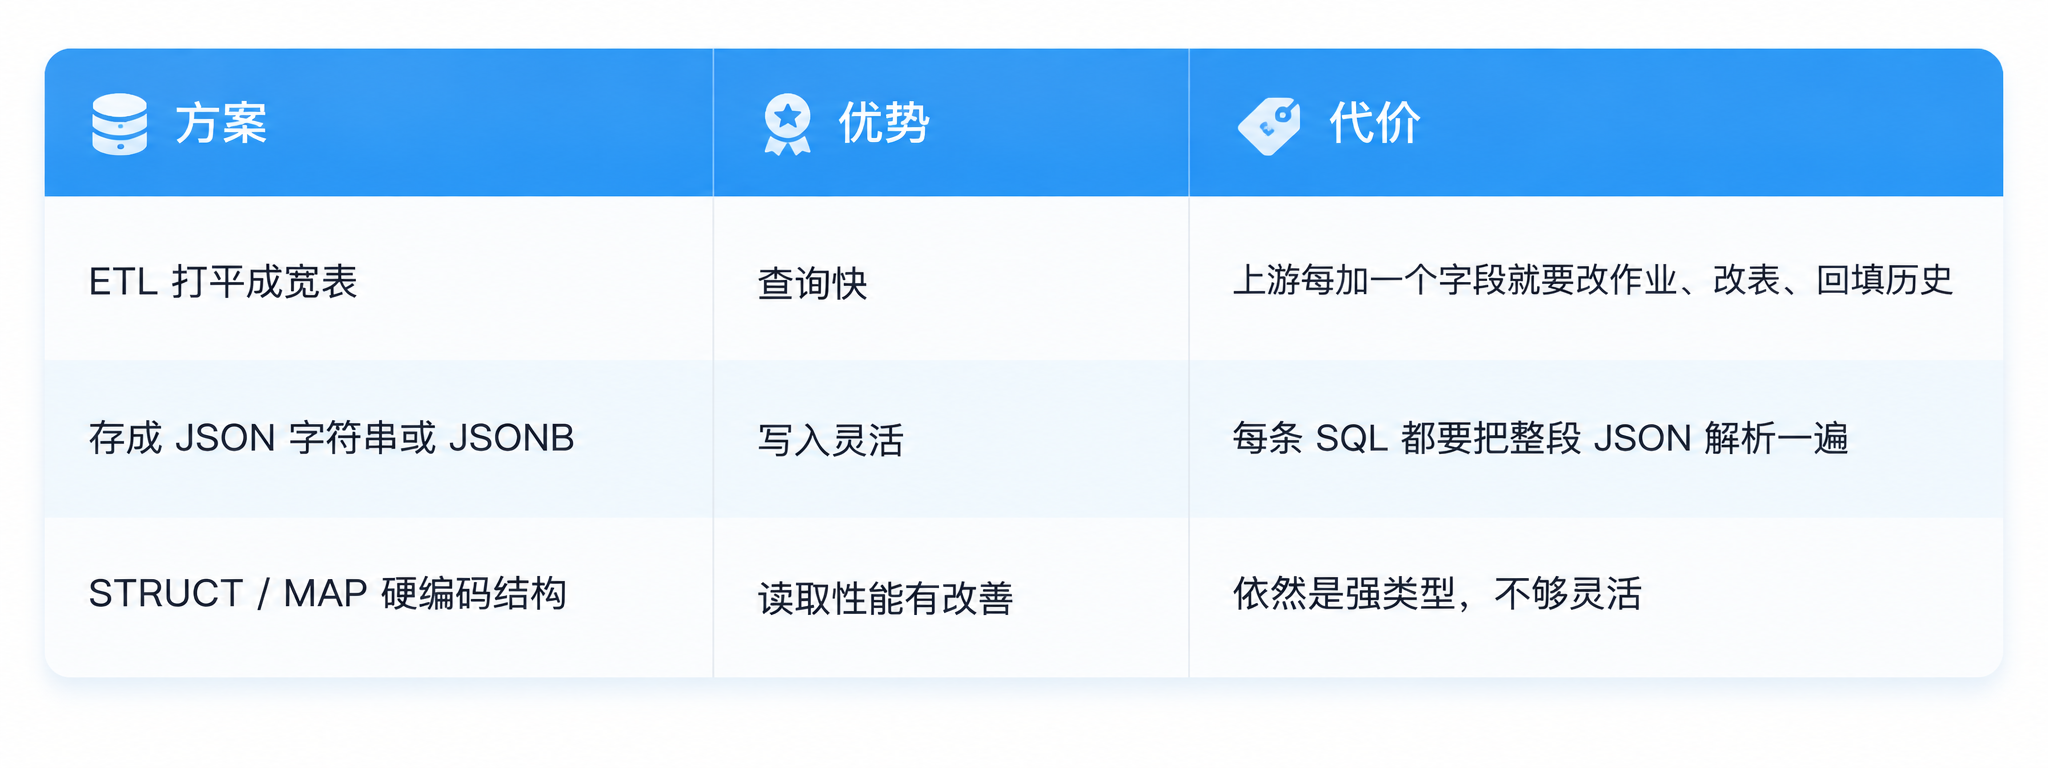
Variant 类型正是为解决灵活性与查询性能不可兼得的矛盾而设计的。Apache Doris 自 2.1 版本起提供 Variant 列类型,专门存放 JSON 这类半结构化数据:
-
建表时只声明一个 VARIANT 列,不用事先定义里面有哪些字段;
-
写入时 Doris 自动把 JSON 拆成类型化的子列,做类型推断与提升,低频字段进稀疏列,子列可以建索引;
-
查询时按路径取值,读的是对应的子列,不用解析整段 JSON。
这样一来,Variant 既有 JSON 的写入灵活性,又能拿到接近列存的查询性能。
在 Agent 观测平台上,推荐的建模方式是:
-
trace_id、tool_name、耗时这些稳定字段做普通列;
-
输入、输出、工具参数放进一个 VARIANT 列,上游加字段不用改表;
-
失败归因、按工具聚合成本、按模型版本对比效果,都是按路径取值的普通 SQL;
-
模型输出里的文本,用倒排索引做全文检索。
Apache Doris 在之后的版本中不断加强对 Variant 类型的支持,新增了 Schema Template、子列级二级索引、应对百 MB 级超大 JSON 的 DOC 模式、解决嵌套数组检索问题的 NestedGroup 等高级功能。
但随着企业数据架构的变化,新的问题产生了:Agent 轨迹的生产者是 Flink 或 Spark 上的采集链路,数据通常先落到 Paimon,再供训练、评估、观测等多个消费者使用。而 5.0 之前的 Doris 只能处理自有格式的 Variant 数据,消费者要用 Variant 做分析,就得在内表和湖之间做双写同步,这会带来数据冗余存储、同步延迟、数据不一致等诸多问题。
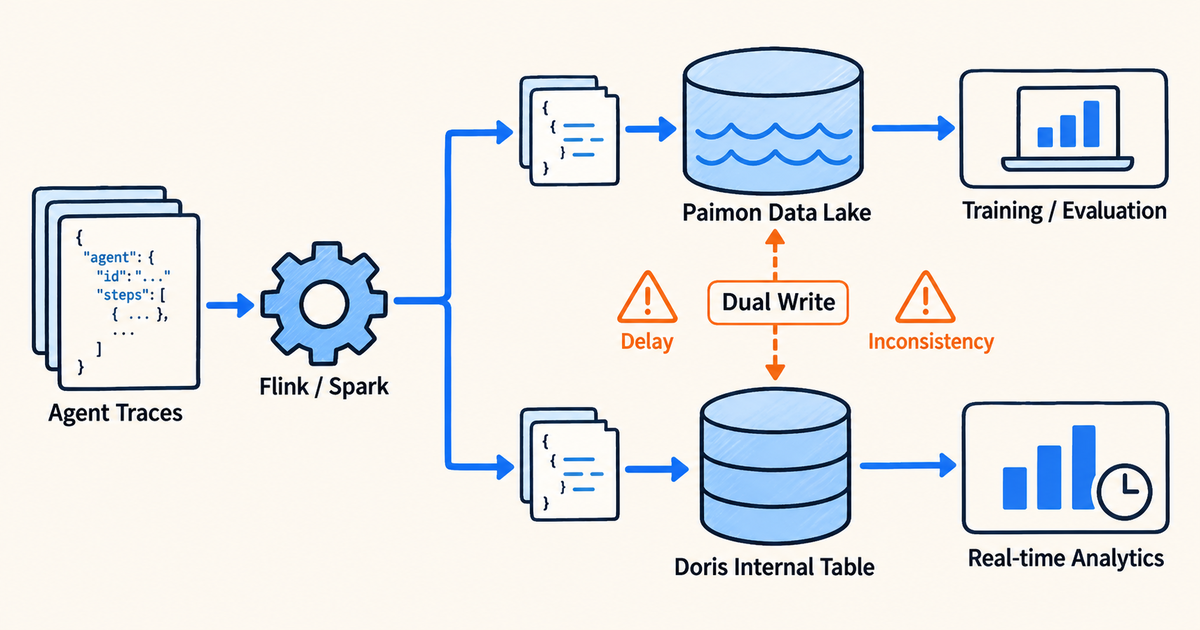
除了 Agent 观测平台,其他 Variant 应用场景也有类似的问题:
-
埋点:事件属性放进 VARIANT 列,产品团队加属性不用改表。但同一份事件数据是企业级的共享资产,算法团队还要拿去做训练特征,数据需要在 Iceberg 上另存一份。
-
IoT 遥测:设备属性因型号和固件而异,打成宽表过于稀疏,放进 VARIANT 列,一条 SQL 就能跨型号聚合。但全量数据要留好几年,只有放到对象存储加开放格式才能显著降低存储成本;于是实时告警和历史回溯要访问不同的系统,体验割裂。
需求很明确:Variant 跟着数据走,数据在湖上,Variant 就得在湖上。因此,计算引擎也需要能对湖上 Variant 数据进行统一分析。
二、Variant 的标准化:半结构化数据进入「一份数据、多引擎共享」
过去,湖上的半结构化数据只有两条路:存成字符串,或者 ETL 成 STRUCT。随着半结构化数据的重要性提升,前面提到的问题性能等问题也开始凸显。于是自 2025 年开始,Variant 走向了开放标准化之路:
-
2025 年 3 月,Apache Parquet 2.11 定义了 Variant 的二进制编码,并引入 Shredding 规范:写入方可以把高频字段拆成类型化的列,其余部分留在二进制值里,文件本身就带上了列存的形状。同年 8 月规范定稿。
-
2025 年 6 月,Apache Iceberg V3 规范批准,Variant 成为表格式的一等类型;Apache Paimon 自 1.4 起支持 Variant 与 Shredding。
-
Spark 4.0 / 4.1、Flink 2.1、DuckDB 相继跟进,Trino 开始实验性支持;Snowflake、Databricks 也在 2026 年先后宣布各自对开放格式 Variant 的支持正式可用。
开放湖仓强调的「一份数据、多引擎共享」逐渐覆盖到了半结构化数据。标准化的进程,意味着湖上的 Variant 数据可以被任何遵循标准的引擎读写,因此我们决定将内表的 Variant 处理能力进一步扩展到标准 Variant 格式上。
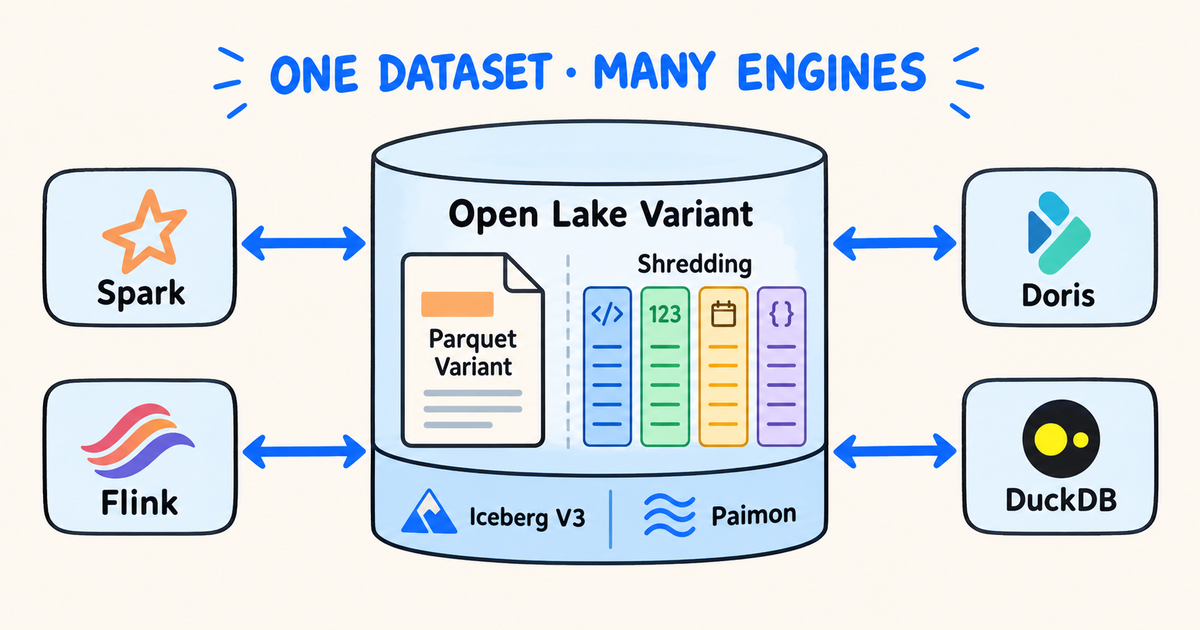
但一个引擎要充分利用湖上的 Variant 类型,需要解决三个问题:
-
如何高性能读取:关键在于能否直接利用 Shredded 布局。
-
能否作为 Variant 的生产者:只读不写,引擎的分析结果就无法回流到开放湖仓上被复用。
-
内外格式能否互通:不同格式的 Variant 在使用体验上能否保持一致。
接下来重点介绍 Apache Doris 5.0 的 Variant 统一解决方案。Shredded 布局的读取能力我们会在之后的 Variant 技术解析文章中着重介绍。
三、Doris 5.0:一种 Variant,一套 SQL,一个执行引擎
Doris 5.0 将内表 Variant 的分析能力扩展到 Iceberg 和 Paimon 等开放湖格式上,并在使用体验上尽可能地保持统一。
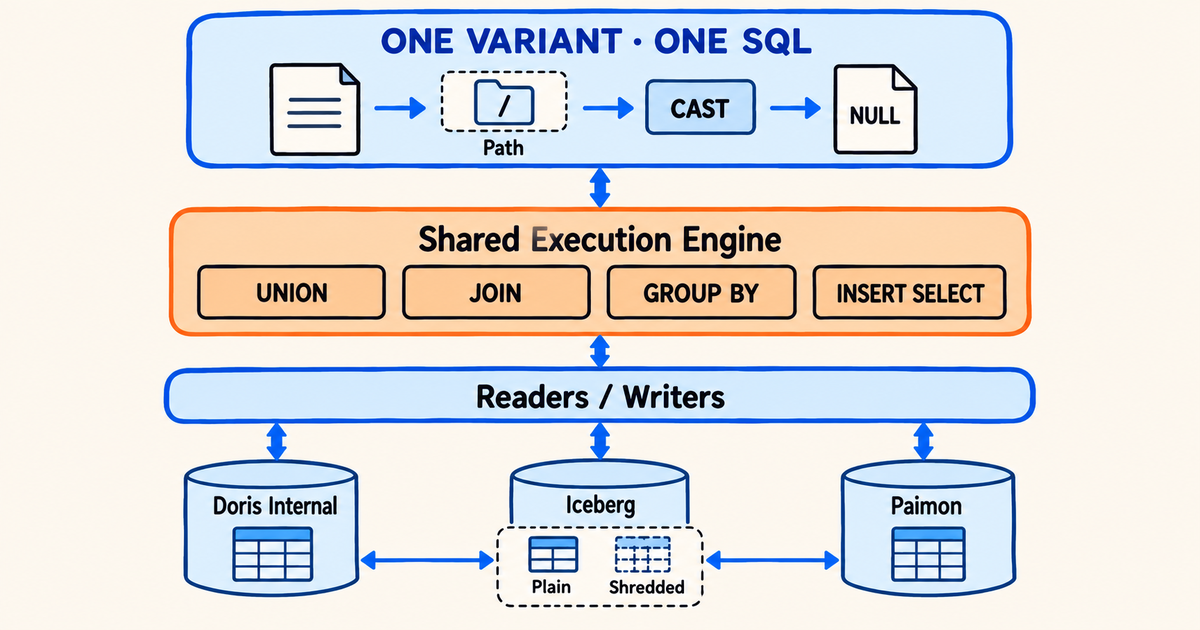
3.1 三层看「统一」
-
上层:统一类型与 SQL 语法Doris 只有一个 VARIANT 类型,并且在 SQL 语法和语义表示上保持内外表一致。
-
统一路径访问语法:
payload['event']['type']; -
统一转换逻辑:
CAST做类型转换,VARIANT_TYPE查看实际类型; -
统一构造函数:
PARSE_TO_VARIANT从 JSON 文本构造值; -
统一嵌套表达:ARRAY / MAP / STRUCT 支持 VARIANT 嵌套;
-
统一 NULL 语义:区分 SQL NULL 与 JSON null。
-
-
中层:统一执行算子数据从内表数据文件读出,或从湖上的 Parquet 文件读出,统一转换成计算引擎内部的 Variant 列表示,走同一批算子,以确保计算行为一致:
-
内表与湖表的 Variant 可以出现在同一条 SQL 里进行 UNION、JOIN 等各类计算;
-
内外表可以互写,如
INSERT INTO LakeTable SELECT ... FROM DorisTable; -
Variant 可以直接参与 GROUP BY 和 DISTINCT,按逻辑值去重,而不是按字节。
-
-
下层:统一格式访问接口通过对 Scan / Sink 算子的逻辑抽象,不同格式仅需实现各自的 reader 和 writer。比如 Doris 内表格式支持拆子列、建倒排索引和 BloomFilter,支持实时写入和主键更新;开放湖格式支持 Plain 和 Shredded 两种布局的读取,写入布局则按格式各自实现(见 3.2)。把格式差异尽可能下推到底层,以确保能复用大部分执行流程。
3.2 能力清单
以下是 Doris 5.0 新增的湖上 Variant 能力清单:
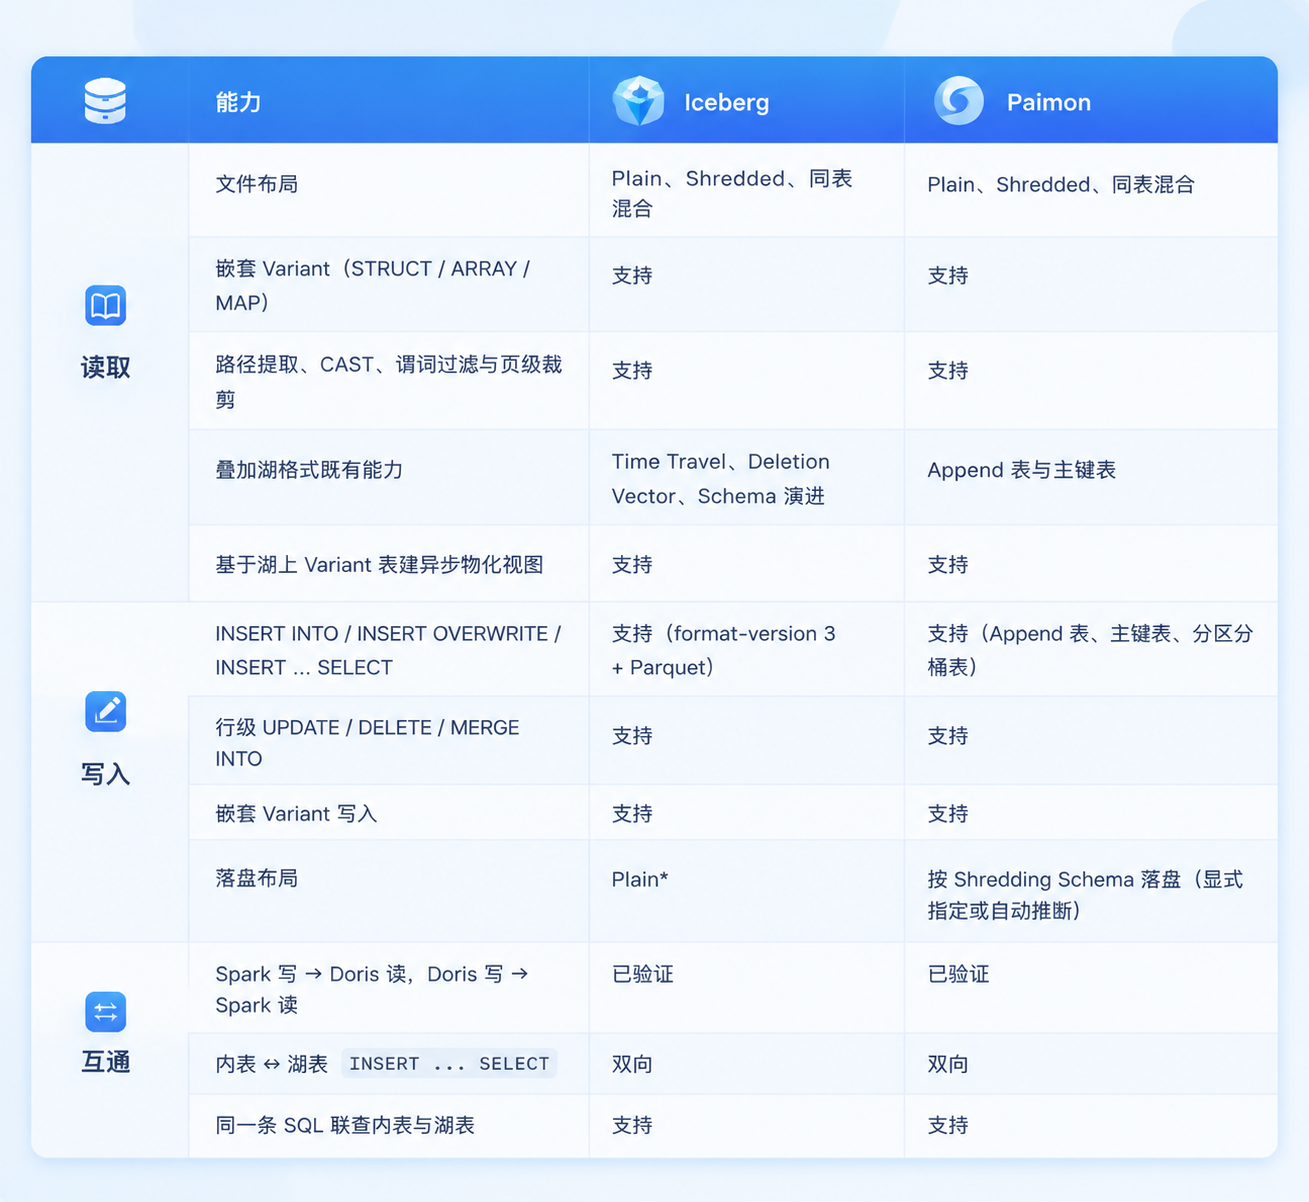
Iceberg 当前只写 Plain 布局,Shredded 布局的读取已完整支持;Shredded 写入是后续迭代方向(见结语)。
3.3 示例:Agent 轨迹统一湖仓分析
接下来我们通过 Agent 观测平台这个场景来做一个简单的示例。
首先,轨迹数据由 Flink 写进 Paimon,稳定字段是普通列,可变部分放一个 VARIANT 列。
-- 轨迹表 paimon.obs.agent_traces 由 Flink 写入:
-- (trace_id, tool_name, latency_ms, dt, payload VARIANT)

-- 1. 直接在湖上做失败归因:路径取值、类型转换、谓词过滤
SELECT tool_name, COUNT(*) AS failures
FROM paimon.obs.agent_traces
WHERE CAST(payload['result']['status'] AS STRING) = 'error'
  AND CAST(payload['model']['version'] AS STRING) = 'v2'
GROUP BY tool_name;

-- 2. 热数据进内表,做实时告警和全文检索
INSERT INTO internal.obs.agent_traces_hot
SELECT * FROM paimon.obs.agent_traces WHERE dt = CURRENT_DATE();

-- 3. 加工结果连同 VARIANT 列一起写回湖上,给其他引擎用
INSERT INTO paimon.obs.failed_traces
SELECT trace_id, tool_name, payload
FROM internal.obs.agent_traces_hot
WHERE CAST(payload['result']['status'] AS STRING) = 'error';
这条链路里:
-
没有第二份 schema,湖表和内表用的是同一个 VARIANT 类型;
-
内表和湖表使用相同的 SQL 查询语法;
-
通过标准 SQL
INSERT ... SELECT即可完成数据同步和回写。
同样的链路换成埋点或 IoT 也成立:
-
埋点:事件以 Iceberg Variant 作为共享资产,Spark 做特征、Doris 做报表,一份数据,一套 schema 演进。
-
IoT:全量数据在湖上长期保留,热数据通过
INSERT ... SELECT进内表做实时告警,冷热两边是同一个数据模型。
四、Variant 选型建议
这里我们通过内外表 Variant 能力的对比,来帮助用户进行 Variant 格式选型。
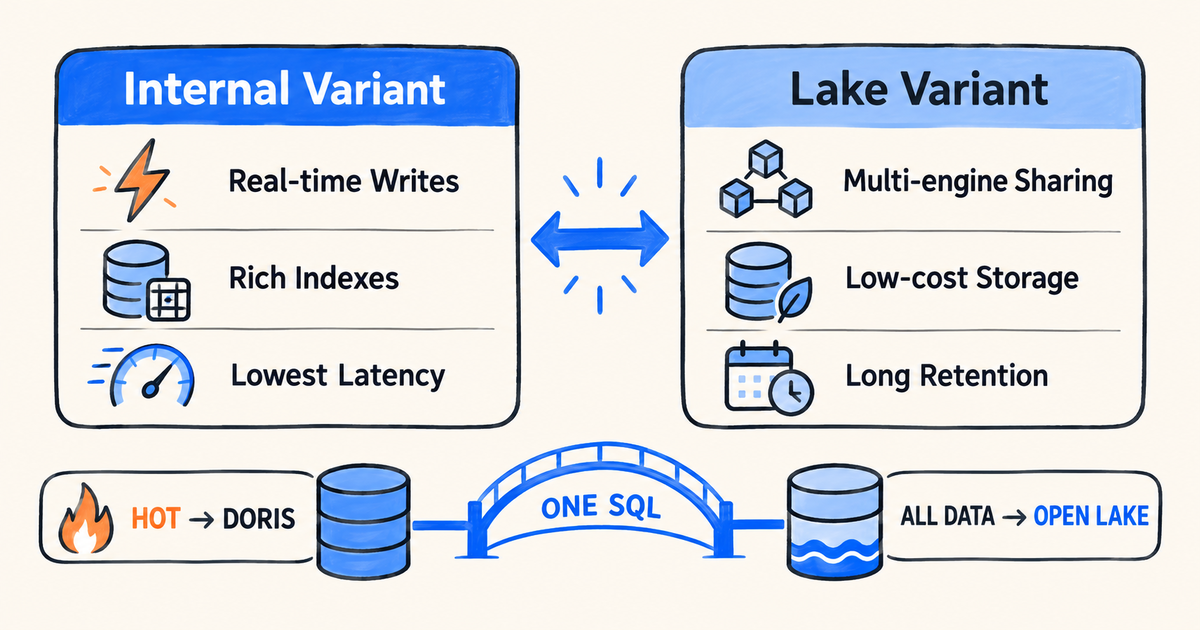
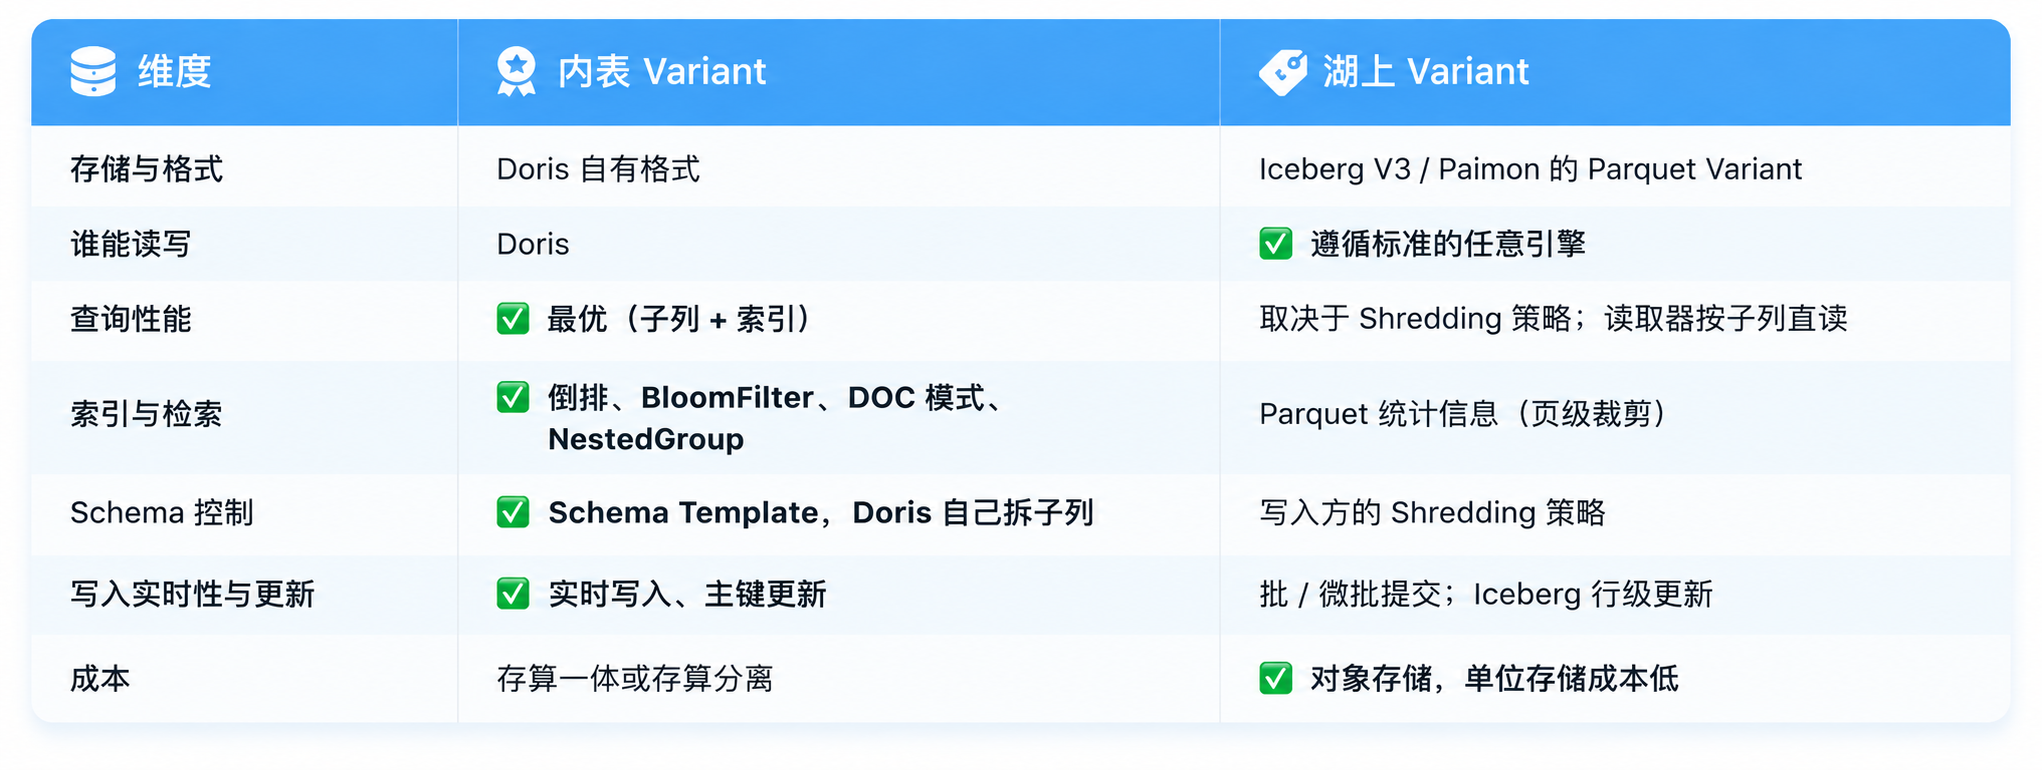
可以看到,内表 Variant 在功能丰富度和读写性能方面有更多优势,而湖上 Variant 的优势在于开放性和存储成本。
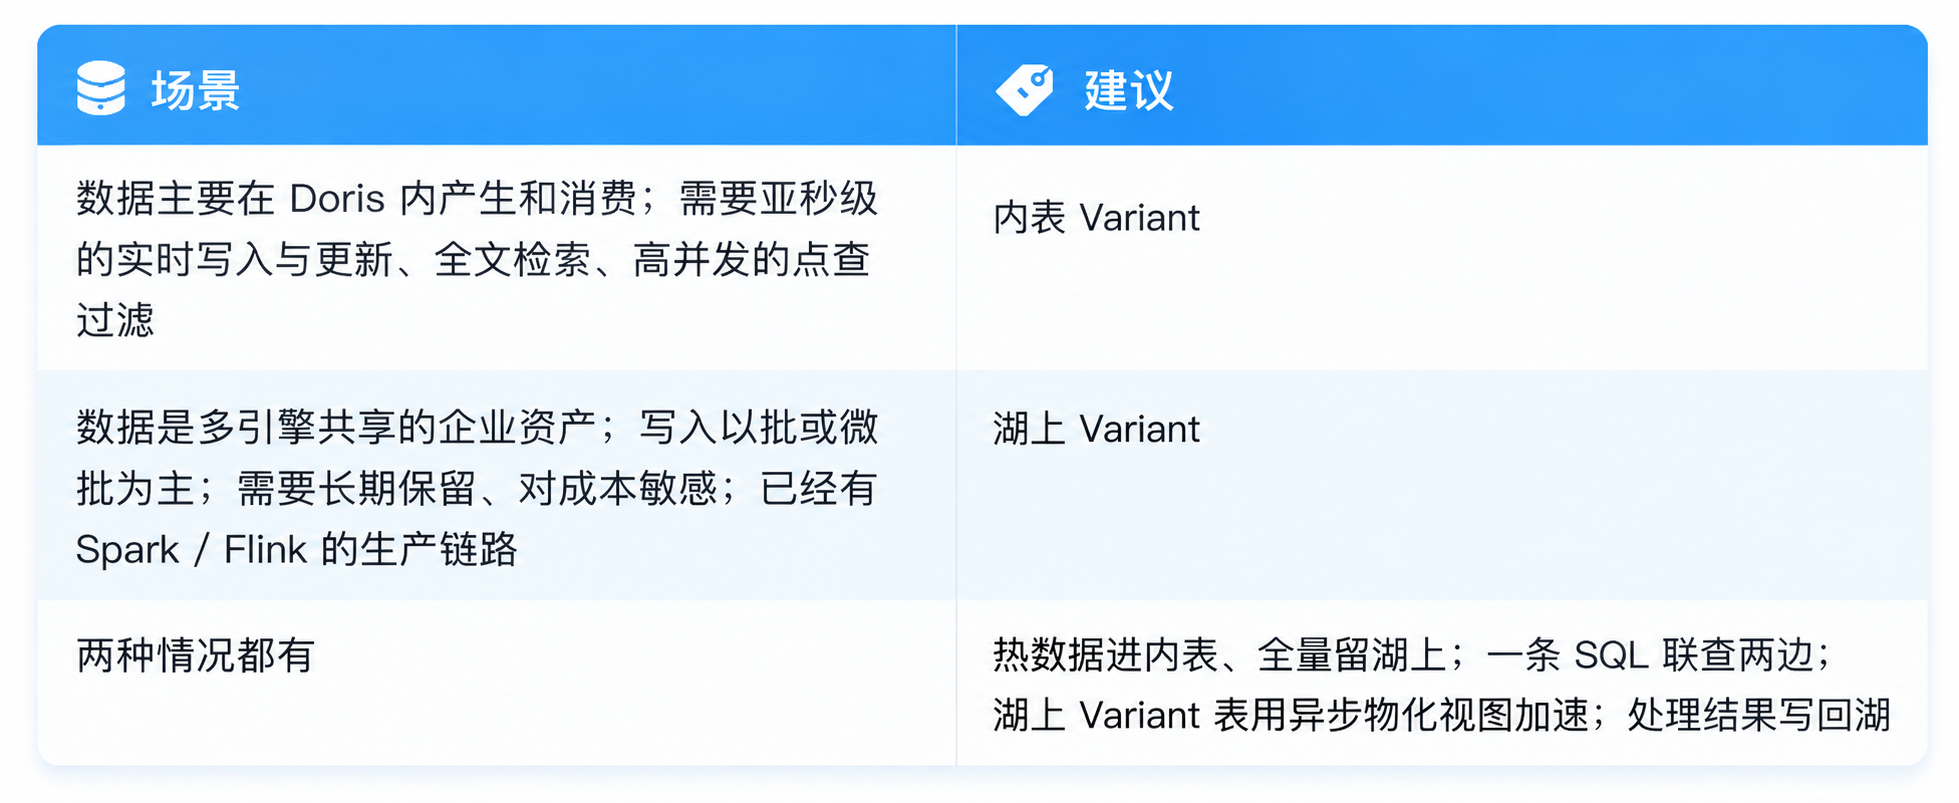
下表是 Variant 的选型建议:
五、结语:数据在哪里,Variant 就在哪里
从内表到开放湖格式,从 2.1 到 5.0,Doris 一直在迭代 Variant 类型的能力。接下来 Doris 会进一步加强对 Variant 的 Shredded 写入能力,优化湖上 Variant 的读取性能,以满足企业对半结构化数据分析的需求,拓展更多应用场景。
下一篇《Apache Doris 湖上 Variant 技术解析:Shredding 实现原理与性能实测》会详细介绍 Variant 的技术实现细节和各类格式的性能表现,帮助大家更深入地了解 Variant 的实现和使用。
对于正在评估实时湖仓、多模数据分析等实际需求的用户,可联系我们。我们可以提供针对具体业务场景提供技术交流、方案评估与测试支持,帮助你更快完成验证和落地。


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


