


1. 引言
图像恢复(Image Restoration, IR)的目标是从退化图像中恢复出尽可能接近真实图像的结果。传统方法通常依赖明确的退化模型,例如已知模糊核、噪声分布、下采样算子或压缩过程,再通过逆问题求解恢复原始图像。然而在真实场景中,图像退化往往具有复杂、未知甚至难以参数化的特点,例如 JPEG 压缩伪影、非均匀形变、水滴遮挡以及未知分布噪声等。近年来,基于预训练扩散模型的零样本图像恢复方法在多个任务上取得了较好效果,但大多数方法仍然需要至少知道退化模型的参数化形式,因此在完全未知退化条件下仍存在适用性限制。
Deep Image Prior(DIP)是完全盲图像恢复中的代表性方法。DIP 不依赖外部训练数据,而是利用未训练卷积神经网络本身的结构作为隐式图像先验。给定固定随机噪声输入 z,DIP 通过优化网络参数 θ,使网络输出逐渐逼近退化图像 y:
θ∗=argminθ∥fθ(z)−y∥22 \theta^*=\arg\min_\theta \|f_\theta(z)-y\|_2^2 θ∗=argθmin∥fθ(z)−y∥22
其中,f_θ 表示未训练 CNN。DIP 的关键现象在于,CNN 在优化过程中通常先拟合图像的自然结构,再逐渐拟合噪声等高频退化,因此通过 Early Stopping 可以在过拟合退化信息之前得到较干净的恢复结果。
不过,DIP 的先验能力存在一定局限。论文指出,DIP 对高频退化信息具有较强的拟合惯性,因此在随机噪声等高频退化上表现较好,但对于模糊这类低频信息损失问题,优化过程并不一定稳定地经历“先恢复清晰图像、后拟合退化图像”的阶段。基于这一现象,论文进一步研究了一个更强的图像先验来源:预训练扩散模型。作者采用已经在干净图像数据上训练完成的扩散模型,并在恢复过程中保持模型参数完全冻结,只优化其输入噪声。实验发现,冻结的预训练扩散模型同样会在优化过程中先生成较干净、自然的图像,再逐渐拟合退化输入,而且这一现象不仅存在于噪声等高频退化中,也存在于模糊等低频退化中。基于这种现象,论文将其称为 Diffusion Image Prior(DIIP)。
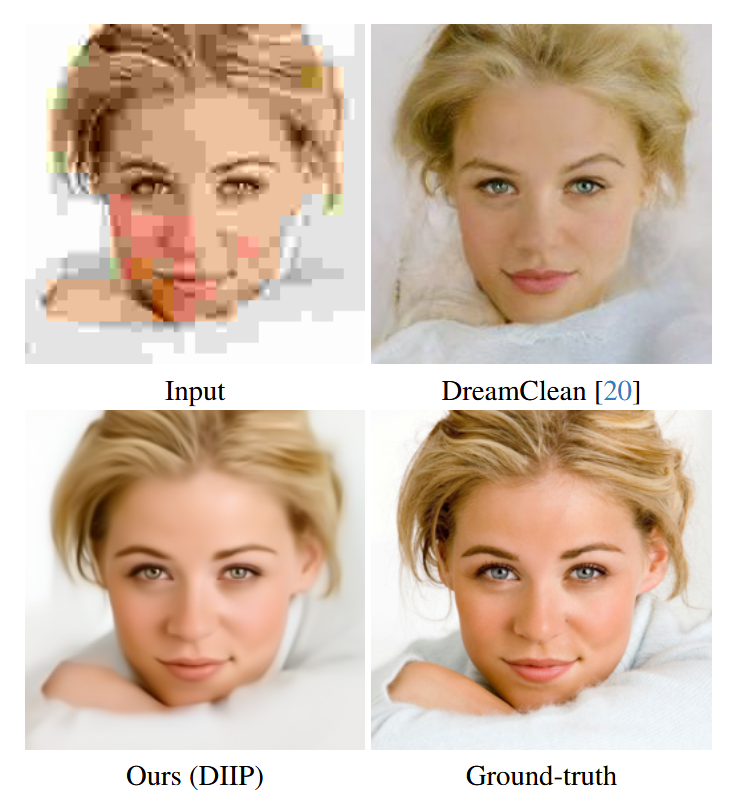
DIIP 的核心特点是 dataset training-free、zero-shot 和 fully blind,即恢复阶段不需要针对具体任务重新训练,也不要求知道退化模型的形式或参数。论文主要贡献可以概括为三点:首先,研究了冻结预训练扩散模型在退化图像重建过程中的隐式先验行为,证明其具有类似 DIP 但覆盖范围更广的“先恢复干净图像、后拟合退化”的优化特性;其次,在此基础上提出 fully blind 图像恢复方法 DIIP,通过优化扩散模型输入噪声实现恢复;最后,设计两类自监督 Early Stopping 机制,并在去噪、超分辨率、JPEG 去伪影、水滴去除和非均匀形变等任务上取得具有竞争力的结果。
2. 相关工作
2.1 Test-Time Image Restoration
论文主要从 Test-Time Image Restoration 的角度梳理现有方法。这类方法不针对当前恢复任务重新进行监督训练,而是在测试阶段直接利用退化图像和已有模型完成恢复。根据对退化模型信息的依赖程度,可以进一步分为非盲、部分盲和完全盲三种情况。
非盲方法假设退化模型完全已知,例如图像去模糊时需要明确知道模糊核。DDRM、DDNM 和 DPS 等方法均属于这一范畴,它们利用扩散模型作为生成先验,同时借助已知退化算子进行后验采样或逆问题求解。这类方法在已知退化条件下能够取得较好的恢复效果,但对退化模型完整知识的依赖限制了其真实场景适应性。
部分盲方法进一步放宽条件,不再要求知道退化模型的具体参数,但通常仍需要知道其参数化形式。GibbsDDRM 将 DDRM 扩展到部分未知退化场景,BlindDPS 在逆扩散过程中联合估计模糊算子与清晰图像,BIRD 则通过扩散模型快速反演同时推断退化模型。这类方法相比非盲方法具有更强的适应性,但本质上仍依赖对退化形式的先验假设。DIIP 与这些方法的根本区别在于,DIIP 不要求知道退化属于哪种数学模型,也不需要显式构造 degradation operator,而是直接利用冻结扩散模型自身的隐式先验完成恢复。
2.2 Fully-Blind Image Restoration
完全盲图像恢复假设退化模型的形式和参数均未知。DIP 是这一方向中的经典代表,它通过未训练 CNN 的结构先验实现单图像恢复,不需要显式退化模型,也不依赖外部训练数据。然而 DIP 的图像先验来源主要是网络结构本身,因此先验能力相对有限。
DreamClean 是另一种基于预训练扩散模型的 fully blind 方法。DreamClean 通过输入图像反演以及逆扩散过程完成恢复,而 DIIP 的方法出发点更接近 DIP:它直接把预训练扩散模型视为一个固定的从噪声空间到图像空间的生成映射,并通过优化输入噪声,使生成图像逐渐逼近退化观测。
从方法关系上看,DIP 与 DIIP 都依赖测试时优化和 Early Stopping。DIP 固定随机输入并优化未训练 CNN 参数,而 DIIP 固定预训练扩散模型并优化其输入噪声。两者都利用了“优化轨迹中存在最佳恢复阶段”这一现象,只是 DIP 的先验来自网络结构,而 DIIP 的先验来自预训练扩散模型学习到的自然图像分布。
3. 方法
3.1 图像恢复问题定义
论文将图像恢复写成经典能量最小化形式:
x∗=argminxE(x;y)+R(x) x^*=\arg\min_x E(x;y)+R(x) x∗=argxminE(x;y)+R(x)
其中,y 表示退化输入图像,x 表示待恢复的干净图像,E(x;y) 是数据保真项,用于衡量恢复结果与观测图像之间的一致性,R(x) 则表示图像先验或正则项。传统方法通常显式定义 R(x),例如总变分、稀疏先验或低秩先验,而 DIP 和 DIIP 都使用隐式先验的形式。
论文采用 DDIM 作为基础生成模型,并将其确定性噪声到图像映射记为:
g:z→x g:z\rightarrow x g:z→x
给定输入噪声 z,扩散模型输出图像 g(z)。DIIP 的优化目标写为:
z∗=argminz∥g(z)−y∥22 z^*=\arg\min_z\|g(z)-y\|_2^2 z∗=argzmin∥g(z)−y∥22
最终恢复结果为:
x∗=g(z∗) x^*=g(z^*) x∗=g(z∗)
这里的关键在于,DIIP 的目标函数并没有显式包含去噪、去模糊或超分辨率对应的 degradation operator,而是直接要求扩散模型输出逼近退化图像。其恢复能力主要来自优化过程中扩散模型表现出的隐式图像先验,而不是目标函数中显式加入的退化逆模型。
3.2 从 Deep Image Prior 到 Diffusion Image Prior
DIP 的基本优化形式为:
θ∗=argminθ∥fθ(z)−y∥22 \theta^*=\arg\min_\theta\|f_\theta(z)-y\|_2^2 θ∗=argθmin∥fθ(z)−y∥22
其中输入 z 固定,优化对象是未训练 CNN 的参数 θ。DIIP 则将这种优化关系反转:
z∗=argminz∥g(z)−y∥22 z^*=\arg\min_z\|g(z)-y\|_2^2 z∗=argzmin∥g(z)−y∥22
扩散模型 g 的参数在整个恢复过程中保持冻结,真正被优化的是输入噪声 z。因此,两种方法虽然目标都是重建退化图像,但先验来源完全不同:DIP 依赖未训练 CNN 的结构偏置,DIIP 则依赖预训练扩散模型已经学习到的自然图像分布。
| 方法 | 模型状态 | 固定部分 | 优化对象 | 图像先验来源 |
|---|---|---|---|---|
| DIP | 未训练 CNN | 输入噪声 z | 网络参数 θ | CNN 网络结构 |
| DIIP | 预训练扩散模型 | 模型参数 | 输入噪声 z | 预训练自然图像分布 |
为了验证这种先验是否真实存在,论文使用 Gaussian Noise 和 Gaussian Blur 两类退化进行实验。前者属于加入高频信息,后者属于去除高频信息。结果表明,冻结预训练扩散模型在两类退化下均呈现出较稳定的两阶段优化过程。第一阶段中,生成图像逐渐变得自然、清晰,并向真实干净图像靠近;第二阶段中,模型继续优化后开始拟合退化输入,例如噪声逐渐重新出现,模糊程度也逐渐加重。相比之下,DIP 在噪声情况下也存在明显的先恢复后过拟合现象,但在模糊退化下难以稳定产生清晰中间结果。
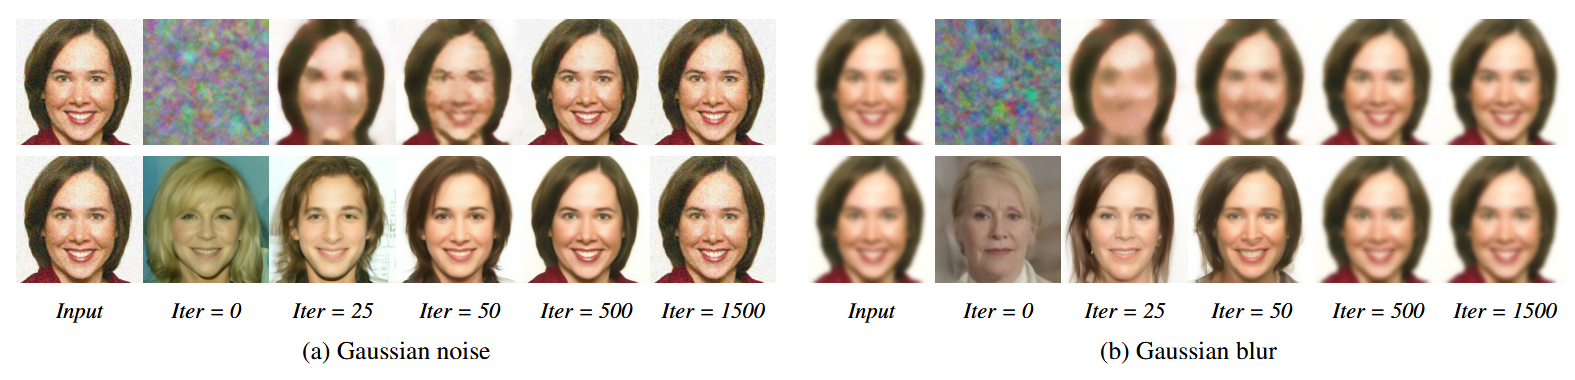
由图可以看到,DIIP 的优化过程大致可以分成两个阶段:
随机生成→干净自然图像→最佳恢复结果→逐渐拟合退化图像 \text{随机生成} \rightarrow \text{干净自然图像} \rightarrow \text{最佳恢复结果} \rightarrow \text{逐渐拟合退化图像} 随机生成→干净自然图像→最佳恢复结果→逐渐拟合退化图像
因此,DIIP 的核心问题进一步转化为:如何在没有 Ground Truth 的情况下找到最佳 Early Stopping 位置。
3.3 高频退化的自监督停止准则
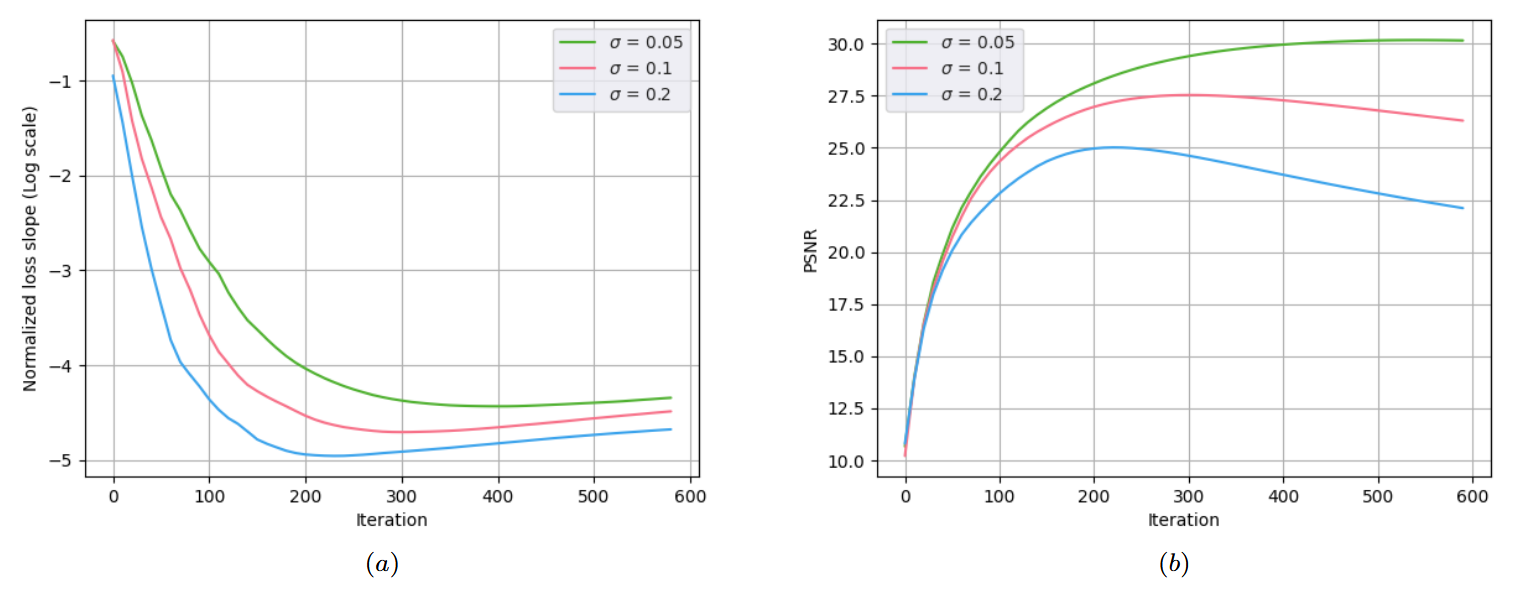
对于噪声等引入高频信息的退化,论文观察到,优化初期模型会快速重建主要图像结构,损失明显下降;随着结构信息逐渐恢复完成,模型对高频噪声的拟合速度变慢,此时损失下降幅度逐渐减小。论文据此定义归一化损失变化:
Δk=E(zk;y)−E(zk−1;y)E(zk−1;y) \Delta_k= \frac{E(z^k;y)-E(z^{k-1};y)} {E(z^{k-1};y)} Δk=E(zk−1;y)E(zk;y)−E(zk−1;y)
其中,k 表示当前迭代次数。实验表明,归一化 Loss Slope 达到特定低值的位置与 PSNR 峰值位置高度对应,因此当:
Δk<ϵ \Delta_k<\epsilon Δk<ϵ
时停止优化,可以在没有 Ground Truth 的情况下较准确地定位最佳恢复阶段。
3.4 低频退化的自监督停止准则
对于模糊等去除高频信息的退化,Loss Slope 不再能够稳定反映最佳停止点,因此论文采用 Laplacian Variance 衡量图像清晰度变化。定义第 k 次迭代恢复结果的清晰度为:
σ2[k]=LV(g(zk)) \sigma^2[k]=LV(g(z^k)) σ2[k]=LV(g(zk))
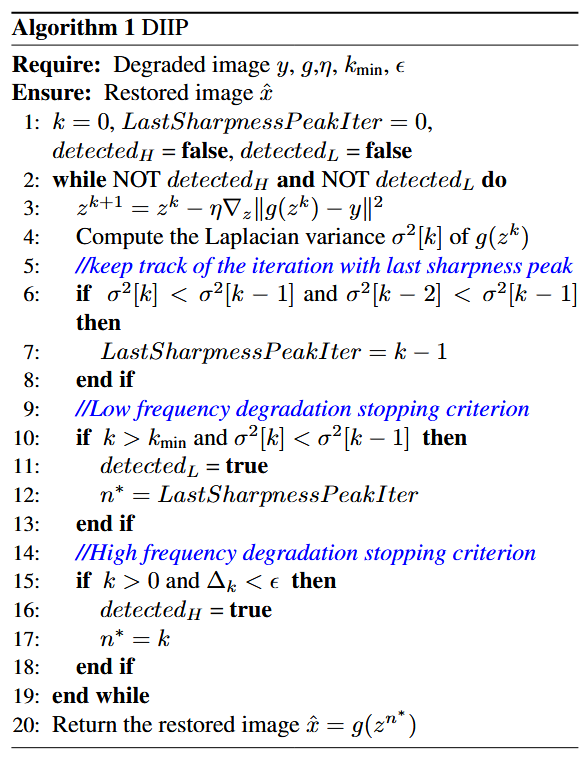
其中,LV 表示 Laplacian Variance。论文并不直接使用清晰度绝对值,而是跟踪其随迭代变化的趋势。在第一阶段,生成图像逐渐变得清晰,Laplacian Variance 通常保持较高水平;进入过拟合阶段后,模型开始重新拟合模糊退化,图像清晰度下降,Laplacian Variance 也随之下降。为了排除优化初期的瞬态变化,论文引入最小迭代次数 k_min。当迭代次数超过 k_min 且清晰度开始下降时停止优化,并返回最近一次 Sharpness Peak 对应的中间结果。
3.5 DIIP 完整算法流程
DIIP 的完整算法可以概括为“随机初始化噪声—梯度优化噪声—监测两类停止条件—输出最佳中间结果”。给定退化图像 y、冻结扩散模型 g、学习率 η、最小迭代次数 k_min 和阈值 ε,首先随机初始化噪声 z^0,随后每次迭代更新输入噪声,同时计算当前恢复结果的 Laplacian Variance 和 Loss Slope。若低频退化条件触发,则返回最近一个清晰度峰值对应结果;若高频退化条件触发,则返回当前迭代结果。整个过程中扩散模型参数始终保持冻结,因此 DIIP 并不是对扩散模型进行重新训练,而是在固定生成空间中搜索一个合适的输入噪声。
4. 实验
4.1 实验设置
论文在 ImageNet 1K 和 CelebA 1K 图像上进行实验,输入分辨率统一设置为:
256×256 256\times256 256×256
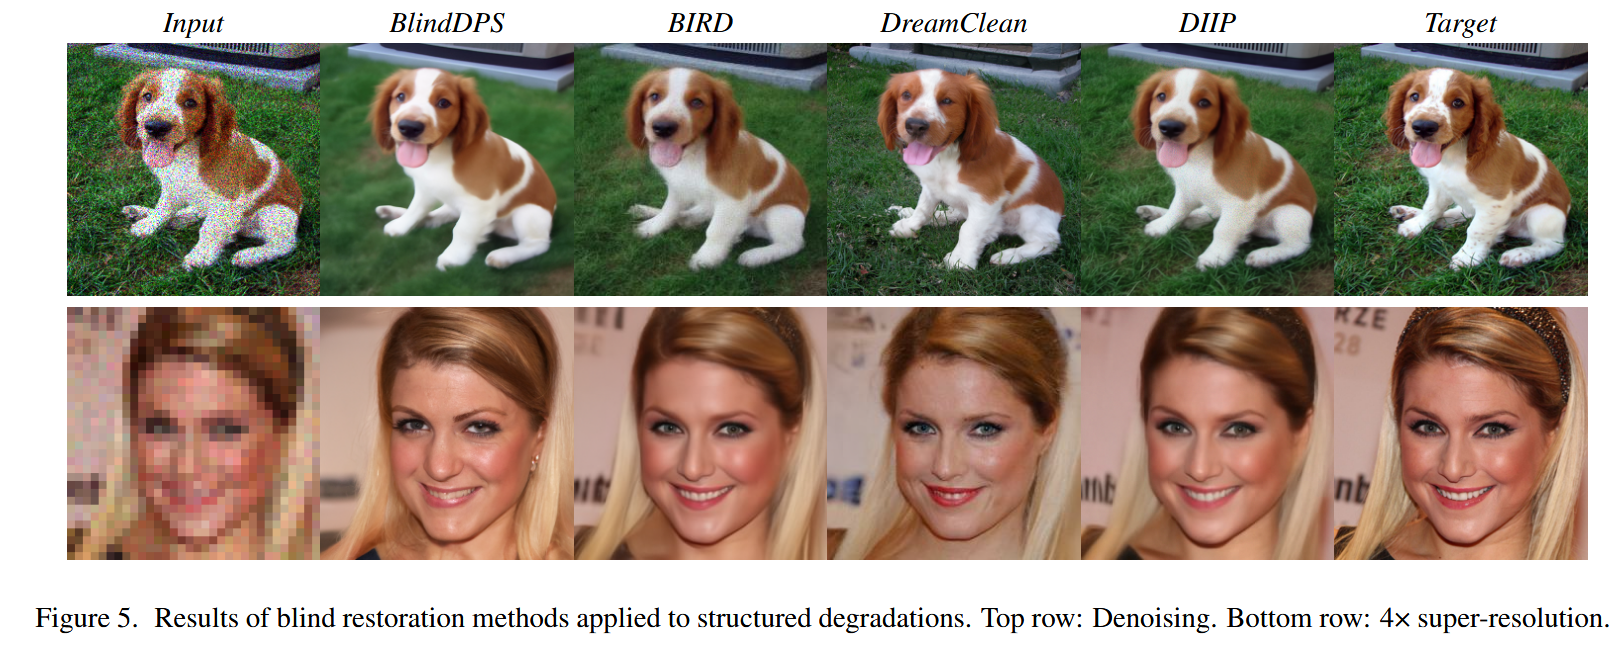
CelebA 实验采用 CelebA 上预训练的扩散模型,ImageNet 实验采用 ImageNet 上预训练的扩散模型,并保证对比方法使用相同预训练模型以维持公平性。评价指标包括 PSNR、SSIM 和 LPIPS,其中 PSNR 与 SSIM 越高越好,LPIPS 越低越好。对比方法包括 partially-blind 方法 BlindDPS、GDP、BIRD、GibbsDDRM,以及 fully-blind 方法 DIP 和 DreamClean。实验任务覆盖结构化退化和复杂非结构化退化,其中结构化任务包括图像去噪和超分辨率,非结构化任务包括 JPEG 去伪影、非均匀形变和水滴去除。
超分辨率实验使用 Gaussian Blur 加下采样构造退化,去噪任务采用 Gaussian 与 Speckle Noise 的混合噪声,JPEG 去伪影使用质量因子 q=5,所有任务额外加入 σ=0.02 的高斯噪声。DIIP 默认设置为:
kmin=100 k_{\min}=100 kmin=100
ϵ=0.001 \epsilon=0.001 ϵ=0.001
优化器采用 Adam,学习率为:
0.0015 0.0015 0.0015
4.2 结构化图像恢复结果
在 CelebA 上的结构化恢复实验中,DIIP 在去噪任务上取得 28.37 dB 的 PSNR、0.842 的 SSIM 和 0.224 的 LPIPS,三项指标均优于表中其他方法。相比传统 DIP 的 25.81 dB,DIIP 在去噪 PSNR 上提升 2.56 dB;相比 DreamClean 的 27.05 dB,也取得明显提升。在 4× 超分辨率任务上,DIIP 的 PSNR 为 25.14 dB,略低于 BIRD 的 25.26 dB,但仍明显优于 DIP、DreamClean、GDP、GibbsDDRM 和 BlindDPS。在 8× 超分辨率任务中,DIIP 达到 22.86 dB,为所有方法中的最高结果。
| 方法 | Denoising PSNR ↑ | SSIM ↑ | LPIPS ↓ | 4× SR PSNR ↑ | 8× SR PSNR ↑ |
|---|---|---|---|---|---|
| GDP | 27.73 | 0.817 | 0.232 | 24.21 | 21.66 |
| GibbsDDRM | 27.38 | 0.809 | 0.255 | 24.38 | 21.45 |
| BIRD | 27.92 | 0.821 | 0.238 | 25.26 | 22.63 |
| BlindDPS | 27.56 | 0.813 | 0.246 | 24.51 | 21.73 |
| DIP | 25.81 | 0.606 | 0.345 | 21.33 | 20.34 |
| DreamClean | 27.05 | 0.771 | 0.236 | 23.44 | 21.33 |
| DIIP | 28.37 | 0.842 | 0.224 | 25.14 | 22.86 |
4.3 非结构化图像恢复结果
非结构化退化更能体现 DIIP 的 fully blind 特性,因为这类退化往往难以用简单参数模型描述。在 JPEG 去伪影任务中,DIP 的 PSNR 为 20.43 dB,DreamClean 为 23.92 dB,而 DIIP 达到 25.29 dB;在非均匀形变任务中,DIP、DreamClean 和 DIIP 分别达到 18.83、22.16 和 23.45 dB;在水滴去除任务中,三者分别为 20.37、22.94 和 23.78 dB。DIIP 在三类非结构化退化上的 PSNR 均为最优,同时在 JPEG 去伪影和非均匀形变任务中也取得更好的 SSIM 与 LPIPS。
| 方法 | JPEG PSNR ↑ | JPEG SSIM ↑ | JPEG LPIPS ↓ | Non-uniform PSNR ↑ | Water-drop PSNR ↑ |
|---|---|---|---|---|---|
| DIP | 20.43 | 0.593 | 0.622 | 18.83 | 20.37 |
| DreamClean | 23.92 | 0.691 | 0.342 | 22.16 | 22.94 |
| DIIP | 25.29 | 0.783 | 0.325 | 23.45 | 23.78 |
其中,DIIP 相比 DIP 在 JPEG 去伪影任务上的 PSNR 提升为:
25.29−20.43=4.86 dB 25.29-20.43=4.86\text{ dB} 25.29−20.43=4.86 dB
这一结果说明,在退化形式复杂且无法显式建模时,预训练扩散模型提供的图像先验明显强于未训练 CNN 的结构先验。
4.4 Early Stopping 消融实验
论文进一步对 k_min 和 ε 两个停止策略超参数进行分析。对于 k_min,当取值从 50 增加到 100 时,非均匀形变 PSNR 从 22.18 dB 提升到 23.45 dB,水滴去除从 22.48 dB 提升到 23.78 dB;继续增大到 150 后,性能仅提升到 23.52 和 23.82 dB,说明 k_min=100 已能够取得较好的恢复质量与效率平衡。
k_min | Non-uniform Deformation | Water-drop Removal |
|---|---|---|
| 50 | 22.18 | 22.48 |
| 100 | 23.45 | 23.78 |
| 150 | 23.52 | 23.82 |
对于高频退化停止阈值 ε,当 ε=0.005 时停止过早,去噪和 JPEG 去伪影 PSNR 分别只有 27.25 和 22.38 dB;当 ε=0.001 时,结果提升到 28.37 和 25.29 dB;进一步减小到 0.0005 后,性能下降到 28.14 和 25.02 dB。论文认为,过大的 ε 会导致模型尚未充分恢复图像结构便提前停止,而过小的 ε 会让优化持续过久并开始拟合高频退化。
ε | Denoising PSNR | JPEG PSNR |
|---|---|---|
| 0.005 | 27.25 | 22.38 |
| 0.001 | 28.37 | 25.29 |
| 0.0005 | 28.14 | 25.02 |
为了评估自动停止策略与理论最优停止点之间的差距,论文还构造了可以访问 Ground Truth 的 Optimal Stopping。去噪任务中,理论最优 PSNR 为 28.63 dB,而 DIIP 自监督策略达到 28.37 dB;水滴去除任务中,两者分别为 23.73 和 23.45 dB,差距约为 0.3 dB。这说明基于 Loss Slope 和 Laplacian Variance 的停止机制能够在没有 Ground Truth 的条件下较准确地定位性能峰值。
4.5 运行效率分析
论文同时比较了不同 Training-Free 方法在 256×256 输入上的运行时间与显存消耗。GDP 平均运行时间为 168 秒、显存占用 1.1 GB,BIRD 为 234 秒和 1.2 GB,BlindDPS 为 270 秒和 6.1 GB,DreamClean 为 125 秒和 1.3 GB,而 DIIP 为 138 秒和 1.2 GB。虽然 DreamClean 的运行时间略低于 DIIP,但 DIIP 在多个任务上的恢复质量更好,同时显存开销较低。
| 方法 | Runtime / s ↓ | Memory / GB ↓ |
|---|---|---|
| GDP | 168 | 1.1 |
| BIRD | 234 | 1.2 |
| BlindDPS | 270 | 6.1 |
| DreamClean | 125 | 1.3 |
| DIIP | 138 | 1.2 |
5. 结论
Diffusion Image Prior 的核心工作并不是简单地将扩散模型应用于图像恢复,而是研究了预训练扩散模型在测试时优化过程中的隐式先验行为。论文发现,当冻结预训练扩散模型并仅优化输入噪声,使生成结果逼近退化图像时,模型并不会立即拟合所有退化信息,而是先生成较干净、自然的中间结果,随后才逐渐向退化观测过拟合。这一现象与 Deep Image Prior 十分相似,但相比 DIP,预训练扩散模型的隐式先验在退化类型上的覆盖范围更广,不仅能够抵抗噪声等高频伪影,也能在模糊等低频退化中产生清晰的中间恢复结果。
在此基础上,论文提出 DIIP,将图像恢复转化为扩散模型输入噪声的优化问题,并通过 Early Stopping 截取最优中间结果。对于高频退化,方法利用 Normalized Loss Slope 判断模型是否开始进入高频信息拟合阶段;对于低频退化,则利用 Laplacian Variance 跟踪图像清晰度变化,并返回最后一个 Sharpness Peak 对应结果。整个方法不依赖显式退化模型,也不需要针对具体恢复任务重新训练,因此能够统一处理去噪、超分辨率、JPEG 去伪影、水滴去除和非均匀形变等多种图像恢复问题。
从方法演进角度看,DIP 和 DIIP 的关系可以概括为:
Deep Image PriorNetwork Architecture Prior \text{Deep Image Prior} \quad \text{Network Architecture Prior} Deep Image PriorNetwork Architecture Prior
⇓ \Downarrow ⇓
Diffusion Image PriorPre-trained Generative Prior \text{Diffusion Image Prior} \quad \text{Pre-trained Generative Prior} Diffusion Image PriorPre-trained Generative Prior
DIP 利用未训练网络结构本身形成隐式先验,而 DIIP 将这种思想进一步扩展到预训练生成模型,通过冻结扩散模型、优化输入噪声和自监督 Early Stopping,将扩散模型已经学习到的自然图像分布转化为图像恢复先验。实验结果表明,这种先验在处理复杂未知退化时具有更强的适用性,也说明预训练扩散模型除了作为条件生成模型和后验采样器之外,还可以被直接视为一种隐式图像恢复先验。


 扫一扫


 34

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


