[论文阅读]Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection

Deep Relational Reasoning Graph Network for Arbitray shape Text Detection阅读笔记 Deep Relational Reasoning Graph Network for Arbitrary shape Text Detection 深度关系推理图网络用于任意形状文本检测 摘要 提出了一种新颖的统一关系推理图网络用于任意形状文本检测。在我们的方法中,一个新颖的局部图连接一个文本建议模型(CNN)和一个深度关系推理网络(GCN)使得我们的网络端到端可训练。更具体的说,每一个文本实例将被分成一系列小的矩形组件,小的矩形组件的几何特征(高度,宽度,方向)通过我们的文本建议模型估计。通过几何特征, 阅读详情

[论文阅读]Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection
用于任意形状文本检测的深度关系推理图网络

文章收录于2020 CVPR
[论文地址]https://arxiv.org/abs/2003.07493
[代码地址]https://github.com/GXYM/DRRG

摘要

本文针对形状文本检测提出了一种新的统一关系推理图网络。局部图(local graph)建立起了基于CNN的text proposal模型和基于GCN(Graph Convolutional Network)的深度关系推理网络之间的关系,使模型可以端到端训练。


简介

目前一些方法,例如TextSnake[17]和CRAFT[1]为了解决任意形状文本检测,采用了Connected Component (CC)策略(一些列的组件定位字符,最后合并组件)。这样的缺点就是,无法获得文字组件之间的更丰富的关系,从而无助于文本实例的划分。

对于CC策略来讲,一项重要的工作就是划分文本实例。现有的方法常采用:预定义规则(pre-defined rules)、链接映射(link map)、嵌入映射(embedding map)。对于长文本和弯曲文本,一般来讲,链接映射和嵌入映射比预定义规则更加鲁棒。

链接映射与嵌入映射的方法大多基于CNN,且CNN不适合处理这些独立的组件(非欧几里得数据),即不能够从两个不相邻的组件中学习相互之间的关系。

而这些非欧几里得数据可以被表示为图,如图1所示,本文选择一个文本组件作为一个节点,选择一个节点作为中枢,将中枢周围的节点连起来形成局部图。局部图(节点之间的边缘)中包含的上下文信息可为估计枢纽节点与其他节点之间的链接可能性提供信息。
在这里插入图片描述

本文首先将每一个文本实例,切分为文本组件。使用基于CNN的text proposal network预测这些文本组件的几何属性(高、宽、方向),然后利用这些几何属性采用了图卷积网络来执行深度关系推理,从而对这些组件进行分组聚合。


相关工作

基于回归的方法:此类方法使用单词级别(word level)或者行级别(line level)的ground-truth,通过基于框回归的文本检测框架。

  • RRD[11]调整SSD [13]的锚定比,以适应非规则形状的宽高比变化。
  • Textboxes ++ [10]修改了卷积核和锚定框,以有效地捕获各种文本形状。
  • EAST [42]直接推断候选单词的像素级四边形,而无需锚定机制和proposal检测。

基于分割的方法:受语义分割思想的启发,通过估计单词边界区域来检测文本。

  • PixelLink [3]通过预测像素与其相邻像素之间的链接关系,对属于同一实例的像素进行分类。
  • PSENet [30]采用多种尺度渐进扩展网络,利用ground truth生成一系列不同大小的mask,最终提高了不规则文本的检测能力。
  • Tian等人[28]将每个实例文本视为一个聚类,通过嵌入映射对像素进行聚类。
  • TextField [34]采用深度方向域(deep direction field)来链接相邻像素并生成候选文本部分。

基于CC的方法:首先通常检测单个文本部分或字符,然后通过链接或者分组的后续处理生成最终的文本。

  • CTPN [27]使用了一个基于Faster R-CNN [20]修改的网络,来提取具有固定宽度的文本,以轻松连接密集的文本组件并生成水平文本行。
  • SegLink [21]将每个场景文本分解为两个可检测的元素,即段和链接,其中链接指示一对相邻的段属于同一单词。
  • CRAFT [1]通过探索每个字符与字符之间的亲和关系来检测文本区域。
  • TextDragon[4] 首先检测文字的局部区域,然后根据边界框的几何关系对其进行分组

关系推理:对于局部卷积算子的限制,CNN不能直接捕获远距离分量区域之间的关系。最近,Wang等人[33]为了解决这种问题,提出了基于频谱的GCN方法来聚类人脸。在复杂情况下,设计的GCN可以合理地链接属于同一个人的不同面部实例。

方法

概述

首先,通过基于CNN的text proposal network利用共享特征来估计文本组建的几何属性;然后局部图可以大致建立不同文本组建的链接;然后使用深度关系推理网络将进一步推断出文本组件与其相邻组件之间的链接可能性;最后根据推理结果将文本组件聚合为整体的文本实例。

其网络框架如图2所示;文本组件提议网络(text component proposal network)和深层关系推理图网络共享卷积特征,并且共享卷积使用VGG-16 和FPN [12]作为主干,如图3所示。

在这里插入图片描述
在这里插入图片描述

文本组件预测

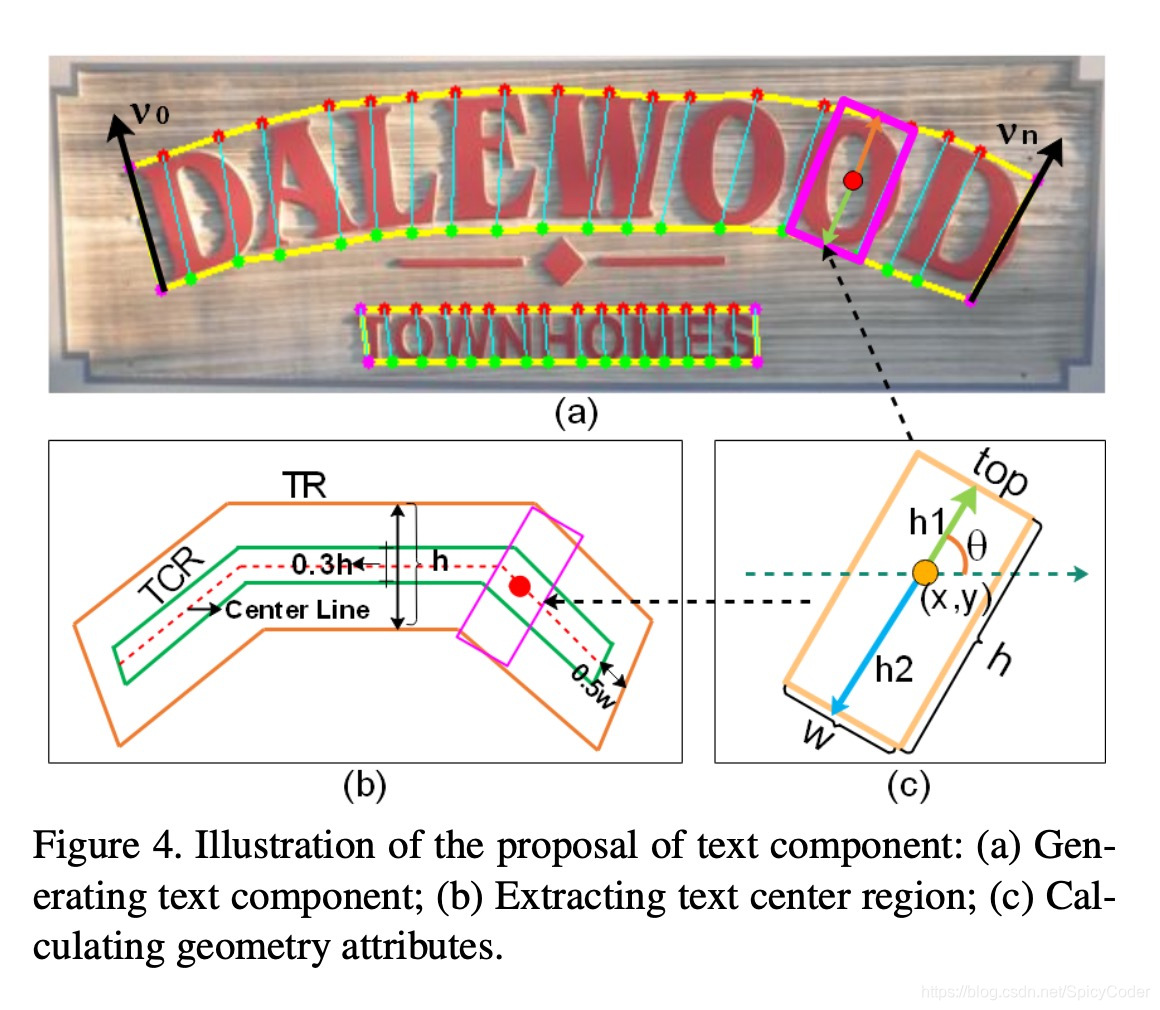
如图4所示,(a)展示了一系列的文本组件,每个文本组件 D D D由(x,y,h,w,sin θ \theta θ,cos θ \theta θ)组成。其中 h h h为文本组件的高度,由(c )图中的h1和h2两部分组成。 w w w则是根据 h h h的大小确定的。
(b)中展示了文本组建的中心域,为了确定文本中心域(text center region 记为TCR)与文本组件的方向,本文采用了[17]中的方法来计算文本域的head和tail,如图4(a)中黑色箭头所示。
在这里插入图片描述
本文根据下列公式确定图4(a)中的上下两组点 P 1 = { t p 0 , t p 1 , . . . , t p i , . . . , t p n } P1= \left\{tp0,tp1,...,tpi,...,tpn\right\} P1={tp0,tp1,...,tpi,...,tpn}和 P 2 = { b p 0 , b p 1 , . . . , b p i , . . . , b p n } P2= \left\{bp0, bp1, ..., bpi, ..., bpn\right\} P2={bp0,bp1,...,bpi,...,bpn}。

p = ∑ i = 0 n sin ⁡ ( v i ) , v i ∈ V p=\sum_{i=0}^{n} \sin \left(v_{i}\right), v_{i} \in V p=i=0∑n​sin(vi​),vi​∈V
其中 V = { t p 0 − b p 0 , . . . , t p i − b p i , . . . , t p n − b p n } V = \left\{tp0 − bp0,...,tpi − bpi,...,tpn − bpn\right\} V={tp0−bp0,...,tpi−bpi,...,tpn−bpn},向量 v i v_i vi​的角度表示文本分量的方向 θ θ θ

TCR是通过缩小文本域(text region 记为TR)得到的,其计算步骤:1. 计算文本中心行 2.将中心行两端缩小0.5 w w w像素,使网络更容易分离相邻的文本实例并降低NMS的计算成本。 3.将文本中心行高度扩展0.3 h h h。

再提取共享特征之后,通过两个卷积层来计算CR(Classification and Regression),即文本组件的几何属性, C R = conv ⁡ 1 × 1 ( conv ⁡ 3 × 3 ( F share ) ) C R=\operatorname{conv}_{1 \times 1}\left(\operatorname{conv}_{3 \times 3}\left(F_{\text {share}}\right)\right) CR=conv1×1​(conv3×3​(Fshare​))
其中CR是一个 H ∗ W ∗ 8 H*W*8 H∗W∗8大小的张量,带有4个通道的TR / TCR分类结果和4个通道的 h 1 , h 2 , c o s θ , s i n θ h1,h2,cos\theta,sin\theta h1,h2,cosθ,sinθ的回归结果。

通过Softmax TR / TCR并将平方和等于1的cosθ和sinθ正则化来获得最终预测。最终的结果通过阈值与正样本上的位置感知NMS产生。(TODO 不是很明白 )

局部图生成

本文对每一张图片生成了多个局部图,每个局部图拥有有限个节点。本文修改了IPS[33]来生成局部图,中枢节点附近的节点按照 h h h- h o p hop hop方法选择。例如: 1 1 1- h o p hop hop为中枢节点的最近8邻域节点; 2 2 2- h o p hop hop为中枢节点的最近4邻域节点。高阶的邻居节点提供了枢纽与其邻居之间上下文的局部结构的辅助信息,但此处本文只考虑每个形成KNN操作的节点之间的欧氏相似性 E s Es Es,计算方法为
E s = 1 − D ( p , v i ) / max ⁡ ( H m , W m ) , v i ∈ V p E_{s}=1-D\left(p, v_{i}\right) / \max \left(H_{m}, W_{m}\right), v_{i} \in V_{p} Es​=1−D(p,vi​)/max(Hm​,Wm​),vi​∈Vp​
其中 D ( p , v i ) D(p,vi) D(p,vi)是中枢 p p p与节点 v i v_i vi​之间的L2距离, H m H_m Hm​是图像的高度, W m W_m Wm​是图像的宽度。

为避免训练中许多相同图形导致容易样本的累积积累,枢轴p应满足以下条件:
G i o u = G p ∩ G q G p ∪ G q < ξ , p , q ∈ T G_{i o u}=\frac{G_{p} \cap G_{q}}{G_{p} \cup G_{q}}<\xi, p, q \in T Giou​=Gp​∪Gq​Gp​∩Gq​​<ξ,p,q∈T
G p G_p Gp​和 G q G_q Gq​代表两个局部图,中枢 p p p与中枢 q q q是属于同一文本实例 T T T,分子与分母分别是两个局部图的 1 1 1- h o p hop hop的交集与并集。

深度关系推理

局部图中包含的粗略链接信息(节点之间的边)对于估计枢轴及其邻居之间的链接可能性很有用。在局部图的基础上,本文采用基于GCN的深度关系推理网络来推断中枢与其邻域节点的链接可能性。图通常表示为 g ( X , A ) g(X,A) g(X,A), X X X为特征矩阵, A A A为邻接矩阵。

在这里插入图片描述

Node Feature Extraction

如图5中灰色矩形框所示,输入节点特征框需要由两个部分组成:上面分支的几何特征和中间分支的RROI特征。

其中RROI特征的输入为图3中的 F n Fn Fn,然后可以得到一个 1 × 3 × 4 × C r 1 \times 3 \times 4 \times C_{r} 1×3×4×Cr​大小的张量,进一步reshape成为 1 × 12 ⋅ C r 1\times12\cdot{C_r} 1×12⋅Cr​二维张量,记作 F r F_r Fr​。

文本组件的几何属性根据[29]和[5]被嵌入到高维度空间,嵌入是通过将不同波长的正弦和余弦函数应用到标量 z z z,
ε 2 i ( z ) = cos ⁡ ( z 100 0 2 i / C ε ) , i ∈ ( 0 , C ε / 2 − 1 ) ε 2 i + 1 ( z ) = sin ⁡ ( z 100 0 2 i / C ε ) , i ∈ ( 0 , C ε / 2 − 1 ) \begin{array}{c}\varepsilon_{2 i}(z)=\cos \left(\frac{z}{1000^{2 i / C_{\varepsilon}}}\right), i \in\left(0, C_{\varepsilon} / 2-1\right) \\ \varepsilon_{2 i+1}(z)=\sin \left(\frac{z}{1000^{2 i / C_{\varepsilon}}}\right), i \in\left(0, C_{\varepsilon} / 2-1\right)\end{array} ε2i​(z)=cos(10002i/Cε​z​),i∈(0,Cε​/2−1)ε2i+1​(z)=sin(10002i/Cε​z​),i∈(0,Cε​/2−1)​
其中,嵌入向量 ϵ ( z ) {\epsilon}(z) ϵ(z)的维数为 C ϵ C_{\epsilon} Cϵ​,结果是每一个文本组件都被嵌入到向量 F g F_g Fg​中,其维度为 6 ⋅ C ϵ 6\cdot C_{\epsilon} 6⋅Cϵ​。

最终, F g F_g Fg​与 F r F_r Fr​执行Concat操作,作为节点特征。

Node Feature Normalization
为了更好地将中枢 p p p的特征编码至局部图中且为了更容易地学习到中枢与其邻居节点之间的链接可能性,本文将进行节点特征的归一化。
F p = [ … , x q − x p , … ] T , q ∈ V p \mathbf{F}_{p}=\left[\ldots, x_{q}-x_{p}, \ldots\right]^{T}, q \in V_{p} Fp​=[…,xq​−xp​,…]T,q∈Vp​
其中, x p x_p xp​是中枢 p p p的特征, q q q是属于以 p p p为中枢的局部图 V p V_p Vp​的节点。

Adjacency Matrix Generation
本文使用邻接矩阵 A p ∈ ℜ N ∗ N A_{p} \in \Re^{N * N} Ap​∈ℜN∗N来代表局部图。

Graph Convolutions
再得到了上述的 X X X和 A A A之后,本文采用基于图的关系推理网络。本文修改了[33]和[8]的结构,图卷积层的计算如下:
Y ( l ) = σ ( ( X ( l ) ⊕ G X ( l ) ) W l ) G = D ~ − 1 / 2 A ~ D ~ − 1 / 2 \begin{array}{c}\mathbf{Y}^{(l)}=\sigma\left(\left(\mathbf{X}^{(l)} \oplus \mathbf{G} \mathbf{X}^{(l)}\right) \mathbf{W}^{l}\right) \\ \mathbf{G}=\tilde{\mathbf{D}}^{-1 / 2} \tilde{\mathbf{A}} \tilde{\mathbf{D}}^{-1 / 2}\end{array} Y(l)=σ((X(l)⊕GX(l))Wl)G=D~−1/2A~D~−1/2​
其中, X ( l ) ∈ ℜ N × d i , Y ( l ) ∈ ℜ N × d o \mathbf{X}^{(l)} \in \Re^{N \times d_{i}}, \mathbf{Y}^{(l)} \in \Re^{N \times d_{o}} X(l)∈ℜN×di​,Y(l)∈ℜN×do​, d i / d o d_{i} / d_{o} di​/do​是输入/输出节点的维度, N N N是节点个数, G \mathbf{G} G是 N × N N\times N N×N的对称归一化拉普拉斯算子, ⊕ \oplus ⊕是矩阵concatenation操作, W ( l ) W^{(l)} W(l)是特定层的可训练权重矩阵, σ ( ⋅ ) \sigma(\cdot) σ(⋅)是非线性激活函数, A ~ = A + I N \tilde{A}=A+I_{N} A~=A+IN​是邻接矩阵加上自连接,即 I N I_N IN​是单位矩阵; D ~ \tilde{\mathbf{D}} D~是对角矩阵 D ~ i i = ∑ j A ~ i j \tilde{D}_{i i}=\sum_{j} \tilde{A}_{i j} D~ii​=∑j​A~ij​。

本文中的深度推力模型由一个Batch Normalization层、4个接着ReLu的图卷积层组成,采用了softmax交叉熵损失。

推理阶段

  • 根据关系推理结果,对文本组件分组
  • 首先将阈值分别应用于TR和TCR,然后使用NMS减少冗余
  • 遍历所有文本组件,以每个组件为中心构造一个局部图,因此获得了由链接可能性加权的一组边
  • 使用宽度优先搜索BFS对链接进行聚类和合并
  • 应用MinPath算法搜索所有文本组件中心的最短路径,然后通过搜索结果对实例T的各个组件进行排序
  • 顺序地在有序文本组件中链接顶部和底部的中点,即可得到文本边界

实验

消融研究

在这里插入图片描述
使用关系推理网络后,在Total-Text、CTW1500和TD500数据集上,Hmean比baseline分别提升1.83%、0.78%和4.27%。在Recall上分别提升3.05%、0.88%和3.78%。

使用关系推理网络在TD500上的检测性能明显提高,但在CTW1500上并不明显,原因是CTW1500的标注是令人迷惑的,一些小文本没有标注,还有一些标注划分不合理,如图6所示。
在这里插入图片描述

与最优模型对比

在这里插入图片描述
在这里插入图片描述
多边形数据集:

  • Total-Text
    如图7所示,本文提出的方法可以很好地检测细小的弯曲文本并且可以很好地划分排布紧密的文本。定量指标在Hmean上达到了85.73%,如表2所示。

  • CTW1500
    本文方法同样在CTW1500上可以精准的检测文本边界,定量上达到了recall(83.02%),Hmean(84.45%)。

四边形数据集:本文针对此类数据集,将结果转化为矩形,使用最小的矩形进行评估。

  • MSRA-TD500
    该数据集中包含很多长文本,本文方法可以成功地检测出任意形状、方向的长文本,如图7所示。
    定量结果在Hmean上达到了85.08%。

  • ICDARs (IC15, IC17)
    IC15包含很多低分辨率和小文本实例;IC17包含很多多语言场景图像和单词级别标注。
    定量结果如表3和表4所示,在IC15和IC17的Hmean指标上分别达到了86.56%和67.31%。
    在这里插入图片描述
    在这里插入图片描述

总结

本文提出新的基于组件连接(CC)策略的文本检测方法。提出了基于图卷积的深度关系推理网络,来学习文本组件之间的链接可能性。

本文实验不仅在任意形状文本的数据集上表现出优越的检测精度,而且也适合定向和多语言文本检测。

遗憾的是,目前仅仅实现了检测功能,下一阶段应该完成端到端的文本阅读方法。

参考文献

[17] Shangbang Long, Jiaqiang Ruan, Wenjie Zhang, Xin He, Wenhao Wu, and Cong Yao. Textsnake: A flexible repre- sentation for detecting text of arbitrary shapes. In ECCV, pages 19–35, 2018. 1, 2, 3, 4, 7, 8
[1] Youngmin Baek, Bado Lee, Dongyoon Han, Sangdoo Yun, and Hwalsuk Lee. Character region awareness for text de- tection. In CVPR, pages 9365–9374, 2019. 1, 2, 3, 7, 8
[11] Minghui Liao, Zhen Zhu, Baoguang Shi, Gui-Song Xia, and Xiang Bai. Rotation-sensitive regression for oriented scene text detection. In CVPR, pages 5909–5918, 2018. 2
[13] Wei Liu, Dragomir Anguelov, Dumitru Erhan, Christian Szegedy, Scott E. Reed, Cheng-Yang Fu, and Alexander C. Berg. SSD: Single shot multibox detector. In ECCV, pages 21–37, 2016. 2
[10] Minghui Liao, Baoguang Shi, and Xiang Bai. Textboxes++: A single-shot oriented scene text detector. IEEE Transac- tions on Image Processing, 27(8):3676–3690, 2018. 2, 8
[42] Xinyu Zhou, C.Yao, He Wen, Yuzhi Wang, Shuchang Zhou, Weiran He, and Jiajun Liang. EAST: An efficient and accu- rate scene text detector. In CVPR, pages 2642–2651, 2017. 1, 2, 8
[3] Dan Deng, Haifeng Liu, Xuelong Li, and Deng Cai. Pix- elLink: Detecting scene text via instance segmentation. In AAAI, pages 6773–6780, 2018. 2, 8
[30] Wenhai Wang, Enze Xie, Xiang Li, Wenbo Hou, Tong Lu, Gang Yu, and Shuai Shao. Shape robust text detection with progressive scale expansion network. In CVPR, pages 9336– 9345, 2019. 2, 7, 8
[28] ZhuotaoTian,MichelleShu,PengyuanLyu,RuiyuLi,Chao Zhou, Xiaoyong Shen, and Jiaya Jia. Learning shape-aware embedding for scene text detection. In CVPR, pages 4234– 4243, 2019. 2, 7, 8
[34] Yongchao Xu, Yukang Wang, Wei Zhou, Yongpan Wang, Zhibo Yang, and Xiang Bai. Textfield: Learning a deep di- rection field for irregular scene text detection. IEEE Trans. Image Processing, 28(11):5566–5579, 2019. 2, 7, 8
[27] ZhiTian,WeilinHuang,TongHe,PanHe,andYuQiao.De- tecting text in natural image with connectionist text proposal network. In ECCV, pages 56–72, 2016. 1, 2
[20] ShaoqingRen,KaimingHe,RossB.Girshick,andJianSun. Faster R-CNN: Towards real-time object detection with re- gion proposal networks. IEEE Trans. Pattern Anal. Mach. Intell., 39(6):1137–1149, 2017. 2, 4
[21] Baoguang Shi, Xiang Bai, and Serge J. Belongie. Detect- ing oriented text in natural images by linking segments. In CVPR, pages 3482–3490, 2017. 1, 2, 7, 8
[4] Wei Feng, Wenhao He, Fei Yin, Xu-Yao Zhang, and Cheng- Lin Liu. Textdragon: An end-to-end framework for arbitrary shaped text spotting. In ICCV, pages 9075–9084, 2019. 2, 7
[33] Zhongdao Wang, Liang Zheng, Yali Li, and Shengjin Wang. Linkage based face clustering via graph convolution net- work. In CVPR, pages 1117–1125, 2019. 2, 3, 4, 5, 6
[12] Tsung-Yi Lin, Piotr Dolla ́r, Ross B. Girshick, Kaiming He, Bharath Hariharan, and Serge J. Belongie. Feature pyramid networks for object detection. In CVPR, pages 936–944, 2017. 3
[29] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszko- reit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. Attention is all you need. In NeurIPS, pages 5998–6008, 2017. 5
[5] Jiayuan Gu, Han Hu, Liwei Wang, Yichen Wei, and Jifeng Dai. Learning region features for object detection. In ECCV, pages 392–406, 2018. 5
[8] Thomas N. Kipf and Max Welling. Semi-supervised classi- fication with graph convolutional networks. In ICLR, 2017. 5
DRRG:Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection解读(1) 前言 关于DRRG网上资料比较少,但是其实作为CVPR最新的成果大家的期待度还是挺高的。我个人在学习的时候就很苦恼,所以处于将心比心,这里将学习心得为大家写下来。 结构 首先,毋庸置疑的DRRG是一个端到端的网络。这正是我们深度学习所追求的效果,端到端能有效地加快模型速度。其次,整个模型被分为两个部分:基于CNN的文本建议网络和基于GCN的关系推理网络。这里我们上图: 关于这个图,我要解释一下:首先基于CNN的文本建议网络只到CR箭头那里,也就是说CNN的文本建议网络的输出为:HW8(带有4个通道的TR 阅读详情

相关推荐

基于图学习与推理的推荐系统,CIKM2019,graph-for-recommendation.zip

【CIKM2019教程】新加坡国立大学:基于图学习与推理的推荐系统,新加坡国立大学三位学者在国际会议CIKM2019上完成题为"Learning and Reasoning on Graph for Recommendation"的大会报告。以下附上这份报告的演讲稿,欢迎大家下载学习。

Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection

Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection 一,Overview 二,文本组件预测: ①首先每个文本组件D与一组几何属性相关联,即D=(x, y, h, w, cosθ, sinθ),其中x和y表示文本框的坐标轴,w和h表示文本组件的高度和宽度。 cosθ和sinθ表示的是文本组件的方向。如图所示: ②文本中心区域(TCR):通过缩小文本区域获得(TR),首先,计...

m0_46434334的博客 722

白色六边形PPT背景图片.zip

这是一张白色六边形PPT背景图片,第一PPT模板网提供精美多边形幻灯片背景图片免费下载; 关键词:白色PowerPoint背景图片,精美六边形PPT背景图片免费下载,.PPTX格式;

DRRG翻译.Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection

摘要 由于场景文本的多样性和复杂性,任意形状文本检测是一项具有挑战性的任务。在本文中,我们提出了一种新颖的统一关系推理图网络用于任意形状的文本检测。在我们的方法中,一个独创的局部图构建了文本建议模型,通过卷积神经网络(CNN)和基于图关系卷积网络的深度关系推理网络(GCN),使我们的网络达到端到端训练。具体来说,每个文本实例都将分成一系列小的矩形组件,小组件的几何属性(例如高度,宽度和方向)将通过文本目标模型进行估算。给定几何属性,局部图构造模型可以大致建立不同文本组件之间的联系,为了进一步的推理并推论组件

weixin_44929101的博客 2059

一文读懂GAN, pix2pix, CycleGAN和pix2pixHD

本文翻译、总结自朱俊伟的线上报告,主要讲了如何用机器学习生成图片。 来源:Games2018 Webinar 64期 :Siggraph 2018优秀博士论文报告 人员信息 主讲嘉宾 姓名:朱俊彦(Jun-Yan Zhu) 现状:麻省理工学院博士后(PostDoc at MIT),计算机科学与人工智能实验室(Computer Science and Artificial In...

gdymind的博客 6万+

REST-meta-MDD Data总结

sMRI数据使用:nwc1、nwc2、nwc3(同样数据集相关论坛中有相关信息指向需要使用wc1、wc2、wc3)多方咨询与讨论后决定使用nwc数据,这里说明wc数据相对wc数据要大的多如wc1的大小为1.33GB,而nwc1的数据却有6.90GB。VBM文件:/REST-meta-MDD/Sharing/REST-meta-MDD-VBM- phase1 -Sharing.tar.gz。1、Excel中的表型信息:1-男,2-女;-9999或空白表示缺少数据。

2404_88295660的博客 1519

探索文本检测新境界:DRRG深度关系推理图网络

探索文本检测新境界:DRRG深度关系推理图网络 DRRGDeep relational reasoning graph network for arbitrary shape text detection; Accepted by CVPR 2020 (Oral). http://arxiv.org/abs/2003.07493项目地址:https://gitcode.com/gh_mi...

gitblog_00035的博客 824

Transformer——从原理、模型架构到内部细节介绍

Transformer模型是一种基于注意力机制的深度学习模型,最早由Google在2017年的论文《AttentionIsAllYouNeed》中提出。自其问世以来就迅速席卷了自然语言处理他(NLP)领域,并在各类主流任务上取得了新的突破,包括机器翻译、语言建模、序列标注和文本分类等。在NLP领域取得巨大成功后,迅速扩展到了计算机视觉(CV)领域,并带来了革命性的变化。这种基于自注意力机制的深度学习模型,不仅在NLP任务中力压群雄,也成为CV领域的新宠。

小拉拉的博客 1万+

Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection论文阅读

用于任意形状文本检测的深度关系推理图网络 摘要 由于场景文本的多样性和复杂性,任意形状文本检测是一项具有挑战性的任务。本文提出了一种用于任意形状文本检测的统一关系推理图网络。 首先通过基于CNN的文本选取网络利用共享特征来估计文本组件的几何属性;然后局部图可以大致建立不同文本组件的连接;然后使用深度关系推理网络将进一步推断出文本组件与其邻接组件之间的链接可能性,最后根据推理结果将文本组件聚合为整体的文本实例。 参考:https://blog.csdn.net/spicycoder/article/det

程序员养成日记 625

群晖Video Station海报墙插件更新了!手把手教你用c5h12o5插件搞定豆瓣/TMDB搜刮

本文详细介绍了如何使用c5h12o5插件为群晖Video Station配置高效的海报墙系统。该插件支持豆瓣、TMDB等多数据源并行搜刮,智能优先级设置和本地化优化,解决TMDB API失效问题,提升影视库管理体验。包含安装教程、配置策略和高级使用技巧,适合影视爱好者优化NAS媒体库。

weixin_29250403的博客 253

群晖Web Station实战:从零搭建个人静态导航站

本文详细介绍了如何利用群晖NAS自带的Web Station套件,从零开始搭建个人静态导航站。通过安装Web Station、上传静态网站源码、配置网页服务与网络门户等步骤,无需代码基础即可实现内网访问。文章还分享了文件权限设置、个性化定制及常见问题排查等实用技巧,帮助用户高效管理个人常用网址,充分挖掘NAS的服务器潜能。

tea88的博客 1320

DRRG:Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection:代码解读(textnet)

前言 期待着期待着,DRRG的代码解读还没有。这是要等死我啊,唉,没办法,没人写就自己摸索吧。没错,我又来吹牛了。全网第一篇DRRG代码解读来了,万事不求人,自己动手丰衣足食,今天和大家一起学习DRRG,希望大家喜欢。 textnet 先说我们要解读哪部分,首先我们的学习是针对代码主体结构。就是说我们最终的目的是做算法优化,所以我们也从代码的网络结构开始,而经过我的苦苦寻找,这部分就在network文件夹下的textnet.py中。那我们就开始解读他吧。 代码全文 import torch import t

weixin_44929101的博客 1079

不用变压器也能联网?手把手教你PHY芯片直连的3种实用方案

本文详细介绍了PHY芯片直连的3种实用方案,帮助开发者在物联网设备中实现更经济、更精简的网络连接设计。通过分析电压驱动型和电流驱动型PHY的核心原理,提供具体的电路配置和优化建议,确保信号质量的同时节省成本和空间。

smartcontract5的博客 327

DRRG:Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection:代码解读(loss)

前言 今天继续写代码解读,下面就是loss损失函数的解读,让我们一起学习,至于损失函数都哟什么,大家可以去看我翻译的原文,我先把损失函数部分粘贴过来。 损失函数 文字组件预测损失为由两个损失组成,计算公式为: 其中Lreg是平滑的L1 [20]回归损失,Lcls是交叉熵分类损失。 分类损失的计算公式为: 其中Ltr代表TR的损失; Ltcrp仅计算TR内部的像素,而Ltcrn仅计算TR外部的像素。 Ltcrn用于抑制TCR中的背景噪声。 以这种方式,获得的TCR可以有益于后处理步骤。 OHEM [22]用

weixin_44929101的博客 770

机器人视觉联动精度优化:从±2mm到±0.02mm,产线级手眼标定全实战

2025年我接东莞长安Type-C接口分拣项目的时候,就是栽在了手眼标定上:实验室里标定完精度±0.5mm,一到产线直接掉到±2mm,机器人10次有3次抓不住,2000多件Type-C接口直接报废,还撞坏了2套汇川SCARA机器人的吸盘,本来45天的工期拖了3个月,不仅没赚到钱,还倒贴了几万块。手眼标定从来不是简单的跑个demo、算个矩阵就完事了,它是一个系统工程:从硬件选型、安装固定、相机标定、标定流程、算法优化、环境控制、重复验证,每一个环节都会影响最终的联动精度。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 371

uniapp - 最新详细实现web-view网页与安卓苹果App端之间互相通信功能,苹果app/安卓app平台与内嵌webview组件内的网页进行相互传值,内置网页与app双向实时通信,详细示例代码

uni-app,Android安卓,苹果ios,app,内嵌webview,第三方H5网页,app和web-view通信传值,web-view引入的页面向App主应用传递数据,App端与webview端相互通信,App端和H5端webview之间的通信,uniapp实现webview和APP之间的传值通信,如何互相传递对象数据,数据传递了接收不到,web-view页面向app内发送消息,监听传递的参数,uni-app和web-view页面相互传参,报错怎么办,跨域,屏幕空白出错,数据交互,解决手机物理返回按

🏆 前端领域优质创作者 4731

DRRG:Deep Relational Reasoning Graph Network for Arbitrary Shape Text Detection解读(2)GCN

前言 这里还是对DRRG的一点补充,这里涉及的是GCN部分,不涉及理论具体理论请参考这篇文章:图卷积网络 GCN Graph Convolutional Network(谱域GCN)的理解和详细推导-持续更新_无知人生,记录点滴-CSDN博客 https://blog.csdn.net/yyl424525/article/details/100058264 这里我只讲意义,就是为啥用GCN。 结构 首先,结构说道GCN的应用我们要先了解一个问题,GCN用来干神魔。答案是用来构建局部图之间的连接。第二个问题

weixin_44929101的博客 782

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

图学习会议 2024 笔记(二)

在本教程中,我们将学习如何将知识图谱与大语言模型相结合,以推动科学研究的发展。我们将探讨知识图谱如何弥补大语言模型在显式知识、可解释性、领域知识更新等方面的不足,并介绍具体的融合框架、技术细节以及在科学发现任务中的应用。知识图谱是一种用于表示结构化知识的多关系图。它由实体(节点)和关系(边)组成,能够以三元组(主语, 谓语, 宾语)的形式描述事实。例如,(曼彻斯特婴儿, 开发者, 汤姆·基尔伯恩)。

龙哥盟 57

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

全网第一篇:DRRG代码的具体运行方法(亲测)

前言 经过三个星期的刻苦奋斗,终于成功运行出了DRRG,期间经历了无数的坑,我不敢说我是全网第一个跑出来的(肯定不是),但我绝对是第一个写出来教程的,本人也是一个小白,过程不易如果有帮到您请给一个赞,谢谢大家。 效果图 先上训练图,证明我跑了: 准备 首先,附上代码网址: https://github.com/GXYM/DRRG 然后我们做准备工作: 第一步下载代码:https://codeload.github.com/GXYM/DRRG/zip/master 第二步:下载数据集: 点击代码网址这部分。有

weixin_44929101的博客 3576

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

CVPR2020 论文和代码合集

CVPR2020-Code CVPR 2020 论文开源项目合集,同时欢迎各位大佬提交issue,分享CVPR 2020开源项目 【推荐阅读】 CVPR 2020 virtual ECCV 2020 论文开源项目合集来了:https://github.com/amusi/ECCV2020-Code 关于往年CV顶会论文(如ECCV 2020、CVPR 2019、ICCV 2019)以及其他优质CV论文和大盘点,详见: https://github.com/amusi/daily-paper-co

AI浩 5116

CVPR2020论文分方向整理之检测篇_3D目标检测(代码/论文解读/136篇打包下载)

CVPR2020论文分方向整理之检测篇(代码/论文解读/136篇打包下载) 本周三,CVPR官方正式开放下载,极市第一时间将所有论文(共1467篇)进行了下载打包,详情见此处。为了方便大家进一步的学习,我们对这1467篇论文进行了整理,本次分享的是所有检测类论文,并将它们细分为3D目标检测、人脸检测、动作检测、视频目标检测、文本检测、行人检测等方向,同时附上了相关解读和已开源论文的代码,共计149篇,并将其打包,获取方式见文末。 3D目标检测 【1】Learning Deep Network...

胭脂草的ABC博客 1万+

【免费下载】 深度文档检测:智能文本审查的利器

**DeepDoctection** 是一个强大且易于使用的开源文本检测和分析框架,由 [deepdoctection.io](http://deepdoctection.io/) 提供支持。它旨在帮助开发者、数据科学家和研究人员在文档处理中实现自动化和智能化,从学术论文到法律文件,都能进行高效、精确的内容检查。 ## 技术分析 ### 灵活的架构 - **模块化设计**:DeepDocte...

gitblog_00072的博客 1568

【亲测免费】 深度文档检测库(deepdoctection)使用教程

**深度文档检测库(deepdoctection)** 是一个使用深度学习模型进行文档提取和布局分析的Python库。它不直接实现模型,而是提供了一个框架,使用户能够构建文档分析管道。该库支持多种文档结构检测,如表格,并提供完整的表格语义。 ## 项目快速启动 ### 安装步骤 1. **安装Detectron2**:由于Detectron2不通过PyPI分发,需要单独安装。请参考[Dete...

gitblog_00257的博客 1106

【亲测免费】 DeepDoctection 文档分析工具安装与使用指南

DeepDoctection 是一个用于处理文档分析的Python库,其主要功能是协调深度学习模型进行文档提取和布局分析任务。在查看`https://github.com/deepdoctection/deepdoctection`时,我们可以了解到该项目的主要目录结构包括以下部分: - **configs**: 存储模型配置文件。 - **docker**: 包含Docker相关文件,用于容器...

gitblog_00595的博客 1070

【亲测免费】 深度文档处理:探索Deep Doctection的无限潜能

在数字化信息时代,处理和提取文档中的关键数据是一项至关重要的任务。而今天,我们有幸向您介绍一款强大的工具——**Deep Doctection**,一个基于Python的开源库,专为解决实际世界中PDF和图像文档的提取难题而来。 ## 项目介绍 **Deep Doctection**并非简单实现模型,而是扮演着一位深谙布局分析与对象检测的调度者角色,它支持利用TensorFlow或PyTorc...

gitblog_00474的博客 787

DeepDoctection 文档智能处理框架安装指南

DeepDoctection 是一个强大的文档智能处理框架,它集成了多种深度学习模型,能够完成文档布局分析、表格识别、文本检测与识别等任务。本文将详细介绍如何在不同环境下安装和配置 DeepDoctection 框架。 ## 系统要求 ### 基础要求 - **操作系统**:Linux 或 macOS(Windows 用户可通过 Docker 使用) - **Python 版本**:≥ 3....

gitblog_00605的博客 487
上一篇: [论文阅读]Chinese Street View Text: Large-scale Chinese Text Reading with Partially Supervised Learning
下一篇: Linux服务器设置ssh私钥登录
一叶知秋Autumn
博客等级 码龄10年 170粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值