





先摆结论,省得读到一半才反应过来——tri-reverse 的域路由里 confidence: high 跟证据多少一点关系都没有,它只表示「这次没有别的域跟它并列」。十几条任务描述跑下来,单域拿到 4 分的是 high,两个域各拿 1 分打平的反而降级成 medium。
我主业写前端和鸿蒙,逆向这块是被项目逼着看的。上周五同事甩了个样本过来,附一句「提YARA规则跑一下」。我本来打算自己 grep 一通,想起前阵子装了 tri-reverse,就拿它跑了路由。结果挺准,直接落到 D6(恶意软件与取证)。可这一准让我起了疑心:它的边界在哪?顺着把 scripts/route.py 那 233 行整个读了一遍,顺手改了几处跑测试。
一句「提YARA规则」是怎么被认出来的
先说个我觉得挺漂亮的地方。域表里 D6 的关键词正则是 \byara\b,在中文语境里这条正则本来是永远不生效的。
Python 的 \b 基于 Unicode \w,而 CJK 字符也算 \w。所以「提YARA规则」里,YARA 左边紧挨着「提」,中间压根没有词边界,\byara\b 直接失配。route.py:137 的 _fix_boundaries() 就是为这个写的——它按 \b 前后字符,把边界改写成 ASCII 显式环视:
# tri-reverse/scripts/route.py:152-157
if nxt and (nxt.isalnum() and nxt.isascii()):
    out.append(r"(?<![A-Za-z0-9_])")
elif prev and (prev.isalnum() and prev.isascii()):
    out.append(r"(?![A-Za-z0-9_])")
else:
    out.append("\\b")
我把这个函数临时换成恒等函数(等于关掉修复),再跑同一批口语化输入,对比是这样:
| 输入 | 关掉修复后 | 实际行为 |
|---|---|---|
提YARA规则跑一下 | D1 / low(零命中) | D6 / high |
上yara吧 | D1 / low | D6 / high |
分析下这个CTF题 | D1 / low | D8 / high |
搞pwn的 | D1 / low | D3 / high |
用IDA看so | D1 / low | D1 / high |
这个是ida吧 | D1 / low | D1 / high |
yara 规则(纯 ASCII 语境) | D6 / high | D6 / high |
7 条里 6 条会全灭。说白了,没有这个函数,中文用户每句话都得在自己脑子里先做一次「中英之间加空格」的预处理。这种你不看源码永远不知道它在替你兜底的东西,我个人特别买账。
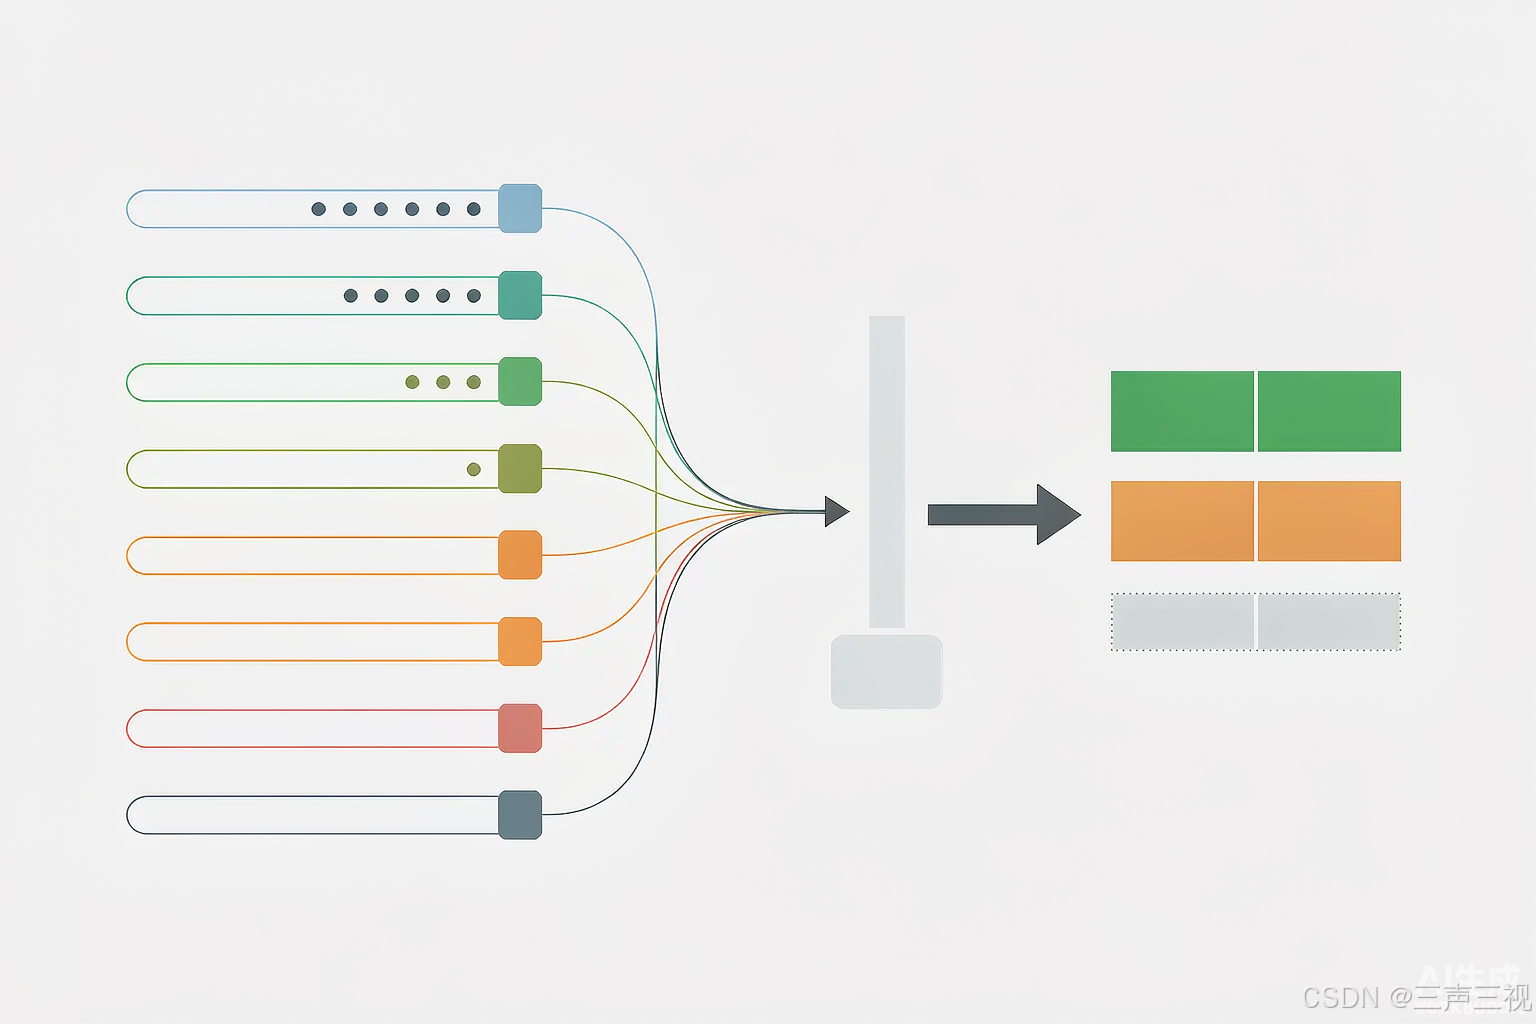
图:八条域规则并行计分 → 取最高分 → 并列时按 PRIORITY 顺序裁决;置信度只在这一步由「是否并列」决定
high 不是「很确定」,是「没人跟它争」
route.py:188 那行:
confidence = "high" if len(tied) == 1 and best >= 2 else ("high" if len(tied) == 1 else "medium")
读两遍你会发现 and best >= 2 是个死条件——len(tied) == 1 的时候,不管 best 是 1 还是 4,两个分支都返回 high。真正决定档位的只有 len(tied) == 1。而 tied 是「拿到最高分的域」列表,长度大于 1 就说明有并列,于是降级 medium。
实测印证了这一点:
| hint | scores | 置信度 |
|---|---|---|
sql 注入 idor 越权 jwt graphql 端口扫描 nmap | {D4: 4} | high |
内网横向 攻击链 持久化 CTF 靶场 | {D8: 3} | high |
yara 规则 | {D6: 1} | high |
CTF 里那道 pwn 题的栈溢出怎么打 | {D8: 1, D3: 1} | medium |
周末在家看看书 | {} | low(回退 D1) |
4 分是 high,1 分也是 high;两个域各 1 分打平反倒成了 medium。证据越多,置信度可能越低。这跟直觉是反着的。
(顺便一提,这组对照我丢进雷达鸭的笔记里留了份档,下次开新案例之前先翻一眼,省得又拿置信度当可靠度读数使。)
依据那行字,把「域」数成了「条」
同一段代码里还有个口径错位,reason 是这么拼的:
# tri-reverse/scripts/route.py:190
reason = "命中 %d 条关键词,得分 %d%s" % (sum(1 for _ in scores), best, ...)
scores 是 {域名: 分数} 的字典,sum(1 for _ in scores) 数的是域的个数,不是命中的正则条数。于是出现了这种自我矛盾的输出:
$ python scripts/route.py --hint "sql 注入 idor 越权 jwt graphql 端口扫描 nmap" --json
  ...
  "reason": "命中 1 条关键词,得分 4"
得分 4 说明命中了 4 条正则,文案却报「命中 1 条关键词」。当日志看无所谓,要是拿去做自动化判据(比如「命中条数 < 2 就转人工」),就会被自己坑一道。
授权门:–force 是真不绕过
路由完转 case 模式。case_tools.py init 按预设生成 work/<case>/scope.md,之后每次对外动作前必须先跑 guard。四组实测:
$ python scripts/case_tools.py init --case-name caseA --preset lab-only --target 10.0.0.5
{"auth_status": "pending", "network": "lab_only", "ready_for_act": false, ...}

$ python scripts/case_tools.py guard --case-root work/caseA
[guard] NOT READY(exit 2)
  - auth.status=pending(须 granted;未 granted 只允许读文档/路由/补授权材料)
  - signoff.ready_for_act != true
lab-only 预设的 auth 是 pending,guard 退出码 2。加 --force 再跑还是 2,只多打一行 [note] --force 为兼容参数,不绕过任何 scope 硬门——这个我专门验了,因为它最容易被误用成「跳过」。换 offline-sample 并给 --sample,ready_for_act: true,guard 退出码 0;同样预设但不给 --sample,assets 空着 guard 也不报(offline 模式豁免 assets 检查),可 ready_for_act 是 false,照样卡住。
这条链的设计我服气:授权状态只能由人写进 scope.md,脚本不做任何自动 granted 的推断。宁可卡死也不放行。
产物落盘也得提一句:案例全在 work/<case>/(scope.md / timeline.md / workitems.md / evidence/ / notes/ / report/),skill 自己的教训另写进 .tribro/tri-reverse/lessons.md,追加式,目录不存在就自动建。SKILL.md 里还有个说法我很认同——「停车态 ≠ 结束态」:guard 退出码 2、等样本、报告待确认,都算停着,不许宣告收工。我以前写自动化脚本就爱在「卡住等输入」的时候输出个 done,吃过亏。
evidence 的 sha256 认的是「当前目录」,不是案例目录
这里我躺了小半天。case_tools.py evidence 会给产物算 sha256 落进证据的 content_hash,判断文件存在的那行是 if artifact and Path(artifact).is_file()——相对路径按进程当前工作目录解析,跟 --case-root 一点关系都没有。
| 当前目录 | 命令(artifact 同为 notes/strings.txt) | content_hash |
|---|---|---|
| 仓库根 | evidence --case-root work/c --id E-002 | n/a |
work/c | evidence --case-root work/c --id E-001 | sha256:530c7571… |
同一条命令换个目录跑,指纹就没了。规避也就一句话:跑 evidence 之前先 cd 到案例根,或者干脆给绝对路径。
还有个静默行为——--excerpt 传进去的内容只保留前 20 行(case_tools.py:212)。我喂了 30 行,落盘的 E-001.md 里只剩 L01 到 L20,一行提示都没有。你要是靠 excerpt 存关键片段,得自己先裁好。
case_review 那句「hash 校验过」,可能是句空话
case_review.py 是只读复查,跑完会打一行汇总:
$ python scripts/case_review.py --case-root work/fullcase
[case-review] OK — work/fullcase
  scope 就绪 / Evidence 契约完整 / hash 校验过 / Finding 追溯通过
我第一次跑出这行的时候,E-001.md 里 content_hash: n/a,report/ 目录压根不存在。翻译成人话:一条 hash 没验、一个 Finding 没追溯。原因在 case_review.py:65:
if hm and hm.group(1) != "n/a" and am:
content_hash 是 n/a 时整段跳过,而汇总文案是写死的,压根不看实际验了几条。
同样的毛病还有一处:它的 docstring 第 7 行写着复查项含「in_scope.assets 非空(offline 豁免)」,代码里却没这段。我造了个 assets 为空的 scope,guard 报 - in_scope.assets 为空(exit 2),case_review 一声不吭。
好在真验起来它是能验的。把 artifact 追加一行再跑:
[ISSUE] E-001.md artifact sha256 mismatch: sha256:f428adc72a0d..(期望 sha256:530c75711971..)
report 里 evidence_ids: [E-001, E-009] 引用了不存在的证据,也能抓出来:[ISSUE] findings.md: F-001 引用不存在的 E-009。能力是有的,问题在于那句汇总文案会让你以为它已经查过了。
顺带一提 strict 模式的差别:report 里写一条没挂证据的结论(### F-002 不带 evidence_ids),默认只给 [WARN ] findings.md: F-002 无 evidence_ids,退出码还是 0;加上 --strict 才升级成 [ISSUE]。我的建议是日常复核一律带 --strict,反正证据链这种东西,漏一条结论的代价比多跑一次脚本大得多。
我现在的用法
- 路由的置信度当「要不要人工消歧」读,别当「证据够不够」读;落到 medium 就顺手看一眼返回里的
secondary数组。 - 跑
evidence之前先cd到案例根,写完当场case_review.py --strict复核(strict 会把 warnings 也算阻断)。 - 不看汇总那行,只看有没有
[ISSUE]/[WARN ];content_hash出现n/a就是没指纹,回去重录。
装一下就能跑:
skillhub install tri-reverse
写到这儿我倒有个没想明白的:把 reason 里的域数改成真实条数、把汇总文案改成「已验 N 条 hash」,改动都很小,可都会改变下游判断的语义。这种「文案比实现更自信」的情况,到底是该改文案还是改实现?我倾向改文案——实现没偷懒,是措辞替它吹了牛。
我是老三,10 年软件开发,软件设计师 / 注册人工智能工程师,主业 Web 前端与鸿蒙应用开发(ArkTS 北向),现在一边做项目一边折腾 AI 自动化,不定期在 CSDN 写点鸿蒙和 AI 相关的实战笔记。
本文遵循 MIT 协议,转载请注明出处。



 扫一扫


 3万+

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


