





作者:来自 Elastic Scott Martens
jina-ocr-v1 在 olmOCR-bench 上以 5.7 亿个激活参数取得了 83.4 分,是所有参数量低于 6 亿的 OCR 模型中最高的,并且在 OmniDocBench 上的得分超过了 GPT-5.2。
我把完整的 demo 放在地址:GitHub - liu-xiao-guo/jina-ocr-v1 · GitHub。你可以在自己的电脑上进行展示。
亲自体验 Elasticsearch:深入了解 Elasticsearch Labs 代码库中的示例笔记本,开始免费云试用,或者立即在你的本地机器上试用 Elastic。
jina-ocr-v1 是 Jina AI 为 Elastic 推出的新预处理模型,适用于文本扫描件、富文本图像数据、完整渲染的打印页面,以及其他难以数字化的印刷材料。它是一种端到端文档解析器,能够从文档的视觉布局中理解文档结构,并使用 AI 将原始图像数据处理成可用于索引和进一步处理的实用结构化文本。它只需调用一次 AI 模型,就能将 100 多种语言的扫描页面、拍摄的文档、幻灯片和手写笔记转换为结构化的机器可读文本。
光学字符识别(Optical character recognition - OCR)长期以来一直是 AI 的目标,而在一些简单场景中(例如布局简单、图像清晰、字体标准,以及资源丰富的标准化语言),使用成本低廉的传统软件也可以获得非常高的可靠性。但真实数据往往很杂乱。文档的扫描件和照片通常比较模糊,图像经过压缩,质量也各不相同。此外,页面布局可能很复杂。而且,这些示例甚至没有考虑手写内容和全球各种语言。
专为 OCR 训练的视觉语言模型
jina-ocr-v1 是一种经过专门训练的视觉语言模型(VLM)。与通用型大语言模型(LLMs)不同,它不会回答问题。它只接受一项任务的训练:以连贯的顺序输出图像中的文本,使其符合人类阅读图像的方式,同时保留内容视觉结构中重要的信息。
它将原本需要通过多个模型和专业程序构建的流水线整合到了一个模型中,包括:
-
具备布局感知能力的文档处理,可生成 Markdown 格式的输出,并尽可能在文本输出中保留原始文档的结构。
-
支持 100 多种语言,其中涵盖所有主要的国际语言和文字系统。
-
手写识别,包括多种语言的块状文字以及英文草写体。
-
将表格提取为基本 HTML 格式,适合进一步处理以及导入电子表格或其他应用程序。
-
数学公式识别,将公式的打印图像转换为 LaTeX 数学代码,你可以直接插入任何支持 LaTeX 的文档引擎或科学软件中。
jina-ocr-v1 总共有 34 亿个参数,但由于它采用混合专家架构(mixture-of-experts architecture),因此在任意时刻只使用模型的一部分。响应用户输入时,只会使用 5.7 亿个参数,大约是总参数量的六分之一,但具体使用哪 5.7 亿个参数是在推理时动态确定的。这意味着 jina-ocr-v1 占用的内存与其他 34 亿参数模型一样多,但运行速度却与 5.7 亿参数模型一样快。
jina-ocr-v1 规格
| 总规模 | 3.4 billion (10⁹) 个参数 |
|---|---|
| 激活参数 | 570 million |
| 骨干模型 | DeepSeek-OCR |
| 输入分辨率 | 1024x1024,但包含额外的高分辨率区域。对于在 2048x2048 分辨率下都不可见的特征,不太可能被读取。 |
| 输出 | UTF-8 文本;章节和列表使用 Markdown 格式,表格使用 HTML,数学公式使用 LaTeX。 |
jina-ocr-v1 架构如何基于 DeepSeek-OCR 构建
完整的 jina-ocr-v1 模型是一个拥有 34 亿(3.4×10⁹)个参数、其中 5.7 亿个为激活参数的混合专家模型。它基于 DeepSeek-OCR 的编码器-解码器架构,并加入了 FastMTP,通过一次预测多个输出 token 来降低推理时的计算负载。这种方法能够实现更高效的处理,在推理时具有更低的延迟和更低的资源消耗。
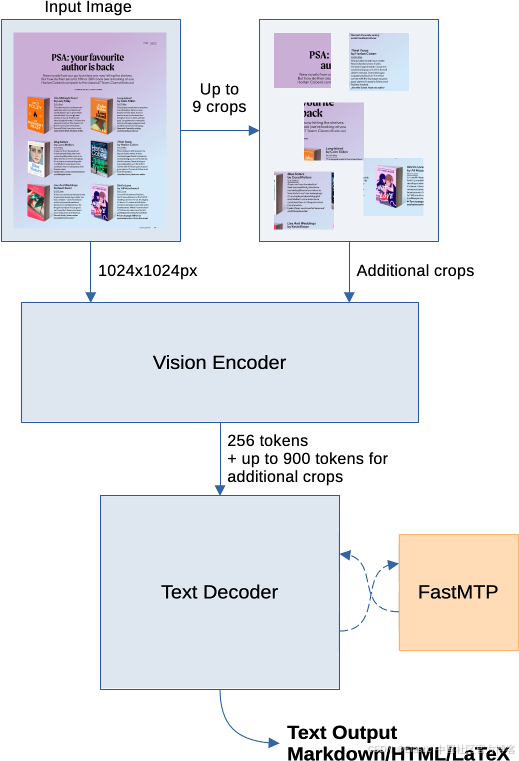
有关模型架构的更多信息,请参阅技术报告以及 jina-ocr-v1 在 Hugging Face 上的模型页面。
输入格式和分辨率限制
遵循 DeepSeek-OCR 架构,图像会被调整为 1024x1024,然后处理为 256 个输入 token,供文本解码器使用。为了纳入更多细节,图像还会根据图像的分辨率和几何形状,被处理为最多 9 个额外的高细节裁剪图块,每个图块还会分别重新处理为最多 100 个额外 token。对于非常大的图像,如果其中的特征在 2048x2048 分辨率下都难以辨认,那么这些特征可能无法被正确处理。
jina-ocr-v1 自动支持所有常见的图像格式。不过,它不原生支持 PDF。你需要将 PDF 页面转换为图像格式后才能与 jina-ocr-v1 一起使用(我们建议使用低压缩率的 PNG)。各种开源和商业工具都可以执行这项任务。
有关输入处理的更多详细信息,请参阅 jina-ocr-v1 的技术报告以及 DeepSeek-OCR 的技术报告。
输出格式:Markdown、HTML 表格和 LaTeX 数学公式
jina-ocr-v1 生成带有 Markdown 格式的文本,仅支持与不同 Markdown 实现最兼容的基本语法元素。Markdown 以简单、易读的格式支持常见的文本结构信息,例如章节和列表。它可以很容易地转换为 HTML 和其他富文本格式。
模型会偏离基本 Markdown 格式来编码表格和数学公式。具体来说:
-
表格采用基本 HTML 格式进行编码,使用
<table>、<th>、<tr>和<td>标签,不包含 CSS 或其他样式表信息。 -
公式采用 LaTeX 数学模式语法进行编码,其中使用的命令来自 amsmath .package。
推动性能与成本的边界
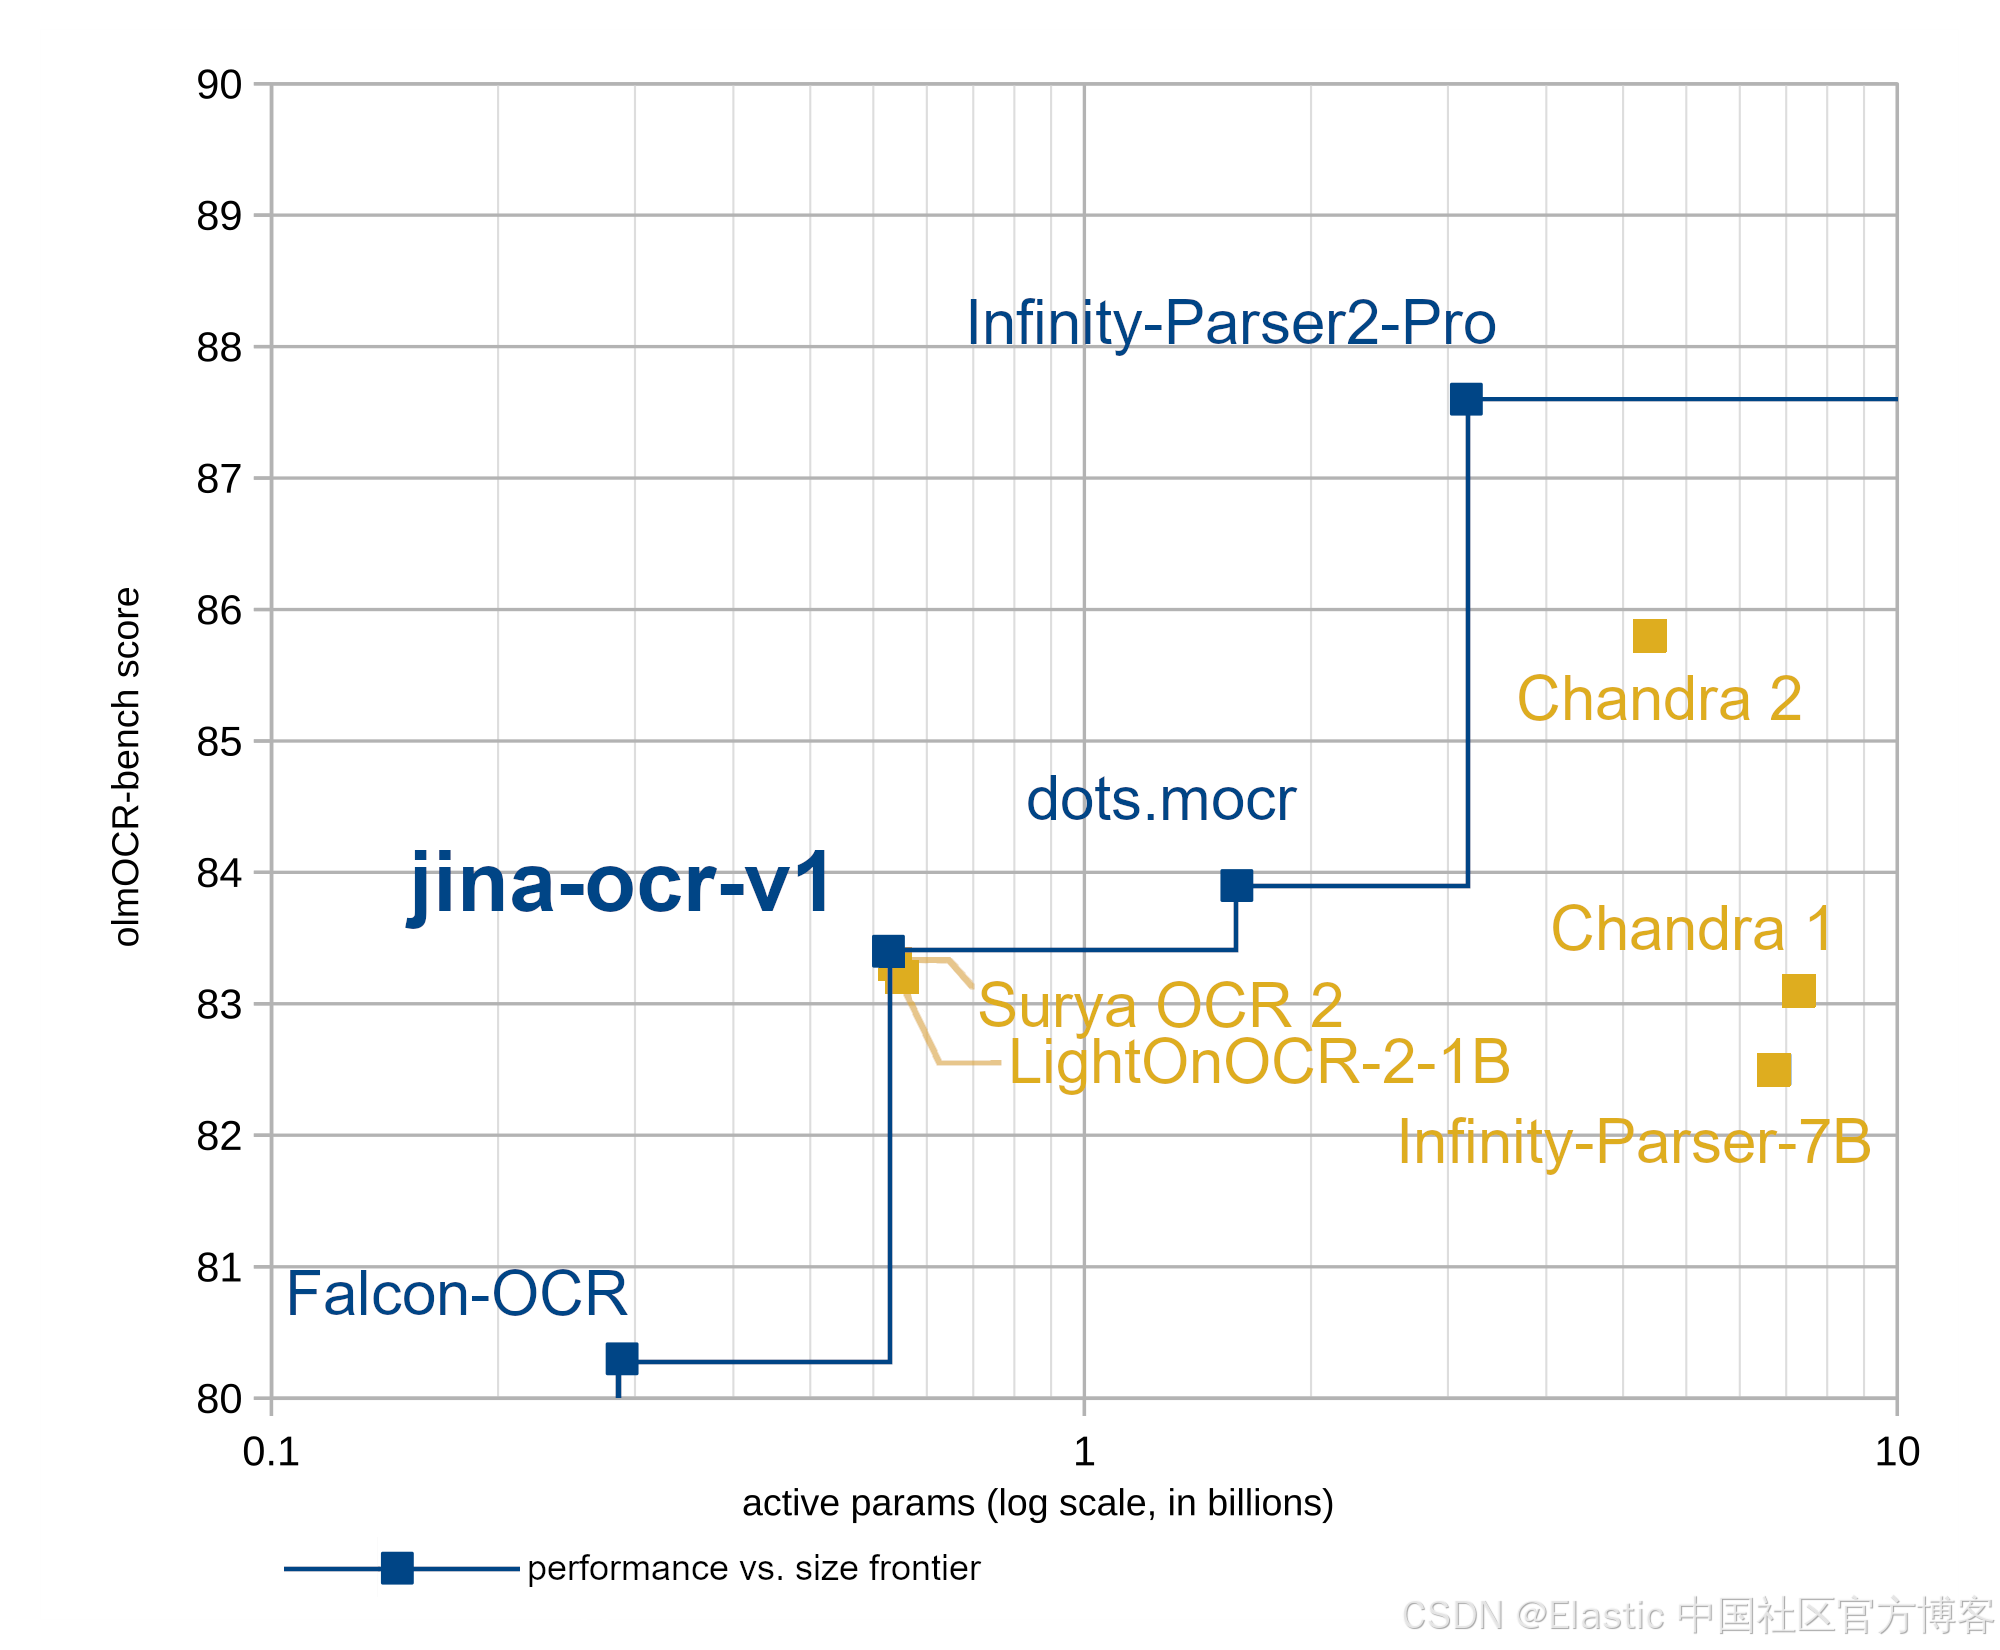
jina-ocr-v1 在 olmOCR-bench 上的得分位居顶级模型之列,并且是所有激活参数少于 6 亿的模型中整体表现最好的。它位于 AI OCR 模型的帕累托前沿上,这意味着在这一基准测试上表现更好的所有模型都拥有更多的激活参数,因此比 jina-ocr-v1 需要更多的计算能力和资源。
| 模型 | 总参数量 | 激活参数量 | olmOCR-bench 总体得分 |
|---|---|---|---|
| Infinity-Parser2-Pro | 350 亿 | 29.5 亿 | 87.6 |
| Chandra 2 | 53 亿 | 49.6 亿 | 85.8 |
| dots.mocr | 30 亿 | 15.4 亿 | 83.9 |
jina-ocr-v1 | 34 亿 | 5.74 亿 | 83.4 |
| Surya OCR 2 | 6.5 亿 | 5.85 亿 | 83.3 |
| LightOnOCR-2-1B | 10 亿 | 5.96 亿 | 83.2 |
| Chandra 1 | 90 亿 | 75.7 亿 | 83.1 |
| Infinity-Parser-7B | 80 亿 | 70.7 亿 | 82.5 |
| PaddleOCR-VL-1.6 | 9 亿 | 9 亿 | 81.0 |
| Falcon-OCR | 3 亿 | 2.7 亿 | 80.3 |
| Qianfan-OCR | 50 亿 | 40.2 亿 | 79.8 |
| dots.ocr | 30 亿 | 15.4 亿 | 79.1 |
| DeepSeek-OCR 2 | 30 亿 | 5.7 亿 | 76.3 |
OmniDocBench(表 2)呈现出更加多元的结果,但 jina-ocr-v1 在从 VLM 改造而来的专业 OCR 模型中取得了较高的得分。不过,对比表 1 和表 2 可以发现,没有规模相近的模型能够在两个基准测试中都超过 jina-ocr-v1,这表明它的高性能能够稳定地适用于不同类型的任务。
| 模型 | 总参数量 | 激活参数量 | OmniDocBench 总体得分 |
|---|---|---|---|
| PaddleOCR-VL-1.6 | 9 亿 | 9 亿 | 96.34 |
| HunyuanOCR | 10 亿 | 10 亿 | 94.74 |
jina-ocr-v1 | 34 亿 | 5.74 亿 | 91.14 |
| dots.ocr | 30 亿 | 30 亿 | 90.77 |
| DeepSeek-OCR 2 | 30 亿 | 5.75 亿 | 90.25 |
表 3 将 jina-ocr-v1 与支持视觉能力的非专业 LLM 进行了对比。在 OmniDocBench 上,它的得分明显超过 GPT-5.2 和规模最大的 Qwen3 VLM,同时总体得分接近 Gemini 3。
| 模型 | 总参数量 | 激活参数量 | OmniDocBench 总体得分 | TextEdit 得分* | Read-OrderEdit 得分* |
|---|---|---|---|---|---|
| Ovis2.6-30B-A3B | 300 亿 | 30 亿 | 93.7 | 0.035 | 0.135 |
Gemini 3 Pro | 闭源模型,未公开 | 闭源模型,未公开 | 92.91 | 0.064 | 0.165 |
Gemini 3 Flash | 闭源模型,未公开 | 闭源模型,未公开 | 92.62 | 0.066 | 0.172 |
jina-ocr-v1 | 34 亿 | 5.74 亿 | 91.14 | 0.046 | 0.142 |
| Qwen3-VL-235B | 2350 亿 | 220 亿 | 89.78 | 0.063 | 0.166 |
GPT-5.2 | 闭源模型,未公开 | 闭源模型,未公开 | — | — | — |
* TextEdit 和 Read OrderEdit 基准测试的评分方式是数值越小越好,而不是数值越大越好。
如表 3 所示,在 OmniDocBench 中专注于正确阅读顺序和整体字符级准确率(TextEdit 和 ReadOrderEdit)的测试中,jina-ocr-v1 轻松超过了三种前沿 LLMs。只有 Ovis2.6-30B-A3B 在 OmniDocBench 的所有方面得分更高,但它的总参数量接近 jina-ocr-v1 的 9 倍,激活参数量约为其 6 倍。
要在你自己的数据上进行测试,你可以在 Jina AI 网站上试用,或者阅读访问 jina-ocr-v1 OCR API 的五种方式,了解如何将其集成到你的文档处理和搜索流水线中。
具备布局感知能力的端到端文档解析
OCR 已经存在很长时间了,时间长到很多人都体验过它的各种不足。识别页面上的字母本身并没有那么困难,尤其是在图像清晰且使用现代数字字体的情况下。真正困难的是,按照从左到右的顺序识别字母,只是理解页面上所打印内容的第一步。
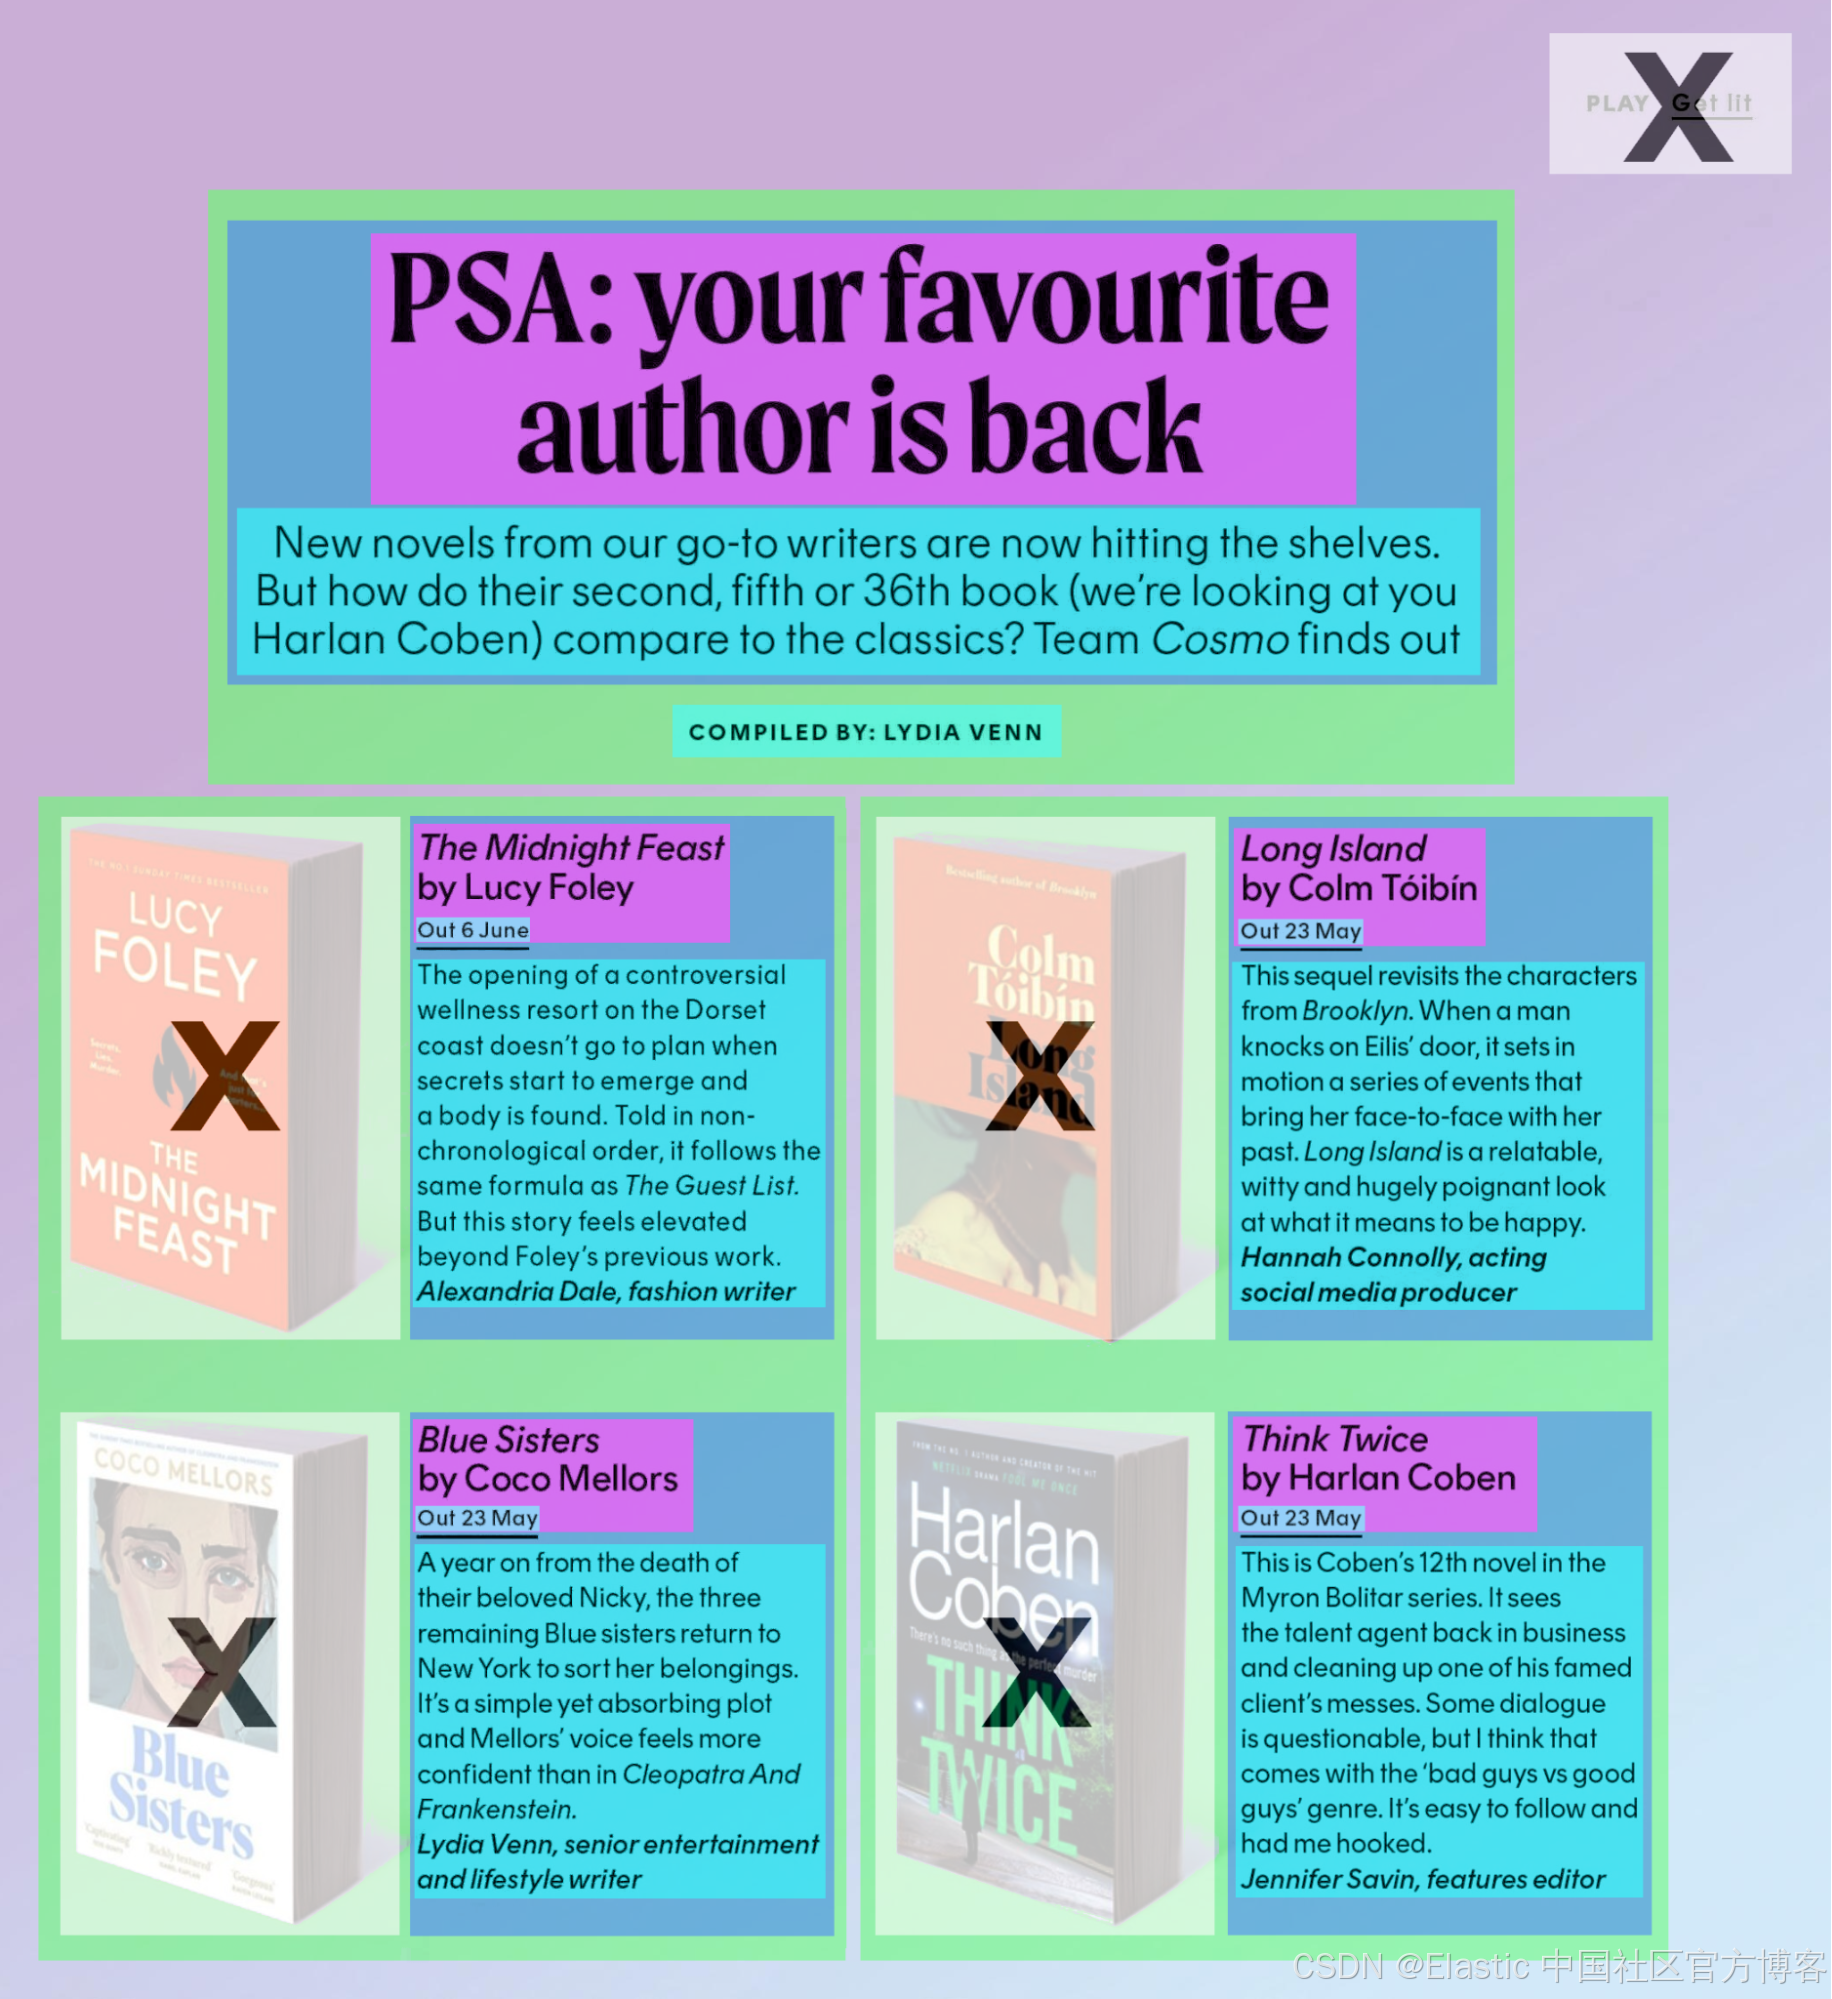
请看下面这张图片,它取自 2024 年 6/7 月英国版 Cosmopolitan 杂志 的印刷版:
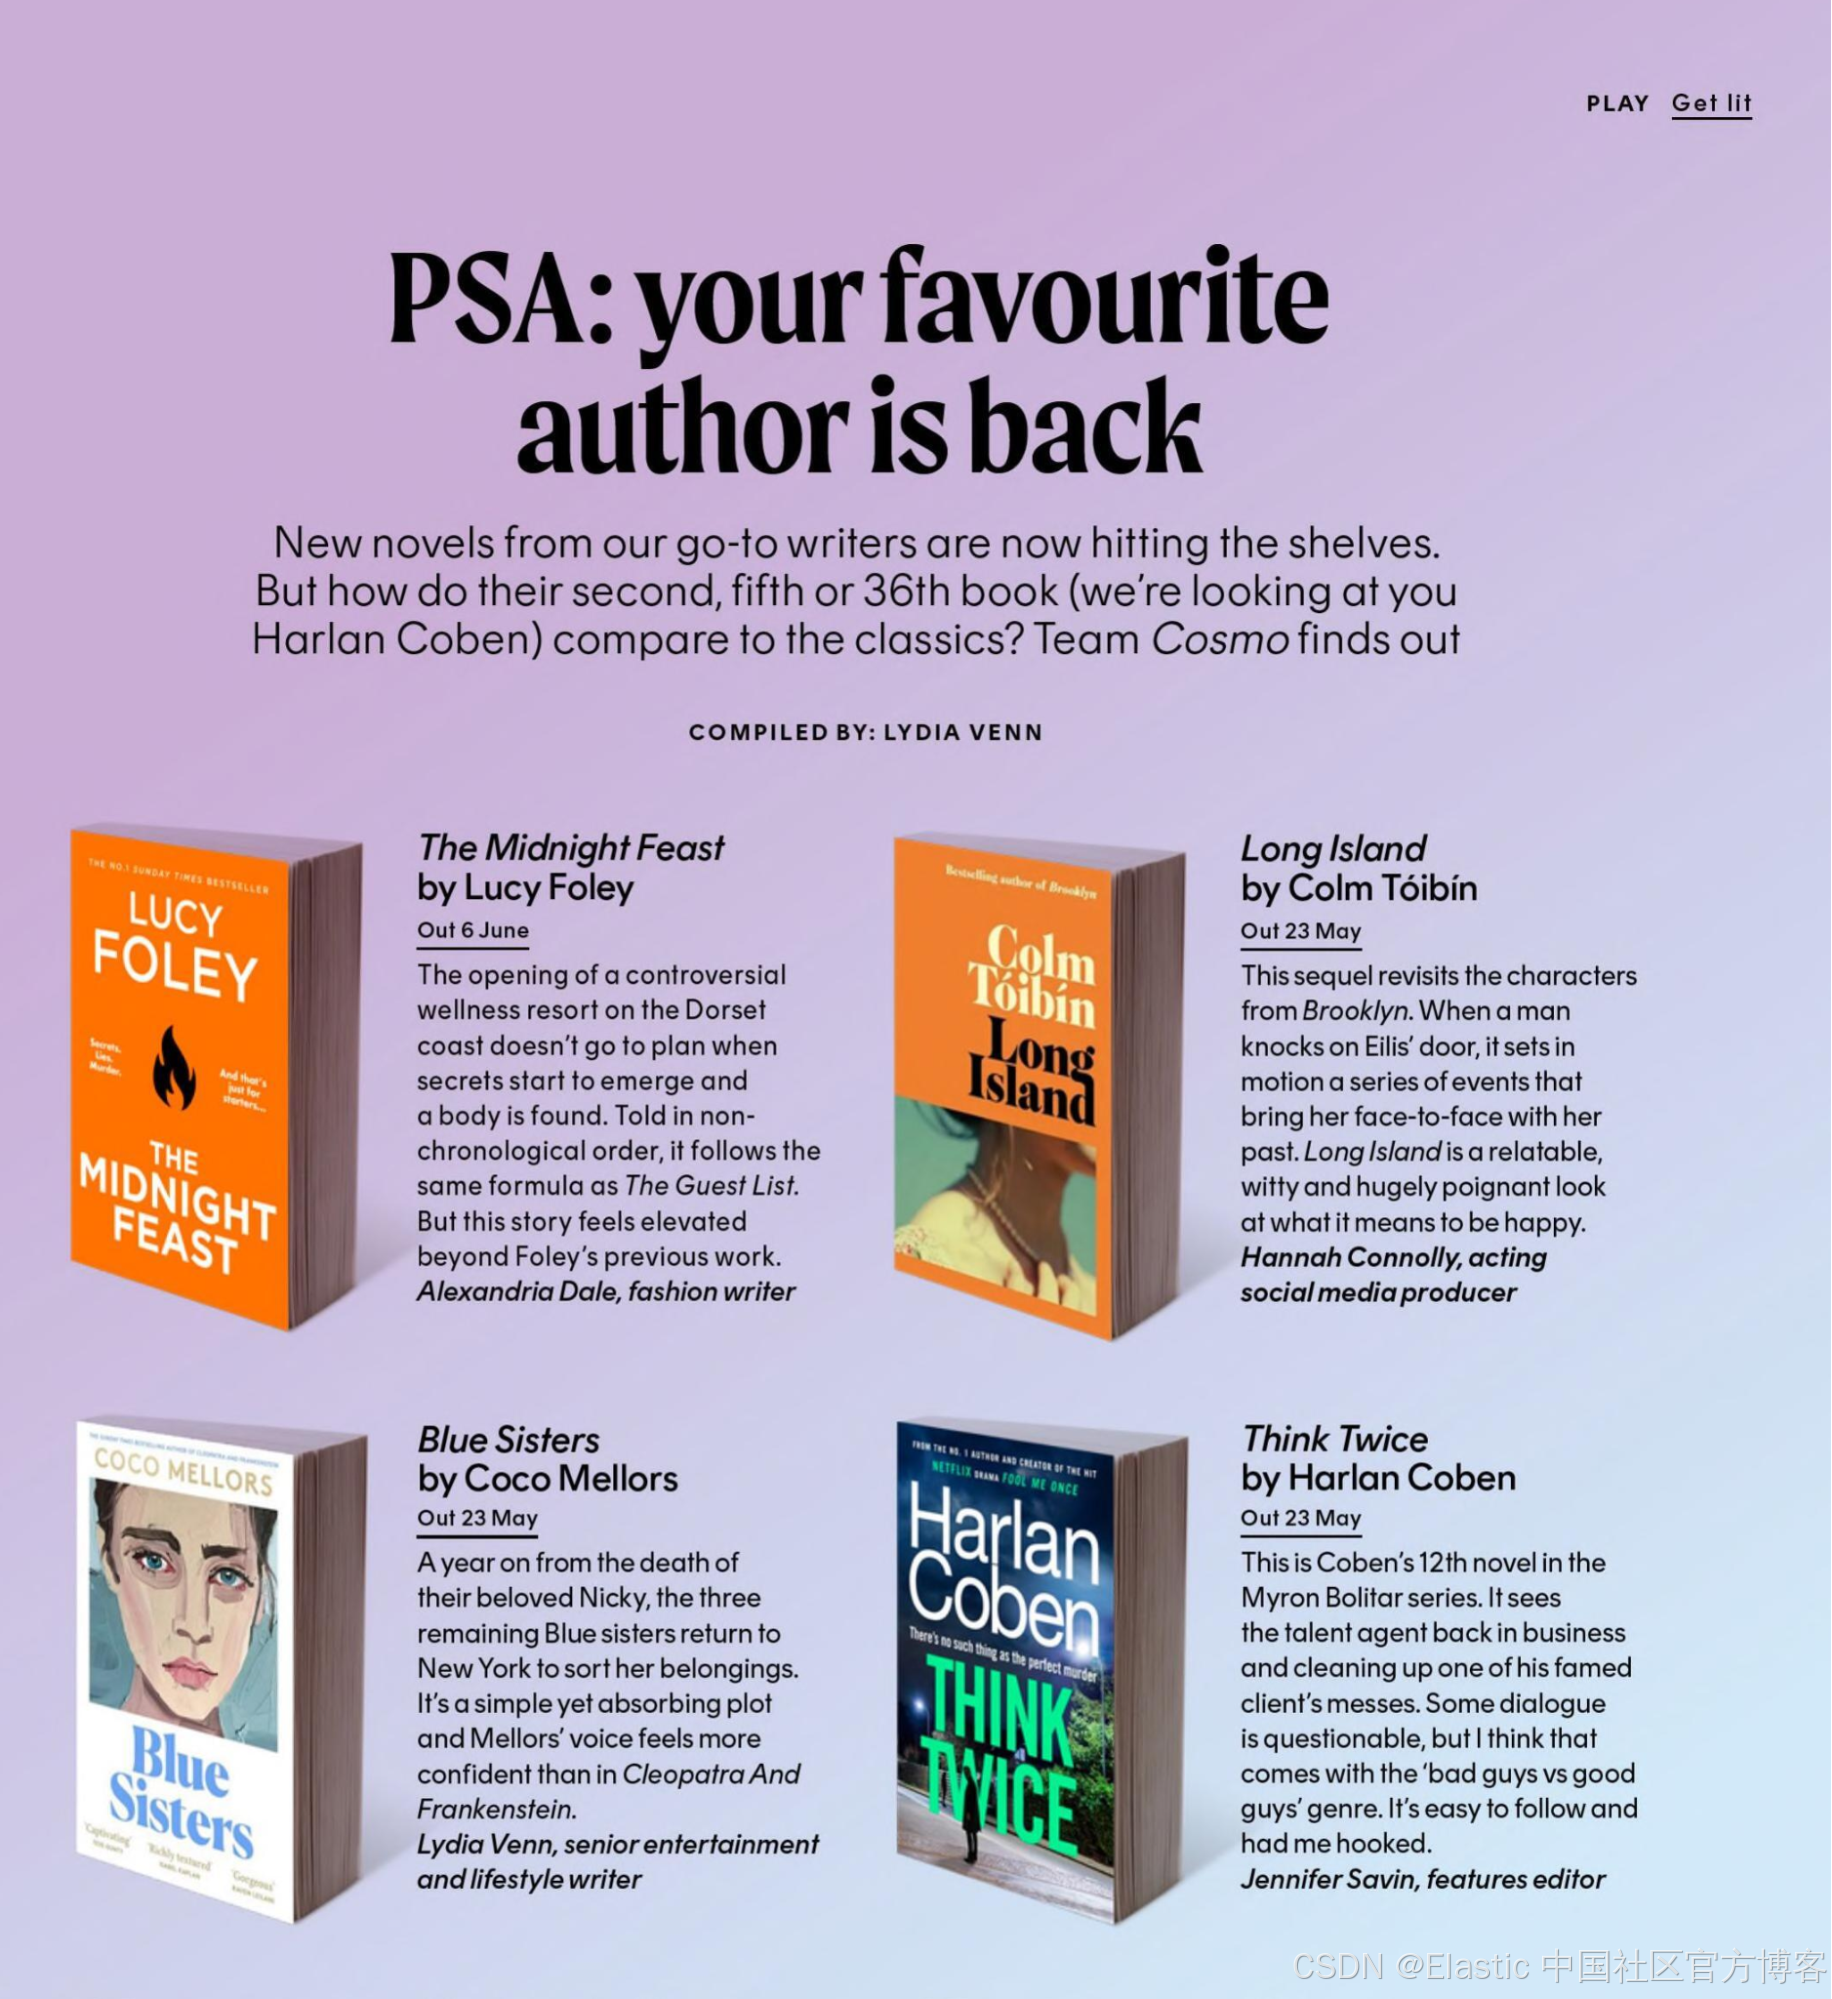
即使每个单词和字母都被正确识别,仅仅按照从左到右的顺序读取,也会产生混乱、无法阅读且毫无用处的文本。一个优秀的 OCR 模型必须对图像进行解析,像人类一样识别各个元素之间的关系,并按照原本的意图读取文本,同时关注字体和空间布局。
它还应该识别那些不应该出现在输出中的元素。页面可能包含一些图像,而这些图像中恰好带有文本,例如图 3 中的书籍封面。页面中通常还会有不属于正文内容的页眉和页脚信息,例如页码和固定格式的文本。OCR 之后再过滤掉这些元素非常困难,因此识别并移除这些元素必须成为预处理或 OCR 过程本身的一部分。
图 4 展示了 jina-ocr-v1 如何解析图 3 中的图像,包括需要忽略的元素。每个彩色区块表示属于同一组的文本元素,其中包含文本以及可能存在的其他区块;而书籍图像则被标记出来,因为尽管其中确实包含文本,但这些文本不属于 OCR 输出。
这些问题意味着,对于具有复杂布局的材料,OCR 传统上一直是一个多阶段过程,需要使用不同的算法来:
-
拆分页面。
-
识别图像中每个部分的作用。
-
借助统计语言模型识别文本。
-
重新组合结果以生成输出。
每个阶段都很脆弱,并且错误会在整个处理流水线中不断累积。
相比之下,端到端文档解析通过一个稳健的、单次处理的生成式语言过程完成所有这些工作。
如图 5 所示,jina-ocr-v1 可以轻松处理这类视觉上复杂的文档。它不仅能够捕获文字,还能正确排列文字顺序,保留标题和章节的结构信息,并忽略书籍图片中的文字以及不属于内容的页眉和页脚。
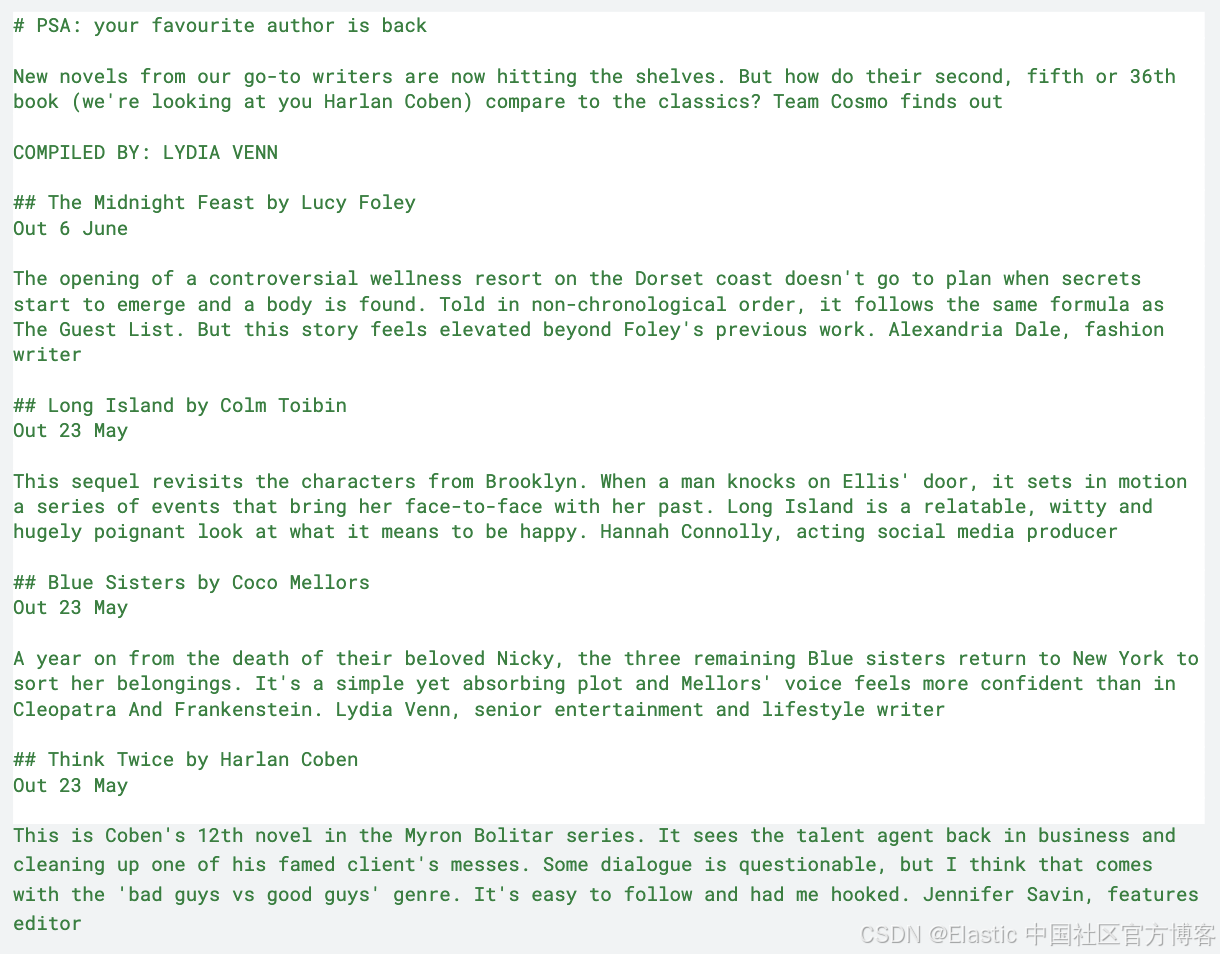
jina-ocr-v1 做的不只是识别页面上的字母。它能够处理复杂的结构信息,并支持 100 多种语言。它还会以 Markdown 风格的格式返回信息,这种格式既便于人类阅读,也被下游应用广泛原生支持。
将表格提取为 HTML
识别和提取表格听起来很简单,但如果没有 AI 模型,要做好这件事非常具有挑战性。
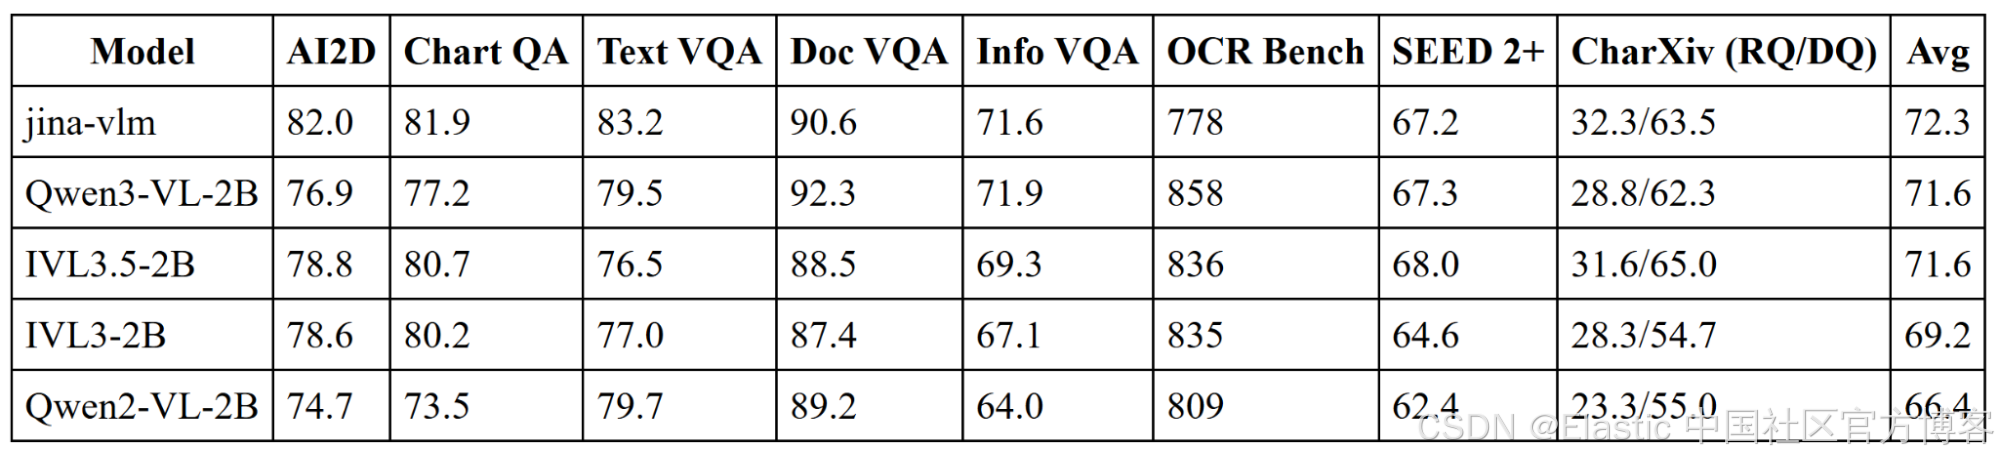
例如,可以看看这张来自最近一篇 Jina AI 会议论文 的表格:
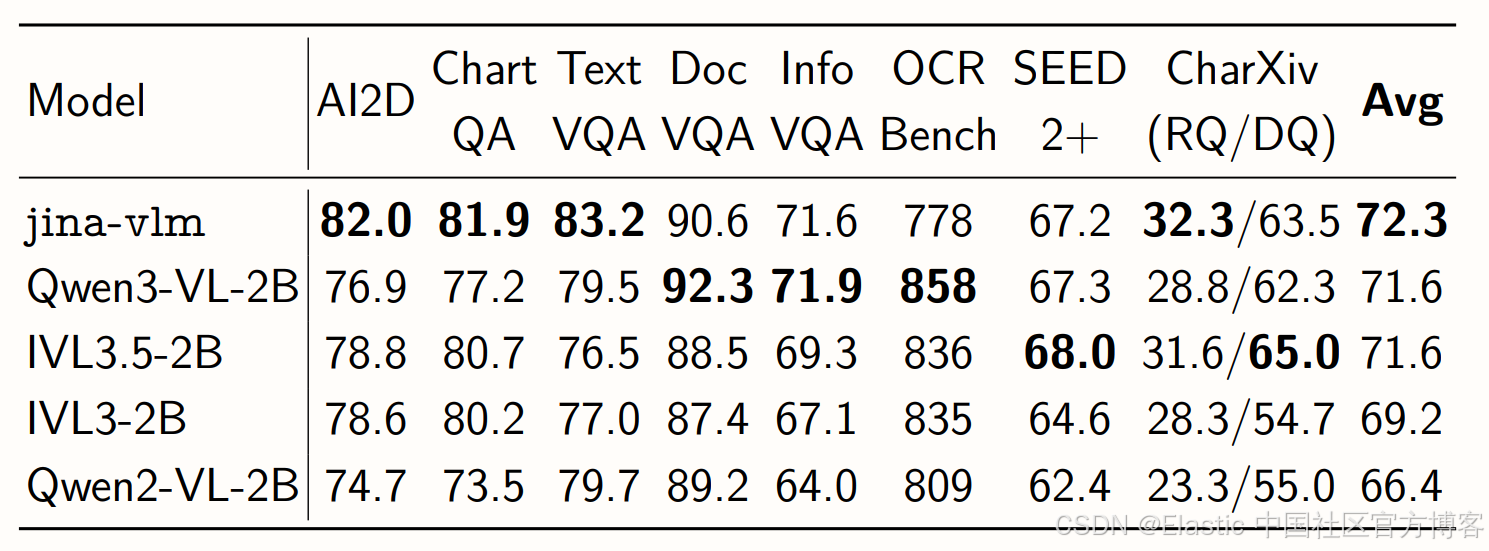
缺乏表格感知能力的 OCR 软件很可能会生成如下结果:
Model AI2D Chart Text Doc Info OCR SEED CharXiv Avg
QA VQA VQA VQA Bench 2+ (RQ/DQ)
jina-vlm 82.0 81.9 83.2 90.6 71.6 778 67.2 32.3/63.5 72.3
Qwen3-VL-2B 76.9 77.2 79.5 92.3 71.9 858 67.3 28.8/62.3 71.6
IVL3.5-2B 78.8 80.7 76.5 88.5 69.3 836 68.0 31.6/65.0 71.6
IVL3-2B 78.6 80.2 77.0 87.4 67.1 835 64.6 28.3/54.7 69.2
Qwen2-VL-2B 74.7 73.5 79.7 89.2 64.0 809 62.4 23.3/55.0 66.4如果不经过进一步处理,这作为表格是毫无用处的。但是,在面对同一张表格时,jina-ocr-v1 会生成简洁、极简的 HTML:
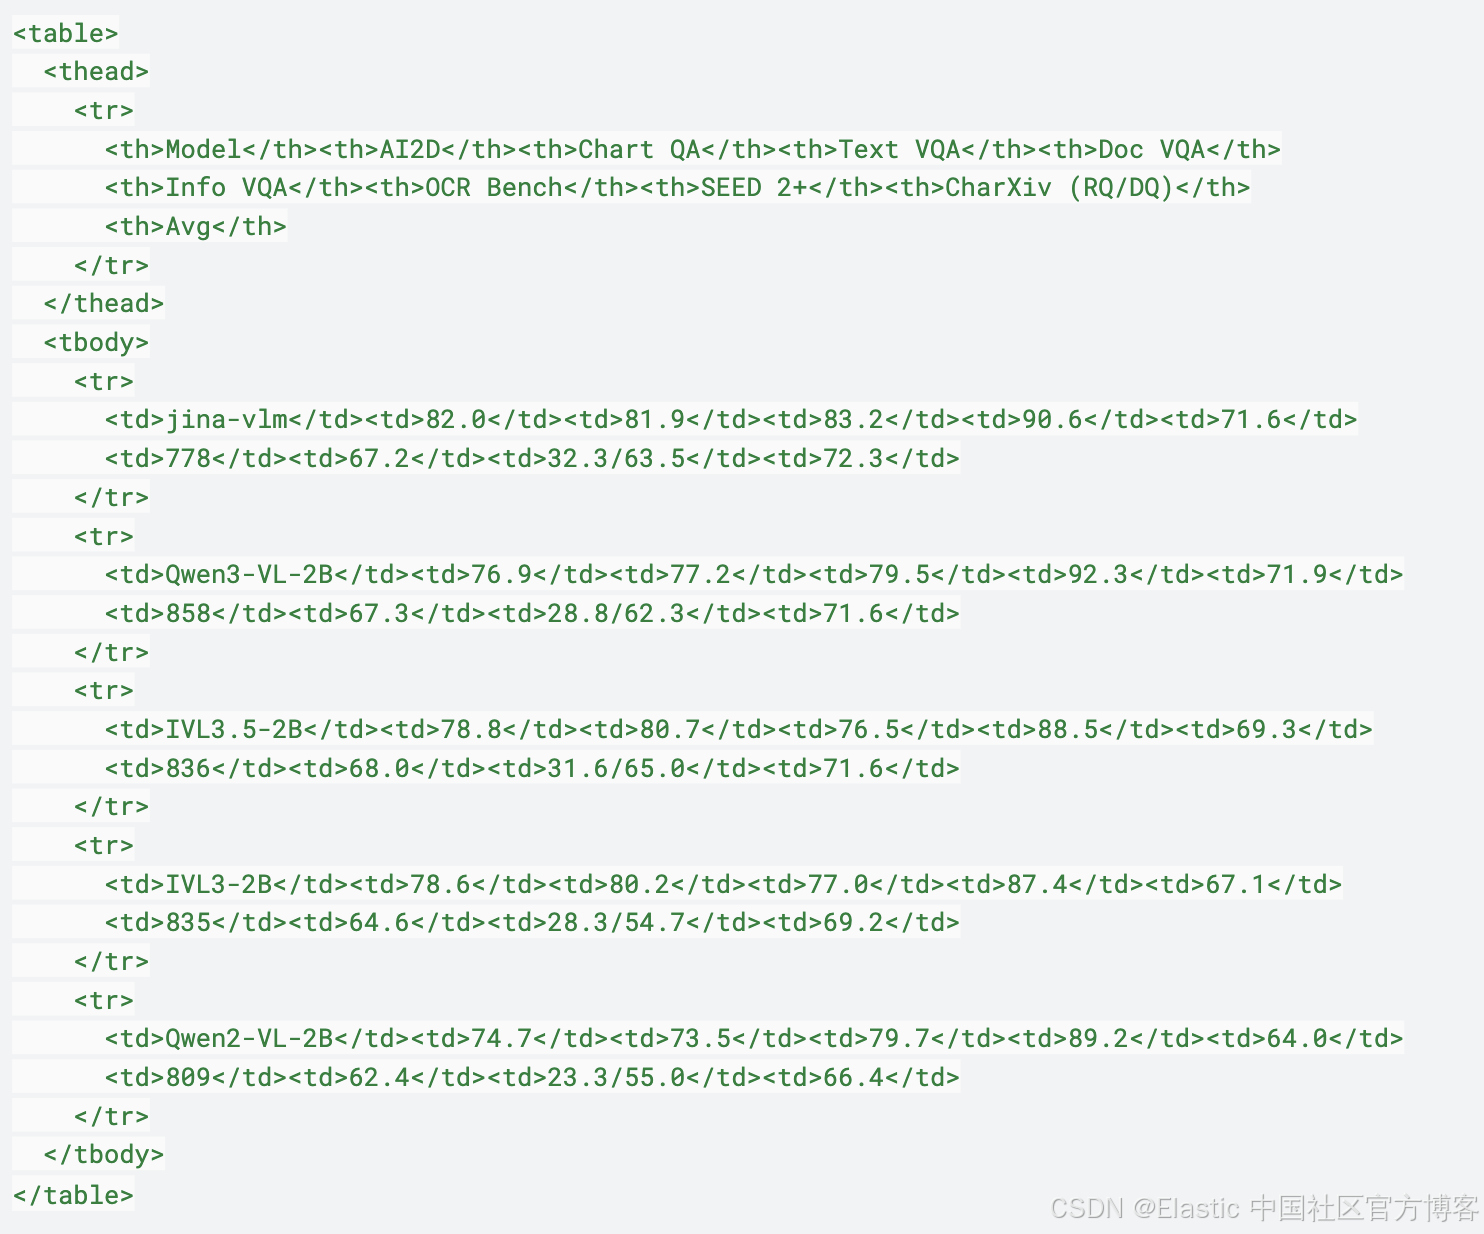
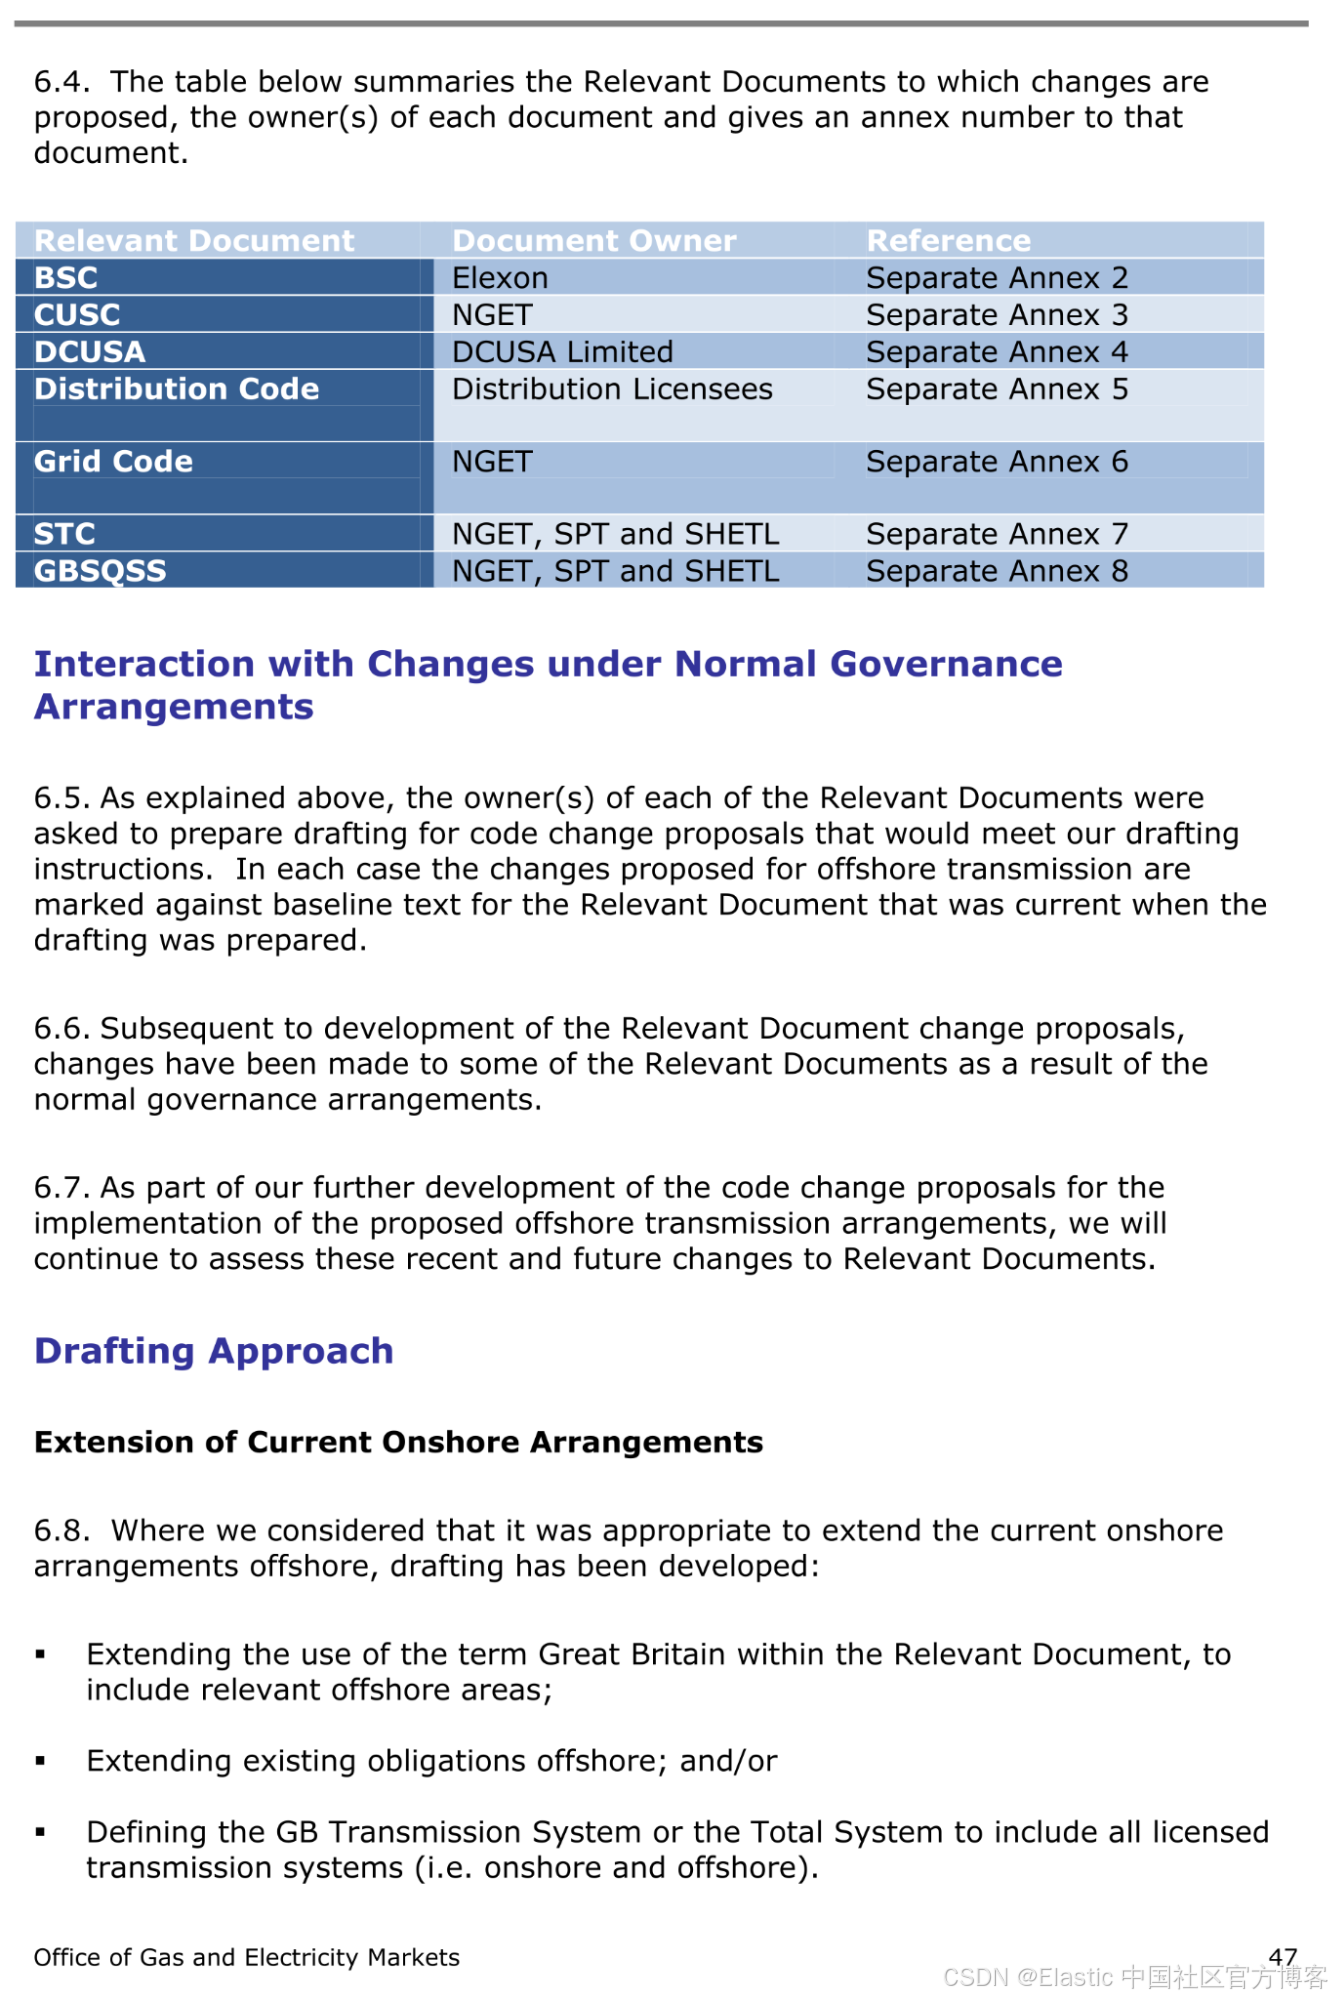
这个 HTML 可以生成一个功能上完全相同的表格,适合用于显示、读取到电子表格或其他支持表格的应用中,也适合进行进一步处理。
当表格与其他文本一起出现在页面中时,HTML 表格会被插入 Markdown 输出中,如图 9 所示:
数学公式识别:将印刷公式转换为 LaTeX
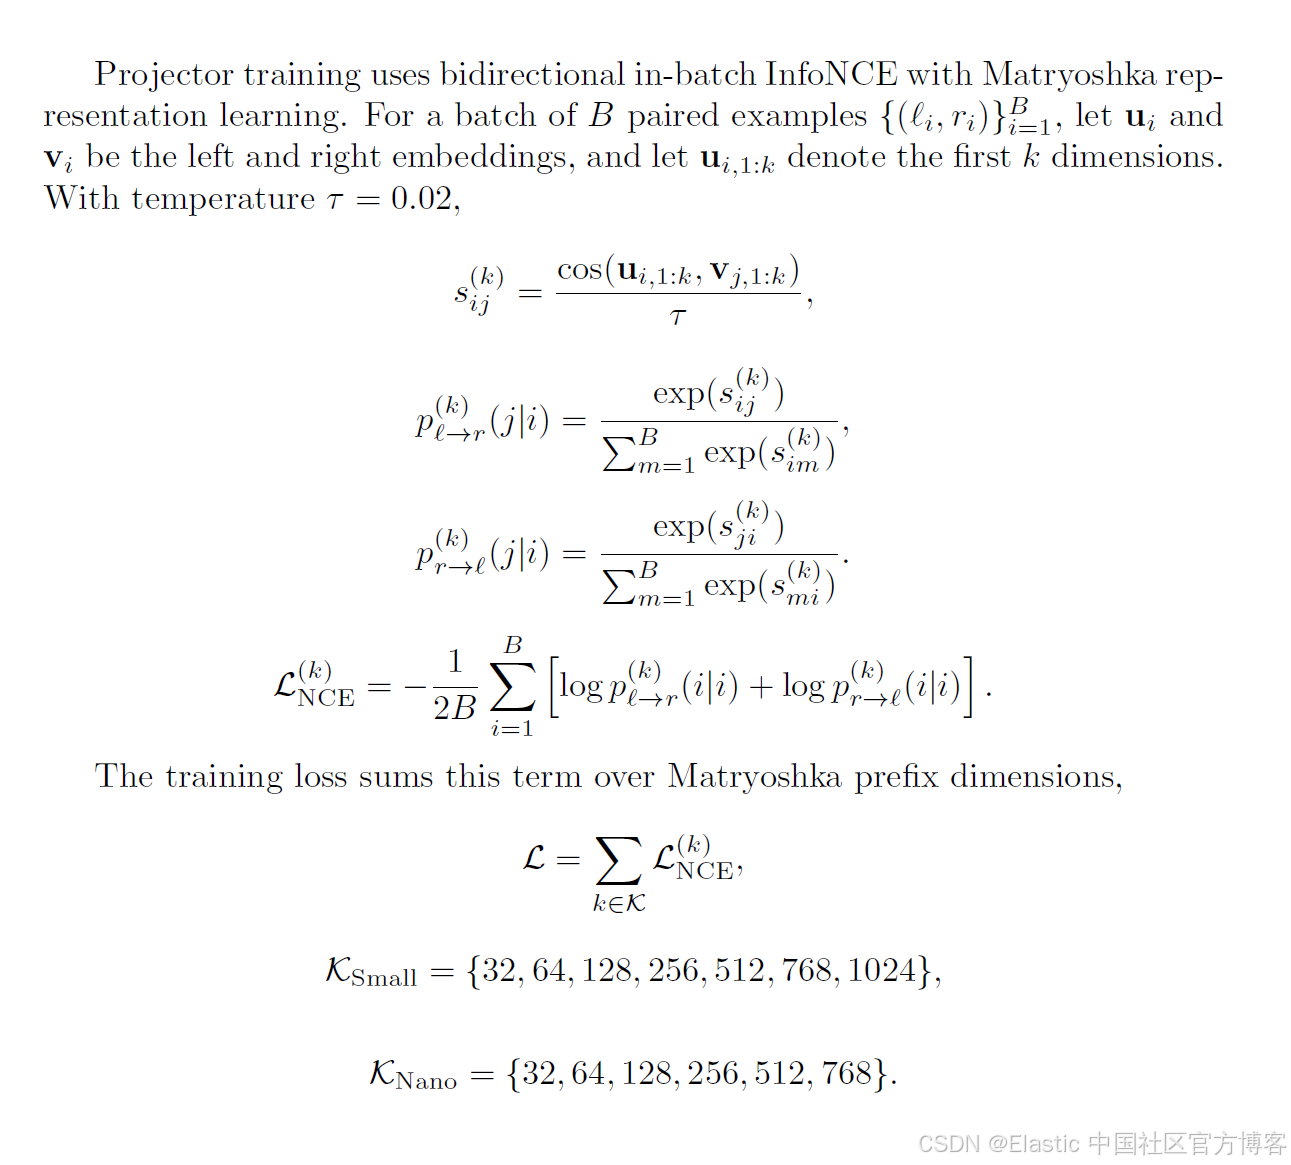
数学公式在视觉上十分复杂且具有非线性特征,其中充满了看起来像普通印刷语言的各种形状,但却无法按照普通语言的方式进行处理。jina-ocr-v1 经过专门训练,可以识别印刷数学公式,并将其转换为 LaTeX 数学代码。
图 10 是一段包含大量公式的文本图像,提取自一篇近期的 Jina AI 会议论文:
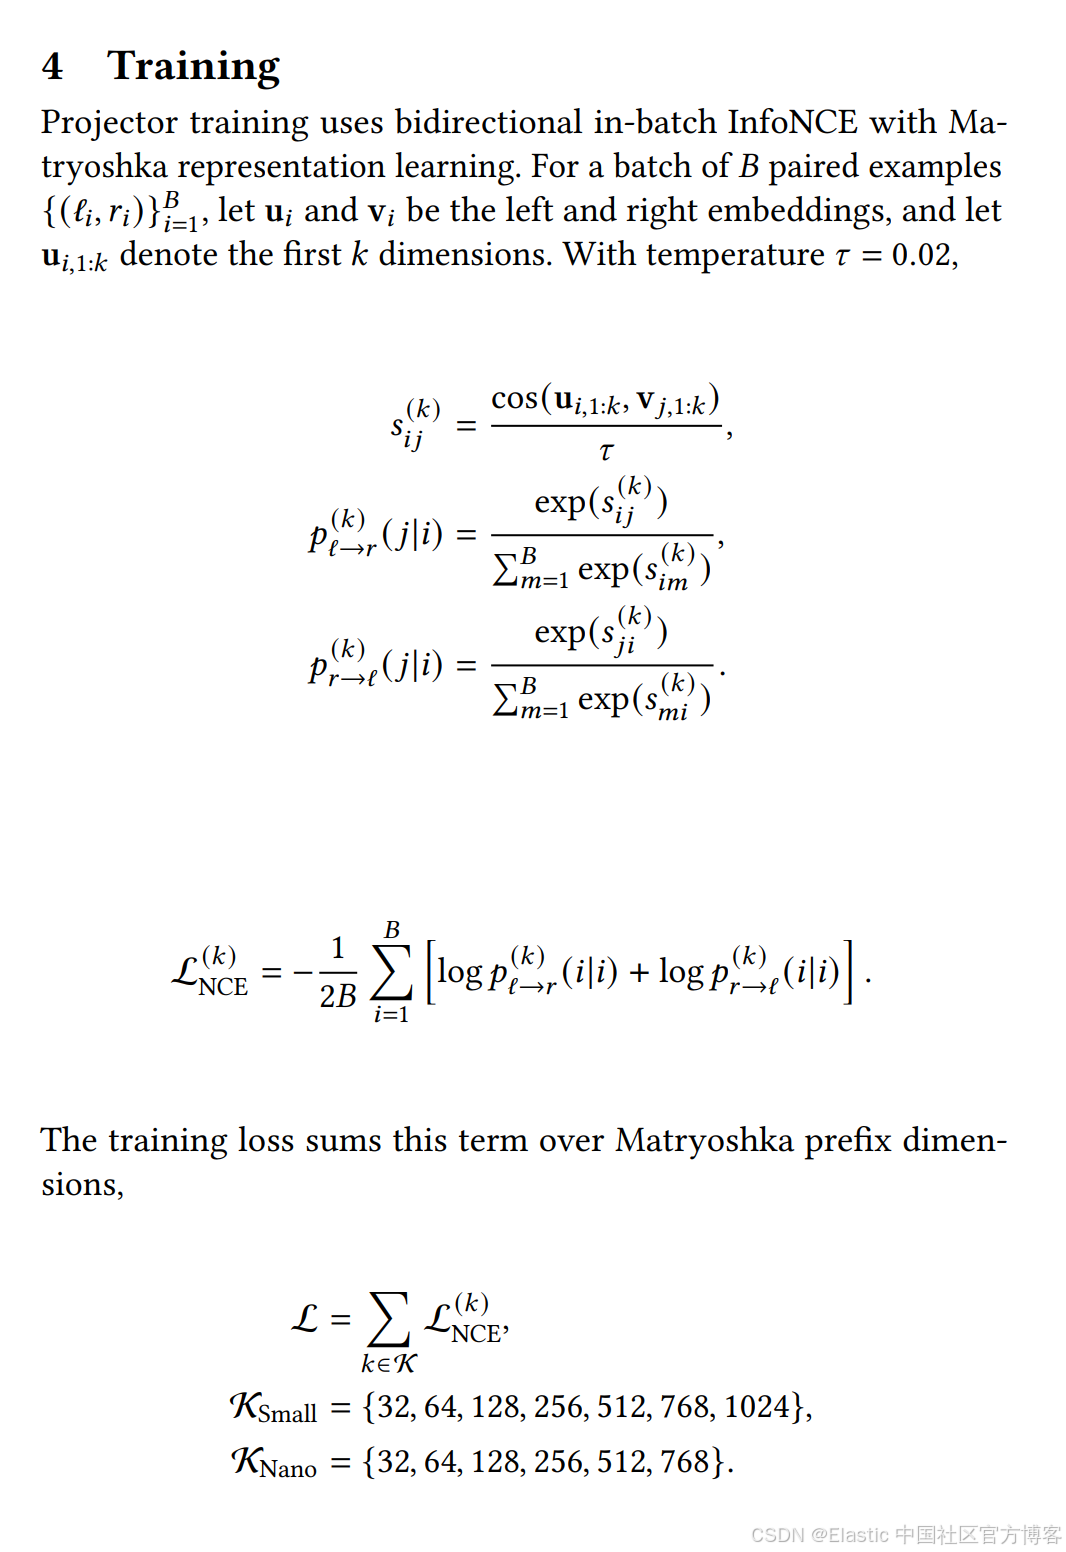
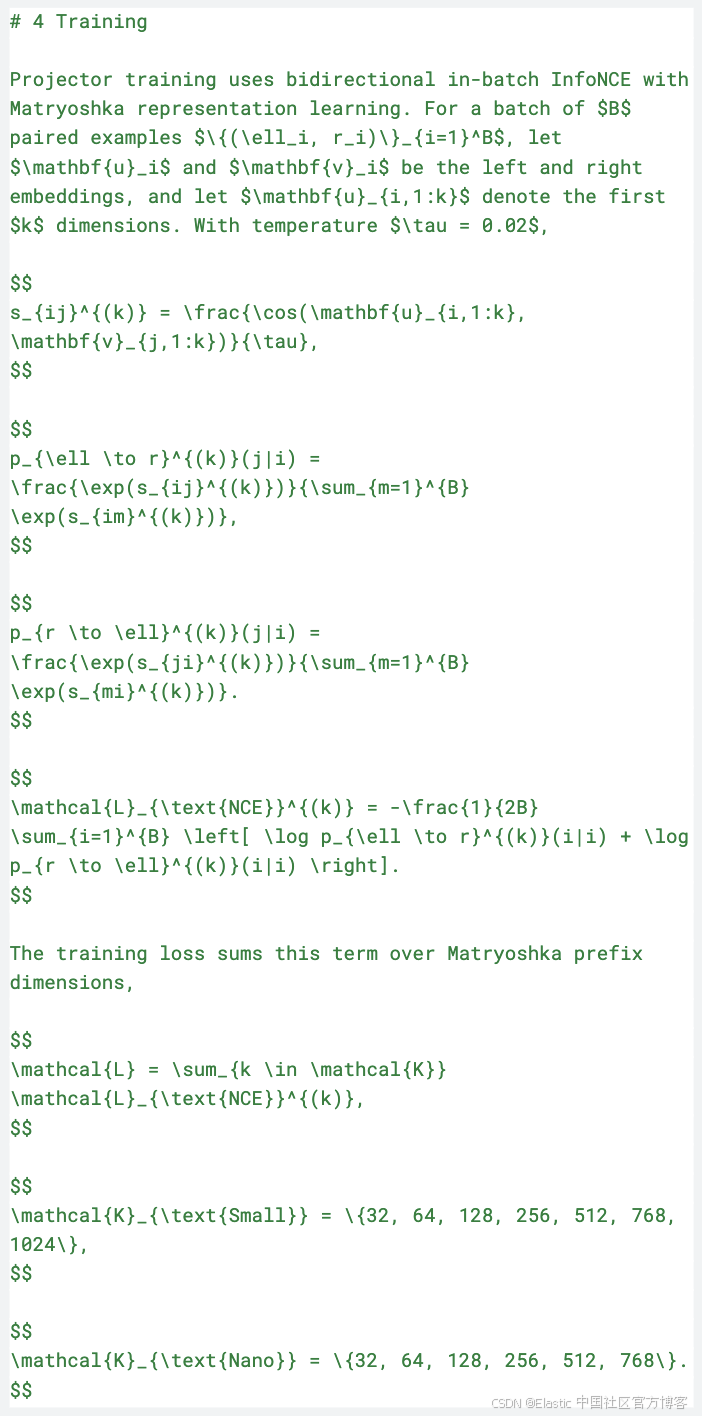
将图 10 中生成的输出粘贴到一个新的 LaTeX 文档中(包含 \usepackage{amsmath}),然后将其编译为可打印格式,得到的结果在功能上与原文基本完全一致,只缺少原文中存在的块级公式对齐:
手写识别:印刷体和草写体
jina-ocr-v1 可以处理印刷体和草写体手写文字:
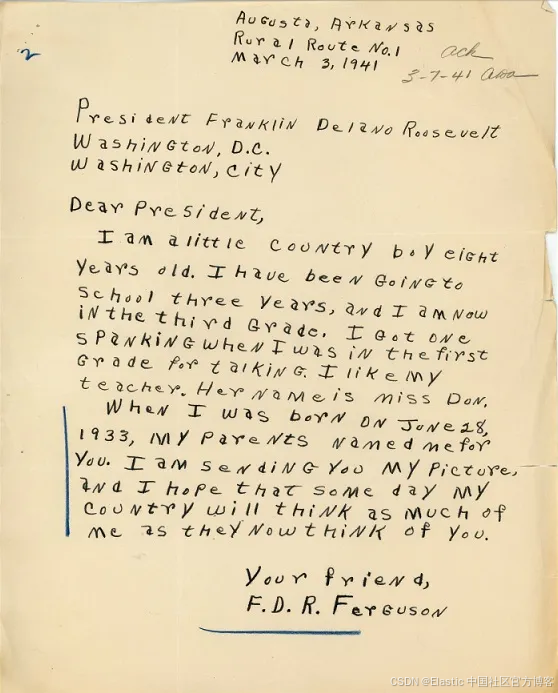
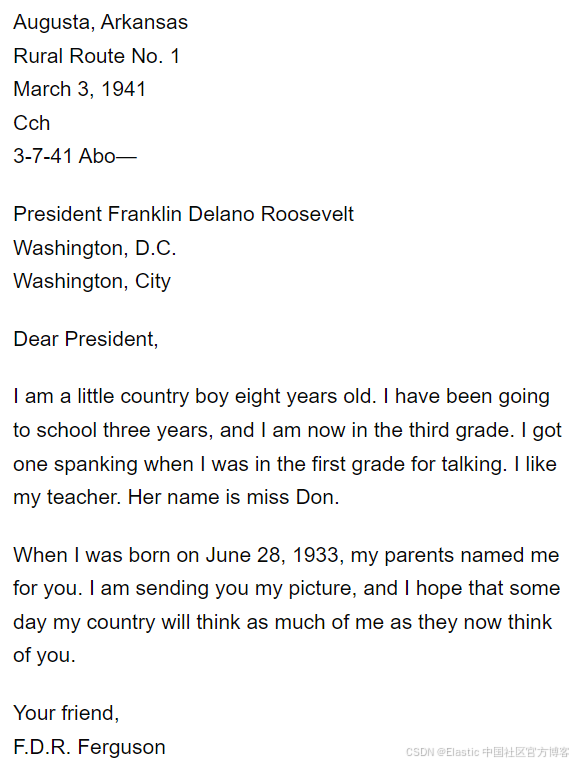
草写手写文字具有高度多样性,即使人类读者也可能难以识别。虽然 jina-ocr-v1 在整洁的英文草写文字上表现良好,但潦草的书写对它来说和对人类一样难以识别。当文字书写潦草、OCR 捕获效果不佳,或者本身难以辨认时,jina-ocr-v1 的表现可能会相当差。
例如,下面的手写文字来自著名的儿童读物插画家 Beatrix Potter:
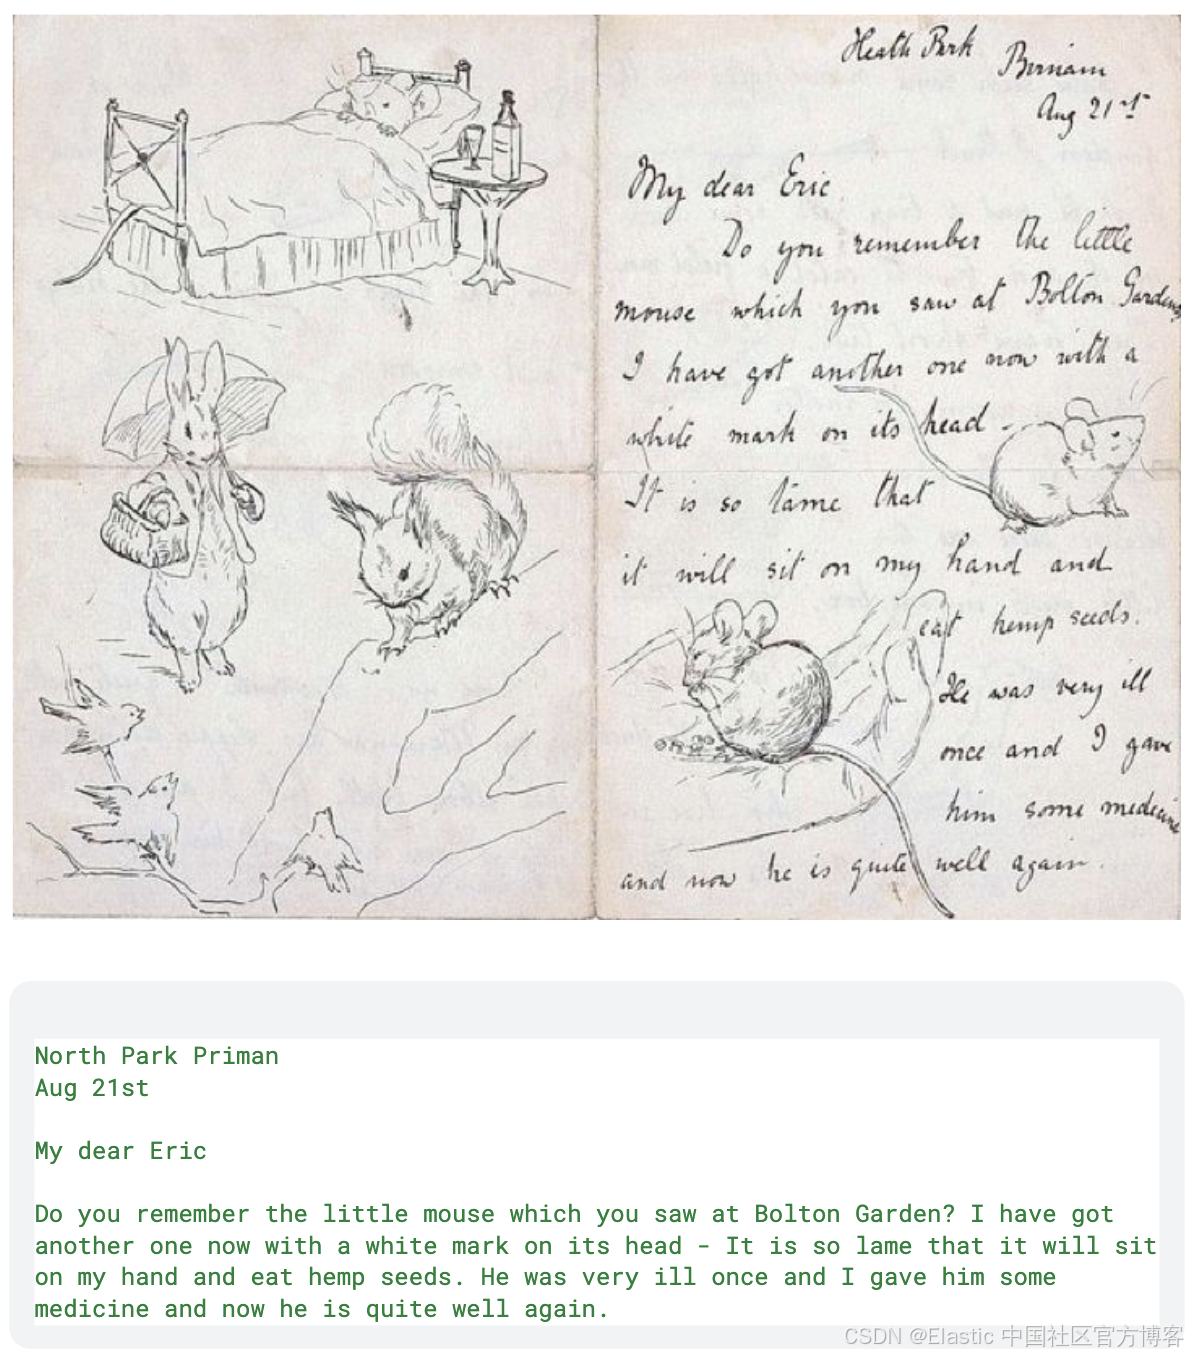
jina-ocr-v1 能够准确捕获图 13 中流畅的草写文字,即使这些文字环绕在 Potter 绘制的老鼠图画周围也是如此。不过,顶部的地名书写得没有那么清晰,而且缺乏用于消除歧义的上下文,因此产生了错误。即使是人类读者也可能觉得难以辨认。
用于幻灯片、报告、标签和名片的 OCR
jina-ocr-v1 针对复杂布局进行了扩展训练,因此能够很好地处理非常规材料。下面的示例展示了该模型能力的部分范围。
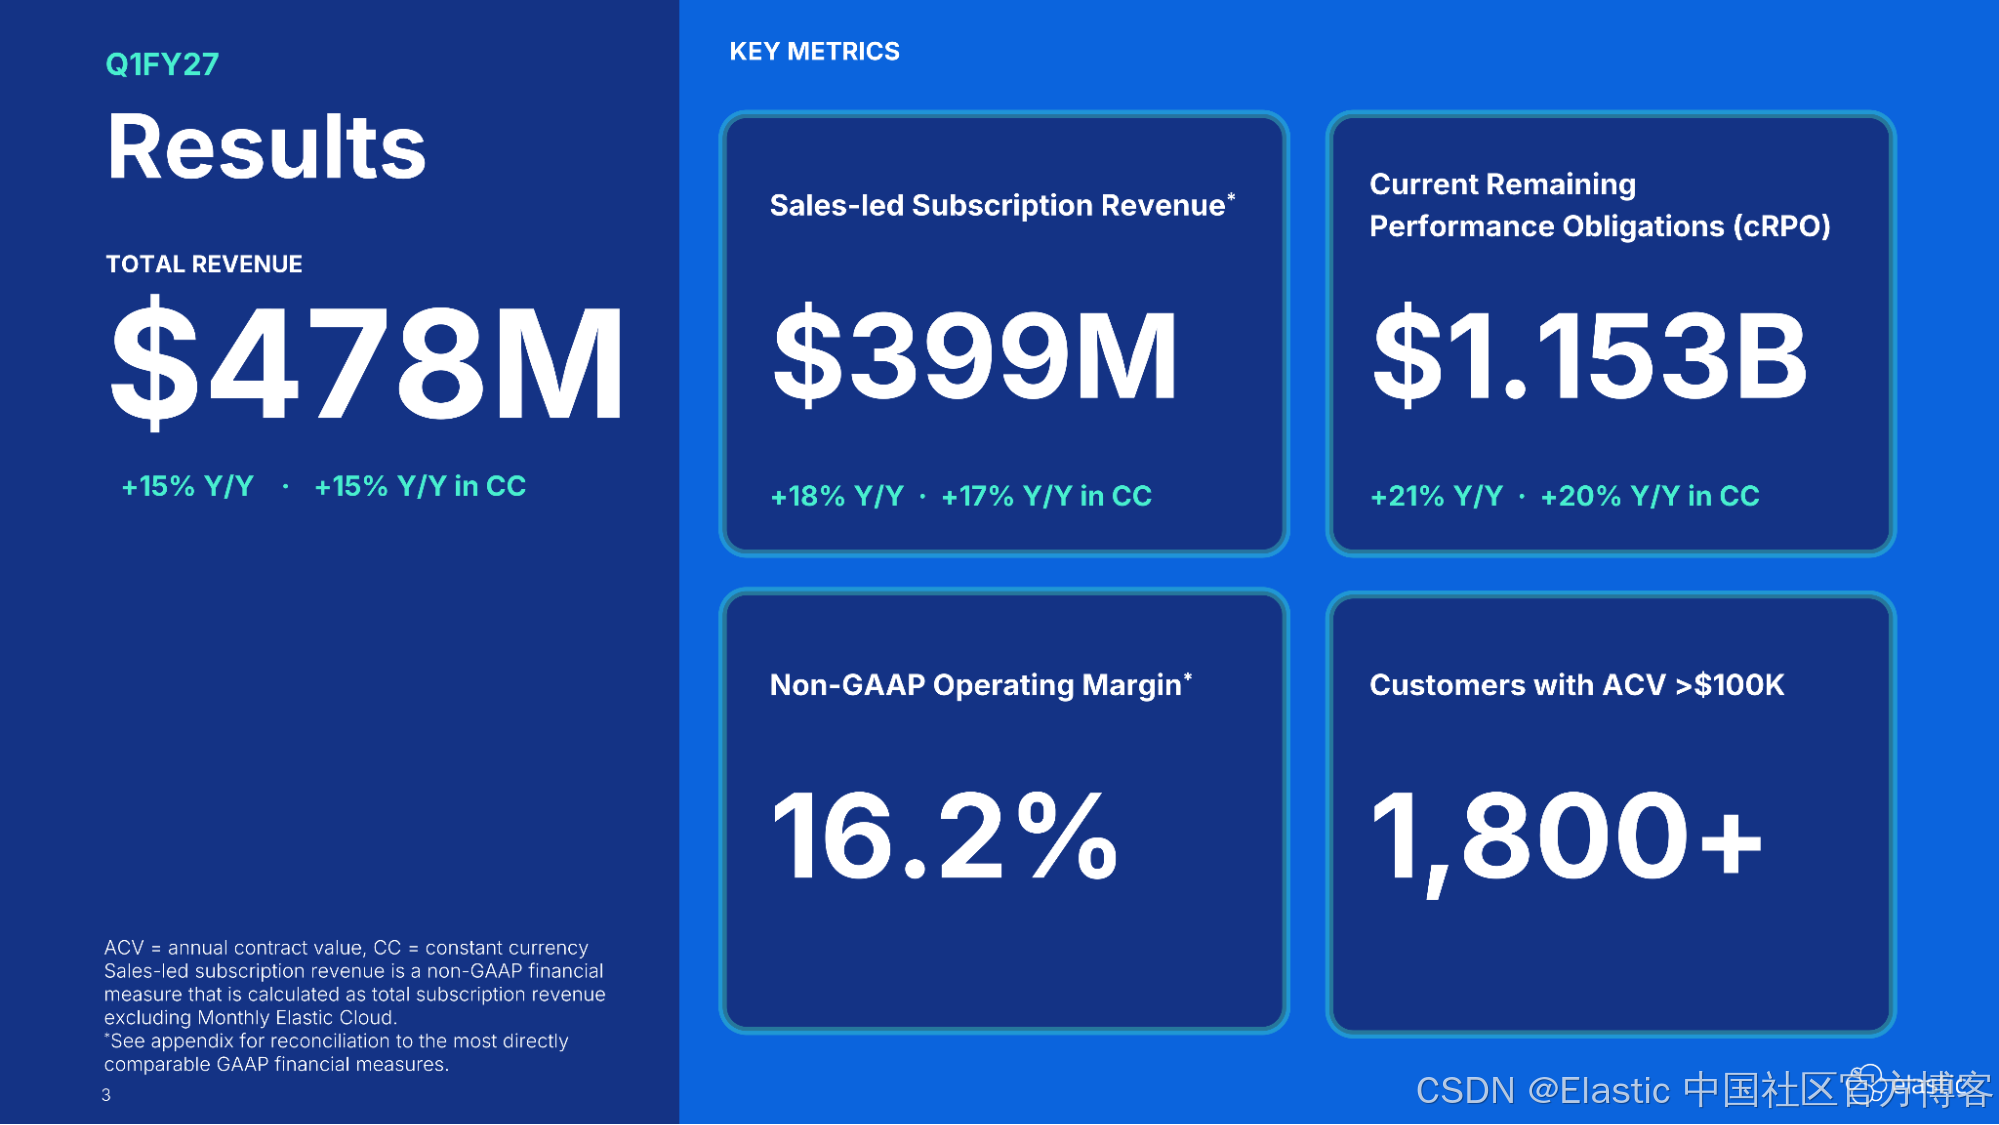
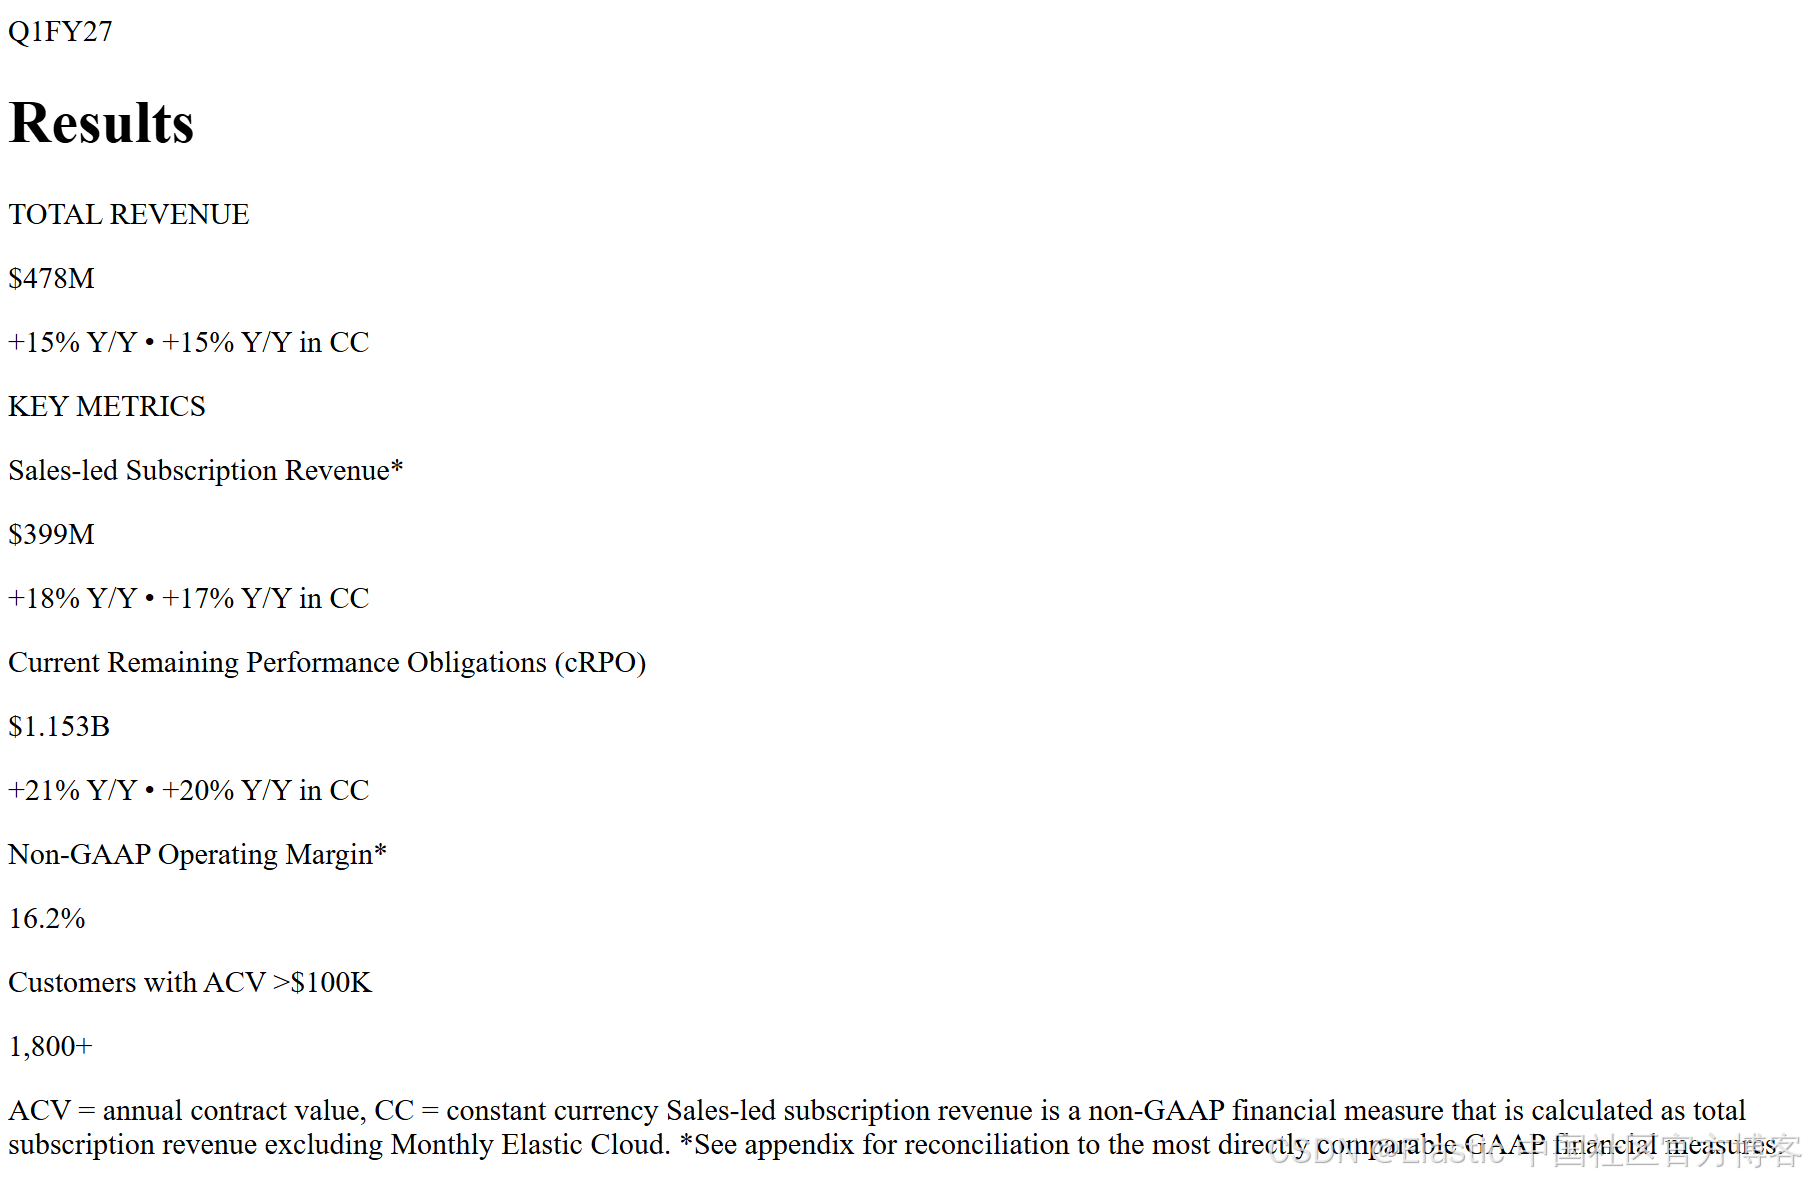
商业报告
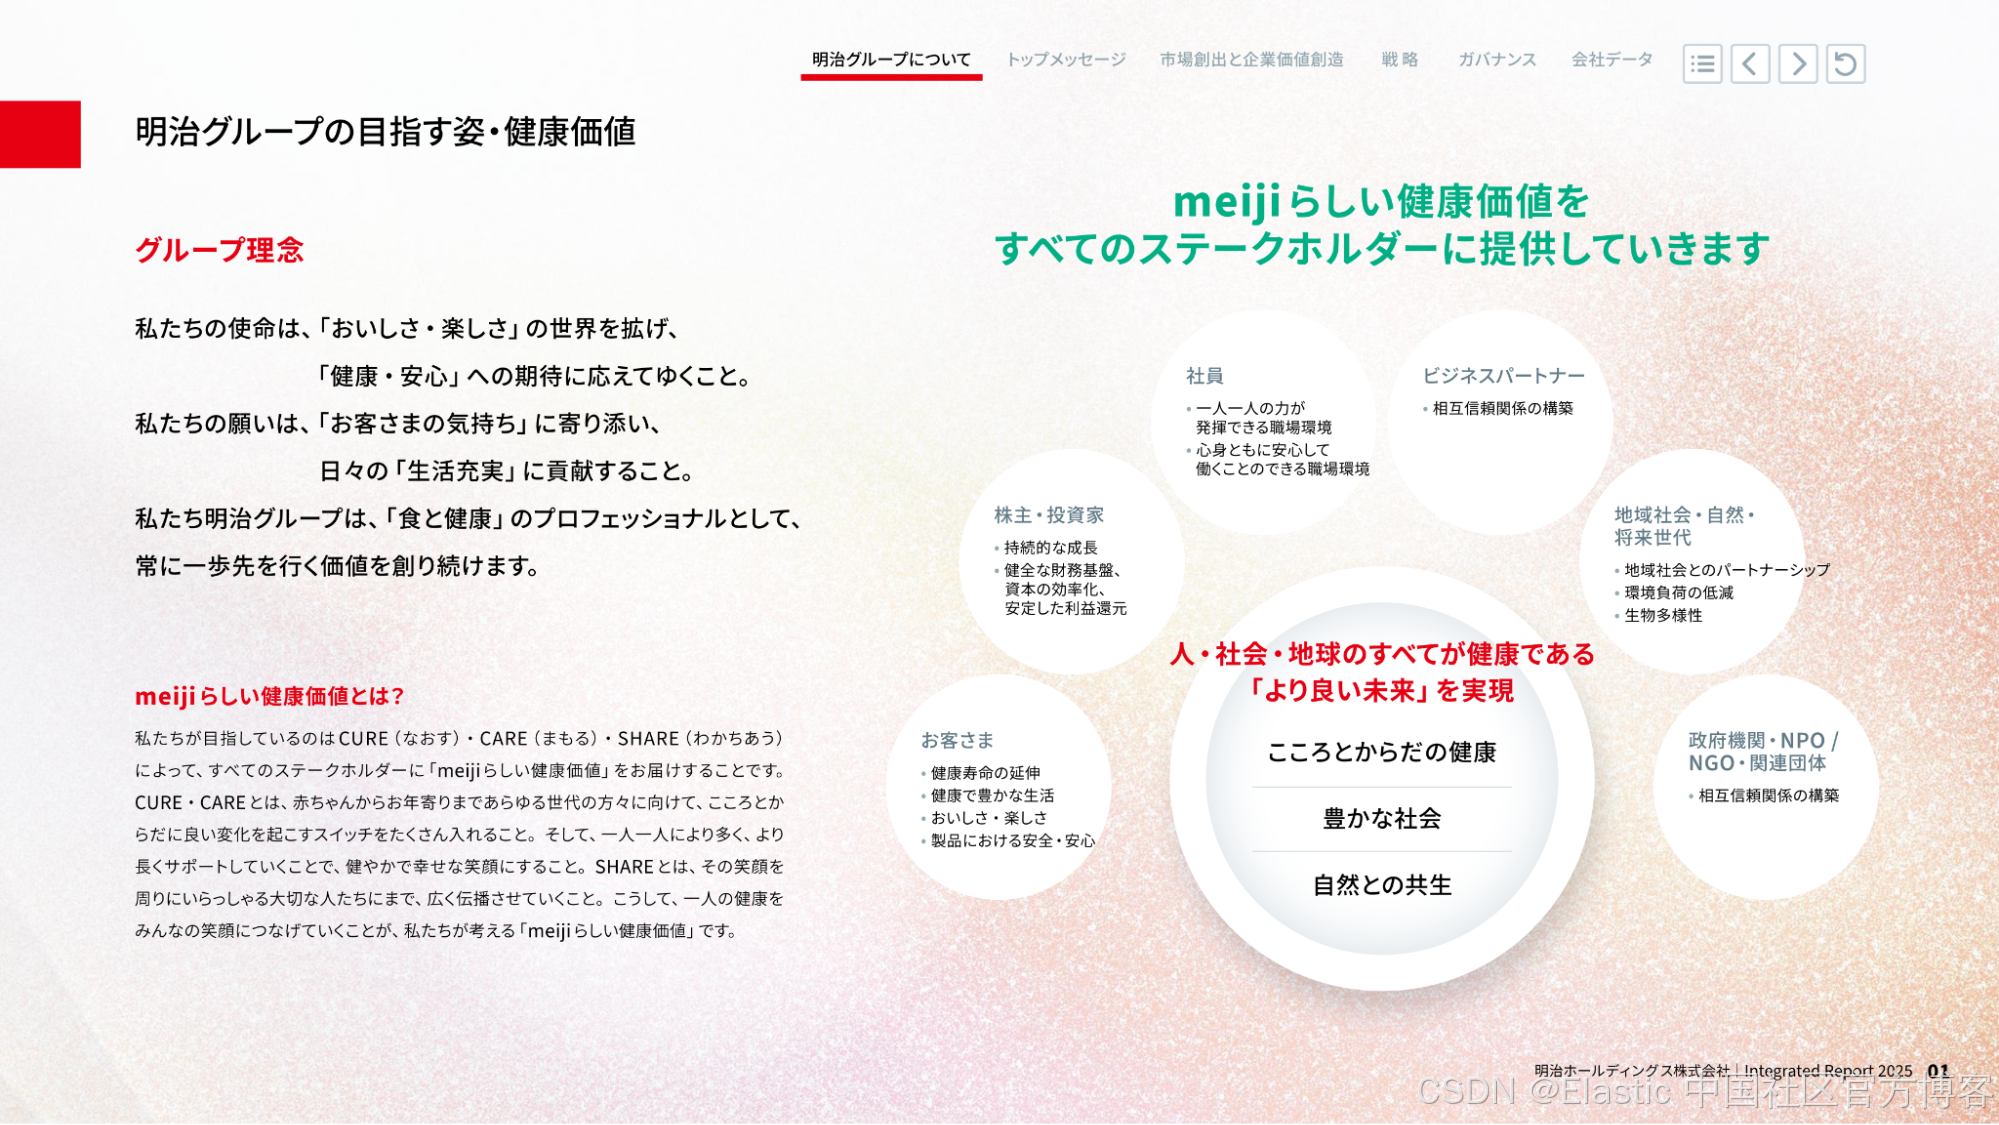
jina-ocr-v1 可以处理企业商业报告中视觉信息密集的页面,如图 15 所示:
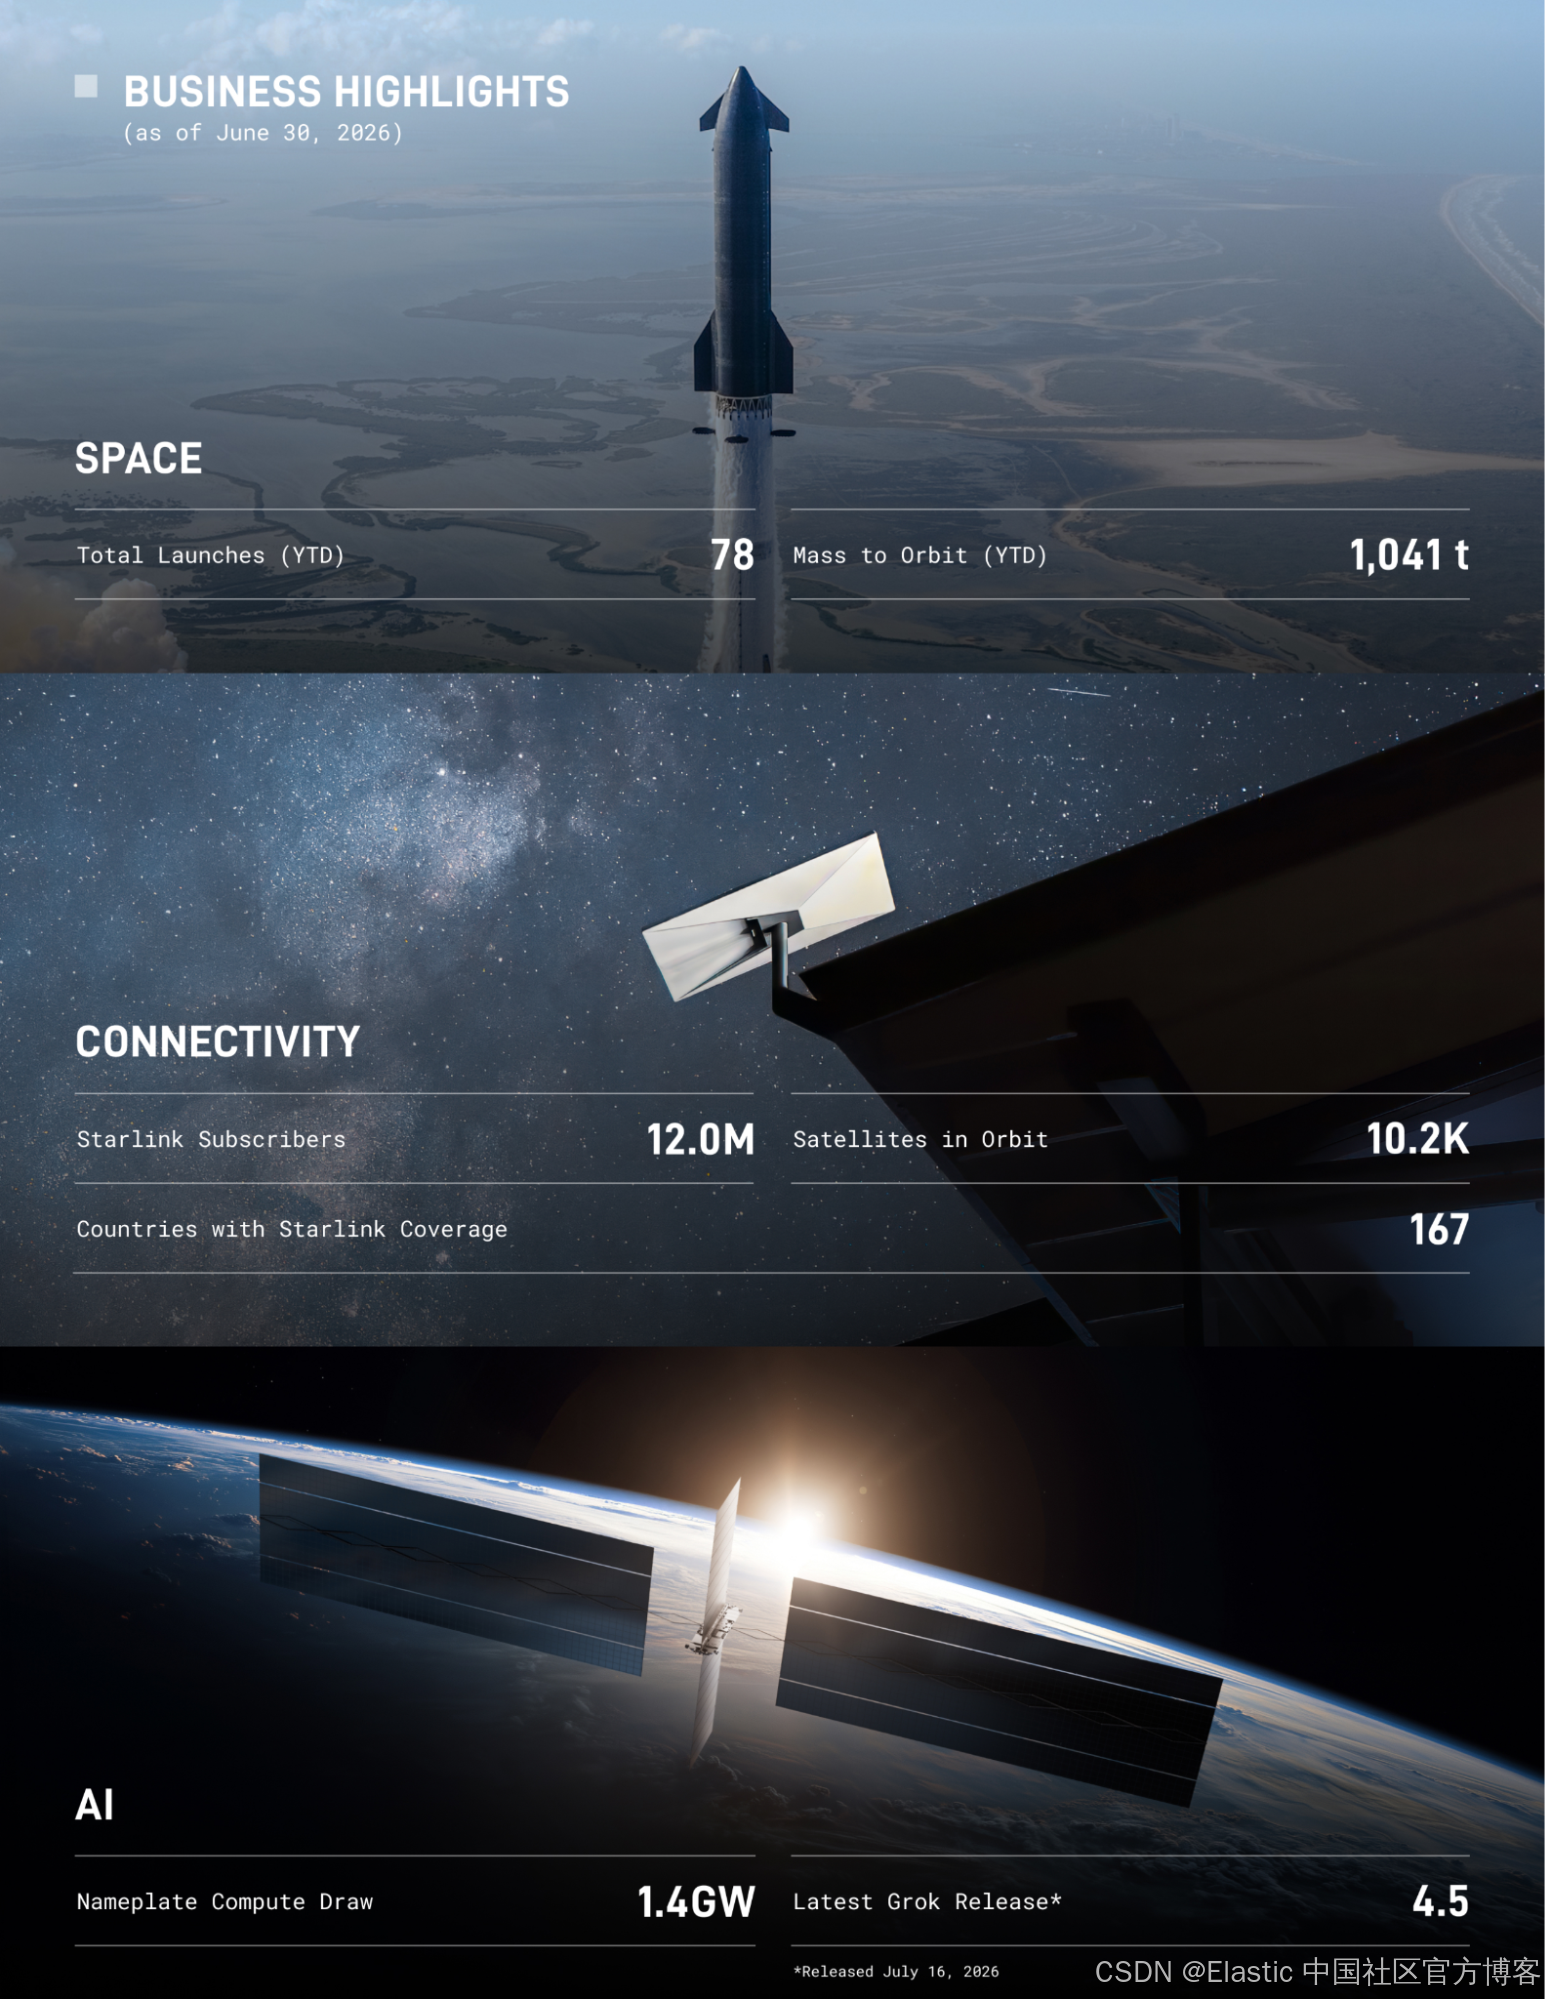
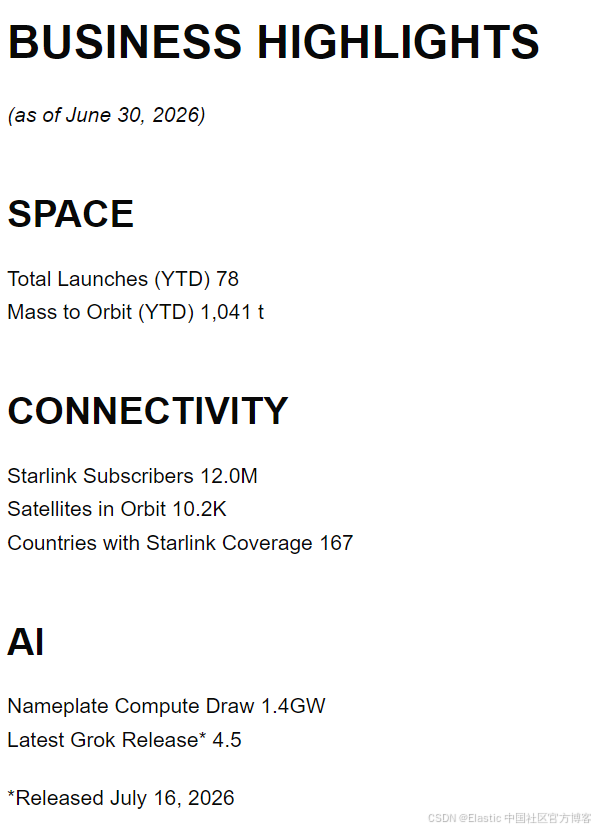
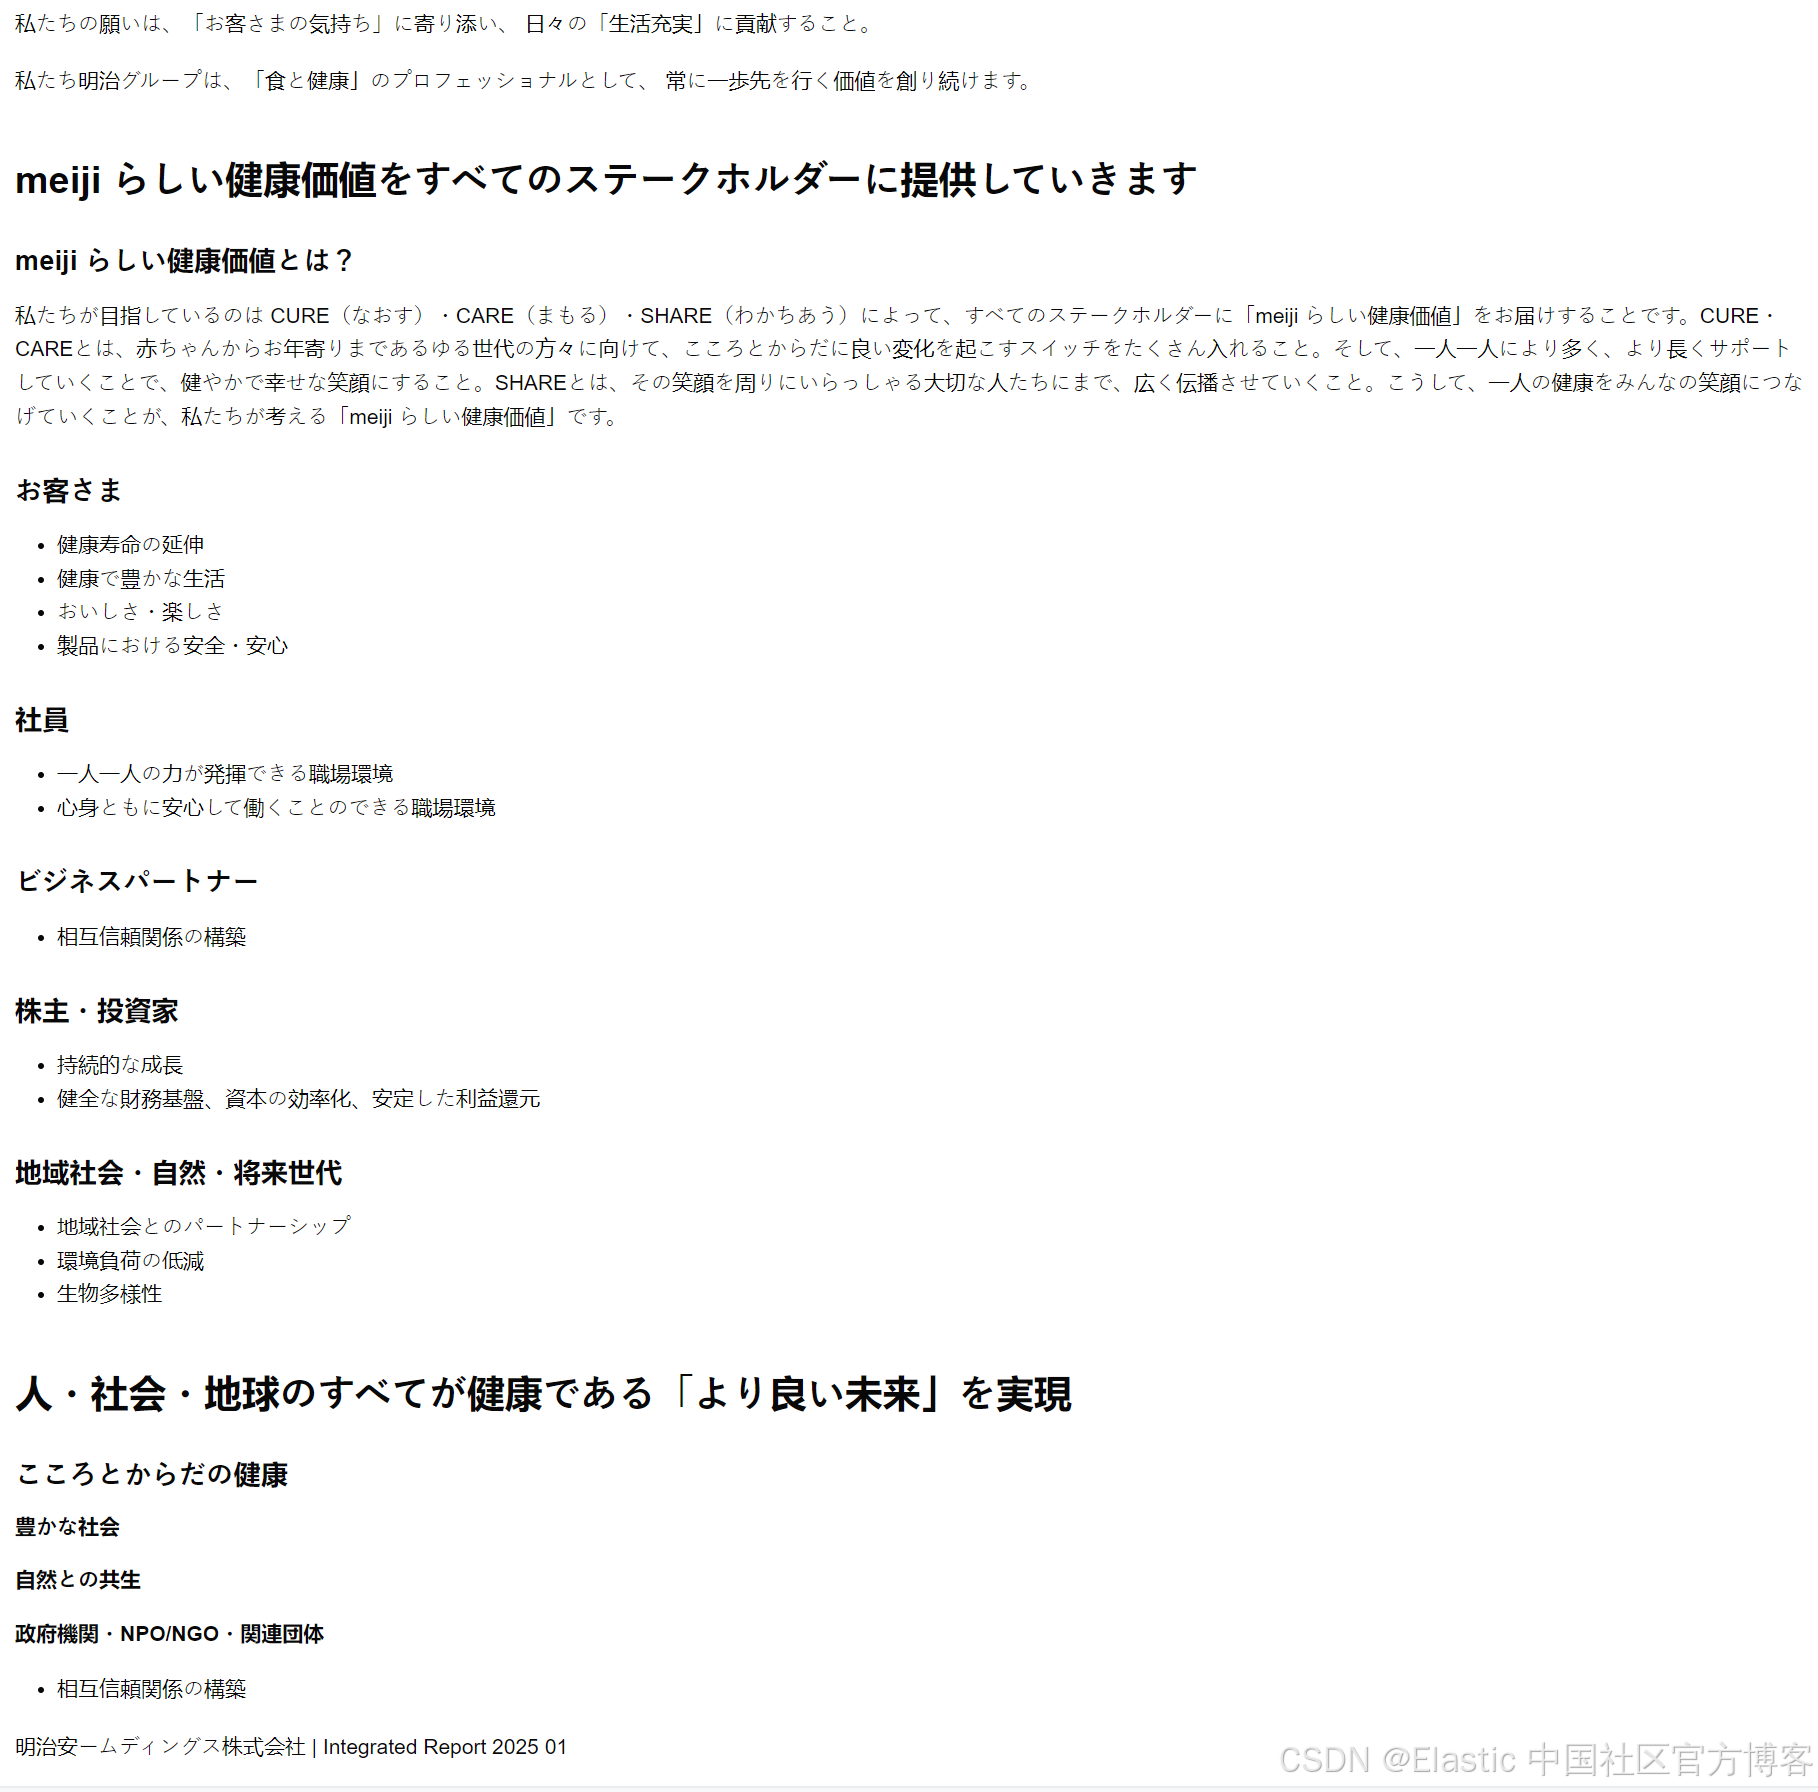
精美的商业报告和演示文稿通常采用复杂且富有视觉效果的布局,这使得传统 OCR 很难正确处理。jina-ocr-v1 非常擅长处理这类材料,如下面图 16 中的示例所示:
标签和包装
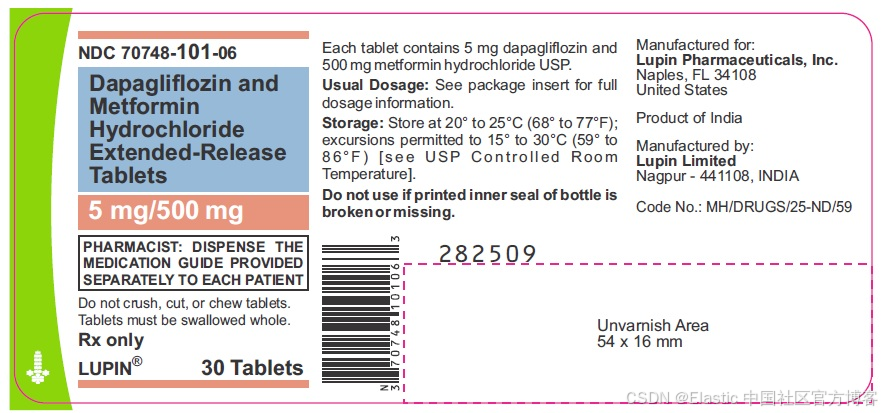
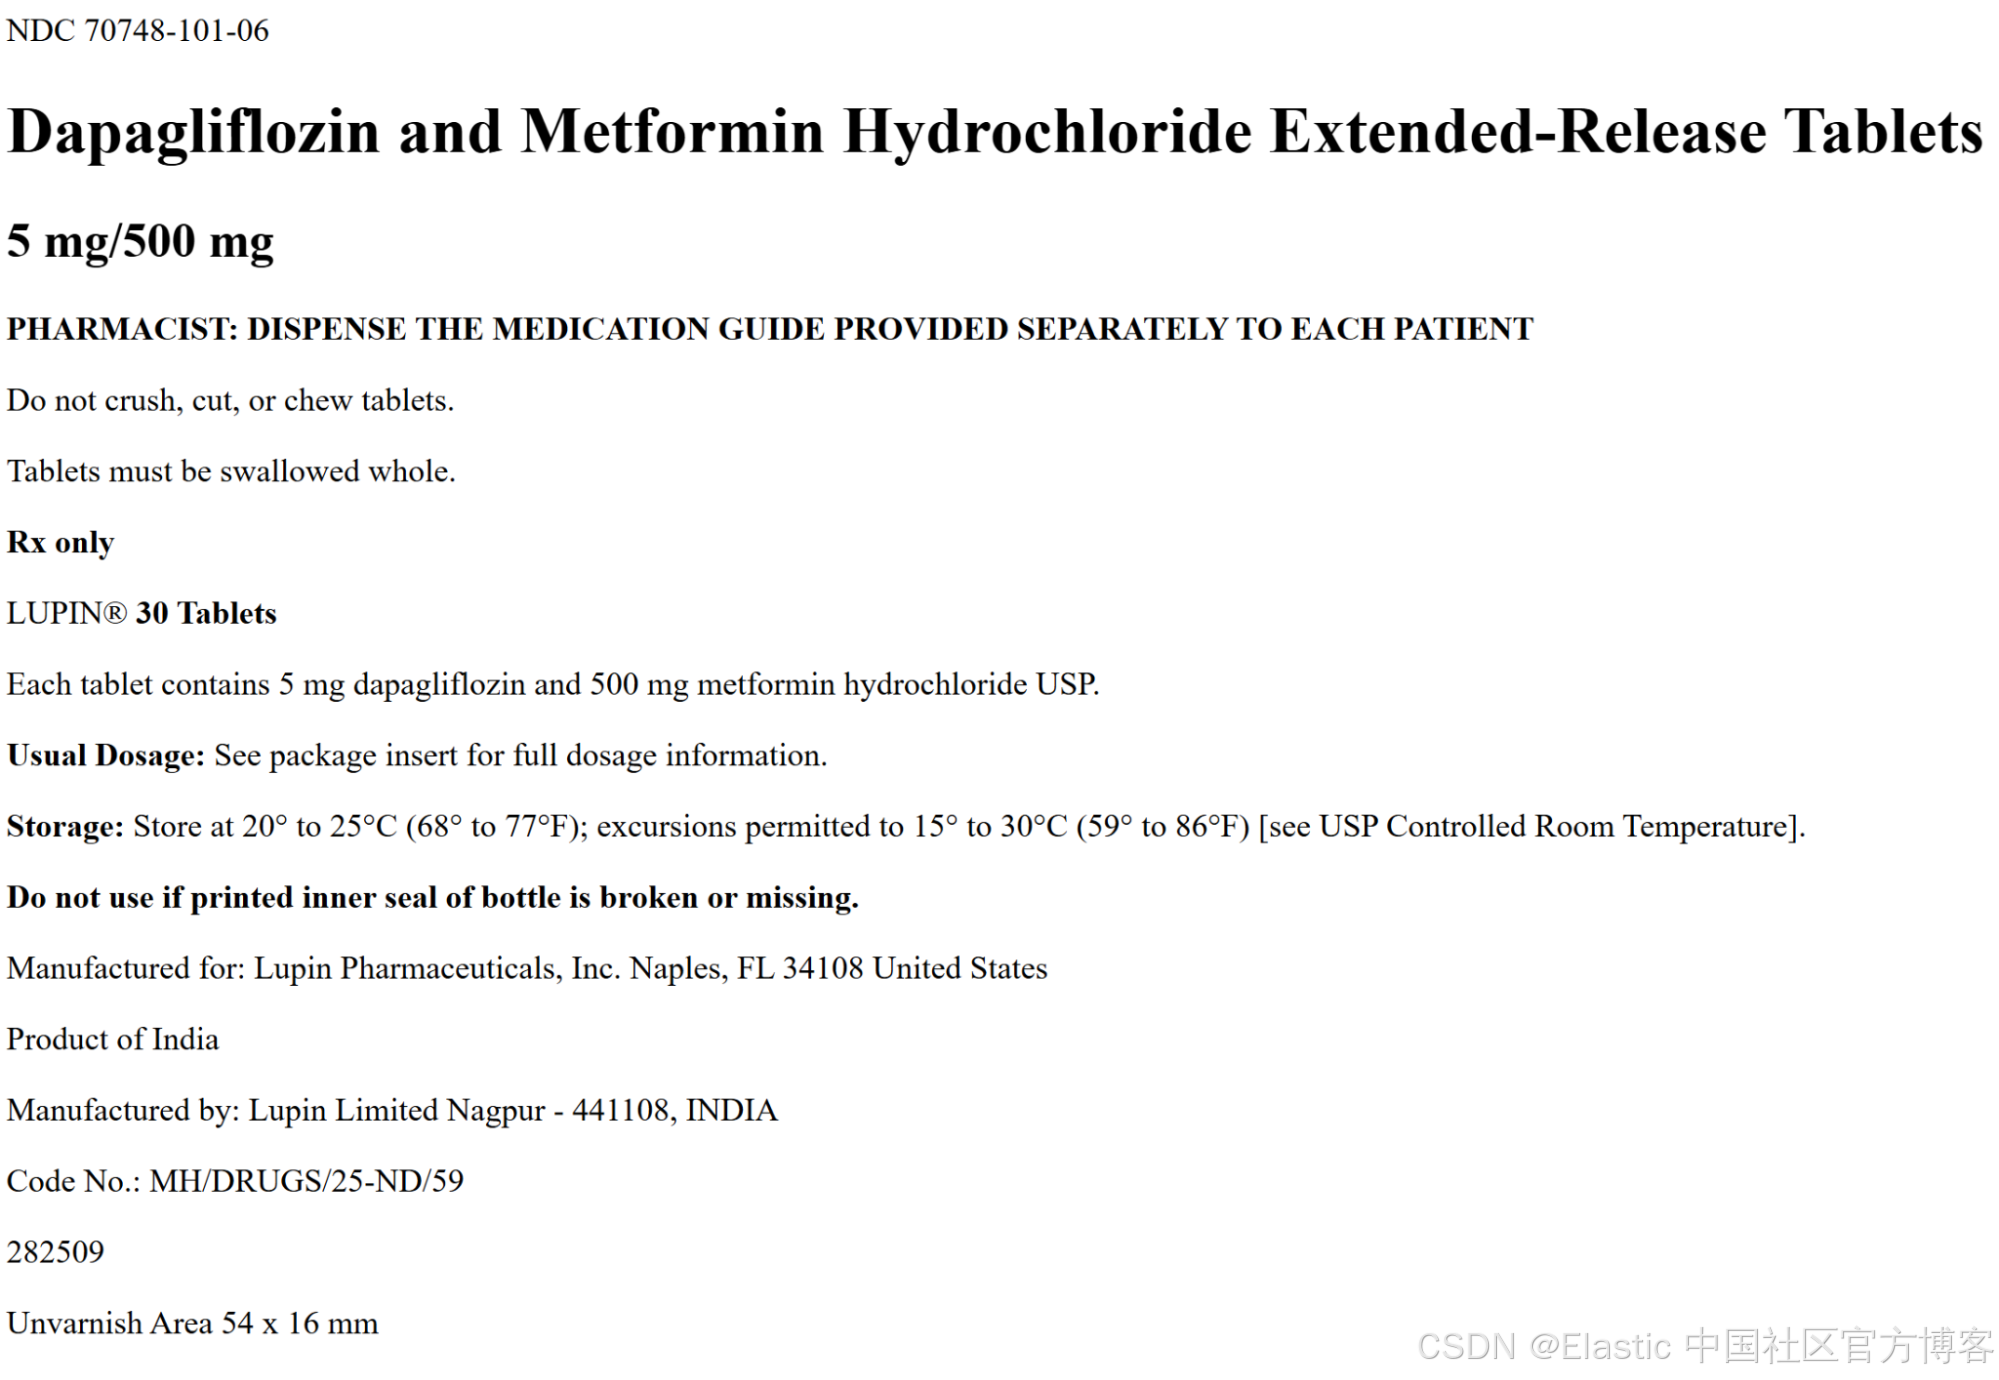
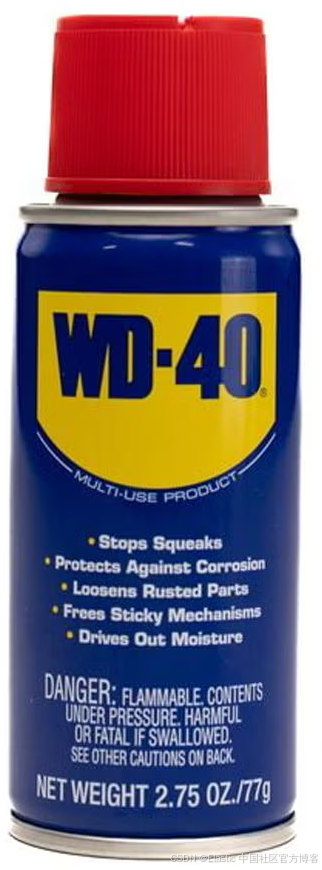
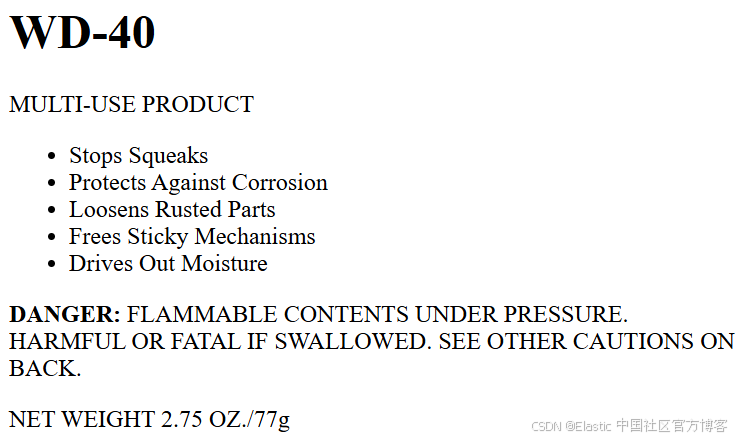
jina-ocr-v1 可以读取标签和平面设计材料中的印刷文字。这对于信息量较大的材料尤其有帮助,例如药品包装:
如果图像质量足够高,它同样能够很好地处理更常见的消费品标签和照片,如图 18 所示:
名片
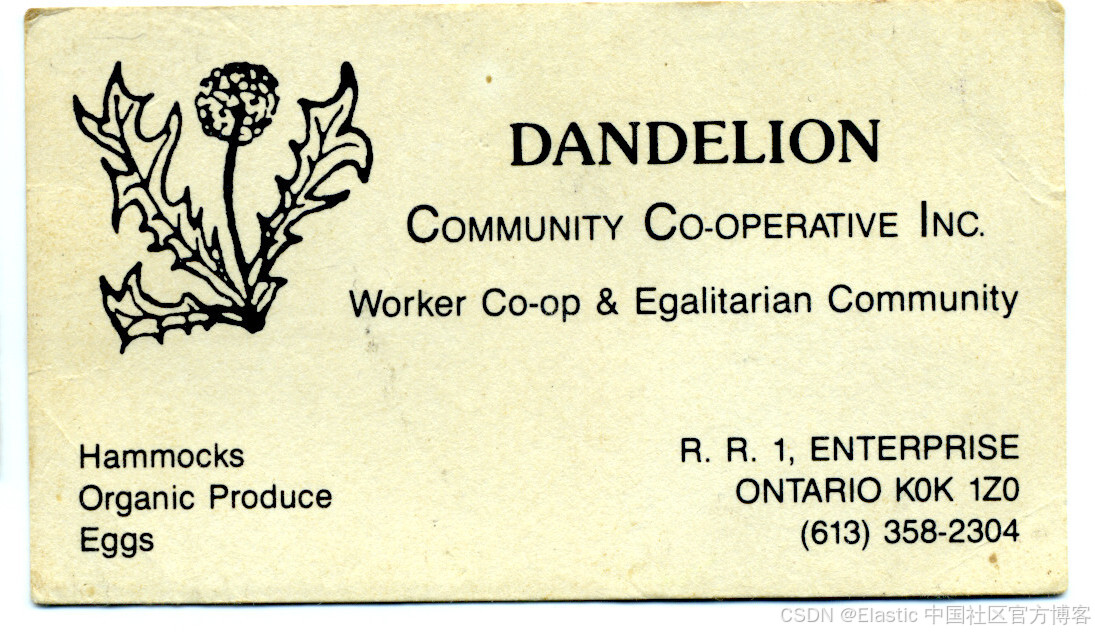
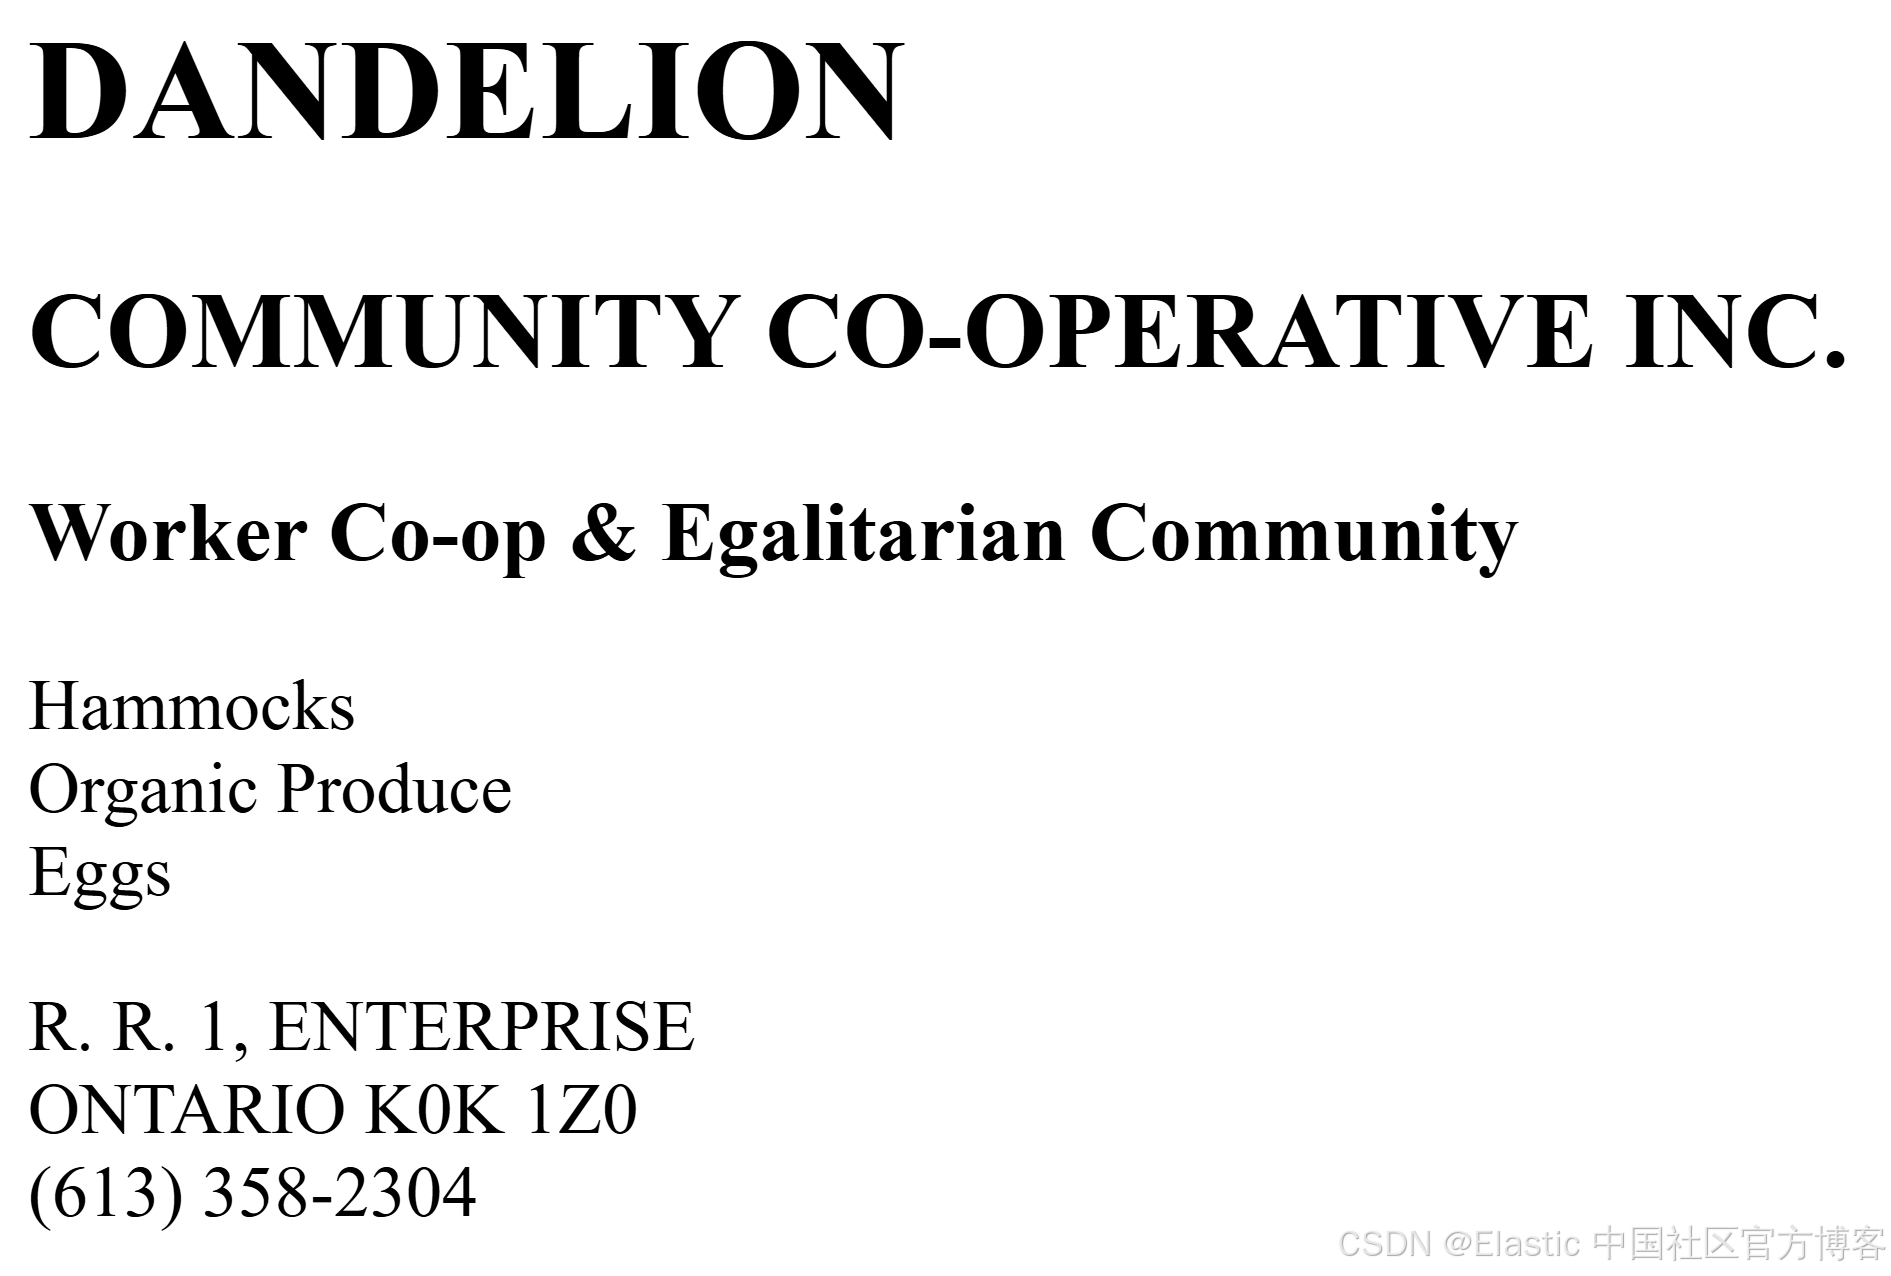
jina-ocr-v1 处理名片这类视觉信息紧凑的文档毫无困难:
支持 100 多种语言的多语言 OCR
jina-ocr-v1 已针对 100 多种全球自然语言进行训练。它无需额外模块来支持不同的语言或文字系统,就能为各种全球媒体提供高质量的 OCR。
变音符号和经过修改的拉丁字母
单语言 OCR 软件(尤其是针对英语的软件)通常难以正确呈现字母上的变音符号。大多数语言都会使用这些符号,而无法准确呈现变音符号可能导致索引、信息检索和其他下游应用失败。
即使是在法语和德语等西欧语言中,带有修改形式的字母,如带变音符号的 C(Ç)和 Eszett(ß),也给许多 OCR 软件套件带来了众所周知的问题:
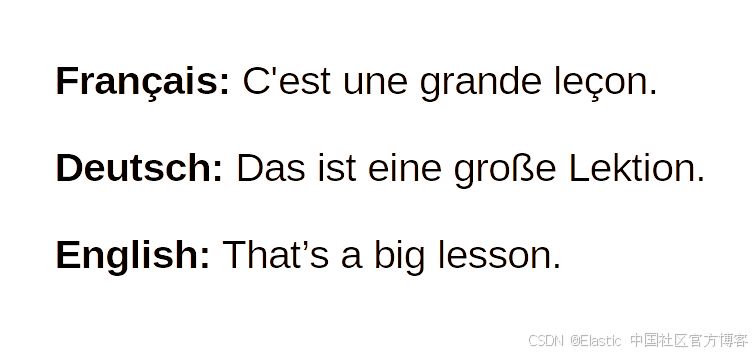
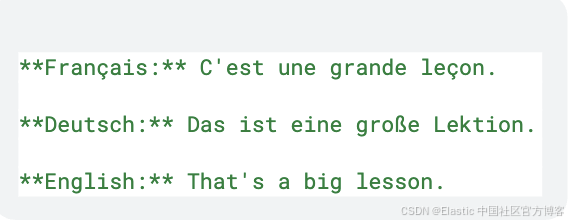
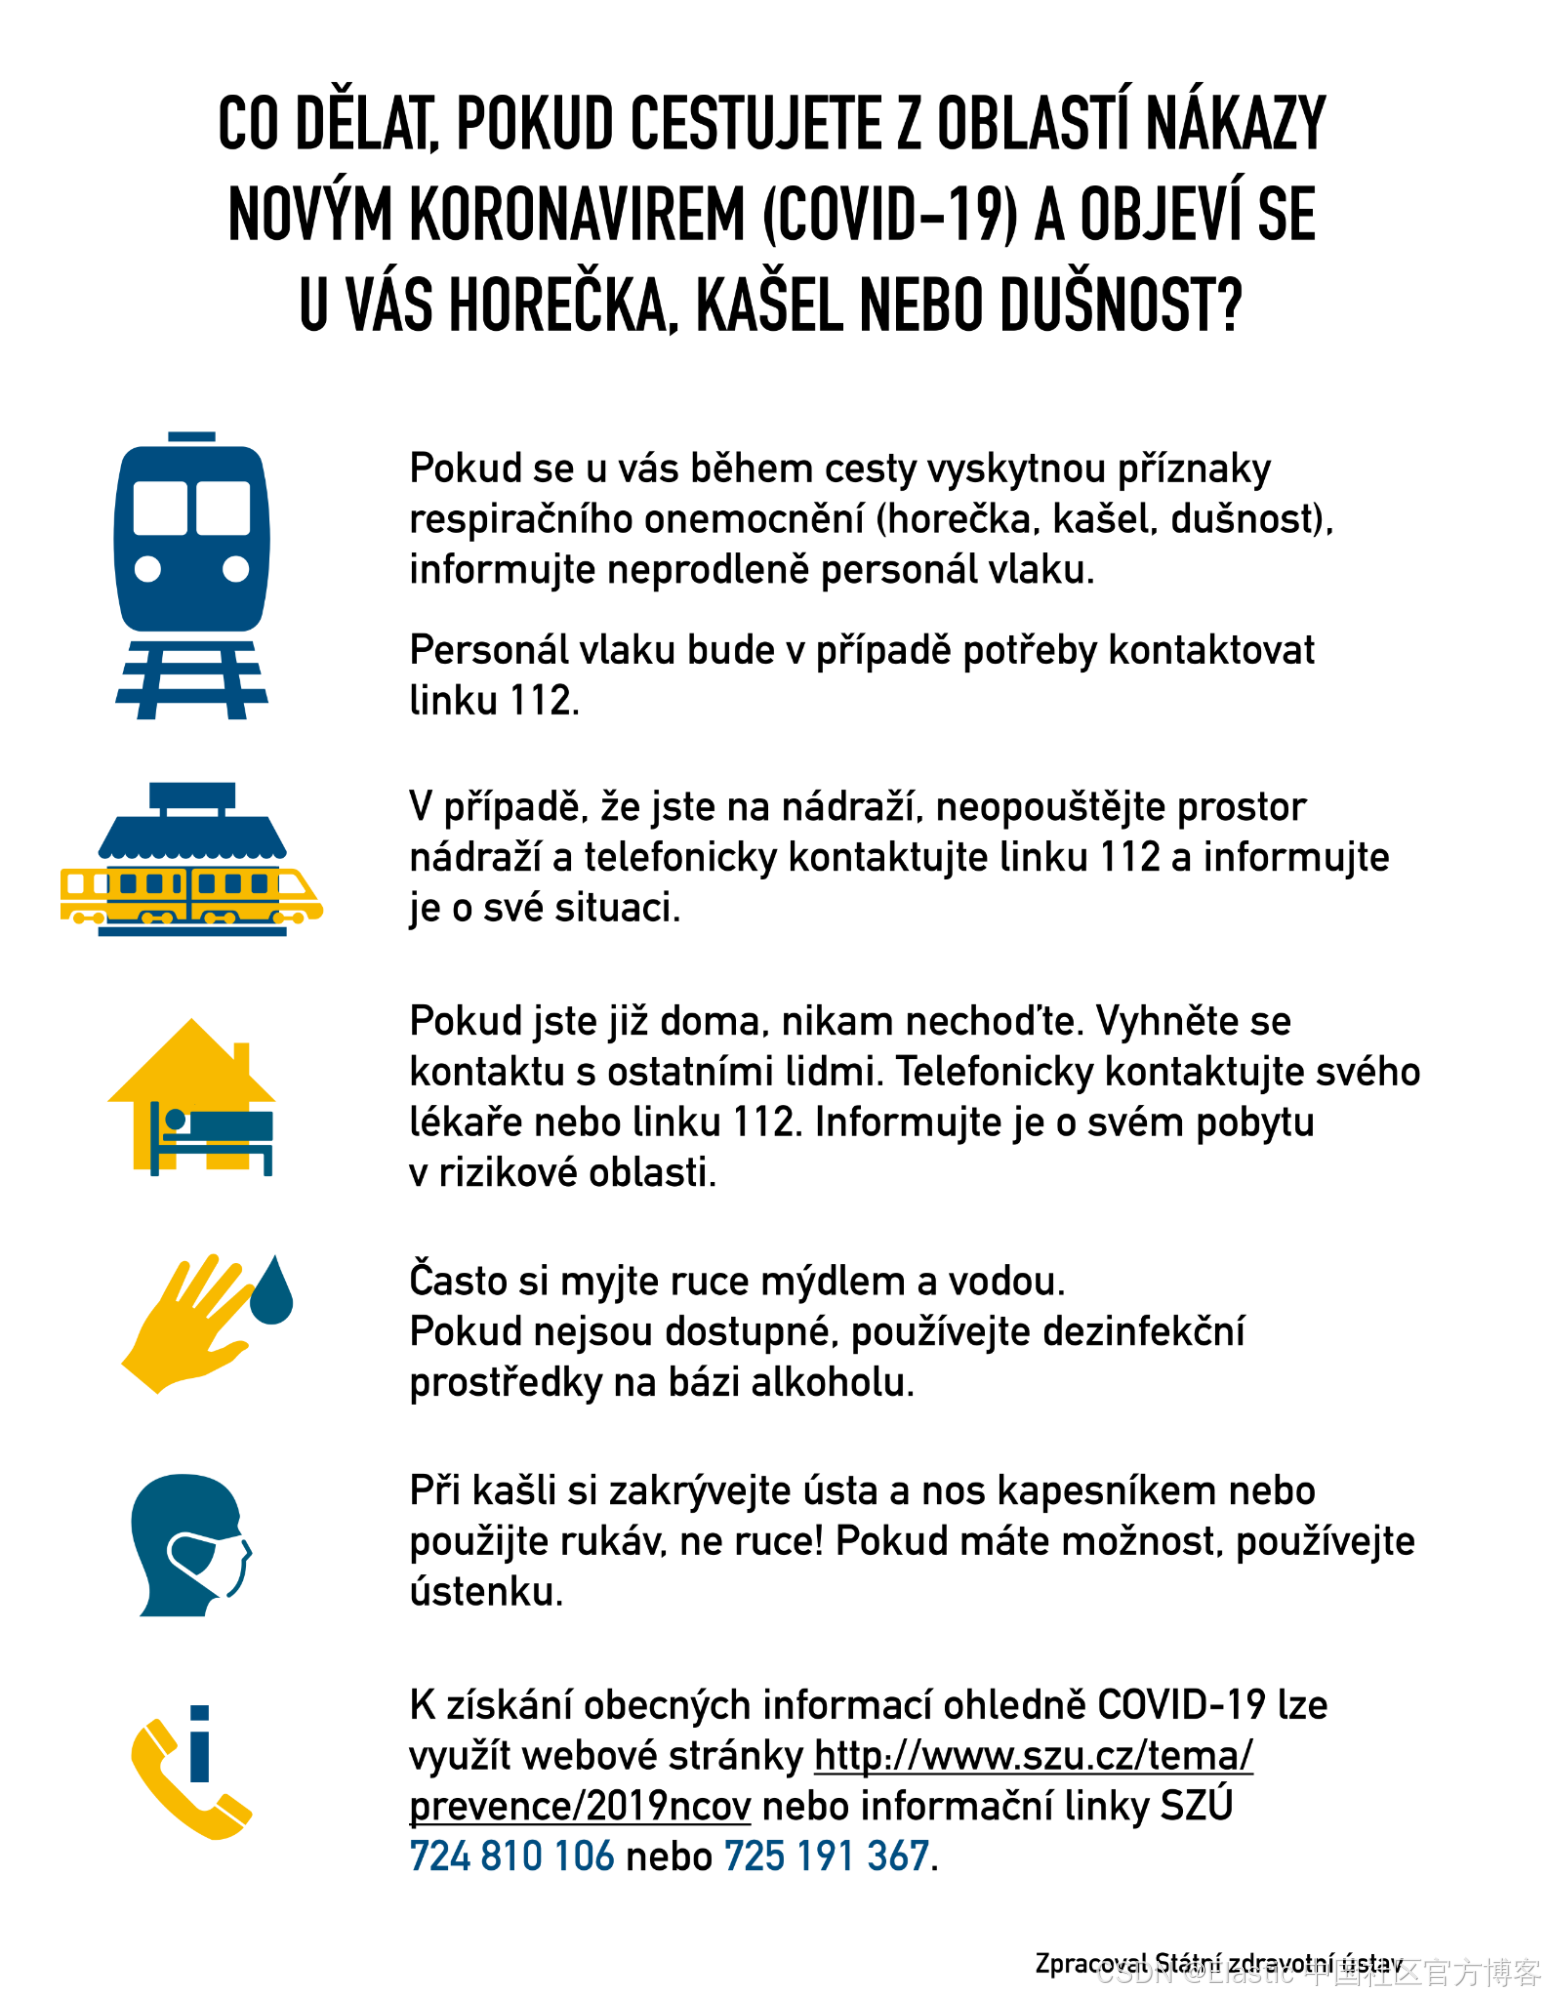
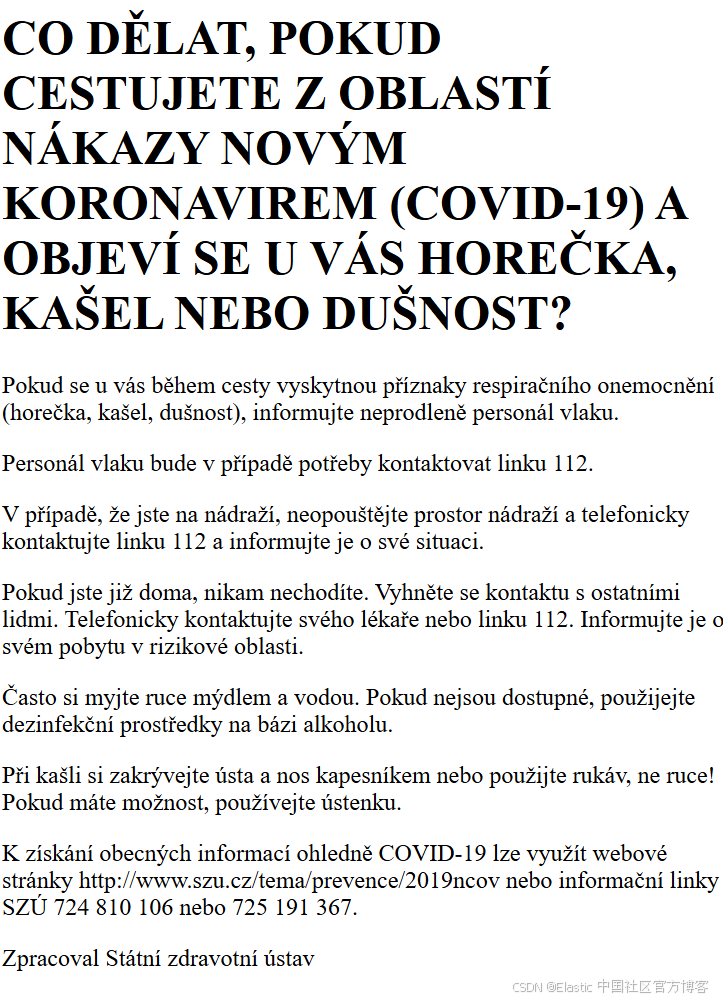
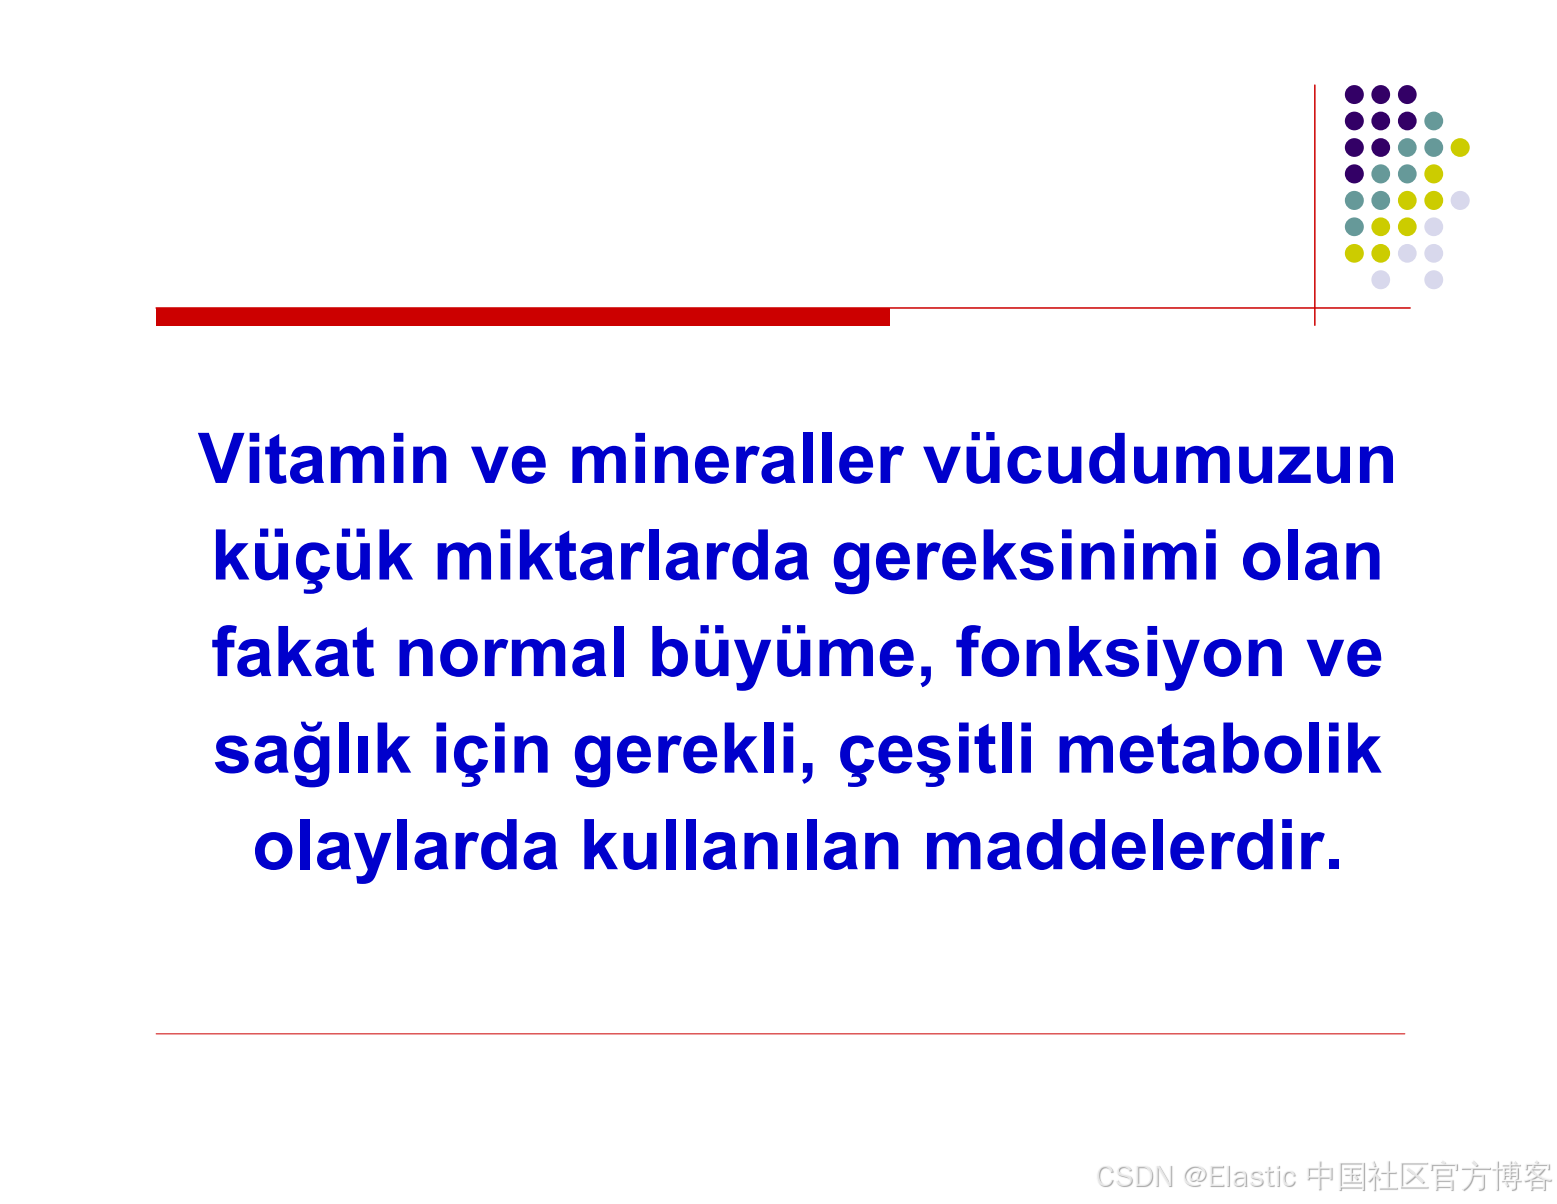
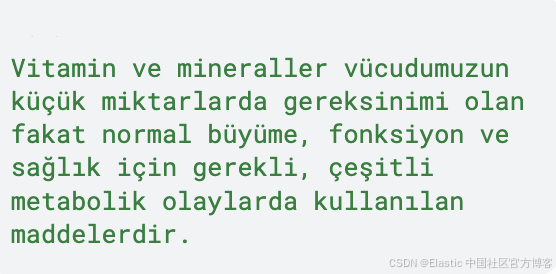
图 21 和图 22 展示了 jina-ocr-v1 处理捷克语和土耳其语的情况。这两种语言都使用经过大量修改的拉丁字母,并且广泛使用变音符号:
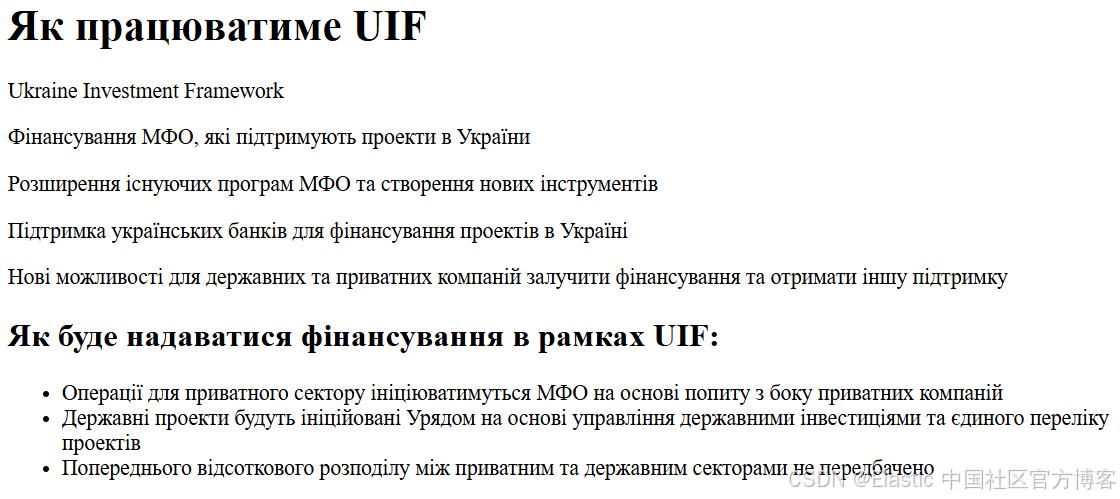
希腊字母和西里尔字母
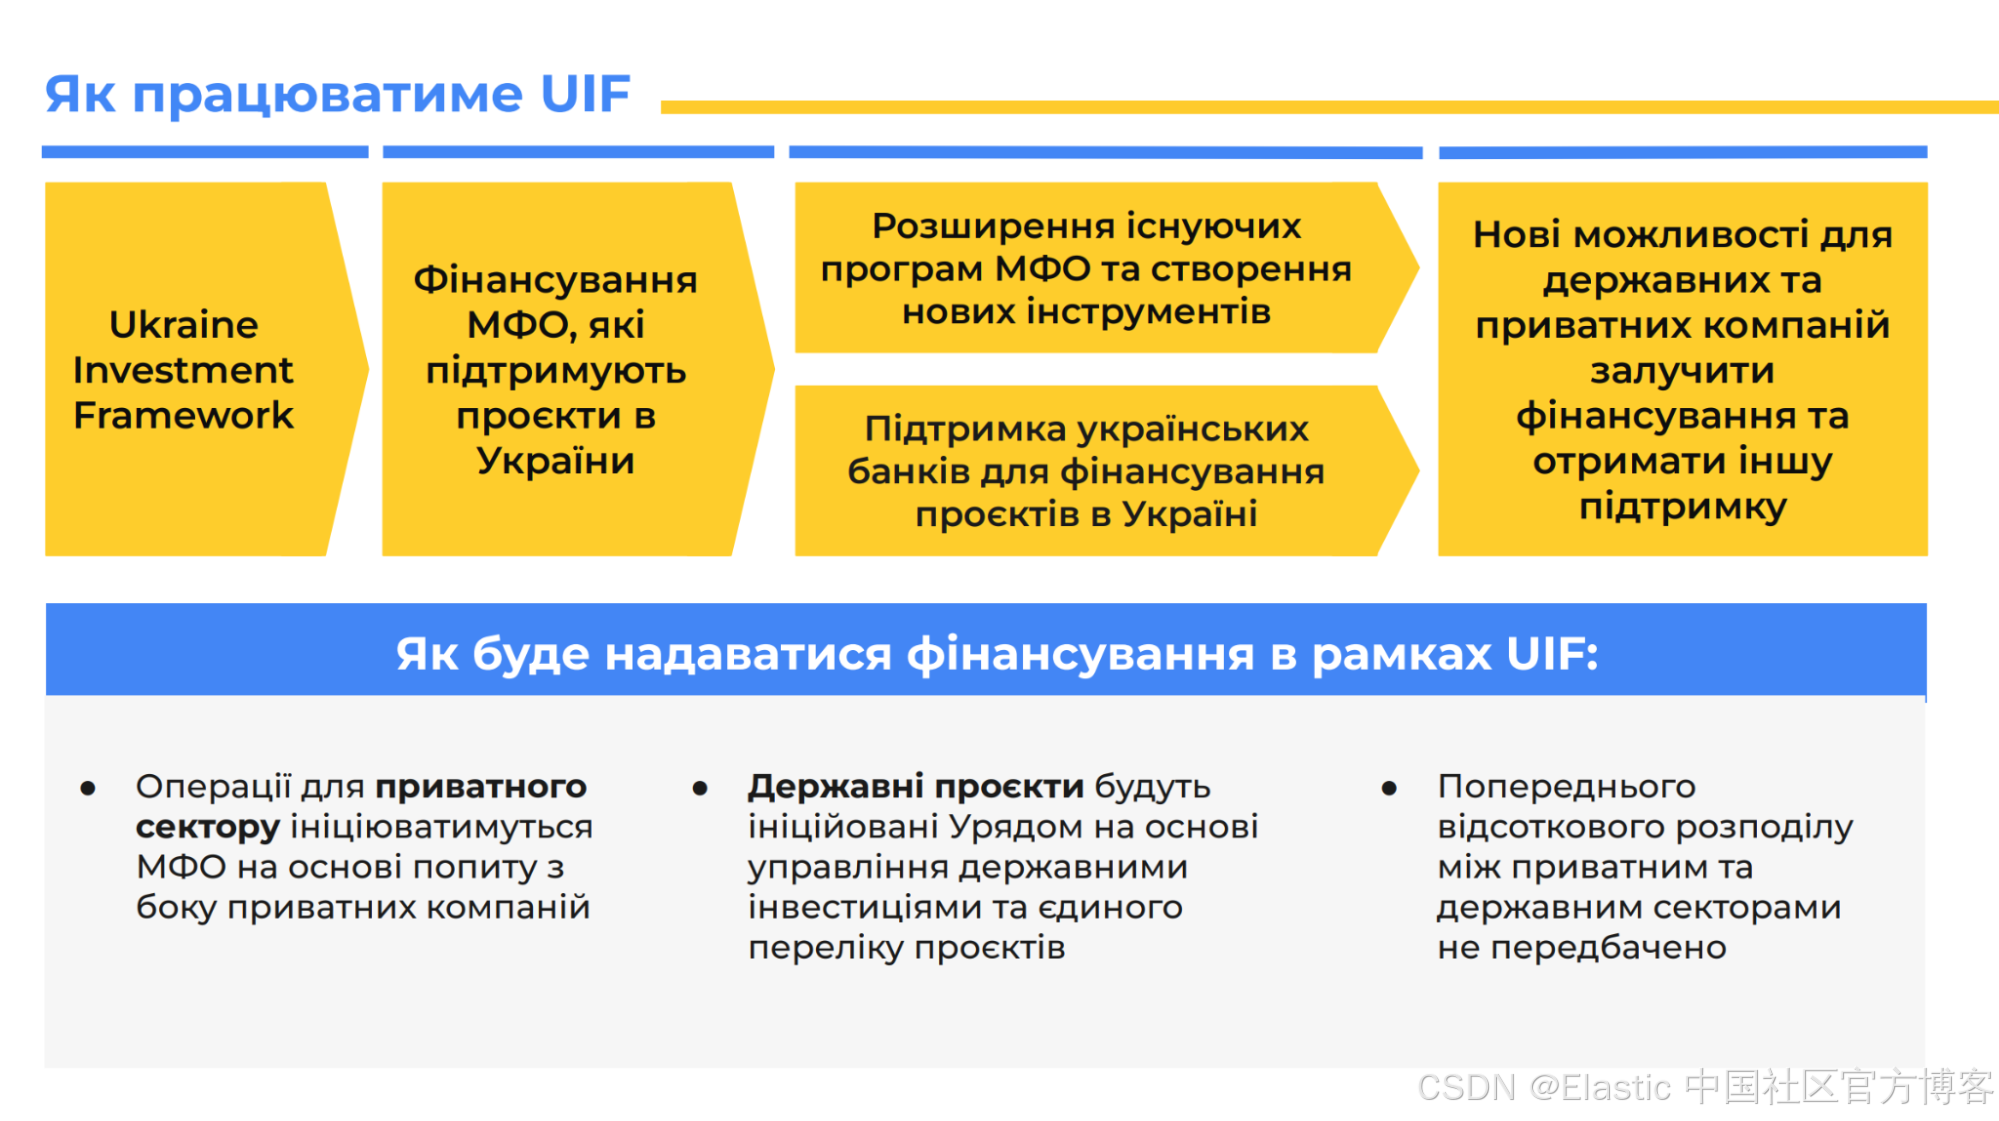
除了拉丁字母文字之外,jina-ocr-v1 还支持希腊字母和西里尔字母文字:
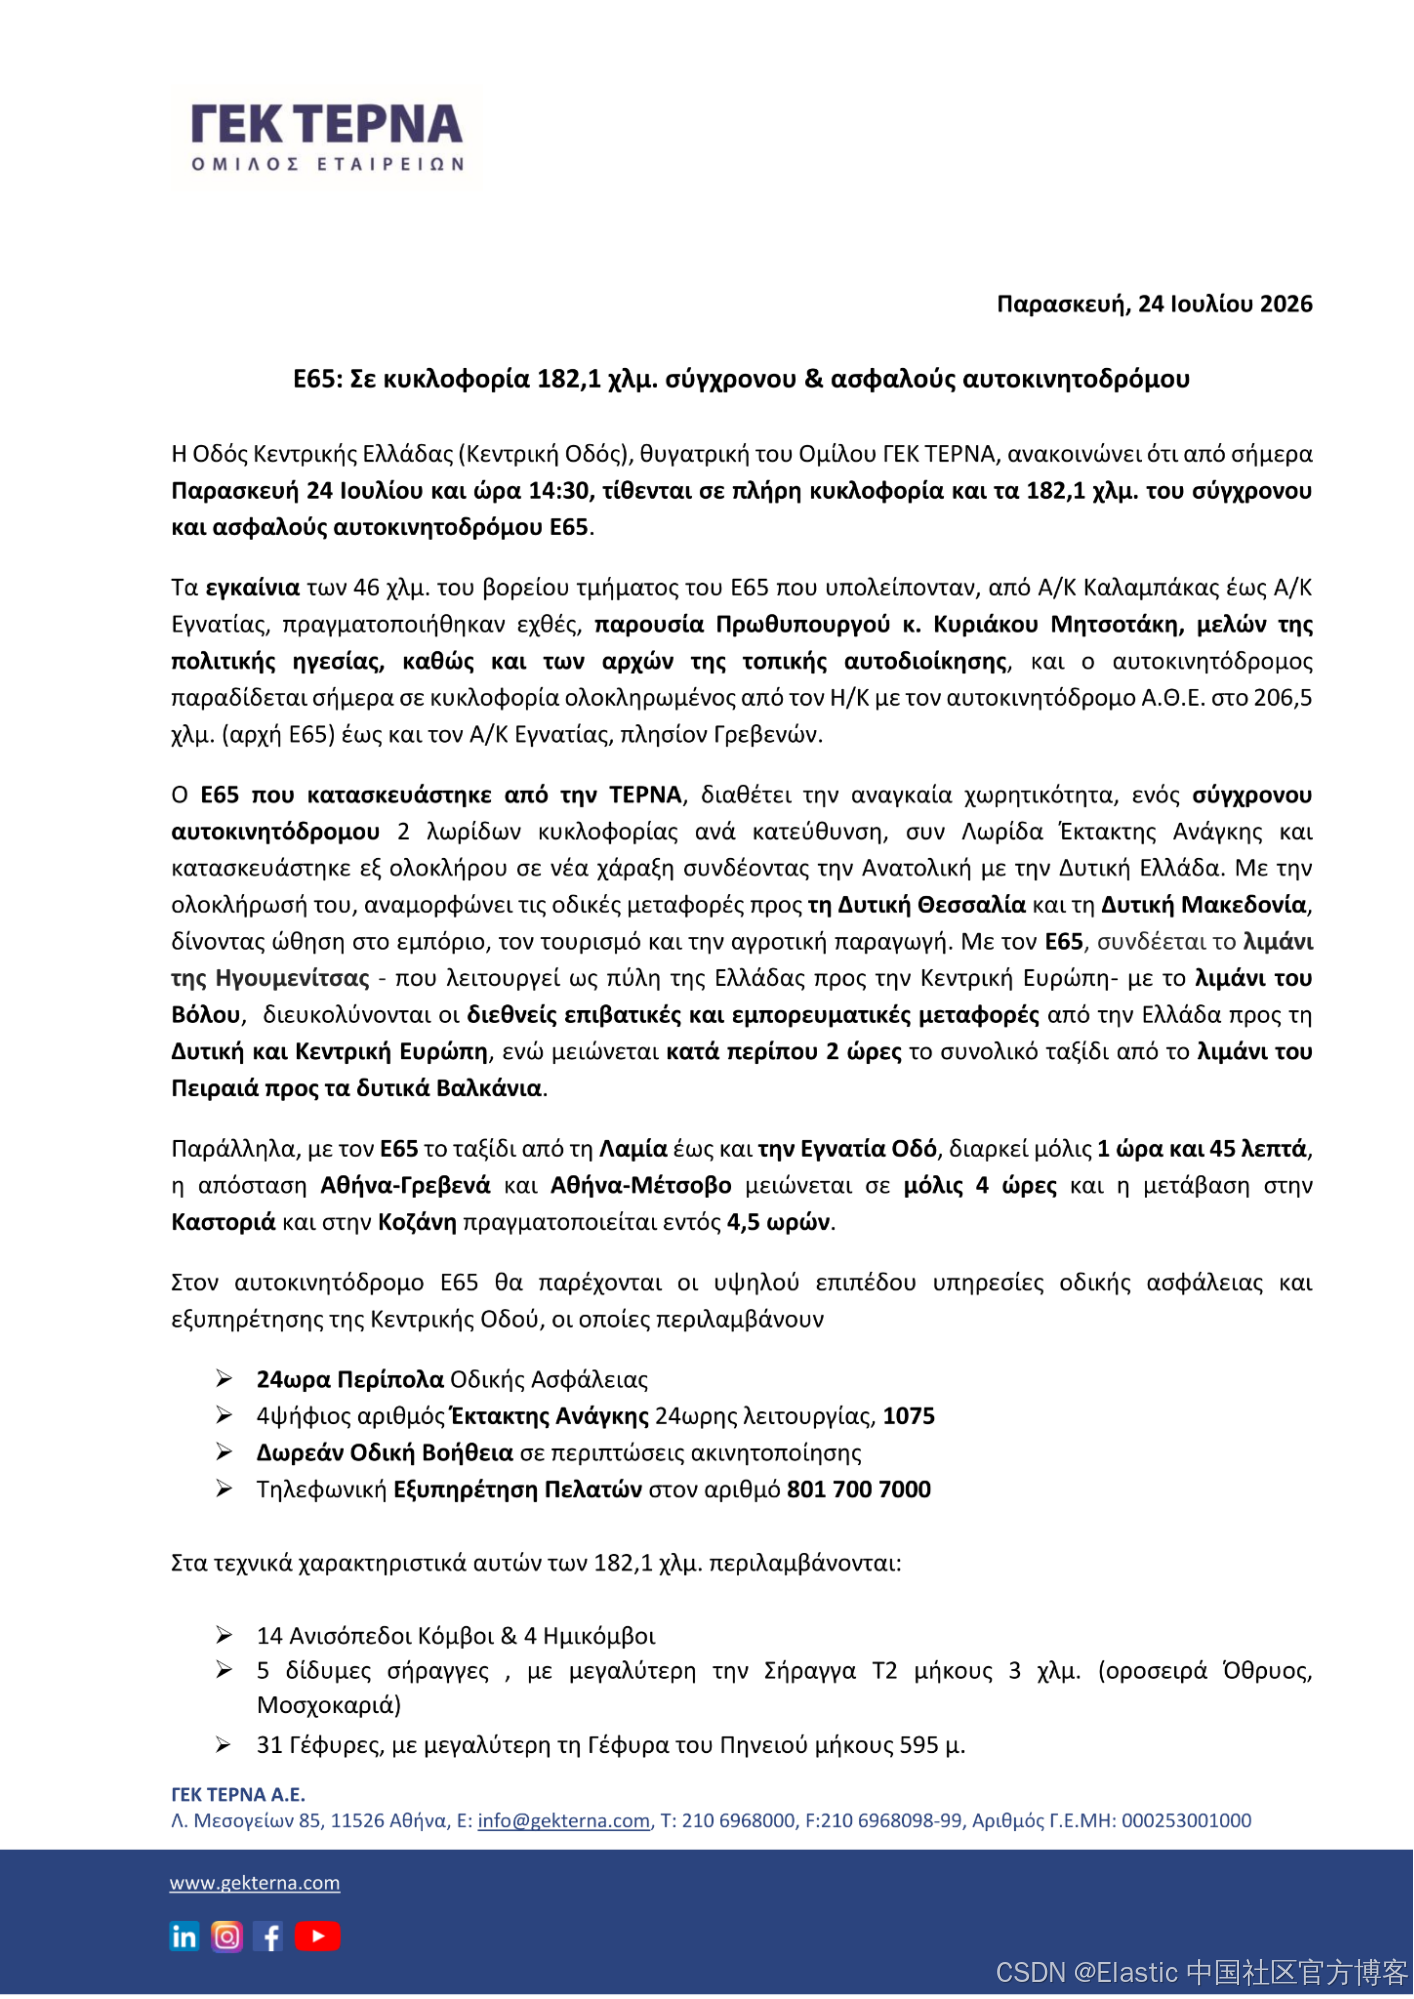
图 23: 建筑公司GEK TERNA(ΓΕΚ ΤΕΡΝΑ)发布的希腊语新闻稿(左),以及提取出的文本(右)。
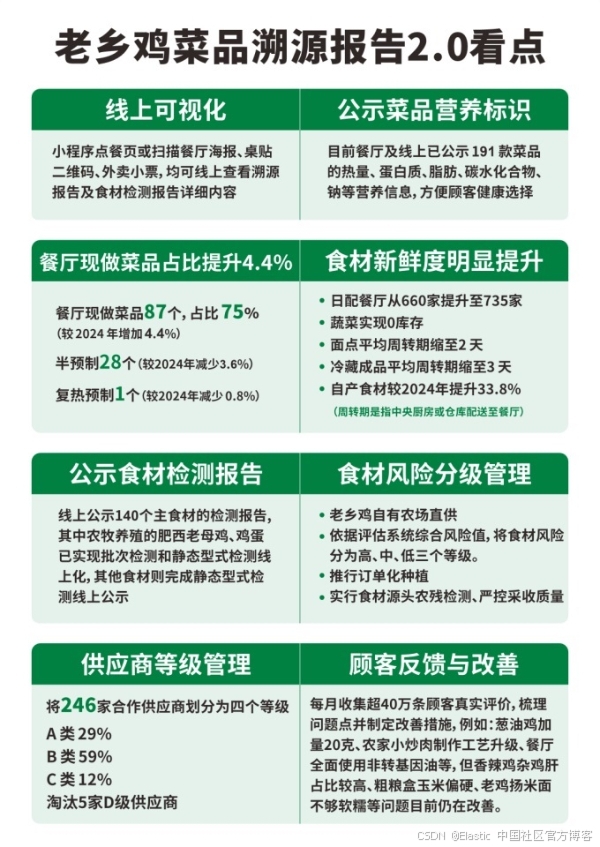
亚洲语言和中东语言
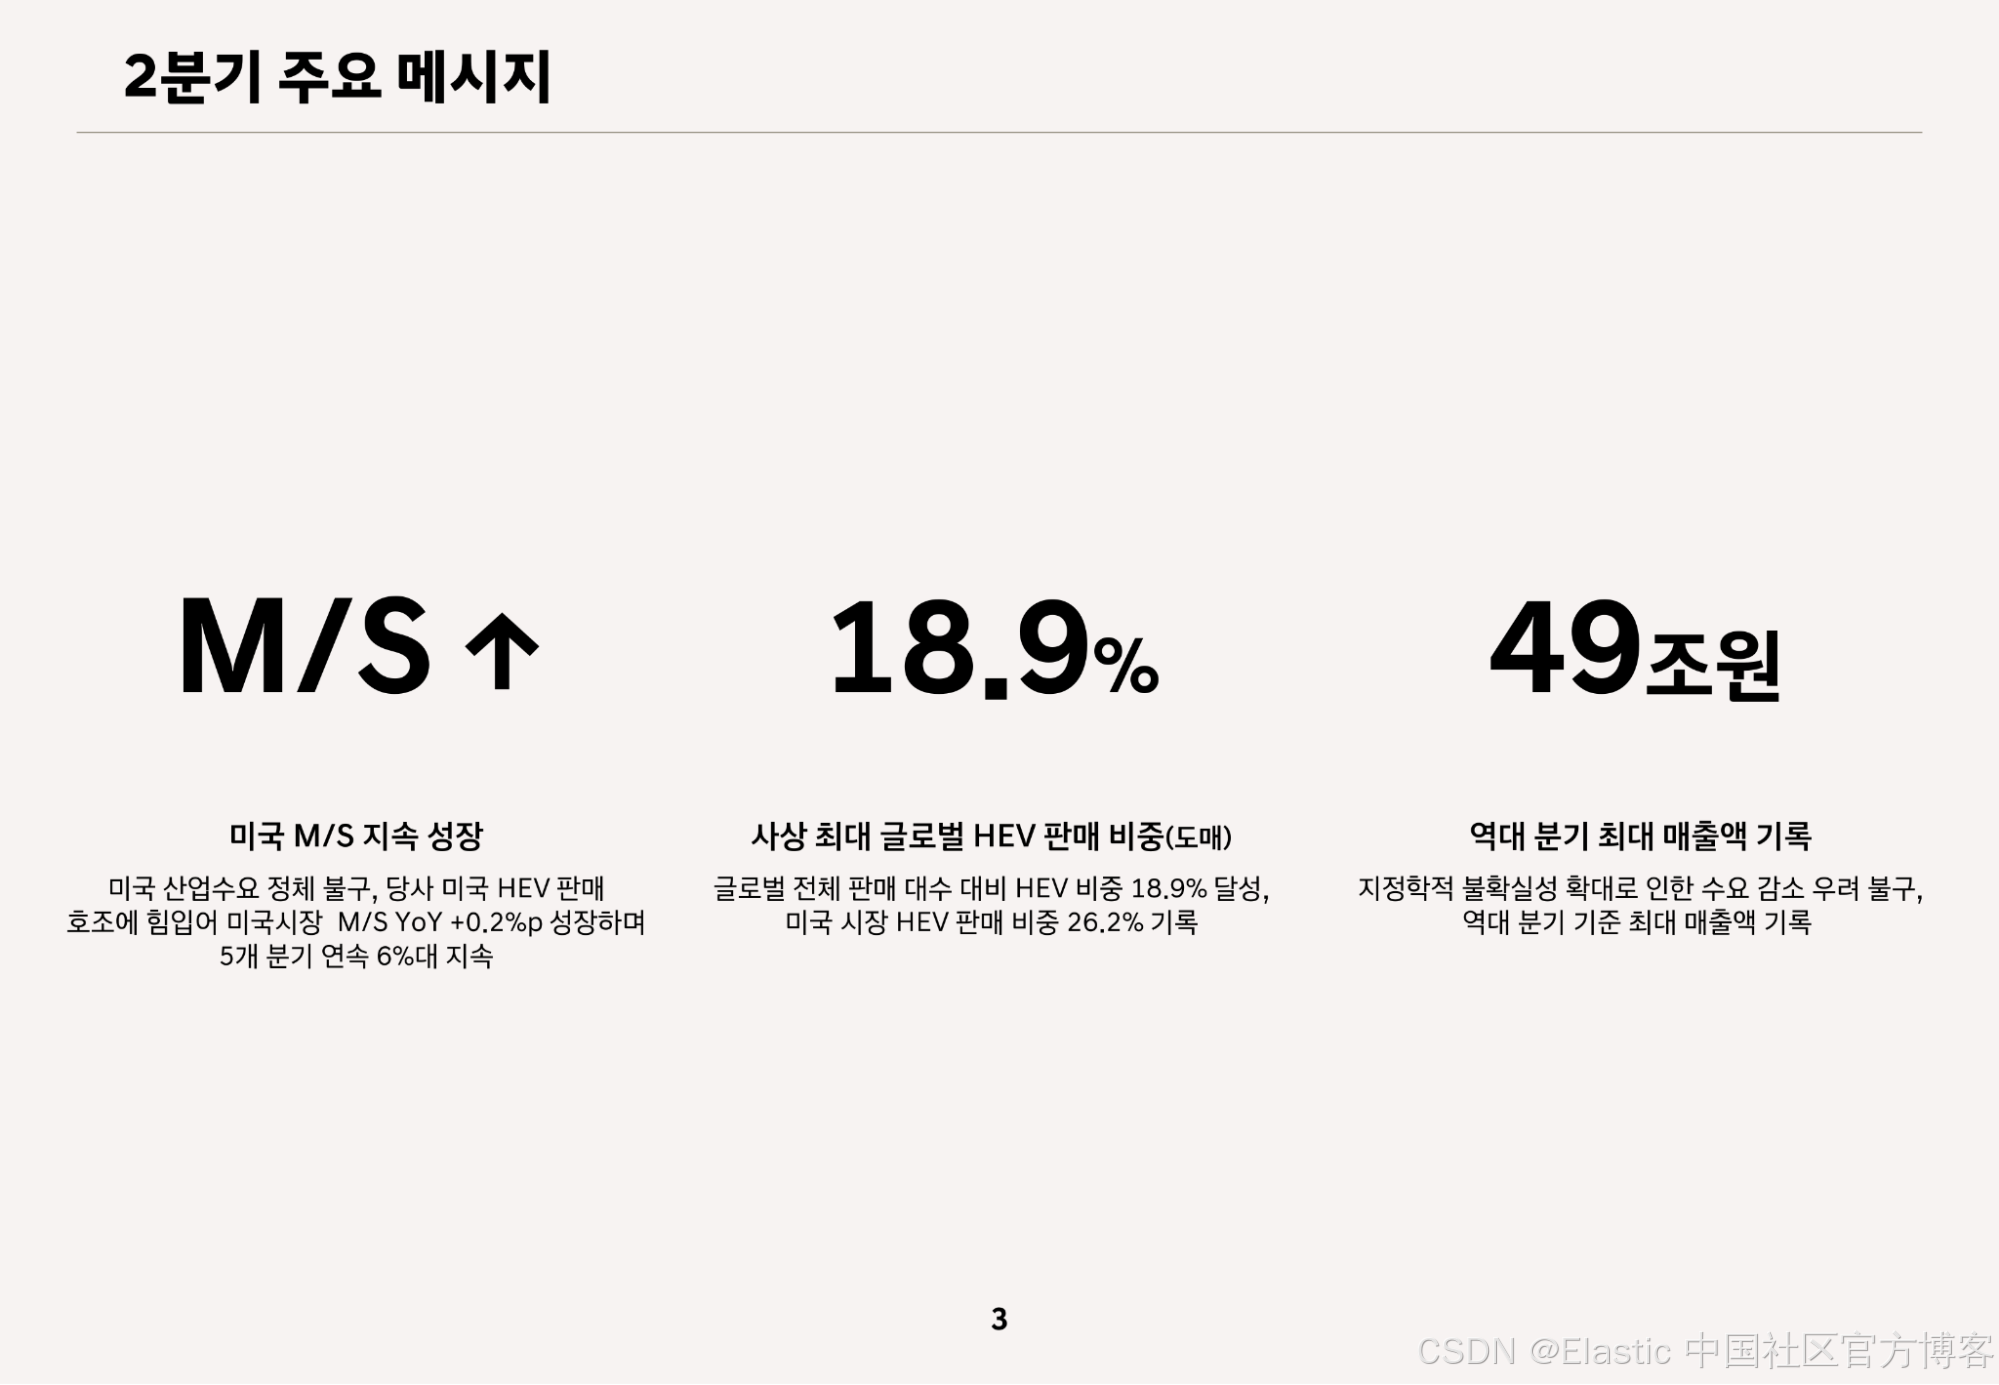
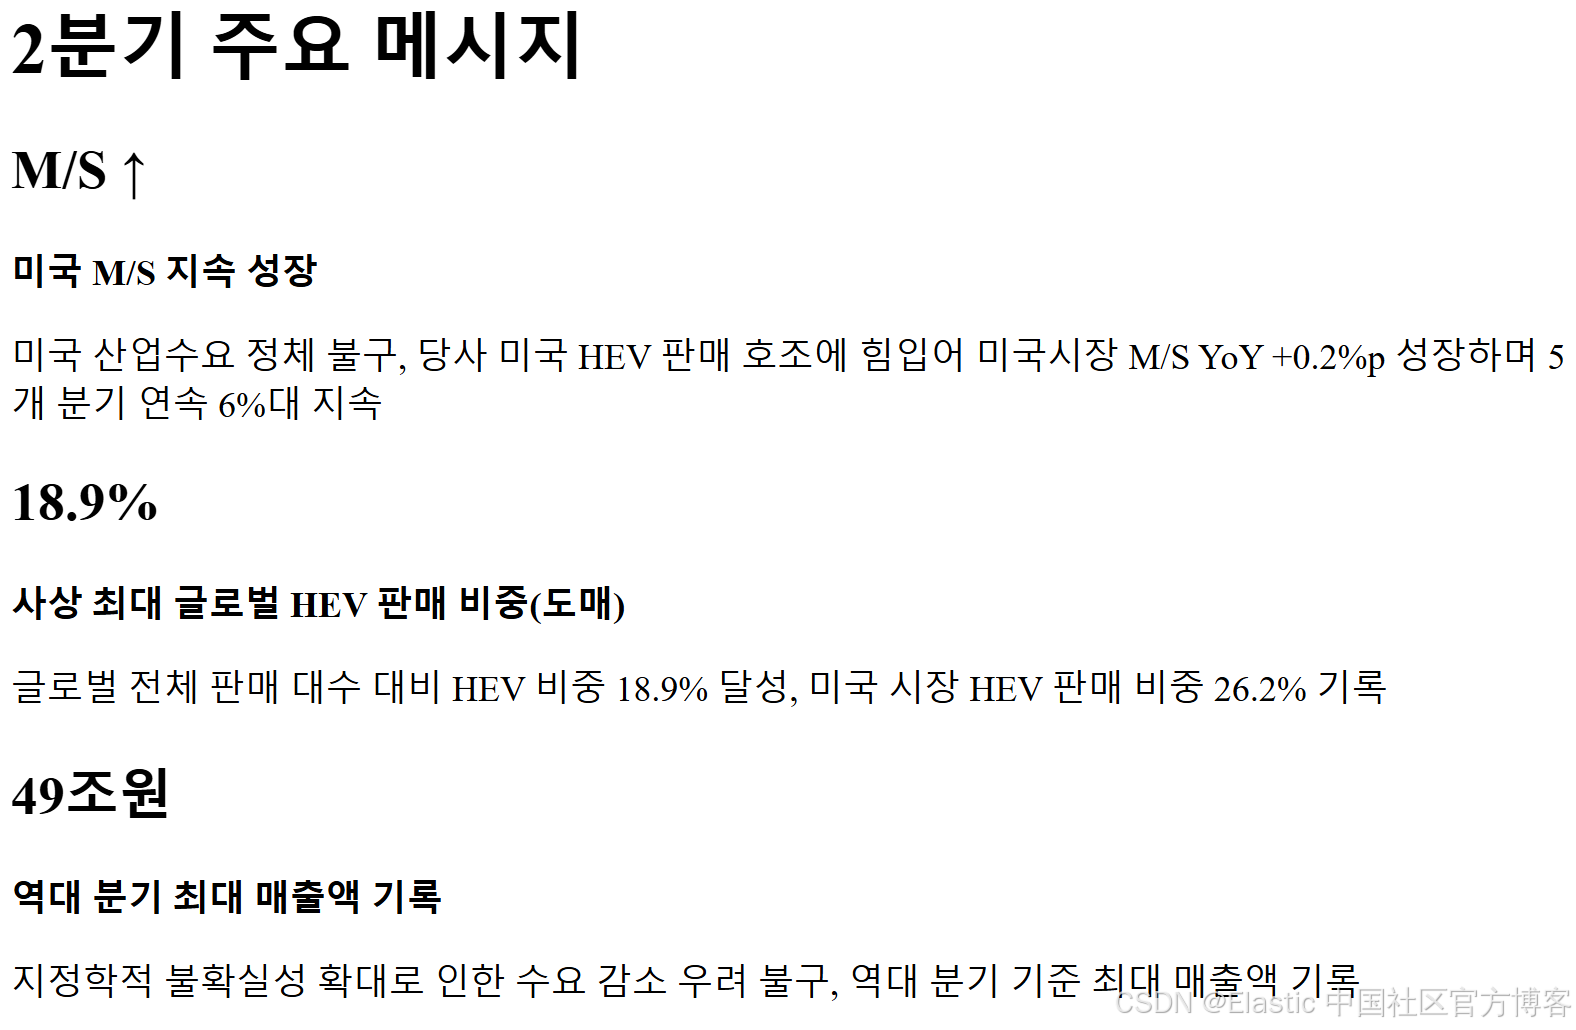
jina-ocr-v1 不仅支持拉丁字母文字。你可以在图 16 中看到它对日语的支持,但它也能够处理其他主要的亚洲语言。
中文:
韩语:
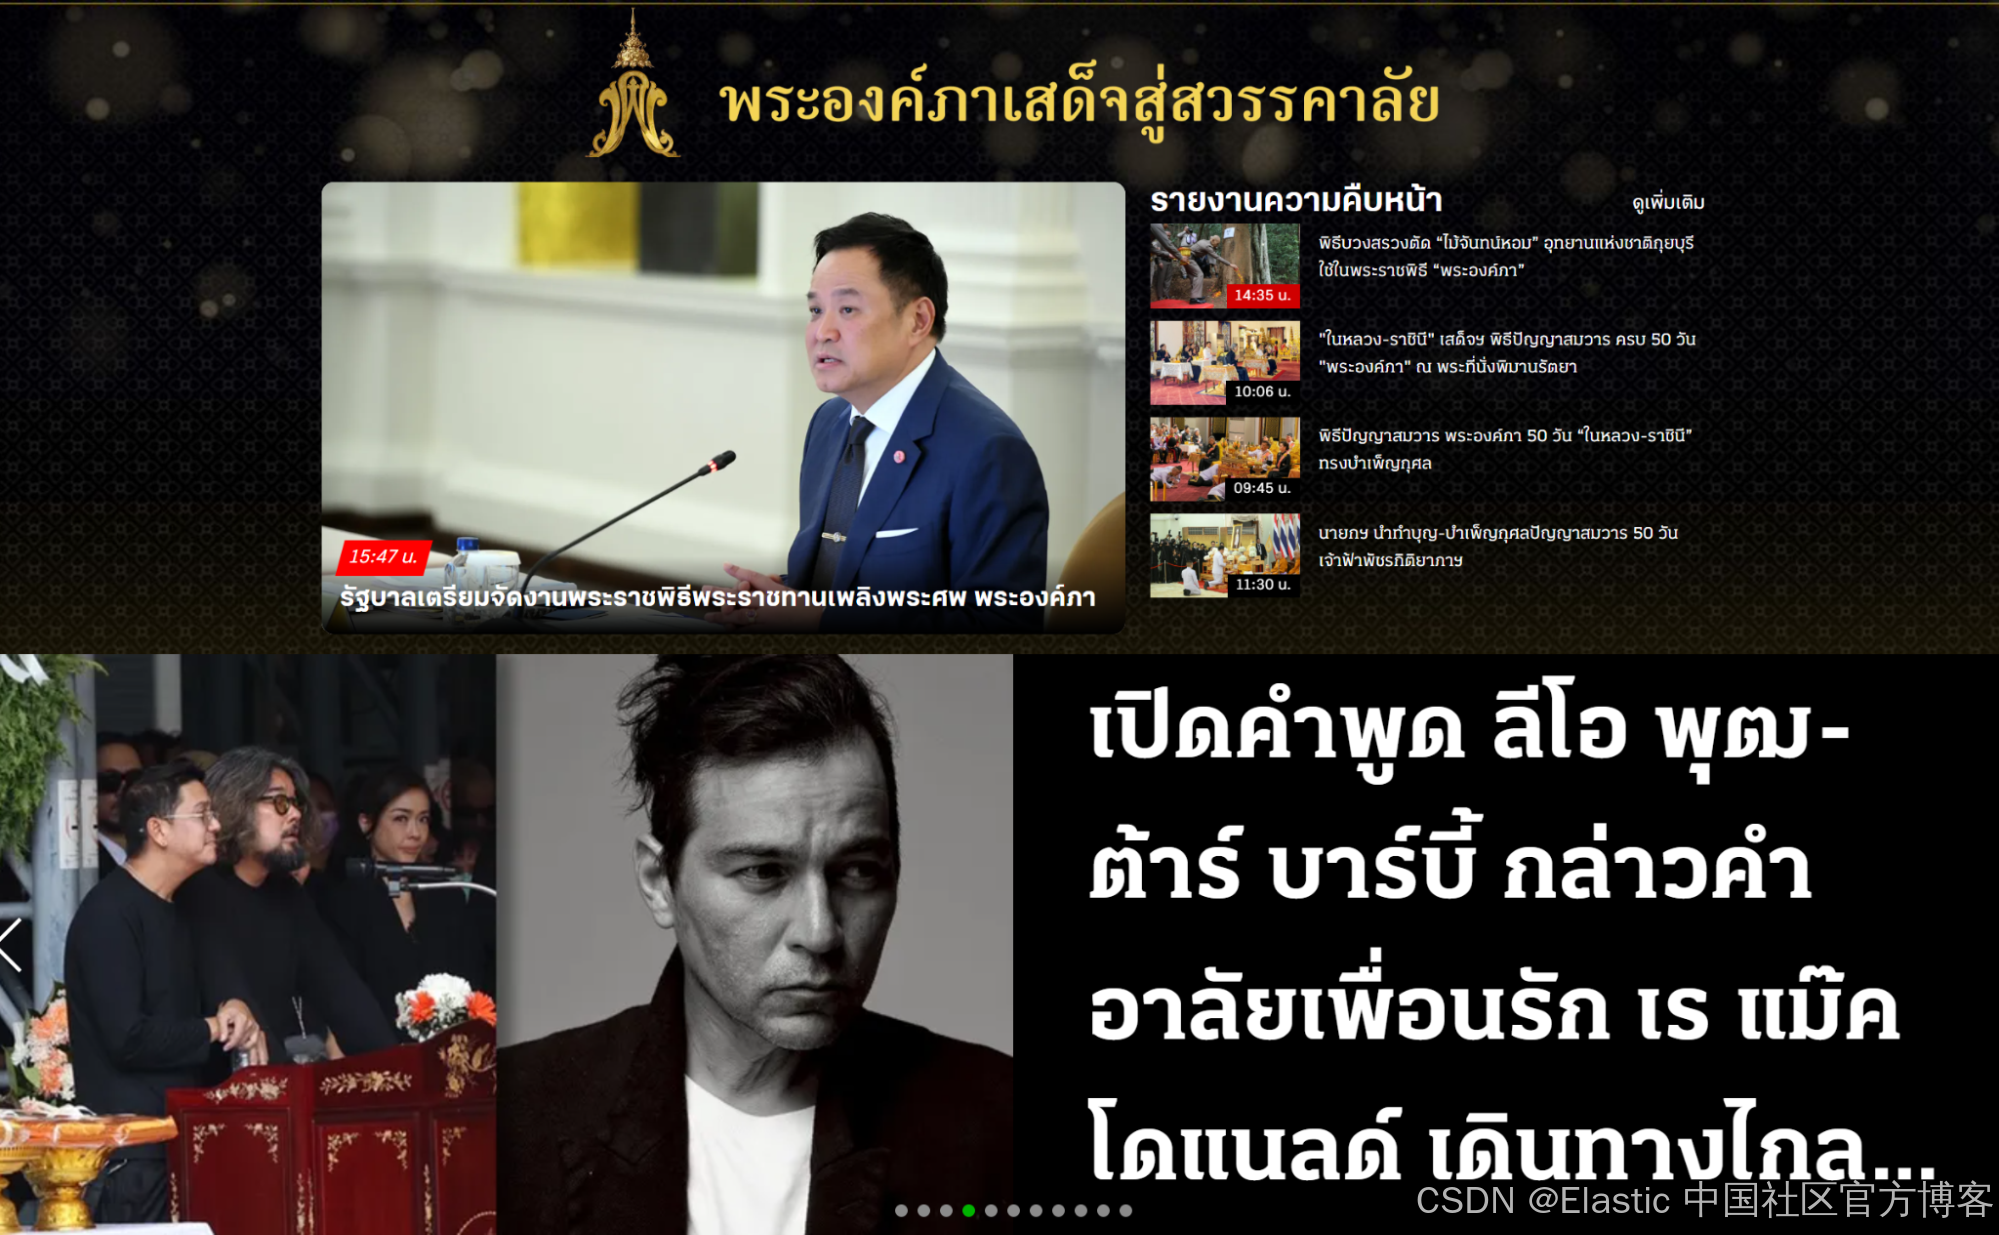
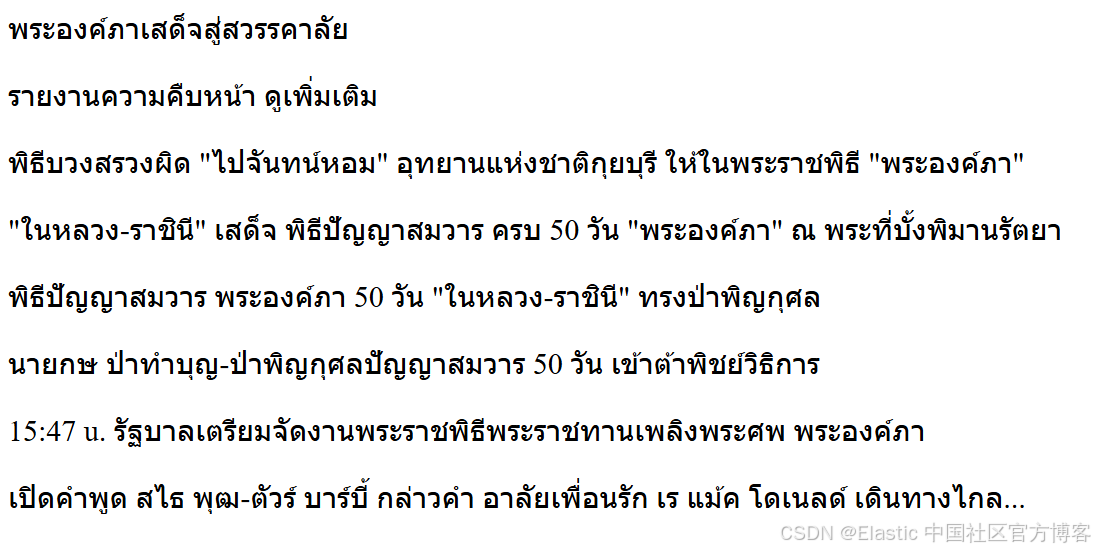
泰语:
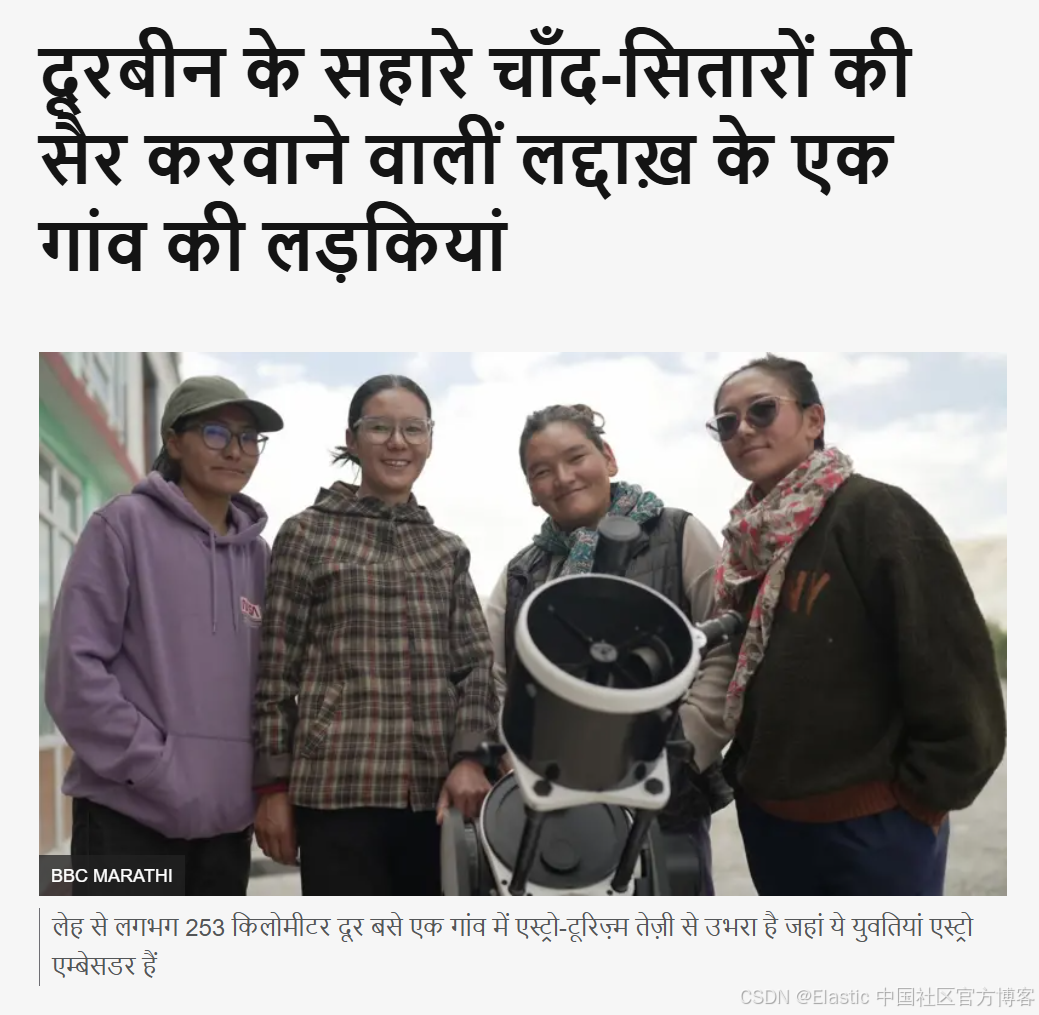
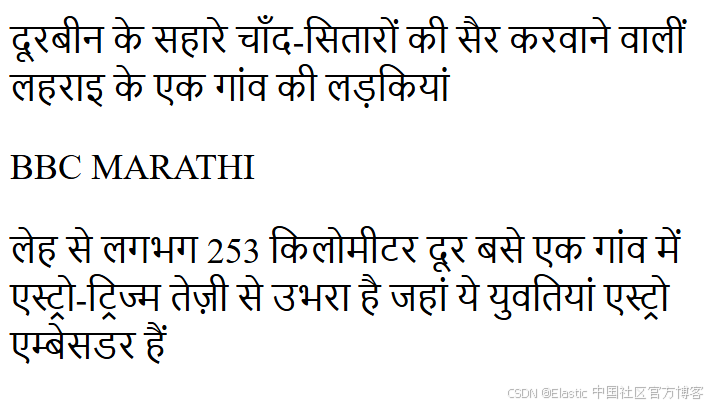
印地语:
阿拉伯语:
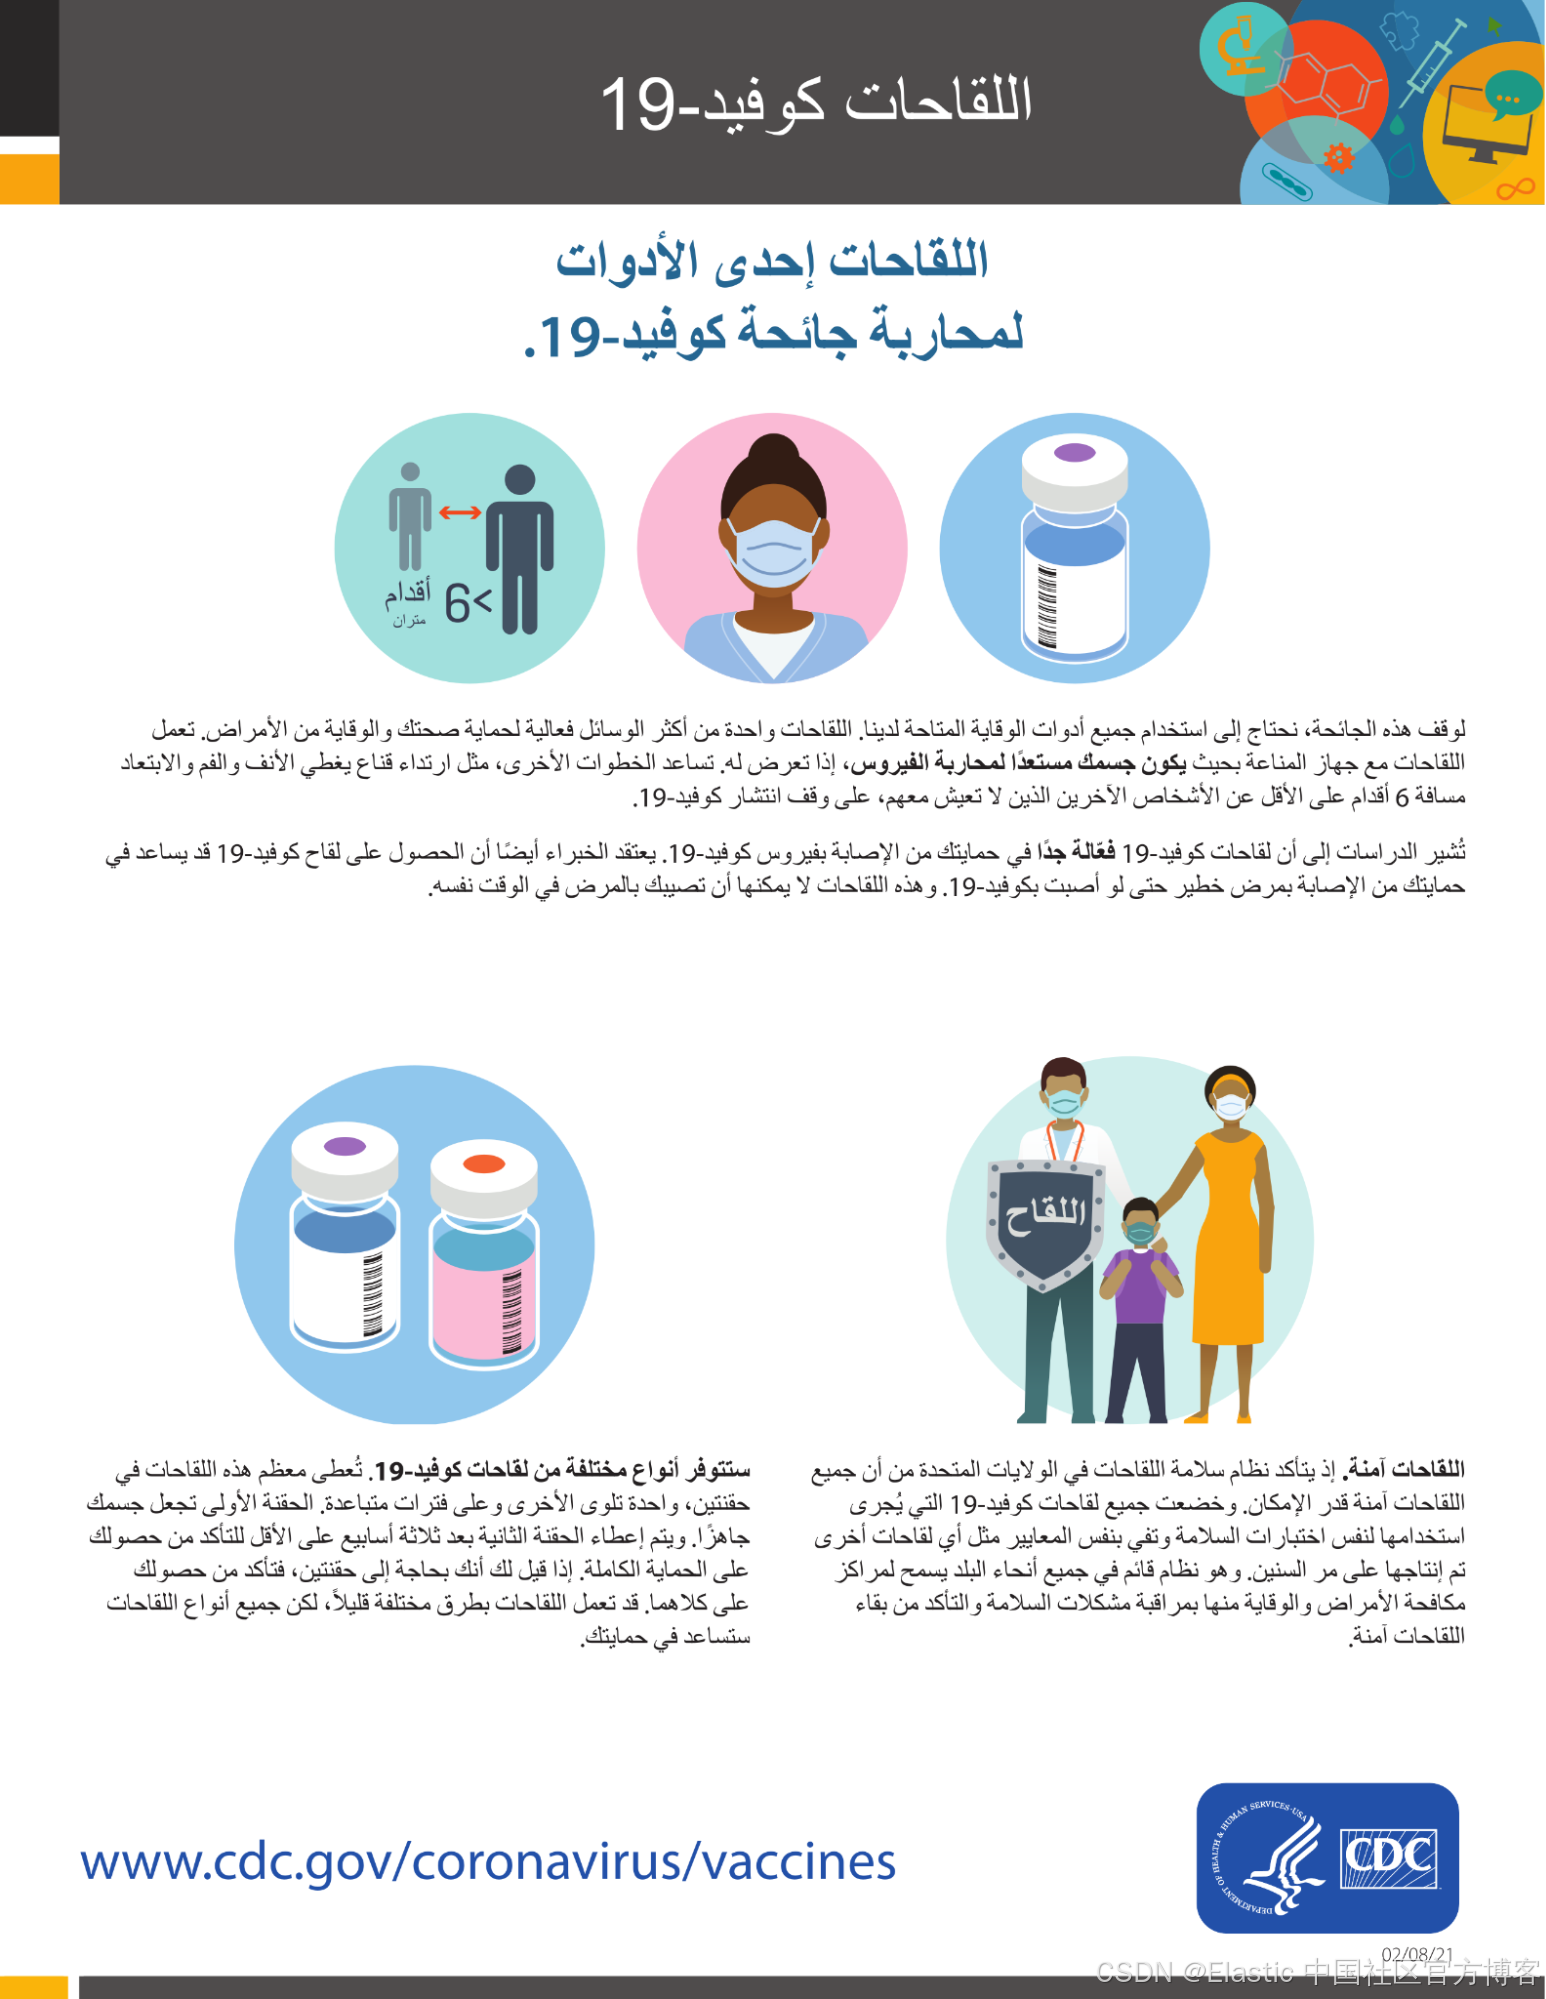
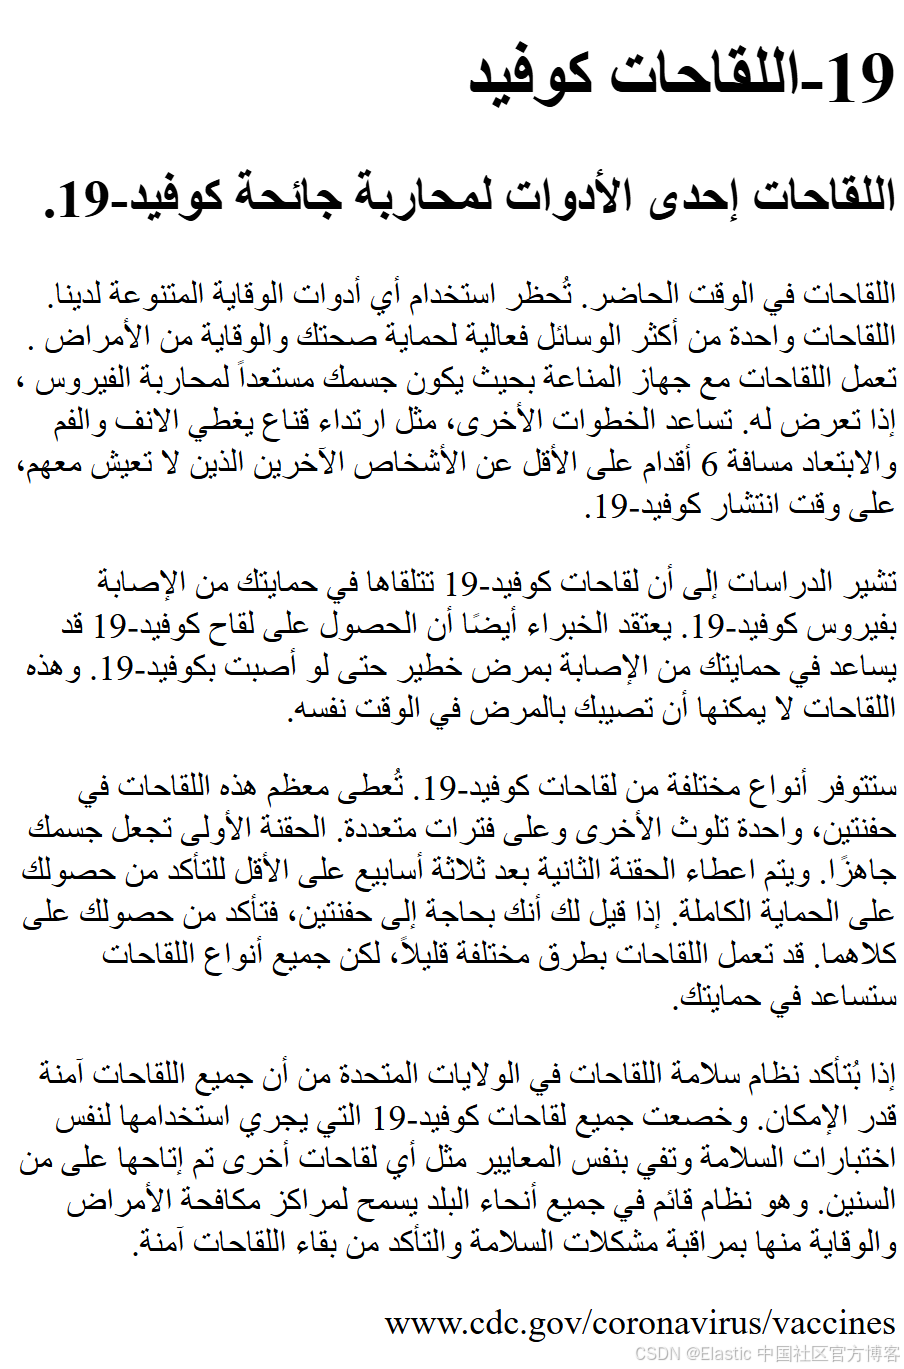
混合语言文档
jina-ocr-v1 擅长处理包含多种语言的材料:
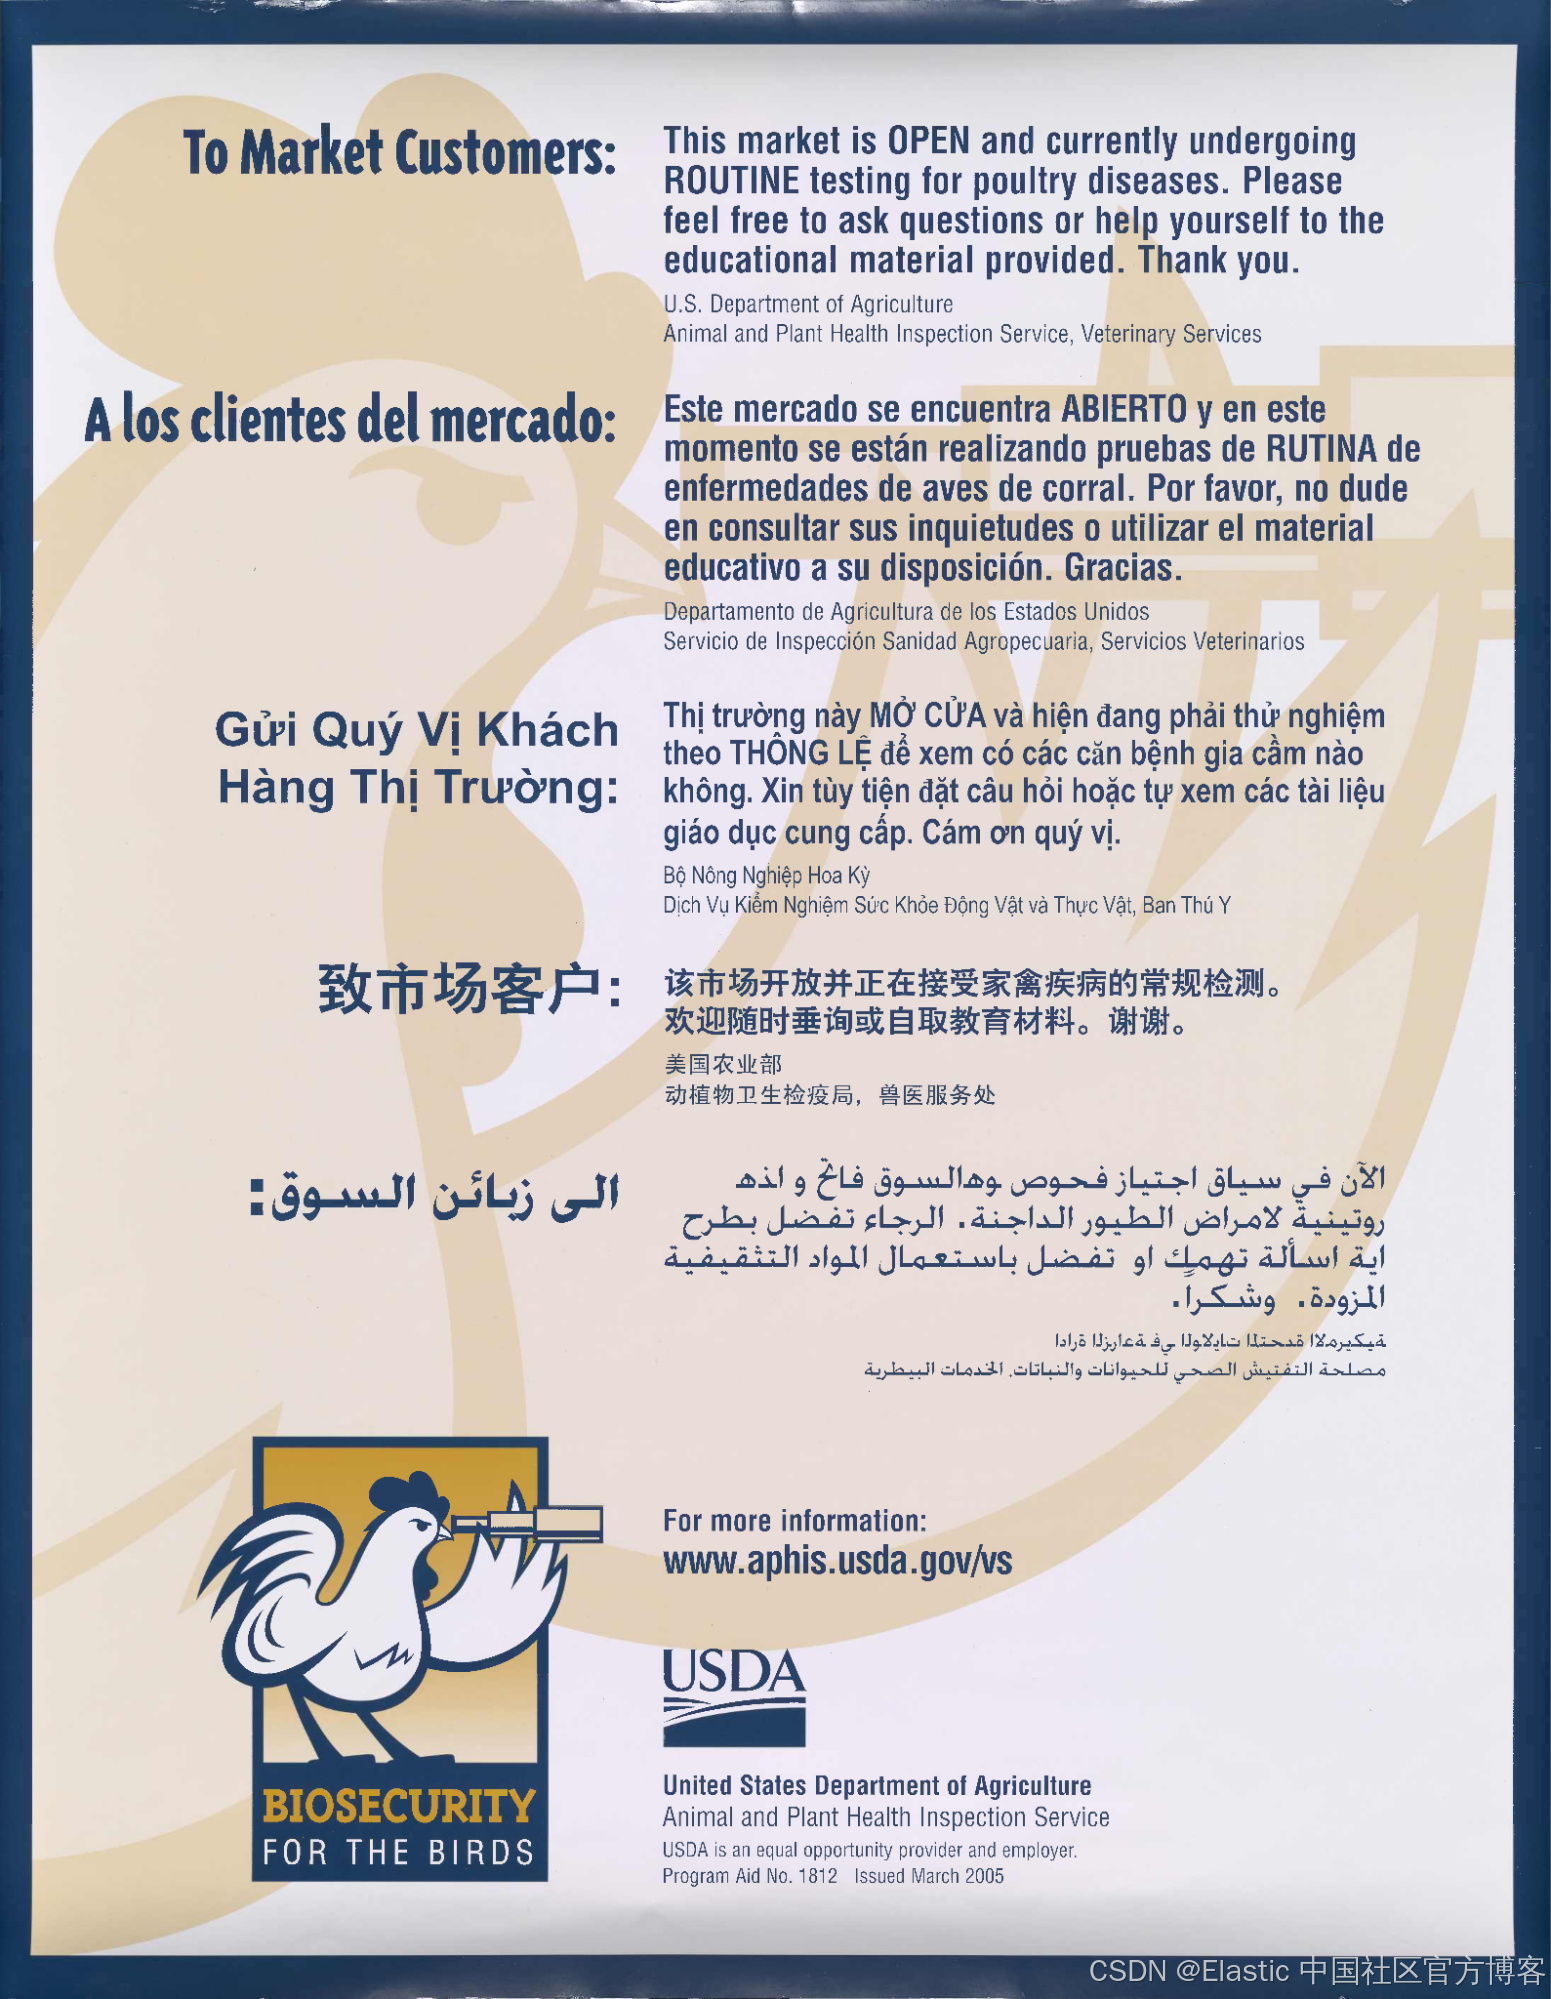
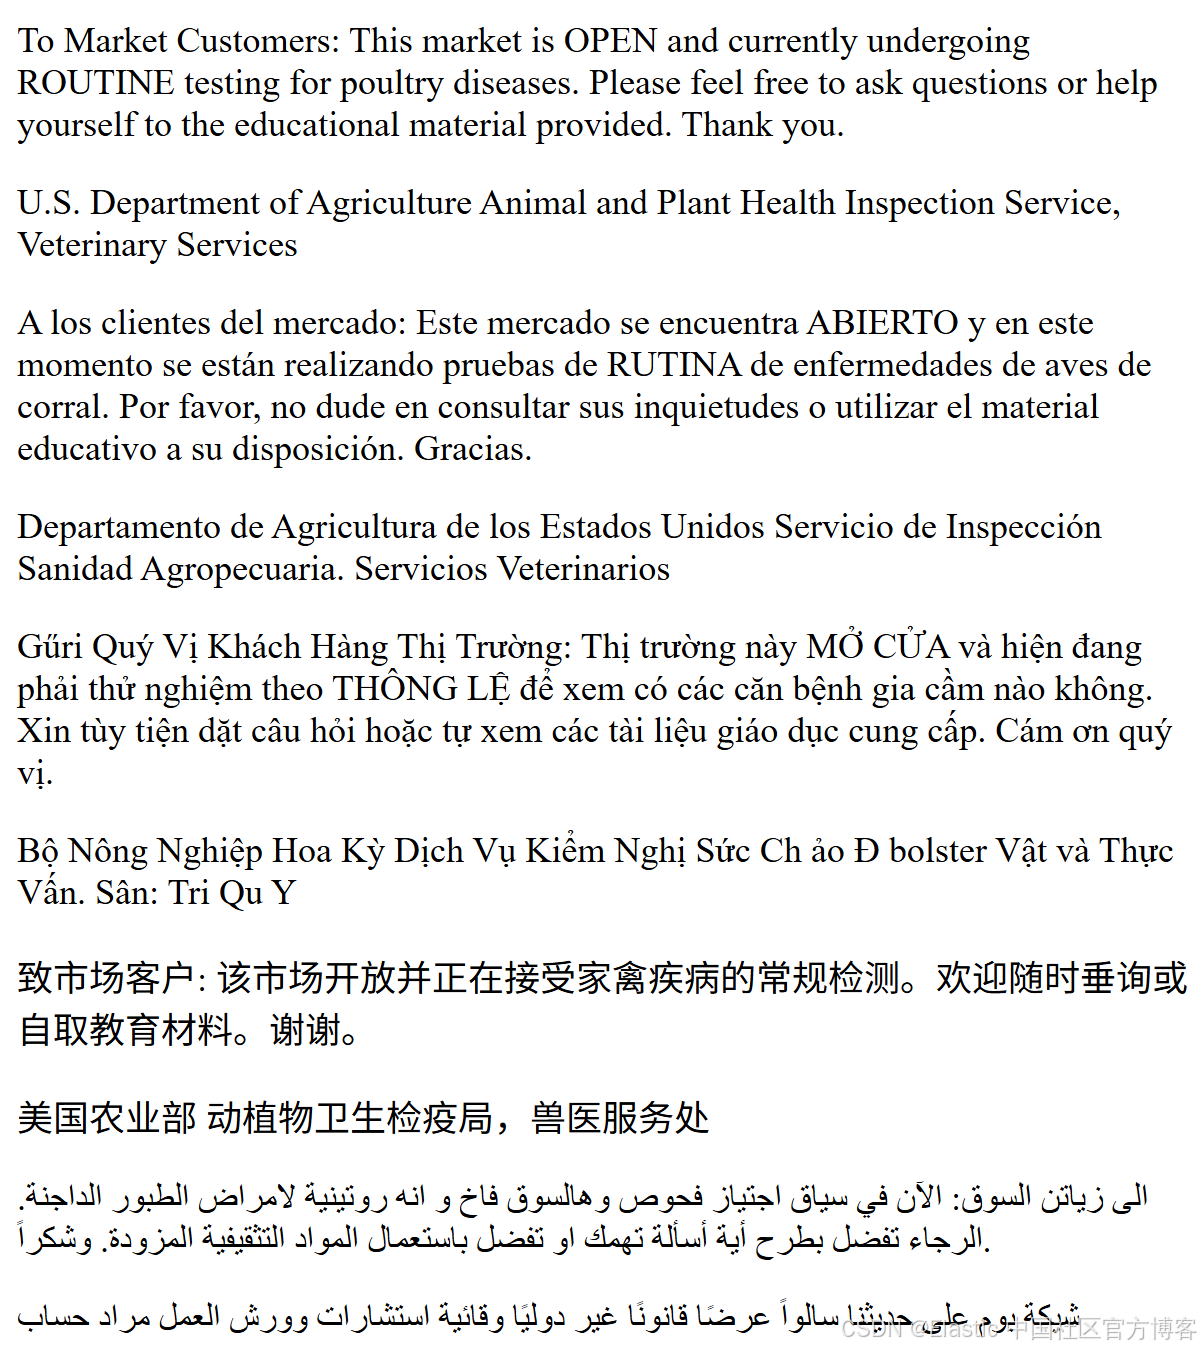
访问 jina-ocr-v1 OCR API 的五种方式
jina-ocr-v1 应该位于你的数据流水线前端或接近前端的位置,将渲染后的文本图像预处理为干净的 Unicode 文本和易于处理的结构化格式。这会为后续流程的每个环节增加价值。你的数据摄取流水线会减少错误,信息检索的准确率也会更高。此外,无论是供人类读者使用,还是供 agentic AI 使用,检索到的数据都可以更快地投入使用。
访问和使用 jina-ocr-v1 有以下五种方式:
| 访问方式 | 接口 | 原生 PDF 支持 | 许可 | 最适合 |
|---|---|---|---|---|
| Elastic inference API / EIS | chat_completions inference endpoint | 暂不支持;需要先将页面转换为图像 | Elastic Cloud 已包含 | 已经将数据摄取到 Elasticsearch 的团队 |
| Jina API | HTTP 服务,预付 token | 暂不支持;需要先将页面转换为图像 | 按 token 付费 | 在 Elasticsearch 之外使用,无需 Elastic 账户 |
| 本地安装 | Jina On-Prem 或从 Hugging Face 下载 | 暂不支持;需要先将页面转换为图像 | 学术和非商业用途采用 CC BY-NC 4.0;商业用途请联系 Elastic Sales | 隔离网络、受监管或高吞吐量工作负载 |
| Jina AI Reader API | HTTP header X-Respond-With: jina-ocr-v1 | 支持;自动将 PDF 和 HTML 转换为图像 | Reader API 服务的一部分 | 如果输入是 PDF 或网页,这是最快的方式 |
Elastic inference API 和 Elastic Inference Service
jina-ocr-v1 可通过 Elastic inference API 和 EIS 作为 inference endpoint 使用。
由于 jina-ocr-v1 会像聊天式 LLM 一样返回流式文本,因此需要通过 chat_completions 接口访问。我们正在为 Elastic 服务集成对 PDF 的原生支持,并将在不久的将来提供该功能。在此之前,你需要先将 PDF 文档处理为图像。
Jina API
对于希望试用 jina-ocr-v1,或者不希望通过 Elasticsearch 的服务基础设施访问它的用户,可以通过标准 HTTP 服务使用 Jina API。该服务使用预付 token,无固定订阅费用,并提供 1000 万个免费 token,可免费试用。
如需了解更多信息,请访问模型页面上的 jina.ai 以及 jina-ocr-v1 sandbox。
本地安装和本地部署许可
Jina AI 模型可通过 Jina On-Prem 下载并获得商业使用许可,也可以从 Hugging Face 的模型页面获取。Jina AI 的最新模型根据 CC BY-NC 4.0 许可协议,可免费用于学术研究和非商业用途。如需获得本地安装的商业许可,请联系 Elastic Sales。
Jina AI Reader API
你可以配置 Jina AI Reader API 服务 使用 jina-ocr-v1,并结合其他多种功能,包括自动将 PDF 和 HTML 转换为图像。这并非默认配置。要配置 Jina AI Reader API 使用 jina-ocr-v1,请在请求的 header 参数中添加以下内容:
X-Respond-With: jina-ocr-v1要使用此服务,请参阅 jina.ai 上的 Reader API 文档页面。
jina-ocr-v1 技术报告和模型卡
如需了解更多关于 jina-ocr-v1 的信息,请参阅该模型的技术报告和其在 Hugging Face 上的页面。
原文:jina-ocr-v1: one OCR model for layout, tables and math | Elasticsearch Labs


 扫一扫


 1205

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


