


自Deepseek展现出它的强大和独一无二时,各个企业领导开始紧密锣鼓学习大模型,想利用起来大模型在自己的公司生产、办公或者科研等各个场景中,并且也费尽心思、茶不思饭不想。
其实,这里面包括小编也一直有一个疑惑,目前的效果较好的是Deepseek大语言模型技术,它除了能落地成为问答助手场景【注意生成式AI的幻觉带来的准确性】,还能做什么?也欢迎各位领导也可以把能落地的场景打在评论区。
如果连大模型、部署工具、知识库这三板斧都还没有搞清楚的领导就赶紧看看下面的内容学【恶】习【补】一下。
一、大模型
概念:大模型,通常指的是大型人工智能模型,尤其是大型语言模型(LLM),是一种基于深度学习技术的人工智能模型,具有海量的数据、庞大的参数规模和强大的学习能力,在自然语言处理等诸多领域展现出卓越的性能。
目前全国已经掀起了Deepseek浪潮,多数企业都基本上部署了Deepseek 671B满血版,模型方面也不用对比,首推Deepseek!
二、大模型部署工具
概念:大模型部署工具是一类用于将大型语言模型(如 ChatGPT、BERT 等)部署到不同环境中,以便进行应用开发、测试和实际运行的软件工具或平台。
大模型部署工具需根据各自的计算资源进行选择,以下是常见大语言模型部署平台的对比分析,涵盖易用性、性能、适用场景等关键维度。
| 平台名称 | 核心优势 | 局限性 | 适用场景 |
|---|---|---|---|
| Ollama | 简单易用,支持多平台(Windows/Mac/Linux),内存占用低,社区活跃(46k+ Star) | 并发能力有限,国内下载需科学上网 | 本地快速部署、模型实验 |
| LM Studio | 图形化界面友好,支持团队协作,预训练模型库丰富 | 闭源,高级功能需付费 | 非技术人员、创意文本生成 |
| Ray Serve | 分布式架构,支持多框架集成(TensorFlow/PyTorch),扩展性强 | 配置复杂,需一定分布式系统经验 | 高并发生产环境 |
| GPT4ALL | 多语言支持,成本可控,离线可用 | 模型规模受限,社区生态较弱 | 国际化应用、轻量级部署 |
| vLLM | 高性能推理,支持 GPU 加速,内存优化 | 配置复杂,显存占用较高 | 大规模模型服务 |
| HuggingFace TGI | 零配置部署,长文本处理速度快(比 vLLM 快 13 倍),支持多模型格式 | 目前推理速度仍略逊于 vLLM | 长文本生成、快速原型开发 |
三、大模型知识库工具
(1)核心功能与技术架构
| 平台名称 | 核心功能 | 技术特点 |
|---|---|---|
| Dify | 可视化工作流编排、多模型支持(OpenAI/Claude 等)、RAG 与 Agent 集成 | 云端优先架构,低代码 / 无代码开发,支持跨知识库检索和 QA 模式生成 |
| RagFlow | 文档精细解析(支持复杂格式)、多路召回优化、切片可视化调整 | 深度文档理解技术,Python 后端,强调高准确率和可追溯性 |
| Langchain-chatchat | 离线私有化部署、多模型兼容(ChatGLM/Qwen 等)、Agent 工具调用 | 基于 Langchain 框架,支持向量检索 + BMM25 混合模式,提供简易 Web UI |
| FastGPT | 自定义模型加载、高性能推理优化(TensorRT/ONNX)、知识图谱集成 | 模块化微服务架构,TypeScript 技术栈,支持本地化部署和高并发场景 |
(2)适用场景与优势
| 平台名称 | 适用场景 | 核心优势 |
|---|---|---|
| Dify | 快速开发智能客服、内容生成等标准化业务 | 开箱即用的云端服务,支持多租户应用,但需注意版权限制(不可移除版权信息) |
| RagFlow | 法律 / 医疗文档处理、复杂格式解析 | 文档解析能力强,支持扫描件 / 表格提取,答案可追溯性高 |
| Langchain-chatchat | 企业内部知识库、个人隐私场景 | 全开源离线部署,数据安全可靠,支持多模态问答(文本 + 图像) |
| FastGPT | 高并发实时问答、行业定制化解决方案 | 自主优化推理性能,支持本地化部署,适合对隐私和性能要求高的场景 |
(3)优缺点对比
| 平台名称 | 优点 | 缺点 |
|---|---|---|
| Dify | 低代码开发、生态整合能力强、支持多模型 API | 依赖第三方模型,数据需经过云端,隐私风险较高 |
| RagFlow | 文档解析精度高、支持多路召回策略、答案可追溯 | 解析速度慢且易失败,技术文档不够完善 |
| Langchain-chatchat | 离线部署安全、多模型兼容、Agent 功能强大 | 前端功能简陋,需技术背景进行二次开发 |
| FastGPT | 高性能推理、本地化部署、自定义模型灵活 | 技术栈较新,生态工具链不如 Py |
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?
答案当然是这样,大模型必然是新风口!
那如何学习大模型 ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:
最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!
在这个版本当中:
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
一、大模型经典书籍(免费分享)
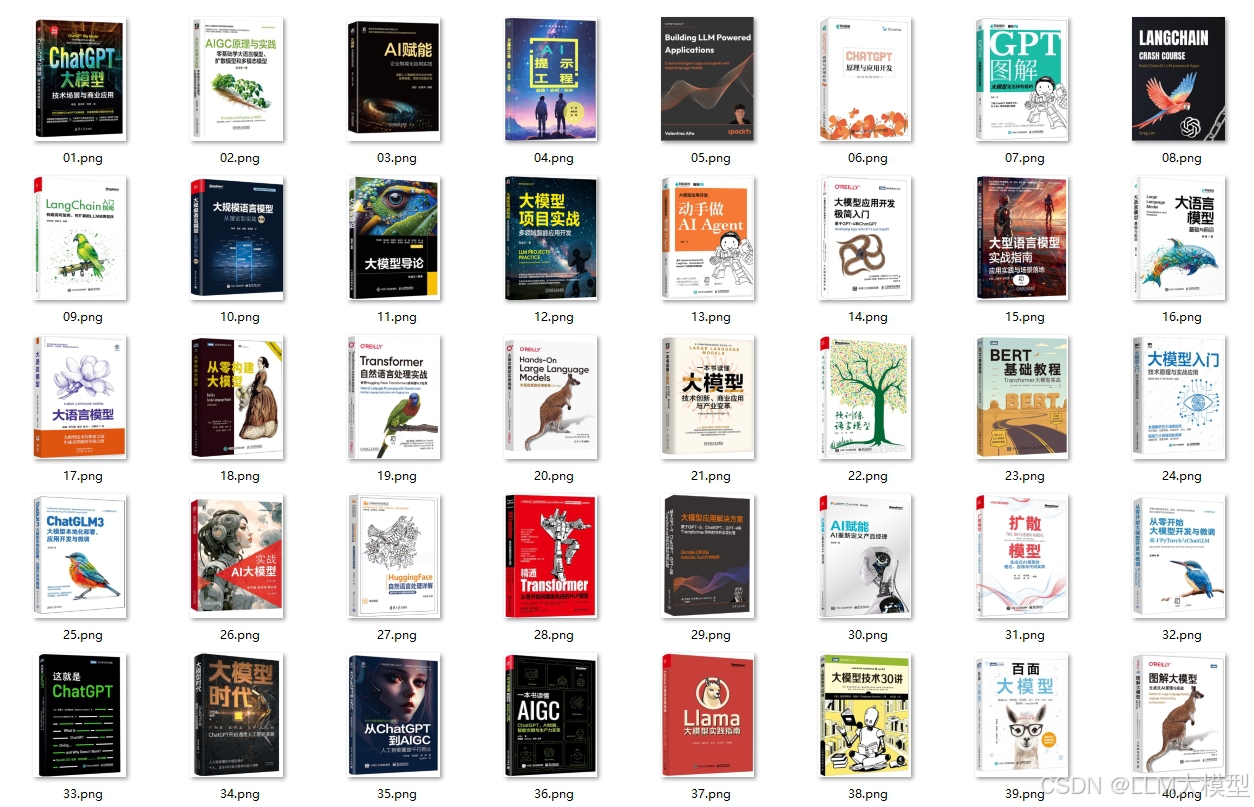
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。
二、640套大模型报告(免费分享)
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、大模型系列视频教程(免费分享)

四、2025最新大模型学习路线(免费分享)
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。
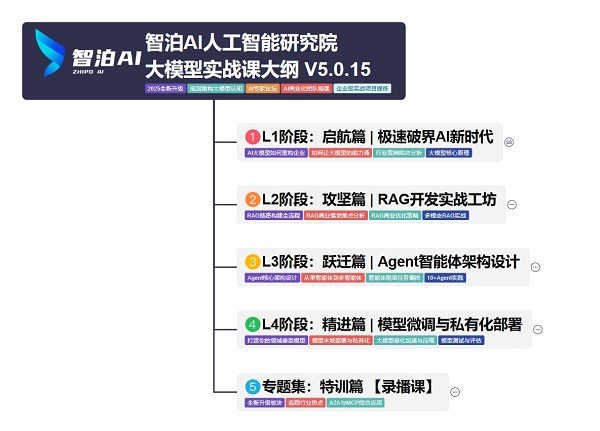
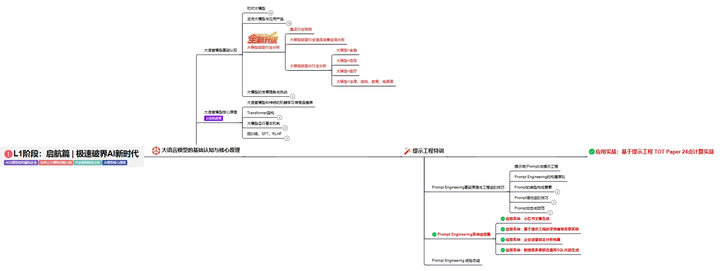
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
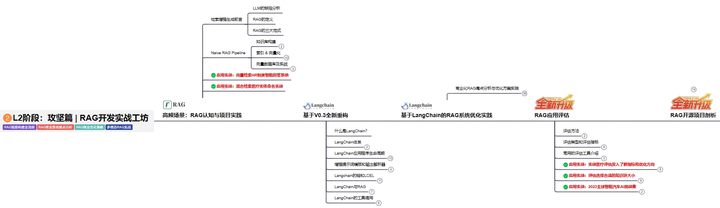
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
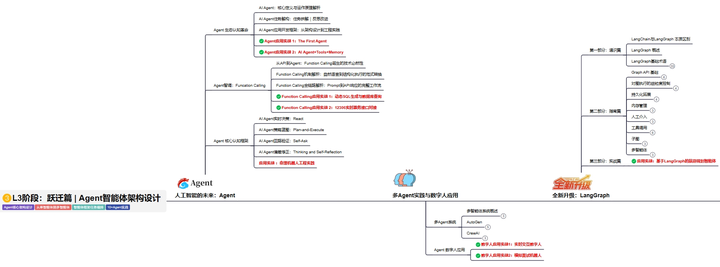
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
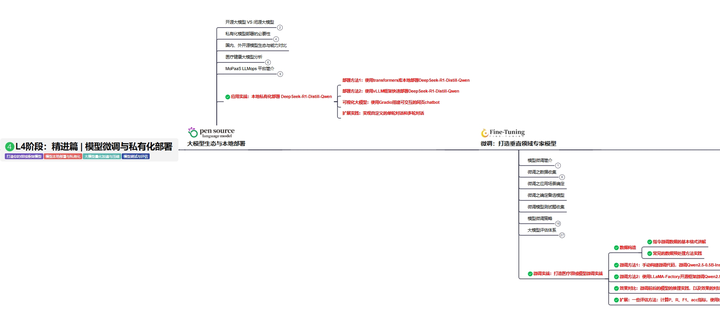
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
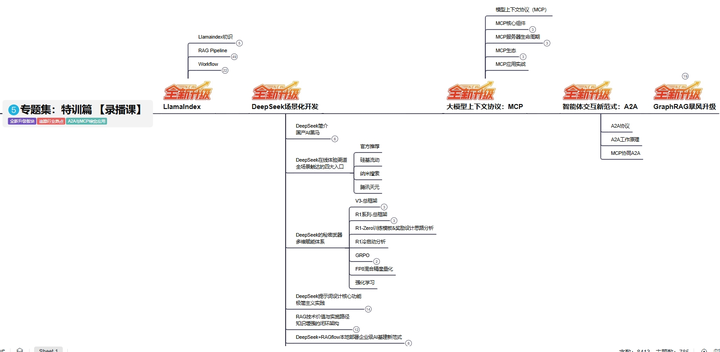
L5阶段:专题集丨特训篇 【录播课】
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取
 258


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


