jieba分词保留社交媒体中的表情符号

表情符号语义建模:让NLP真正理解emoji的语气与意图 表情符号(emoji)已不再是文本中的装饰性字符,而是承载语气、态度和语用功能的关键语义单元。其本质属于副语言特征,需结合上下文建模情感极性、作用范围与平台特异性。传统NLP流程因预处理过滤、分词断裂和评估失配,导致真实场景下性能断崖式下跌。本文聚焦emoji在中文文本挖掘中的工程化落地,系统解析emoticon与emoji的技术差异,提出标准化、对齐、四维特征注入与可插拔架构等实战方案,覆盖从数据清洗、特征构建到模型部署的完整链路,助力情感分析、客服分类与舆情监控等任务实现准确率与可解释性的双重提升。 阅读详情

社交媒体中的表情,经常是中括号+文字的形式,比如,[泪]。

但是按默认的jieba分词,会把[泪]拆成[’[’,‘泪’,’]’]。如果我们想分词的时候保留"[泪]”怎么做呢?

首先修改jieba
直接在jieba包init.py文件中
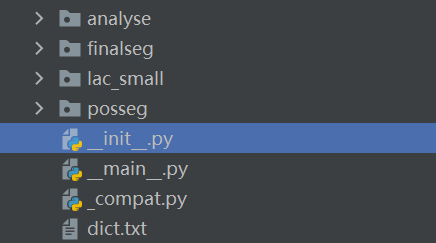
在这里插入图片描述

把
re_han_default = re.compile(“([\u4E00-\u9FD5a-zA-Z0-9+#&._]+)”,re.U)

改成

re_han_default = re.compile("([\u4E00-\u9FD5a-zA-Z0-9+#&\._%\-\]\[]+)", re.U)

然后

import jieba
# 添加不拆新词
jieba.add_word('[泪]')
text = '明天就要高考了,我压力好大……[泪]'
jieba.lcut(text)

输出:
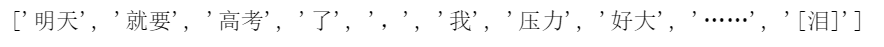
在这里插入图片描述

参考资料:
jieba分词支持关键词带空格和特殊字符

jieba结巴分词加入自定义词典

用KH Coder做社交媒体舆情分析:以微博热点话题为例的实战教程 本文提供了一份使用KH Coder进行社交媒体舆情分析的实战教程,重点以微博热点话题为例。教程详细涵盖了从软件安装、中文环境配置、数据采集清洗,到文本导入、分词、停用词过滤等预处理步骤,并深入讲解了词频分析、共现网络、对应分析等核心操作,最终指导如何将数据结果转化为可视化洞察和具有说服力的分析报告。 阅读详情

相关推荐

停用词表避坑指南:为什么你的中文分词效果总不理想?

本文深入探讨了中文分词中停用词表的选择与优化策略,揭示了通用词表在不同领域应用中的局限性,并提供了动态停用词策略和领域适应性解决方案。通过TF-IDF和上下文感知技术,帮助开发者提升分词效果,避免关键词误过滤和语义丢失问题。

weixin_29081163的博客 329

关于《后浪》的B站弹幕分析总结(二)——jieba分词、常用词典、颜文字处理以及字符格式统一

目录关于《后浪》的B站弹幕分析总结(二)——分词常用的词典、颜文字处理以及格式统一一、你需要知道的几个常用词典- **停用词典(停用词,颜文字,emoji)**- 否定词典,程度副词词典- 情感极性词典,多维情感词典二、统一字符、统一大小写、统一繁简体- 统一字符- 统一大小写- 统一繁简体三、添加无法识别的词和字典中没有的新词四、代码实现分词 关于《后浪》的B站弹幕分析总结(二)——分词常用的词典、颜文字处理以及格式统一 与本文相关内容链接: B站视频《[数说弹幕]我不小心看了后浪弹幕》 关于《后浪》的

Lady_Stark的博客 4122

NLP 文本预处理

实例 # 使用HuggingFace的tokenizer示例 from transformers import BertTokenizer tokenizer = BertTokenizer.from_pretrained('bert-base-chinese') tokens = tokenizer.tokenize("自然语言处理") print(tokens) # ['自', '然', '语', '言', '处', '理']文本清洗是预处理的第一步,目的是去除文本中的噪声数据,提高后续处理的准确性。

xiaoaque的博客 490

jieba分词

三中分词模式 精确模式,试图将句子最精确地切开,适合文本分析 全模式,把句子中所有的可以成词的词语都扫描出来, 速度非常快,但是不能解决歧义 搜索引擎模式,在精确模式的基础上,对长词再次切分,提高召回率,适合用于搜索引擎分词。 安装 pip3 install jieba 分词 jieba.cut方法接受两个输入参数: (1) 第一个参数为需要分词的字符串 (2)cut_all参数用来控制是否采用全模式 jieba.cut_for_search方法接受一个参数:需要分词的字符串,该方法适合.

qq_39249347的博客 510

jieba分词关键字含英文和特殊字符的处理方法

1.默认情况 语句中关键字在含有英文和特殊字符时(machine-1234),使用jieba往往将我们的关键词分割的非常零碎,比如: # 默认情况 import jieba str1 = 查找machine-1234的产品说明书 for w in jieba.cut(str1): print(w) # 运行结果 >>>查找 >>>machine >>>- >>>1234 >>>的 >>>产品 >>>说明书 2.利用自定义字典 通常情况下,我们可以加载预定义字典来包含词库里不存在的词,以达到正确分词的效果 # 利用用户自定义字典 import jieba str1 = 查找mac

10xGenomics Loupe Browser实战指南:从数据导入到细胞注释全流程解析

本文提供了10xGenomics Loupe Browser的实战指南,详细解析了从数据导入到细胞注释的全流程。作为一款强大的可视化工具,Loupe Browser能帮助研究者直观探索单细胞测序数据,通过交互式操作进行细胞选择、差异基因分析和细胞类型注释,是单细胞数据分析入门和结果验证的高效平台。

blue42的博客 451

用python对单一微博文档进行分词——jieba分词(加保留词和停用词)

用python对单一微博文档进行分词——jieba分词(加保留词和停用词)

weixin_41168304的博客 4万+

LEC/FORMAL --- PARTIII debug

lec(logic equivalence checking)又叫formal check,是对ic design的综合,PR前后的设计进行逻辑对比检查的工具/手段,保证综合不改变rtl原始的logic function。目前用的较多的就是C家的formal工具。接下来介绍一下lec过程中遇到的问题以及debug手段。...

sinat_27691203的博客 7685

jieba自定义词典包含特殊符号

1.原来:re_han_internal = re.compile(“([\u4E00-\u9FD5a-zA-Z0-9+#&._]+)”)2.现在:re_han_internal = re.compile(“(.+)”, re.U)参考链接:https://www.cnblogs.com/callyblog/p/10097847.html注:更改jieba根目录下的__init__.py文件下代码我试过在我这儿好像不起作用,直接更改re_han_internal就可以了,大家可以试一下,这样更改后在自定义词

qq_37280534的博客 934

Avalonia 超级详细学习指南

什么是 Avalonia?Avalonia 是一个开源的、跨平台的 GUI 框架,允许开发者使用 XAML 和 C# 构建现代化、高性能的桌面应用程序。与其他框架相比,Avalonia 具有强大的跨平台能力和灵活的界面设计。} }()Avalonia 的特点和优势跨平台性:Avalonia 可以在 Windows、Linux、macOS 等多个平台上运行,开发者可以编写一套代码,然后在不同的操作系统上运行相同的应用程序。

仰望星空的博客 1万+

ESP8266-Arduino网络编程实例-异步TCP客户端

本次实例将使用ESPAsyncTCP库实现一个简单的客户端。

视觉与物联智能 1734

python中的jieba分词保留给定词汇

之前在做python的词云作业时,希望保留一些特定的词汇,但在网上没有找到方法,今天在上python课的时候老师给出了解答: 首先,调用jieba.load_userdict(文件名),加载需要保留的词汇,文件内容是需要保留的词汇,然后使用jieba.lcut(text)即可对给定的文本进行分析,即可得到结果。 代码: def cut_by_custom_dict(text=None): jieba.load_userdict('../data/user_dict.txt') ret

CoAAColA的博客 3413

FakeNewsGPT4:通过知识增强的大规模视觉语言模型推进多模态假新闻检测

当前,多模态假新闻的大量涌现导致了显著的分布差异,这一现状亟需我们开发具备广泛适用性的检测器。然而,现有假新闻检测器因特定领域内的训练方式,难以有效获取开放世界中的事实信息。这种训练的封闭性限制了传统检测器的能力,特别是在面对跨域假新闻时,其表现往往不尽如人意。具体而言,开放世界中的假新闻在两个方面具有显著的分布差异:一方面,其操纵内容多种多样,新闻的任一部分都可能受到创意策略的操控;另一方面,真实背景复杂多变,不同地区的新闻背景和主题焦点存在显著差异。

qq_52053775的博客 818

中英文混合分词实战:Jieba、spaCy与HanLP在社交媒体文本中的表现与调优

本文针对社交媒体中英文混合文本的分词难题,实战对比了Jieba、spaCy和HanLP三大工具的表现。通过真实案例分析,揭示了它们在处理网络用语、表情符号、话题标签及跨语言混合时的痛点,并提供了针对性的调优策略与选型指南,帮助开发者根据速度、准确率和易用性选择最佳方案。

apple5的专栏 1008

以太网PHY寄存器

并且,值得注意的是,由于目前很多百兆的PHY芯片其MAC接口主流的都是SMII/S3MII,8个端口的接口是相互关联的,一个端口设置Isolate可能会影响其他端口的正常使用,因此在使用中注意不要随意更改bit10的状态。Bit10和bit11的区别是,bit11的配置在强制情况下生效,PHY只能工做与bit11指定的工作模式,而bit10的配置在非强制配置情况下生效,仅仅控制PHY在AN时候的优先级,偏向于Maser或者Slave,但是最终的工作模式看协商的结果,不一定和优先级配置的结果一致。

mangofu的博客 289

多agv系统调度的MATLAB仿真

从起点出发,到货物点领取货物最后到卸货点,以完成任务总时间最短为目标进行单目标优化,约束条件为,任务不冲突,路径不冲突,要能实现路径规避 ,4-6台agv一起工作。左右货架间隔可通过1个agv,上下货架间隔可通过两个agv,通道为双向行驶通道。一台agv只能带一个货物,优化目标为完成任务总的时间最短,agv的速度是匀速,转弯也不会减速,取货物时间为固定值。上面的图里面货物看为正方形跟agv一样的长度大小,agv试做是跟货物一样大小的正方形agv的速度是每秒1个车身。多台agv一起完成...

FPGA/MATLAB学习教程/源码/项目合作开发 7559

避坑指南:weibo_senti_100k数据集预处理中的5个常见错误(附jieba分词优化方案)

本文深入剖析了在weibo_senti_100k数据集预处理中常见的五个关键错误,包括噪声处理、停用词选择、分词优化、词汇表构建及序列化策略。针对中文微博文本特性,提供了精细化的数据清洗方案和jieba分词的深度定制技巧,旨在提升后续文本分类模型的训练效果与鲁棒性。

kk1234的博客 244

深度学习论文: AnomalyDINO: Boosting Patch-based Few-shot Anomaly Detection with DINOv2

通过将DINOv2模型适应到一次性和少量异常检测中,并专注于工业应用少量异常检测。实验表明,这种方法不仅与现有技术相匹敌,甚至可以在许多设置中超越它们。我们提出的仅视觉方法AnomalyDINO基于补丁相似性,能够实现图像级别的异常预测和像素级别的异常分割。该方法在方法论上很简单,无需训练,因此不需要任何额外的数据进行微调或元学习。

mingo_敏 1892

NLP文本预处理全流程解析:从分词到词形还原的实战技巧

本文全面解析了NLP文本预处理的核心流程与实战技巧,涵盖从文本清洗、分词、去除停用词到词形标准化的完整步骤。重点对比了词干提取与词形还原的差异与应用场景,并提供了基于Python的模块化预处理流水线构建方案,旨在帮助开发者提升模型输入数据质量,优化NLP任务效果。

weixin_29103191的博客 254

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

利用PyTorch与Bi-LSTM实现中文社交媒体情感极性分析

本文详细介绍了如何利用PyTorch框架和Bi-LSTM模型进行中文社交媒体情感极性分析。针对网络文本短小、非规范、情感隐晦等挑战,文章从数据清洗、模型构建到训练调优提供了完整实战指南,并探讨了针对网络流行语和隐式情感的优化策略,帮助开发者构建高效准确的情感分析系统。

zzz56的博客 207

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

从分词到BERT:NLP算法实战中的5个关键步骤与避坑指南

本文为开发者提供了构建NLP文本分类系统的完整实战指南,涵盖从数据清洗、分词、特征工程到模型训练与部署的5个关键步骤。文章结合jieba、BERT等工具,重点解析了在自然语言处理项目中如何规避常见陷阱,平衡资源与精度,并最终实现模型的高效部署与持续维护。

c2d3e4f的博客 682

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

当贝叶斯遇见社交媒体:新闻标题的70次重复实验启示录

本文探讨了贝叶斯算法在社交媒体情感分析中的应用,通过70次重复实验揭示了标题重复对情感分类性能的影响。研究发现,适度重复标题(50-70次)可显著提升模型准确率,尤其在处理简短、非正式的社交媒体文本时效果突出。文章详细介绍了朴素贝叶斯分类器的原理、特征工程方法及生产环境部署方案,为互联网新闻和社交媒体分析提供了实用见解。

transformer2023的博客 677

基于Word2Vec和LSTM实现微博评论情感分析

本文介绍了一个基于LSTM的中文情感分析项目,通过深度学习技术对社交媒体文本进行情感分类。项目使用jieba进行中文分词和停用词过滤,采用Word2Vec生成词向量作为模型输入。LSTM模型架构包含嵌入层、LSTM层和全连接层,使用交叉熵损失函数和Adam优化器进行训练。创新点包括优化的数据预处理流程、自定义词向量生成和多层LSTM设计。实验结果显示,该模型能有效识别微博文本的情感倾向(正面/中性/负面),可应用于用户情感分析和市场研究。项目提供了完整的数据预处理、模型训练和评估代码。

1197

从数据到情感:基于SVM的社交媒体情绪分析实战

本文详细介绍了基于支持向量机(SVM)的社交媒体情绪分析实战,从数据获取、清洗到特征工程和模型调优,全面解析如何利用机器学习技术精准捕捉用户情感。通过实际案例展示SVM在情绪分析中的高效表现,帮助开发者快速掌握智能模型的应用技巧。

weixin_30673611的博客 279

避坑指南:用pandas处理小红书评论数据时常见的5个错误(附词云优化技巧)

本文总结了使用pandas处理小红书评论数据时常见的5个错误,包括编码问题、数据清洗、分词不准、词频统计偏差及词云图生成不佳,并提供了详细的避坑指南和优化技巧。重点介绍了如何利用WordCloud库调整参数,生成专业、清晰的中文词云图,从而有效提升社交媒体文本分析的质量与可视化效果。

u6v7w8x的博客 684

使用TensorFlow进行情感分析:社交媒体舆情监控

在信息爆炸时代,企业需快速捕捉公众情绪。基于TensorFlow的情感分析系统,结合预训练模型、高效数据流水线与TensorFlow Serving部署,可实现高精度、低延迟的社交媒体舆情监控。通过Kafka解耦、闭环反馈与人工复核机制,保障系统稳定与准确。技术之外,更需关注隐私保护与模型局限性。

weixin_42602726的博客 1016
上一篇: 常见10种排序算法的python实现
下一篇: 微信也能玩AI绘画啦
JUNE YAO
博客等级 码龄8年 57粉丝 24原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
