


前言:
HSTU / GenRank:模型怎么“算”推荐、OneReason:模型怎么“想”推荐,而CoVeMem:Agent 怎么“记”用户。它不是重新设计一个 HSTU/GenRank 式的推荐 backbone,也不是直接解决 OneReason 的推荐 Reasoning,而是把传统推荐模型学到的协同信息变成 Agent 的长期 Vector Memory,再让 LLM 学会读取这种 Memory。即:让推荐模型负责“存协同知识”,让 LLM 负责“读协同知识”。
提出问题:现有 Agentic Recommender 大多把 Memory 做成文本,存在两个问题:① Memory维护成本高;② 文本会损失协同结构。所以论文提出:
为什么不直接保存推荐模型学习到的 Collaborative State?
而且进一步提出一个更关键的问题:
如果 Vector Memory 不能直接作为 LLM Token,那么怎么让 LLM真正学会读取它?
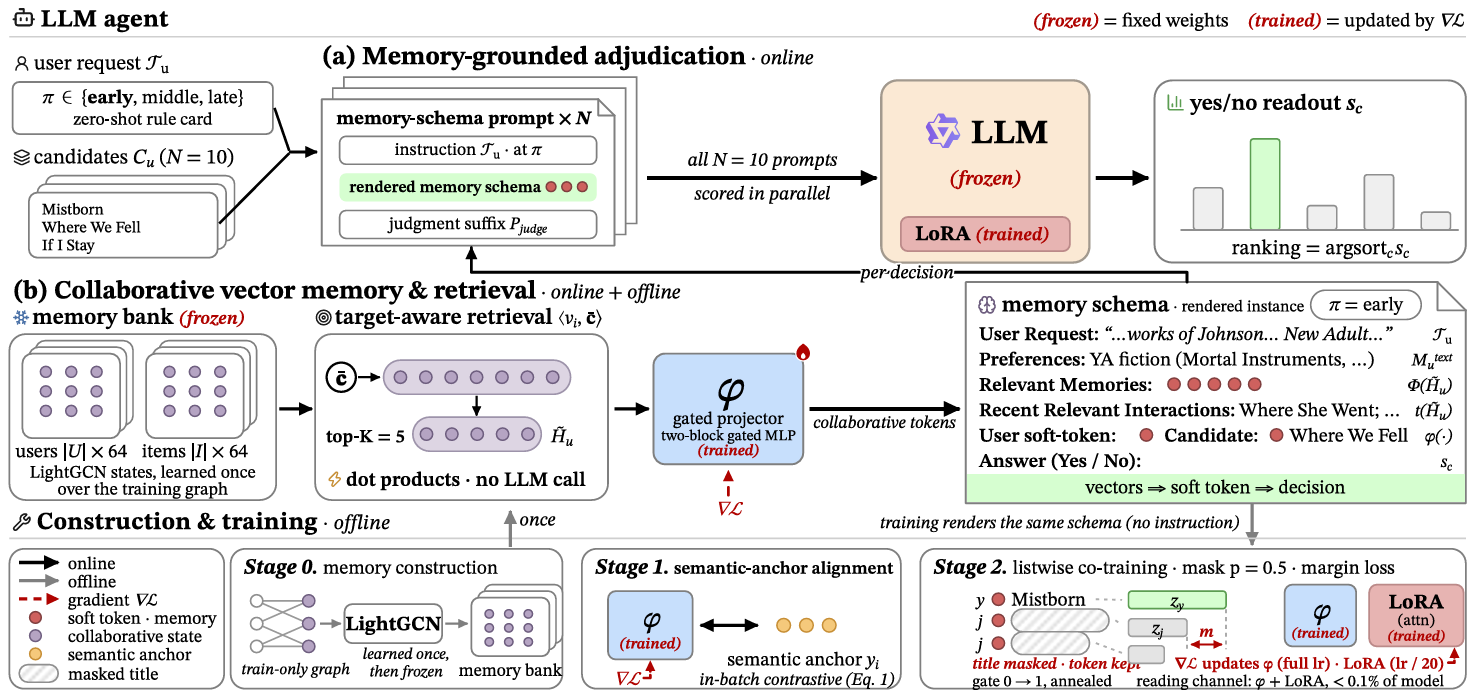
💡创新1:Collaborative Vector Memory
📌好处:
把原本的:
Text Memory
变成:
Textual Profile + Collaborative Vector Memory
相比文本 Memory:
- 不需要持续调用 LLM 更新 Memory
- 保存整个 Catalog 的协同关系
- 可以直接利用完整交互历史进行训练
- Memory 可以接受推荐任务产生的训练信号
论文的核心变化就是:
Memory 不再只是 LLM“写出来”的东西,而变成推荐模型可以学习的模型组件。
🏃♀️做法:
使用 LightGCN 在用户—物品交互图上学习:
User State
Item State
每个 User / Item 对应一个 64维向量。
训练完成以后:
冻结这些 States
形成:
Collaborative Vector Memory Bank
同时保留一个轻量级 Textual Profile 作为显式语义信息补充。
因此 CoVeMem 的 Memory:
Text = 显式语义
Vector = 隐式协同关系
💡创新2:Candidate-aware Retrieval → Soft Token
📌好处:
解决两个问题:
Memory太大,不能全部塞进Prompt
推荐模型Vector不能直接被LLM理解
而且不是简单地:
“取用户最近5个行为”
而是:
当前要推荐什么 → 决定应该读取用户过去什么
因此 Memory Retrieval 变成了候选集感知。
🏃♀️做法:
① Candidate-aware Retrieval
首先得到当前候选集合:
C = {item₁, item₂, ..., itemₙ}
计算候选物品向量的平均值:
Candidate Centroid
然后使用它去检索用户历史 Item States:
Candidate Centroid→与历史 Item State 做相似度计算→Top-K
论文设置:
K = 5
所以读取的不是:
“用户最近看了什么”
而是:
“用户过去哪些行为与当前这批候选最相关?”
② Vector → Soft Token
推荐模型输出的是:
64维 Collaborative State
LLM需要的是:
LLM Embedding
于是加入:
Gated Projector(门控投影)
将:
Collaborative State→Gated Projector→LLM Embedding Space→Soft Token
最终:
1个Vector State = 1个Soft Token
这些 Soft Tokens 和:
User Token、History Tokens、Candidate Tokens、Textual Profile
一起进入 LLM。所以这里实际上搭建了一条非常重要的桥:
Recommendation Embedding → LLM Token
💡创新3:让LLM真正学会“读取”Collaborative Memory
📌好处:
最大的风险不是:
Vector 能不能送进 LLM
而是:
送进去以后,LLM会不会根本不用它?
例如候选物品有标题:
“科幻电影A”、“科幻电影B”、“喜剧电影C”
LLM完全可能只根据标题语义完成推荐,而忽略 Collaborative Vector。
所以 CoVeMem 的真正关键:
不仅把 Vector Memory 接进去,还要训练 LLM 学会使用它。
🏃♀️做法:
采用两阶段训练:
Stage 1:Contrastive Alignment
Stage 2:Masked Listwise Co-training
同时使用:
LoRA
训练 LLM 的读取方式。
① Contrastive Alignment
首先解决:
Collaborative Vector 和 LLM Semantic Space 不对齐
对于一个 Item:
Item State→Gated Projector→Projected State
同时利用:
Item Title + Category
生成一个 LLM Semantic Anchor。然后做对比学习:
Projected State ↔ 正确 Item Semantic Anchor
Projected State ↔ 其他 Item Semantic Anchor
让:
正确匹配更近,错误匹配更远
论文:
τ = 0.07
作用:
先把推荐模型的向量“放进LLM能理解的空间”。
② Masked Listwise Co-training
接着真正进行 Ranking Training。把用户历史中的每次交互变成:
History → Positive Item + Negative Items
关键操作:
随机 Mask 50% Candidate Titles
例如:
Candidate A:标题可见
Candidate B:标题被Mask
Candidate C:标题被Mask
Candidate D:标题可见
如果:
Positive Item 恰好被 Mask
那么 LLM 就无法根据标题判断:
“这个物品看起来更符合用户兴趣”
此时只能更多依靠:
Collaborative Soft Tokens
于是 Ranking Loss 就真正开始训练:
LLM应该如何读取 Collaborative Memory
这一步是 CoVeMem 最关键的地方。
③ LoRA:让LLM改变“读取方式”
基础模型使用:
Qwen2.5-7B-Instruct
大部分参数冻结。只训练:
Gated Projector + LoRA
LoRA 加在 Attention:
Wq / Wk / Wv / Wo
上。
所以 LoRA 在这里不是单纯为了“省参数微调”,更重要的是:
让 Attention 学会关注、解释和使用 Collaborative Soft Tokens。
最终整个 Parametric Memory Reader 只有约:
6.8M 参数
<0.1% 基础模型参数
💡创新4:Training Listwise → Inference Pointwise
📌好处:
训练的时候需要:
Listwise Ranking(列表式排序)
让模型学习多个候选之间的比较。但推理时直接让 LLM:
一次生成完整推荐列表
可能出现:
输出解析问题、Collaborative Token 被多个候选同时输入后稀释、生成过程增加额外成本
所以推理采用:
Pointwise Yes/No
🏃♀️做法:
对每一个 Candidate 单独询问:
Will the user interact with this item?(用户是否会与该物品进行交互?)
然后不让 LLM真的生成完整回答,而是直接读取:
Yes Token Logit
作为推荐分数:
Candidate₁ → Yes Logit
Candidate₂ → Yes Logit
Candidate₃ → Yes Logit
↓
Sort
↓
Ranking
所有候选可以并行评分。
所以:
训练:Listwise
推理:Pointwise
🧪实验验证:
4个 InstructRec 数据集:
Books / Goodreads / MovieTV / Yelp
CoVeMem 与 MemRec 这个最强的文本 Memory Agent 比较。
结果:
20个指标中,19个达到或超过 MemRec
其中 Goodreads 提升非常明显:
MemRec:Hit@1 = 0.3087
CoVeMem:Hit@1 = 0.7730
MovieTV:
MemRec:H@1 = 0.5371
CoVeMem:H@1 = 0.5799
Yelp:
MemRec:H@1 = 0.5173
CoVeMem:H@1 = 0.5400
🔬Collaborative Backbone还能替换:
论文进一步把:
LightGCN
替换成:
SASRec / BPR-MF / GRU4Rec / LightGCN / SVD++
说明:
CoVeMem真正依赖的不是LightGCN本身,而是“推荐模型提供Collaborative Representation”这个接口。
也就是说未来可以:
更好的 RecSys Backbone→更好的 Vector Memory→更好的 Agent Recommendation
💰Memory Efficiency:
传统 Text Memory Agent:
用户交互→LLM Rewrite→Memory Update→下一次交互→再次Rewrite
CoVeMem:
Recommendation Model→Offline Memory Bank→不再调用LLM维护Memory
论文统计下:
Memory Maintenance = 0 additional LLM tokens
而且 Pointwise Yes/No Readout 使得其决策阶段 Token Cost 也较低。
🧠论文最核心的思想:
以前:
Memory = Text
Agent 得不断:
写Memory → 改Memory → 再读Memory
CoVeMem:
Memory = Text + Collaborative Vector
其中:
Text → 保留显式语义
Vector → 保存推荐模型学习到的协同关系
最关键的是:
Memory开始“吃梯度”了。
以前:
Interaction→LLM→Text Memory
Memory更像一个:
LLM写出来的产物
CoVeMem:
Interaction(交互)→Collaborative Model(协作模型)→Vector Memory(向量记忆)→Ranking Gradient(排序梯度)→Memory Reader(记忆读取器)
于是 Memory 变成:
可以训练、可以优化的模型组件。
所以论文标题:
When Memory Takes Gradients
真正想表达的是:
当Memory可以接受训练信号后,它就不再只是Agent保存信息的“笔记本”,而成为推荐模型的一部分。
💡对生成式推荐的启发:
① 推荐模型可以从“Scorer”变成“Memory Provider”
传统:
Recommender → Score
CoVeMem:
Recommender → 提供 Collaborative Knowledge
然后:
LLM → 读取 Knowledge → 做决策
这意味着 HSTU、GenRank 这类推荐 backbone 学到的表示,不一定只能用于最终打分。
还可以成为:
Agent 的长期记忆来源。
② Generative Recommendation可以引入“外部协同记忆”
OneReason解决的是:
如何让生成式推荐模型产生更好的 Reasoning
CoVeMem提供了另外一个方向:
Reasoning / Generation 不一定需要自己承担所有 Collaborative Knowledge
可以让:
RecSys Backbone
↓
Collaborative Memory
↓
Generative Model / LLM
↓
Generation / Ranking / Reasoning
形成:
Recommendation Model → Memory → Generative Model
③ 一个非常值得继续想的问题
CoVeMem目前主要解决:
LLM怎么读取Collaborative Vector Memory?
那么进一步可以继续问:
如果把这种Vector Memory接到真正的Generative Recommendation中,会怎么样?
例如:
HSTU / OneRec
- Collaborative Vector Memory
- Semantic ID
- Multimodal Memory
- Reasoning
最终可能形成:
Behavior Sequence → Collaborative Memory → LLM/Generator → Item Generation
而不只是:
Behavior Sequence → Generator


 扫一扫


 59

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


